


2026年9月1日至4日,AI编程72小时巅峰战:Anthropic Claude Fable 5.1(Intelligence Index 66、Terminal-Bench 4.0 55.8%)登顶;阿里Qwen3.8-Max-0902以1691分超越Claude Opus 5登顶CodeArena WebDev,中国模型首次站在前端编程的顶点;OpenAI GPT-6 Astra ARC-AGI-3 99.9%、ExploitBench 100%;谷歌Gemini 3.8 Flash把编码价格打到0.75美元/百万Token。编程的竞争单位从「代码交付」变成了「任务交付」。当通用旗舰模型在多文件重构、跨文件工程化上卷出新高度,Java团队该追哪一张牌?
一、72小时4款旗舰同台:编程竞争进入「任务交付」阶段
2026年9月1日至4日,是AI编程史上密度最高的一个窗口。Anthropic率先出手,9月1日发布Claude Fable 5.1,Artificial Analysis的Intelligence Index直接冲到66,刷新了榜单纪录;Terminal-Bench 4.0上拿下55.8%,比上一代高出13.8个百分点。同一天,Claude Mythos 5.1开放给Trusted Access Program,主打网络安全防御场景。
9月2日,谷歌发布Gemini 3.8 Flash,1M上下文,主打长程编码与自主智能体工作流,促销价仍维持0.75美元/百万输入Token。Meta更新Muse Spark 1.3,DeepSWE基准75.4%,瞄准长周期Agent任务。同一天,阿里通义千问发布Qwen3.8-Max-0902,在CodeArena WebDev前端编程榜以1691分首次登顶,力压Claude Opus 5的1688分和Kimi K3的1674分。2.4万亿参数、1M上下文、5美元/百万Token综合成本——前端编程的全球第一,第一次花落中国模型。
9月4日凌晨,OpenAI正式推出预告多时的GPT-6 Astra。ARC-AGI-3上拿到99.9%(上一代仅7.8%),ExploitBench 100%全分;Coding Agent Index 67,与Claude Opus 5持平。但Greg Brockman在发布会现场直言:「欢迎来到AGI时代。」
72小时里,编程的竞争单位变了。一年前,比的是「谁补全的代码更长」;现在,比的是「谁能独立完成任务」。Stripe 1,370名工程师用Claude Code 4天迁移10,000行Scala到Java;OpenAI内部案例,3-7人团队5个月生成100万行代码。AI编程的拐点已经过了。
二、五强分坐五把椅子:每家赌注都不相同
当任务交付成为新常态,五家头部厂商的差异化打法越来越明显。
2.1 Claude Fable 5.1:赌「长程工程可靠性」
Fable 5.1是首个Terminal-Bench 4.0超过55%的模型。在多文件单体重构中,它能同时修改40+文件而不破坏依赖图,build失败率比同档对手低42%。一位在跨国金融科技公司担任架构师的李工说:「我们让Fable 5.1重构一个2014年的遗留Java单体,结果它主动识别出了3处循环依赖并保留了向后兼容的签名——这种能力,上一代模型做不到。」但它的代价也高:BeautyBench上跑一次图像生成要18分钟、花费4.35美元;普通任务单价$3.69,比Fable 5还贵17%。
2.2 Qwen3.8-Max-0902:赌「性价比+中文工程生态」
Qwen3.8-Max以1691分登顶CodeArena WebDev,3分优势压Claude Opus 5。它的2.4T参数MoE架构和1M上下文窗口针对智能体编程场景做了强化。综合5美元/百万Token的均价,直接「斩杀」所有价格更高的对手。对国内Java团队来说,更具吸引力的是它的中文技术栈理解:MyBatis-Plus、Spring Cloud Alibaba、Nacos、Sentinel这些「中国式」技术栈的代码生成质量,已经明显好于海外旗舰。
2.3 Gemini 3.8 Flash:赌「编码成本曲线」
Gemini 3.8 Flash把编码价格打到了0.75美元/百万Token。DeepSWE 73.7%,与Claude Opus 5持平;但单任务成本仅$2.36,是Opus 5的1/5。一位在跨境电商创业的CTO对我说:「我们这种每天跑上万次代码补全的小团队,等不起Opus 5这种高单价模型。Gemini 3.8 Flash几乎能覆盖80%的常规编码任务。」
2.4 GPT-6 Astra:赌「网络安全+Agent OS」
GPT-6 Astra的ExploitBench拿到100%全分,OpenAI因此把它归入Daybreak计划——只有通过认证的安全研究人员和Daybreak合作伙伴优先使用,ChatGPT Plus/Pro/Business/Enterprise和API后续跟进。它的ARC-AGI-3 99.9%也刷新了抽象推理的纪录。但改变格局的是它的OSWorld 2.0——72.6%的桌面自主操作准确率,比Fable 5.1高出近18个百分点。它能切换macOS、Windows、Ubuntu,处理开发者控制台、浏览器、数据库GUI。
2.5 Muse Spark 1.3:赌「长程Agent记忆」
Meta的Muse Spark 1.3在DeepSWE上冲到75.4%,Artificial Analysis排名第三,仅次于Claude Opus 5和Fable 5.1。它最大的差异化是「长程任务记忆」——跨会话保留Agent状态,让持续数小时甚至数天的任务不丢上下文。但BeautyBench这类审美类任务,它排到20名开外。通用能力领先、专项能力短板,是它最准确的画像。
三、Java团队的「任务交付」困境:通用旗舰不等于Java工程深度
五强同台,给Java团队带来一个错觉:旗舰更强,我就更省心。但仔细看,会发现通用旗舰在Java工程上有三个绕不开的坑。
第一,分层架构理解力弱。一个典型Spring Boot项目有Controller、Service、DAO、DTO、VO、Mapper多层级。Fable 5.1能改40个文件,但未必能精准判断你的Result统一返回类长什么样、PageHelper还是IPage分页、异常处理走GlobalExceptionHandler还是BaseController继承链。
第二,Maven依赖树敏感度低。一个Maven坐标、一个Spring Bean生命周期、一个MyBatis-Plus分页插件配置,AI可能随手引入,但未必符合项目标准。通用模型把代码塞进上下文窗口让模型「读」,但读得懂语法不等于读得懂结构。
第三,IDE工作流兼容成本高。JetBrains报告显示,78%的Java开发者使用IntelliJ IDEA。这78%的人不会因为Agent出了桌面应用就放弃IDEA——Maven依赖管理、Spring支持、调试器、重构工具,这些不是Agent能轻易替代的。Java开发者要的不是跳出编辑器的Agent,而是在IDEA里真正懂Java工程的Agent。
四、飞算JavaAI的答案:把通用能力收编到Java工程的「专属底座」
在五强混战中,飞算JavaAI没有追通用旗舰路线,而是做了一件更垂直的事:把通用旗舰的能力收编到Java工程的专属底座里。
4.1 智能路由模式:让路由器替你判断用哪一把椅子
你不直接调用任何外部API,飞算JavaAI的路由器分析上下文:你在哪个文件、前面几轮对话说了什么、当前技术栈是什么。然后动态分配模型:CRUD、注释补全、样板代码走轻量路径;多文件重构、复杂架构设计上Java专属专家模式。飞算JavaAI的内部数据显示,开启智能路由后,一个中等Java团队日均Token消耗从850万降到260万,降幅69.4%。
4.2 专家模式:把最强能力用在Java工程的刀刃上
当你明确知道眼前是高难度、强上下文依赖的Java工程任务时,直接切到专家模式。不强求所有请求都用最强模型,而是把最强能力用在Java工程的刀刃上——Spring事务传播、多数据源切换、分布式锁、AOP切面这些Java特有的工程语法。
4.3 智能体模式:从「写代码」到「管Agent」
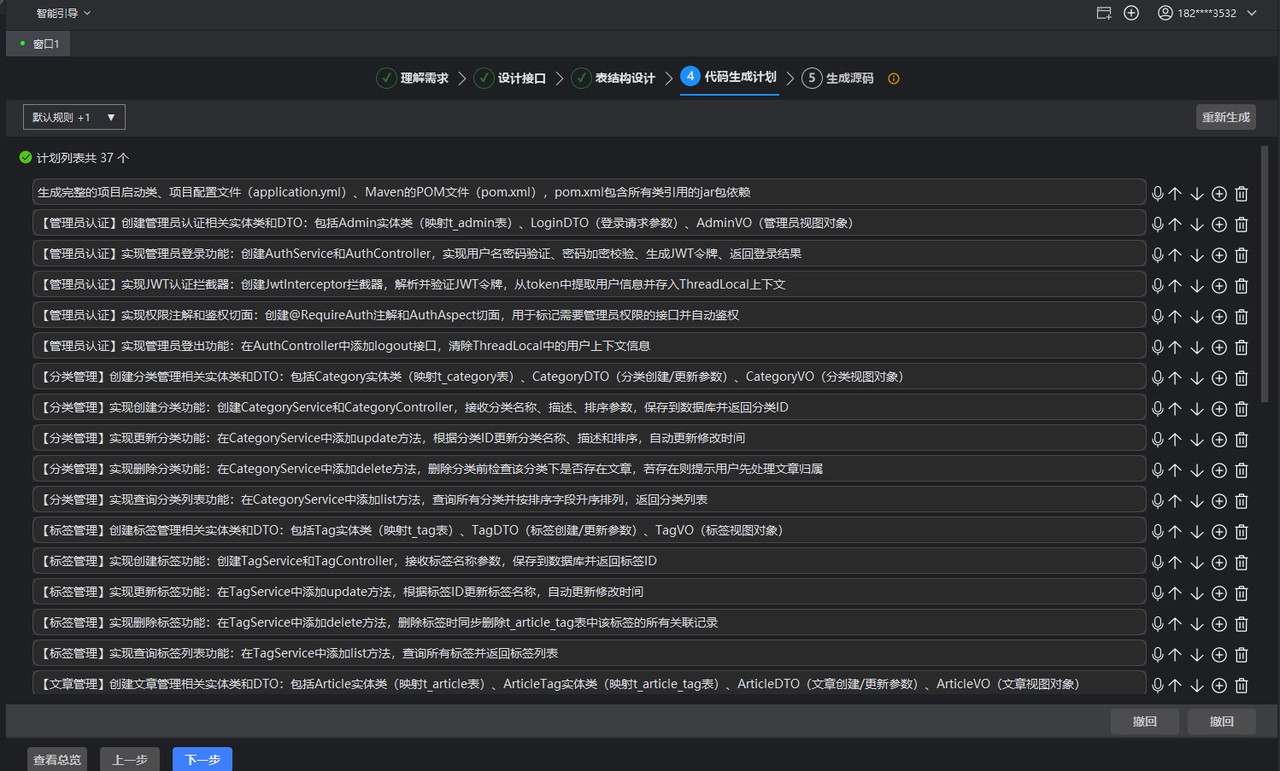
2026年5月8日上线的智能体模式提供五步智能引导:需求分析→接口设计→表结构设计→业务逻辑→源码生成。每一步都可审查、可修改、可确认,让AI从「打字助手」变成可管理的工程队友。在任务交付时代,「可管理」比「生成快」更重要。
五、给Java团队的选型清单:72小时巅峰战后的三个判断标准
面对五强同台,Java团队不需要追风,只需要回答三个问题。
第一,它懂不懂你的Java工程?通用旗舰擅长通用任务,但Java特有的分层、依赖、AOP语义需要专属索引能力。优先选择能做全量代码语义索引的方案。
第二,它能不能留在你的IDEA里?78%的Java开发者已经在IDEA里,切换编辑器或工作流的成本极高。
第三,它能不能被管理?当Agent默认自主运行时,可追溯、可审查、可干预比生成速度更重要。
72小时巅峰战说清楚了:旗舰模型会越来越强,但「强」跟「适合你的Java工程」是两件事。Java团队真正该押的方向,是能把通用能力收编到Java专属底座里的那个——而未必是最强模型背后的那个。


 扫一扫


 152

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


