


 超级会员免费看
一篇帮你从"知道 Skill 这个词"到"能独立设计生产级 Skill"的系统教学,含 3 个完整实战案例。
阅读提示
适合谁看:正在做或准备做 AI Agent 开发的工程师,尤其是从传统后端 / 数据仓库转过来的同学
看完能做什么:能独立写一个完整的 Skill,能说清 Skill 的注册、调度、执行全链路,能避开 80% 的常见坑
不适合谁:只用 ChatGPT 聊天、不涉及 Agent 系统开发的用户
先给结论
Skill 本质上是一段"被结构化描述的可复用能力",它和普通函数的区别不在于代码本身,而在于它对 LLM 是可发现、可理解、可调度的
一个 Skill 的质量,70% 取决于描述(description)和触发规则(trigger),而不是执行逻辑本身
写 Skill 最常见的错误不是代码写错,而是"描述太模糊导致 LLM 不知道什么时候该用它"
你有没有遇到过这种情况:你给 Agent 接了一个天气查询 API,测试的时候手动调用没问题,但用户说"明天北京冷不冷",Agent 就开始瞎猜,根本不调你的接口。
或者你写了一个计算工具,用户说"帮我算一下 15% 的折扣价",Agent 自己心算了一个错的答案,完全忽略了你的函数。
问题不在模型笨,而在你给模型的"工具说明书"写得太差了。
很多人以为 Skill 就是包了一层的函数调用,写个 name、写个 parameters 就完事了。但真正让 Skill 在 Agent 系统里可靠工作的,是描述、触发规则、参数校验、返回格式、异常兜底这一整套设计。
这一篇,我会从最基础的定义开始,一直讲到底层注册机制和调度引擎,中间穿插 3 个可以直接跑的实战 Skill。看完之后,你不只会写 Skill,还能说清楚"为什么这么写"。
01 先搞清楚:Skill 到底是什么,和插件 / 工具有什么区别
很多文章把 Skill、Plugin、Tool 这三个词混着用,导致读者越看越迷糊。先在这里把边界画清楚。
Tool(工具):最底层的概念。一个 HTTP API、一个数据库查询函数、一个文件读写操作,都是 Tool。它只关心"输入什么、输出什么",不关心"什么时候该被调用"。
Plugin(插件):一组 Tool 的打包。比如一个"飞书插件"可能包含发消息、读文档、查日历等十几个 Tool。Plugin 解决的是"怎么安装和管理",不解决"怎么被 LLM 理解"。
Skill(技能):在 Tool 之上加了一层"对 LLM 的语义描述"。它不只是一个可执行的函数,还包含:
-
这个能力是干什么的(description)
-
什么情况下应该触发它(trigger rules)
-
需要从用户输入里提取哪些参数(slot definitions)
-
执行出错了怎么办(error handling)
用一句话总结:Tool 是给机器看的接口,Skill 是给 LLM 看的能力说明书。
这个区别非常关键。一个写得好的 Skill,LLM 能准确判断什么时候该调它、该传什么参数;一个写得差的 Skill,即使代码逻辑完全正确,LLM 也可能在该用的时候不用、不该用的时候乱用。
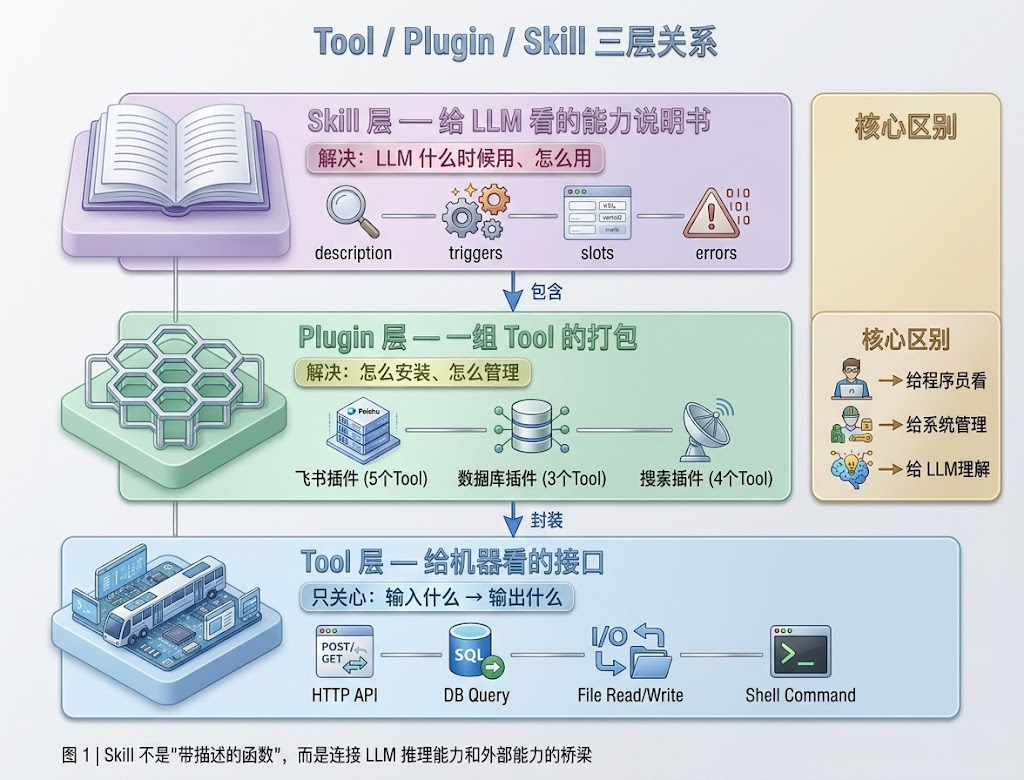
图 1|Tool / Plugin / Skill 三层关系
这一节的小结
Skill 不是"带描述的函数"这么简单。它是连接 LLM 推理能力和外部可执行能力之间的桥梁,核心价值在于让 LLM 能"理解"和"选择"什么时候使用哪个能力。
02 Skill 的核心组成结构:7 个缺一不可的模块
一个完整的 Skill 由 7 个部分组成。少了任何一块,在实际 Agent 系统里都会出问题。
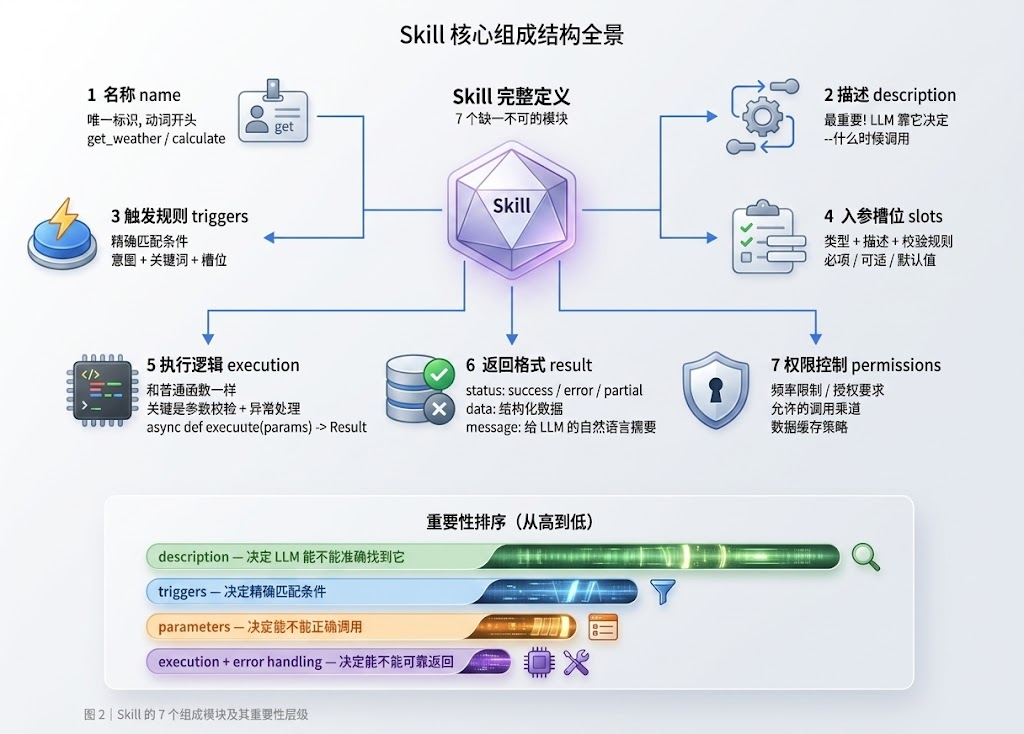
图 2|Skill 核心组成结构全景
1. 名称(name)
Skill 的唯一标识符。要求:
-
全小写,用下划线连接:
get_weather、calculate_discount -
动词开头,一眼能看出它干什么
-
避免泛化命名如
do_something、process_data
2. 描述(description)
这是整个 Skill 里最重要的字段,没有之一。LLM 靠这段文字决定什么时候调用你的 Skill。
写好描述的关键原则:
-
说清楚"能干什么":
查询指定城市未来 3 天的天气预报 -
说清楚"什么时候用":
当用户询问天气、温度、是否下雨、穿衣建议时触发 -
说清楚"不适用什么":
不支持历史天气查询,不支持全球所有城市
代码 1
# 好的描述
name: get_weather
description: |
  查询指定城市的天气预报,支持未来 1-7 天。
  触发场景:用户问天气、温度、降雨概率、穿衣建议。
  不支持:历史天气、空气质量、紫外线指数。

# 差的描述(LLM 无法准确判断何时调用)
name: get_weather
description: 获取天气信息
3. 触发规则(trigger rules)
描述是"大致什么时候用",触发规则是"精确匹配条件"。常见写法:
triggers:
  -intent:weather_query          # 意图匹配
    keywords:[天气,温度,下雨,穿什么]
    required_slots:[city]          # 必须有城市参数才触发
-intent:travel_planning
    keywords:[出差,旅游,带伞]
    optional_slots:[date_range]
4. 入参槽位(parameter slots)
定义 Skill 需要从用户输入里提取哪些信息。每个槽位包含:
parameters:
  city:
    type:string
    description:城市名称,如"北京"、"上海"
    required:true
    extraction_rules:
      -entity_type:location
      -aliases:[帝都,魔都,深圳]
days:
    type:integer
    description:预报天数,1-7
    required:false
    default:3
    constraints:
      min:1
      max:7
5. 执行逻辑(execution logic)
实际的业务代码。这一层和普通函数没什么区别,关键是要做好参数校验和异常处理:
async def execute(city: str, days: int = 3) -> SkillResult:
    # 参数校验
    ifnot city or len(city) > 20:
        return SkillResult.error("城市名称不合法")
    if days < 1or days > 7:
        return SkillResult.error("预报天数必须在 1-7 之间")

    try:
        weather = await weather_api.fetch(city, days)
        return SkillResult.success(format_weather(weather))
    except CityNotFoundError:
        return SkillResult.error(f"未找到城市:{city}")
    except APIRateLimitError:
        return SkillResult.error("天气服务繁忙,请稍后重试")
6. 返回格式(return format)
统一的返回结构让 Agent 框架能标准化处理所有 Skill 的结果:
@dataclass
class SkillResult:
    status: str          # "success" | "error" | "partial"
    data: dict           # 结构化数据
    message: str         # 给 LLM 的自然语言摘要
    metadata: dict       # 耗时、来源、置信度等
7. 权限控制(permission control)
哪些场景下允许调用、哪些不允许:
permissions:
  rate_limit: 10/minute          # 频率限制
  auth_required: false            # 是否需要用户授权
  allowed_channels: [web, app]    # 允许的调用渠道
  data_retention: none            # 是否缓存结果
这一节的小结
7 个模块各司其职。其中 description 和 trigger rules 决定了"LLM 能不能准确找到它",parameter slots 决定了"找到之后能不能正确调用",execution logic 和 error handling 决定了"调用之后能不能可靠返回"。
03 手把手教你写第一个 Skill:语法、规范与参数校验
理论讲够了,直接上手。我们来写一个"商品价格查询" Skill,这是 Agent 系统里最常见的查询类场景。
Step 1:定义 Skill 元信息
name: query_product_price
version: "1.0.0"
description: |
  查询小米商城商品的实时价格。
  当用户问"多少钱"、"价格"、"便宜多少"、"有没有优惠"时触发。
  支持按商品名称、型号、SKU 查询。
  不支持:历史价格趋势、竞品比价。
author: xiting
tags: [ecommerce, price, xiaomi]
Step 2:定义参数槽位
parameters:
  product_name:
    type:string
    description:商品名称或型号,如"小米14"、"RedmiNote14Pro"
    required:true
    extraction_rules:
      -entity_type:product
      -fuzzy_match:true           # 允许模糊匹配
    validation:
      min_length:2
      max_length:50

platform:
    type:string
    description:查询平台
    required:false
    default:"xiaomi_mall"
    enum:[xiaomi_mall,jd,taobao]
Step 3:编写执行逻辑
from typing import Optional
from dataclasses import dataclass

@dataclass
class SkillResult:
    status: str
    data: dict
    message: str

asyncdef execute(product_name: str, platform: str = "xiaomi_mall") -> SkillResult:
    """查询商品价格 - 这是 Skill 的核心执行逻辑"""

    # 1. 参数校验(永远不要信任 LLM 提取的参数)
    ifnot product_name or len(product_name.strip()) < 2:
        return SkillResult(
            status="error",
            data={},
            message="商品名称太短,请提供更具体的商品名称或型号。"
        )

    # 2. 实体消歧(同一个商品可能有多种叫法)
    resolved = await resolve_product(product_name)
    ifnot resolved:
        return SkillResult(
            status="error",
            data={},
            message=f"未找到名为「{product_name}」的商品,请确认名称是否正确。"
        )

    # 3. 调用外部 API
    try:
        price_info = await price_api.query(
            sku=resolved.sku,
            platform=platform
        )
    except APITimeoutError:
        return SkillResult(
            status="error",
            data={},
            message="价格服务响应超时,请稍后重试。"
        )

    # 4. 格式化返回(给 LLM 看的自然语言摘要 + 给系统看的结构化数据)
    return SkillResult(
        status="success",
        data={
            "product_name": resolved.name,
            "sku": resolved.sku,
            "current_price": price_info.price,
            "original_price": price_info.original_price,
            "discount": price_info.discount,
            "platform": platform,
            "url": price_info.url
        },
        message=f"{resolved.name} 在{platform_name(platform)}的当前售价为 ¥{price_info.price}"
                f"(原价 ¥{price_info.original_price},{price_info.discount})。"
    )
Step 4:编写参数校验规则
参数校验是 Skill 稳定性的第一道防线。很多人的 Skill 在测试时没问题,一上用户环境就崩,80% 的原因是参数校验不够。
# 校验模式:先宽松匹配,再严格校验
def validate_params(raw_params: dict) -> tuple[bool, dict, str]:
    """
    三步校验法:
    1. 类型检查 - 是不是期望的数据类型
    2. 范围检查 - 值在不在合法范围内
    3. 语义检查 - 值有没有实际意义
    """

    errors = []

    # 类型检查
    product_name = raw_params.get("product_name")
    if product_name andnot isinstance(product_name, str):
        errors.append("product_name 必须是字符串")

    # 范围检查
    platform = raw_params.get("platform", "xiaomi_mall")
    valid_platforms = ["xiaomi_mall", "jd", "taobao"]
    if platform notin valid_platforms:
        errors.append(f"platform 必须是 {valid_platforms} 之一")

    # 语义检查(最容易被忽略)
    if product_name and len(product_name.strip()) < 2:
        errors.append("商品名称至少需要 2 个字符")

    if errors:
        returnFalse, {}, ";".join(errors)

    returnTrue, {"product_name": product_name.strip(), "platform": platform}, ""
这一节的小结
写 Skill 的执行逻辑不难,难的是"把各种异常情况都想到并处理好"。参数校验、实体消歧、超时处理、错误消息——这些看起来是细节,实际上决定了你的 Skill 在生产环境里能不能稳定工作。
04 Skill 调用全链路:从用户提问到结果返回,中间到底发生了什么
很多人写完 Skill 就以为完事了,但 Skill 只是整个调用链路中的一个环节。理解全链路,才能写出和系统其他部分配合得好的 Skill。
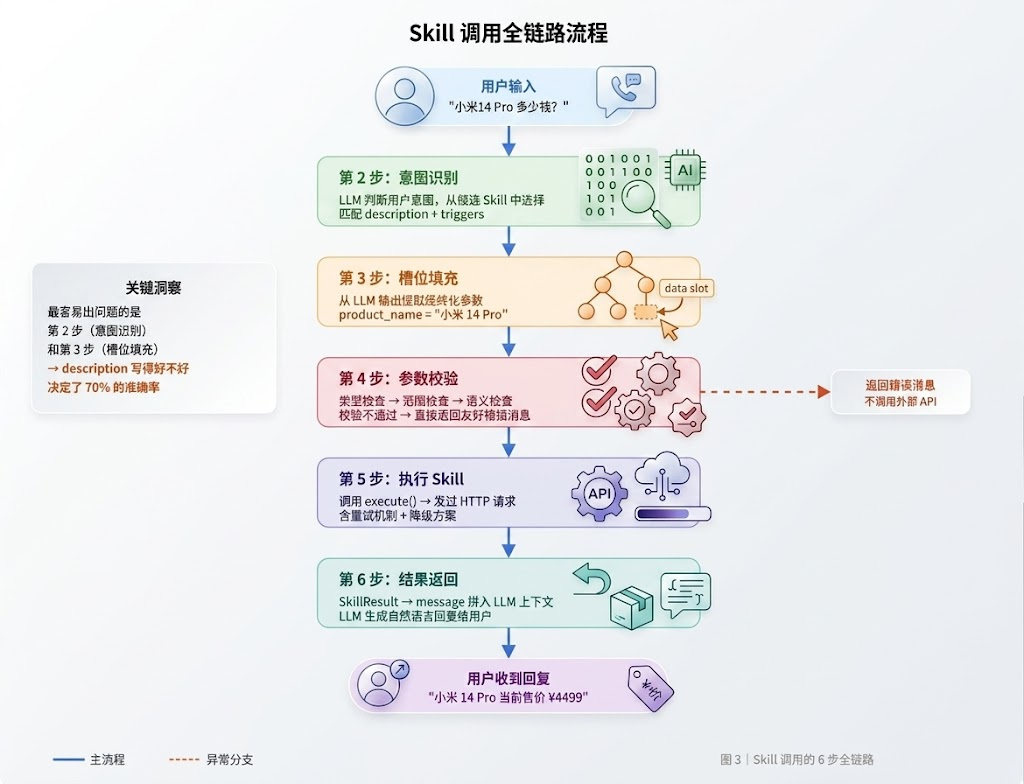
图 3|Skill 调用全链路流程
完整的调用流程分 6 步:
第 1 步:用户输入
用户说了一句话:"小米 14 Pro 现在多少钱?"
第 2 步:意图识别(Intent Recognition)
Agent 框架把用户输入发给 LLM,LLM 判断这句话的意图。这一步的核心是 prompt engineering:
你是一个意图分类器。根据用户输入,判断应该调用哪个工具。

可用工具:
1. query_product_price - 查询商品价格。当用户问"多少钱"、"价格"时使用。
2. get_weather - 查询天气。当用户问天气、温度时使用。
3. search_product - 搜索商品。当用户想找某个商品但没问价格时使用。

用户输入:小米 14 Pro 现在多少钱?
LLM 返回:应该调用 query_product_price,提取参数 product_name = "小米 14 Pro"。
第 3 步:槽位填充(Slot Filling)
框架从 LLM 的输出中提取结构化参数。这一步常见的坑:
-
LLM 提取了
product_name = "小米14Pro"(没有空格),但实际数据库里叫"小米 14 Pro" -
LLM 漏提了可选参数
platform,需要用默认值补上 -
LLM 多提了不存在的参数,需要过滤掉
第 4 步:参数校验
上一节讲的三步校验法在这里执行。校验不通过,直接返回友好的错误消息,不调用外部 API。
第 5 步:执行 Skill
调用 query_product_price.execute(),实际发起 HTTP 请求查询价格。
第 6 步:结果返回与格式化
Skill 返回结构化的 SkillResult,Agent 框架把 message 字段的内容拼进 LLM 的上下文,LLM 生成最终的自然语言回复给用户。
小米 14 Pro 在小米商城的当前售价为 ¥4499(原价 ¥4999,9 折)。
需要我帮你看看有没有其他优惠券吗?
关键洞察
整个链路里最容易出问题的不是执行逻辑,而是第 2 步和第 3 步——意图识别和槽位填充。而这两步的准确性,主要取决于你在 Skill 定义里写的 description 和 triggers。
这就是为什么我说"一个 Skill 的质量,70% 取决于描述"。
05 深入底层原理:Skill 注册机制、调度引擎与上下文透传
如果你想从"会写 Skill"进阶到"能设计 Skill 系统",这一节是核心。
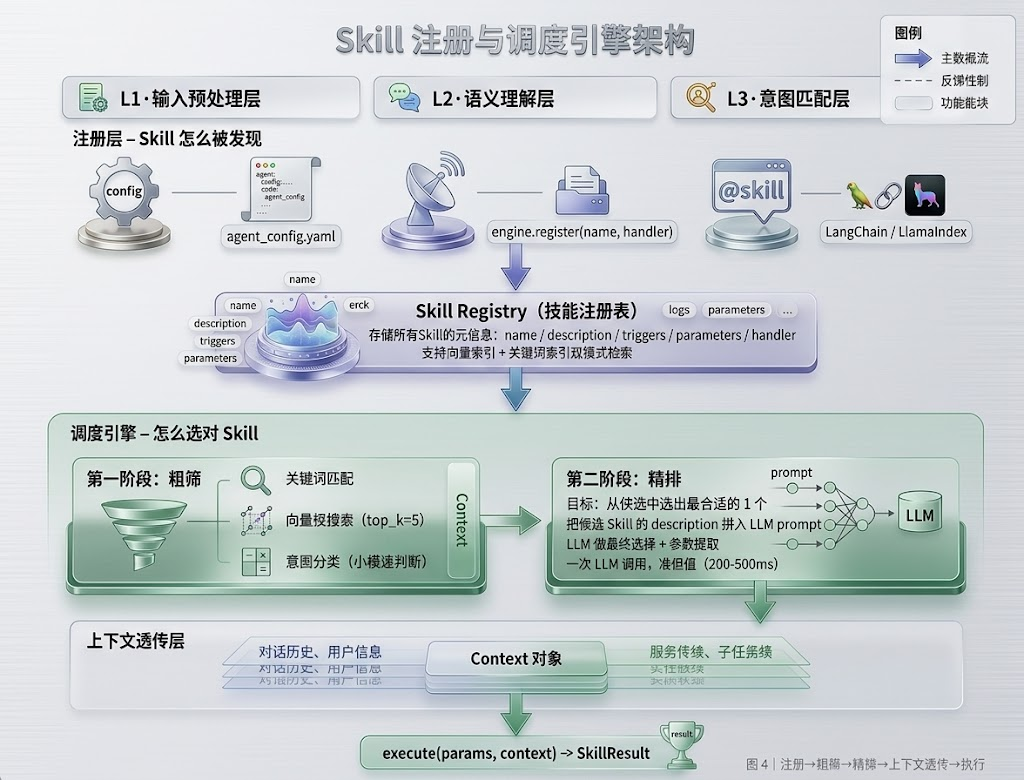
图 4|Skill 注册与调度引擎架构
5.1 Skill 注册机制
Skill 写好了,怎么让 Agent 框架知道它的存在?常见的注册方式有三种:
静态注册:在配置文件里声明所有 Skill,框架启动时一次性加载。
# agent_config.yaml
skills:
-name:query_product_price
    module:skills.price_query
    enabled:true
-name:get_weather
    module:skills.weather
    enabled:true
优点:简单、可控。缺点:新增 Skill 需要重启服务。
动态注册:Skill 在运行时主动向调度引擎注册自己。
# Skill 启动时
engine = SkillEngine.get_instance()
engine.register(
    name="query_product_price",
    description="查询商品价格...",
    handler=execute,
    triggers=["多少钱", "价格", "优惠"]
)
优点:热插拔,不用重启。缺点:需要处理注册冲突和去重。
声明式注册:Skill 通过装饰器或类继承自动注册,框架扫描特定目录下的所有 Skill 定义。
@skill(
    name="query_product_price",
    description="查询商品价格",
    triggers=["多少钱", "价格"]
)
class PriceQuerySkill(BaseSkill):
    async def execute(self, product_name: str, **kwargs) -> SkillResult:
        ...
这是目前主流 Agent 框架(LangChain、LlamaIndex、OpenCode 等)最常用的方式。
5.2 调度引擎怎么选择 Skill
当用户发了一句话,调度引擎需要从几十甚至几百个 Skill 里找到最合适的一个。这个过程通常是"两阶段匹配":
第一阶段:粗筛(Fast Filtering)
用关键词匹配、意图分类器或向量检索,从全量 Skill 里快速缩小候选范围。这一步要求快,通常在 10ms 内完成。
# 向量检索方式
user_embedding = embed(user_input)
candidates = skill_index.search(user_embedding, top_k=5)
第二阶段:精排(Precise Ranking)
把候选 Skill 的 description 拼进 LLM 的 system prompt,让 LLM 做最终选择。这一步准,但慢(需要一次 LLM 调用)。
你是工具选择器。以下是候选工具:

1. query_product_price:查询商品价格。当用户问"多少钱"、"价格"时使用。
2. search_product:搜索商品目录。当用户想找某个商品但没问价格时使用。
3. get_discount_info:查询优惠活动。当用户问"有没有优惠"、"打折吗"时使用。

用户说:小米 14 Pro 现在多少钱?
选择最合适的工具(只返回编号):
5.3 上下文透传
Skill 执行时,不是在一个真空环境里。它需要访问的上下文包括:
-
对话历史:用户之前说了什么(可能影响参数提取)
-
用户信息:用户 ID、会员等级、地区偏好
-
会话状态:之前调用过哪些 Skill、中间结果是什么
-
系统配置:超时时间、重试策略、降级方案
这些上下文通过 Context 对象透传给 Skill:
@dataclass
class SkillContext:
    user_id: str
    session_id: str
    conversation_history: list[Message]
    user_profile: dict
    system_config: dict
    intermediate_results: dict   # 前面 Skill 的执行结果

async def execute(params: dict, context: SkillContext) -> SkillResult:
    # 可以通过 context 获取用户所在城市,作为默认参数
    default_city = context.user_profile.get("city", "北京")
    ...
这一节的小结
注册机制决定了"Skill 怎么被发现",调度引擎决定了"怎么选对 Skill",上下文透传决定了"Skill 能不能拿到它需要的信息"。这三层共同构成了 Skill 系统的基础设施。
06 高阶进阶:多轮对话 Skill、嵌套 Skill、条件分支与异常兜底
基础 Skill 是单轮的——用户问一句,Skill 执行一次,返回结果。但真实场景往往更复杂。
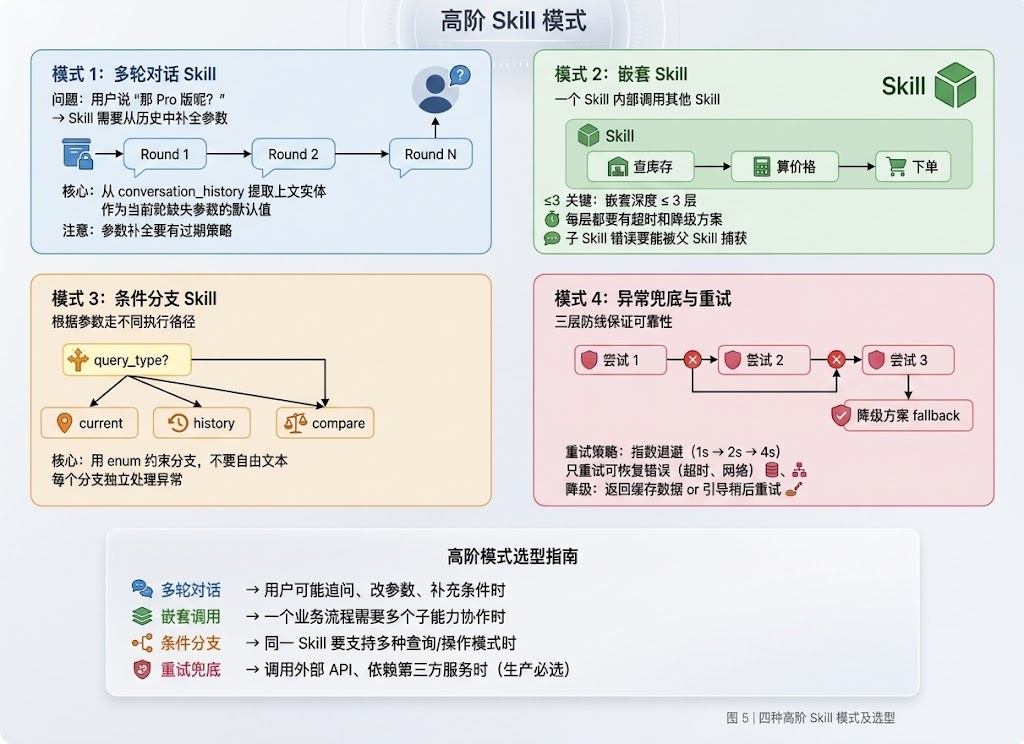
图 5|高阶 Skill 模式
6.1 多轮对话 Skill
用户说"帮我查一下小米 14 的价格",Skill 返回价格后,用户接着问"那 Pro 版呢?"——这时候 Skill 需要理解上下文,知道"Pro 版"指的是"小米 14 Pro"。
class PriceQuerySkill(BaseSkill):
    async def execute(self, params: dict, context: SkillContext) -> SkillResult:
        product_name = params.get("product_name")

        # 多轮对话:如果用户没给完整商品名,从历史里补全
        if not product_name or len(product_name) < 4:
            last_product = self._extract_last_product(context.conversation_history)
            if last_product:
                product_name = f"{last_product} {product_name}".strip()

        # 继续执行查询...
6.2 嵌套 Skill
一个 Skill 的执行过程中,需要调用另一个 Skill。比如"下单 Skill"内部需要调用"查库存 Skill"和"计算价格 Skill"。
class PlaceOrderSkill(BaseSkill):
    asyncdef execute(self, params: dict, context: SkillContext) -> SkillResult:
        # 嵌套调用:先查库存
        stock_result = await self.engine.invoke_skill(
            "check_stock",
            {"product_id": params["product_id"], "quantity": params["quantity"]},
            context
        )
        if stock_result.status == "error":
            return stock_result  # 库存不足,直接返回错误

        # 嵌套调用:计算价格
        price_result = await self.engine.invoke_skill(
            "calculate_price",
            {"product_id": params["product_id"], "coupon": params.get("coupon")},
            context
        )

        # 组合结果,执行下单逻辑
        ...
嵌套 Skill 的关键设计原则:
-
嵌套深度不超过 3 层,否则调试成本指数级上升
-
每个嵌套调用都要有超时和降级方案
-
子 Skill 的错误要能被父 Skill 捕获和处理
6.3 条件分支 Skill
同一个 Skill,根据参数不同走不同的执行路径。
async def execute(self, params: dict, context: SkillContext) -> SkillResult:
    query_type = params.get("query_type", "current")

    if query_type == "current":
        # 查当前价格
        returnawait self._query_current_price(params)
    elif query_type == "history":
        # 查历史价格(需要调不同的 API)
        returnawait self._query_price_history(params)
    elif query_type == "compare":
        # 多平台比价
        returnawait self._compare_prices(params)
    else:
        return SkillResult.error(f"不支持的查询类型:{query_type}")
6.4 异常兜底与重试机制
生产环境里,外部 API 超时、网络抖动、参数异常都是家常便饭。一个好的 Skill 必须有完善的异常处理:
class ResilientSkill(BaseSkill):
    MAX_RETRIES = 3
    RETRY_DELAY = 1.0# 秒

    asyncdef execute_with_retry(self, params: dict, context: SkillContext) -> SkillResult:
        last_error = None

        for attempt in range(self.MAX_RETRIES):
            try:
                result = await self.execute(params, context)
                if result.status != "error":
                    return result
                last_error = result.message
            except TimeoutError:
                last_error = "请求超时"
                await asyncio.sleep(self.RETRY_DELAY * (attempt + 1))  # 指数退避
            except ConnectionError:
                last_error = "网络连接失败"
                await asyncio.sleep(self.RETRY_DELAY * (attempt + 1))

        # 所有重试都失败,走降级方案
        returnawait self._fallback(params, context, last_error)

    asyncdef _fallback(self, params: dict, context: SkillContext, error: str) -> SkillResult:
        """降级方案:返回缓存数据或引导用户稍后重试"""
        cached = await self.cache.get(f"price:{params.get('product_name')}")
        if cached:
            return SkillResult(
                status="partial",
                data=cached,
                message=f"(数据可能不是最新的){cached['summary']}"
            )
        return SkillResult.error(f"服务暂时不可用:{error},请稍后重试。")
重试策略的核心原则:
-
用指数退避(1s, 2s, 4s),不要用固定间隔
-
设置最大重试次数,通常 3 次
-
最后一次失败后走降级方案,不要无限重试
-
只重试可恢复的错误(超时、网络),不重试参数错误
07 实战:从零完整手写 3 个 Skill
实战 1:查询类 Skill——飞书文档搜索
from dataclasses import dataclass, field

@dataclass
class SkillResult:
    status: str          # success / error / partial
    data: dict = field(default_factory=dict)
    message: str = ""

    @classmethod
    def success(cls, data: dict, message: str = ""):
        return cls(status="success", data=data, message=message)

    @classmethod
    def error(cls, message: str):
        return cls(status="error", data={}, message=message)


# Skill 定义
SKILL_DEFINITION = {
    "name": "search_feishu_doc",
    "description": """
        搜索飞书云文档。当用户说"找文档"、"搜一下"、"之前的文档"时触发。
        支持按关键词、作者、时间范围搜索。
        不支持:搜索聊天记录、搜索邮件。
    """,
    "parameters": {
        "keyword": {
            "type": "string",
            "description": "搜索关键词",
            "required": True
        },
        "owner": {
            "type": "string",
            "description": "文档作者,可选",
            "required": False
        },
        "time_range": {
            "type": "string",
            "description": "时间范围,如'最近一周'、'本月'",
            "required": False,
            "default": "最近一周"
        }
    }
}


asyncdef execute(keyword: str, owner: str = None, time_range: str = "最近一周",
                   context=None) -> SkillResult:
    """飞书文档搜索的执行逻辑"""

    # 参数校验
    ifnot keyword or len(keyword.strip()) < 2:
        return SkillResult.error("搜索关键词至少需要 2 个字符。")

    # 时间范围解析
    date_filter = parse_time_range(time_range)
    ifnot date_filter:
        return SkillResult.error(f"无法理解时间范围「{time_range}」,请用'最近一周'、'本月'等表述。")

    # 解析作者(如果有)
    owner_id = None
    if owner:
        owner_id = await resolve_user_id(owner)
        ifnot owner_id:
            return SkillResult.error(f"未找到名为「{owner}」的用户。")

    # 调用飞书 API
    try:
        results = await feishu_api.search_docs(
            keyword=keyword,
            owner_id=owner_id,
            start_time=date_filter["start"],
            end_time=date_filter["end"],
            page_size=10
        )
    except FeishuAPIError as e:
        return SkillResult.error(f"飞书接口异常:{e.message}")

    ifnot results:
        return SkillResult.success(
            data={"documents": [], "total": 0},
            message=f"未找到包含「{keyword}」的文档。"
        )

    # 格式化结果
    doc_list = [
        {
            "title": doc.title,
            "url": doc.url,
            "owner": doc.owner_name,
            "updated_at": doc.updated_at,
            "snippet": doc.snippet[:100]
        }
        for doc in results
    ]

    summary = f"找到 {len(doc_list)} 篇文档:\n"
    for i, doc in enumerate(doc_list[:5], 1):
        summary += f"{i}. {doc['title']}({doc['owner']},{doc['updated_at']})\n"

    return SkillResult.success(
        data={"documents": doc_list, "total": len(doc_list)},
        message=summary
    )
实战 2:计算类 Skill——折扣价格计算
SKILL_DEFINITION = {
    "name": "calculate_discount",
    "description": """
        计算商品的折扣后价格。当用户说"打折"、"优惠后多少"、"算一下折扣"时触发。
        支持百分比折扣、满减、多件折扣。
        不支持:跨商品组合优惠、会员积分抵扣。
    """,
    "parameters": {
        "original_price": {
            "type": "number",
            "description": "原价",
            "required": True,
            "validation": {"min": 0.01, "max": 999999}
        },
        "discount_type": {
            "type": "string",
            "description": "折扣类型",
            "required": True,
            "enum": ["percentage", "fixed_amount", "buy_more"]
        },
        "discount_value": {
            "type": "number",
            "description": "折扣值:百分比写 85 表示 85 折,满减写减免金额,多件写件数",
            "required": True
        },
        "quantity": {
            "type": "integer",
            "description": "购买数量,多件折扣时必填",
            "required": False,
            "default": 1
        }
    }
}


asyncdef execute(original_price: float, discount_type: str, discount_value: float,
                   quantity: int = 1, context=None) -> SkillResult:

    # 参数校验
    if original_price <= 0:
        return SkillResult.error("原价必须大于 0。")

    if discount_type == "percentage"and (discount_value <= 0or discount_value > 100):
        return SkillResult.error("百分比折扣必须在 0-100 之间。")

    if discount_type == "buy_more"and quantity < int(discount_value):
        return SkillResult.error(f"多件折扣需要购买至少 {int(discount_value)} 件。")

    # 计算逻辑
    if discount_type == "percentage":
        final_price = original_price * (discount_value / 100) * quantity
        saving = original_price * quantity - final_price
        detail = f"{discount_value / 10} 折"

    elif discount_type == "fixed_amount":
        if original_price < discount_value:
            return SkillResult.error("满减金额不能超过原价。")
        final_price = (original_price - discount_value) * quantity
        saving = discount_value * quantity
        detail = f"满 ¥{original_price} 减 ¥{discount_value}"

    elif discount_type == "buy_more":
        free_count = quantity // int(discount_value)
        pay_count = quantity - free_count
        final_price = original_price * pay_count
        saving = original_price * free_count
        detail = f"买 {int(discount_value)} 件减 1 件"

    else:
        return SkillResult.error(f"不支持的折扣类型:{discount_type}")

    return SkillResult.success(
        data={
            "original_price": original_price,
            "quantity": quantity,
            "discount_type": discount_type,
            "discount_detail": detail,
            "final_price": round(final_price, 2),
            "saving": round(saving, 2)
        },
        message=f"原价 ¥{original_price} × {quantity} 件 = ¥{original_price * quantity},"
                f"享受{detail}后实付 ¥{round(final_price, 2)},立省 ¥{round(saving, 2)}。"
    )
实战 3:工具调用类 Skill——数据库查询
SKILL_DEFINITION = {
    "name": "query_database",
    "description": """
        查询业务数据库中的数据。当用户说"查一下数据"、"跑个 SQL"、"看看有多少"时触发。
        只支持 SELECT 查询,不支持 INSERT/UPDATE/DELETE。
        自动限制返回行数为 1000 行。
    """,
    "parameters": {
        "sql": {
            "type": "string",
            "description": "SQL 查询语句,只支持 SELECT",
            "required": True
        },
        "database": {
            "type": "string",
            "description": "目标数据库",
            "required": False,
            "default": "analytics",
            "enum": ["analytics", "user_db", "order_db"]
        }
    }
}


# SQL 安全校验(关键!)
FORBIDDEN_KEYWORDS = ["INSERT", "UPDATE", "DELETE", "DROP", "ALTER", "TRUNCATE",
                       "CREATE", "GRANT", "REVOKE", "EXEC", "EXECUTE"]

asyncdef execute(sql: str, database: str = "analytics", context=None) -> SkillResult:
    """安全地执行 SQL 查询"""

    # 1. SQL 注入防护(第一优先级)
    sql_upper = sql.upper().strip()
    for keyword in FORBIDDEN_KEYWORDS:
        if keyword in sql_upper:
            return SkillResult.error(
                f"安全限制:不允许执行 {keyword} 操作。本 Skill 只支持 SELECT 查询。"
            )

    # 2. 必须以 SELECT 开头
    ifnot sql_upper.startswith("SELECT"):
        return SkillResult.error("SQL 必须以 SELECT 开头。")

    # 3. 自动添加 LIMIT(防止查询过大拖垮数据库)
    if"LIMIT"notin sql_upper:
        sql = sql.rstrip(";") + " LIMIT 1000;"

    # 4. 执行查询
    try:
        conn = await get_db_connection(database)
        result = await conn.execute(sql)
        rows = result.fetchall()
        columns = result.keys()
    except SQLError as e:
        return SkillResult.error(f"SQL 执行失败:{e.message}")
    finally:
        await conn.close()

    # 5. 格式化结果
    ifnot rows:
        return SkillResult.success(
            data={"columns": [], "rows": [], "row_count": 0},
            message="查询结果为空。"
        )

    data = {
        "columns": list(columns),
        "rows": [dict(zip(columns, row)) for row in rows[:100]],  # 前 100 行
        "row_count": len(rows),
        "truncated": len(rows) > 100
    }

    summary = f"查询返回 {len(rows)} 行数据"
    if data["truncated"]:
        summary += "(已截取前 100 行)"
    summary += "。"

    return SkillResult.success(data=data, message=summary)
实战小结
三个 Skill 代表了三种典型模式:
-
查询类:重点在参数校验和结果格式化
-
计算类:重点在业务逻辑分支和数值精度
-
工具调用类:重点在安全防护和资源管理
不管哪种模式,参数校验、异常处理、友好的错误消息都是必须的。
08 常见报错排查、性能优化与面试核心考点
8.1 常见报错与排查
|
现象 |
可能原因 |
排查方法 |
|---|---|---|
|
Skill 永远不被触发 |
description 写得太模糊 |
用 3 个不同的用户问法测试触发率 |
|
触发了但参数全错 |
参数描述和实际期望不匹配 |
检查 LLM 提取的原始参数 |
|
间歇性超时 |
外部 API 不稳定 |
加重试 + 降级方案 |
|
返回格式乱了 |
message 里混了 JSON 和自然语言 |
统一返回格式,结构化数据放 data |
|
多轮对话丢失上下文 |
没有从 conversation_history 补全参数 |
加上下文透传逻辑 |
8.2 性能优化
描述优化:description 不是越长越好。太长的描述会占用 LLM 的上下文窗口,反而降低匹配准确率。经验是 50-150 字。
粗筛优化:当 Skill 数量超过 50 个时,不能让 LLM 逐个判断。用向量检索做粗筛,把候选范围缩小到 5-10 个。
缓存策略:对于查询类 Skill,同样的参数短时间内返回缓存结果,避免重复调用外部 API。
from functools import lru_cache
from datetime import datetime, timedelta

class SkillCache:
    def __init__(self, ttl_seconds: int = 300):
        self._cache = {}
        self._ttl = ttl_seconds

    asyncdef get_or_execute(self, key: str, executor):
        now = datetime.now()
        if key in self._cache:
            result, cached_at = self._cache[key]
            if (now - cached_at).seconds < self._ttl:
                return result

        result = await executor()
        self._cache[key] = (result, now)
        return result
8.3 Skill 设计最佳实践
-
单一职责:一个 Skill 只做一件事。"查询价格"和"计算折扣"应该是两个 Skill。
-
描述精确:description 里要说清楚"能做什么"和"不能做什么"。
-
错误友好:错误消息要告诉用户下一步怎么做,不要只说"失败了"。
-
幂等设计:同一个 Skill 同样的参数调用两次,结果应该一样(查询类天然幂等,下单类需要特殊处理)。
-
可观测:每次调用都要记录日志,包括输入参数、执行耗时、返回状态。
8.4 面试核心考点
如果你在面试 Agent 相关岗位,这些 Skill 相关的问题大概率会被问到:
Q1:Skill 和普通函数有什么区别?
核心答:Skill 在普通函数之上加了语义描述层(description、triggers、slot definitions),让 LLM 能理解"什么时候该用这个函数"。普通函数是给程序员看的接口,Skill 是给 LLM 看的能力说明书。
Q2:怎么让 LLM 准确选择该调用哪个 Skill?
核心答:两阶段匹配——先用关键词/向量检索粗筛候选,再用 LLM 精排。关键是 description 要写得精确,既要说能力,也要说边界。
Q3:Skill 之间的依赖和冲突怎么处理?
核心答:依赖用嵌套调用解决,冲突用优先级机制解决。优先级可以基于 description 的语义相关度、Skill 的置信度评分、或显式的优先级配置。
Q4:怎么处理 Skill 执行失败?
核心答:三层防线——参数校验防第一层、重试机制防第二层、降级方案防第三层。关键是不要让一个 Skill 的失败拖垮整个 Agent。
Q5:Skill 数量多了以后性能怎么优化?
核心答:粗筛用向量检索(快),精排用 LLM(准),结果用缓存(省)。分层处理,别让 LLM 看所有 Skill。
决策帮助
如果你现在是刚接触 Agent 开发,先写 2-3 个单轮查询类 Skill,把 description 和参数校验写扎实
如果你已经在做多轮对话,重点投入在上下文透传和槽位补全逻辑上
如果你在设计Skill 系统,优先把注册机制和调度引擎做对,Skill 的代码反而是最简单的部分
如果你只能先做一步,先把 description 写好——这一个动作能解决 50% 的调用不准问题
参考链接
-
[OpenAI Function Calling 官方文档] :https://platform.openai.com/docs/guides/function-calling
-
[LangChain Tools 文档] :https://python.langchain.com/docs/modules/tools/
-
[Anthropic Tool Use 文档] :https://docs.anthropic.com/en/docs/build-with-claude/tool-use)


 扫一扫


 201

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


