


1、为什么图表层值得单独写一篇
多数技术文章会把"图表"当成 UI 附属品,一笔带过。但在期货量化里,图表是策略的第一现场,也是排查问题的第一性工具。回测报告告诉你"年化 24%、最大回撤 11%",但它不会告诉你那 11% 的回撤发生在哪三天、是因为连续三次假突破,还是因为一次换月跳空。只有把信号画在 K 线上,你才能看到策略真实的决策纹理。
期魔方把指标系统做成基于 Python,而不是另一门封闭脚本语言,这个选择的长期价值常被低估:它意味着指标不再是"画图的装饰",而是可以和 pandas、TA-Lib、sklearn 同处一个命名空间的可计算对象。你可以写一个指标,既用于绘图,又用于策略信号,还用于事后归因分析,三处共用同一份代码,彻底消除"图上画的和实际用的不一致"这类隐蔽 bug。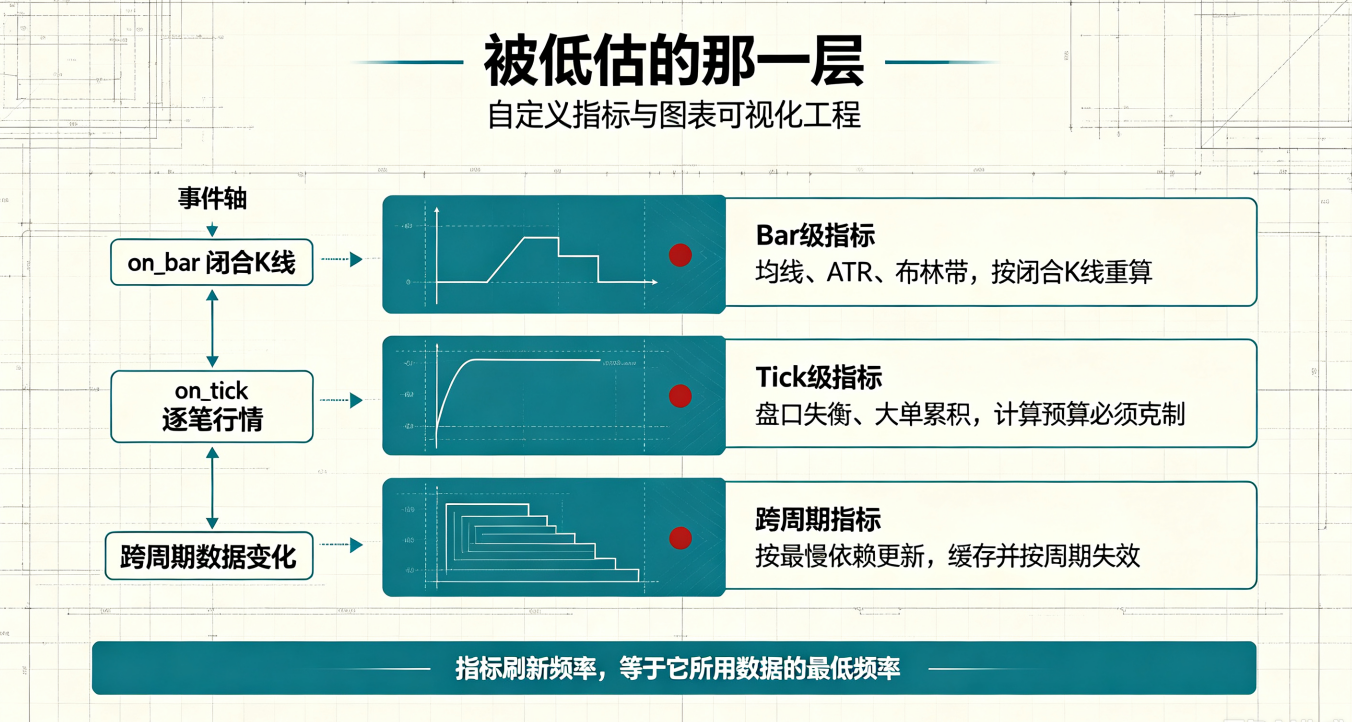
2、 指标的生命周期:先想清楚它什么时候该重算
写自定义指标之前,必须先回答一个问题:这个指标在什么事件上刷新?
Bar 级指标(均线、ATR、布林带等):只在 on_bar 或图表每新增一根闭合 K 线时重算。这是绝大多数指标的合理形态,计算量与 K 线数量线性相关。
Tick 级指标(盘口失衡、逐笔大单累积、持仓量瞬时变化率):每个 Tick 都要更新,计算预算必须严格控制。任何涉及排序、回归、全序列遍历的操作都不应放在 Tick 路径上。
跨周期指标(在 5 分钟图上画日线级别的均线):只在底层数据变化时更新,且要注意"上层周期未闭合"带来的重绘问题。
一个实用的纪律是:让指标的刷新频率等于它所用数据的最低频率。在 15 分钟策略里用日线因子,该因子就不应该每根 15 分钟 K 线都重新计算一遍,而应该缓存并按日线节奏失效。这种"按最慢依赖更新"的原则,是多周期指标性能优化的核心。
3、序列对齐:自定义指标最容易出错的环节
用 Python 写指标时,最典型的事故是长度不对齐导致的静默错位。get_kline 返回的序列长度可能短于请求值(上市初期、数据未下全、网络中断),而 TA-Lib 的多数函数会在头部产出 nan。如果你直接取 [-1] 并参与后续运算,nan 会沿着整条计算链向下传播,最终表现为"图上一段空白、策略那段没交易"——没有报错,极难定位。
规范写法应当包含三层防御:
1.长度守卫:入口处判断 len(close) < required,不足则返回空或延续上一值;
2.显式填充策略:明确选择向前填充、置零还是中断输出,并在文档字符串里写明,不要依赖库的默认行为;
3.有效值校验:在参与逻辑判断前,用 np.isfinite 做一次兜底检查。
另外要注意索引语义的一致性。如果策略里的指标取 [-2](上一根已闭合 bar),那么同名绘图指标也必须取 [-2]。曾经有团队出现过"图上信号完美、实盘一塌糊涂"的情况,排查半天发现是绘图用了 [-1](含未闭合 bar),产生了视觉上的重绘。图和代码必须同源同偏移,这条规矩值得写进团队的代码审查清单。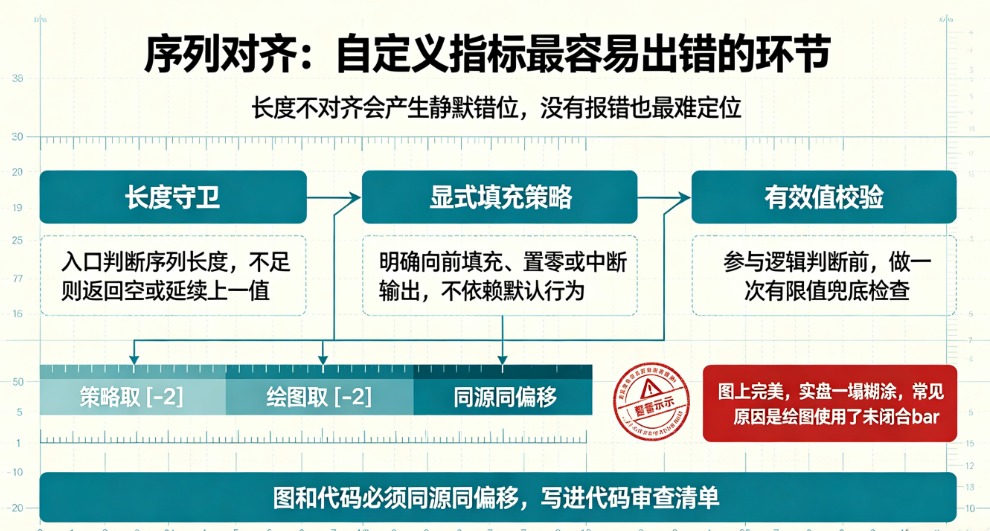
4、分层绘制:让一张图承载更多信息
期魔方的图表支持自定义样式与多面板布局,合理利用这一层可以大幅降低认知负荷。比较有效的分层方式是:
主图:只放价格与直接指导开平仓的要素——入场线、止损线、通道边界。颜色要克制,入场用一种色、止损用一种色,全局统一。
副图面板一:放趋势类辅助指标(均线组、MACD),用于判断当前处于趋势段还是震荡段。
副图面板二:放量价与情绪类指标(成交量比、持仓量变化、大单净量),用于过滤信号质量。
标注层:买卖点箭头、平仓原因文字(止损止盈/时间退出/反向信号)、当日盈亏标记。
最后一层尤其重要。给每一笔平仓打上"退出原因"标签,复盘时你就能直接回答"我的策略到底是输在进场太早,还是输在不该过早离场"。这种归因能力,比多试十个参数有价值得多。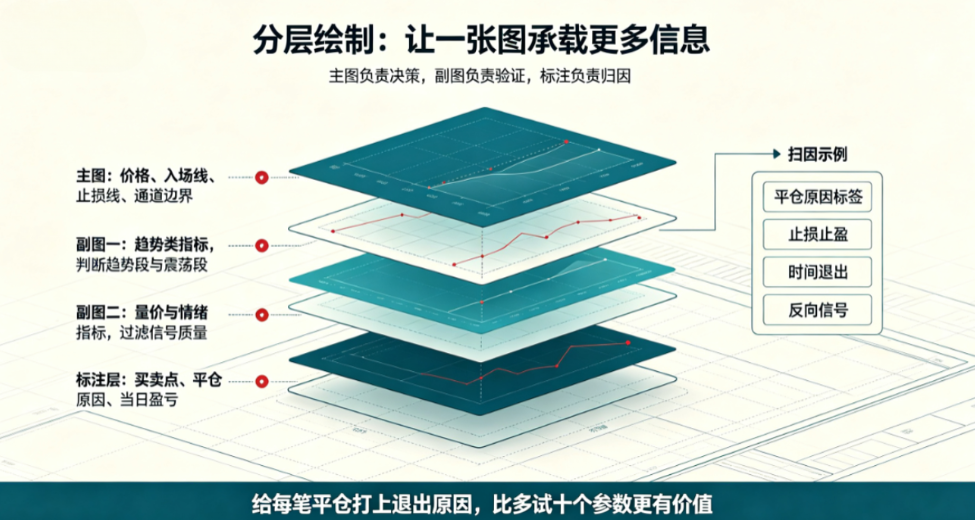
5、从麦语言迁移:一条现实可行的过渡路径
很多交易者手上已经有一批文华或博弈大师风格的指标公式。期魔方支持将这类麦语言指标转码后用于智能预警,这是一条阻力最小的过渡路径:先不动你的分析习惯,把"盯盘"这一步自动化掉。
具体做法是,把原有公式里用于触发提醒的条件抽出来,转成 Python 指标,绑定到预警引擎,设置成微信或弹窗推送。这样你仍然自己做决策,但不再需要死盯盘面。跑通这套流程后,再逐步把触发条件改写成可回测的形式,最终接入自动下单。三步走的好处是,每一步都能独立验证,出错时能立刻定位是哪一环的问题。
迁移时有两个坑要避开:一是麦语言里部分函数自带"未来引用"语义(例如某些跨周期引用写法),转码后要主动核对取值偏移;二是两类语言的除零、空值处理方式不同,转码后首尾若干根 bar 的值要做数值比对,不能只看图形像不像。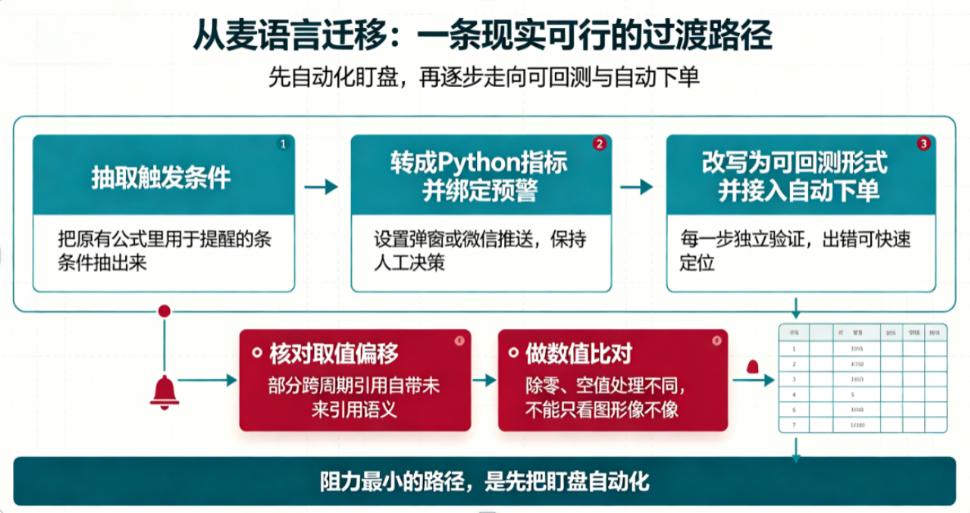
6、性能预算:图表不是免费午餐
需要清醒认识的是,自定义指标和图表渲染是要消耗资源的,而且它与行情接收、策略执行、日志写入同属一个客户端进程。几个实测中容易超支的地方:
在高频回调里做绘图调用。绘图应当按 bar 聚合,不要按 tick 触发。
每次重绘都全量重算长序列。能用增量更新的就用增量(例如 EMA、累计量),必须全量算的就加缓存,且缓存失效条件要写得足够窄。
同时开太多品种和太多周期。多品种 × 多周期 × 多指标的组合是乘法关系,内存和 CPU 开销会快速膨胀。建议给每台机器设一个"品种数 × 指标数"的上限,并在任务面板里分批启动。
在指标里做 IO 或网络请求。任何外部调用都应移到独立的定时任务或线程中,指标层只读结果。
一个简单的自测方法:打开任务管理器,让客户端空跑一个完整的夜盘,观察内存是否单调增长。如果出现持续爬升,基本可以判定存在缓存未释放或绘图对象累积的问题。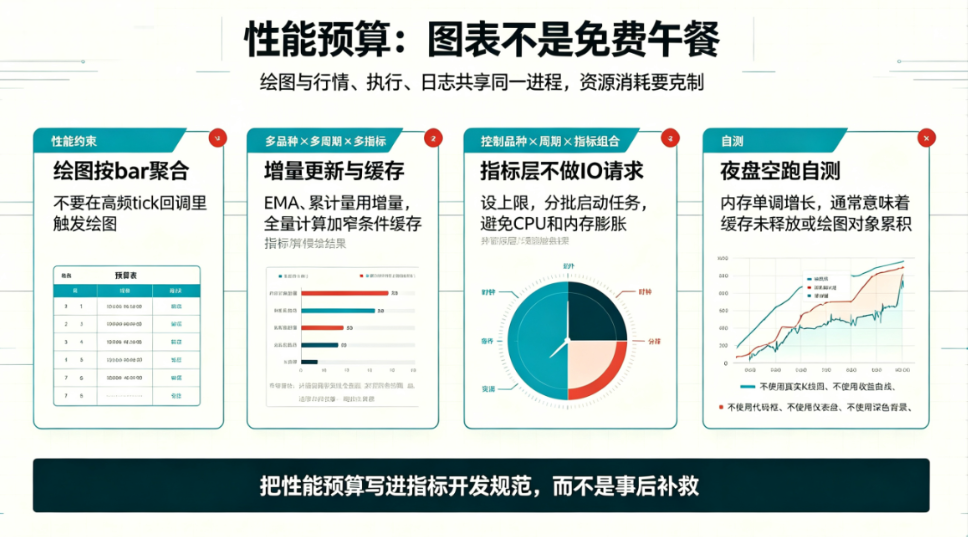
7、可视化层的验收清单
一个新写的指标上线前,建议过一遍这七项:
1.与官方或权威实现做数值比对(至少比对三个品种、三段行情、两种周期);
2.故意喂入短序列、全 nan 序列、含涨停板的序列,确认不崩溃且行为可解释;
3.确认绘图偏移与策略取值偏移完全一致;
4.确认未闭合 bar 不会改变已画出的历史信号(无重绘);
5.换月日前后各取一段,确认跳空不会造成指标失真或误触发;
6.压测:把品种数和周期数翻倍,确认 CPU 与内存仍在安全区间;
7.把指标输出导出成序列,与策略实际使用的序列做逐点 assert 相等。
第 7 条看起来有点偏执,但它是唯一能证明"图上所见即策略所用"的方法。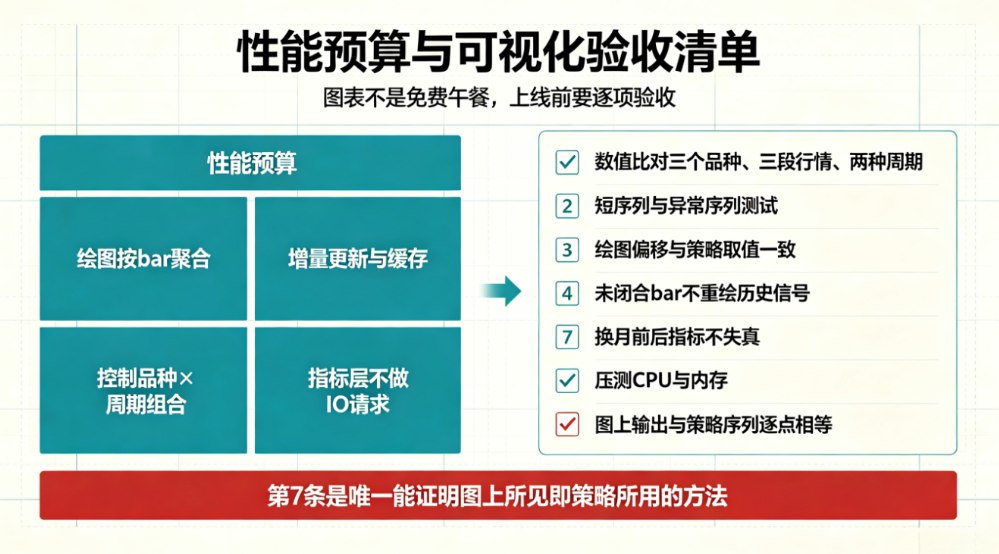
小结:
图表层的工程意义在于把不可见的决策过程变成可见的证据链。期魔方允许你用 Python 写指标、在同一张图上叠加信号与标注、并把同一份代码复用于预警和策略,这套能力如果用得克制而规范,会是提升投研效率最划算的一笔投入。反之,如果把它当成随意涂鸦的画布,它就会成为你最大的性能负担和最隐蔽的错误来源。


 扫一扫


 477

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


