魔改离线VLLM

Video-LLM:根据视频进行实时互动的创新模型(包含论文代码详解) VideoLLM-online,这是一个突破性的模型,它通过实时处理视频流并进行交互式对话,为流媒体视频交互带来了革命性的进步。这个模型不仅能够理解视频中的视觉内容,还能够在视频播放的同时提供实时的语言反馈,这为后续实现人工智能助手提供了无限可能 阅读详情

----->更多内容,请移步“鲁班秘笈”!!<-----

通过内存缓冲+轮次压缩解决上下文记忆和效率矛盾,通过外部激活模型实现主动性,是StreamBridge 的关键创新点

传统的视频大语言模型 (Video-LLM)通常一次性处理整个视频,对实时输入支持不足。然而在机器人、无人驾驶等应用中,需要模型具有因果感知和动态反应能力,即能够在视频流不断到来时及时理解新内容并主动输出。

StreamBridge提出了一个简单有效的框架,将现有的离线Video-LLM缝升级为可处理流式视频的系统。它针对流式场景中的两大核心挑战:(1) 多轮实时理解:模型需要持续跟踪最近视频帧,同时结合历史上下文多轮交互;(2) 主动响应生成:模型应当主动监控视频流,在关键时刻生成回应,而不必等待用户明确提问。
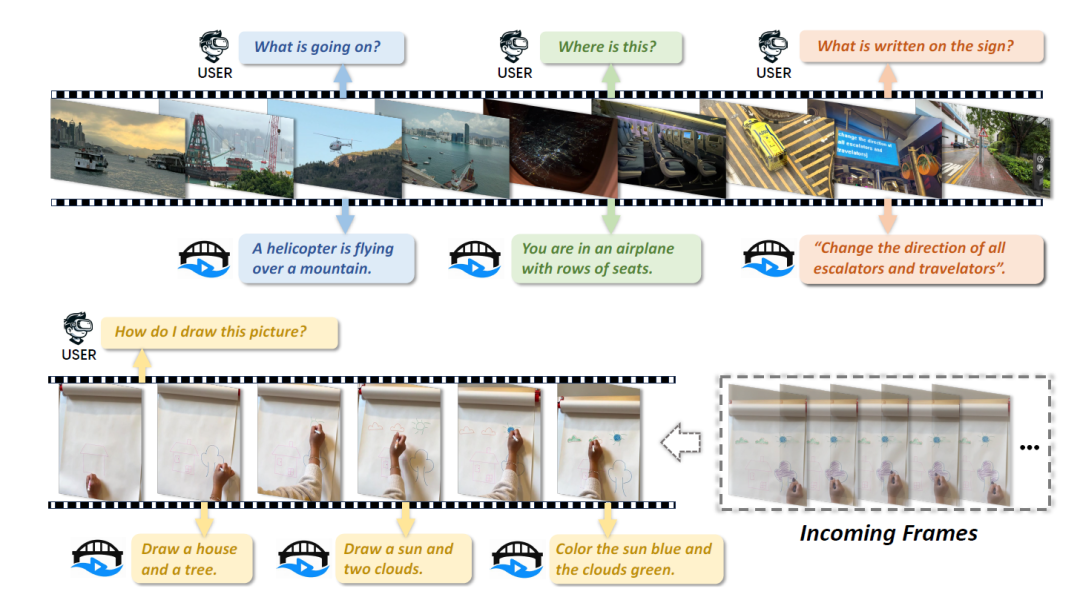
上图为流式视频理解场景示例。上面的部分为多轮交互模式,用户在不同时间点提问;下面展示了主动响应模式,模型根据视频内容主动输出。在上方示例中,用户在视频播放过程中多次提问,每轮关注最近的视频段并结合历史信息进行回答;在下方示例中,助手无需提示,通过绘画过程的展开主动输出指导性反馈。
三大配方

StreamBridge旨在弥合离线与流式之间的鸿沟,使预训练视频模型在上述场景中表现出色。StreamBridge 框架与关键技术: 为实现流式理解,StreamBridge在已有Video-LLM基础上引入了三大组件:
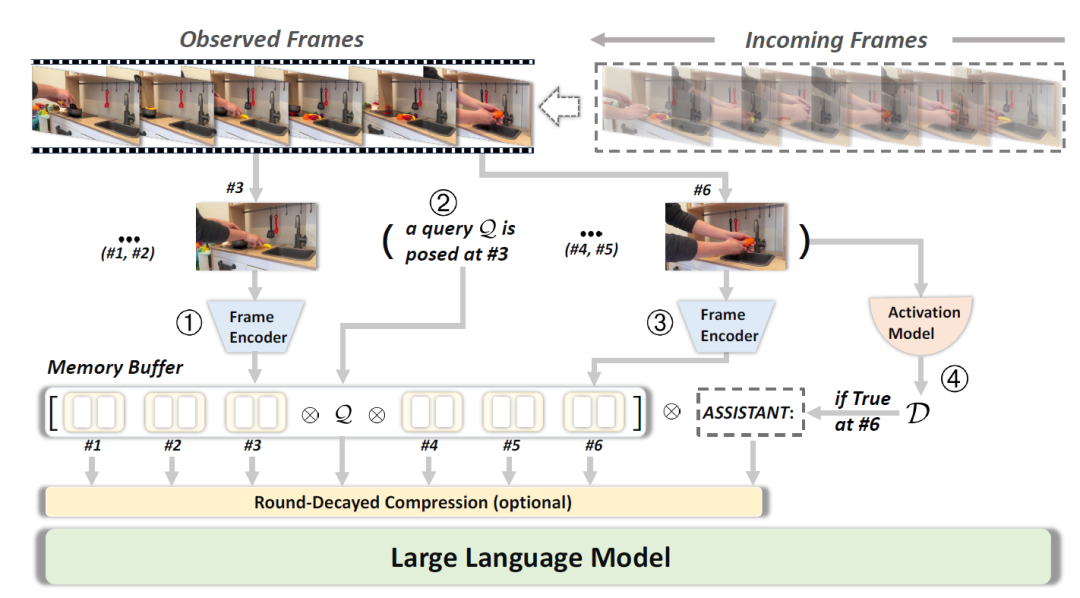
1)内存缓冲 (Memory Buffer): 对每一帧图像,系统首先通过视觉编码器提取嵌入向量,并连同任何生成的文本嵌入向量存入内存缓冲区。当收到用户查询Q且激活模型 (Activation Model)发出明确的触发信号D时,缓冲区中的视觉和文本嵌入被展开成序列输入LLM生成回答。生成的回答R也会追加到缓冲区,以保留完整的多轮交互历史。这样,StreamBridge能够累积上下文,不断扩展对话历史而不丢失前文信息。

2)轮次衰减压缩 (Round-Decayed Compression):

 随着视频流时间增长,缓冲区内嵌入序列长度会不断增加。为避免过长输入带来的计算和延迟问题,StreamBridge 设计了轮次衰减压缩策略。具体来说,系统预设最大允许长度MaxLen,若当前输入超过该阈值,则从最早的对话轮开始,对视觉嵌入逐帧进行平均池化合并,直至序列长度在MaxLen之内。这一策略能减少传递给LLM的信息量,同时保留了与当前回答最相关的近期视觉上下文。

3)激活模型 (Activation Model):
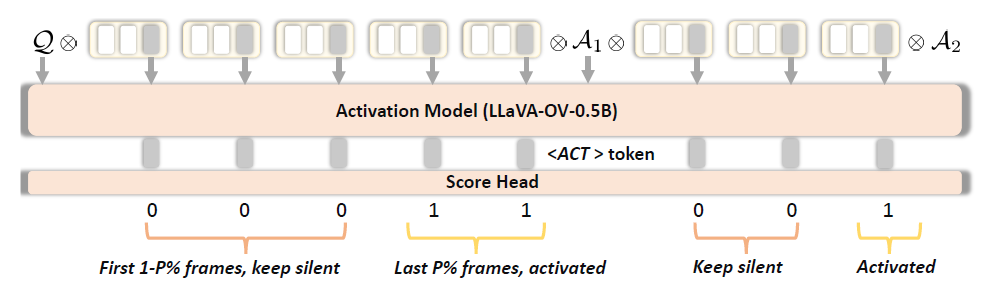
为了实现主动响应,StreamBridge引入了一个解耦的、轻量级的激活子模型。该激活模型本质上是一个独立的小型多模态LLM,它在每个时间步依据当前帧(及可选的查询Q)预测是否需要触发主模型输出。具体地,在训练时向每帧视觉嵌入添加可学习的激活标记,并将该帧的最新激活标记输入激活模型的二分类头预测响应概率。若预测分数超过阈值alpha,则激活信号D为真,主Video-LLM将基于缓冲区内容生成回答。通过这一机制,StreamBridge可以及时响应关键信号,在无需明确提问的情况下主动输出结果,从而体现出类似人类的主动行为。

StreamBridge的本次研究的核心贡献在于一方面它给出了一个通用的解决方案,将任何预训练的离线Video-LLM快速适配到流式理解场景,无需全盘重训,仅需额外添加上述轻量组件即可。原模型的离线视频理解能力得到保留,且同时具备了多轮交互和主动输出的能力。

另一方面,StreamBridge组建了一个大规模流式视频理解数据集Stream-IT。该数据集重新整理了多种公开数据(如密集视频字幕、序列步骤识别、带时标的VideoQA等),并生成了跨越长视频的流水式问答对,涵盖多样的任务类型与指令格式,为流式Video-LLM的训练和评测提供了重要资源。
性能评估

StreamBridge设计中针对延迟和长期记忆做了多项优化。内存缓冲机制确保多轮交互中的历史上下文不丢失,而轮次衰减压缩则在保证近期上下文信息的同时削减不必要的旧帧细节,从而减轻每次推理时的信息量。这些措施联合降低了单步推理的计算延迟。另一方面,激活模型的引入使系统无需对每帧都进行完整推理,而是只在检测到关键帧时才触发模型响应。这意味着系统可以在后台持续观察视频,当有重要视觉变化或用户关注点时才即时输出,避免了不必要的重复计算。综上,StreamBridge通过内存管理和智能触发策略,在流水线处理和时延控制方面取得了良好的平衡。
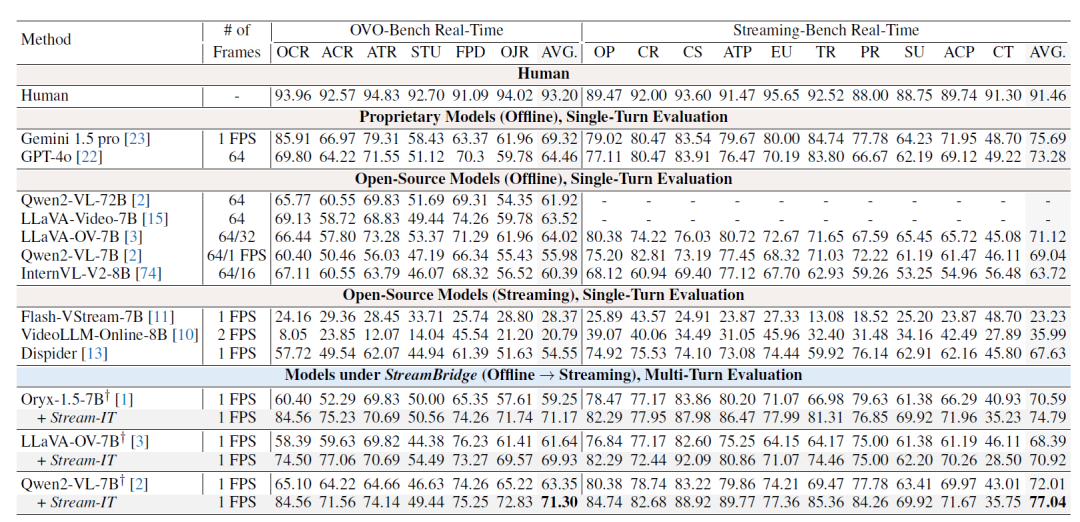
实验设置与对比分析: 为评估StreamBridge的效果,在多个任务和基准上进行了测试。实验中使用了主流Video-LLM模型(如LLaVA-OV-7B、Qwen2-VL-7B、Oryx-1.5-7B),并在构建的Stream-IT数据集(约60万条示例)上进行了微调,增强模型的流式理解能力。测试基准包括多轮实时理解任务(如OVO-Bench、Streaming-Bench)和常规模态视频理解基准(如MVBENCH、VideoQA等)。

结果表明,采用StreamBridge后,各模型在流式任务上表现显著提升:例如,Qwen2-VL模型在OVO-Bench上的平均得分由约55.98提高到63.35,在Streaming-Bench上由69.04提高到72.01。进一步对模型进行Stream-IT数据集微调后,Qwen2-VL分别达到了71.30和77.04,甚至超过了GPT-4o和Gemini 1.5 Pro;Oryx-1.5模型在OVO-Bench上提高了11.92分,Streaming-Bench上提高了4.2分。

StreamBridge 框架为视频多模态大模型的实时应用提供了一种通用可行的解决方案。通过内存缓冲、动态压缩和激活模型三者协同,离线训练的Video-LLM成功具备了实时多轮交互和主动响应的能力。实验验证了其在流式视频理解中的有效性和通用性。
vLLM官方中文教程:使用vLLM的两种方式(离线推理和vllm server) 本文介绍了使用vllm推理框架的两种方式,离线推理和vllm server 阅读详情

相关推荐

开源模型应用落地-Qwen2.5-7B-Instruct与vllm实现离线推理-CPU版本

使用CPU将Qwen2.5-7B-Instruct模型与vLLM框架进行有效整合(使用vLLM框架,能为模型推理提供强有力的支持,使得在CPU上执行的模型不仅能保持较高的准确率,还能在资源有限的条件下,实现快速响应,充分释放潜在价值)

以微薄之力,予他人些许温暖. 2万+

探索视频理解新时代:VideoLLM

探索视频理解新时代:VideoLLM 随着视频数据的爆炸式增长,对自动化视频内容分析和理解的需求日益迫切。传统的视频理解模型往往针对特定任务,缺乏处理多样化任务的能力。然而,大型语言模型(LLMs)在自然语言处理中的成功展示出其在序列因果推理方面的强大潜力。正是基于这一洞察,我们引入了一个创新框架——VideoLLM,它将NLP领域的LLMs的强大功能扩展到视频序列理解。 项目介绍 VideoLL...

gitblog_00078的博客 737

Docker+vLLM内网离线部署Qwen3 流程

本文介绍了在CentOS 7系统下进行VLLM容器化部署Qwen3-32B大模型的内网离线方案。首先需准备Nvidia显卡驱动、CUDA 12.4和Docker环境。通过联网机器拉取vllm/vllm-openai镜像并导入内网服务器,同时从魔塔社区下载模型文件。部署时使用docker run命令启动容器,配置了GPU资源、内存共享、端口映射等参数,特别指定了模型路径、并行计算、内存利用率等关键参数。该方案实现了大模型在内网环境的安全高效部署,适用于需要离线运行的AI推理场景。

qq_42881308的博客 1033

开源项目VideoLLM常见问题解决方案

开源项目VideoLLM常见问题解决方案 项目基础介绍 VideoLLM是一个基于大型语言模型(LLM)的视频序列理解框架。该框架利用预训练的语言模型在自然语言处理(NLP)中的序列推理能力,通过精心设计的模态编码器(Modality Encoder)和语义转换器(Semantic Translator),将来自不同模态的输入转换为统一的令牌序列。然后,这个令牌序列被送入一个纯解码器LLM中。通过...

gitblog_00671的博客 625

离线环境下vLLM大模型部署实战与优化指南

大语言模型部署在离线环境中面临诸多挑战,尤其是依赖网络连接的框架如vLLM。离线部署的核心在于解决依赖管理和环境配置问题。通过提前下载Python、CUDA Toolkit、cuDNN等关键组件,并利用pip download命令获取所有依赖项的wheel文件,可以构建完整的离线安装包。在硬件选择上,需根据模型尺寸匹配显存需求,例如7B模型至少需要16GB显存,而70B模型则需要多卡并行。部署过程中,GGUF量化格式能有效节省显存,而PagedAttention技术则能进一步提升显存利用率。对于金融、军工等

weixin_33525298的博客 340

VLLM专题(十八)—离线推理

你可以在自己的代码中使用 vLLM 对一组提示(prompts)进行推理。离线 API 基于LLM类。要初始化 vLLM 引擎,需要创建一个LLM的新实例,并指定要运行的模型。例如,以下代码从 HuggingFace 下载在初始化LLM实例后,您可以使用多种 API 执行模型推理。有关每个 API 的更多详细信息,请参考上述页面。

523

视频理解新纪元:VideoLLM深度解析与应用探索

视频理解新纪元:VideoLLM深度解析与应用探索 在我们这个视频数据爆炸的时代,如何高效自动化地分析和理解视频内容成为了一个迫切的需求。然而,传统的视频理解模型常常针对特定任务进行设计,缺乏处理多样化任务的全面能力。正当此时,一个革命性的框架应运而生——VideoLLM,它将大型语言模型的成功经验引入视频序列的理解之中,开启了视频分析的新篇章。 项目介绍 VideoLLM,正如其名,是一个借助自...

gitblog_00858的博客 922

逆向工程实战:如何用Frida和IDA破解AppleAccount的X-MMe-Nas-Qualify签名机制

本文通过逆向工程实战,详细解析了如何利用Frida动态Hook和IDA静态分析技术,破解AppleAccount服务中关键的X-MMe-Nas-Qualify签名机制。文章从环境搭建、动态追踪NSMutableURLRequest的签名注入点开始,逐步深入到AuthKit框架的静态剖析与算法还原,最终实现独立的签名生成,为安全研究和自动化测试提供了完整的技术路径。

bush的博客 691

VideoLLM:基于大型语言模型的视频序列建模

VideoLLM:基于大型语言模型的视频序列建模 VideoLLM 是一个开源项目,旨在利用自然语言处理(NLP)中预训练的大型语言模型(LLMs)的序列推理能力,进行视频序列的理解。该项目主要使用 Python 编程语言进行开发。 项目基础介绍 VideoLLM 项目提出了一种名为 VideoLLM 的框架,该框架通过一个精心设计的模态编码器(Modality Encoder)和语义翻译器(Se...

gitblog_00409的博客 474

设计一个订单管理系统(OMS)系统100问?

一个完善的订单管理系统不仅仅是简单地记录和处理订单信息,更需要考虑到订单的全生命周期管理,包括订单的创建、支付、配送、售后等环节。这100个问题围绕订单管理系统(OMS)的各个方面展开,涵盖了系统的功能、架构、安全性、异常处理、订单处理流程、支付、库存管理、客户管理、报表与分析等多个方面。通过这些问题,可以全面考虑订单管理系统在设计与实现过程中需要考虑的各种因素,从而确保系统能够满足业务需求、具有良好的性能和稳定性,同时易于扩展、维护和管理。

nbsaas-boot基于Request-Response的企业级快速开发框架 1380

ATE自动化测试设备:硬件与软件的完美协同

本文深入解析了ATE自动化测试设备如何通过硬件与软件的完美协同,实现高效、精准的电子产品测试。文章详细阐述了ATE系统的硬件架构(如测试控制器、仪器模块、开关矩阵)与软件层次(如测试管理、仪器控制、数据分析),并结合实战案例,揭示了软硬件协同设计在提升测试效率与可靠性中的关键作用。

weixin_29218509的博客 160

Copilot 能彻底换成本地模型吗?2026 最新可行方案、限制与落地指南

随着GitHub Copilot涨价和隐私争议加剧,开发者寻求本地化替代方案。官方Copilot无法完全离线运行,但可通过三种方案实现本地AI编程:Ollama+Continue(新手首选,8G显存即可);2vLLM+LocalAI(高性能,适合团队);localCopilot(保留原版UI)。本地方案优势包括数据隐私、无订阅费用、离线可用及高定制性,但超大项目理解稍弱。硬件门槛低(8G显存可流畅运行),模型推荐Qwen/DeepSeek等。结论:注重隐私或预算有限的开发者可完全切换,大型项目建议混合使用。

yu808454的博客 697

别再为通讯发愁了!手把手教你用PCAN-View调试Kinco步科伺服电机的CANopen

本文详细介绍了如何使用PCAN-View工具调试Kinco步科伺服电机的CANopen通讯,从环境搭建到实战演练,涵盖硬件连接、软件配置及故障排除。通过具体案例和代码示例,帮助工程师快速掌握伺服电机通讯控制技术,解决工业设备通讯难题。

weixin_29189377的博客 264

vllm 离线源码安装

在完全离线的环境中从源码安装 vLLM,核心思路是在一台联网机器上准备好所有材料(源码 + 依赖包),然后转移到目标机器上进行编译和安装。整个过程可以分为两个阶段。

larance的挨踢生活 1303

仅使用 Python 创建的 Web 应用程序(前端版本)第03章Streamlit-多页面

接下来,我们将解释多页面切换。Streamlit 没有“多页面”或“页面路由”等功能。另一方面,通过根据用户动作切换要执行的功能,可以使其看起来好像存在“多个页面”。注意:我认为它类似于 SinglePageApplication (SPA)。然而,根据 React、Vue 等中使用的 URL 路径来更改页面的路由很困难。还有一个用于获取查询参数的实验性 API,但如果您确实需要这种功能,我认为认真尝试编写 React 或 Vue 是个好主意。我们来看一个通过按下按钮来切换页面的示例,如下所示。

xianyinsuifeng的博客 1324

用 Message Monitoring Overview 打造接口健康驾驶舱:SAP AIF 消息监控实战解析

究竟解决了什么痛点?概括起来,这个应用把SAP AIF的接口监控,从传统的事务码和技术视角,带到了一个更加直观、业务友好的层次:(通过卡片式总览,让你在一个页面上看到所有自己负责的接口及其健康状况。通过和的联动,实现了从接口态势到具体消息的快速钻取。通过Recipient模型和应用,实现了监控职责的灵活分配。借助拖拽排序、搜索过滤等特性,让每个运维人员都可以打造属于自己的接口健康 cockpit。如果你正在做S/4HANA或项目,无论是公有云还是本地部署,只要系统启用了SAP AIF。

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 99

vLLM-benchmarks本地离线测试

本文详细记录了在NVIDIA H200 Tensor Core GPU服务器上离线部署DeepSeek-R1-0528(671B)大语言模型的完整流程。采用vLLM推理框架,通过8张H200显卡(140G显存/张)实现多卡并行,配置了FP8量化和前缀缓存优化。部署过程包括Docker环境搭建、vLLM容器启动、离线缓存配置以及Conda基准测试环境准备。测试使用vLLM官方工具,模拟高并发场景(200请求/秒),设置2048输入/512输出长度,完成10000次请求的性能评估。文档涵盖了硬件配置(Dell

zxt_95的博客 1415

一文掌握 Playwright 的详细使用

Playwright 是一个功能强大的浏览器自动化工具,适用于网页自动化测试、数据抓取和网页交互。通过掌握其基础用法和高级功能,你可以轻松实现各种浏览器自动化任务。Playwright 支持多浏览器、多语言,并且具有高效的异步操作能力,是现代浏览器自动化的首选工具之一。

数据知道的博客 1万+

nvidia显卡服务器离线环境下通过vllm部署deepseek

https://www.python.org/downloads/source/ 压缩包地址。如果不要求操作系统,个人建议使用ubuntu22.04版本。三、安装miniconda3。下载好的压缩包上传到服务器。四、安装nvidia驱动。下载之后上传到服务器。

一步一步走向大牛 1670

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

pscad IEEE标准系统搭建说明

pscad IEEE标准系统搭建说明,包含典型的IEEE 9节点、14节点、30节点、39节点和118节点系统。内含标准测试系统的原始数据和潮流结果。

vLLM 部署大模型

vLLM 是来自 UC Berkeley 的 LMSYS 在 LLM 推理方面的最新工作(没错就是搞出 Vicuna 的那个 group),最大亮点是采用 Paged Attention 技术,结合 Continuous Batching,极大地优化了 realtime 场景下的 LLM serving 的 throughput 与内存使用。

哦豁灬 13万+

IMSL CNL 7.0.0 (x86-64)Crack

IMSL CNL 7.0.0 (x86-64)Crack intel的算法库破解文件,这是C++版本的破解文件

vLLM镜像能否部署在离线环境?内网隔离部署方案

本文详解vLLM如何在无网络环境下部署,利用PagedAttention提升显存利用率与推理吞吐,结合Docker实现内网快速交付。支持本地模型加载、量化压缩与OpenAI兼容接口,适用于金融、政务等高安全场景,实现高效、稳定、合规的私有化大模型服务。

weixin_32456485的博客 822

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

【杂记】vLLM如何指定GPU单卡离线推理

vLLM如何指定GPU单卡/多卡离线推理

LZXCyrus的博客 6499

vllm离线部署大模型部署流程

scp -P 139xx <本地存储路径> root@10.101.xxx.xxx:~/DeepSeek-R1-0528-Qwen3-8B/DeepSeek-R1-0528-Qwen3-8B。scp -P <端口号> -r <本地文件路径> <用户名>@<服务器IP>:<远程目录>scp -P <端口号> <本地文件路径> <用户名>@<服务器IP>:<远程目录>{"role": "user", "content": "你是谁"}ssh -p <端口号> 用户名@<服务器IP>pwd 查看当前所在目录。

weixin_44918814的博客 1051

vllm安装及总结

vllm的安装和使用,对torch、cuda、xformers等有较多的版本依赖,过程中有一些曲折,故整理记录如下。

AI智能,无处不在 1万+

vllm笔记(1):最基础的离线推理

这三个参数用于控制重复和多样性,避免模型输出死循环或内容太重复。

ouliten的博客 1171
上一篇: 旧酒装新瓶:A2A+MCP
下一篇: Seed1.5-VL:高效通用的视觉-语言基础模型
庞德公
博客等级 码龄18年 2253粉丝 164原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值