Seed1.5-VL:高效通用的视觉-语言基础模型

字节-Seed-Thinking-v1.5-通过强化学习的推理模型 完成比例α(取值范围在[0, 1]之间)被定义为使用最新模型版本生成的在线策略样本的比例。在线策略样本是指基于当前最新的模型状态生成的样本,α值决定了这部分样本在总样本中的占比。例如,当α = 0.6时,意味着60%的样本是由最新模型版本通过在线策略生成的。 阅读详情

----->更多内容,请移步“鲁班秘笈”!!<-----

视觉-语言模型(Vision-Language Models,简称VLMs)逐渐成为实现通用人工智能(AGI)的一项关键技术。通过在同一模型中对图像和文本进行对齐,VLM能够在虚拟和现实环境中进行感知、推理与决策。过去几年里,VLM已经在多模态推理、图像编辑、GUI 操作代理、自动驾驶和机器人等多个领域取得显著进展,然而当前的VLM仍然存在明显不足,例如:缺乏三维空间理解能力、难以进行精确计数、缺乏想象力和互动游戏推理等。

这些问题的根本原因在于一方面,视觉-语言数据的数量和质量远不如纯文本数据丰富;另一方面,多模态数据本身就具有异构性,导致训练与推理流程更加复杂,影响模型的效率与效果。

字节跳动近日推出了Seed1.5-VL——一个面向通用视觉-语言理解任务的多模态基础模型。Seed1.5-VL由一个532M参数的视觉编码器和一个拥有20B活跃参数的混合专家(MoE)大语言模型组成。尽管其架构相对紧凑,但它在广泛的公开VLM基准和内部评估测试中表现出色,在60个公开基准中的38个上实现了最先进的性能。此外,在GUI控制和游戏等以代理为中心的任务中,Seed1.5-VL的表现超过了领先的多模态系统,包括OpenAI CUA和Claude 3.7。
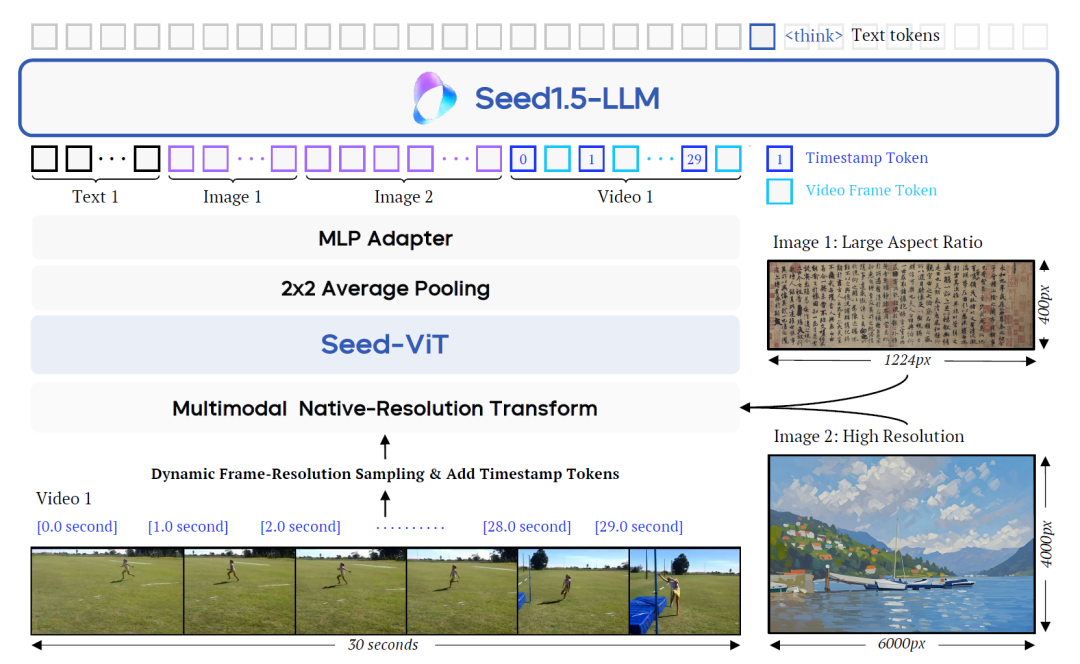
Seed1.5-VL 的架构由三个核心部分构成:Seed-ViT,专为高效图像和视频编码而设计的视觉Transformer。MLP适配器,用于将视觉特征映射为多模态统一表示。大型语言模型(LLM),具备20B活跃参数,用于理解和生成多模态文本。

整体架构如上图所示,模型支持不同尺寸的图片和视频输入,并通过原生分辨率转换模块保留了最大图像细节。视频输入采用动态帧分辨率采样策略,提升时间感知能力和效率。

Seed-ViT支持动态的分辨率,传统VLM多使用固定尺寸的图像输入(如224×224),这会导致高分辨率图片的细节丢失。Seed-ViT通过引入2D RoPE位置编码和动态分辨率支持机制,允许输入任意大小的图像,并保持原始结构信息。这在处理OCR、文档分析等需要细节的任务中表现出显著优势。
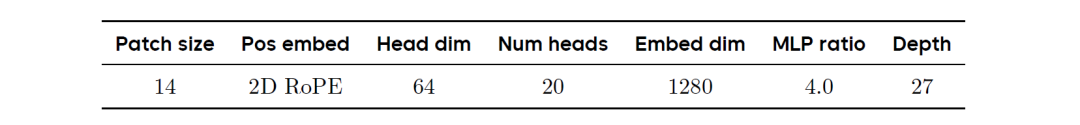
每张图像先被切分为不重叠的patch,再通过线性嵌入层映射为向量序列。为避免多张图像在batch中互相干扰,注意力机制使用了mask控制范围。编码后结果再进行2×2平均池化,以减少token数量,以便于降低LLM处理负担。
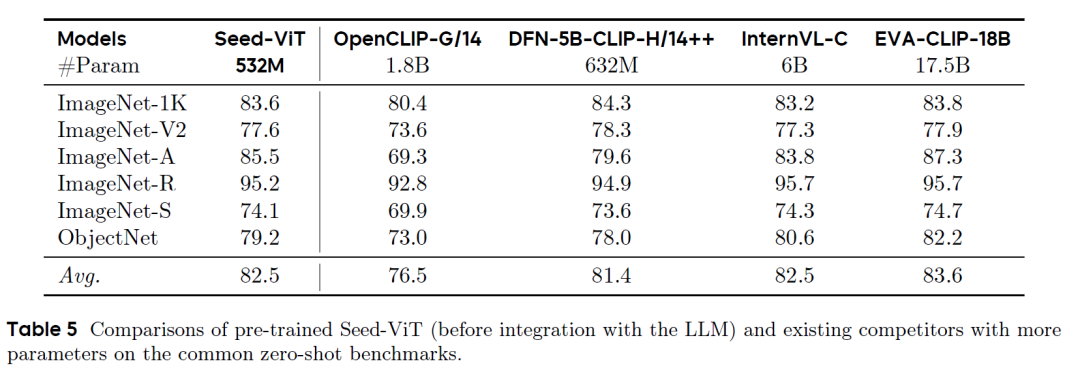
我们在ImageNet-1K、ImageNet-V2、ImageNet-A、ImageNet-R、ImageNet-S和ObjectNet等零样本图像分类基准上评估了Seed-ViT模型。如上表所示,Seed-ViT在这些数据集上取得了82.5%的平均零样本准确率,与InternVL-C-6B相当,而其参数量仅为后者的9%。更令人印象深刻的是,相比参数量30倍于它的EVA-CLIP-18B,Seed-ViT在大多数ImageNet变体上都取得了相当的准确率。此外,与DFN-5BCLIP-H/14++相比,Seed-ViT在包含复杂背景、旋转和视角变化的ObjectNet数据集以及包含自然对抗样本的ImageNet-A数据集上表现更优,这表明Seed-ViT对现实世界的变化具有更强的鲁棒性。

值得一提的是Seed-ViT的预训练方法,整个预训练过程分为三个阶段:

1. Masked Image Modeling (MIM)

该阶段以EVA02-CLIP-E为教师模型,学生模型随机初始化。训练过程中随机遮盖75%图像patch,并使用教师输出作为重建目标,通过余弦相似度损失进行优化。这一阶段显著增强了模型对图像结构和几何的感知能力。

2. 原生分辨率对比学习

将MIM预训练好的视觉编码器与CLIP-E文本编码器配合,进行图文对齐训练。采用SigLIP损失和SuperClass损失共同优化。对比学习强化了模型在图像和文本语义对齐方面的能力。

3. 全模态联合预训练

引入视频、音频、文本等模态,使用MiCo框架构建多模态对齐三元组(视频帧、音频、描述文本)。Seed-ViT学习处理这些不同模态的表示,获得强大的视频和语音理解能力。尽管这阶段只占预训练token总量的4.8%,但显著提升了模型的动态场景处理能力。

在视频处理方面,Seed1.5-VL采用动态帧-分辨率采样策略,根据任务需求调整帧率和分辨率。例如:普通任务:1帧/秒;高时序任务:2帧/秒;计数与运动追踪任务:5帧/秒。

每一帧图像都加上时间戳token,增强模型的时间感知能力。为了控制计算复杂度,模型设定了最大token预算为81920,利用6级分辨率等级动态分配帧的空间精度(如640、512、384等)。如果视频过长,系统会自动启用回退策略,降低帧数以保证覆盖完整视频。
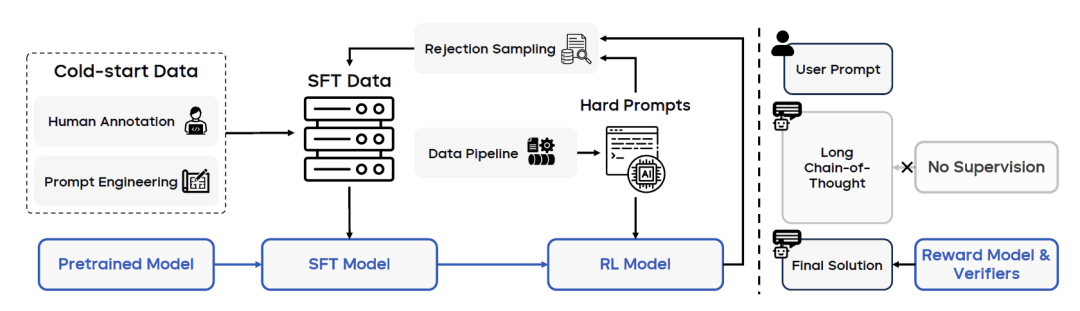
上图为Seed1.5-VL后训练流程概述。Seed1.5-VL的后训练包含结合拒绝采样与在线强化学习的迭代更新机制。通过构建了包含具有难度的提示词收集与筛选的数据管道,用于增强后训练数据集。
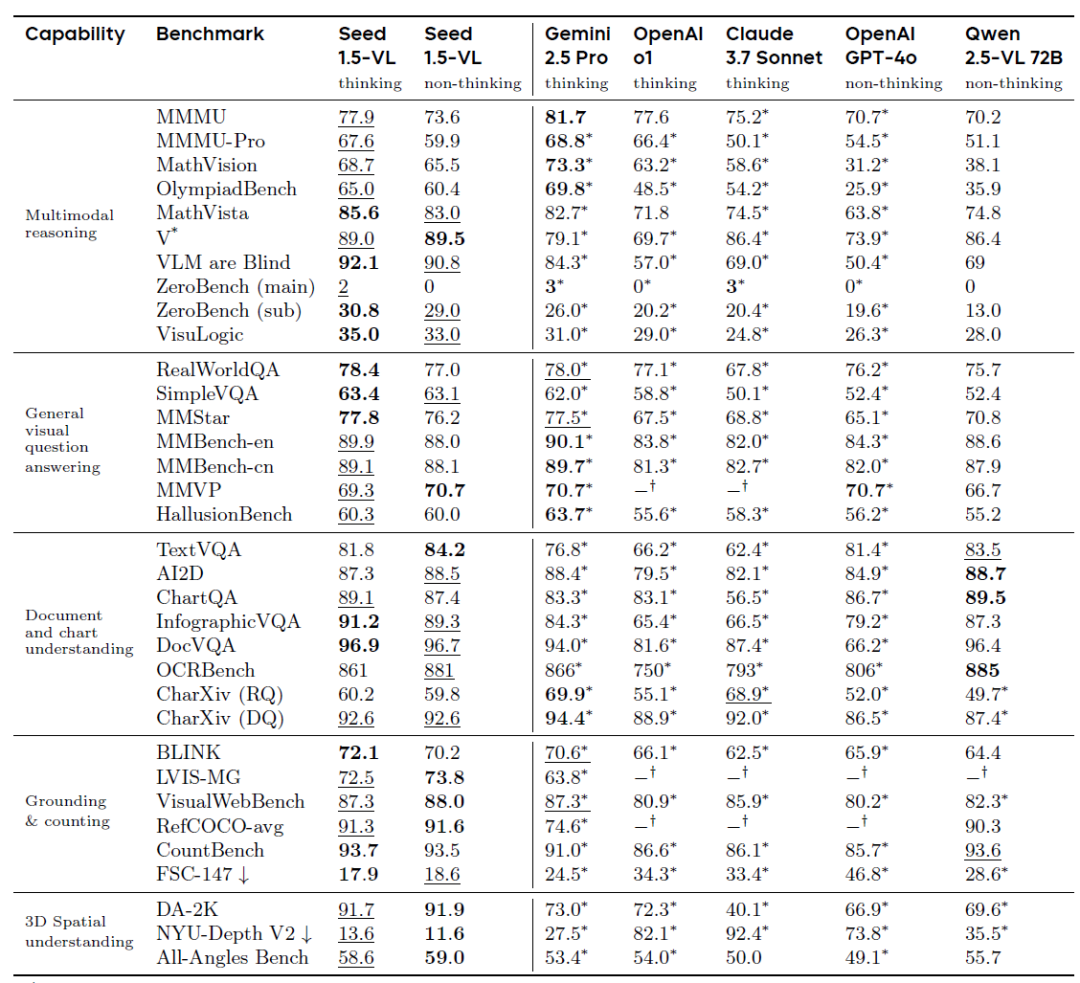
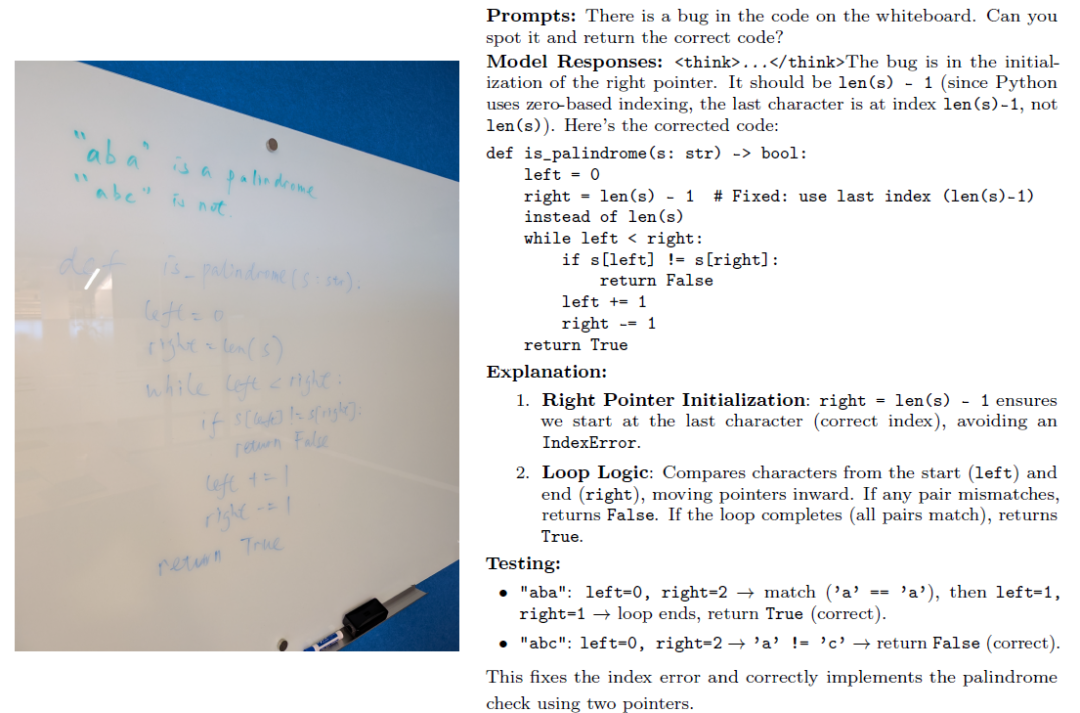
Seed1.5-VL通过高效架构、原生分辨率支持、大规模合成数据及多模态训练流程,构建一个同时具备强大理解能力与推理能力的视觉语言模型。其紧凑设计在保证性能的同时,显著降低了推理成本。除了视觉和视频理解外,它还展示了强大的推理能力,使其在视觉谜题等多模态推理挑战中特别有效。
大模型硬核测评:DeepSeek-VL、GLM-5.1与混元3实战能力拆解 大语言模型(LLM)能力评估不能依赖抽象基准分,而需回归真实业务场景——中文长文本理解、多模态文档处理、法律合规推理等核心任务,直击模型在OCR纠错、跨页表格关联、公章真伪初判、词性感知注意力等底层机制的表现。本文基于15款主流模型(含DeepSeek-VL、GLM-5.1、混元3)在L40S等真实硬件上的实测数据,揭示其推理能力边界、显存占用拐点与鲁棒性短板,为金融、政务、教育等垂直领域提供可复现的选型依据与部署调优路径。 阅读详情

相关推荐

VL-JEPA:视觉语言联合嵌入预测架构原理与实操

视觉语言模型(VLM)正从‘生成驱动’转向‘理解驱动’,其核心在于突破自回归解码的固有范式,构建统一、稠密、可度量的语义嵌入空间。VL-JEPA 以联合嵌入预测为技术路径,通过对比学习优化语义一致性而非token分布,实现动作本质的几何化表征——距离反映语义相似性,方向编码关系变化。该架构天然支持时序一致性建模与思考-说话解耦,在厨房操作等细粒度动作理解任务中展现出高稳定性(余弦相似度0.92+)与强泛化性。本文聚焦VL-JEPA的工程落地,涵盖X/Y编码器协同对齐、Predictor轻量设计、黄金小样本构

aikenqiu5098的博客 433

Seed-Thinking-v1.5:字节豆包新推理模型发布,200B参数战胜Deepseek

字节跳动旗下的豆包团队正式发布了其最新的推理模型——Seed-Thinking-v1.5,该模型在多个方面展现出了明显的技术优势。这一进展不仅推动了推理模型的发展,还引发了同行业内的高度关注,标志着AI技术在通用推理能力上的一个重要里程碑。

sherlockMa的博客 2623

多模态大模型升级:LLaVA→LLaVA-1.5,MiniGPT4→MiniGPT5

LLaVA, MiniGPT4的改进版本:LLaVA-1.5, MiniGPT5。

pku_langzi的博客 2345

Seed1.5-VL Technical Report——Seed1.5-VL 技术报告

Seed1.5-VL Technical Report——Seed1.5-VL 技术报告

Together_CZ的博客 2098

实战指南:视觉模型 MiniCPM-V 4.5

MiniCPM-V 4.5是一款8B参数的先进视觉-语言模型,基于Qwen3-8B和SigLIP2-400M构建,在OpenCompass评测中以77.0分超越GPT-4o和Gemini-2.0 Pro等主流模型。

举世誉之而不加劝,举世非之而不加沮,定乎内外之分,辩乎荣辱之境,斯已矣。 1303

单片机技术入门与实战:从零基础到项目开发

单片机(MCU)作为嵌入式系统的核心组件,集成了CPU、内存和各种接口电路,广泛应用于智能家居、工业控制和汽车电子等领域。其工作原理基于实时控制和低功耗设计,通过定时器、中断系统和通信接口等功能模块实现各种控制任务。在物联网和智能硬件快速发展的背景下,掌握单片机开发技术成为电子工程师的重要技能。本文以STM32和PIC系列为例,详细解析单片机的基本概念、功能模块和选型指南,并分享从入门到项目实战的系统学习方法,帮助开发者在3-6个月内快速掌握这一关键技术。

weixin_35753291的博客 649

字节Seed团队发布Seed1.5-VL,用仅20B活跃参数在60个主流测试中狂揽38项第一!

VLM通过整合视觉和文本模态,推动了多模态推理、图像编辑、GUI代理、自动驾驶和机器人等领域的发展。与现有模型比,Seed1.5-VL在多个内部基准测试中表现出色,特别是在OOD任务上。,Seed1.5-VL是一个强大的视觉-语言基础模型,通过创新的架构和训练策略,在多模态任务上取得了显著进展。视觉任务评估:在多模态推理、文档理解、视觉定位和计数等任务上,Seed1.5-VL取得了SOTA或接近SOTA的结果。视频任务评估:在短视频、长视频、流视频、视频推理和视频定位任务上,Seed1.5-VL表现出色。

zenRRan的博客 2116

深入解析ISO12233标准:SFR算法从理论到代码实现

本文深入解析ISO12233标准中的SFR算法,从理论到代码实现全面介绍如何量化成像系统的解析力。通过e-SFR算法测量边缘扩散函数(ESF)和空间频率响应(SFR),结合光学原理和实际代码示例,帮助开发者准确评估影像质量。文章包含关键步骤的Python实现和工程优化技巧,适用于相机测试、镜头评估等应用场景。

weixin_29200485的博客 150

Seed1.5-VL:20250511字节视觉-语言多模态大模型

我们介绍 Seed1.5-VL,这是一款旨在提升通用多模态理解与推理能力的视觉 - 语言基础模型。Seed1.5-VL 由一个 5.32 亿参数的视觉编码器和一个包含 200 亿活跃参数的混合专家(MoE)语言模型组成。尽管架构相对紧凑,它在广泛的公共视觉语言模型(VLM)基准和内部评估套件中表现出色,在 60 个公共基准中的 38 个上实现了最先进的性能。

ttkkdd的博客 2809

手把手教你用Simulink搭建交流异步电机矢量控制模型(附完整仿真文件)

本文详细介绍了如何使用Simulink搭建交流异步电机矢量控制模型,涵盖系统架构设计、关键模块实现、PI调节器参数整定及仿真分析等核心内容。通过实战指南和完整仿真文件,帮助读者掌握矢量控制技术,提升电机控制系统的设计与调试能力。

n4o5p6q7r的博客 246

[计算机头歌]爬虫进阶

【代码】爬虫进阶。

M_inherit的博客 919

小红书 hi lab 开源最强多模态大模型 dots.vlm1,性能对标闭源 Gemini 2.5 Pro和Seed-VL1.5

小红书 hi lab 推出的 dots.vlm1 多模态大模型以全链条自研和开源姿态,综合性能首次对标并逼近 Gemini 2.5 Pro、Seed-VL1.5 等闭源最强大模型,不仅在视觉-文本复杂场景中展现卓越,文本编码推理能力也保持主流水平。在文本任务(AIME、GPQA、LiveCodeBench 等)上,dots.vlm1 达到了与主流 LLM 相当的水准,具备通用数学推理和代码能力,但极复杂推理仍与 SOTA 闭源模型存在差距。

我爱计算机视觉 754

把云端打印带回办公室:通信场景 SAP_COM_0466 打通 SAP BTP ABAP environment 与本地打印机的 Pull Integration 实战

摘要: 本文探讨云端SAP系统如何通过SAP_COM_0466通信场景实现与本地打印机的安全连接。核心方案采用Pull Integration模式,由本地组件(如SAP Cloud Print Manager或第三方OMS)主动从云端打印队列拉取任务,避免网络边界冲突。配置流程涵盖通信安排创建、打印队列绑定及权限管理,并强调队列类型必须选择"Pull Integration Queue"的关键细节。方案通过分离云端生产与本地打印环节,既保障安全性又便于运维监控,适用于SAP BTP AB

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 134

字节Seed推出Lumine:从<原神>到<星穹铁道>,开启3D开放世界通用Agent新时代

近年来,人工智能在围棋、星际争霸等封闭环境中取得了超越人类的成就,但这些系统往往局限于单一任务,缺乏在开放世界中的适应性与泛化能力。:Lumine并非每一步都推理,而是仅在环境发生重大变化或任务切换时生成内部独白(如“<|thought_start|>...<|thought_end|>”),避免冗余计算,提升实时性。:7B模型在预训练中随数据量增加,能力逐步涌现:100小时内掌握基础交互,1000小时内精通战斗和GUI操作,1800小时后理解游戏机制与导航。当新推理生成时,上下文被清空并重新积累。

zenRRan的博客 800

基于毫米波生物感知雷达+STM32设计的独居老人居家监护系统(微信小程序)(192)

当前基于STM32设计的独居老人居家监护系统为独居老人提供一种简便、实时的健康监护服务。该系统通过集成多种传感器和功能模块,能够实时监测老人的生理指标、姿态以及室内环境状况,并通过微信小程序远程显示数据,当出现异常情况时及时发出报警提醒。

1万+

【2026年米哈游春招 - 3月14日 -第一题- 行列相等】(题目+思路+Java&C++&Python解析+在线测试)

摘要 本文解决了一个矩阵行列和匹配问题:统计矩阵中行和等于列和的所有行列对数量。算法首先计算每行和每列的元素和,然后利用哈希表统计各行列和的出现次数。通过遍历列和并查询对应的行和出现次数,高效计算出匹配对数。该方法时间复杂度为O(nm),空间复杂度为O(n+m),适用于大规模矩阵数据。代码实现了Python、Java和C++版本,通过哈希表优化避免了暴力枚举,显著提高了计算效率。

m0_73659489的博客 83

OpenAI 携 GPT-4.1 全量来袭,谷歌/字节/微美全息齐力加码AI多模态模型革新

从表现来看,微美全息逐步展现了AI战略的初步成效,聚焦开源生态、多模态交互、垂直场景等方向,大模型系列不断迭代,构建起从底层算法到多模态应用的完整技术体系,技术投入已开始反哺核心业务,整体技术实力处于前列,进一步巩固AI领域的领先地位。资料显示,近些年来,微美全息(WIMI.US)亦加大了对AI应用与多模态大模型等新AI机遇的投入,完善人工智能及云基础设施建设,能支持企业的模型开发训练及生产,同时AI相关产品在众多的行业垂直领域获得更广泛应用,包括互联网、零售、制造业,并越来越侧重于增值应用。

2501_92029301的博客 316

多测师肖sir_高级金牌讲师_数据库之存储练习题(8.13.1)

实验 一、 实验要求: 理解存储过程的概念 掌握存储过程的语法格式、使用方法 掌握存 储过程的创建、执行 二、实验前提: – drop table if exists student; – Create table student – (Id varchar(255), #学号 – Name varchar(255), #姓名 – Roomid varchar(255), #班级 – Sex char(1), #性别 – Degree varchar(3) );#成绩; Insert into stud

多测师肖sir的博客 683

StepFun团队:STEP3-VL-10B以小模型实现高智能

StepFun团队:STEP3-VL-10B以小模型实现高智能

至顶AI实验室 464

ssm框架搭建

这个是一个在idea上成功跑起来的ssm框架项目,保存在这里方便以后使用直接下载

SAP B1中文培訓教材_SDK

公司内部培训资料,对开发工具 ,DIAPI, UIAPI,Add-ON有详细解说

2025视觉Transformer革命:从ViT到多模态通用架构的突破与应用

Vision Transformer(ViT)自2020年问世以来,彻底改变了计算机视觉领域的技术格局,从最初的图像分类任务扩展到如今的多模态融合与移动端部署,2025年的最新进展正推动AI视觉技术进入高效化、轻量化与跨场景应用的全新时代。 ## 行业现状:视觉Transformer的技术演进与市场需求 传统卷积神经网络(CNN)凭借空间归纳偏差在视觉任务中统治多年,但其局部特征提取能力局限了对...

gitblog_00928的博客 1232

STM32F407中文手册

STM32f407中文手册 本参考手册面向应用开发人员,提供有关使用 STM32F405xx/07xx、STM32F415xx/17xx、 STM32F42xxx 和 STM32F43xxx 微控制器存储器与外设的完整信息。STM32F405xx/07xx、STM32F415xx/17xx、STM32F42xxx 和 STM32F43xxx 构成一个微 控制器系列,各产品具有不同的存储器大小、封装和外设。有关订购信息以及器件的机械与电气特性,请参见数据手册。有关 ARM Cortex™-M4F 内核的信息,请参见《Cortex™-M4F 技术参考手册》。

VisionLLMv2 LoRA 微调实战:低成本训练自己的统一视觉模型指南

VisionLLMv2 是一个"看图、找框、分割、生成、编辑、人体姿态"一体化的统一视觉语言模型。本文手把手教你用 **LoRA 微调** 技术,在单卡 GPU 上低成本地把 VisionLLMv2 适配到自家领域数据——不用全参数训练、不用天价算力,几十 GB 显存即可开训。 ## VisionLLMv2 统一视觉模型能做什么? 传统工作流里,目标检测、语义分割、文生图、图像编辑、姿态估计各

gitblog_00951的博客 167

Probability and Statistics - 4th edition

Probability and Statistics - 4th edition

上一篇: 魔改离线VLLM
下一篇: PARSCALE:大语言模型的第三种扩展范式
庞德公
博客等级 码龄18年 2253粉丝 164原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值