




很高兴又和大家来深度剖析我们的 Web 文档引擎—— JitWord。
github:https://github.com/jitOffice/jitword-sdk
由于内容过长,干货过多,大家看之前建议先收藏~
一、先把痛点说透:为什么web端还原Word格式这么难
想象一个再普通不过的动作:把一份真实的红头文件拖进浏览器。用户的预期只有一句话——「跟我刚才在 Word 里看到的一模一样」。
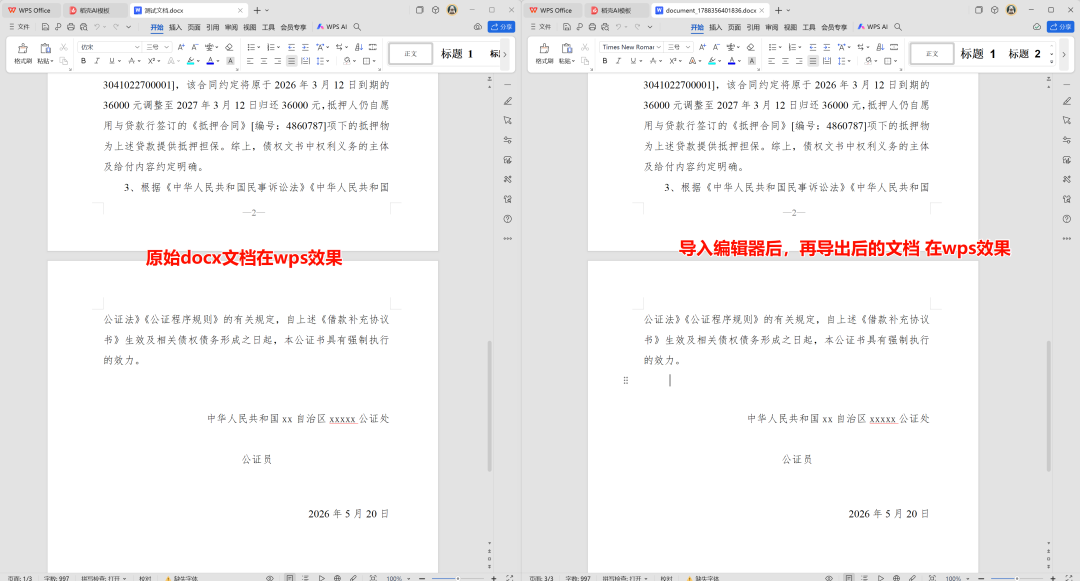
而实际发生的事情往往是:
字号对了、字体也对了,但行距差了半格;
表格整体窄了一截还往右偏;
多级编号的缩进跑进了正文;
一个求和公式变成一张糊掉的图片。
这些差异单看每一条都像「小 bug」,凑在一起就是用户嘴里的那句「这东西不专业」。
我们花了很久才承认一件事:它们不是 bug 的集合,而是缺一层模型。
Web 端做 Word 还原,最容易掉进的陷阱是「用 CSS 去猜 Word」。CSS 描述的是最终视觉,OOXML 描述的是排版规则,两者的表达能力根本不对齐——猜,一定会错。
下面这三个坑,是我们用真金白银踩出来的。
坑一:行距。
Word 里的「1.5 倍行距」是 1.5 × 字体自然行盒,而 CSS 的 line-height: 1.5 是 1.5 × 字号。宋体的自然行盒约是字号的 1.14 倍、雅黑约 1.32 倍、Times 约 1.45 倍。直接用 CSS 倍数,等于把所有字体当成同一套度量,段落一长,累计误差就把换行点全推错了位。
坑二:三态。
在 OOXML 里,「这个属性没出现」和「这个属性被显式写成 0 或 nil」是两件完全不同的事。表格边框、单元格宽度、snapToGrid 全是三态语义。解析时一旦把 undefined 和 false 合并,导出时就再也分不回来,文档来回导两次就被「洗白」了。
坑三:ZIP 手术。
第三方库能帮你生成 90% 的 document.xml,但公式(OMML)、静态目录条目、页眉页脚部件、水印、批注线程这些,要么库不支持,要么支持得不完整。剩下的 10% 必须自己把 ZIP 拆开、改 XML、再按 OOXML 规定的子元素顺序塞回去——顺序错了,Word 会当没看见,甚至直接报文件损坏。
所以我们给自己定了三条不可协商的原则,后面所有架构都是这三条的推论:原料与结论分离、单一真源双端同构、精度边界清晰可见。
二、JitWord是什么:一句话讲明白
JitWord 是一套跑在浏览器里的 Word 级文档引擎:一份 .docx 进来,先被拆成 OOXML 事实(原料),再被翻译成编辑器能协同编辑的语义(结论),最后还能原样写回 .docx。中间那层「事实」,就是整套架构的“承重墙”。
原则一 · 原料与结论分离。解析阶段先把 OOXML 的原始事实(twips 原值、三态标记、原始 XML 片段)完整保留,再另外派生出浏览器能渲染的结论值(px、CSS)。两份同时存在,互不覆盖。
原则二 · 单一真源、双端同构。浏览器和服务端必须给出同一份解析结果。前端 TypeScript 管线是唯一真源,服务端那一份是机械转译产物,再用测试断言两端产出的 OOXML 逐字节相等。
原则三 · 精度边界诚实可见。还原不了的东西,明确记进结构化诊断报告(9 类 warning code + 78 项包级计数),而不是悄悄降级、让用户在打印时才发现。
先看一组可验证的工程量,好让后面的架构讨论有分量:
导入导出管线能力,我们共写了 40868 行非测试代码,其中中间表示构建器 buildDocIR.ts 单文件 6171 行、导出引擎 wordExporter.js 8337 行;解析器里被显式处理的 w: 标签有 91 个,公式转换器覆盖 42 个 m: 标签;这条管线上有 431 个单元/集成测试用例在守着。
为了做这套方案, 我们3个架构师化了 3 个月时间才设计出来。
三、六个核心亮点复盘
下面我总结了6条核心实现的亮点,供大家研究参考。
3.1 在 web 端也能高精度打开 Word 文件
最容易翻车的场景是这样:对方发来一份红头文件,正文宋体小四、首行缩进两字符、标题居中、表格贴着页边距、页脚一个页码。
我们把它拖进一个 Web 编辑器,字确实都出来了,但总觉得哪里不对——行与行之间松了,表格往右挪了一点,页码不见了。
这些偏差单独看都很小,叠在一起就是三个字:不专业。
为什么会这样?因为大多数产品的做法是「猜」:把 Word 文件里的样式读出来,翻译成网页样式,翻译不了的就挑一个看起来接近的凑上。凑一次差一点,凑十处就差很多。
我们换了个思路——不猜,逐项对账。Word 文件里写了什么,先原封不动记下来,包括那些网页根本渲染不了的东西;记完再决定屏幕上怎么画。渲染不了的那部分也不丢掉,导出时原样还回去。
我们的设计方案:同一份文件在 Word 里和在我们编辑器里,行距、段前段后距、首行缩进、表格左右边线的位置、多级编号、页眉页脚、水印、批注与修订痕迹,都能对得上。真对不上的地方,我们也不假装看不见——导入完成时会给出一份诊断报告,明确告诉你哪些元素没还原、属于哪一类原因,而不是让你在打印的时候才发现少了一页页眉。
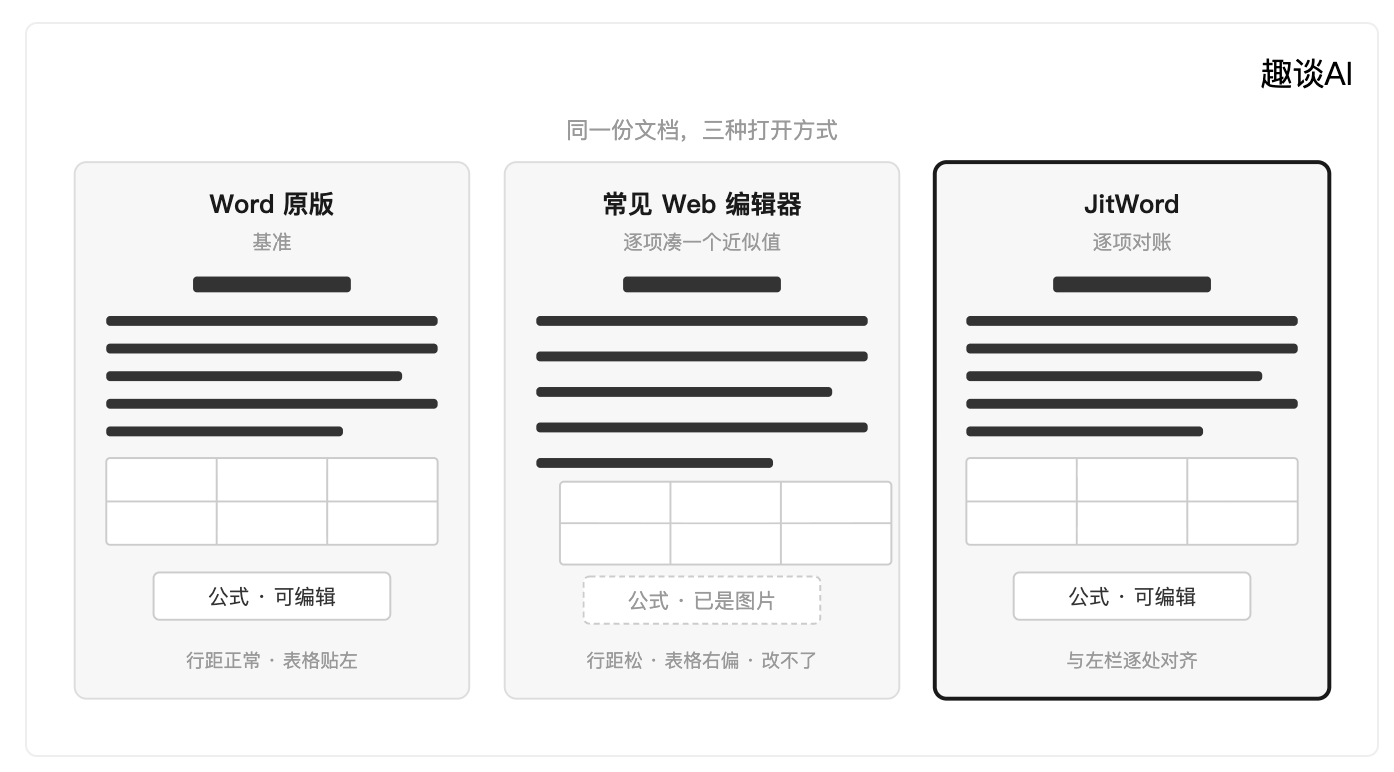
「像不像」不是靠肉眼一遍遍调出来的,是靠「原文写了什么就记什么」这条纪律。
技术底账 · 解析器 buildDocIR.ts 单文件 6171 行,显式处理 91 个 OOXML 标签;还原不了的内容归入 9 类诊断码与 78 项包级计数,随导入结果一并返回。
3.2 来回改几轮,格式不会一轮比一轮塌
合同和公文的真实流程,从来不是「打开一次改一次」,而是来回好几轮:
法务在网页上改完导出,
业务同事用 Word 打开接着改,
改完发回来又得导进去。
这个来回每走一趟,格式就掉一层皮——表格窄了一点、缩进少了一格、行距松了一些。三轮之后,文档已经不像原来那份了,最后只能有人手工重排一遍。
根因在于只留下了加工后的结果,没留下原料。屏幕上用的像素是加工品:Word 内部用一套更精细的计量单位,换算成像素要四舍五入,误差从这一刻就产生了。如果导出时拿这个已经舍入过的像素再倒推回去,每轮都会丢一点,而且误差会累积。这就像反复复印一张复印件——每一张都比上一张糊一点,糊到最后没法看。
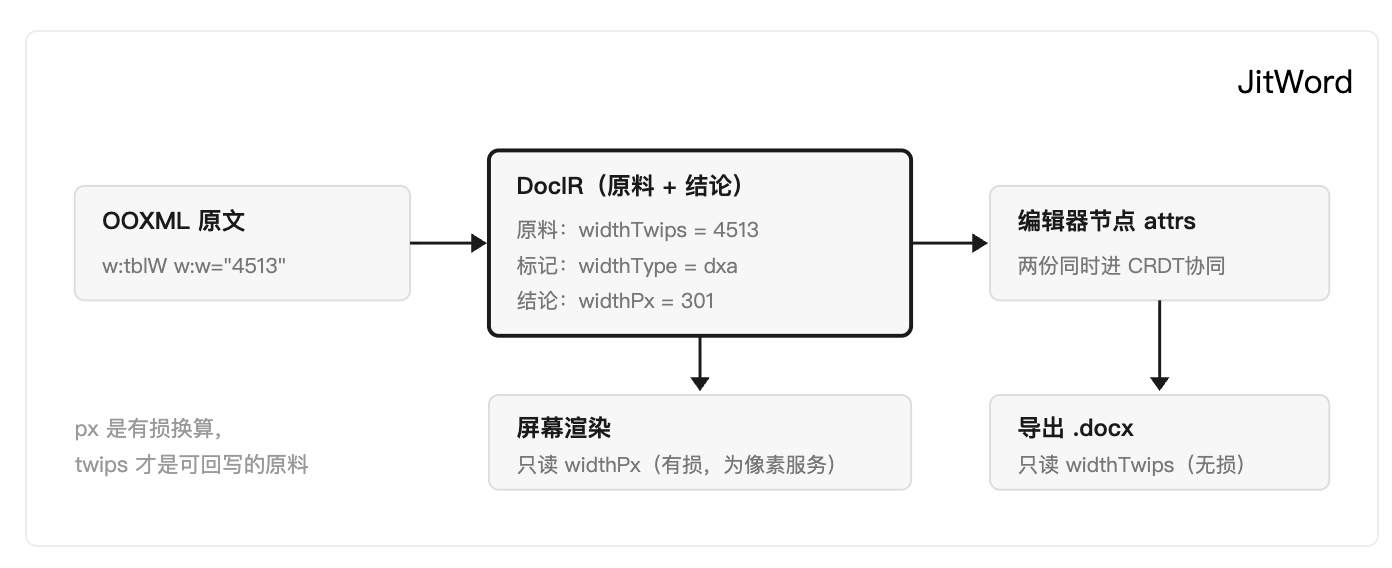
我们的做法是原料和加工品同时留着:Word 给的原始数值原封不动存一份,屏幕上用的换算值另存一份,两份并存、互不覆盖。导出的时候优先拿原始数值写回去,换算值只负责显示。于是每一轮往返都是「从原料重建」,而不是「拿上一轮的结果接着算」,误差没有累积的机会。至于那些我们压根看不懂、也渲染不了的字段,直接原样封存成一段文本留着,导出时再按 Word 规定的位置插回去——看不懂的东西,不许丢。
我画了一个原理图,供大家参考:
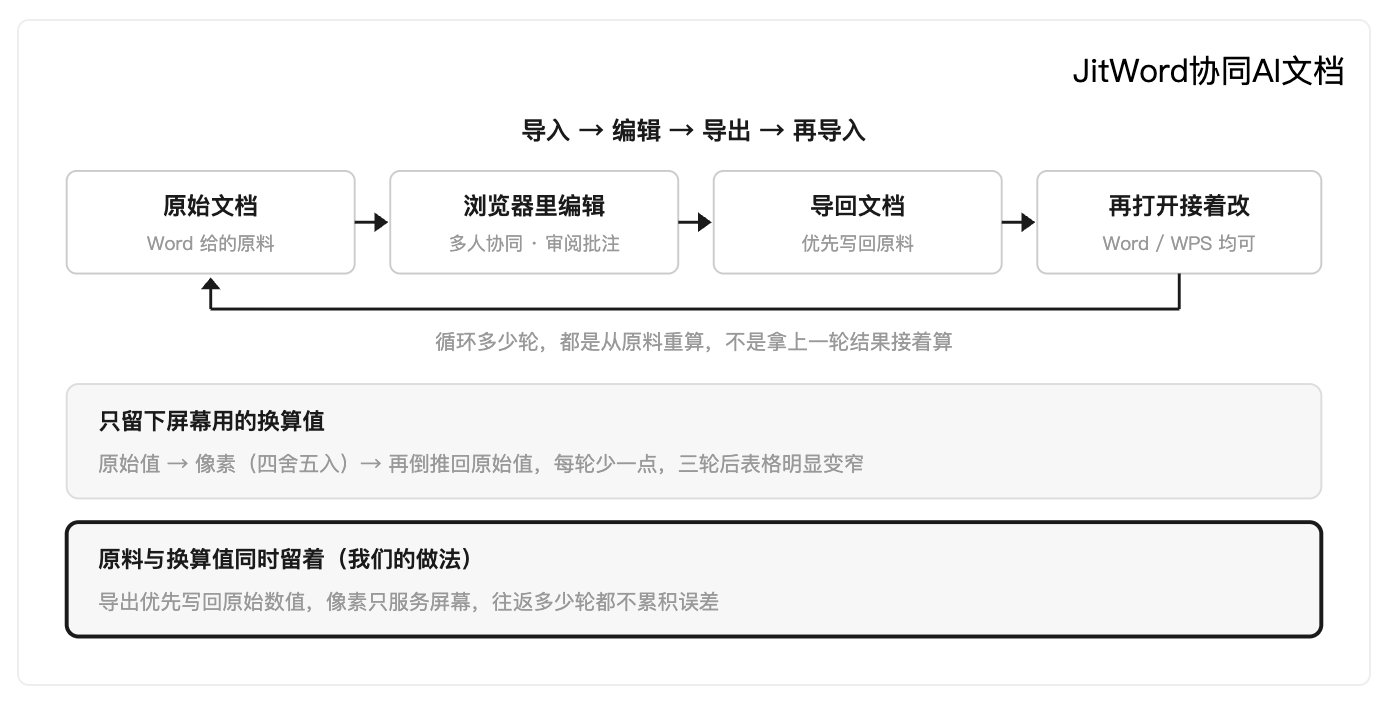
往返不塌的关键,是永远留着一份没被加工过的原料。
技术底账 · 中间表示对同一属性同时保存 twips 原值与 px 换算值(ir/types.ts);渲染不了的段落标记原样封存为 docxParagraphMarkRPrXml,导出时按 OOXML 规定的子元素顺序回插。
3.3 行距和缩进这些「玄学」,我们是量出来的
用过 Word 的人都碰过这类玄学,也大概率见过别的工具在这几件事上翻车:同一份文档换成微软雅黑,行与行之间莫名变松;明明设的是单倍行距,换个工具导出就挤了回去;表格在 Word 里贴着页边距,搬到网页上就右移了几个像素。很多产品的处理方式是加一个行距调节滑杆,让用户自己试到看着顺眼为止——这等于把问题甩给了用户。
真相是:「单倍行距」根本不是一个固定数字,它是每一款字体自己的属性。同样的字号,宋体、雅黑、等线、Times 的「自然行高」实测下来差得很远,我们量到的倍数从 1.04 到 1.45 不等。而网页样式里那个 line-height 只有两种能力:字号的几倍,或者固定多少像素。它表达不了 Word 那种「先按字体算出自然行高、再乘倍数」的算法。既然表达不了,我们就在画到屏幕之前,自己按 Word 的规则算一遍。
要算,就得先知道那款字体的「自然行高」,而这个数字字体文件里没有、规范里也推不出来。我们的做法是:文档打开时,在页面里偷偷放一个看不见的探测元素,用当前字体排一行中英文混排的文字,量一次它的实际高度,除以字号就得到这款字体的倍数,然后缓存起来——一款字体一生只量一次,不拖累性能。还有个更玄的:微软雅黑在 Word 里的行盒会被额外放大约三成,这个值任何文档里都查不到,只能靠真机 WPS 一格一格数出来(雅黑 11 磅占两行网格、宋体占一行)。这类数字我们一个都不猜,全部实测。
表格位置和编号缩进也是同一套思路:它们不是「样式问题」,是几何问题。
举个例子,Word 里那个表格缩进值,量的不是表格边框,而是第一列文字的起点,所以表格左边线其实会略微越过页边距角标——这恰恰就是你在 Word 里看到的样子。我们照抄这条规则,而不是想当然地把表格对齐到页边距。多级编号同理,它本质是一台计数器:遇到下一级要清零、回到上一级要接得上,缩进还要按「字符」和「磅值」两种单位分别继承。这些都不是调样式能调出来的。
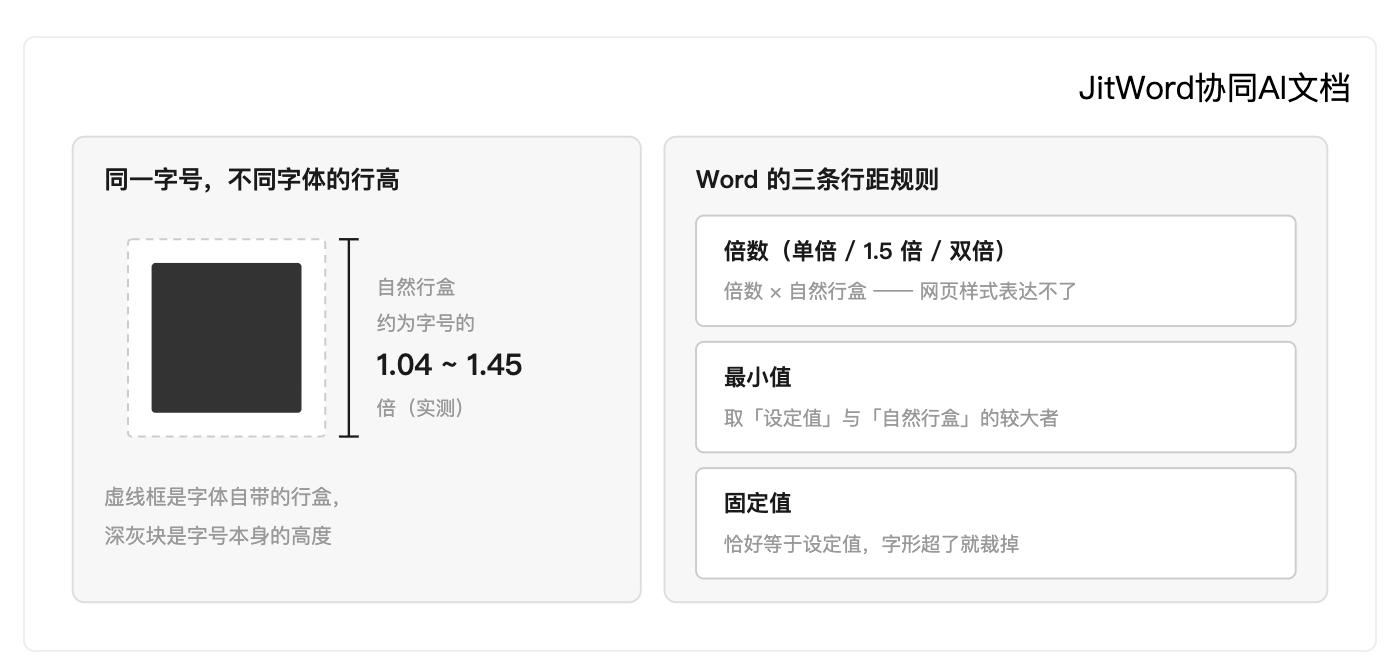
网页样式凑不出 Word 的算法,那就自己算;量一次,比让用户试一百次准。
技术底账 · line-height.js 的 getNaturalRatio() 用隐藏探针实测字体自然行盒并按字体缓存,resolveLineHeightCss() 分别实现三条规则与文档网格吸附;表格几何见 tableProcessor.js,编号计数器见 resolveParagraphNumbering()。
3.4 公式还是公式,不会变成一张图片
教材、试卷、论文、技术方案里全是公式。很多 Web 编辑器导入 Word 公式的做法是——截个图贴上去。看上去没坏,但公式从此就死了:改不了、放大会糊、全文搜索搜不到它、复制出来是一张图、导回 Word 也不再是公式。对做教育、出版、科研客户的团队来说,这一条基本就是能不能用的分水岭。
我们把公式当活的内容处理。导入时,新版 Word 的公式被完整翻译成可编辑的公式对象,分式、上下标、根号、求和、积分、矩阵、括号伸缩、重音符号都在覆盖范围内;十几年前老版本公式编辑器留下的二进制公式,我们另写了一条转换路径,同样翻成可编辑对象,并保留它自带的预览图作为兜底显示。导出时再原样写回 Word 的公式格式,Word 打开后依然是一个可以双击进去改的公式。
这里有个很容易踩的细节:整行独立的公式,它的居中 / 左对齐设置不在段落的对齐属性里,而在公式自己的属性里。读错地方,导入后所有独立公式的对齐就全乱了。这种「同一个效果、Word 却存在两个不同地方」的情况,在整个解析过程里到处都是,只能一条条踩平。
3.5 几百页大文档不白屏、不崩,真实可测
招投标书、验收报告、汇编材料,动辄几百页、上千个表格。这类文档最容易出的问题是:拖进去之后白屏十几秒,转圈,然后浏览器标签页直接崩掉——或者更糟,没崩,但内容少了一半,而界面没告诉你。对客户而言,这两种结果都没区别:文件不敢往里拖。
我们做了三件事。
第一,先算规模再决定怎么读:文档一进来先统计有多少个内容块、多少个节点、多少个表格单元格,超过阈值就切换到分批写入,每写一批就让浏览器喘一口气,界面不冻结、进度看得见。
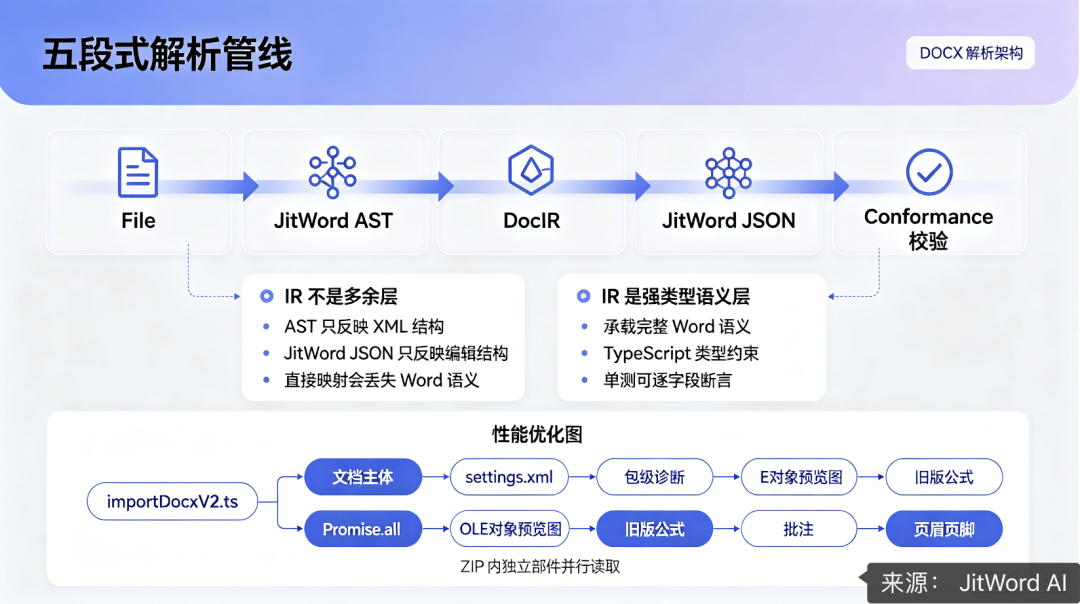
第二,读取阶段并行化:Word 文件本质是个压缩包,正文、批注、页眉页脚、图片、旧版公式这些部件彼此独立,我们七路同时读,而不是排队读。
第三,真扛不住时让用户点头:文档特别大时会明确弹提示,告知预计耗时与内存风险,由用户决定继续还是取消,而不是偷偷硬扛。
这里必须说句实话:分批处理能把「卡死几十秒」摊平成「有进度地慢」,但它不能降低内存峰值。浏览器标签页的内存是有上限的,几十万节点的文档确实会触到天花板。所以我们的策略是把规模数据如实告诉用户、让他自己决定,而不是承诺一个做不到的事。这一句写进了代码注释,也写进了产品交互。
大文档的第一要求不是快,是不骗人。
技术底账 · 复杂度护栏阈值 heavy 20000 节点 / 8000 单元格、extreme 60000 / 30000;分批每 40 个顶层块配合 requestAnimationFrame 让帧;浏览器实测数据与「分块不降峰值内存」的结论记录在 applyImportedContent.js 文件头注释。
3.6 网页上改的,和服务器上批量跑的,结果基本一致
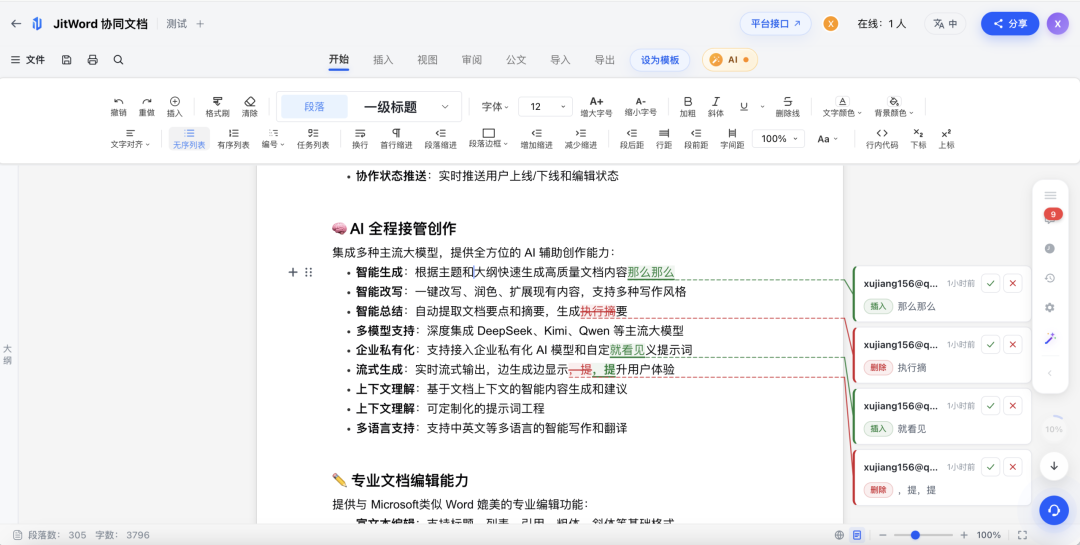
前面五条讲的都是「一个人在浏览器里编辑」。但真正决定这套引擎能不能被集成、能不能规模化的,是第六条:同一份文档,在浏览器里导出,和在服务器上批量导出,结果必须完全一样。为什么这一条值钱?因为一旦你要做「一个模板 + 一万条数据,自动生成一万份合同 / 通知书 / 成绩单」,或者把编辑能力嵌进客户自己的系统里,就绕不开它。如果出现「网页上看着对、批量跑出来的不对」,就意味着你要长期养两套逻辑,而这两套逻辑一定会慢慢分叉。
我们的做法是只写一份。前端那一套解析与导出逻辑是唯一真源,服务器上那一份不是重写的,而是一个脚本自动转译出来的产物——就像同一份菜谱,两个厨房照着做,味道必须一样。服务器目录下那批文件明确规定不许手改,改了下次转译就会被覆盖,从制度上杜绝了「两边各自修一修」这条最常见的分叉路径。
光靠「只有一份源码」还不够,我们还上了硬验证:让浏览器和服务端各自导出一份,然后断言两个结果完全相等。不是「语义等价」,不是「看起来一样」,是逐字节相等。这类断言分布在缩进、页眉页脚、水印三个模块里。整条导入导出管线上有 431 个测试用例在守着,测试文件的名字本身就是一份特性清单:制表位、网格吸附、单元格边距、表格定位、隐藏文字、行尾空白……每一个名字背后,都是一次线上差异的复盘。
JitWord协同AI文档一份源码(前端 23 个文件)唯一真源,服务端那一份不许手改脚本机械转译浏览器里导出用户点「下载」服务端批量导出一个模板 + 一批数据,自动出稿两份产出逐字节相等测试直接断言相等,不是「看起来一样」
四、整体架构:五层,承重墙在第三层
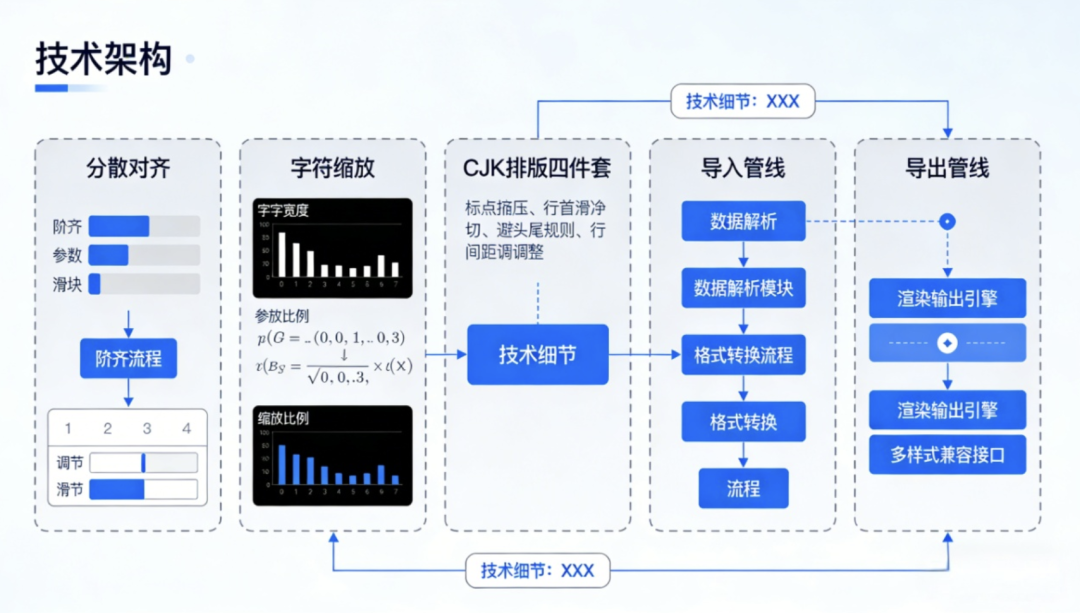
先看全景。整套系统分五层,越往下越接近 OOXML 字节,越往上越接近用户手指。真正决定「像不像 Word」的,是夹在中间的第三层——文档保真层。它既不负责编辑手感,也不负责解 ZIP,只干一件事:把 Word 的排版事实翻译成可推理、可断言、可回写的数据。
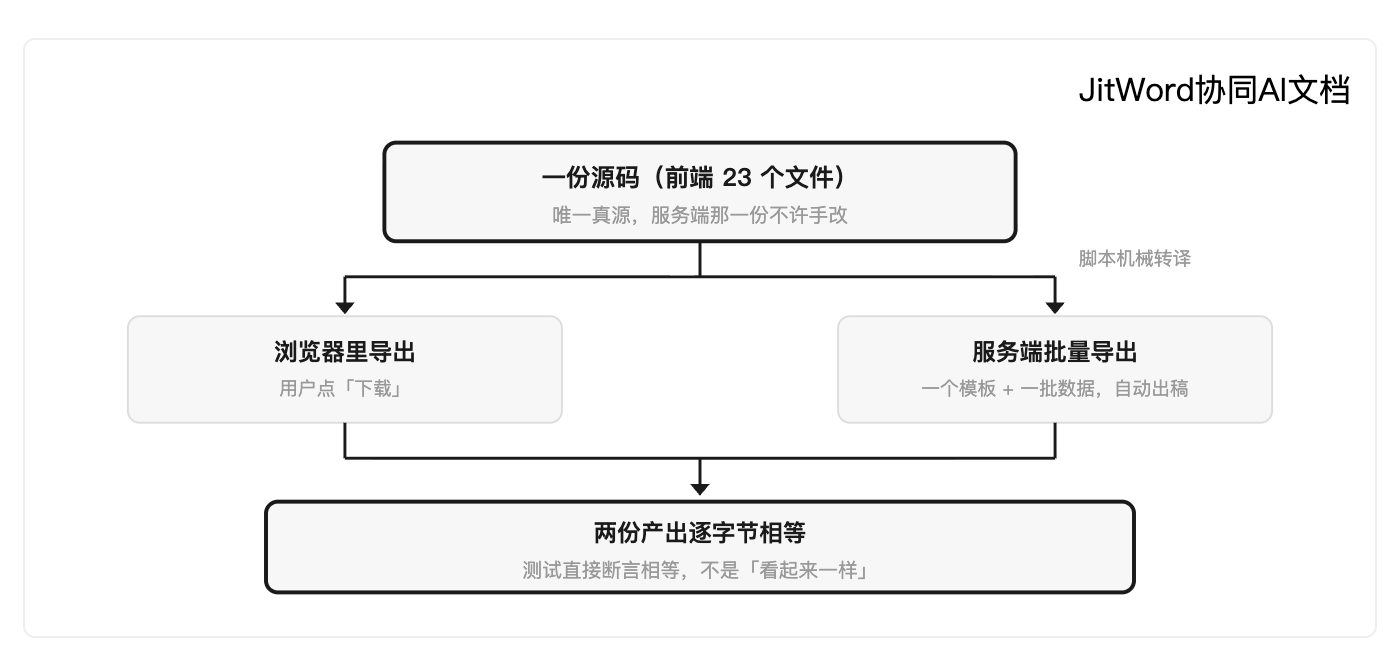
为什么自研 DocIR?AST 是「XML 的形状」——想知道一个段落的最终缩进,你得在 docDefaults、样式链、编号定义、表格条件样式、段落直接格式之间来回跳。JitWord JSON 是「编辑器的形状」——它装不下三态标记,也不关心 twips。IR 是唯一一个「既懂 Word 又强类型」的落点:每个 OOXML 机制都能被单测逐字段断言,改一处不会波及全文。
为什么导出是「生成 + ZIP 手术」,而不是纯手写 OOXML?纯手写要自己维护 [Content_Types].xml、各种 .rels、主题、字体表,代价极高,而且很容易写出 Word 直接报「文件损坏」的包。
为什么 PDF 走无头 Chromium?保真的唯一标准是「和用户在浏览器里看到的一致」。服务端另起一套排版实现,等于凭空造出第二份偏差。apps/browser-service 直接用无头 Chromium 的 printToPDF 对真实渲染结果出图,所见即所得这件事,只能有一个真相来源。
五、两条主流程:导入八步,导出八步
先看导入。从用户拖进文件到文档真正出现在编辑器里,一共八步。前两步是防御,中间四步是翻译,最后两步是保护主线程。特别注意第 2 步的七路并行和第 8 步的复杂度护栏:前者把 ZIP 里彼此独立的部件同时读,后者把一份 23 万节点的大文档拆成批次写入,两者都是为了不让用户在白屏前干等。
再看导出。它不是一次生成,而是一条流水线:先让第三方库交一份合规骨架,再用 JSZip 把这个 ZIP 拆开,按固定顺序做 7 道定向手术,最后重新打包。顺序不能乱:编号轴要先于缩进字符单位,批注线程要先于页眉页脚,水印最后改 sectPr(因为它和目录改写的 SDT 区域不重叠)。
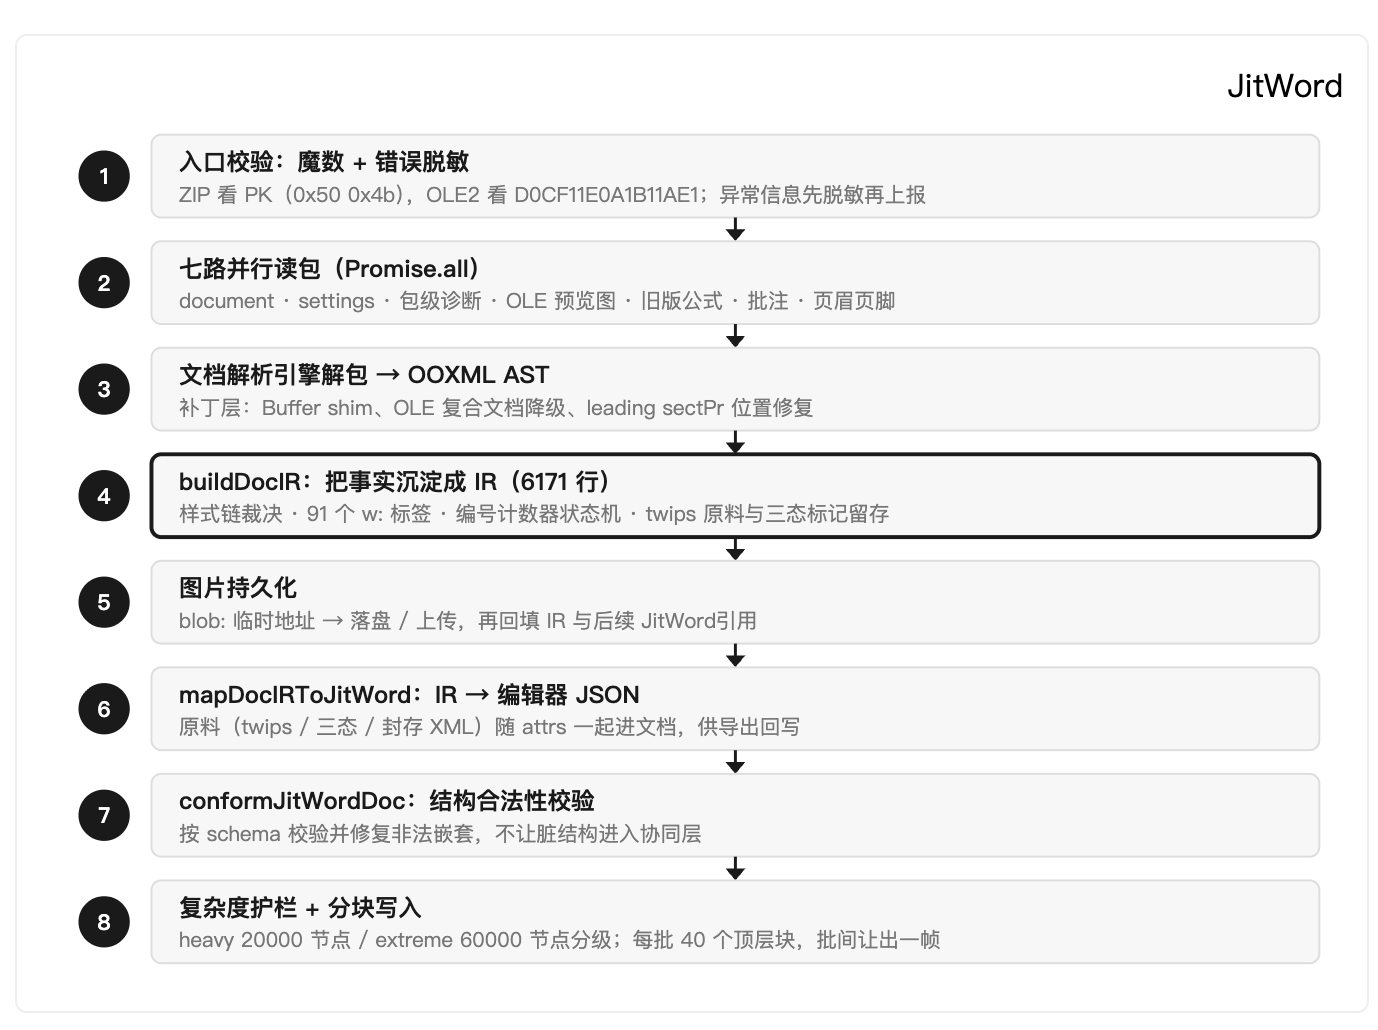
5.1 数据流:一个表格宽度的完整旅程
抽象的架构说完了,看一个具体到字段的例子。一个表格宽度从 OOXML 出发,到屏幕、再回到 .docx,全程走的是下面这条路径。关键在于中间那个盒子:原料和结论同时存在,彼此不覆盖。这就是「导两次不走样」的全部秘密。
我们也清楚,依然还有很多优化空间。但在当下,对于需要 Web 端处理高保真 Word 文档的企业与开发者,JitWord 已经是一套可以落地的完整解决方案。
如果大家正在做 OA、知识库、合同管理系统,或者团队需要在线协作处理正式 Word 文档,欢迎参考 JitWord,也欢迎和我们交流你的业务痛点。


 扫一扫


 1万+

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


