




论文题目: CogVideoX: Text-to-Video Diffusion Models with An Expert Transformer
中文翻译: CogVideoX:基于专家 Transformer 的文本到视频扩散模型
会议: ICLR 2025
摘要: 本文提出 CogVideoX,一个基于 Diffusion Transformer 的大规模文本到视频生成模型,可生成与文本提示高度一致的连续 10 秒视频,帧率为 16 FPS,分辨率最高达到 768 × 1360。以往视频生成模型通常面临运动幅度有限、视频时长较短的问题,尤其难以根据文本生成具有连贯叙事的视频。为解决这些问题,作者首先提出 3D Variational Autoencoder,在空间和时间两个维度压缩视频,从而同时提高压缩率与视频重建质量;其次,为改善文本与视频之间的对齐,引入带有 Expert Adaptive LayerNorm 的 Expert Transformer,使两种模态能够进行更深层次融合;再次,通过渐进式训练以及 Multi-Resolution Frame Packing,使 CogVideoX 能够生成时序连贯、时长较长、具有多种宽高比并包含明显运动的视频。除此之外,作者构建了一套包括视频过滤和重新描述在内的数据处理流程,并训练视频 Caption 模型提升生成质量以及语义对齐能力。实验表明,CogVideoX 在自动指标和人工评测中都取得了很强的性能。
源码与模型:https://github.com/THUDM/CogVideo。论文公开了 5B、2B,以及 Text-to-Video 和 Image-to-Video 等模型版本。
一、研究背景与核心问题
文本生成视频看起来像是“把文生图多生成几帧”,但真正困难的地方恰恰是时间维度。
对于单张图像,只需要保证这一帧内部结构正确;视频却要求几十甚至上百帧之间保持主体身份、位置、运动轨迹以及场景状态的一致性。如果 Prompt 只是“A dog running”,短视频模型还相对容易处理;但如果文本描述的是“闪电击中岩石,岩石裂开,一个人从里面跳出来”,模型必须理解事件发生的先后顺序,还要让前后状态真正发生变化。
因此 CogVideoX 真正想解决的并不是单纯的“视频清晰度”,而是三个相互关联的问题:
第一,视频 Token 数量过大。高分辨率、长时间的视频同时包含空间和时间两个维度,直接在像素空间建模几乎不可行,因此需要比图像 VAE 更有效的视频压缩方式。
第二,大运动下的时序一致性。如果空间 Attention 和时间 Attention 完全分开,物体一旦跨帧发生较大位移,相邻帧中的同一个主体未必能够直接建立联系。
第三,文本和视频之间的语义对齐。互联网视频通常没有足够详细的文字说明,而一句非常粗糙的 Caption 很难教会模型理解“谁先做了什么,随后发生了什么”。
CogVideoX 的思路可以概括为:
先用 3D Causal VAE 压缩视频,再用 Expert Transformer 在统一序列中建模文本与视频,通过 3D Full Attention 建立完整时空联系,最后利用渐进式训练、Frame Packing 和高质量视频 Caption 把模型扩展到长视频和高分辨率场景。
论文最终的 5B 模型能够生成最高 768 × 1360、10 秒、16 FPS 的视频。
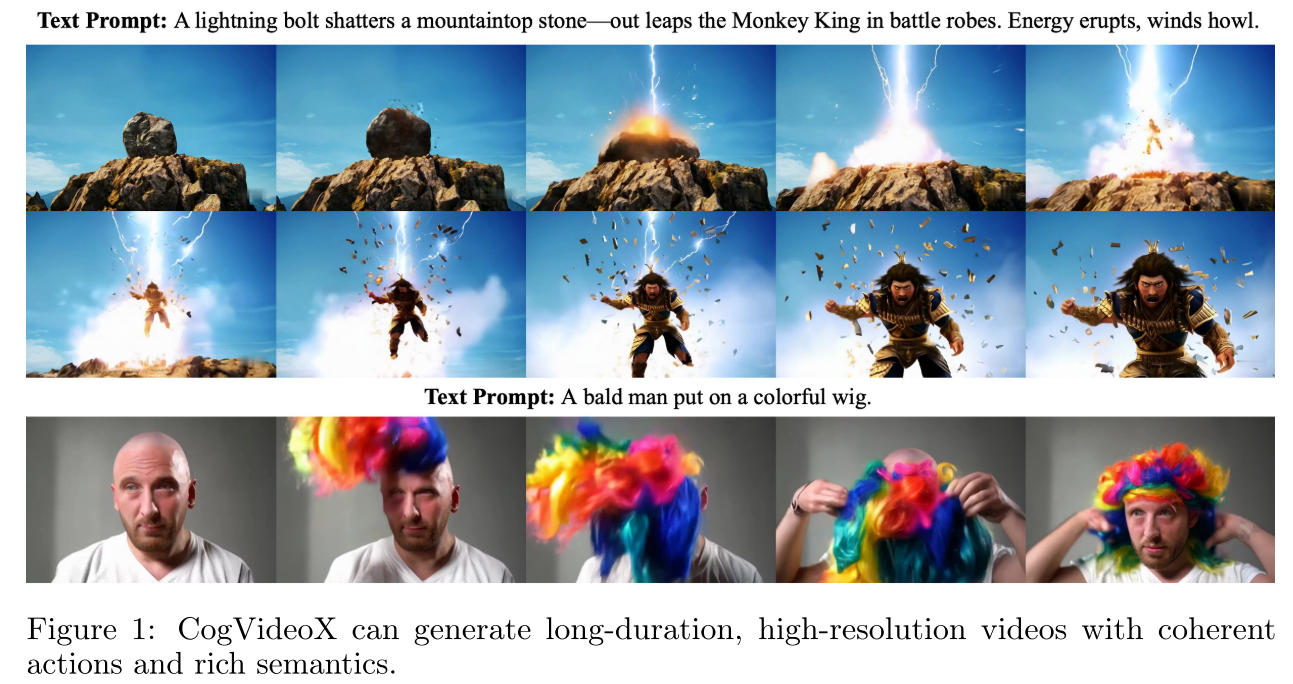
论文 Figure 1:CogVideoX 文本生成视频示例
这张图最直观地展示了论文希望解决的问题:重点并不是某一帧“像不像图片”,而是连续视频中动作是否真正发生。例如闪电击中岩石以后,岩石发生变化;人物动作也需要随着时间连续演化。
二、CogVideoX 整体架构
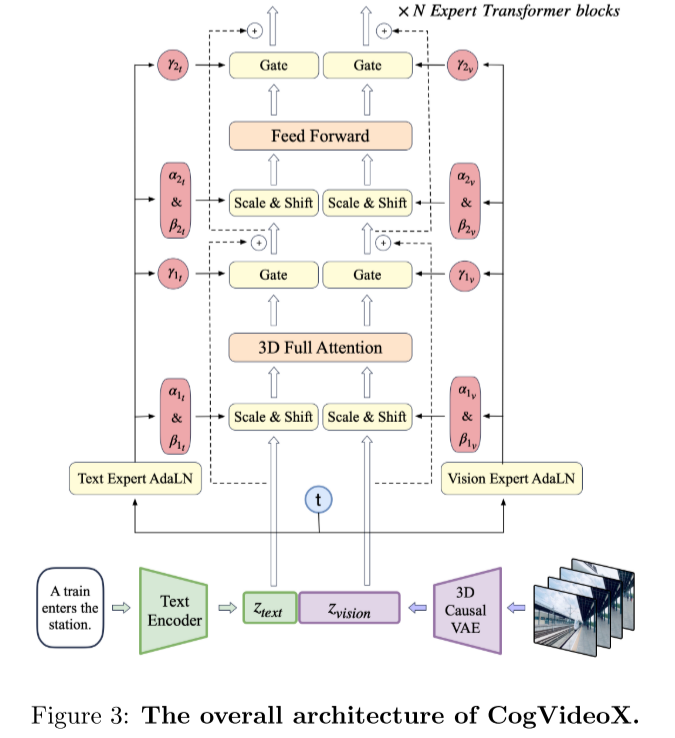
论文 Figure 3:CogVideoX 整体架构
Figure 3 是理解整篇论文最重要的一张图。
CogVideoX 的完整数据流可以概括成:
Video → 3D Causal VAE → Video Latent → Patchify → Vision Tokens
Text → T5 → Text Tokens
Text Tokens + Vision Tokens → Expert Transformer → Unpatchify → 3D VAE Decoder → Video
训练时,原始视频首先通过 3D Causal VAE Encoder 压缩到 Latent Space。随后把视频 Latent 切成 Patch,并展开成长序列 。
与此同时,文本 Prompt 使用 T5 编码为 。
CogVideoX 并没有简单地让视频 Token 对文本做 Cross-Attention,而是直接在 Sequence 维度把两者拼接:
拼接后的完整序列进入多层 Expert Transformer。模型输出再经过 Unpatchify 恢复视频 Latent 的结构,最后使用 3D VAE Decoder 重建视频。
这个结构的一个重要特点是:文本和视频被放进了同一个 Transformer 上下文。
但问题也随之而来:语言特征和视觉特征的数值分布明显不同。CogVideoX 因此没有给它们建立两套完全独立的 Transformer,而是在共享 Transformer 的基础上,用 Expert Adaptive LayerNorm 分别处理两种模态。
三、3D Causal VAE:先解决视频太大的问题
3.1 为什么不能直接沿用 2D VAE?
图像 Latent Diffusion 通常只需要在空间维度压缩,但视频还多了时间维度。如果只逐帧使用 2D VAE,那么即使每一帧被压缩,几十上百帧累积起来以后,Transformer 的序列长度仍然非常大。
CogVideoX 因此使用 3D VAE 同时进行空间压缩和时间压缩。
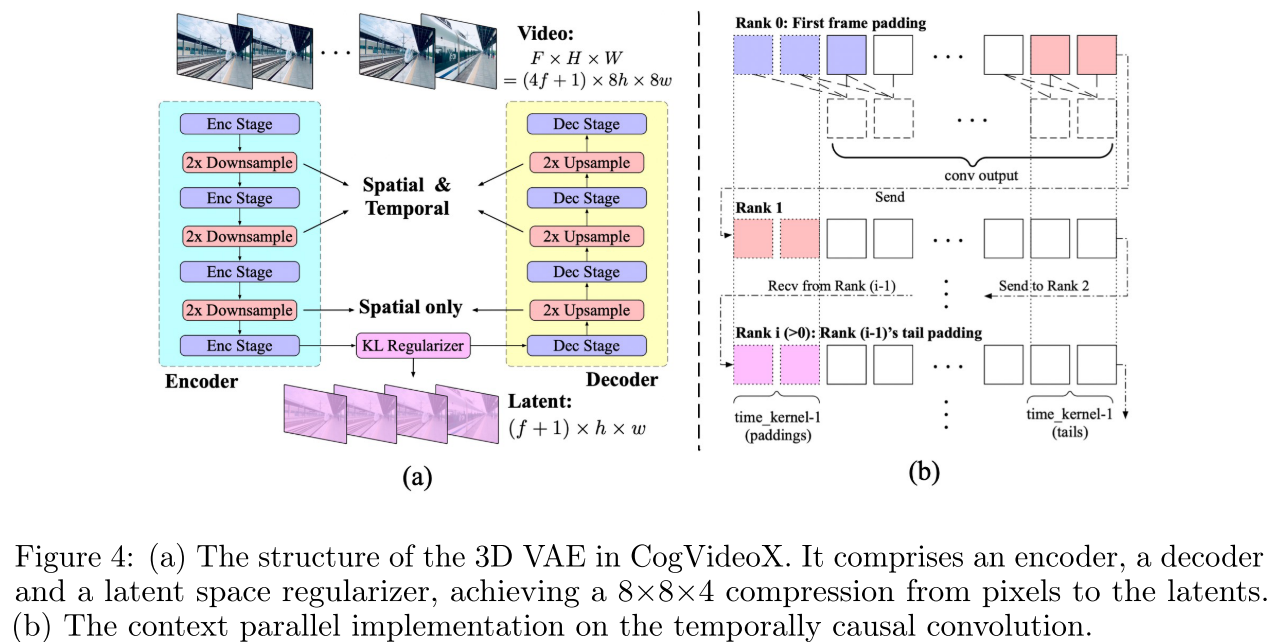
论文 Figure 4:3D Causal VAE 结构以及 Temporal Context Parallel
其 Encoder 和 Decoder 由对称的多个阶段组成,中间交替使用 ResNet Block、2D Downsample 和 3D Downsample。最终从 Pixel Space 到 Latent Space 实现 8 × 8 × 4 的压缩:空间的高、宽分别压缩 8 倍,时间维度压缩 4 倍。
这里还有一个很重要的设计:Temporal Causal Convolution。
普通 3D 卷积可能同时看到当前帧前后的信息,而因果卷积只允许当前状态依赖过去,不能让未来帧反向影响之前的状态。论文实现时把 Padding 放在时间轴卷积的起始侧,从而保持这种因果关系。
3.2 压得越狠越好吗?
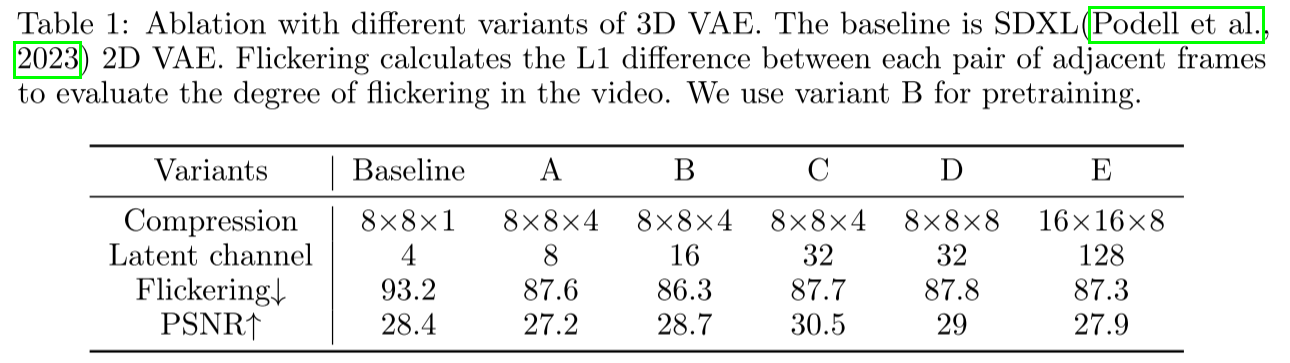
论文 Table 1:不同 3D VAE 压缩率和 Latent Channel 的消融实验
答案是否定的。
2D VAE Baseline 的 Flickering 为 93.2,而采用 8 × 8 × 4 时,可以降低到 86 左右,说明时间维度上的联合建模明显改善了连续帧抖动。
但继续把压缩率增加到 16 × 16 × 8 并不划算。即使增加 Latent Channel,模型依然变得很难收敛。因此最终预训练采用的是相对平衡的 8 × 8 × 4 配置,而不是盲目追求最高压缩率。
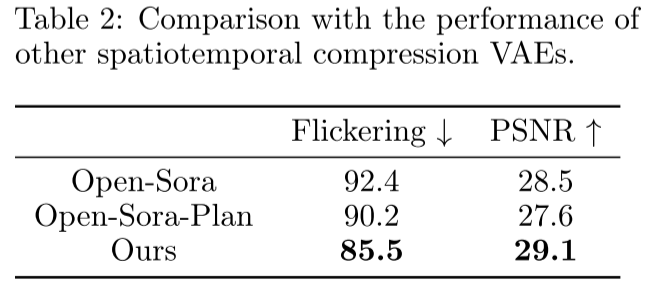
论文 Table 2:CogVideoX 3D VAE 与其他时空 VAE 的重建性能比较
在 WebVid 的 256 × 256、17 帧验证视频上,CogVideoX VAE 的 Flickering 为 85.5,低于 Open-Sora 的 92.4 和 Open-Sora-Plan 的 90.2;PSNR 达到 29.1,同样是三者中最高。
也就是说,3D VAE 的价值并不仅是“节省 Token”,它本身也承担了维持跨帧连续性的任务。
对于长视频 VAE 训练,作者还沿时间维度使用 Context Parallel,把不同时间片分配到多个设备。因为卷积具有因果性,相邻 Rank 只需要传递长度为 k−1k-1 的边界片段,因此通信开销相对有限。
四、Expert Transformer:真正建模文本、空间与时间
4.1 3D-RoPE:位置不再只有二维
经过 VAE 后,视频 Latent 的形状可以写成 T×H×W×CT × H × W × C。Patchify 后,真正进入 Transformer 的 Token 同时具有三个位置坐标:
(x,y,t)(x,y,t)
CogVideoX 将传统 RoPE 扩展成 3D-RoPE,分别在 x、y、t 三个维度应用 1D RoPE。其中空间 x 和 y 各使用 Hidden Channel 的 3/8,时间维度使用 2/8,最后拼接得到完整位置编码。
这种设计尤其适合后面的 Multi-Resolution Frame Pack,因为不同视频可以拥有不同分辨率、宽高比和时长,而 RoPE 依然能够根据相对位置描述 Token 关系。
4.2 Expert Adaptive LayerNorm:共享 Transformer,但分别处理两种模态
文本 Token 与视觉 Token 虽然进入了同一条序列,但它们本身属于完全不同的 Feature Space。
CogVideoX 的处理方式非常直接:Transformer 主体仍然共享,但是在 AdaLN 中划分为 Text Expert AdaLN 和 Vision Expert AdaLN。两者都接受扩散 Timestep 的调制,但分别归一化和调制文本 Hidden State 与视觉 Hidden State。
换句话说,它没有像 MMDiT 那样为不同模态维护两套更重的 Transformer,而是:
共享 Attention/FFN 参数 + 模态专属 AdaLN。
这样既保留了文本与视频充分交互的能力,又没有大幅增加参数量。
4.3 为什么坚持 3D Full Attention?
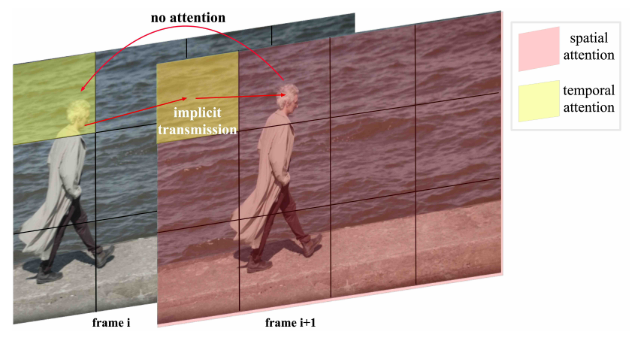
论文 Figure 5:2D Spatial Attention + 1D Temporal Attention 在大运动场景下的问题
Figure 5 很好地解释了作者为什么不用常见的“空间 Attention + 时间 Attention”分解方案。
假设一个人的头在第 ii 帧位于画面左侧,下一帧因为大幅运动出现在另一个位置。如果空间与时间 Attention 被拆开,第 i+1i+1 帧的头部 Patch 未必可以直接 Attend 到上一帧对应的头部,而可能需要通过大量中间背景 Token 间接传递信息。
CogVideoX 因此直接采用 3D Text-Video Full Attention:空间、时间以及文本 Token 在统一 Attention 中建立关系。FlashAttention 则用来缓解长序列 Attention 带来的计算压力。
这个选择虽然更贵,但作者认为对于“大运动”和长视频的一致性来说值得。
五、训练、数据与实验结果
5.1 Multi-Resolution Frame Pack:不同长度的视频一起训练
固定帧数训练看似简单,却会浪费很多视频数据:短视频必须被丢弃,长视频必须截断,而图片和视频之间又存在“一帧 vs. 数十帧”的巨大 Token 数差距。
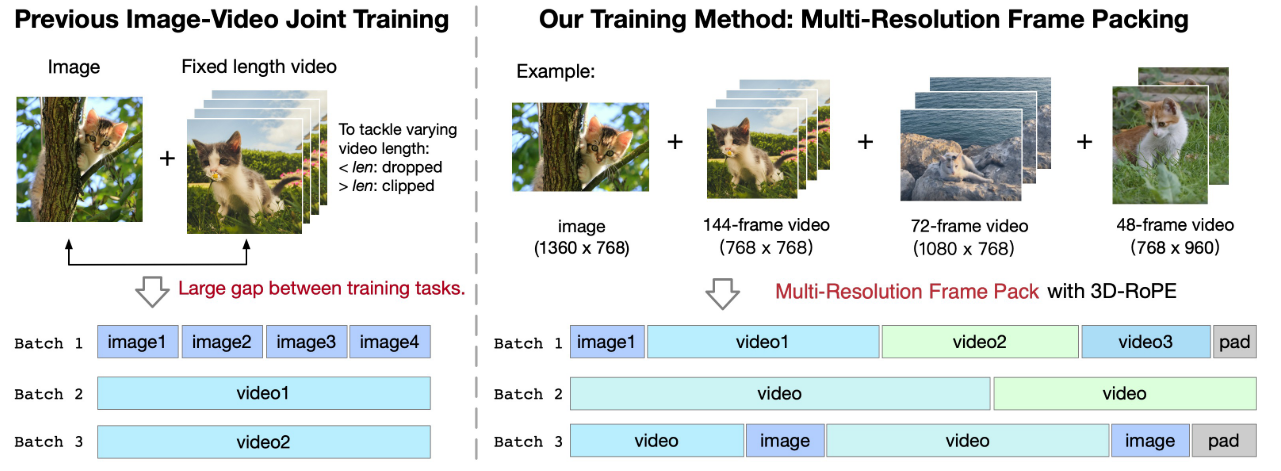
论文 Figure 6:Multi-Resolution Frame Packing
CogVideoX 将不同分辨率、不同持续时间的视频打包进同一个 Batch,通过 Packing 让整体 Tensor Shape 满足训练要求,同时保留每个样本原本的时长和宽高比。
作者把图片直接当成单帧视频,因此图片和视频也可以进入统一训练框架。这不仅提高数据利用率,也降低了模型简单依靠 Token 数量区分“图片模式”和“视频模式”的风险。
训练分辨率同样采用 Progressive Strategy:先从低分辨率学习语义和低频结构,再逐渐提高到 512px、768px,最终执行高质量 Fine-tuning。这样比一开始直接训练 768px 视频节省大量计算。
5.2 Explicit Uniform Sampling:一个很小但很实用的训练技巧
普通 Diffusion 训练中,每个 Data Parallel Rank 都随机从完整 Timestep 范围采样 t。理论上长期看是均匀的,但有限 Batch 下可能出现某些时间步被过度采样、另一些采样不足。
而不同 Timestep 的 Loss 尺度本来就不完全一样,这就会导致训练 Loss 明显波动。
CogVideoX 的方法非常简单:假设有 n 个 Rank,就把完整 Timestep 范围切成 n 段,每个 Rank 只在自己的区间内均匀采样。
所以它没有修改 Diffusion Loss,而是修改了并行训练时 Timestep 的采样方式。这样每个全局 Batch 覆盖的噪声水平更加均匀。
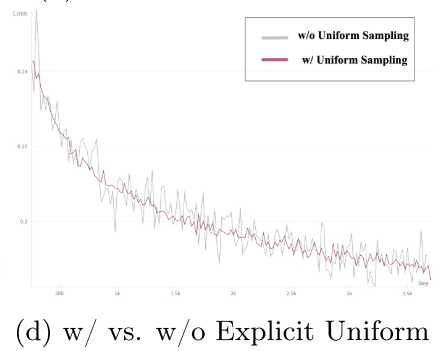
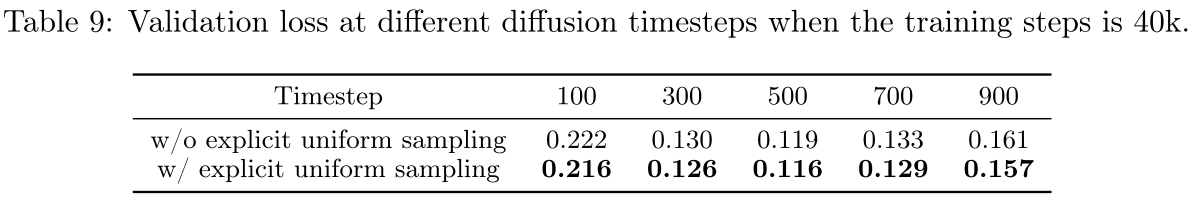
论文 Figure 10(d) + Table 9:Explicit Uniform Sampling 消融
训练到 40k Step 后,从 timestep 100 到 900,使用 Explicit Uniform Sampling 的 Validation Loss 都更低,例如 timestep 100 从 0.222 降至 0.216,timestep 900 从 0.161 降至 0.157。
单个数字变化不算巨大,但更重要的是 Loss Curve 明显更加稳定,因此这个设计更像是一个大规模训练稳定器。
5.3 数据质量:模型不仅需要更多视频,还需要更好的“文字老师”
CogVideoX 最终过滤得到大约 3500 万个 Single-shot 视频片段,平均每段约 6 秒,同时额外使用约 20 亿张图片辅助训练。
视频数据过滤的重点不是简单判断“清不清晰”,而是判断它适不适合学习真实运动。作者专门过滤明显剪辑、缺乏运动连续性、低质量拍摄、讲座类、文本占比过高以及屏幕录制等视频,还结合 Optical Flow 与美学分数动态筛选样本。
真正值得关注的是 Caption。
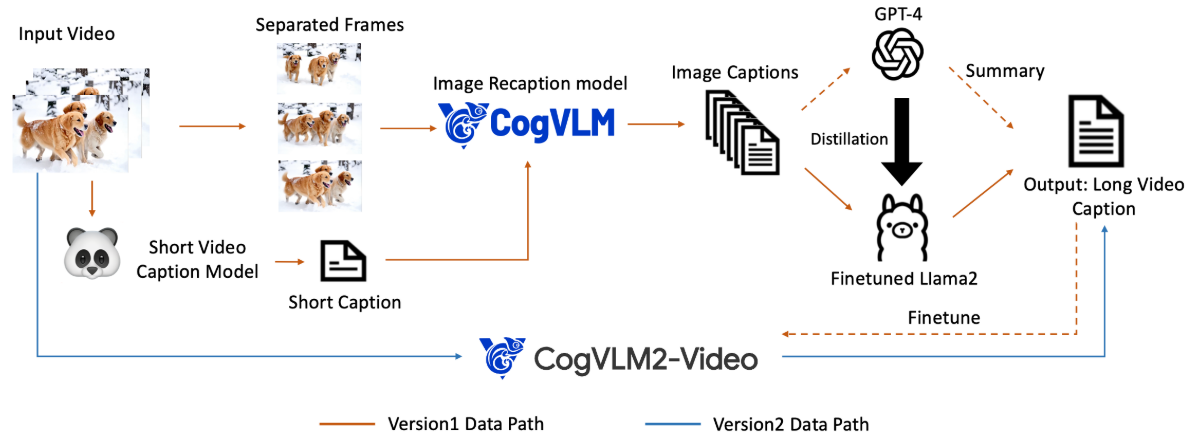
论文 Figure 7:Dense Video Caption Data Generation Pipeline
原始视频 Caption 通常只有类似“a man walking”这样的短句,很难描述视频内部发生的时序变化。
作者先用已有视频 Caption 模型产生短描述,再按时间抽取视频帧,由 CogVLM 生成详细 Image Caption,最后让 GPT-4 将这些逐帧描述总结为具有时间顺序的完整 Video Caption。为了把流程扩展到数千万视频,又使用 GPT-4 生成的数据 Fine-tune LLaMA2,并进一步训练 CogVLM2-Caption。
这部分其实揭示了 CogVideoX 一个非常重要的经验:
生成模型能够学会多复杂的视频语义,很大程度上取决于训练文本能否准确描述视频里的“变化”。
5.4 主实验:CogVideoX 到底表现如何?
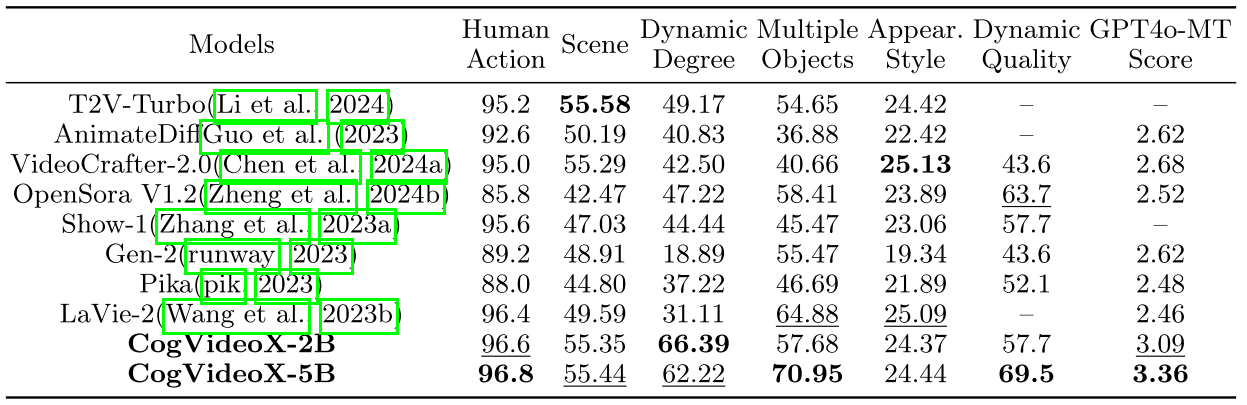
论文 Table 3:CogVideoX 与公开文本生成视频模型的自动指标对比
作者没有简单只用画质指标,而是选取 Human Action、Scene、Dynamic Degree、Multiple Objects、Appearance Style,同时加入 Dynamic Quality 和 GPT4o-MTScore,尽量降低“生成几乎静止的视频反而容易拿高分”的问题。
CogVideoX-5B 在 7 个指标中的 5 项取得最高值。例如 Multiple Objects 达到 70.95,Dynamic Quality 为 69.5,GPT4o-MTScore 达到 3.36。
这里需要注意论文的结论边界:CogVideoX-5B 并不是所有指标都第一。例如 Scene 指标略低于 T2V-Turbo,而 Dynamic Degree 上 CogVideoX-2B 甚至高于 5B。因此更准确的说法是:5B 在整体视频质量、复杂场景和动态变化方面表现最强,而不是所有单项全面领先。
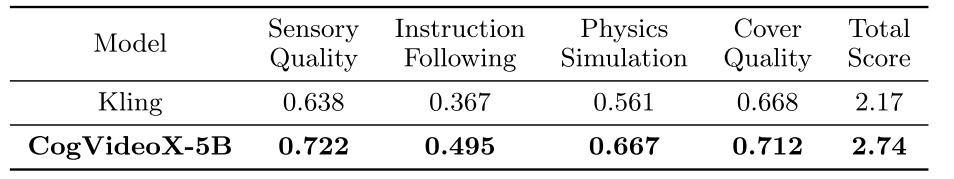
论文 Table 4:CogVideoX-5B 与 Kling 的人工评测
人工评测从 Sensory Quality、Instruction Following、Physics Simulation、Cover Quality 四个方面打分。
CogVideoX-5B 的总分为 2.74,Kling 为 2.17;四个子项中 CogVideoX-5B 都取得更高评分,例如 Sensory Quality 为 0.722 vs. 0.638,Instruction Following 为 0.495 vs. 0.367。
这组结果的重要性在于,自动指标之外,人类评测也支持了论文关于质量、Prompt 遵循和物理动态表现的结论。
5.5 消融实验:哪些设计真正起作用?
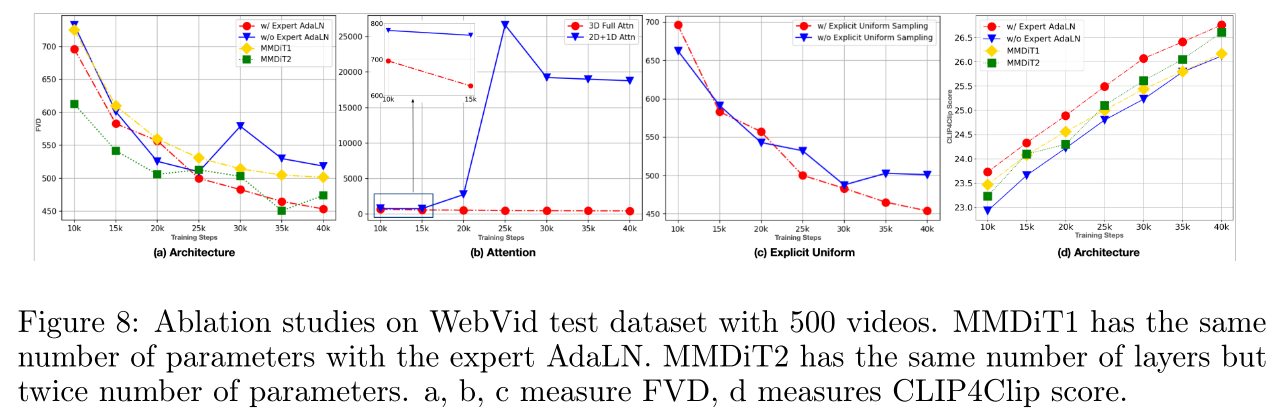
论文 Figure 8:Expert AdaLN、3D Full Attention、Explicit Uniform Sampling 消融
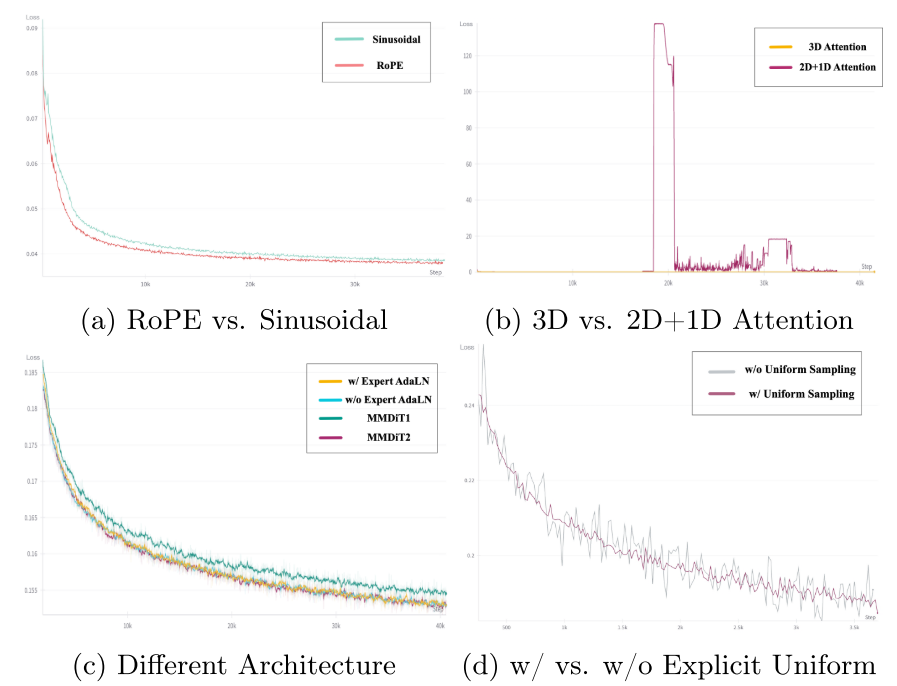
论文 Figure 10:各设计对应的训练 Loss Curve
Expert AdaLN 与 MMDiT、无 Expert AdaLN 的结构相比,在 FVD、CLIP4Clip 以及训练 Loss 上都表现更好。尤其是在与 Expert AdaLN 参数规模相近的 MMDiT1 对比中,结果说明并不一定需要两套独立 Transformer 才能处理文本和视觉模态。
3D Full Attention 换成 2D + 1D Attention 后,早期 FVD 明显恶化,而且训练容易发生不稳定甚至 Collapse。作者认为模型扩大到 5B 后,这种结构差异会更加明显。
3D-RoPE 相比 Sinusoidal Absolute Position Embedding 则表现出更快的 Loss 收敛。整体来看,这些消融不是简单证明“每个模块都有一点提升”,而是在回答三个不同问题:
Expert AdaLN 负责文本与视觉的模态融合;3D Full Attention 负责大运动下的时空一致性;3D-RoPE 和 Explicit Uniform Sampling 更多负责长序列建模和大规模训练稳定性。
5.6 代价:3D Full Attention 并不便宜
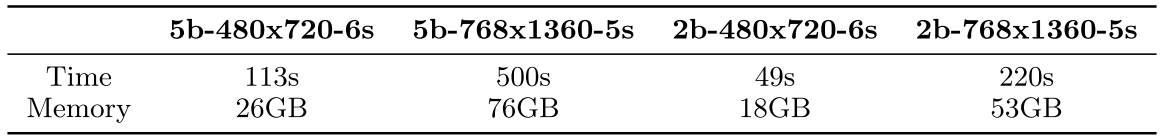
论文 Table 7:不同模型和分辨率下的推理时间与显存
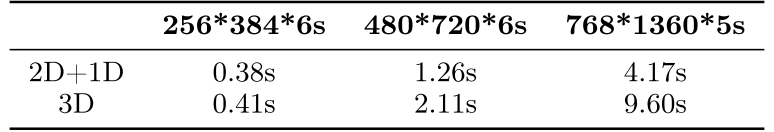
论文 Table 8:3D Full Attention 与 2D+1D Attention 推理时间比较
5B 模型生成 768 × 1360、5 秒视频,在论文测试环境下 50 步推理约需 500 秒、76 GB 显存;2B 对应约为 220 秒和 53 GB。
Attention 本身的代价也很明显:768 × 1360、5 秒条件下,一次 DiT Forward 中 2D+1D Attention 为 4.17 秒,而 3D Full Attention 达到 9.60 秒。
因此 CogVideoX 的核心取舍非常明确:作者用更昂贵的全时空 Attention 换取大运动视频的一致性,再通过 VAE 压缩、FlashAttention 和并行训练尽可能把成本控制下来。
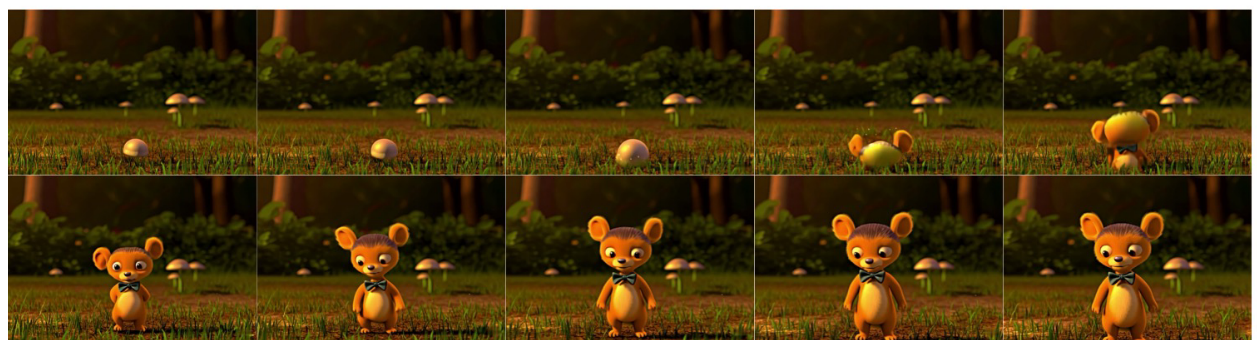
论文 Figure 11–12:Text-to-Video 生成案例
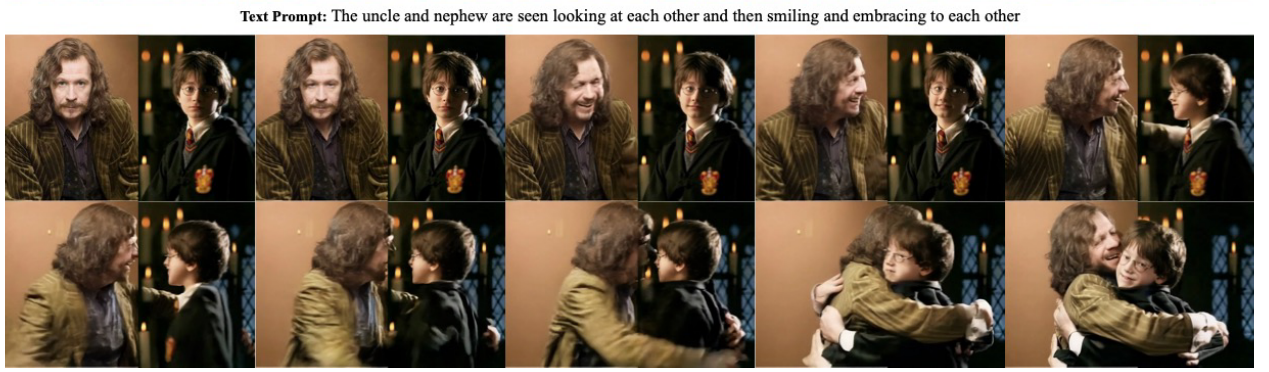
论文 Figure 13–14:Image-to-Video 生成案例
除了 Text-to-Video,作者还从已有 T2V 模型继续 Fine-tune Image-to-Video 模型。输入图像先通过 3D VAE,再与带噪视频 Latent 在 Channel 维度拼接;为了缓解训练时“视频首帧”和推理时“真实图片”之间的分布差异,训练阶段还会主动给图像条件加入较大的噪声。
六、总结与思考
如果把 CogVideoX 压缩成一句话,我认为它做的事情是:
把图像时代已经成熟的 Latent Diffusion + Transformer 路线真正扩展到“长时间、高分辨率、大运动”的视频场景,并围绕视频特有的时空问题重新设计 VAE、Attention、位置编码、训练方式和数据 Caption。
最值得记住的并不只是“5B 参数”或者“10 秒 768 × 1360”,而是四个更一般的经验。
首先,视频生成首先是一个压缩问题。 如果没有足够好的时空 VAE,Transformer 后面再强也会被 Token 数量拖垮。
其次,大运动要求真正的时空连接。 2D+1D Attention 的计算更加便宜,但当物体跨帧移动距离变大时,完整 3D Attention 提供了更直接的对应关系。
再次,多模态融合不一定意味着堆两套大模型。 CogVideoX 的 Expert AdaLN 表明,共享 Transformer 主体、只对模态相关归一化进行“专家化”,同样可以获得不错的文本—视觉融合效果。
最后,数据 Caption 本身就是模型能力的一部分。 如果训练文本只告诉模型“画面里有什么”,模型就很难学会“视频中发生了什么”。CogVideoX 的 Dense Caption Pipeline 实际上是在把视频的时间变化显式写进监督信号。
论文没有单独设置很长的 Limitations 章节,作者在 Conclusion 中主要强调下一步继续研究视频生成的 Scaling Law,并训练更大、更长、更高质量的模型。
从工程角度看,CogVideoX 当前最明显的代价仍然是计算量:3D Full Attention 在高分辨率长视频上的序列长度增长非常快,5B 模型的显存和推理时间也并不低。因此后续视频生成模型一个核心问题可能不是“还要不要扩大 Transformer”,而是如何在不失去全局时空建模能力的前提下,把长视频 Attention 做得更高效。
而 CogVideoX 给出的答案至少已经很清楚:对于视频生成,仅仅把文生图模型沿时间轴复制并不够。真正决定长视频质量的,是空间、时间、文本、数据和大规模训练系统能否同时被统一起来。


 扫一扫


CogVideoX:用 3D Causal VAE 与 Expert Transformer 生成长时、高动态视频&spm=1001.2101.3001.5002&articleId=165345747&d=1&t=3&u=9d1291439ab64fd1bd8f0c761196161b)

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


