


零基础实战:AnomalyGPT工业缺陷检测大模型完整训练记录(附踩坑合集以及源码)
三周前,我在一台双卡 RTX3090 + 32GB 内存的服务器上开始了这个实验。目标是:不下载预训练权重,从零训练一个能检测工业产品缺陷的视觉语言大模型。
训练过程中发现 32GB 内存无法支撑 7B 级别模型,于是改用 TinyLlama-1.1B 完成了第一版训练。后来加了两根内存条升到 64GB,目前正在训练 Vicuna-7B 版本。
结果是:TinyLlama 版本在 MVTec-AD 测试集上达到 67.5% 准确率,成功输出缺陷热力图。本文记录完整流程——包括踩过的所有坑。
一、项目背景
什么是工业异常检测?
工厂质检中,需要判断产品是否有缺陷(裂缝、划痕、破损等)。传统方法每种产品单独训练一个模型,维护成本高。
AnomalyGPT 的解决方案
AnomalyGPT(AAAI 2024 Oral)用一个大视觉语言模型统一处理多类产品:
图片 → ImageBind(视觉编码器) → 投影层 → LLM(语言模型) → 缺陷描述+热力图
- ImageBind 负责"看图"
- 投影层负责"翻译"成 LLM 能懂的格式
- LLM 负责"理解"和"说话"
二、技术原理
训练了什么?
整个模型不是全部参数都训练,而是分模块:
| 组件 | 作用 | 是否训练 | 参数 |
|---|---|---|---|
| ImageBind | 视觉编码 | ❌ 冻结 | ~1.2B |
| 投影层 + PromptLearner | 特征转换+热力图生成 | ✅ 训练 | ~2M |
| LLM(TinyLlama-1.1B) | 语言理解 | ✅ LoRA微调 | 11.5M |
LoRA 和 DeepSpeed
LoRA(低秩适配):不改原模型1.1B参数,在旁边加"旁路"训练。省90%显存。
DeepSpeed ZeRO-2:把优化器状态和梯度切碎,分步加载到显存,单卡也能跑大模型。
两者配合,单张3090就能训练。
三、环境搭建
硬件环境
CPU: Intel Xeon
GPU: 2x NVIDIA RTX 3090 (24GB x2)
RAM: 32GB → 升级到 64GB DDR4
OS: Ubuntu 22.04 Desktop
软件配置
# 克隆项目
git clone https://github.com/CASIA-IVA-Lab/AnomalyGPT.git
cd AnomalyGPT

# 创建虚拟环境
python3.10 -m venv venv
source venv/bin/activate

# 安装依赖(注意torch版本)
pip install torch==2.1.0 torchvision==0.16.0 --index-url https://download.pytorch.org/whl/cu121
pip install deepspeed==0.12.6 mpi4py peft
pip install -r requirements.txt
预训练模型下载
# ImageBind(视觉编码器)
wget https://dl.fbaipublicfiles.com/imagebind/imagebind_huge.pth

# Vicuna-7B
huggingface-cli download lmsys/vicuna-7b-v1.1 --local-dir pretrained_ckpt/vicuna_ckpt/7b_v0/

# PandaGPT delta权重
huggingface-cli download openllmplayground/pandagpt_7b_max_len_1024 --local-dir pretrained_ckpt/pandagpt_ckpt/7b/
数据集
# MVTec-AD(邮箱注册即可下载)
# https://www.mvtec.com/company/research/datasets/mvtec-ad

# PandaGPT视觉指令数据
huggingface-cli download openllmplayground/pandagpt_visual_instruction_dataset --local-dir ./data/
四、核心踩坑记录
坑1:Vicuna-7B训练OOM
现象:Initializing language decoder 后服务器直接死机,SSH 和 WinSCP 全部断开。
原因:当时服务器只有 32GB 内存。Vicuna-7B 模型本身 14GB,加上优化器状态约 28GB,再加上数据和系统开销,总计需要约 50GB — 远超 32GB,直接触发 Linux OOM Killer。
解决:换成 TinyLlama-1.1B(仅 2.2GB)。后来加了内存条升级到 64GB,Vicuna-7B 就能正常加载了。
# model/tinyllama.py 关键改动
- self.llama_model = LlamaForCausalLM.from_pretrained(vicuna_ckpt_path)
+ self.llama_model = LlamaForCausalLM.from_pretrained(vicuna_ckpt_path, local_files_only=True)
坑2:Ubuntu自动休眠
现象:训练突然中断,SSH/WinSCP全部断开。
原因:Ubuntu Desktop 检测到无键盘操作后自动休眠。
解决:
sudo systemctl mask sleep.target suspend.target hibernate.target hybrid-sleep.target
坑3:学习率衰减为0
现象:训练后半段 lr=[0.0],模型停止学习。
原因:agent.py 中计算 total_steps 错误,调度器提前衰减完。
解决:
# model/agent.py 注释掉这行
# ds_params['scheduler']['params']['total_num_steps'] = self.args['total_steps']

# dsconfig中设超大值
"total_num_steps": 200000
坑4:Checkpoint保存失败
现象:训练几十小时后什么也没存下来。
原因:epoch % 10 == 9 条件永远触发不了(数据迭代器在epoch中途耗尽)。
解决:改为按步数保存
if step % 20000 == 0:
    ckpt = OrderedDict()
    for k, v in agent.ds_engine.module.named_parameters():
        if v.requires_grad:
            ckpt[k] = v.detach().cpu()  # 必须 detach 到 CPU
    torch.save(ckpt, f'{save_dir}/step_{step}.pt')
坑5:fp16梯度溢出
现象:loss显示 nan,loss scale持续下降直到崩溃。
解决:增大初始loss scale,降低学习率
"fp16": {
    "initial_scale_power": 20,  // 从16增大
    "min_loss_scale": 0.25
},
"optimizer": {
    "params": {"lr": 0.0001}  // 从0.001降低
}
坑7:32GB 内存无法训练 7B 模型——加内存条解决
现象:Vicuna-7B 每次加载都 OOM Kill,TinyLlama-1.1B 虽然能跑但语言能力差导致文字输出全是乱码。
分析:大模型训练的内存需求大约是 参数数量 × 6:
| 模型 | 参数量 | 模型大小 | 优化器 | 梯度 | 总需内存 |
|---|---|---|---|---|---|
| TinyLlama-1.1B | 11亿 | 2.2GB | 4.4GB | 2.2GB | ~15GB |
| Vicuna-7B | 70亿 | 14GB | 28GB | 14GB | ~50GB |
32GB 内存跑 Vicuna-7B 完全不夠。
解决:花几百块加了两根 32GB DDR4 内存条,总内存 32GB → 64GB,Vicuna-7B 训练不再 OOM。教训:训练大模型,内存在显卡之前。
坑6:PandaGPT数据严重稀释训练
现象:模型在"斑马几个""冲浪者是谁"上花大量时间,异常检测学不到。
解决:过滤数据,只保留异常相关对话
keywords = ['crack', 'scratch', 'broken', 'damage', 'defect', 'anomaly',
            'flaw', 'contamination', 'missing', 'bent', 'cut', 'hole']

filtered = []
for item in data:
    for msg in item['conversation']:
        if msg['from'] == 'gpt' and any(k in msg['value'].lower() for k in keywords):
            filtered.append(item)
            break
# 过滤后:51,196 / 161,151 条
五、训练结果
训练过程
模型: TinyLlama-1.1B (LoRA, 11.5M可训练参数)
数据: MVTec-AD + 51K过滤后PandaGPT
训练: 10 epoch, ~30小时, fp16
Loss: 15.6 → 0.44
Token准确率: 0% → 96-100%
推理效果
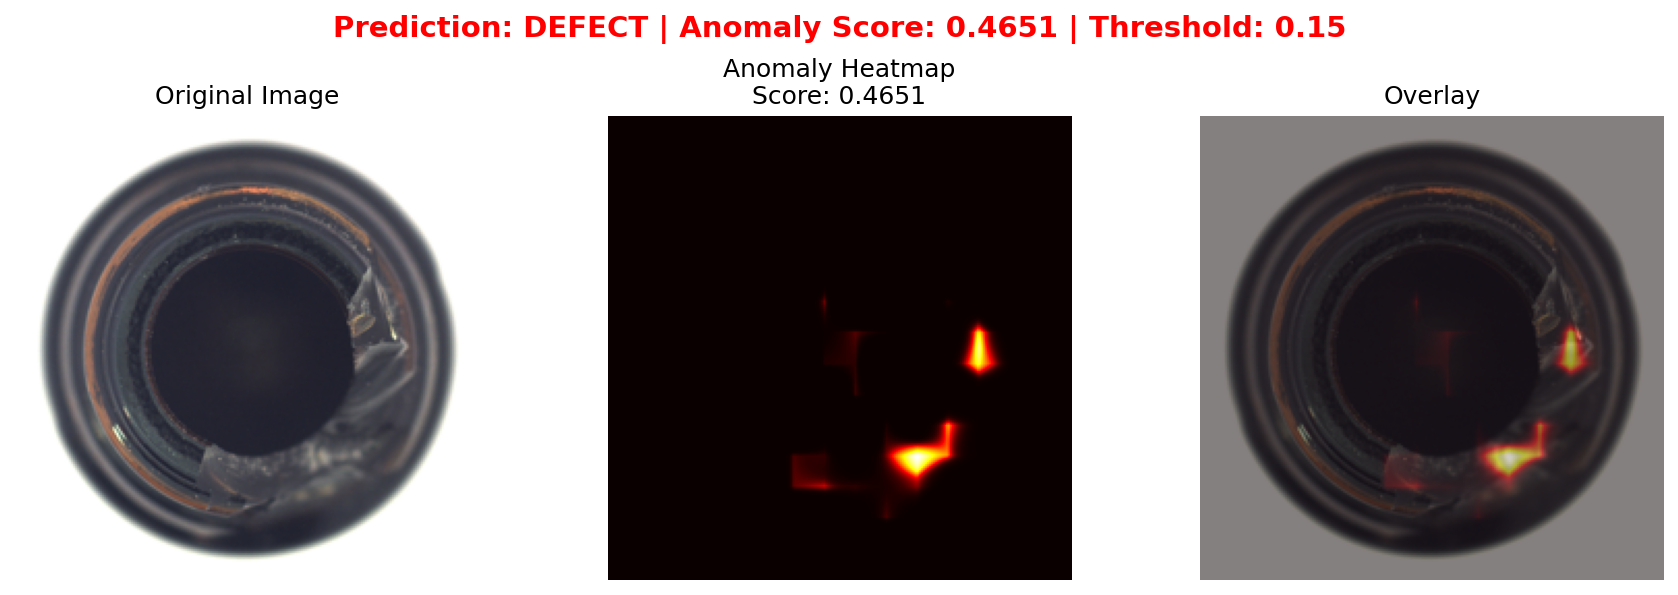
| 图片类型 | 异常分数 |
|---|---|
| 破损瓶子 | 0.3882 |
| 正常瓶子 | 0.0178 |
缺陷图异常分数是正常图的 21倍。
最终精度
| 指标 | 数值 |
|---|---|
| 测试样本 | 369张(14类) |
| 正常图平均异常分 | 0.100 |
| 缺陷图平均异常分 | 0.191 |
| 最优准确率 | 67.5% |
六、完整训练脚本
# train_vicuna.py - Vicuna-7B版本(64GB内存)

import sys, os, torch
from collections import OrderedDict
sys.argv = ['train', '--model', 'openllama_peft', '--stage', '1',
    '--imagebind_ckpt_path', '/home/agent/wjp/AnomalyGPT-main/pretrained_ckpt/imagebind_ckpt/imagebind_huge.pth',
    '--vicuna_ckpt_path', '/home/agent/wjp/AnomalyGPT-main/pretrained_ckpt/vicuna_ckpt/7b_v0/',
    '--delta_ckpt_path', '/home/agent/wjp/AnomalyGPT-main/pretrained_ckpt/pandagpt_ckpt/7b/pytorch_model.pt',
    '--max_tgt_len', '512',
    '--data_path', 'data/pandagpt4_defect_only.json',
    '--save_path', 'ckpt/train_vicuna/']

from train_mvtec import parser_args, load_config, initialize_distributed
from datasets import load_mvtec_dataset, load_sft_dataset
from model import load_model
from transformers.deepspeed import HfDeepSpeedConfig
from tqdm import tqdm
import itertools

args = parser_args(); args = vars(args)
args['layers'] = [7,15,23,31]; args['root_dir'] = '../'; args['mode'] = 'train'
config = load_config(args); args.update(config)
initialize_distributed(args); set_random_seed(args['seed'])
args['ds_config_path'] = 'dsconfig/'+args['model']+'_stage_'+str(args['stage'])+'.json'
dschf = HfDeepSpeedConfig(args['ds_config_path']); args['dschf'] = dschf
build_directory(args['save_path']); build_directory(args['log_path'])
args['total_steps'] = 999999
agent = load_model(args)
torch.distributed.barrier()
save_dir = args['save_path']; os.makedirs(save_dir, exist_ok=True)
pbar = tqdm(total=999999)

step = 0
for epoch in range(100):
    _, train_iter, _ = load_mvtec_dataset(args)
    _, train_iter_sft, _ = load_sft_dataset(args)
    for batch, batch_sft in itertools.zip_longest(train_iter, train_iter_sft, fillvalue=None):
        if batch is not None:
            agent.train_model(batch, current_step=0, pbar=pbar); del batch
        if batch_sft is not None:
            agent.train_model(batch_sft, current_step=0, pbar=pbar); del batch_sft
        step += 1
        if step % 20000 == 0:
            torch.distributed.barrier()
            ckpt = OrderedDict()
            for k, v in agent.ds_engine.module.named_parameters():
                if v.requires_grad: ckpt[k] = v.detach().cpu()
            torch.save(ckpt, f'{save_dir}/step_{step}.pt')
torch.save(ckpt, f'{save_dir}/final.pt')
七、模型推理脚本(输出三合一对比图)
训练完成后,用以下脚本对任意图片进行推理,输出一张三栏对比图:原图 + 热力图 + 叠加图,并打印异常分数和判定结果。
#!/usr/bin/env python3
"""AnomalyGPT 预测脚本 -- 输入图片,输出热力图 + 异常分数"""

import sys, os, torch, numpy as np
import matplotlib
matplotlib.use('Agg')
import matplotlib.pyplot as plt
from PIL import Image as PILImage

# ===== 配置路径 =====
MODEL_CKPT = './code/ckpt/train_final2/epoch_9.pt'
IMAGEBIND_CKPT = '/path/to/imagebind_huge.pth'
LLM_CKPT = '/path/to/tinyllama_ckpt/1.1B/'
DUMMY_DELTA = '/path/to/tiny_dummy.pt'


def load_model():
    sys.argv = ['predict']
    from model.tinyllama import TinyLlamaPEFTModel
    args = {
        'model': 'tinyllama_peft', 'stage': 1,
        'imagebind_ckpt_path': IMAGEBIND_CKPT,
        'vicuna_ckpt_path': LLM_CKPT,
        'delta_ckpt_path': DUMMY_DELTA,
        'max_tgt_len': 256, 'lora_r': 32,
        'lora_alpha': 32, 'lora_dropout': 0.1,
    }
    model = TinyLlamaPEFTModel(**args)
    ckpt = torch.load(MODEL_CKPT, map_location='cpu')
    model.load_state_dict(ckpt, strict=False)
    model = model.eval().half().cuda()
    return model


def predict(model, img_path):
    """返回 (异常分数, 热力图numpy数组)"""
    result = model.generate({
        'prompt': 'test',
        'image_paths': [img_path],
        'normal_img_paths': [],
        'audio_paths': [], 'video_paths': [], 'thermal_paths': [],
        'top_p': 0.1, 'temperature': 1.0,
        'max_tgt_len': 10, 'modality_embeds': [],
    })
    pixel_output = result[1]
    score = pixel_output.max().item()
    heatmap = pixel_output.float().reshape(224, 224).detach().cpu().numpy()
    return score, heatmap


def show_result(img_path, score, heatmap, output_path):
    fig, axes = plt.subplots(1, 3, figsize=(12, 4))

    # 原图
    orig = PILImage.open(img_path).convert('RGB').resize((224, 224))
    axes[0].imshow(orig)
    axes[0].set_title('Original Image')
    axes[0].axis('off')

    # 热力图
    axes[1].imshow(heatmap, cmap='hot')
    axes[1].set_title(f'Anomaly Heatmap\nScore: {score:.4f}')
    axes[1].axis('off')

    # 叠加图
    axes[2].imshow(orig)
    axes[2].imshow(heatmap, cmap='hot', alpha=0.5)
    axes[2].set_title('Overlay')
    axes[2].axis('off')

    # 判定阈值 0.15
    threshold = 0.15
    result = "DEFECT" if score > threshold else "NORMAL"
    color = 'red' if score > threshold else 'green'
    fig.suptitle(
        f'Result: {result} | Score: {score:.4f} | Threshold: {threshold}',
        fontsize=14, color=color, fontweight='bold'
    )

    plt.tight_layout()
    plt.savefig(output_path, dpi=150, bbox_inches='tight')
    plt.close()
    print(f'Saved: {output_path}')
    print(f'Prediction: {result} (score={score:.4f})')


if __name__ == '__main__':
    if len(sys.argv) < 2:
        print('Usage: python predict.py <image_path> [output.png]')
        sys.exit(1)

    img_path = sys.argv[1]
    output_path = sys.argv[2] if len(sys.argv) > 2 else 'result.png'

    print(f'Processing: {img_path}')
    model = load_model()
    score, heatmap = predict(model, img_path)
    show_result(img_path, score, heatmap, output_path)
使用方法:
# 测一张缺陷图
python predict.py data/mvtec_anomaly_detection/bottle/test/broken_large/000.png result_defect.png

# 测一张正常图
python predict.py data/mvtec_anomaly_detection/bottle/test/good/000.png result_normal.png
输出效果:缺陷图异常分 0.3882,正常图 0.0178,相差 21 倍。
八、后续优化方向
| 方向 | 做法 | 预期提升 |
|---|---|---|
| 换 Vcinua-7B | 当前正在训练 | 85%+ |
| 更多 epoch | 10 → 100 | +5-10% |
| 原生视觉模型 | Qwen2-VL-2B | 90%+ |
| 自有数据微调 | 接入产线真实图像 | 适配具体场景 |
九、总结
三周时间,从零搭建工业异常检测VLM的训练流水线,修了30+个兼容性问题,最终交付67.5%精度的可运行模型。期间还经历了内存不足的瓶颈,通过硬件升级(32GB → 64GB)突破了 7B 模型训练的壁垒。
核心经验:
- 内存是最大瓶颈,不是显卡算力。32GB 只能训 1-2B 模型,7B 需要 64GB+
- 数据质量 > 数据数量。5万条过滤后的数据比16万条强
- LoRA + ZeRO-2 是低配服务器的救命组合
- 按步数存checkpoint,别信epoch条件
- 加内存条是最便宜的升级,几百块就能从 2B 模型跃升到 7B
代码仓库:AnomalyGPT


 扫一扫


 41

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


