


一、Redis简介
随着互联网+和大数据时代的来临,传统的关系型数据库已经不能满足中大型网站日益增长的访问量和数据量,这个时候就需要一种能够快速存取数据的组件来缓解数据库服务I/O的压力 ,来解决系统性能上的瓶颈。
1、redis特点
1、Redis支持数据的持久化,可以将内存中的数据保存在磁盘中,重启的时候可以再次加载进行使用。
2、Redis不仅仅支持简单的key-value类型的数据,同时还提供字符串(strings)、lists(列表)、sets(集合)和zsets(有序集合)、散列(hash)等数据结构的存储。
3、Redis支持数据的备份,即master-slave模式的数据备份。
4、性能极高:Redis能读的速度是110000次/s,写的速度是81000次/s 。
5、原子性:Redis的所有操作都是原子性的,意思就是要么成功执行要么失败完全不执行。单个操作是原子性的。多个操作也支持事务,即原子性,通过MULTI和EXEC指令包起来。
6、丰富的特性:Redis还支持 publish(发布)/subscribe(订阅), 通知, key 过期等等特性。
2、redis持久化
由于Redis的数据都存放在内存中,如果没有配置持久化,redis重启后数据就全丢失了,于是需要开启redis的持久化功能,将数据保存到磁盘上,当redis重启后,可以从磁盘中恢复数据。redis提供两种方式进行持久化:
一种是RDB持久化,原理是将Reids在内存中的数据定时dump到磁盘上。性能高,但可能会引起一定程度的数据丢失。
另外一种是AOF(append only file)持久化,原理是将Redis的操作日志以追加的方式写入文件,类似mysql的binlog,记录每次更新的日志。
3、redis架构方案
redis单机模式
Redis单机模式,采用单个Redis节点部署架构,没有备用节点实时同步数据,不提供数据持久化和备份策略,适用于数据可靠性要求不高的纯缓存业务场景。
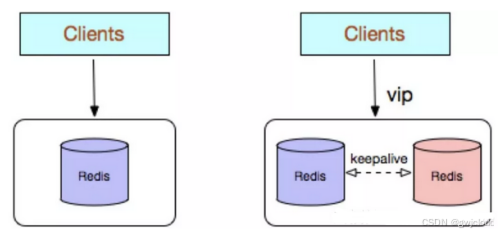
优点:
• 架构简单,部署方便;
• 高性价比:缓存使用时无需备用节点(单实例可用性可以用supervisor或crontab保证),当然为了满足业务的高可用性,也可以牺牲一个备用节点,但同时刻只有一个实例对外提供服务;
缺点:
• 不保证数据的可靠性;
• 在缓存使用,进程重启后,数据丢失,即使有备用的节点解决高可用性,但是仍然不能解决缓存预热问题,因此不适用于数据可靠性要求高的业务;
• 高性能受限于单核CPU的处理能力(Redis是单线程机制),CPU为主要瓶颈,所以适合操作命令简单,排序、计算较少的场景。也可以考虑用Memcached替代。
redis多副本(主从)
Redis多副本,采用主从(replication)部署结构,相较于单副本而言最大的特点就是主从实例间数据实时同步,并且提供数据持久化和备份策略。主从实例部署在不同的物理服务器上,根据公司的基础环境配置,可以实现同时对外提供服务和读写分离策略。
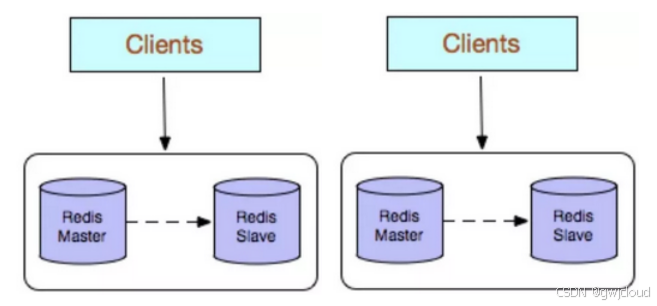
redis sentiel(哨兵模式)
当用Redis做Master-slave的高可用方案时,假如master宕机了,Redis本身(包括它的很多客户端)没有实现自动进行主备切换,需要手动把一台从服务器切换为主服务器,这就需要人工干预,费事费力,还会造成一段时间内服务不可用。这不是一种推荐的方式,更多时候,我们优先考虑哨兵模式。
Redis Sentinel是社区版本推出的原生高可用解决方案,其部署架构主要包括两部分:Redis Sentinel集群和Redis数据集群。
而Redis-sentinel本身也是一个独立运行的进程,它能监控多个master-slave集群,发现master宕机后能进行切换。redis-Sentinel(哨兵模式)是Redis官方推荐的高可用性(HA)解决方案。
sentinel是redis高可用的解决方案,sentinel系统可以监视一个或者多个redis master服务,以及这些master服务的所有从服务;当某个master服务下线时,自动将该master下的某个从服务升级为master服务替代已下线的master服务继续处理请求。
sentinel可以让redis实现主从复制,当一个集群中的master失效之后,sentinel可以选举出一个新的master用于自动接替master的工作,集群中的其他redis服务器自动指向新的master同步数据。一般建议sentinel采取奇数台(Redis Sentinel的节点数量要满足2n+1(n>=1)的奇数个,官方建议至少3个),防止某一台sentinel无法连接到master导致误切换。其结构如下:
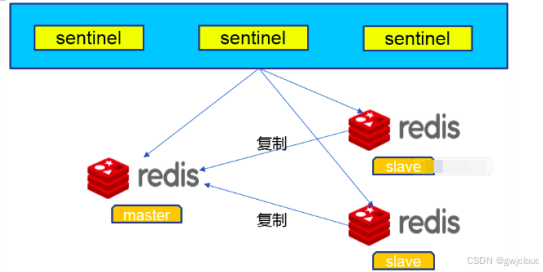
Sentinel由一个或多个Sentinel 实例组成的Sentinel 系统可以监视任意多个主服务器,以及这些主服务器属下的所有从服务器,并在被监视的主服务器进入下线状态时,自动将下线主服务器属下的某个从服务器升级为新的主服务器。
选出新的master节点,redis sentinel会选一个合适的slave来升级为master,那么,如何选择一个合适的slave呢?顺序如下:
1). 选择slave-priority最低的slave节点(默认是相同)。
2). 选择复制偏移量最大的节点。
3). 如果以上两个条件都不满足,选runId最小的(启动最早的)。
redis-cluster(集群模式)
Redis Sentinel集群模式中,随着业务量和数据量增到性能达到redis单节点瓶颈,垂直扩容受机器限制,水平扩容涉及对应用的影响以及数据迁移中数据丢失风险。针对这些痛点,Redis3.0推出cluster分布式集群方案,当遇到单节点内存,并发,流量瓶颈时,采用cluster方案实现负载均衡。
Redis Cluster有效地解决了 Redis 分布式方面的需求。分布式数据存储方案中最为重要的一点就是数据分片,也就是所谓的 Sharding。
为了使得集群能够水平扩展,首要解决的问题就是如何将整个数据集按照一定的规则分配到多个节点上,常用的数据分片的方法有:范围分片,哈希分片,一致性哈希算法,哈希槽等。
Redis Cluster 采用虚拟哈希槽分区,所有的键根据哈希函数映射到 0 ~ 16383 整数槽内,计算公式:slot = CRC16(key) & 16383。每一个节点负责维护一部分槽以及槽所映射的键值数据。
下图展现一个五个节点构成的集群,每个节点平均大约负责3276个槽,以及通过计算公式映射到对应节点的对应槽的过程。
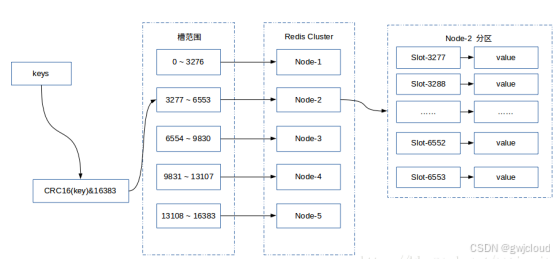
Redis Cluster 一般由多个节点组成,节点数量至少为 6 个才能保证组成完整高可用的集群,其中三个为主节点,三个为从节点。三个主节点会分配槽,处理客户端的命令请求,而从节点可用在主节点故障后,顶替主节点。
一般来说,主 Redis 节点会处理 Clients 的读写操作,而从节点只处理读操作。
二、redis部署
1、redis单机模式
部署redis
#上传软件包 没有从redis官网下载
[root@localhost ~]# ll
total 1940
-rw-------. 1 root root    1508 Mar  5 14:03 anaconda-ks.cfg
-rw-r--r--  1 root root 1975750 Mar 20 09:41 redis-5.0.5.tar.gz
[root@localhost ~]# tar -zxvf redis-5.0.5.tar.gz

#安装gcc编译工具进行编译
[root@localhost ~]# yum -y install gcc
[root@localhost ~]# cd redis-5.0.5
[root@localhost redis-5.0.5]# make
[root@localhost redis-5.0.5]# cd src/
[root@localhost src]# make install PREFIX=/usr/local/redis
[root@localhost src]# cd ..

#创建redis配置文件目录
[root@localhost redis-5.0.5]# mkdir /usr/local/redis/etc
[root@localhost redis-5.0.5]# cp redis.conf /usr/local/redis/etc/

#启动redis
[root@localhost redis-5.0.5]# /usr/local/redis/bin/redis-server /usr/local/redis/etc/redis.conf
5539:C 20 Mar 2026 09:47:59.818 # oO0OoO0OoO0Oo Redis is starting oO0OoO0OoO0Oo
5539:C 20 Mar 2026 09:47:59.818 # Redis version=5.0.5, bits=64, commit=00000000, modified=0, pid=5539, just started
5539:C 20 Mar 2026 09:47:59.818 # Configuration loaded
5539:M 20 Mar 2026 09:47:59.820 * Increased maximum number of open files to 10032 (it was originally set to 1024).
                _._
           _.-``__ ''-._
      _.-``    `.  `_.  ''-._           Redis 5.0.5 (00000000/0) 64 bit
  .-`` .-```.  ```\/    _.,_ ''-._
 (    '      ,       .-`  | `,    )     Running in standalone mode
 |`-._`-...-` __...-.``-._|'` _.-'|     Port: 6379
 |    `-._   `._    /     _.-'    |     PID: 5539
  `-._    `-._  `-./  _.-'    _.-'
 |`-._`-._    `-.__.-'    _.-'_.-'|
 |    `-._`-._        _.-'_.-'    |           http://redis.io
  `-._    `-._`-.__.-'_.-'    _.-'
 |`-._`-._    `-.__.-'    _.-'_.-'|
 |    `-._`-._        _.-'_.-'    |
  `-._    `-._`-.__.-'_.-'    _.-'
      `-._    `-.__.-'    _.-'
          `-._        _.-'
              `-.__.-'

5539:M 20 Mar 2026 09:47:59.821 # WARNING: The TCP backlog setting of 511 cannot be enforced because /proc/sys/net/core/somaxconn is set to the lower value of 128.
5539:M 20 Mar 2026 09:47:59.821 # Server initialized
5539:M 20 Mar 2026 09:47:59.821 # WARNING overcommit_memory is set to 0! Background save may fail under low memory condition. To fix this issue add 'vm.overcommit_memory = 1' to /etc/sysctl.conf and then reboot or run the command 'sysctl vm.overcommit_memory=1' for this to take effect.
5539:M 20 Mar 2026 09:47:59.821 # WARNING you have Transparent Huge Pages (THP) support enabled in your kernel. This will create latency and memory usage issues with Redis. To fix this issue run the command 'echo never > /sys/kernel/mm/transparent_hugepage/enabled' as root, and add it to your /etc/rc.local in order to retain the setting after a reboot. Redis must be restarted after THP is disabled.
5539:M 20 Mar 2026 09:47:59.821 * Ready to accept connections

可以看到以上有告警
解决方法
执行ulimit -n查看当前用户打开的最大文件数
[root@localhost redis-5.0.5]# ulimit -n
1024
[root@localhost redis-5.0.5]# vim /etc/security/limits.conf
*               soft    nofile          10032
*               hard    nofile          10032
[root@localhost redis-5.0.5]# vim /etc/pam.d/login
session    required     /usr/lib64/security/pam_limits.so

重新登录使修改生效
[root@localhost ~]# ulimit -n
10032
[root@localhost ~]# vim /etc/sysctl.conf
net.core.somaxconn=511
vm.overcommit_memory=1

[root@localhost ~]# sysctl -p
net.core.somaxconn = 511
vm.overcommit_memory = 1

启动
[root@localhost ~]# echo "never" > /sys/kernel/mm/transparent_hugepage/enabled
[root@localhost ~]# /usr/local/redis/bin/redis-server /usr/local/redis/etc/redis.conf
注:默认redis是在前台终端运行
修改后台运行
[root@localhost ~]# vim /usr/local/redis/etc/redis.conf
daemonize yes   #修改no为yes
bind 127.0.0.1 192.168.1.111   #默认监控127.0.0.1 添加本机IP 192.168.1.111

#启动
[root@localhost ~]# /usr/local/redis/bin/redis-server /usr/local/redis/etc/redis.conf
5743:C 20 Mar 2026 10:05:00.899 # oO0OoO0OoO0Oo Redis is starting oO0OoO0OoO0Oo
5743:C 20 Mar 2026 10:05:00.899 # Redis version=5.0.5, bits=64, commit=00000000, modified=0, pid=5743, just started
5743:C 20 Mar 2026 10:05:00.899 # Configuration loaded

#查看端口和进程
[root@localhost ~]# netstat -anptl | grep redis
tcp        0      0 192.168.1.100:6379      0.0.0.0:*               LISTEN      5744/redis-server 1
tcp        0      0 127.0.0.1:6379          0.0.0.0:*               LISTEN      5744/redis-server 1
[root@localhost ~]# ps -ef | grep redis
root       5744      1  0 10:05 ?        00:00:00 /usr/local/redis/bin/redis-server 127.0.0.1:6379
root       5753   5703  0 10:05 pts/0    00:00:00 grep --color=auto redis

停止Redis
[root@localhost ~]# /usr/local/redis/bin/redis-cli shutdown

#把redis命令添加到PATH变量中
[root@localhost ~]# ln -s /usr/local/redis/bin/* /usr/local/bin/
#添加为开机自启动
[root@localhost ~]# echo "/usr/local/redis/bin/redis-server /usr/local/redis/etc/redis.conf" >> /etc/rc.d/rc.local
[root@localhost ~]# chmod +x /etc/rc.d/rc.local
配置文件详解
#是否作为守护进程运行

daemonize yes

#如以后台进程运行,则需指定一个pid,默认为/var/run/redis.pid

pidfile redis.pid

#绑定主机IP,默认值为127.0.0.1

#bind 127.0.0.1

#Redis默认监听端口

port 6379

#客户端闲置多少秒后,断开连接,默认为300(秒)

timeout 300

#日志记录等级,有4个可选值,debug,verbose(默认值),notice,warning

loglevel verbose

#指定日志输出的文件名,默认值为stdout,也可设为/dev/null屏蔽日志

logfile stdout

#可用数据库数,默认值为16,默认数据库为0

databases 16

#保存数据到disk的策略

#当至少有一条Key数据被改变时,900秒刷新到disk一次

save 900 1

#当至少有10条Keys数据被改变时,300秒刷新到disk一次

save 300 10

#当至少有1w条keys数据被改变时,60秒刷新到disk一次

save 60 10000

#当dump .rdb数据库的时候是否压缩数据对象

rdbcompression yes

#存储和加载rdb文件时校验

rdbchecksum yes

#本地数据库文件名,默认值为dump.rdb

dbfilename dump.rdb

#后台存储错误停止写。

stop-writes-on-bgsave-error yes

#本地数据库存放路径(存放rdb文件和aof文件),默认值为 ./

dir /var/lib/redis/

########### Replication #####################

#Redis的复制配置

# replicaof <masterip> <masterport> 当本机为从服务时,设置主服务的IP及端口

# masterauth <master-password> 当本机为从服务时,设置主服务的连接密码

#连接密码

# requirepass foobared

#最大客户端连接数,默认不限制

# maxclients 128

#最大内存使用设置,达到最大内存设置后,Redis会先尝试清除已到期或即将到期的Key,当此方法处理后,一旦到达最大内存设置,将无法再进行写入操作。

# maxmemory <bytes>

#是否在每次更新操作后进行日志记录,如果不开启,可能会在断电时导致一段时间内的数据丢失。因为redis本身同步数据文件是按上面save条件来同步的,所以有的数据会在一段时间内只存在于内存中。默认值为no

appendonly no

#更新日志文件名,默认值为appendonly.aof

#appendfilename "appendonly.aof"

#更新日志条件,共有3个可选值。no表示等操作系统进行数据缓存同步到磁盘,always表示每次更新操作后调用fsync()将数据写到磁盘,everysec表示每秒同步一次(默认值)。

# appendfsync always

appendfsync everysec

# appendfsync no

#当slave失去与master的连接,或正在拷贝中,如果为yes,slave会响应客户端的请求,数据可能不同步甚至没有数据,如果为no,slave会返回错误"SYNC with master in progress"

replica -serve-stale-data yes

#如果为yes,slave实例只读,如果为no,slave实例可读可写。

replica -read-only yes

# 在slave和master同步后(发送psync/sync),后续的同步是否设置成TCP_NODELAY . 假如设置成yes,则redis会合并小的TCP包从而节省带宽,但会增加同步延迟(40ms),造成master与slave数据不一致  假如设置成no,则redis master会立即发送同步数据,没有延迟

repl-disable-tcp-nodelay no

#如果master不能再正常工作,那么会在多个slave中,选择优先值最小的一个slave提升为master,优先值为0表示不能提升为master。

replica-priority 100
#### LIMITS ####

maxclients 10000    #客户端并发连接数的上限是10000,到达上限,服务器会关闭所有新连接并返回错误"max number of clients reached"

maxmemory 15G    #设置最大内存,到达上限,服务器会根据驱逐政策(eviction policy)删除某些键值,如果政策被设置为noeviction,那么redis只读,对于增加内存的操作请求返回错误。

#### APPEND ONLY MODE ####

appendonly no    #redis默认采用快照(snapshotting)异步转存到硬盘中,它是根据save指令来触发持久化的,当Redis异常中断或停电时,可能会导致最后一些写操作丢失。AOF(Append Only File,只追加文件)可以提供更好的持久性,结合apendfsync指令可以把几分钟的数据丢失降至一秒钟的数据丢失,它通过日志把所有的操作记录下来,AOF和RDB持久化可以同时启动。

appendfilename appendonly.aof    #指定aof的文件名。

apendfsync always|everysec|no    #调用fsync()写数据到硬盘中,always是每一次写操作就马上同步到日志中,everysec是每隔一秒强制fsync,no是不调用fsync(),让操作系统自己决定何时同步。

no-appendfsync-on-rewrite no    #如果为yes,当BGSAVE或BGREWRITEAOF指令运行时,即把AOF文件转写到RDB文件中时,会阻止调用fsync()。

auto-aof-rewrite-percentage 100

auto-aof-rewrite-min-size 64mb    #Redis会将AOF文件最初的大小记录下来,如果当前的AOF文件的大小增加100%并且超过64mb时,就会自动触发Redis改写AOF文件到RDB文件中,如果auto-aof-rewrite-percentage为0表示取消自动rewrite功能。

#### LUA SCRIPTING ####

lua-time-limit 5000    #一个Lua脚本最长的执行时间为5000毫秒(5秒),如果为0或负数表示无限执行时间。

#### SLOW LOG ####

slowlog-log-slower-than 10000    #当某个请求执行时间(不包括IO时间)超过10000微妙(10毫秒),把请求记录在慢日志中 ,如果为负数不使用慢日志,如果为0强制记录每个指令。

slowlog-max-len 128    #慢日志的最大长度是128,当慢日志超过128时,最先进入队列的记录会被踢出来,慢日志会消耗内存,你可以使用SLOWLOG RESET清空队列回收这些内存。

#### ADVANCED CONFIG ####

hash-max-ziplist-entries 512

hash-max-ziplist-value 64    #较小的hash可以通过某种特殊的方式进行编码,以节省大量的内存空间,我们指定最大的条目数为512,每个条目的最大长度为64。

list-max-ziplist-entries 512

list-max-ziplist-value 64    #同上。

zset-max-ziplist-entries 128

zset-max-ziplist-value 64    #同上。

activerehashing yes    #重新哈希the main Redis hash table(the one mapping top-level keys to values),这样会节省更多的空间。

client-output-buffer-limit normal 0 0 0    #对客户端输出缓冲进行限制可以强迫那些就不从服务器读取数据的客户端断开连接。对于normal client,第一个0表示取消hard limit,第二个0和第三个0表示取消soft limit,normal client默认取消限制,因为如果没有寻问,他们是不会接收数据的。

client-output-buffer-limit slave 256mb 64mb 60    #对于slave client和MONITER client,如果client-output-buffer一旦超过256mb,又或者超过64mb持续60秒,那么服务器就会立即断开客户端连接。

client-output-buffer-limit pubsub 32mb 8mb 60    #对于pubsub client,如果client-output-buffer一旦超过32mb,又或者超过8mb持续60秒,那么服务器就会立即断开客户端连接。

#### INCLUDES ####

include /path/to/conf    #包含一些可以重用的配置文件。

hz 10  #Redis 调用内部函数来执行后台task,比如关闭已经timeout连接,删除过期的keys并且永远不会被访问到的,执行频率根据 hz 后面的值来确定。在Redis 比较空闲的时候,提高这个值,能充分利用CPU,让Redis相应速度更快,可取范围是1-500 ,建议值为 1--100

aof-rewrite-incremental-fsync yes  # 当子进程重写AOF文件,以下选项开启时,AOF文件会每产生32M数据同步一次。这有助于更快写入文件到磁盘避免延迟

################ VIRTUAL MEMORY ###########

#是否开启VM功能,默认值为no

vm-enabled no

# vm-enabled yes

#虚拟内存文件路径,默认值为/tmp/redis.swap,不可多个Redis实例共享

vm-swap-file /tmp/redis.swap

#将所有大于vm-max-memory的数据存入虚拟内存,无论vm-max-memory设置多小,所有索引数据都是内存存储的 (Redis的索引数据就是keys),也就是说,当vm-max-memory设置为0的时候,其实是所有value都存在于磁盘。默认值为0。

vm-max-memory 0

vm-page-size 32

vm-pages 134217728

vm-max-threads 4

############# ADVANCED CONFIG ###############

glueoutputbuf yes

hash-max-zipmap-entries 64

hash-max-zipmap-value 512

#是否重置Hash表

activerehashing yes
redis数据储存
redis的存储分为内存存储、磁盘存储和log文件三部分,配置文件中有三个参数对其进行配置。
save seconds updates:save配置,指出在多长时间内,有多少次更新操作,就将数据同步到数据文件。这个可以多个条件配合,比如默认配置文件中的设置,就设置了三个条件。
appendonly yes/no :appendonly配置,指出是否在每次更新操作后进行日志记录,如果不开启,可能会在断电时导致一段时间内的数据丢失。因为redis本身同步数据文件是按上面的save条件来同步的,所以有的数据会在一段时间内只存在于内存中。
appendfsync no/always/everysec :appendfsync配置,no表示等操作系统进行数据缓存同步到磁盘,always表示每次更新操作后调用fsync()将数据写到磁盘,everysec表示每秒同步一次。
redis认证
[root@localhost ~]# vim /usr/local/redis/etc/redis.conf
# requirepass foobared		//启用此项,并指定密码即可
requirepass 123456

#重启redis
[root@localhost ~]# redis-cli shutdown
[root@localhost ~]# redis-server /usr/local/redis/etc/redis.conf
5761:C 20 Mar 2026 10:20:50.057 # oO0OoO0OoO0Oo Redis is starting oO0OoO0OoO0Oo
5761:C 20 Mar 2026 10:20:50.058 # Redis version=5.0.5, bits=64, commit=00000000, modified=0, pid=5761, just started
5761:C 20 Mar 2026 10:20:50.058 # Configuration loaded
测试
[root@localhost ~]# redis-cli
127.0.0.1:6379> select 1
(error) NOAUTH Authentication required. #提示需要密码
127.0.0.1:6379> auth 123456 #输入认证密码
OK
127.0.0.1:6379> select 1
OK
127.0.0.1:6379[1]> exit
或者登录的时候指定密码 提示不建议这样使用密码
[root@localhost ~]# redis-cli -a 123456
Warning: Using a password with '-a' or '-u' option on the command line interface may not be safe.
127.0.0.1:6379> select 1
OK
127.0.0.1:6379[1]> exitredis命令
官网命令网址:https://www.redis.net.cn/order/3533.html
1、常规命令
[root@localhost ~]# redis-cli -h 192.168.1.100 -p 6379 -a 123456
Warning: Using a password with '-a' or '-u' option on the command line interface may not be safe.
192.168.1.100:6379> set myname breey  #插入值
OK
192.168.1.100:6379> get myname        #获取值
"breey"
192.168.1.100:6379> set foo bar
OK
192.168.1.100:6379> keys *            #获取所有key
1) "myname"
2) "foo"
2、set
192.168.1.111:6379> help set  #查询set帮助
  SET key value [expiration EX seconds|PX milliseconds] [NX|XX]
//命令 键 值 [EX 过期时间,单位秒]
NX:如果一个键不存在,才创建并设定值,否则不允许设定
XX:如果一个键存在则设置建的值,如果不存在则不创建并不设置其值
  summary: Set the string value of a key
  since: 1.0.0
  group: string
举例:
192.168.1.100:6379> set cjk aaa
OK
192.168.1.100:6379> set cjk bbb NX
(nil)             #反回提示一个没能执行的操作
192.168.1.100:6379> get cjk
"aaa"
192.168.1.100:6379> set foo abc XX  #设置foo key值,foo之前存在
OK              #修改成功
192.168.1.100:6379> get foo
"abc"
3、get
192.168.1.100:6379> help get  #查询get帮助
  GET key
  summary: Get the value of a key
  since: 1.0.0
  group: string
4、append
192.168.1.100:6379> help APPEND  #查询string组中APPEND命令帮助
  APPEND key value
  summary: Append a value to a key
  since: 2.0.0
  group: string
append添加键中的值(在原有键中附加值的内容):

192.168.1.100:6379> append cjk fda
(integer) 6
192.168.1.100:6379> get cjk
"aaafda"
5、strlen
获取键中值的长度
192.168.1.100:6379> strlen cjk
(integer) 6
6、del
# 删除key
192.168.1.100:6379> del cjk
(integer) 1
192.168.1.100:6379> get cdk
(nil)
7、列表
键指向一个列表,而列表可以理解为是一个字符串的容器,列表是有众多元素组成的集合,可以在键所指向的列表中附加一个值
LPUSH	//在键所指向的列表前面插入一个值(左边加入)
RPUSH	//在键所指向的列表后面附加一个值(右边加入)
LPOP	//在键所指向的列表前面弹出一个值(左边弹出)
RPOP	//在键所指向的列表后面弹出一个值(右边弹出)
LINDEX	//根据索引获取值,指明索引位置进行获取对应的值
LSET	//用于修改指定索引的值为指定的值
创建一个新的列表,在帮助中并没产明哪个命令用于创建一个新的列表,实际上创建一个新的列表使用LPUSH或RPUSH都可以。
192.168.1.100:6379> lpush ll cjk    # ll为列表名称,cjk为值
(integer) 1
192.168.1.100:6379> lindex ll 0     #第一个索引(值)则为0
"cjk"
在原有的列表中的左侧加入一个值
192.168.1.100:6379> lpush ll fda    #在原有的列表中的左侧加入一个值
(integer) 2
192.168.1.100:6379> lindex ll 0
"fda"
192.168.1.100:6379> lindex ll 1
"cjk"
在原有的列表中的右侧加入一个值
192.168.1.100:6379> rpush ll www
(integer) 3
192.168.1.100:6379> lindex ll 2
"www"
192.168.1.100:6379> lindex ll 1
"cjk"
192.168.1.100:6379> lindex ll 0
"fda"


修改一个已有的列表中的值:
192.168.1.100:6379> lset ll 0 abc
OK
192.168.1.100:6379> lindex ll 0
"abc"
查看列表中的值的数量
192.168.1.100:6379> llen ll
(integer) 3
在已有的列表中右侧弹出(删除)一个值
192.168.1.100:6379> rpop ll
"www"
在已有的列表中左侧弹出(删除)一个值
192.168.1.100:6379> lpop ll
"abc"
192.168.1.100:6379> lpop ll
"cjk"
192.168.1.100:6379> lpop ll
(nil)
清空数据库
FLUSHDB:删除当前选择的数据库所有key
FLUSHALL:清空所有库
192.168.1.100:6379> flushdb
OK
8、设置key的过期时间
Redis PEXPIREAT 命令用于设置 key 的过期时间,以毫秒计。key 过期后将不再可用。
实例:
首先创建一个 key 并赋值:
192.168.1.100:6379> set w3 redis   #创建一条记录
OK
192.168.1.100:6379> EXPIRE w3 4
(integer) 1
192.168.1.100:6379> keys *
1) "myset"
2) "book_list"
3) "myname"
redis数据持久化
1、持久化概述
默认情况下,redis工作时所有数据都是存储于内存中的,不论是否有磁盘上的持久化数据,都是工作于内存当中,redis本身就是一个内存的数据库,如果redis崩溃或断电导致所有数据丢失,所以redis提供了持久化功能来保证数据的可靠性,redis持久化有两种实现:RDB和AOF
2、RDB
RDB持久化是指在指定的时间间隔内将内存中的数据集快照写入磁盘,实际操作过程是fork一个子进程,先将数据集写入临时文件,写入成功后,再替换之前的文件,用二进制压缩存储。
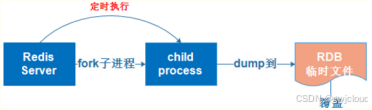
RDB持久化是默认启动的持久化机制;按事先定制的策略,周期性地将数据保存至磁盘,数据文件默认为dump.rdb。
RDB持久化有两种方式:
1、借助于配置文件所定义的save和策略进行保存。
2、客户端使用SAVE或BGSAVE命令启动快照保存机制。
SAVE命令: 是同步保存,在客户端使用save保存快照时,是在redis主线程中保存快照;因为redis的主线程是用于处理请求的,所以此时会阻塞所有客户端请求,每次的保存快照都是把内存中的数据完整的保存一份,并非是增量的,如果内存中的数据比较大,而还有大量的写操作请求时,此方式会引起大量的I/O,会导致redis性能下降
BGSAVE命令:异步方式,将立即返回结果,但自动在后台保持操作,所以BGSAVE命令启动以后,前台不会被占用,客户端的请求是不会被阻塞(主进程不会被阻塞)。
如果是在配置文件中定义的save,那么redis在持久化的时候,则会开启另外的进程去处理,不会阻塞redis的主进程
redis的RDB持久化不足之处则是,一旦数据出现问题,由于RDB的数据不是最新的,所以基于RDB恢复过来的数据一定会有一部分数据丢失,也就是RDB保存之后的修改的数据会丢失
3、AOF
AOF:Append Only File,持久化以日志的形式记录服务器所处理的每一个写、删除操作,查询操作不会记录,以文本的方式记录,可以打开文件看到详细的操作记录。AOF类似于MySQL的二进制日志,记录每一次redis的写操作命令,以顺序IO方式附加在指定文件的尾部,是使用追加方式实现的,这也叫做一种附加日志类型的持久化机制,由于每一次的操作都记录,则会随着时间长而增大文件的容量,AOF不像RDB,RDB是保存数据集的本身。
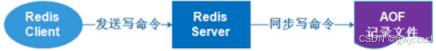
4、RDB和AOF的优缺点
RDB优点:
1). 采用RDB方式,那么你的整个Redis数据库将只包含一个文件,这对于文件备份而言是非常方便的,因为我们可以非常轻松的将一个单独的文件压缩后再转移到其它存储介质上。
2). 性能最大化。对于Redis的服务进程而言,在开始持久化时,它唯一需要做的只是fork出子进程,之后再由子进程完成这些持久化的工作,这样就可以极大的避免服务进程执行IO操作了。
3). 相比于AOF机制,如果数据集很大,RDB的启动效率会更高。


RDB缺点:
1). 如果你想保证数据的高可用性,即最大限度的避免数据丢失,那么RDB将不是一个很好的选择。因为系统一旦在定时持久化之前出现宕机现象,此前没有来得及写入磁盘的数据都将丢失。
2). 由于RDB是通过fork子进程来协助完成数据持久化工作的,因此,如果当数据集较大时,可能会导致整个服务器停止服务几百毫秒,甚至是1秒钟。
AOF优点:
1). AOF机制可以带来更高的数据安全性,即数据持久性。Redis中提供了3中同步策略,即每秒同步、每修改同步和不同步。事实上,对于每秒同步,一旦系统出现宕机现象,那么这一秒钟之内修改的数据将会丢失。而每修改同步,即每次发生的数据变化都会被立即记录到磁盘中。至于无同步,无需多言,我想大家都能正确的理解它。
2). 由于AOF机制对日志文件的写入操作采用的是append模式,因此在写入过程中即使出现宕机现象,也不会破坏日志文件中已经存在的内容。然而如果我们本次操作只是写入了一半数据就出现了系统崩溃问题,不用担心,在Redis下一次启动之前,我们可以通过redis-check-aof工具来帮助我们解决数据一致性的问题。
3). 如果日志过大,Redis可以自动启用rewrite机制。即Redis以append模式不断的将修改数据写入到老的磁盘文件中,同时Redis还会创建一个新的文件用于记录此期间有哪些修改命令被执行。因此在进行rewrite切换时可以更好的保证数据安全性。
4). AOF包含一个格式清晰、易于理解的日志文件用于记录所有的修改操作。事实上,我们也可以通过该文件完成数据的重建。
AOF缺点:
1). 对于相同数量的数据集而言,AOF文件通常要大于RDB文件。RDB 在恢复大数据集时的速度比 AOF 的恢复速度要快。
2). 根据同步策略的不同,AOF在运行效率上往往会慢于RDB。5、RDB配置文件相关的参数
[root@cong11 ~]# vim /usr/local/redis/etc/redis.conf
	stop-writes-on-bgsave-error yes		//在进行快照备份时,一旦发生错误的话是否停止写操作
	rdbcompression yes		//RDB文件是否使用压缩,压缩会消耗CPU
	rdbchecksum yes		//是否对RDB文件做校验码检测,此项定义在redis启动时加载RDB文件是否对文件检查校验码,在redis生成RDB文件是会生成校验信息,在redis再次启动或装载RDB文件时,是否检测校验信息,如果检测的情况下会消耗时间,会导致redis启动时慢,但是能够判断RDB文件是否产生错误
	dbfilename dump.rdb 	//定义RDB文件的名称
	dir /redis/data		//定义RDB文件存放的目录路径
[root@localhost ~]# vim /usr/local/redis/etc/redis.conf
dir /redis/data #修改存储位置
[root@localhost ~]# mkdir -p /redis/data
#启动
[root@localhost ~]# redis-server /usr/local/redis/etc/redis.conf
1250:C 20 Mar 2026 14:12:19.264 # oO0OoO0OoO0Oo Redis is starting oO0OoO0OoO0Oo
1250:C 20 Mar 2026 14:12:19.265 # Redis version=5.0.5, bits=64, commit=00000000, modified=0, pid=1250, just started
1250:C 20 Mar 2026 14:12:19.265 # Configuration loaded
[root@localhost ~]# redis-cli -a 123456
Warning: Using a password with '-a' or '-u' option on the command line interface may not be safe.
127.0.0.1:6379> config get dir
1) "dir"
2) "/redis/data"6、AOF配置文件相关的参数
appendonly no 		//定义是否开启AOF功能,默认为关闭,启用修改为yes
appendfilename "appendonly.aof" 	//定义AOF文件
appendfsync always 		//表示每次收到写命令时,立即写到磁盘上的AOF文件,虽然是最好的持久化功能,但是每次有写命令时都会有磁盘的I/O操作,容易影响redis的性能
appendfsync everysec 	//表示每秒钟写一次,不管每秒钟收到多少个写请求都往磁盘中的AOF文件中写一次
appendfsync no 		//表示append功能不会触发写操作,所有的写操作都是提交给OS,由OS自行决定是如何写的
no-appendfsync-on-rewrite no 		//当此项为yes时,表示在重写时,对于新的写操作不做同步,而暂存在内存中
auto-aof-rewrite-percentage 100		//表示当前AOF文件的大小是上次重写AOF文件的二倍时,则自动日志重写过程
auto-aof-rewrite-min-size 64mb		//定义AOF文件重写过程的条件,最少为定义大小则触发重写过程
注意:持久本身不能取代备份;还应该制定备份策略,对redis数据库定期进行备份;
[root@localhost ~]# vim /usr/local/redis/etc/redis.conf
appendonly yes
[root@localhost ~]# redis-cli -a 123456 shutdown
[root@localhost ~]# redis-server /usr/local/redis/etc/redis.conf7、数据恢复
RDB与AOF同时启用需要注意:
	(1) BGSAVE和BGREWRITEAOF不会同时执行,为了避免对磁盘的I/O影响过大,在某一时刻只允许一者执行;
	如果BGSAVE在执行当中,而用户手动执行BGREWRITEAOF时,redis会立即返回OK,但是redis不会同时执行,会等BGSAVE执行完成,再执行BGREWRITEAOF
	(2) 在Redis服务器启动用于恢复数据时,会优先使用AOF
每次redis重启都会去读取相对应的文件,如果误删除可以用备份文件直接替换原来的文件,dump.rdb或者appendonly.aof。
[root@localhost ~]# ls /redis/data/
appendonly.aof dump.rdb
#看一下文件中的内容 发现没有 因为刚开启
[root@localhost ~]# cat /redis/data/appendonly.aof
#登录redis
[root@localhost ~]# redis-cli -a 123456
127.0.0.1:6379> set a 1
OK
127.0.0.1:6379> keys *
1)"a"
#现在去看文件中内容
[root@localhost ~]# cat /redis/data/appendonly.aof
*2
$6
SELECT
$1
0
*3
$3
set
$1
a
$1
1
#持续插入值 看文件的变化
127.0.0.1:6379> set b 2
OK
127.0.0.1:6379> set c 3
OK
#删除一些记录
127.0.0.1:6379> del c
(integer) 1
127.0.0.1:6379> del b
(integer) 1
查看文件的内容
#查看文件的大小
[root@localhost ~]# ll -h /redis/data/appendonly.aof
-rw-r--r-- 1 root root 144 Mar 20 14:22 /redis/data/appendonly.aof
127.0.0.1:6379> BGREWRITEAOF #进行重写
Background append only file rewriting started
[root@localhost ~]# ll -h /redis/data/appendonly.aof
-rw-r--r-- 1 root root 102 Mar 20 14:23 /redis/data/appendonly.aof测试数据恢复
现在把redis程序的文件上传到别的服务器就可以使用redis
[root@client ~]# scp -r /usr/local/redis/ root@192.168.1.101:/usr/local/
[root@client ~]# vim /usr/local/redis/etc/redis.conf
bind 127.0.0.1 192.168.1.101
[root@client ~]# ln -s /usr/local/redis/bin/* /usr/local/bin/
[root@client ~]# mkdir -p /redis/data
#把appendonly.aof文件拷贝过来
[root@localhost ~]# scp /redis/data/appendonly.aof root@192.168.1.101:/redis/data/
#client查看数据
[root@client ~]# redis-cli -a 123456
Warning: Using a password with '-a' or '-u' option on the command line interface may not be safe.
127.0.0.1:6379> keys *
1) "a"
127.0.0.1:6379> get a
"1"2、redis主从
复制的工作过程
主库会基于ping check方式检查从库是否在线,如果在线则直接同步数据文件至从服务端,从服务端也可以主动发送同步请求到主服务端,主库如果是启动了持久化功能时,会不断的同步数据到磁盘上,主库一旦收到从库的同步请求时,主库会将内存中的数据做快照,然后把数据文件同步给从库,从库得到以后是保存在本地文件中(磁盘),而后则把该文件装载到内存中完成数据重建。
1、启动redis slave
2、slave会向master发送同步命令,请求主库上的数据,不论从是第一次连接,还是非第一次连接,master此时都会启动一个后台的子进程将数据快照保存在数据文件中,然后把数据文件发送给slave
3、slave收到数据文件以后会保存到本地,而后把文件重载装入内存


特点
1、一个Master可以有多个Slave;
2、支持链式复制(一个slave也可以是其他的slave的slave);
3、Master以非阻塞方式同步数据至slave(master可以同时处理多个slave的读写请求,salve端在同步数据时也可以使用非阻塞方式);
# 配置从redis服务器
[root@client ~]# vim /usr/local/redis/etc/redis.conf
# replicaof <masterip> <masterport>
replicaof 192.168.1.100 6379 #指定主服务器的IP
masterauth 123456 #若是主节点有密码 必须配置主节点的认证密码
#重启redis
[root@client ~]# redis-cli shutdown
[root@client ~]# redis-server /usr/local/redis/etc/redis.conf
#查看主从信息
[root@client ~]# redis-cli
127.0.0.1:6379> info replication
# Replication
role:slave
master_host:192.168.1.100
master_port:6379
master_link_status:up #up开启主从模式
master_last_io_seconds_ago:5
master_sync_in_progress:0
slave_repl_offset:28
slave_priority:100
slave_read_only:1
connected_slaves:0
master_replid:38ab1ee03b1bc6ab7c61401bc4c4fa336d4d38f0
master_replid2:0000000000000000000000000000000000000000
master_repl_offset:28
second_repl_offset:-1
repl_backlog_active:1
repl_backlog_size:1048576
repl_backlog_first_byte_offset:1
repl_backlog_histlen:28
说明:
如果master使用requirepass开启了认证功能,从服务器要使用masterauth <PASSWORD>来连入服务请求使用此密码进行认证; 如果master没有配置密码 这里可以省略测试:
主:
[root@localhost ~]# redis-cli
127.0.0.1:6379> keys *
(empty list or set)
127.0.0.1:6379> set test a
OK
从:
127.0.0.1:6379> keys *
1) "test"
127.0.0.1:6379> get test
"a"3、sentinel主从高可用
redis主从切换技术的方法是:当主服务器宕机后,需要手动把一台从服务器切换为主服务器,这就需要人工干预,费事费力,还会造成一段时间内服务不可用。这不是一种推荐的方式,更多时候,我们优先考虑哨兵模式。
sentinel的工作过程
sentinel即可以部署在另外的主机上也可以部署在redis主机上,sentinel既能监控又能提供配置功能,向sentinel指明主redis服务器即可(仅监控主服务器),sentinel可以从主服务中获取主从架构信息,并分辨从节点。sentinel可以监控当前整个主从服务器架构的工作状态,一旦发现master离线的情况,sentinel会从多个从服务器中选择并提升一个从节点成为主节点,当主节点被从节点取代以后,那么IP地址则发生了变化,客户之前连接的主节点IP无法连接,此时可以向sentinel发起查询请求,sentinel会告知客户端新的主节点的IP,所以sentinel是redis在主从架构中实现高可用的解决方案。为了防止sentinel误判和单点故障,sentinel也应该部署为集群,sentinel多个节点同时监控redis主从架构,一旦有一个sentinel节点发现redis的主节点不在线时的情况,sentinel会与其他的sentinel节点协商,看其他的sentinel节点是否也同样发现redis的主节点不在线,如果sentinel的多个点节点都发现redis的主节点都为离线,那么则判定redis主节点为离线状态,以此方式避免误判,同样也避免了单点故障。
| 服务类型 | 是否是主服务器 | IP地址 | 端口 |
| redis | 是 | 192.168.1.100 | 6379 |
| redis | 否 | 192.168.1.101 | 6379 |
| redis | 否 | 192.168.1.102 | 6379 |
| sentinel | - | 192.168.1.100 | 26379 |
| sentinel | - | 192.168.1.101 | 26379 |
| sentinel | - | 192.168.1.102 | 26379 |
所有节点安装redis 不开启认证配置 过程省略
master节点
[root@master ~]# mkdir /var/log/redis
[root@master ~]# vim /usr/local/redis/etc/redis.conf
…………省略部分内容
logfile "/var/log/redis/redis_6379.log"
#masterauth 123456  #主从切换需要用到密码,如果你redis本省设置了密码,才需要添加 这里省略
[root@master ~]# pkill redis-server
[root@master ~]# redis-server /usr/local/redis/etc/redis.conf
slave01节点
[root@slave01 ~]# mkdir /var/log/redis
[root@slave01 ~]# mkdir -p /redis/data
[root@slave01 ~]# vim /usr/local/redis/etc/redis.conf
………..省略部分内容
bind 127.0.0.1 192.168.1.101
port 6379
pidfile /var/run/redis_6379.pid
logfile "/var/log/redis/redis_6379.log"  #修改log文件路径
dir /redis/data              #修改RDB目录
replicaof  192.168.1.100 6379  #指定master的IP和端口
#masterauth 123456          #指定master登陆密码 如果master服务器本身redis没有指定密码 可以省略 这里省略

#重启redis
[root@slave01 ~]# pkill redis-server
[root@slave01 ~]# redis-server /usr/local/redis/etc/redis.conf

#查看信息
[root@slave01 ~]# redis-cli
127.0.0.1:6379> info replication
# Replication
role:slave
master_host:192.168.1.100
master_port:6379
master_link_status:up   #这里是up才是成功
master_last_io_seconds_ago:1
master_sync_in_progress:0
slave_repl_offset:14
slave_priority:100
slave_read_only:1
connected_slaves:0
master_replid:0e62ac1d0fa2416387dcf67a96adf4c3016b5f96
master_replid2:0000000000000000000000000000000000000000
master_repl_offset:14
second_repl_offset:-1
repl_backlog_active:1
repl_backlog_size:1048576
repl_backlog_first_byte_offset:1
repl_backlog_histlen:14
slave02节点
[root@slave02 ~]# mkdir /var/log/redis
[root@slave02 ~]# mkdir -p /redis/data
[root@slave02 ~]# vim /usr/local/redis/etc/redis.conf
………….省略部分内容
daemonize yes
bind 127.0.0.1 192.168.1.102
port 6379
pidfile /var/run/redis_6379.pid
logfile "/var/log/redis/redis_6379.log"  #修改log文件路径
dir /redis/data              #修改RDB目录
replicaof  192.168.1.100 6379  #指定master的IP和端口

#重启redis
[root@slave02 ~]# pkill redis-server
[root@slave02 ~]# redis-server /usr/local/redis/etc/redis.conf

#查看信息
[root@slave02 ~]# redis-cli
127.0.0.1:6379> info replication
# Replication
role:slave
master_host:192.168.1.100
master_port:6379
master_link_status:up  #这里一定是UP
master_last_io_seconds_ago:4
master_sync_in_progress:0
slave_repl_offset:602
slave_priority:100
slave_read_only:1
connected_slaves:0
master_replid:3d4a8fb93e283c4e1b13c3775be5aa82b6839577
master_replid2:0000000000000000000000000000000000000000
master_repl_offset:602
second_repl_offset:-1
repl_backlog_active:1
repl_backlog_size:1048576
repl_backlog_first_byte_offset:477
repl_backlog_histlen:126
验证主从
在master上查看信息
[root@master ~]# redis-cli
127.0.0.1:6379> info replication
# Replication
role:master
connected_slaves:2
slave0:ip=192.168.1.102,port=6379,state=online,offset=14,lag=1
slave1:ip=192.168.1.101,port=6379,state=online,offset=14,lag=1
master_replid:176ba1d232e3c80e072090aa2bb55d2fc200ff70
master_replid2:0000000000000000000000000000000000000000
master_repl_offset:14
second_repl_offset:-1
repl_backlog_active:1
repl_backlog_size:1048576
repl_backlog_first_byte_offset:1
repl_backlog_histlen:14
部署sentinel
三个sentinel节点的sentinel.conf文件配置一样,如果是在同一个主机上,则需要使用不同的端口号。
redis-sentinel可以理解为运行有着特殊代码的redis,redis自身也可以运行sentinel,sentinel也依赖配置文件,在redis解压目录下有一个sentinel.conf文件,copy一份进行修改用于保存sentinel不断收集的状态信息.

#生成配置文件
[root@master ~]# cd redis-5.0.5
[root@master redis-5.0.5]# cp sentinel.conf /usr/local/redis/etc/


#修改配置文件
[root@master redis-5.0.5]# vim /usr/local/redis/etc/sentinel.conf
daemonize yes
bind 0.0.0.0  #添加监控IP,一定要写0.0.0.0,不然主从切换不了
logfile "/var/log/redis/sentinel_26379.log"
sentinel monitor mymaster 192.168.1.100  6379 2   #修改master IP
sentinel down-after-milliseconds mymaster 30000
sentinel parallel-syncs mymaster 1
sentinel failover-timeout mymaster 180000
说明:
# sentinel monitor <master-name> <ip> <redis-port> <quorum> //此项可以出现多次,可以监控多组redis主从架构,此项用于监控主节点 <master-name> 自定义的主节点名称,<ip> 主节点的IP地址,<redis-port>主节点的端口号,<quorum>主节点对应的quorum法定数量,是一个大于sentinel数量一半的值,所以sentinel数量尽量为奇数个,如果sentinel有3个,则指定为2即可,如果有4个,不能够指定为2,避免导致集群分裂,注意,<master-name>为集群名称,可以自定义,如果同时监控有多组redis集群时,<master-name>不能相同。
注:最后数字2表示如果有两个sentinel认为master挂了,则这个master即认为不可用;
# sentinel author-pass定义服务的密码,mymaster是服务名称,123456是Redis服务器密码
#sentinel down-after-milliseconds <master-name> <milliseconds> //默认30秒,sentinel会通过ping来判断master是否存活,如果在30秒内master返回pong给sentinel,则认为master是好的,否则sentinel认为master不可用。
#sentinel parallel-syncs <master-name> <numslaves> //当Sentinel节点集合对主节点故障判定达成一致时,Sentinel领导者节点会做故障转移操作,选出新的主节点,原来的从节点会向新的主节点发起复制操作,限制每次向新的主节点发起复制操作的从节点个数为1
#sentinel failover-timeout <master-name> <milliseconds> //故障转移超时时间,在指定时间没能完成则判定为失败,单位为毫秒(默认为180秒)#把配置文件拷贝别从服务器
[root@master redis-5.0.5]# for i in 101 102 ; do scp /usr/local/redis/etc/sentinel.conf root@192.168.1.$i:/usr/local/redis/etc/ ; done
#注意启动的顺序。首先是主机的Redis服务进程,然后启动从机的服务进程,最后启动3个哨兵的服务进程。
[root@master ~]# redis-sentinel /usr/local/redis/etc/sentinel.conf
[root@master ~]# echo "redis-sentinel /usr/local/redis/etc/sentinel.conf" >> /etc/rc.local
[root@slave01 ~]# redis-sentinel /usr/local/redis/etc/sentinel.conf
[root@slave01 ~]# echo "redis-sentinel /usr/local/redis/etc/sentinel.conf" >> /etc/rc.local
[root@slave02 ~]# redis-sentinel /usr/local/redis/etc/sentinel.conf
[root@slave02 ~]# echo "redis-sentinel /usr/local/redis/etc/sentinel.conf" >> /etc/rc.local#检查整个集群的在状态
[root@master ~]# redis-cli -p 26379
127.0.0.1:26379> info sentinel
# Sentinel
sentinel_masters:1
sentinel_tilt:0
sentinel_running_scripts:0
sentinel_scripts_queue_length:0
sentinel_simulate_failure_flags:0
master0:name=mymaster,status=ok,address=192.168.1.100:6379,slaves=2,sentinels=3
127.0.0.1:26379> client list
id=3 addr=192.168.1.101:46602 fd=13 name=sentinel-50b784ba-cmd age=401 idle=0 flags=N db=0 sub=0 psub=0 multi=-1 qbuf=0 qbuf-free=0 obl=0 oll=0 omem=0 events=r cmd=ping
id=4 addr=192.168.1.102:57078 fd=14 name=sentinel-d5698082-cmd age=401 idle=0 flags=N db=0 sub=0 psub=0 multi=-1 qbuf=0 qbuf-free=0 obl=0 oll=0 omem=0 events=r cmd=publish
id=6 addr=127.0.0.1:53516 fd=17 name= age=86 idle=0 flags=N db=0 sub=0 psub=0 multi=-1 qbuf=26 qbuf-free=32742 obl=0 oll=0 omem=0 events=r cmd=client验证sentinel
#关闭master的redis进程
[root@master ~]# ps -ef | grep redis
root       1372      1  0 09:15 ?        00:00:02 redis-server 127.0.0.1:6379
root       1430      1  0 09:36 ?        00:00:00 redis-sentinel 0.0.0.0:26379 [sentinel]
root       1437   1409  0 09:37 pts/0    00:00:00 grep --color=auto redis
[root@master ~]# kill -9 1372
[root@master ~]# ps -ef | grep redis
root       1430      1  0 09:36 ?        00:00:00 redis-sentinel 0.0.0.0:26379 [sentinel]
root       1439   1409  0 09:37 pts/0    00:00:00 grep --color=auto redis
[root@master ~]# redis-cli -p 26379
127.0.0.1:26379> info sentinel
# Sentinel
sentinel_masters:1
sentinel_tilt:0
sentinel_running_scripts:0
sentinel_scripts_queue_length:0
sentinel_simulate_failure_flags:0
master0:name=mymaster,status=ok,address=192.168.1.102:6379,slaves=2,sentinels=3
如果这里没有切换等待30S.我们配置文件写的是30S,这里看到master变成192.168.1.102
#启动redis
[root@master ~]# redis-server /usr/local/redis/etc/redis.conf
[root@master ~]# redis-cli
127.0.0.1:6379> info replication
# Replication
role:slave
master_host:192.168.1.102
master_port:6379
master_link_status:up
master_last_io_seconds_ago:1
master_sync_in_progress:0
slave_repl_offset:171857
slave_priority:100
slave_read_only:1
connected_slaves:0
master_replid:e48b62539a084175fbba782ac90cb28c133980a4
master_replid2:0000000000000000000000000000000000000000
master_repl_offset:171857
second_repl_offset:-1
repl_backlog_active:1
repl_backlog_size:1048576
repl_backlog_first_byte_offset:170425
repl_backlog_histlen:1433
#在新主上查看
[root@slave02 ~]# redis-cli
127.0.0.1:6379> info replication
# Replication
role:master
connected_slaves:2
slave0:ip=192.168.1.101,port=6379,state=online,offset=207768,lag=0
slave1:ip=192.168.1.100,port=6379,state=online,offset=207627,lag=0
master_replid:e48b62539a084175fbba782ac90cb28c133980a4
master_replid2:176ba1d232e3c80e072090aa2bb55d2fc200ff70
master_repl_offset:207768
second_repl_offset:127526
repl_backlog_active:1
repl_backlog_size:1048576
repl_backlog_first_byte_offset:1
repl_backlog_histlen:207768
由以上测试可见,主的故障离线后,sentinel重新选了其一个从redis成为了新的主节点,在原来的主节点重新上线后,仍然不会恢复为主节点。
总结:
Failover过程分析:
sentinel节点会定期通过ping检测redis的master是否存活,一旦master crash,
首先sentinel自己会主观认为master crash,然后三个sentinel之间彼此通信,只要有两个sentinel节点认为master crash,则客观认为master crash,
接着三个sentinel节点会投票,得到两票的一个sentinel会去执行failover,
最后master 30s之内没有响应sentinel才会真正的failover;
一旦挂掉的旧master修复,重新启动后,会作为新master的从库存在;4、redis-cluster集群
尽管可以使用哨兵主从集群实现可用性保证,但是这种实现方式每个节点的数据都是全量复制,数据存放量存在着局限性,受限于内存最小的节点,因此考虑采用数据分片的方式,来实现存储,这个就是redis-cluster。
Redis cluster 是redis的分布式解决方案,在3.0版本正式推出后,有效的解决了redis分布式方面的需求;当遇到单机内存,并发,流量等瓶颈时,可以采用cluster架构方案达到负载均衡的目的。
官方网站:https://redis.io/topics/cluster-tutorial
2018年十月 Redis 发布了稳定版本的 5.0 版本,推出了各种新特性,其中一点是放弃 Ruby的集群方式,改为使用 C语言编写的 redis-cli的方式,使集群的构建方式复杂度大大降低。
在redis3.0以前的版本要实现集群一般是借助哨兵sentinel工具来监控master节点的状态,如果master节点异常,则会做主从切换,将某一台slave作为master,哨兵的配置略微复杂,并且性能和高可用性等各方面表现一般,特别是在主从切换的瞬间存在访问瞬断的情况,而且哨兵模式只有一个主节点对外提供服务,没法支持很高的并发,且单个主节点内存也不宜设置得过大,否则会导致持久化文件过大,影响数据恢复或主从同步的效率。
redis数据分区
Redis cluster 采用虚拟槽分区,所有的键根据哈希函数映射到0~16383整数槽内,计算公式:Slot=CRC16(key)&16384。每个节点负责维护一部分槽以及槽所映射的键值数据。
redis群集中的每个节点都负责哈希槽的子集,例如,您可能拥有一个包含3个节点的群集,其中:
节点A包含从0到5460的散列槽。
节点B包含从5461到10922的散列槽。
节点C包含从10923到16383的散列槽。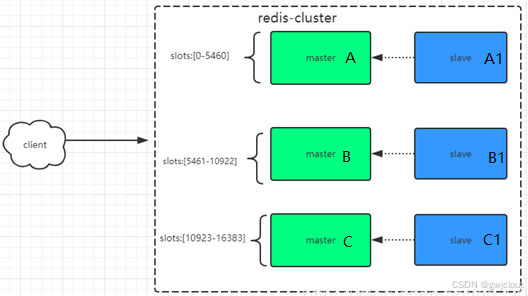
redis cluster主从模型
如果只具有节点A,B,C实例的集群中,如果节点B发生故障,则群集无法继续,因为我们不再能够在5461-10922范围内提供服务哈希位置的方法。
然而,当创建集群时(或稍后),我们向每个主节点添加一个从节点,以便最终集群由作为主节点的A,B,C和作为从节点的A1,B1,C1组成。 ,如果节点B出现故障,系统就能继续运行。
节点B1复制B,B失败,集群将节点B1升级为新的主节点,并将继续正常运行。
但请注意,如果节点B和B1同时发生故障,Redis Cluster将无法继续运行。
Redis Cluster 一般由多个节点组成,节点数量至少为 6 个才能保证组成完整高可用的集群,其中三个为主节点,三个为从节点。三个主节点会分配槽,处理客户端的命令请求,而从节点可用在主节点故障后,顶替主节点。
redis-cluster搭建
Redis集群至少需要3个节点,因为投票容错机制要求超过半数节点认为某个节点挂了该节点才是挂了,所以2个节点无法构成集群。
要保证集群的高可用,需要每个节点都有从节点,也就是备份节点,所以Redis集群至少需要6台服务器。
我们这里搭建三个master节点,并且给每个master再搭建一个slave节点,三主三从。
| 主机 | IP | 角色 | 端口 |
| node01 | 192.168.1.100 | Master | 6379 |
| node01 | 192.168.1.100 | Slave | 6380 |
| node02 | 192.168.1.101 | Master | 6381 |
| node02 | 192.168.1.101 | Slave | 6382 |
| node03 | 192.168.1.102 | Master | 6383 |
| node03 | 192.168.1.102 | Slave | 6384 |
1、所有节点安装redis省略
2、所有节点添加hosts文件
vim /etc/hosts
192.168.1.100 node01
192.168.1.101 node02
192.168.1.102 node03
3、node1配置
#创建配置文件目录和数据存放目录
[root@node01 ~]# mkdir -p /etc/redis/cluster/{6379,6380}
[root@node01 ~]# mkdir -p /data/redis/data/{6379,6380}
[root@node01 ~]# mkdir /var/log/redis
[root@node01 ~]# cp ./redis-5.0.5/redis.conf /etc/redis/cluster/6379/
[root@node01 ~]# cp ./redis-5.0.5/redis.conf /etc/redis/cluster/6380/

#修改配置文件
[root@node01 ~]# vim /etc/redis/cluster/6379/redis.conf
daemonize   yes                   //redis后台运行
bind 192.168.1.100                   //监听地址,不能监听127.0.0.1
pidfile  /var/run/redis_6379.pid       //pidfile文件对应端口
port  6379                        //端口
dir "/data/redis/data/6379"           //配置redis rdb数据保存位置
logfile "/var/log/redis/redis_6379.log"
cluster-enabled  yes                //开启集群  把注释#去掉
cluster-config-file  nodes_6379.conf   //集群的配置,配置文件首次启动自动生成
cluster-node-timeout  15000      //请求超时15s
appendonly  yes              //aof日志开启,有需要就开启,它会每次写操作都记录一条日志

#添加6380端口redis的配置文件
[root@node01 ~]# cp /etc/redis/cluster/6379/redis.conf /etc/redis/cluster/6380/redis.conf
[root@node01 ~]# sed -i '/^[^#]/s/6379/6380/' /etc/redis/cluster/6380/redis.conf

#启动添加开机自启
[root@node01 ~]# redis-server /etc/redis/cluster/6379/redis.conf
[root@node01 ~]# redis-server /etc/redis/cluster/6380/redis.conf
[root@node01 ~]# netstat -anplt | grep redis
tcp        0      0 192.168.1.100:16379     0.0.0.0:*               LISTEN      1345/redis-server 1
tcp        0      0 192.168.1.100:16380     0.0.0.0:*               LISTEN      1350/redis-server 1
tcp        0      0 192.168.1.100:6379      0.0.0.0:*               LISTEN      1345/redis-server 1
tcp        0      0 192.168.1.100:6380      0.0.0.0:*               LISTEN      1350/redis-server 1
[root@node01 ~]# ps -ef | grep redis
root       1345      1  0 10:18 ?        00:00:00 redis-server 192.168.1.100:6379 [cluster]
root       1350      1  0 10:18 ?        00:00:00 redis-server 192.168.1.100:6380 [cluster]
root       1357   1280  0 10:18 pts/0    00:00:00 grep --color=auto redis

[root@node01 ~]# echo "redis-server /etc/redis/cluster/6379/redis.conf" >> /etc/rc.local
[root@node01 ~]# echo "redis-server /etc/redis/cluster/6380/redis.conf" >> /etc/rc.local
4、node2配置
[root@node02 ~]# mkdir -p /data/redis/data/{6381,6382}
[root@node02 ~]# mkdir /var/log/redis
[root@node02 ~]# mkdir -p /etc/redis/cluster/{6381,6382}

#在node01上拷贝配置文件
[root@node01 ~]# scp /etc/redis/cluster/6379/redis.conf root@192.168.1.101:/etc/redis/cluster/6381/
[root@node01 ~]# scp /etc/redis/cluster/6379/redis.conf root@192.168.1.101:/etc/redis/cluster/6382/

把各端口的配置文件的监听地址更换为自己的
[root@node02 ~]# vim /etc/redis/cluster/6381/redis.conf
bind 192.168.1.101
[root@node02 ~]# vim /etc/redis/cluster/6382/redis.conf
bind 192.168.1.101

[root@node02 ~]# sed -i '/^[^#]/s/6379/6381/' /etc/redis/cluster/6381/redis.conf
[root@node02 ~]# sed -i '/^[^#]/s/6379/6382/' /etc/redis/cluster/6382/redis.conf

[root@node02 ~]# redis-server /etc/redis/cluster/6381/redis.conf
[root@node02 ~]# redis-server /etc/redis/cluster/6382/redis.conf

[root@node02 ~]# echo "redis-server /etc/redis/cluster/6381/redis.conf" >> /etc/rc.local
[root@node02 ~]# echo "redis-server /etc/redis/cluster/6382/redis.conf" >> /etc/rc.local
5、node03配置
[root@node03 ~]# mkdir -p /etc/redis/cluster/{6383,6384}
[root@node03 ~]# mkdir -p /data/redis/data/{6383,6384}
[root@node03 ~]# mkdir /var/log/redis

[root@node01 ~]# scp /etc/redis/cluster/6379/redis.conf root@192.168.1.102:/etc/redis/cluster/6383/
[root@node01 ~]# scp /etc/redis/cluster/6379/redis.conf root@192.168.1.102:/etc/redis/cluster/6384/

#修改自己的IP地址
[root@node03 ~]# vim /etc/redis/cluster/6383/redis.conf
bind 192.168.1.102
[root@node03 ~]# vim /etc/redis/cluster/6384/redis.conf
bind 192.168.1.102
[root@node03 ~]# sed -i '/^[^#]/s/6379/6383/' /etc/redis/cluster/6383/redis.conf
[root@node03 ~]# sed -i '/^[^#]/s/6379/6384/' /etc/redis/cluster/6384/redis.conf
[root@node03 ~]# redis-server /etc/redis/cluster/6383/redis.conf
[root@node03 ~]# redis-server /etc/redis/cluster/6384/redis.conf
[root@node03 ~]# echo "redis-server /etc/redis/cluster/6383/redis.conf" >> /etc/rc.local
[root@node03 ~]# echo "redis-server /etc/redis/cluster/6384/redis.conf" >> /etc/rc.local
6、创建redis-cluster集群
[root@node01 ~]# redis-cli --cluster create 192.168.1.100:6379 192.168.1.101:6381 192.168.1.102:6383 192.168.1.100:6380 192.168.1.101:6382 192.168.1.102:6384 --cluster-replicas 1
>>> Performing hash slots allocation on 6 nodes...
Master[0] -> Slots 0 - 5460
Master[1] -> Slots 5461 - 10922
Master[2] -> Slots 10923 - 16383
Adding replica 192.168.1.101:6382 to 192.168.1.100:6379
Adding replica 192.168.1.102:6384 to 192.168.1.101:6381
Adding replica 192.168.1.100:6380 to 192.168.1.102:6383
M: e90e701efbc09e74f7ed9fe97985c80370594716 192.168.1.100:6379
   slots:[0-5460] (5461 slots) master
M: 644c96d31884f88806a3e3a6935c0713b162a7c4 192.168.1.101:6381
   slots:[5461-10922] (5462 slots) master
M: d40354cd2085bde509377ca21a2c68f0a01f90b1 192.168.1.102:6383
   slots:[10923-16383] (5461 slots) master
S: 2cdb160f6190c97db945556cdcdc6861056483e5 192.168.1.100:6380
   replicates d40354cd2085bde509377ca21a2c68f0a01f90b1
S: 038707b17f95e0b65e4e1ab9c22c709d852e108d 192.168.1.101:6382
   replicates e90e701efbc09e74f7ed9fe97985c80370594716
S: 33dfe603225857d0cee84b13176e9939f3c0bf44 192.168.1.102:6384
   replicates 644c96d31884f88806a3e3a6935c0713b162a7c4
Can I set the above configuration? (type 'yes' to accept): yes
>>> Nodes configuration updated
>>> Assign a different config epoch to each node
>>> Sending CLUSTER MEET messages to join the cluster
Waiting for the cluster to join
....
>>> Performing Cluster Check (using node 192.168.1.100:6379)
M: e90e701efbc09e74f7ed9fe97985c80370594716 192.168.1.100:6379
   slots:[0-5460] (5461 slots) master
   1 additional replica(s)
S: 2cdb160f6190c97db945556cdcdc6861056483e5 192.168.1.100:6380
   slots: (0 slots) slave
   replicates d40354cd2085bde509377ca21a2c68f0a01f90b1
S: 33dfe603225857d0cee84b13176e9939f3c0bf44 192.168.1.102:6384
   slots: (0 slots) slave
   replicates 644c96d31884f88806a3e3a6935c0713b162a7c4
S: 038707b17f95e0b65e4e1ab9c22c709d852e108d 192.168.1.101:6382
   slots: (0 slots) slave
   replicates e90e701efbc09e74f7ed9fe97985c80370594716
M: d40354cd2085bde509377ca21a2c68f0a01f90b1 192.168.1.102:6383
   slots:[10923-16383] (5461 slots) master
   1 additional replica(s)
M: 644c96d31884f88806a3e3a6935c0713b162a7c4 192.168.1.101:6381
   slots:[5461-10922] (5462 slots) master
   1 additional replica(s)
[OK] All nodes agree about slots configuration.
>>> Check for open slots...
>>> Check slots coverage...
[OK] All 16384 slots covered.

看到OK,说明集群创建成功。
7、查看集群信息
[root@node01 ~]# redis-cli -h 192.168.1.100 -p 6379 -c
192.168.1.100:6379> cluster nodes
2cdb160f6190c97db945556cdcdc6861056483e5 192.168.1.100:6380@16380 slave d40354cd2085bde509377ca21a2c68f0a01f90b1 0 1774061882000 4 connected
33dfe603225857d0cee84b13176e9939f3c0bf44 192.168.1.102:6384@16384 slave 644c96d31884f88806a3e3a6935c0713b162a7c4 0 1774061882570 6 connected
038707b17f95e0b65e4e1ab9c22c709d852e108d 192.168.1.101:6382@16382 slave e90e701efbc09e74f7ed9fe97985c80370594716 0 1774061882000 5 connected
d40354cd2085bde509377ca21a2c68f0a01f90b1 192.168.1.102:6383@16383 master - 0 1774061883577 3 connected 10923-16383
644c96d31884f88806a3e3a6935c0713b162a7c4 192.168.1.101:6381@16381 master - 0 1774061881000 2 connected 5461-10922
e90e701efbc09e74f7ed9fe97985c80370594716 192.168.1.100:6379@16379 myself,master - 0 1774061880000 1 connected 0-5460
192.168.1.100:6379> cluster info
cluster_state:ok
cluster_slots_assigned:16384
cluster_slots_ok:16384
cluster_slots_pfail:0
cluster_slots_fail:0
cluster_known_nodes:6
cluster_size:3
cluster_current_epoch:6
cluster_my_epoch:1
cluster_stats_messages_ping_sent:121
cluster_stats_messages_pong_sent:121
cluster_stats_messages_sent:242
cluster_stats_messages_ping_received:116
cluster_stats_messages_pong_received:121
cluster_stats_messages_meet_received:5
cluster_stats_messages_received:242
#测试插入数据
192.168.1.100:6379> set name zhangsan
-> Redirected to slot [5798] located at 192.168.1.101:6381
OK
说明:数据分到了192.168.1.101的6381主中 是5798槽
#查看集群完整性
[root@node01 ~]# redis-cli --cluster check 192.168.1.100:6379
192.168.1.100:6379 (e90e701e...) -> 0 keys | 5461 slots | 1 slaves.
192.168.1.102:6383 (d40354cd...) -> 0 keys | 5461 slots | 1 slaves.
192.168.1.101:6381 (644c96d3...) -> 1 keys | 5462 slots | 1 slaves.
[OK] 1 keys in 3 masters.
0.00 keys per slot on average.
>>> Performing Cluster Check (using node 192.168.1.100:6379)
M: e90e701efbc09e74f7ed9fe97985c80370594716 192.168.1.100:6379
slots:[0-5460] (5461 slots) master
1 additional replica(s)
S: 2cdb160f6190c97db945556cdcdc6861056483e5 192.168.1.100:6380
slots: (0 slots) slave
replicates d40354cd2085bde509377ca21a2c68f0a01f90b1
S: 33dfe603225857d0cee84b13176e9939f3c0bf44 192.168.1.102:6384
slots: (0 slots) slave
replicates 644c96d31884f88806a3e3a6935c0713b162a7c4
S: 038707b17f95e0b65e4e1ab9c22c709d852e108d 192.168.1.101:6382
slots: (0 slots) slave
replicates e90e701efbc09e74f7ed9fe97985c80370594716
M: d40354cd2085bde509377ca21a2c68f0a01f90b1 192.168.1.102:6383
slots:[10923-16383] (5461 slots) master
1 additional replica(s)
M: 644c96d31884f88806a3e3a6935c0713b162a7c4 192.168.1.101:6381
slots:[5461-10922] (5462 slots) master
1 additional replica(s)
[OK] All nodes agree about slots configuration.
>>> Check for open slots...
>>> Check slots coverage...
[OK] All 16384 slots covered.8、故障切换
把集群的6379端口的进程kill
[root@node01 ~]# ps -ef | grep redis
root       1345      1  0 10:18 ?        00:00:03 redis-server 192.168.1.100:6379 [cluster]
root       1350      1  0 10:18 ?        00:00:03 redis-server 192.168.1.100:6380 [cluster]
root       1558   1280  0 11:02 pts/0    00:00:00 grep --color=auto redis
[root@node01 ~]# kill -9 1345


检查集群完整性:
[root@node01 ~]# redis-cli --cluster check 192.168.1.100:6380
Could not connect to Redis at 192.168.1.100:6379: Connection refused
192.168.1.102:6383 (d40354cd...) -> 0 keys | 5461 slots | 1 slaves.
192.168.1.101:6381 (644c96d3...) -> 1 keys | 5462 slots | 1 slaves.
192.168.1.101:6382 (038707b1...) -> 0 keys | 5461 slots | 0 slaves. #新的主之前是192.168.1.100:6379
[OK] 1 keys in 3 masters.
0.00 keys per slot on average.
>>> Performing Cluster Check (using node 192.168.1.100:6380)
S: 2cdb160f6190c97db945556cdcdc6861056483e5 192.168.1.100:6380
   slots: (0 slots) slave
   replicates d40354cd2085bde509377ca21a2c68f0a01f90b1
M: d40354cd2085bde509377ca21a2c68f0a01f90b1 192.168.1.102:6383
   slots:[10923-16383] (5461 slots) master
   1 additional replica(s)
S: 33dfe603225857d0cee84b13176e9939f3c0bf44 192.168.1.102:6384
   slots: (0 slots) slave
   replicates 644c96d31884f88806a3e3a6935c0713b162a7c4
M: 644c96d31884f88806a3e3a6935c0713b162a7c4 192.168.1.101:6381
   slots:[5461-10922] (5462 slots) master
   1 additional replica(s)
M: 038707b17f95e0b65e4e1ab9c22c709d852e108d 192.168.1.101:6382
   slots:[0-5460] (5461 slots) master
[OK] All nodes agree about slots configuration.
>>> Check for open slots...
>>> Check slots coverage...
[OK] All 16384 slots covered.

可以看到192.168.1.100:6379的从redis实例192.168.1.101:6382成为了主redis.
再次将192.168.1.100:6379启动:
[root@node01 ~]# redis-server /etc/redis/cluster/6379/redis.conf

#查看集群信息
[root@node01 ~]# redis-cli --cluster check 192.168.1.100:6379
192.168.1.101:6381 (644c96d3...) -> 1 keys | 5462 slots | 1 slaves.
192.168.1.101:6382 (038707b1...) -> 0 keys | 5461 slots | 1 slaves.
192.168.1.102:6383 (d40354cd...) -> 0 keys | 5461 slots | 1 slaves.
[OK] 1 keys in 3 masters.
0.00 keys per slot on average.
>>> Performing Cluster Check (using node 192.168.1.100:6379)
S: e90e701efbc09e74f7ed9fe97985c80370594716 192.168.1.100:6379
   slots: (0 slots) slave
   replicates 038707b17f95e0b65e4e1ab9c22c709d852e108d
S: 33dfe603225857d0cee84b13176e9939f3c0bf44 192.168.1.102:6384
   slots: (0 slots) slave
   replicates 644c96d31884f88806a3e3a6935c0713b162a7c4
S: 2cdb160f6190c97db945556cdcdc6861056483e5 192.168.1.100:6380
   slots: (0 slots) slave
   replicates d40354cd2085bde509377ca21a2c68f0a01f90b1
M: 644c96d31884f88806a3e3a6935c0713b162a7c4 192.168.1.101:6381
   slots:[5461-10922] (5462 slots) master
   1 additional replica(s)
M: 038707b17f95e0b65e4e1ab9c22c709d852e108d 192.168.1.101:6382
   slots:[0-5460] (5461 slots) master
   1 additional replica(s)
M: d40354cd2085bde509377ca21a2c68f0a01f90b1 192.168.1.102:6383
   slots:[10923-16383] (5461 slots) master
   1 additional replica(s)
[OK] All nodes agree about slots configuration.
>>> Check for open slots...
>>> Check slots coverage...
[OK] All 16384 slots covered.

启动后的node1:6379节点是从节点,不再是主节点


 扫一扫


 8543


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


