


在爬取大众点评之前,已经想到会遇到反爬,只是没想到反爬措施这么狠。
爬取的关键问题主要是2点:
- ip被封
- 网页内容被加密
关于ip被封可以使用代理个人代理解决,芝麻代理每天都有免费的代理领取,当然还有很多公开的代理平台免费试用,当然如果你是有钱人家的孩子,可以购买代理。
下面开始开始写怎么爬取
一、分析
我们开始从url开始
http://www.dianping.com/shop/107732165这个是我们需要的每个商户的主页
我这里爬取选择广州的餐饮
- 先获取大众点评的美食分类的标签
- 按照行政区获取各区域的id
- 将美食分类和区域组合就可以获取到该链接下的url
我这里就简单一点爬取全部的,就不分类了
下面我们来分析源码
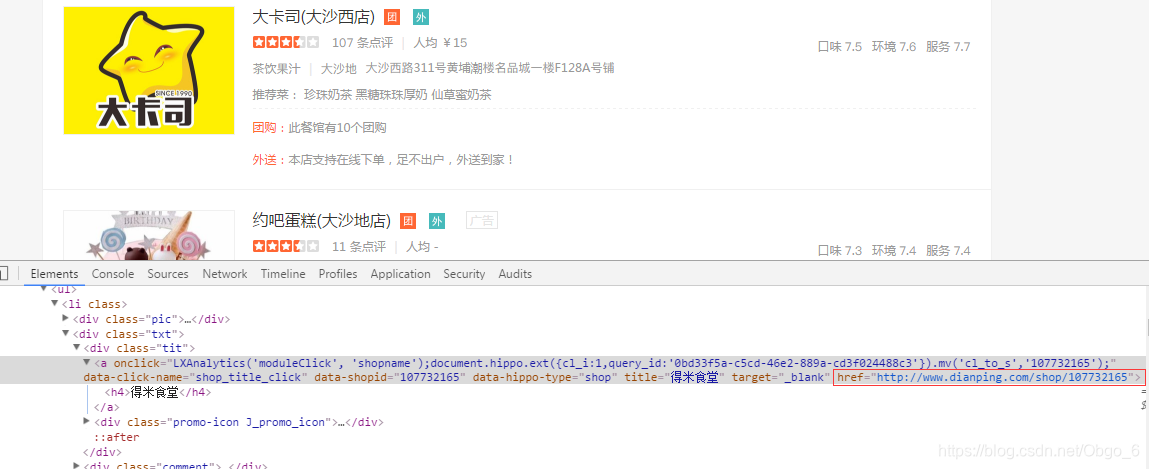
下面通过xpath抓取href链接
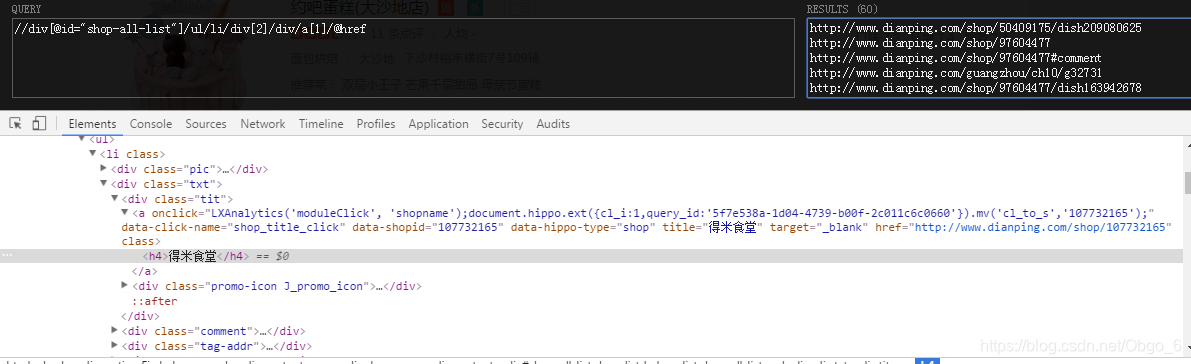
下面是代码的实现
import requests
from lxml import etree


url = 'http://www.dianping.com/guangzhou/ch10/r13880'
headers = {
    'Cookie':'navCtgScroll=0; _lxsdk_cuid=16cec6906cbc8-047c0f916a33a7-76212462-100200-16cec6906ccc8; _lxsdk=16cec6906cbc8-047c0f916a33a7-76212462-100200-16cec6906ccc8; _hc.v=b13839d4-ffa5-75e7-e9d3-93ffc6e5d2b8.1567334402; aburl=1; Hm_lvt_dbeeb675516927da776beeb1d9802bd4=1567404596; cy=4; cye=guangzhou; _lx_utm=utm_source%3DBaidu%26utm_medium%3Dorganic; s_ViewType=10; _lxsdk_s=16d064f44c2-2e3-76d-d4c%7C%7C116',
    'Host':'www.dianping.com',
    'Referer':'http://www.dianping.com/guangzhou/ch10/g210r13880',
    'Upgrade-Insecure-Requests':'1',
    'User-Agent':'Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/55.0.2883.87 UBrowser/6.2.4098.3 Safari/537.36'
}
r = requests.get(url, headers=headers)
html = etree.HTML(r.text)
href_all_list = html.xpath('//div[@id="shop-all-list"]/ul/li/div[2]/div/a[1]/@href')
for href in href_all_list:
    print(href)
运行结果
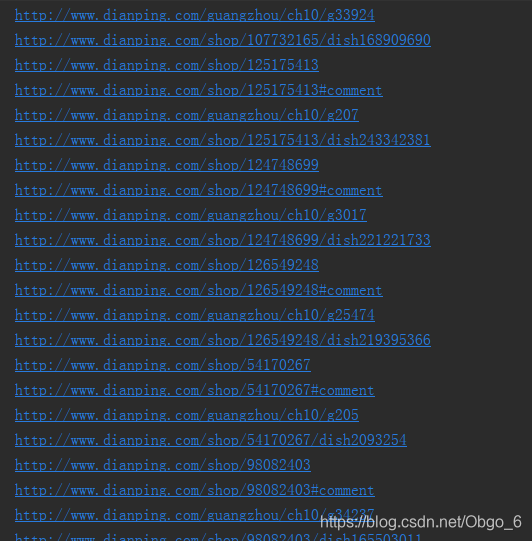
下面是重点开始抓取评论
首先解析
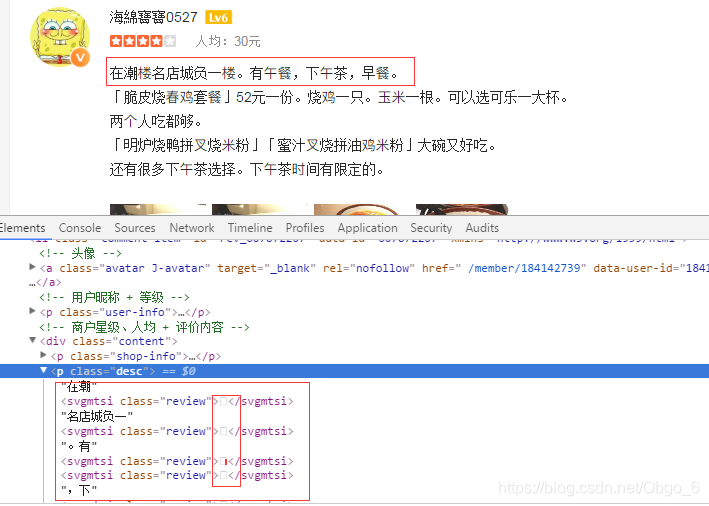
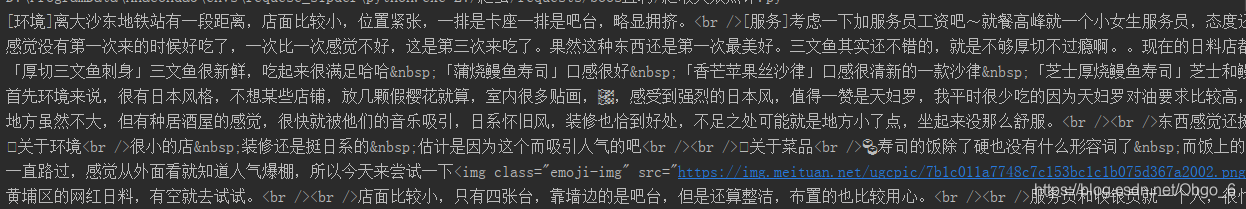
首先来看看,页面显示的和代码显示的内容
发现页面显示内容不相符,多了一些块状的,这是什么情
下面通过xpath抓取一下看看
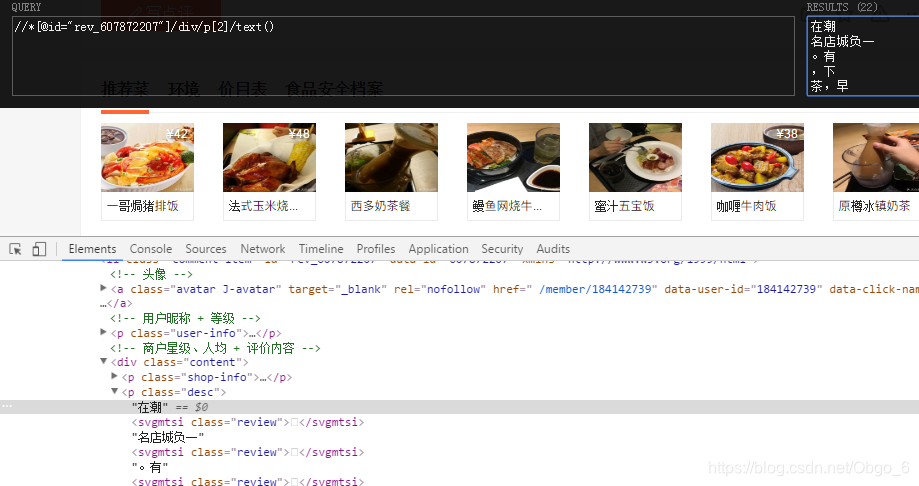 还是没有

是什么情况?
难道是通过js加密了?
经过不懈的努力把js文件全部看了一遍发现了这个ccs文件http://s3plus.meituan.net/v1/mss_0a06a471f9514fc79c981b5466f56b91/svgtextcss/1076181daac6336909f8448bbc87ddb8.css
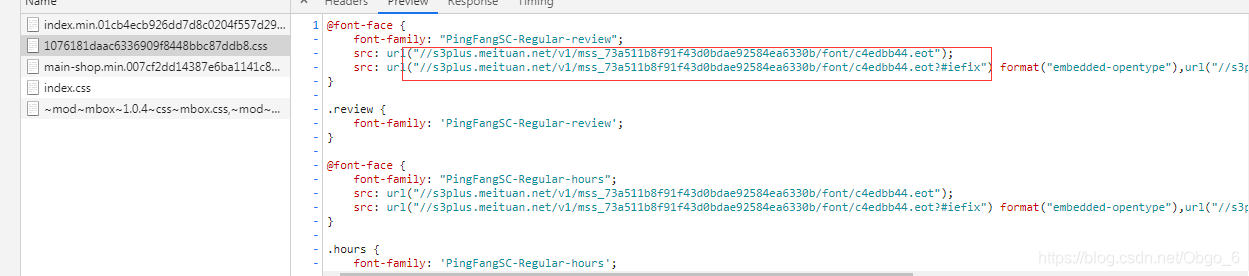
把这个链接复制到浏览器上会下载一个eot文件,去百度查了一下,发现是一个字体文件。
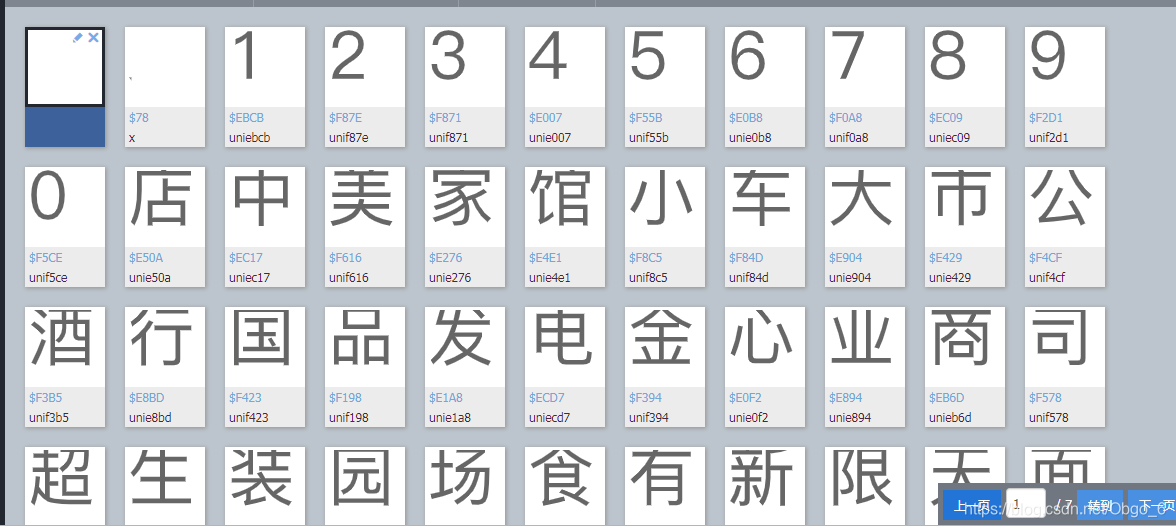
与源码中的unicode编码相比可知,编码的后四位是一样的,只要找到源码中unicode后四位一致的字符编码,该编码对应的汉字就是网页源码中要显示的信息。这里只要建立编码—汉字字典,取对应的编码的汉字就可以破解网页源码中的白色框框。这里的难点就是建立编码—汉字字典。
我这里做的比较简单,直接了一个字典,如果有跟好的方法可以在下面留言。
items = {'\\ebcb': '1', '\\f87e': '2', '\\f871': '3', '\\e007': '4', '\\f55b': '5', '\\e0b8': '6', '\\f0a8': '7', '\\ec09': '8', '\\f2d1': '9', '\\f5ce': '0', '\\e50a': '店', '\\ec17': '中', '\\f616': '美', '\\e276': '家', '\\e4e1': '馆', '\\f8c5': '小', '\\f84d': '车', '\\e904': '大', '\\e429': '市',下面就是具体的代码实现
import requests, re
from lxml import etree


def get_url(url, headers):
    r = requests.get(url, headers=headers)
    # r.encoding = r.apparent_encoding
    return r.text


def xpath_href(html_text):
    html = etree.HTML(html_text)
    href_all_list = html.xpath('//div[@id="shop-all-list"]/ul/li/div[2]/div/a[1]/@href')
    return href_all_list


def re_item(html_text, item):
    res = re.findall('<p class="desc">(.*?)</p>', html_text)
    for review in res:
        rev = re.findall('<svgmtsi class="review">&#x(.*?);</svgmtsi>', review)
        uni = re.split('<svgmtsi class="review">.*?</svgmtsi>', review)
        txt = ''
        for k, v in enumerate(rev):
            txt += uni[k] + item['\\' + v]
        txt += uni[-1]
        print(txt)


def main():
    item = {'\\ebcb': '1', '\\f87e': '2', '\\f871': '3', '\\e007': '4', '\\f55b': '5', '\\e0b8': '6',
            '\\f0a8': '7', '\\ec09': '8', '\\f2d1': '9', '\\f5ce': '0', '\\e50a': '店', '\\ec17': '中', '\\f616': '美',
            '\\e276': '家', '\\e4e1': '馆', '\\f8c5': '小', '\\f84d': '车', '\\e904': '大', '\\e429': '市', '\\f4cf': '公',
            '\\f3b5': '酒', '\\e8bd': '行', '\\f423': '国', '\\f198': '品', '\\e1a8': '发', '\\ecd7': '电', '\\f394': '金',
            '\\e0f2': '心', '\\e894': '业', '\\eb6d': '商', '\\f578': '司', '\\f26f': '超', '\\f677': '生', '\\e9e5': '装',
            '\\f376': '园', '\\e5d4': '场', '\\ecdc': '食', '\\f8f6': '有', '\\e89e': '新', '\\e912': '限', '\\ec05': '天',
            '\\f2ef': '面', '\\ed5e': '工', '\\e84c': '服', '\\e867': '海', '\\f093': '华', '\\f087': '水', '\\ea15': '房',
            '\\ef42': '饰', '\\f6c6': '城', '\\e5b8': '乐', '\\e662': '汽', '\\f2d8': '香', '\\f781': '部', '\\e159': '利',
            '\\e2de': '子', '\\f45b': '老', '\\e4fd': '艺', '\\ee21': '花', '\\f10a': '专', '\\eae9': '东', '\\e9a8': '肉',
            '\\f39b': '菜', '\\ed44': '学', '\\e684': '福', '\\e6a2': '饭', '\\ec4c': '人', '\\ecda': '百', '\\e921': '餐',
            '\\f69c': '茶', '\\e3e3': '务', '\\e8a7': '通', '\\e15e': '味', '\\e691': '所', '\\ec56': '山', '\\f8e6': '区',
            '\\e213': '门', '\\ead2': '药', '\\f513': '银', '\\e0fa': '农', '\\e819': '龙', '\\f2db': '停', '\\f20e': '尚',
            '\\efd1': '安', '\\ea09': '广', '\\f878': '鑫', '\\e899': '一', '\\f711': '容', '\\e492': '动', '\\e830': '南',
            '\\f50e': '具', '\\f808': '源', '\\e7a0': '兴', '\\e253': '鲜', '\\ef83': '记', '\\f039': '时', '\\e26e': '机',
            '\\e706': '烤', '\\e4e2': '文', '\\e247': '康', '\\f4e5': '信', '\\f64a': '果', '\\e432': '阳', '\\f2e1': '理',
            '\\edet': '化', '\\f18f': '五', '\\ef01': '米', '\\f886': '修', '\\eb41': '爱', '\\e48a': '北', '\\ecef': '养',
            '\\f663': '卖', '\\e9a5': '建', '\\f630': '材', '\\e62e': '三', '\\eec6': '会', '\\f6ef': '鸡', '\\f121': '室',
            '\\e2c0': '红', '\\e449': '站', '\\ec9d': '德', '\\e7cd': '王', '\\effc': '光', '\\ea28': '名', '\\f8f1': '丽',
            '\\e6b3': '油', '\\f239': '院', '\\ed5b': '堂', '\\e2d5': '烧', '\\e5fa': '江', '\\e509': '社', '\\e3b2': '合',
            '\\e412': '星', '\\e23b': '货', '\\f29a': '型', '\\e4ea': '村', '\\ecf6': '自', '\\f6f8': '科', '\\e58d': '快',
            '\\f386': '便', '\\f803': '日', '\\ef0b': '民', '\\f635': '营', '\\e74e': '和', '\\f5d7': '活', '\\eb04': '童',
            '\\e598': '明', '\\ebd9': '器', '\\f232': '烟', '\\e9f5': '育', '\\f7b6': '宾', '\\e0f1': '精', '\\e94f': '屋',
            '\\e135': '经', '\\edc7': '居', '\\efea': '庄', '\\e7ad': '石', '\\ee7b': }
    url = 'http://www.dianping.com/guangzhou/ch10/r13880'
    headers = {
        'Cookie': 'navCtgScroll=0; _lxsdk_cuid=16cec6906cbc8-047c0f916a33a7-76212462-100200-16cec6906ccc8; _lxsdk=16cec6906cbc8-047c0f916a33a7-76212462-100200-16cec6906ccc8; _hc.v=b13839d4-ffa5-75e7-e9d3-93ffc6e5d2b8.1567334402; aburl=1; Hm_lvt_dbeeb675516927da776beeb1d9802bd4=1567404596; cy=4; cye=guangzhou; _lx_utm=utm_source%3DBaidu%26utm_medium%3Dorganic; s_ViewType=10; _lxsdk_s=16d064f44c2-2e3-76d-d4c%7C%7C116',
        'Host': 'www.dianping.com',
        'Referer': 'http://www.dianping.com/guangzhou/ch10',
        'Upgrade-Insecure-Requests': '1',
        'User-Agent': 'Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/55.0.2883.87 UBrowser/6.2.4098.3 Safari/537.36'
    }
    html_text = get_url(url, headers)
    href_list = xpath_href(html_text)
    for href in href_list:
        show_html = get_url(href, headers)
        re_item(show_html, item)


if __name__ == '__main__':
    main()
下面是运行效果:
运行报错:
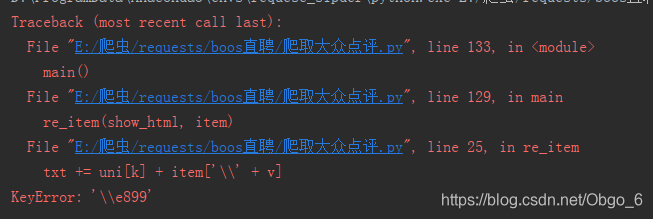
需要跟新一下字体的字典
后续会跟新跟详细的爬取,请关注下一篇博客


 扫一扫


 1万+


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


