


一、前言
之前做社媒数据采集相关的项目,需要批量获取账号帖子、评论内容还有视频互动数据,目标平台页面嵌套复杂,加载逻辑全是动态的,跑任务的时候动不动就触发访问阻碍,好不容易拿到返回结果,还经常碰到字段缺失、请求直接失败的情况。
一开始我以为写个简单请求脚本就能搞定,真上手才发现最磨人的不是写代码,而是要长期稳定维护一整套流程:适配页面渲染、绕过反爬限制、解析字段、管理定时任务、导出可用结果,每天大半精力都耗在这些运维琐事上。也尝试了很多工具,效果都不太如意。
最近我发现了一个平台,它直接把底层采集基建、标准化采集API、现成数据集和可视化控制台整合到了一起。
二、 它能解决什么问题
这个平台是Dataify,它跳出了过去“自己写脚本+搭IP资源池”的零散模式,把采集相关的能力都做了模块化封装,哪怕是没有太多采集开发经验的人,也能快速上手跑通稳定的数据采集流程。
Dataify 的产品结构可以拆成四个核心模块:产品定位、采集 API 矩阵、行业数据集板块和 Dashboard 控制台。
采集 API 矩阵:四类核心接口
进入 Dataify 控制台后,最核心的是四类标准化采集 API。
立即体验:
https://dataify.com?utm_source=aqsdm&utm_term=01
SERP API:搜索引擎结果采集
SERP API 用于实时获取 Google、Bing、Yandex、DuckDuckGo 等搜索引擎结果,包括自然搜索结果、广告位、People Also Ask 等 SERP Feature。
它支持本地化搜索参数、设备类型配置和结果结构化解析,适合 SEO 监控、关键词排名分析、广告情报分析和搜索趋势研究。
比如这里使用 Google API。配置好参数后,运行请求即可开始采集,右侧也会生成对应的请求代码。
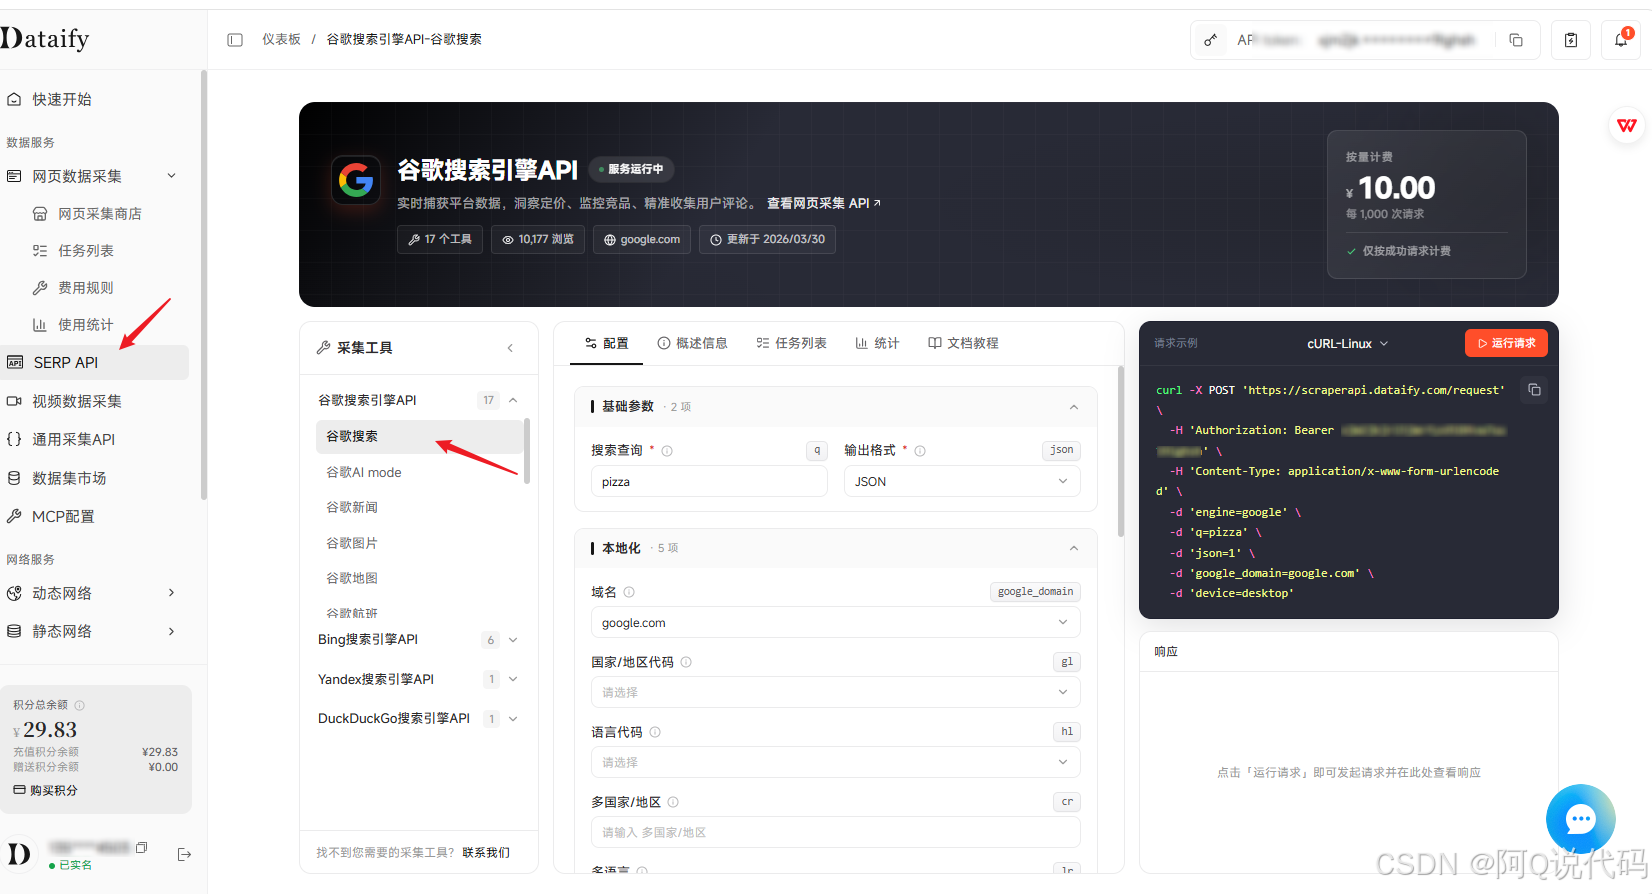
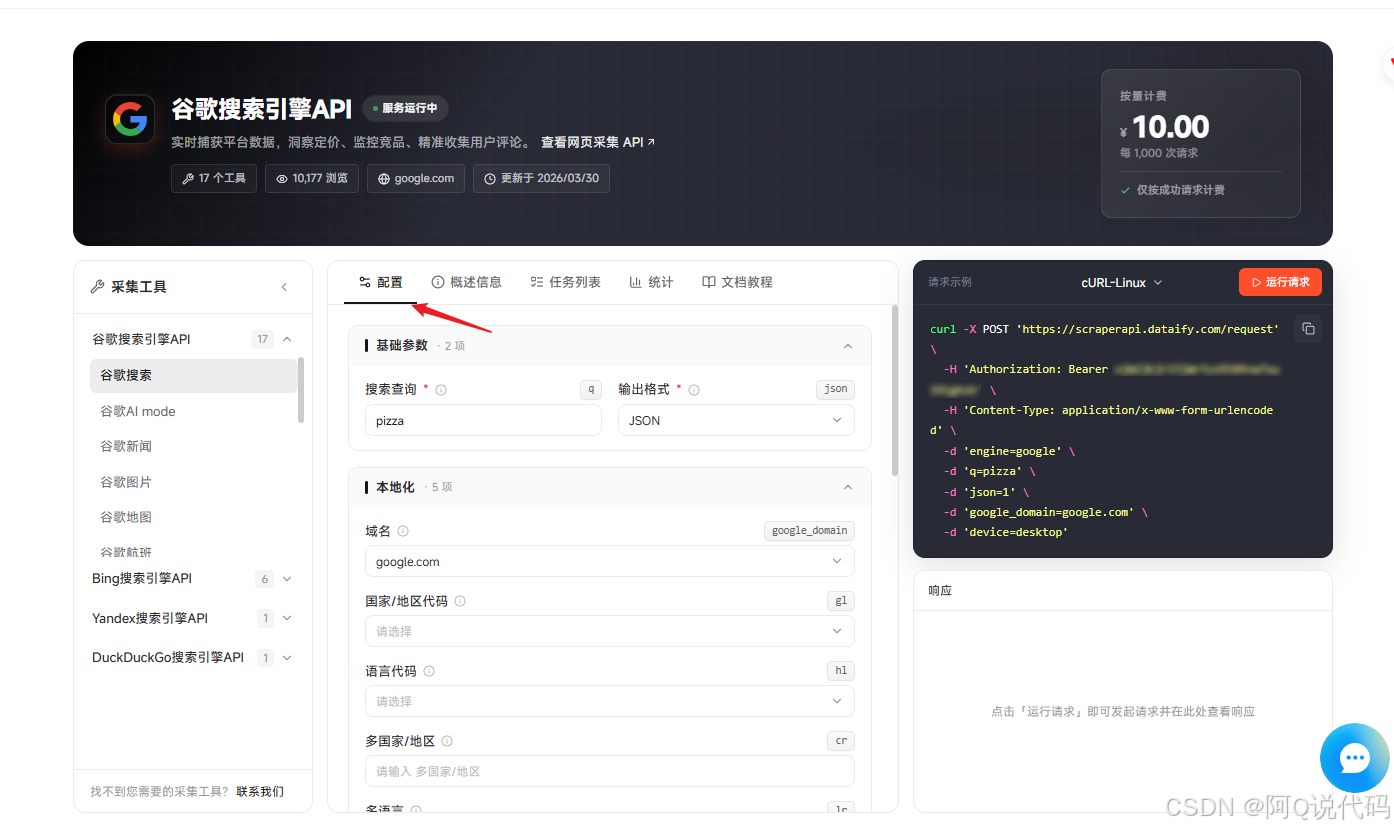
示例请求:
curl -X POST 'https://scraperapi.dataify.com/request' \
-H 'Authorization: Bearer 你的APItoken' \
-H 'Content-Type: application/x-www-form-urlencoded' \
-d 'engine=google' \
-d 'q=pizza' \
-d 'json=1' \
-d 'google_domain=google.com' \
-d 'device=desktop'
网页采集 API:网页内容结构化抓取
网页采集 API 适合采集商品详情页、新闻文章、企业黄页、跨境电商页面等内容。
开发者提交目标 URL 后,API 可以处理页面访问、JS 渲染、反爬绕过和数据返回,输出格式可根据需求选择 HTML、Markdown 或结构化 JSON。
在控制台中,用户可以查看采集器说明、示例输出、字段解释和输入参数说明。
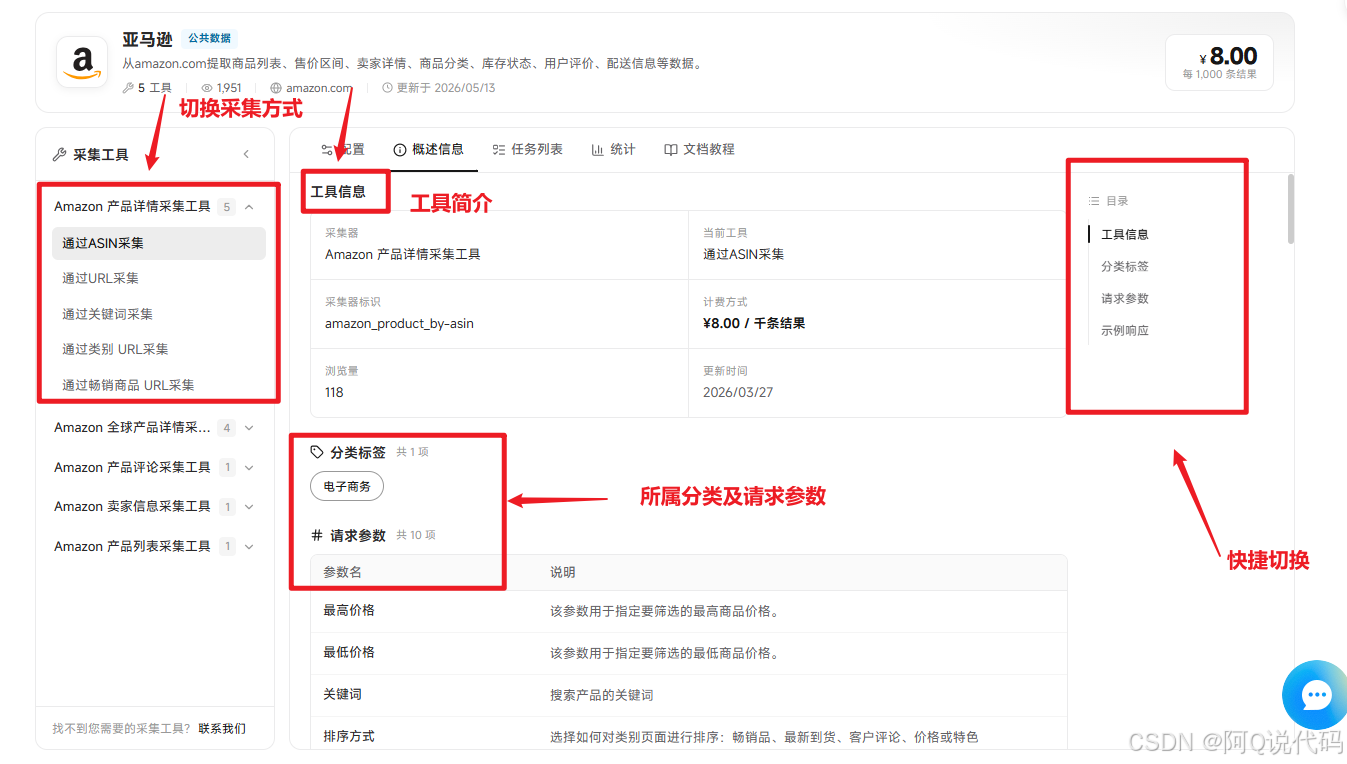 以 Amazon 商品详情页为例,只需将商品链接填入 API 构建器中的 URL 参数,即可发起采集任务。
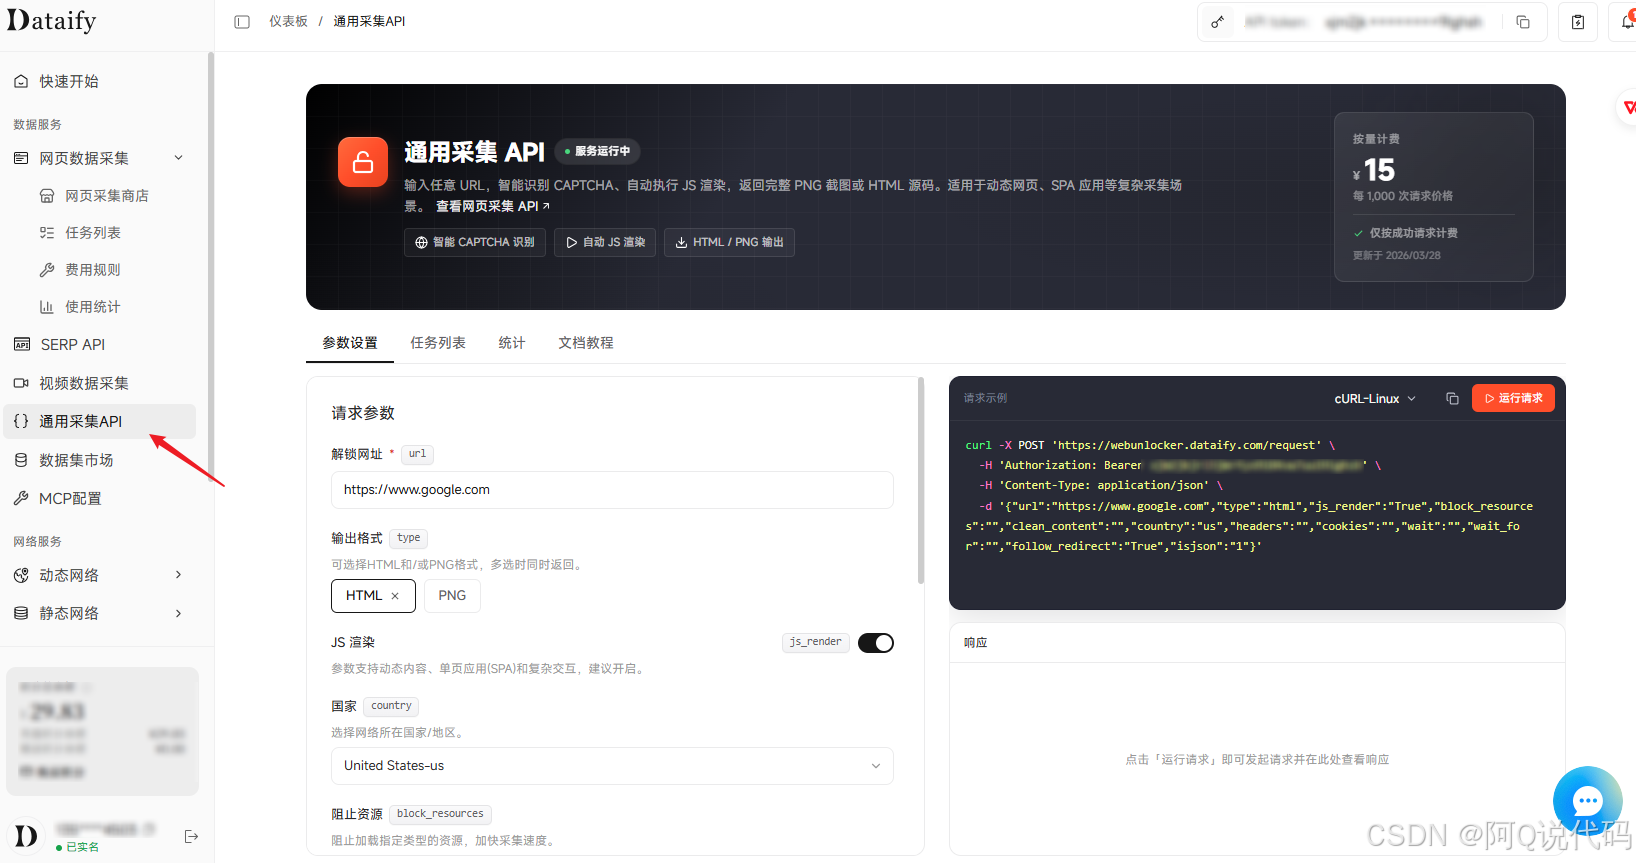
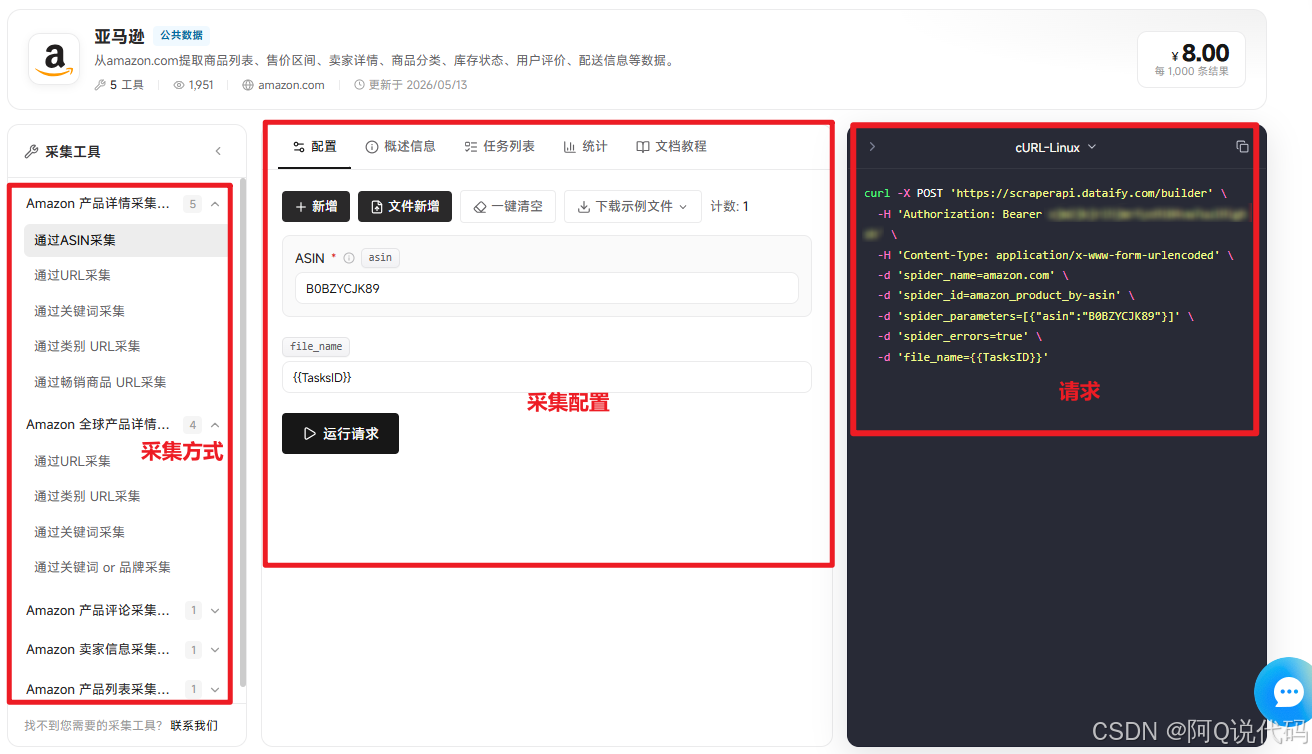 通用采集 API:长尾站点兜底方案
通用采集 API 适合没有专门模板的站点,例如长尾行业网站、结构不固定页面、冷门内容页等。
它的价值在于降低开发者对站点结构的依赖。对于无法直接套用预置模板的网站,可以通过通用接口发起请求,由平台处理访问路由、浏览器指纹、JS 渲染和验证码等复杂流程。
 视频采集 API:视频平台元数据采集
视频采集 API 用于采集视频 URL、频道或关键词下的结构化元数据,包括标题、作者、播放量、评论数、互动量等字段。
它适合短视频舆情分析、达人筛选、内容监测、视频榜单同步等场景。
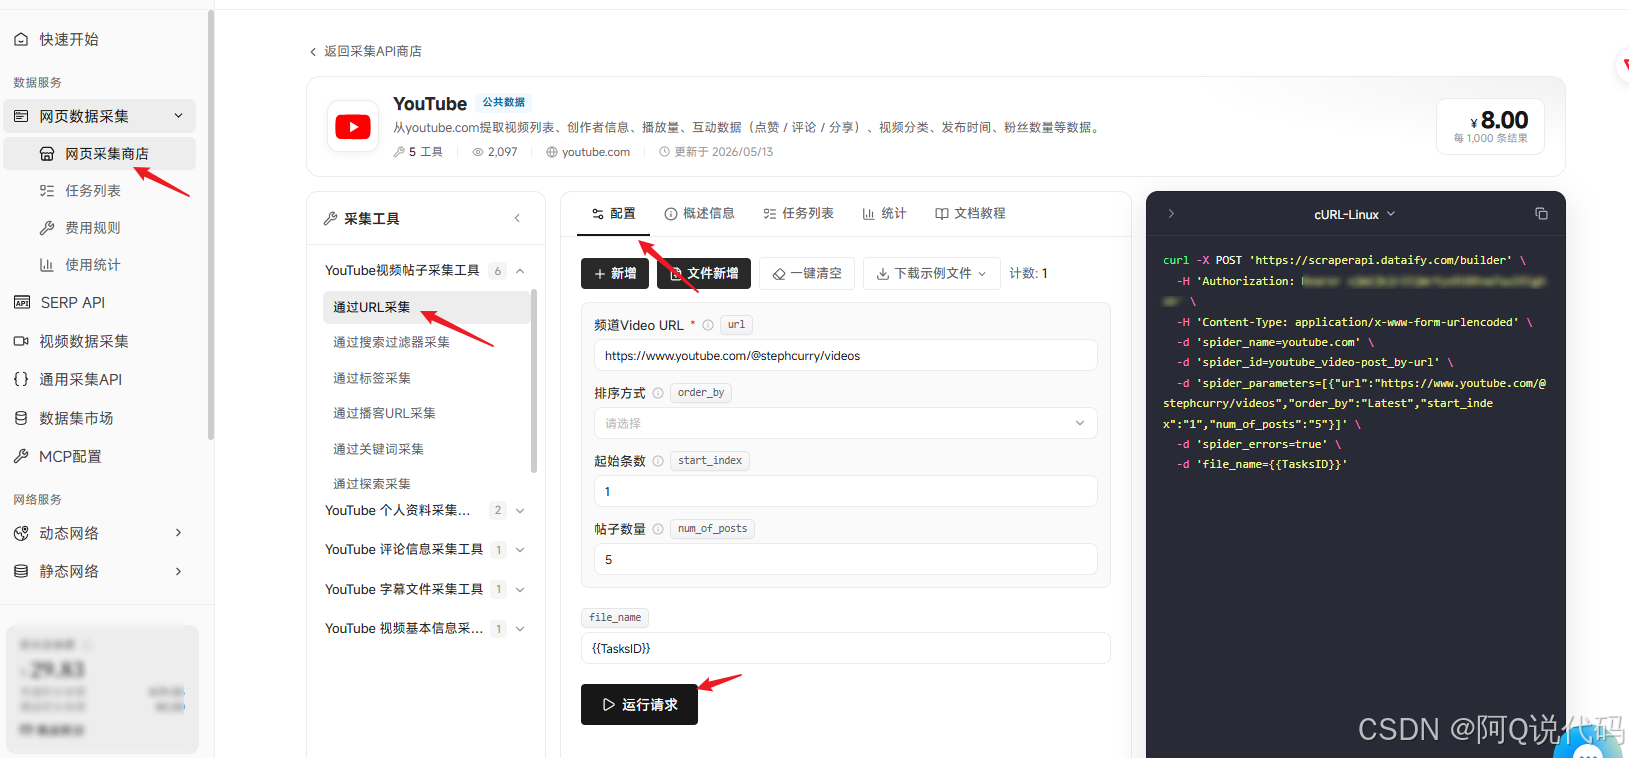 示例请求:
curl -X POST 'https://scraperapi.dataify.com/builder' \
-H 'Authorization: Bearer 你的API' \
-H 'Content-Type: application/x-www-form-urlencoded' \
-d 'spider_name=youtube.com' \
-d 'spider_id=youtube_video-post_by-url' \
-d 'spider_parameters=[{"url":"https://www.youtube.com/@stephcurry/videos","order_by":"Latest","start_index":"1","num_of_posts":"5"}]' \
-d 'spider_errors=true' \
-d 'file_name={{TasksID}}'
行业数据集板块:不想采,也可以直接用数据
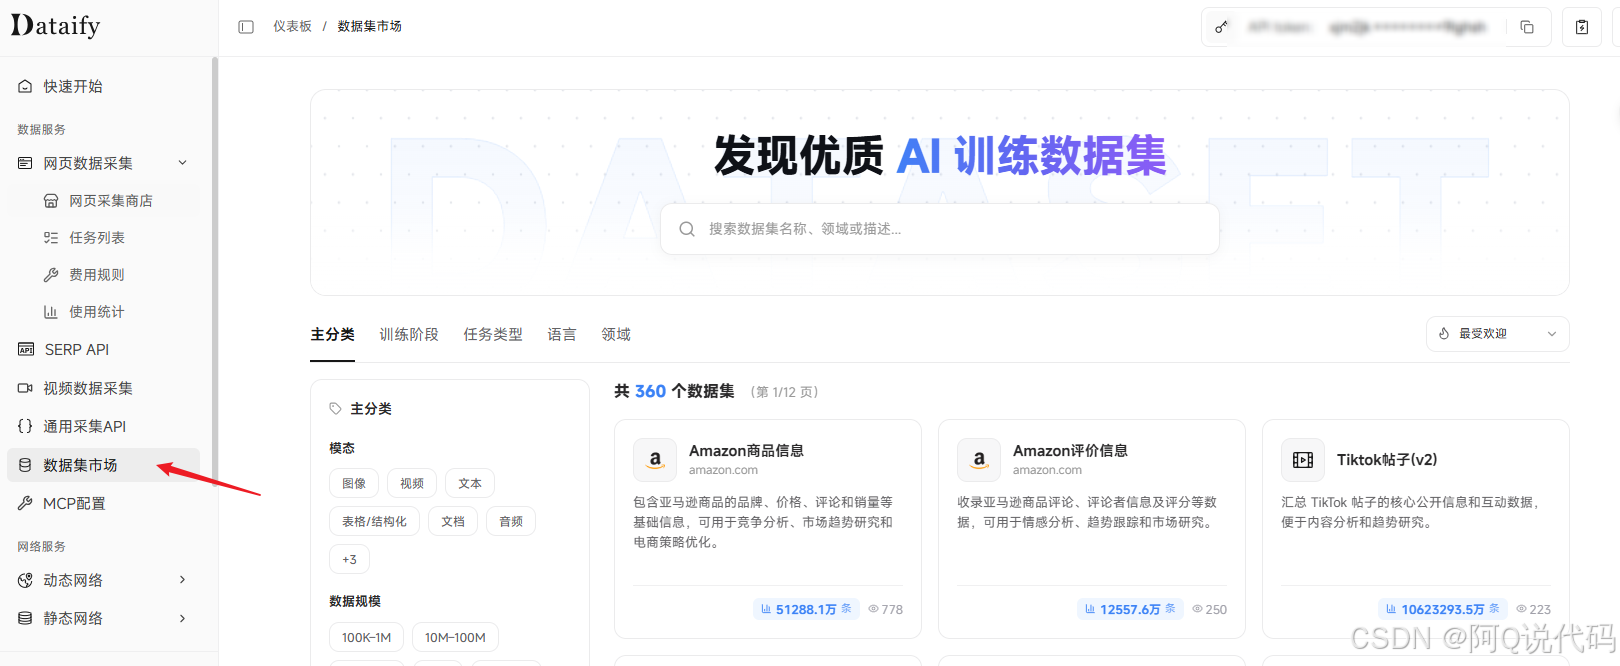
除了 API,Dataify 还提供数据集市场,公开了1000+数据集,覆盖电商、社交媒体、音视频、AI 训练、金融、医疗、法律等多个方向。
典型场景包括:
 Dashboard 控制台:采集任务的驾驶舱
Dataify Dashboard 控制台主要包含以下功能:
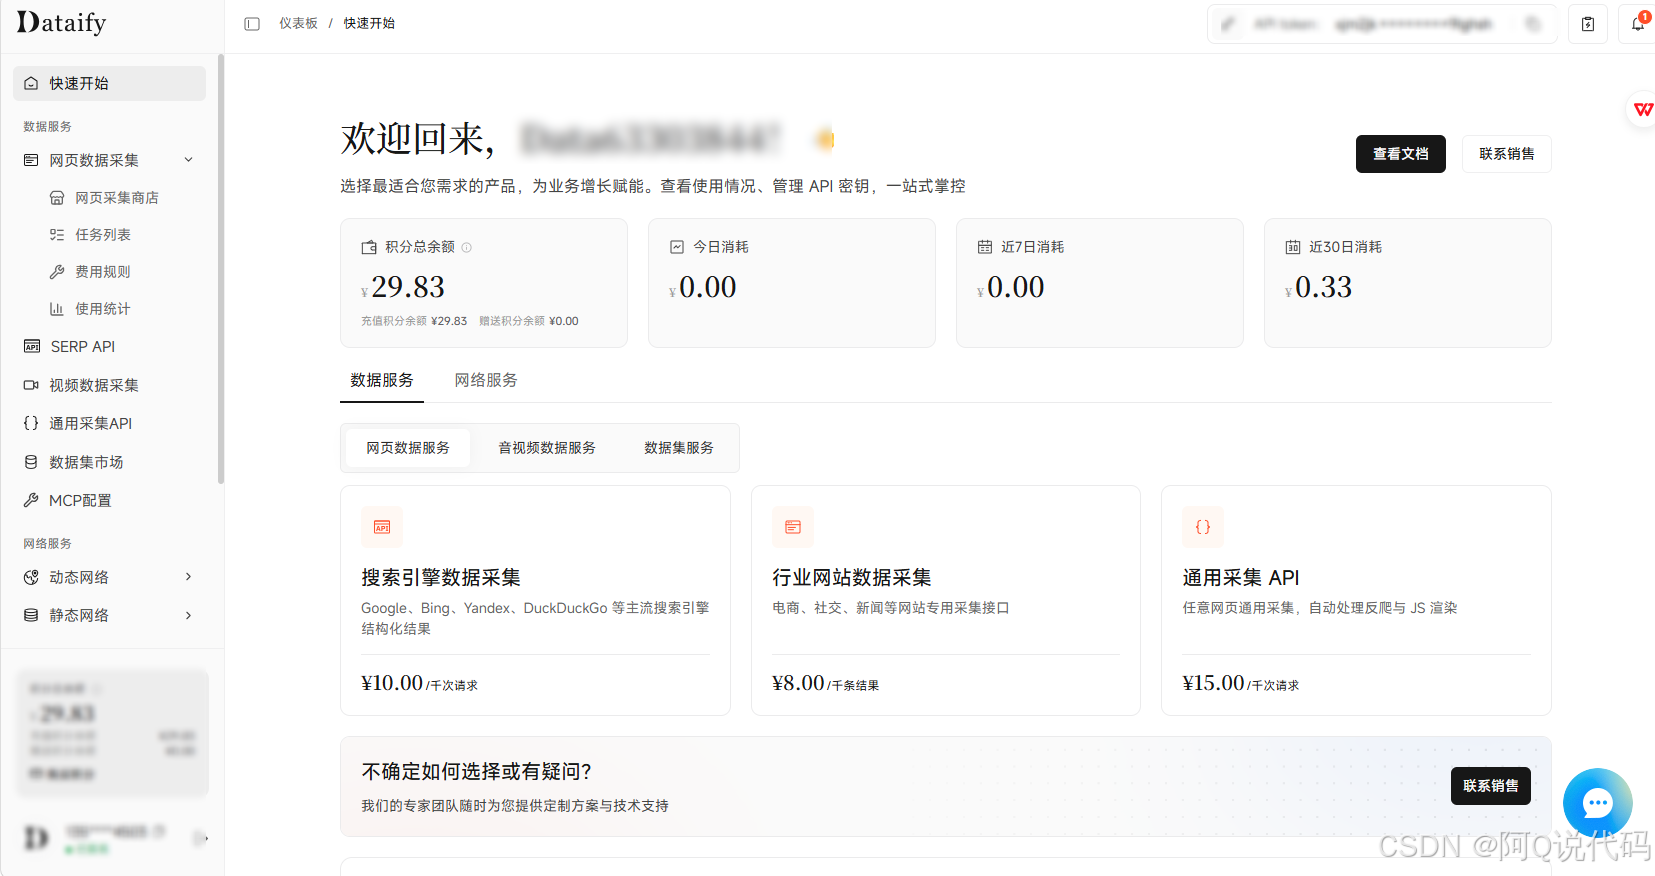 整体来看,Dashboard 更像是采集任务的驾驶舱。它不仅能发起任务,还能查看任务状态、响应时间、成功率、积分消耗和历史日志,方便后续排查问题和评估采集稳定性。
三、案例
案例一:获取X帖子
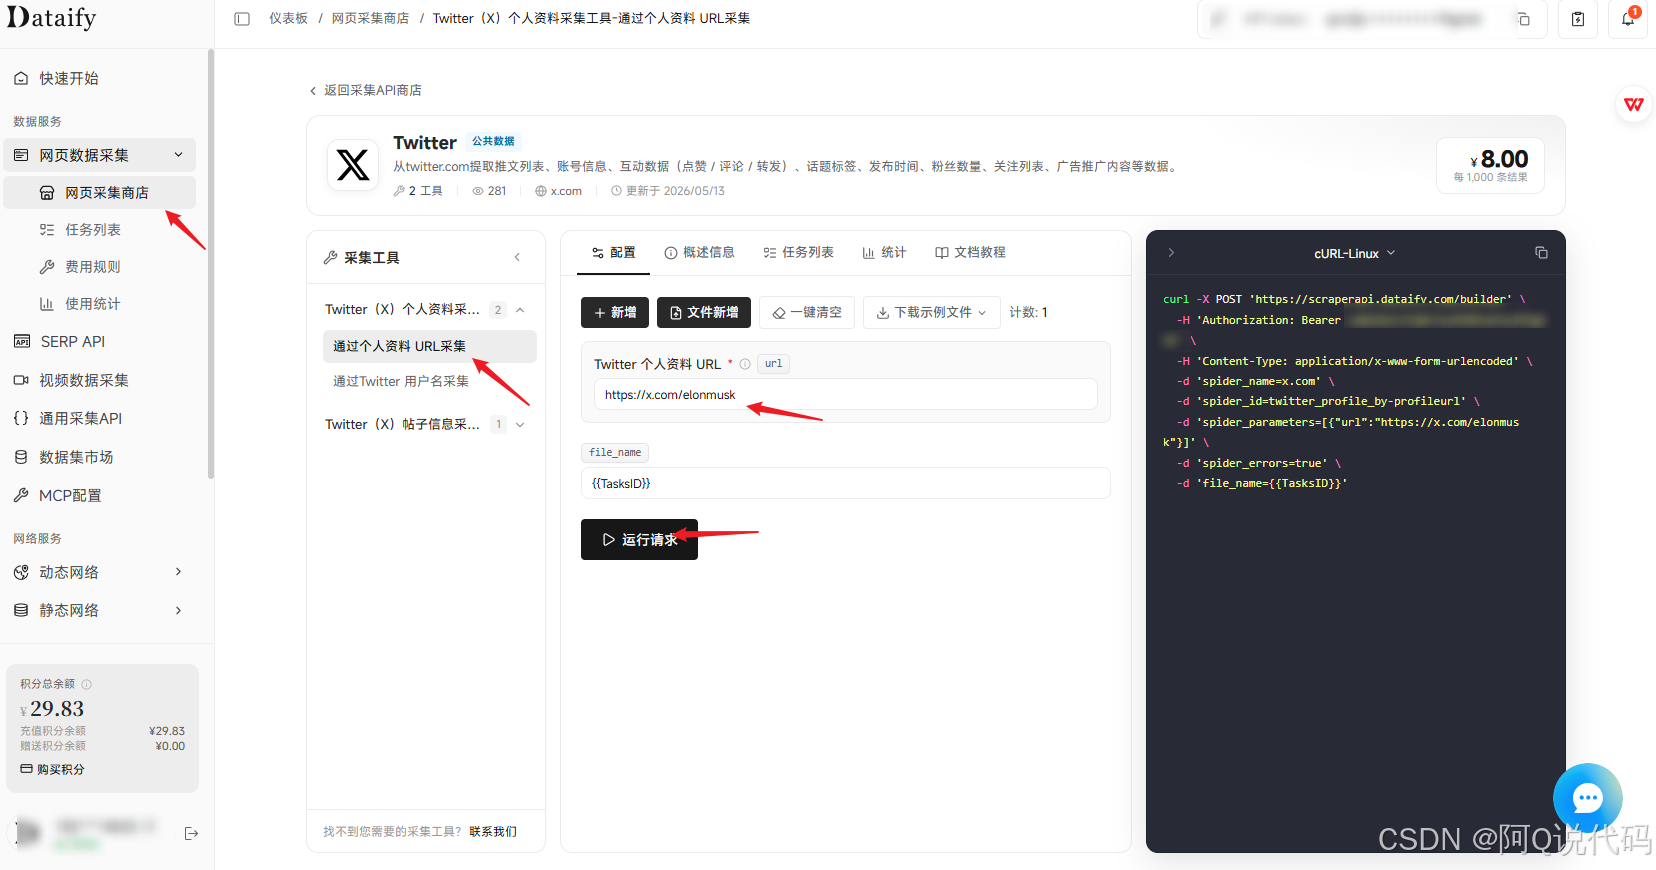
这里以采集 X(Twitter)帖子为例。在网页采集商店中找到 X 采集器,配置目标账号地址后,点击运行请求即可创建采集任务。
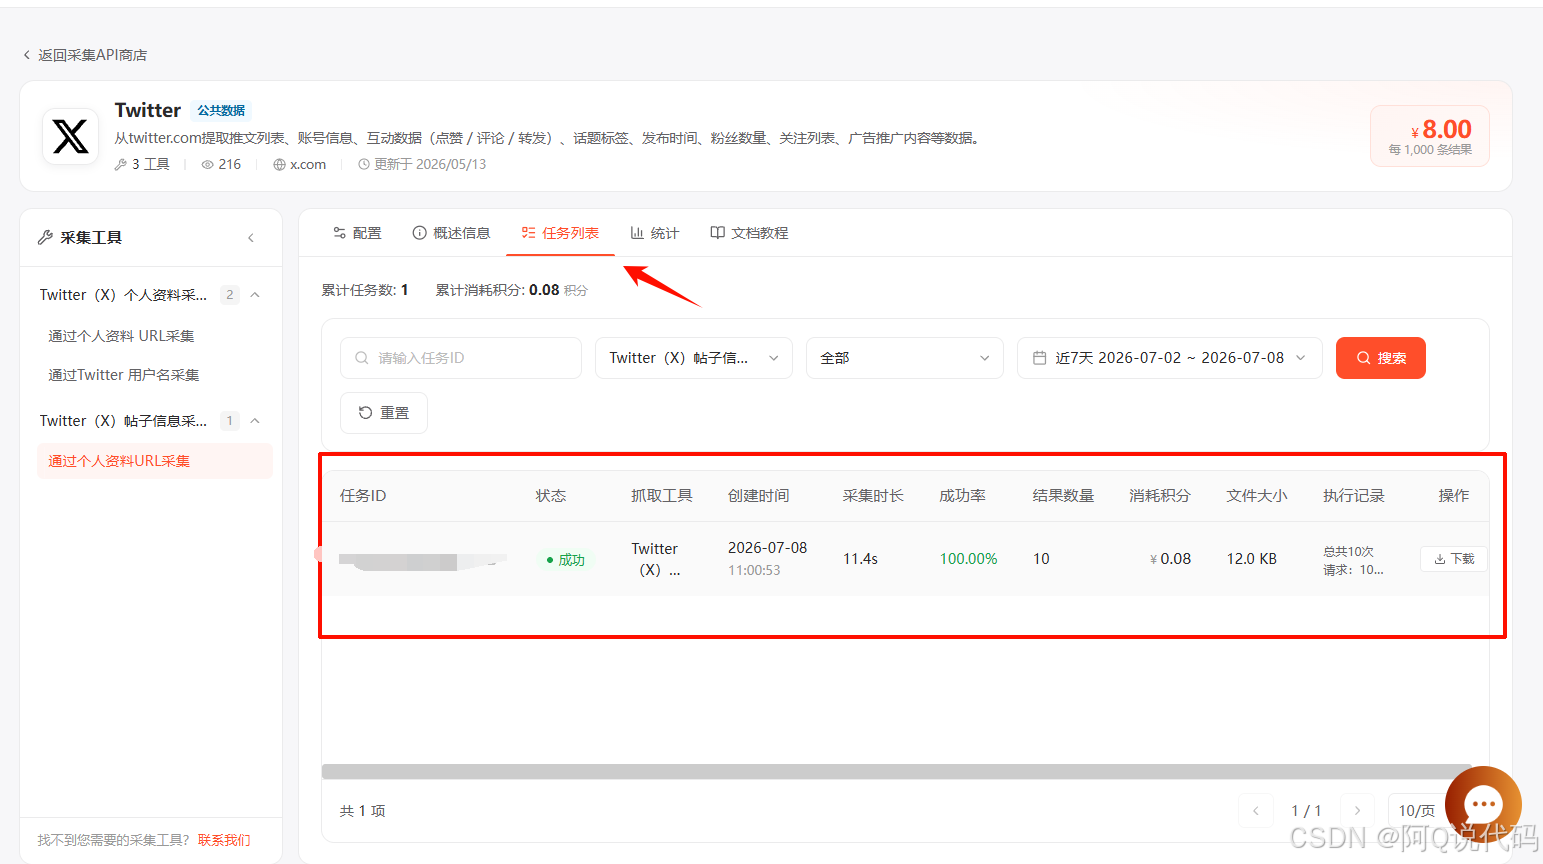
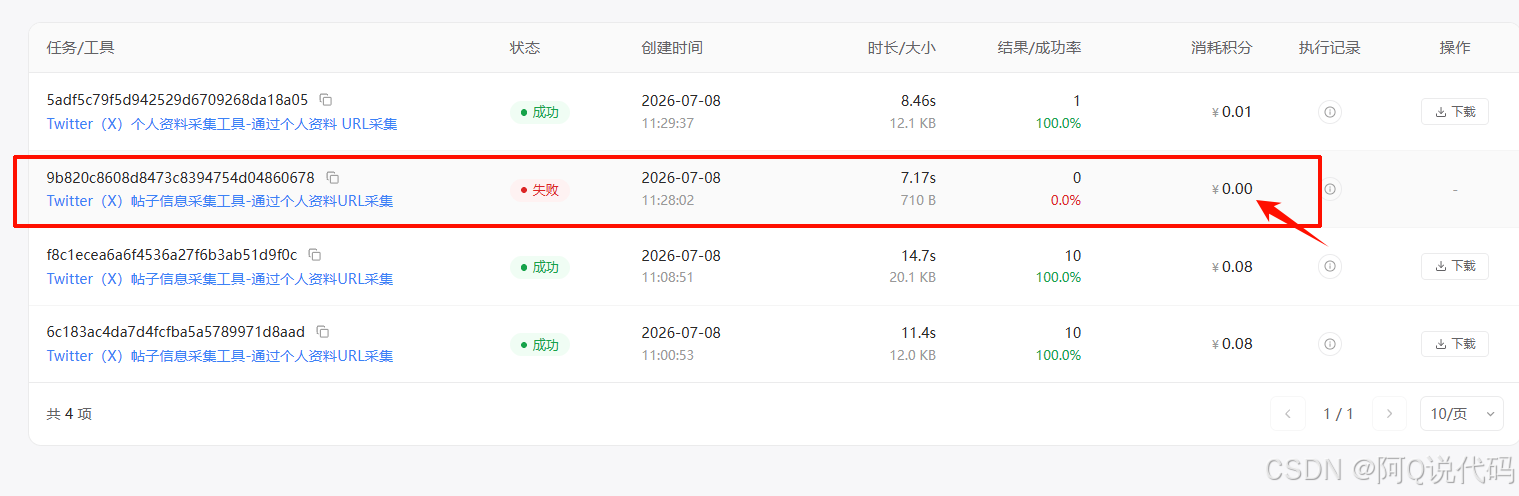
 在任务列表中可以看到创建的任务,包括任务ID、状态、时长、成功率等等。
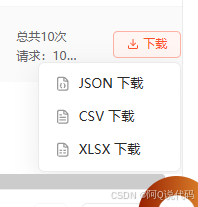
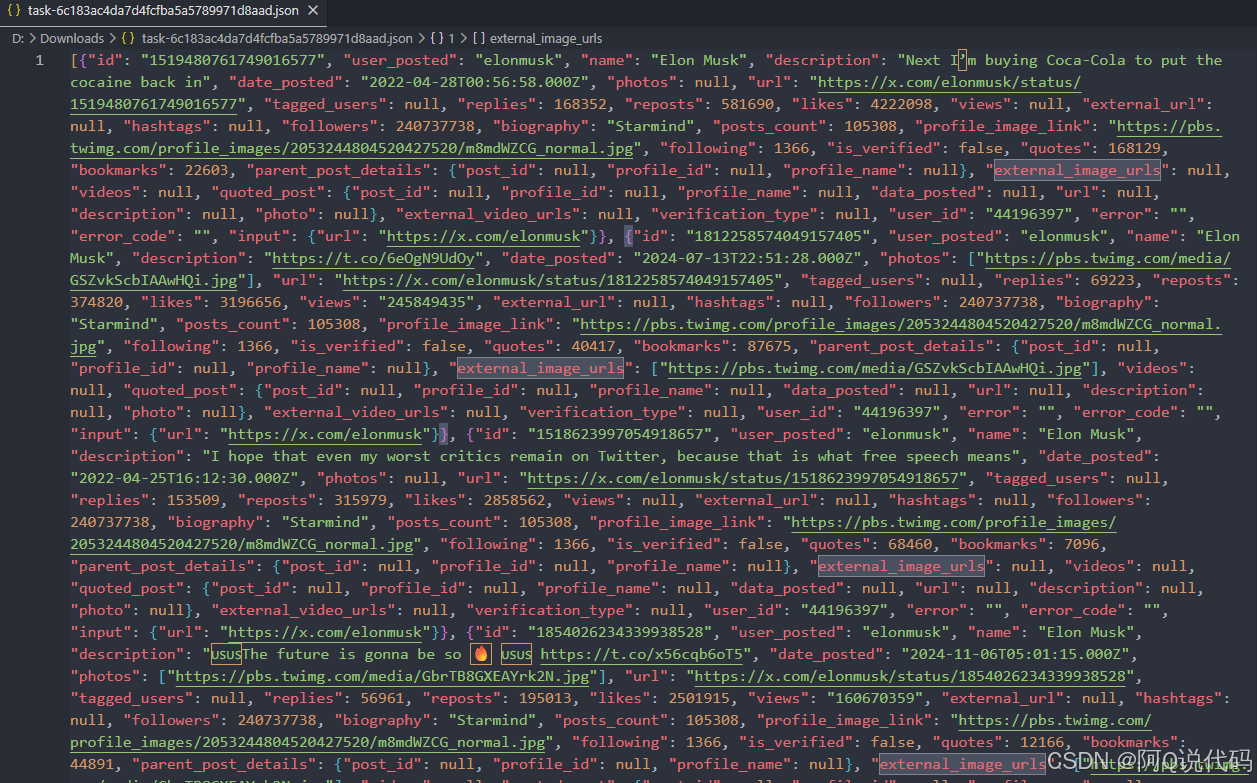
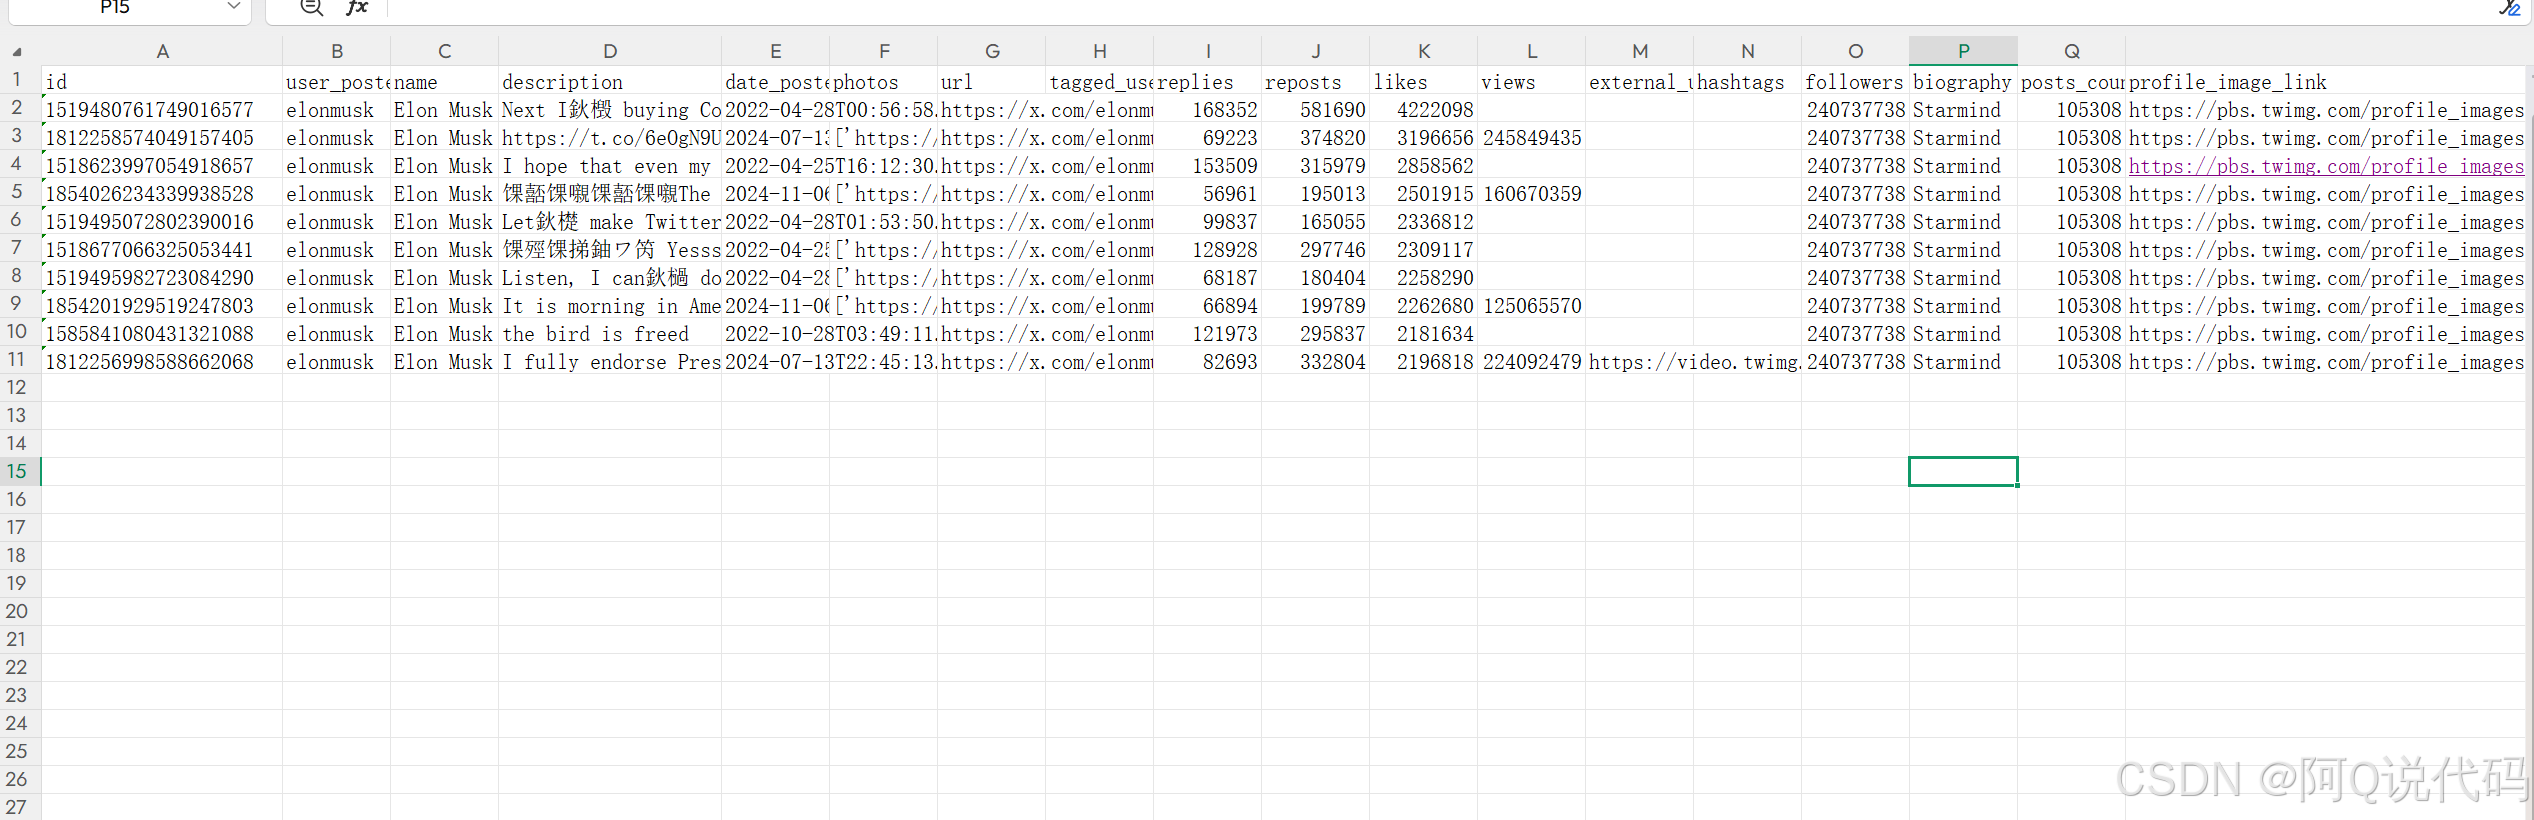
 任务完成后,点击下载,可以导出 JSON、CSV、XLSX 三种格式的数据。返回结果中包含推文列表、账号信息、互动数据(点赞、评论、转发)、话题标签、发布时间、粉丝数量、关注列表、广告推广内容等字段。
实际体验下来,响应速度比较快,等待几秒即可看到采集结果。
curl -X POST 'https://scraperapi.dataify.com/builder' \
-H 'Authorization: Bearer 你的APItoken' \
-H 'Content-Type: application/x-www-form-urlencoded' \
-d 'spider_name=x.com' \
-d 'spider_id=twitter_post_by-profileurl' \
-d 'spider_parameters=[{"url":"https://x.com/elonmusk"}]' \
-d 'spider_errors=true' \
-d 'file_name={{TasksID}}'
import requests
url = "https://scraperapi.dataify.com/builder"
headers = {
"Authorization": "Bearer 你的APItoken",
"Content-Type": "application/x-www-form-urlencoded",
}
data = {
"spider_name": "x.com",
"spider_id": "twitter_post_by-profileurl",
"spider_parameters": '[{"url":"https://x.com/elonmusk"}]',
"spider_errors": "true",
"file_name": "{{TasksID}}",
}
response = requests.post(url, headers=headers, data=data)
print(response.text)
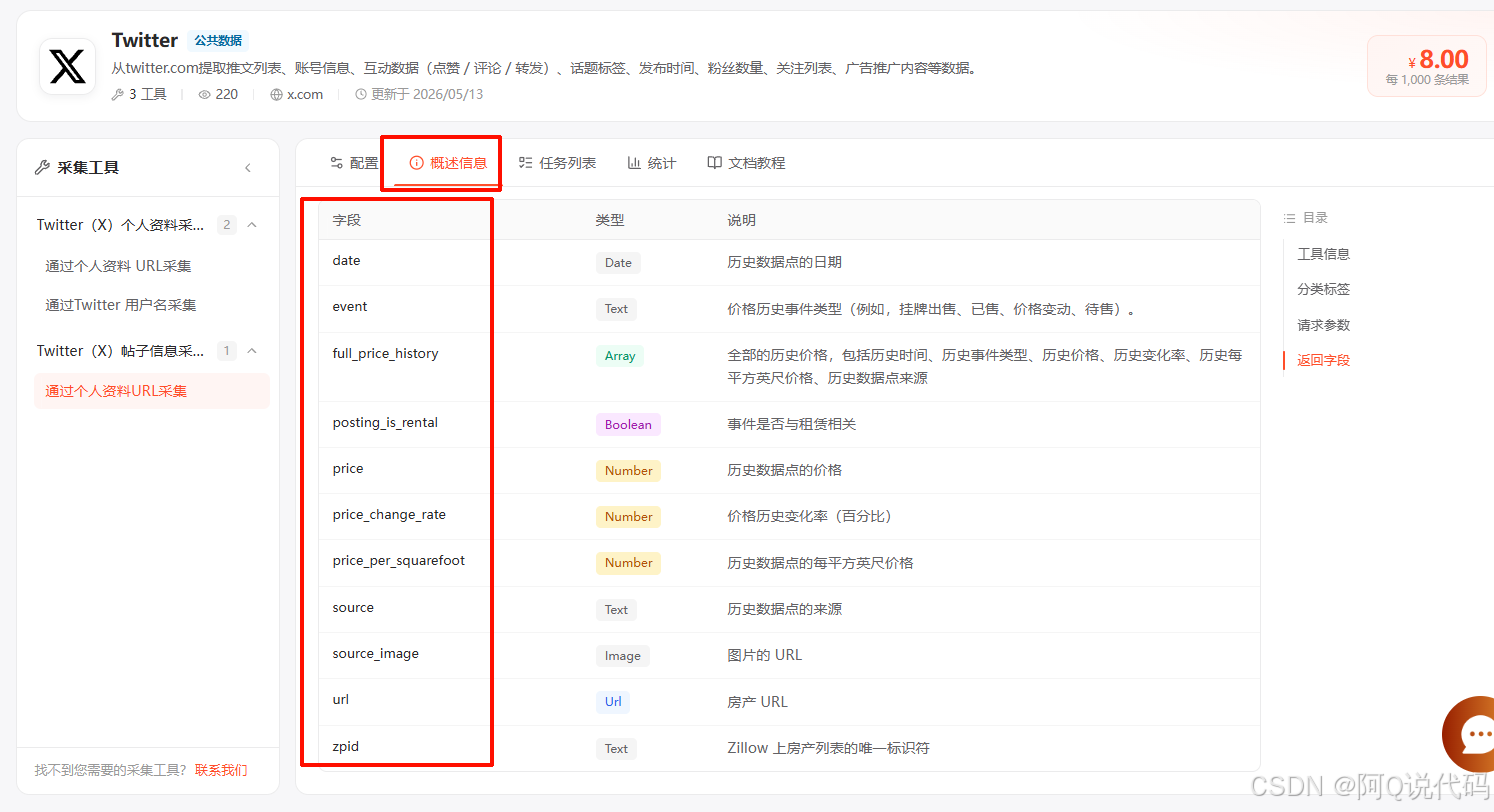
在概述信息中,可以看到该采集器支持返回的字段。对于社交媒体分析来说,比较关键的字段包括帖子正文、发布时间、点赞数、评论数、转发数、账号名称、粉丝数等。
 这里还专门设置了一个错误参数做测试。任务失败后,控制台显示失败消耗积分为 0。这个设计对接入初期比较友好,因为刚开始调试 API 时,参数填错、URL 格式错误、采集器选择错误都很常见,如果错误请求不扣积分,可以降低试错成本。
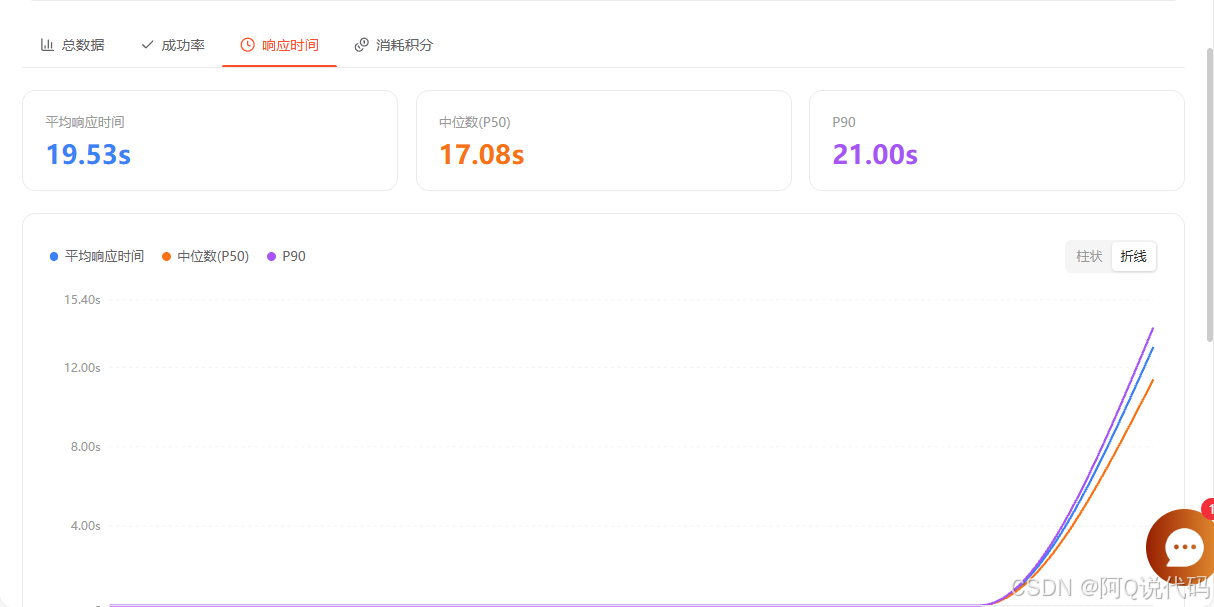
 除此之外,Dashboard 还提供了详细的任务统计信息,包括平均响应时间、P50、P90 等指标,便于评估任务运行表现。
 案例二:采集YouTube评论信息
我让它采集了YouTube评论信息,配置好后开始采集。
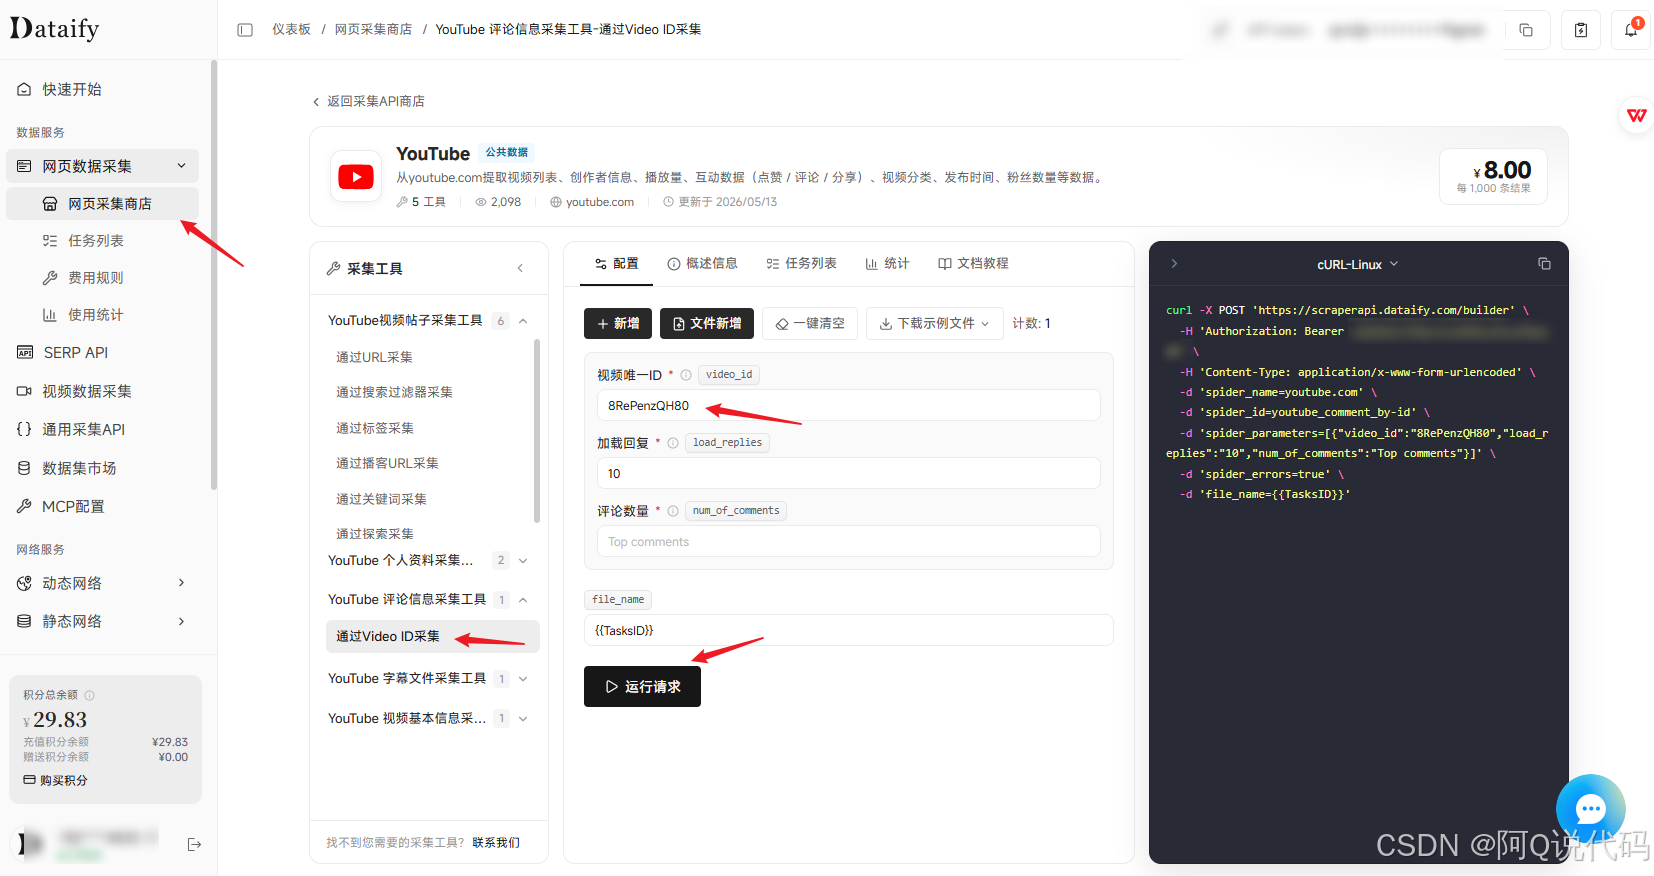 实际返回的数据比较完整,包括评论内容、评论发布时间、评论作者、点赞数量、回复数量和评论 ID。
而且 评论数据已经完成结构化处理,不需要再自己解析 HTML,可以直接用于评论分析、情感分析、用户画像或数据统计等业务。
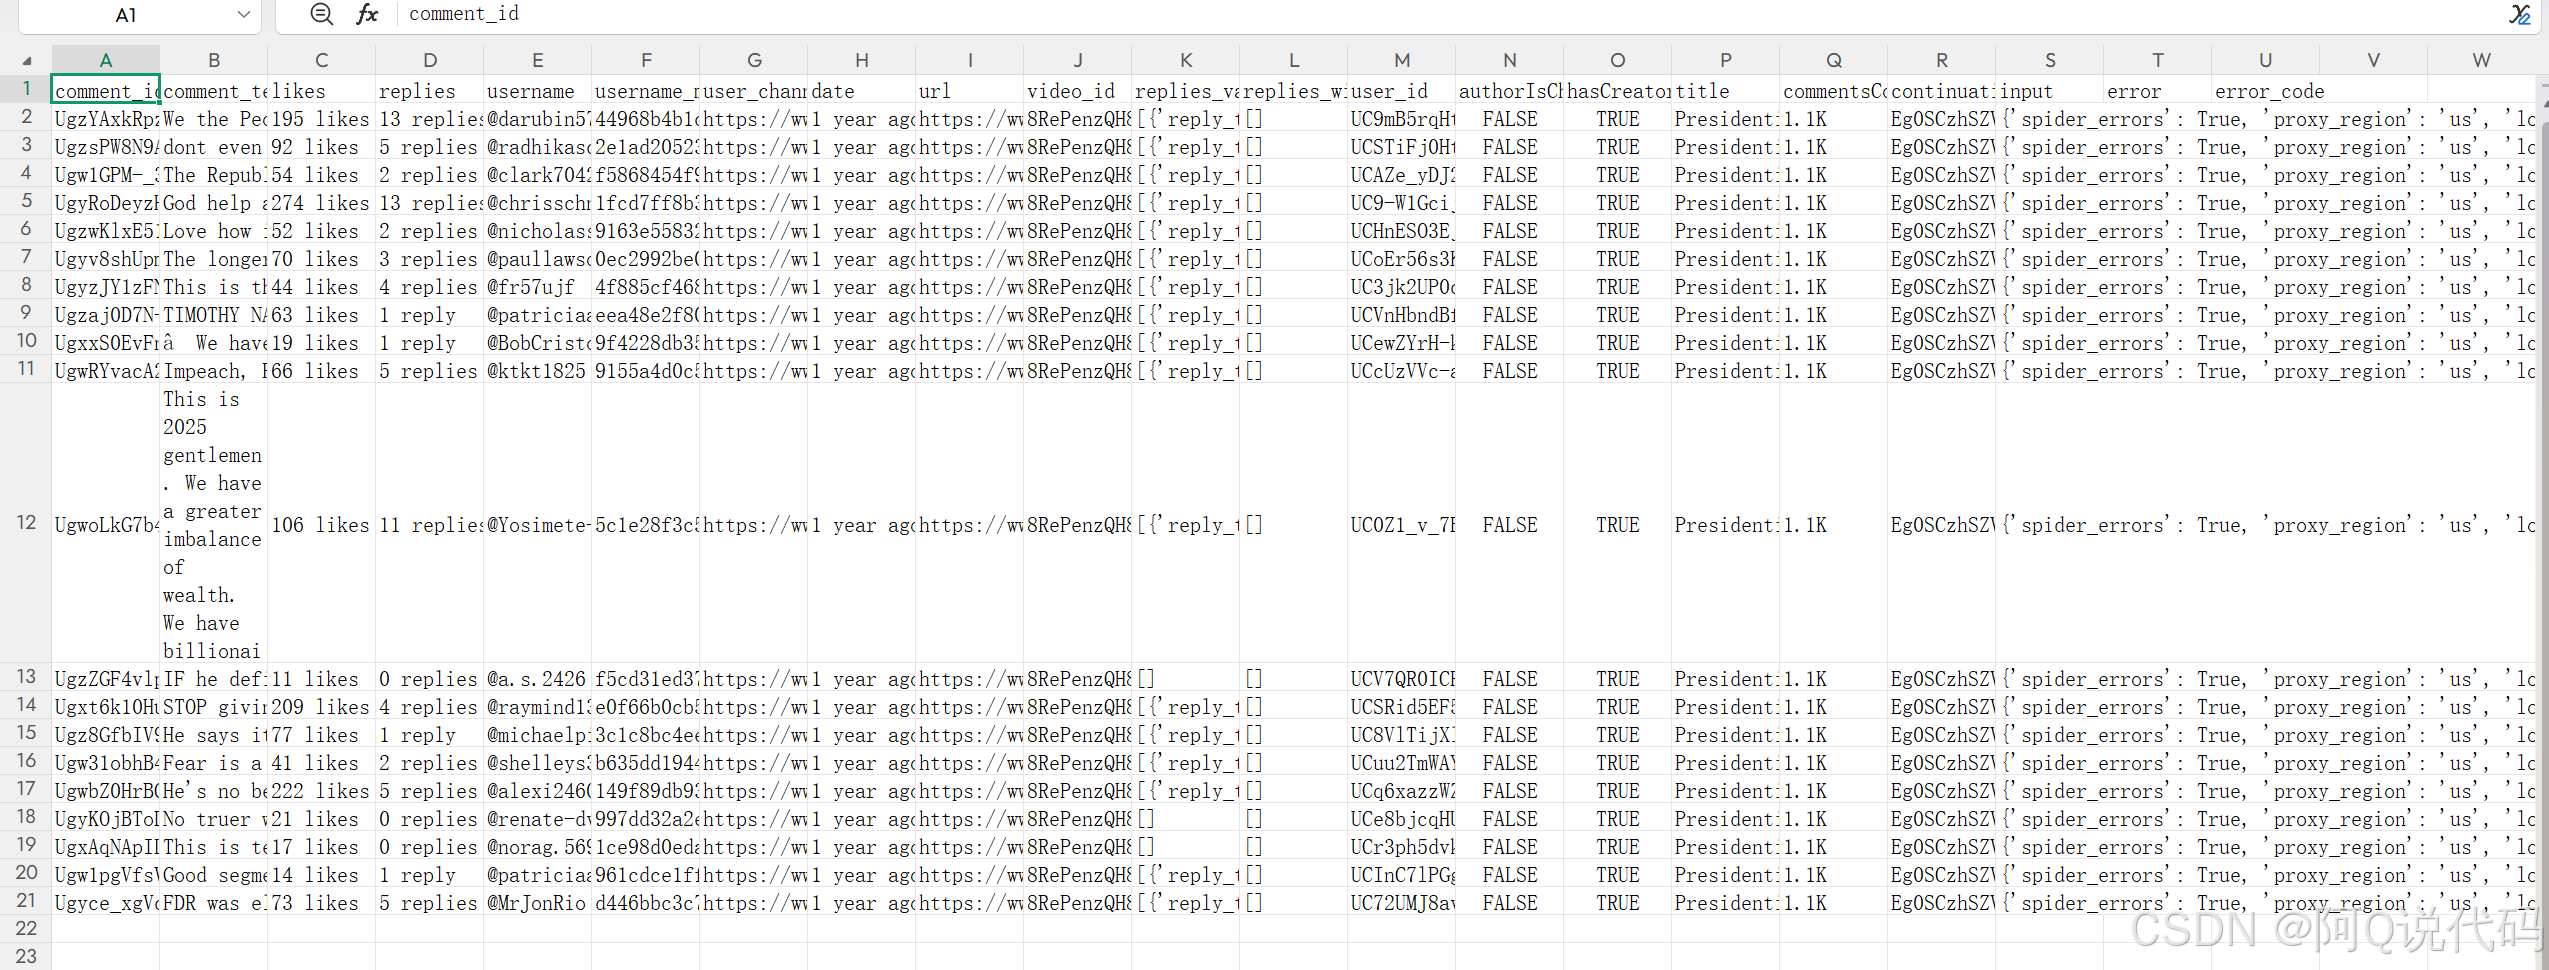 为了观察整体表现,我连续跑了多次任务,并在 Dashboard 中查看了响应时间和任务状态。测试结果如下:
Dataify 的使用流程比较统一:选择采集器、配置参数、运行任务、查看结果、导出数据即可完成整个采集过程。而且平台已经处理了页面访问、JS 渲染、反爬以及结果结构化等工作,使用起来非常方便,小白都能无痛上手了!
同时 Dashboard 提供了任务状态、响应时间和日志等运行指标,方便后续排查和性能分析。
相比自行维护代理池和浏览器集群,这种标准化采集方式能够明显降低接入和维护成本。
四、总结
总体来看,Dataify 将采集 API、数据集市场和 Dashboard 控制台整合在同一套平台中,既能通过可视化方式快速发起任务,也能通过 API 接入业务系统。无论是 SERP 搜索结果、网页内容、通用页面,还是视频与社交媒体数据,Dataify 都提供了相对标准化的采集路径,减少了开发者在页面解析、JS 渲染、反爬处理、任务监控和数据导出上的重复投入。如果你有类似的需求,可以试试呀。


 扫一扫


 2041


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


