


文章目录
论文精读-CHARM: Composing Heterogeneous AcceleRators for Matrix Multiply on Versal ACAP Architecture
优点:
1、使用较小尺寸的acc来减少小型mm(矩阵乘法)机的浪费,使用较大尺寸的acc来最大限度地提高大型mm机的数据重用。(填充是在大型加速器上实现小型MM操作的一种常见而简单的方法,但填充既会浪费计算量,也会浪费带宽。)小acc意味着更少的数据重用。
2、通过协同优化工作负载和资源分区,仔细重叠这些acc的执行时间
3、设计空间探索(DSE),自动CHARM DSE(CDSE),基于排序的两步搜索算法CDAC,以多项式时间复杂度而不是指数时间复杂度找到优化的CHARM设计。(为了在多个访问上映射不同大小的MM内核时实现整体最优吞吐量。)
4、使用自动代码(PL,AIE,CPU)生成
5、在主机CPU中启动CHARM运行时系统(CRTS),该系统将不同的内核调度到访问(因为多acc计算,需要内核调度),以优化任务延迟和总体系统吞吐量。
概述
密集矩阵乘法(Dense matrix multiply, MM)是深度学习应用中使用最多的核函数之一。为了应对这些应用的高计算需求,具有FPGA和专用ASIC加速器的异构架构已经成为有前途的平台。例如,AMD/赛灵思通用ACAP架构结合了通用CPU内核和可编程逻辑,以及针对AI/ML优化的AI Engine处理器。由400个AI Engine处理器组成的阵列以1ghz的频率运行,可为32位浮点(fp32)数据提供高达6.4 TFLOPs的性能。然而,机器学习模型通常同时包含大型和小型MM操作。 大型MM操作可以跨多个核心高效并行化,但小型MM操作通常不能。 我们观察到,在通用ACAP中的大型单片MM加速器上执行来自BERT自然语言处理模型的一些小MM层,获得的性能不到理论峰值的5%。因此,一个关键问题出现了:我们如何设计加速器,以充分利用有限通信带宽下的丰富计算资源,用于具有多个不同大小MM层的端到端应用?
我们确定了由于单个单片加速器的大量计算资源与应用中各种小尺寸MM层的不匹配而导致的最大系统吞吐量瓶颈。为了解决这个问题,我们提出了CHARM框架来组合多个不同的MM加速器体系结构,在一个应用程序中并发地针对不同的层工作。CHARM包括指导设计空间探索的分析模型,以确定加速器分区和层调度。为了方便系统设计,CHARM自动生成代码,从而实现彻底的板载设计验证。我们在四种不同的深度学习上部署了CHARM框架应用程序,包括BERT, ViT, NCF, MLP,在AMD/赛灵思通用ACAPVCK190评估板。实验表明,我们在BERT、ViT、NCF、MLP上分别实现了1.46 TFLOPs、1.61 TFLOPs、1.74 TFLOPs和2.94 TFLOPs的推理吞吐量,与单片加速器相比,分别获得了5.29倍、32.51倍、1.00倍和1.00倍的吞吐量增益。
背景介绍
密集矩阵乘法(MM)是许多深度学习工作负载中最常用的内核之一,包括用于自然语言处理的BERT[1],用于推荐的NCF[2],用于视觉分类的ViT[3],以及用于多层感知器分类或回归的MLP[4]。根据谷歌[5]的分析结果,2017年谷歌数据中心密集矩阵乘任务占据了90%的神经网络(NN)推理工作量。这些应用的日益复杂导致了对计算和数据移动的极端需求。

片外带宽一直是系统性能和能效的瓶颈,当前平台上的一个共同趋势是片外带宽的扩展速度不如计算资源的扩展速度
快。因此,第一个研究问题出现了:如何在扩展较慢的片外带宽下维持更快的扩展计算?
常见的解决方案是通过在加速器(acc)内分配更多的片上存储来增加数据重用。如[9]中的渐近分析所示,MM中的总片外通信体积尺度为O(√1),其中M为片上瓦片大小。如果我们增加M贴片大小,我们可以减少总通信量,从而减少片外带宽的压力。
在这项工作中,我们的目标是AMD/赛灵思通用ACAP架构[10],它将通用CPU内核和可编程逻辑(PL)与针对AI/ML计算优化的AI引擎处理器(AIE)相结合。例如,我们在AMD/赛灵思VCK190板上使用384个ae和超过80%的片上URAM和BRAM资源实现了MM加速器。图1中的红线说明了该加速器的性能。该设计在原生平铺大小为1536×128×1024的情况下运行,在携带大型方形MM(点a)的平铺执行时实现2.8TFLOPs吞吐量。然而,当简单地将不同大小的MM映射到这样的设计时,随着方形MM大小降至512以下,性能显著下降,因为每个贴片都被填充到加速器的原生贴片大小。例如,在B点,这样的单片设计的性能达到0.41 GFLOPs,比a点低6880倍。虽然填充是在大型加速器上实现小型MM操作的一种常见而简单的方法,但填充既会浪费计算量,也会浪费带宽。
填充的另一种替代方法是实现具有较小原生贴图大小的多个加速器,可以在每个加速器上并行执行不同的任务[11]。我们使用8个独立的加速器来应用这种方法,它们的原生贴图大小为256×128×256,如图1中的蓝色虚线所示。对于大小为64的小正方形MM操作,该方法在C点实现7.2 GFLOPS,与B点相比大约加快了17倍。然而,较小的加速器尺寸也意味着更少的数据重用用于大型MM,当可以参考表5时,操作规模大于256。当MM尺寸为3072 (D点)时,在一个单片设计中,8个重复accs的总吞吐量比A点小4.08倍。
这些实验暴露了两个相互冲突的设计目标。
1、我们希望实现具有足够数据重用的大型MM操作,以在设备上实现尽可能高的性能。
2、我们希望实现小型MM操作,同时最小化计算和通信开销。
这两种简单的设计似乎都无法同时实现这些设计目标。
因此,第二个研究问题就出现了:对于大小尺寸的MM层共存的现实世界端到端应用,如何在这两个设计目标之间进行权衡?
为了说明这些相互冲突的设计目标如何影响实际机器学习模型的性能,我们将BERT[1]视为包含大小MM层的代表性工作负载。在BERT的一个变压器层中,共有8种MM核,其中核0-5为大mm机,核6和7为批点,即小mm机。详细的形状如图2所示。
总吞吐量几乎饱和。以内核5和内核6为例,内核5是一个形状为3072×1024×4096的MM,内核6是一个形状为96×512×512×64的批处理点,这意味着有96个大小为512×512×64的小型独立mm机。
如图2所示,当使用一个单片MM加速器时,内核0-5消耗了总BERT MM计算操作的92%和总MM计算时间的12%。相比之下,内核6-7只消耗了总操作的8%,却占用了总调度时间的88%。对于内核0-5,它们位于区域A(一个执行类似于图1中的点A的区域),其中acc的吞吐量大于2082 GFLOPS。对于内核6-7,它们位于区域B,其中acc的吞吐量仅为23.6 GFLOPS。考虑到在时间轴中有很大一部分acc执行未被充分利用,总体MMacc吞吐量仅为276 GFLOPS。我们能否实现位于a区域的BERT设计,即适合大型mm机,并且也优于C点的区域,即适合小型mm机,具有较少或没有浪费的计算/带宽?
我们的答案是“可以”。关键思想是将更多的资源分配给专用于计算较大mm的访问,并将较小的资源分配给同时计算较小mm的其他访问,如图2所示,其中展示了一个两种不同的访问系统。为了实现我们的设计目标,我们需要解决这些新的挑战。
1、首先,我们需要实现每个单个acc的高计算利用率,即使用较小的acc来减少小型mm机的浪费,使用较大的acc来最大限度地提高大型mm机的数据重用。(使用小acc,1.减少额外的计算量2.减少带宽消耗)
2、其次,为了在保持高吞吐量和低延迟的同时最大限度地提高整体利用率,我们需要通过协同优化工作负载和资源分区来仔细重叠这些acc的执行时间。
3、第三,为了便于设计空间探索(DSE),我们需要分析模型来优化资源和带宽约束下的整体吞吐量。
4、第四,为了减少系统实现的编程工作量,我们需要自动代码生成。
5、第五,当运行多个acc时,为了解决应用程序图中内核的依赖性,我们需要一个加速器运行时来将来自不同任务的内核调度到acc上。

前人工作

总结了我们的工作与之前工作的差异。我们的工作能够从一个单片、多个副本和多个不同的加速器中选择设计,并且每个加速器都是考虑到我们的DSE所涵盖的不同工作负载分配、数据流和数据并行策略的专门设计。
乘法加速器设计
ACAP架构
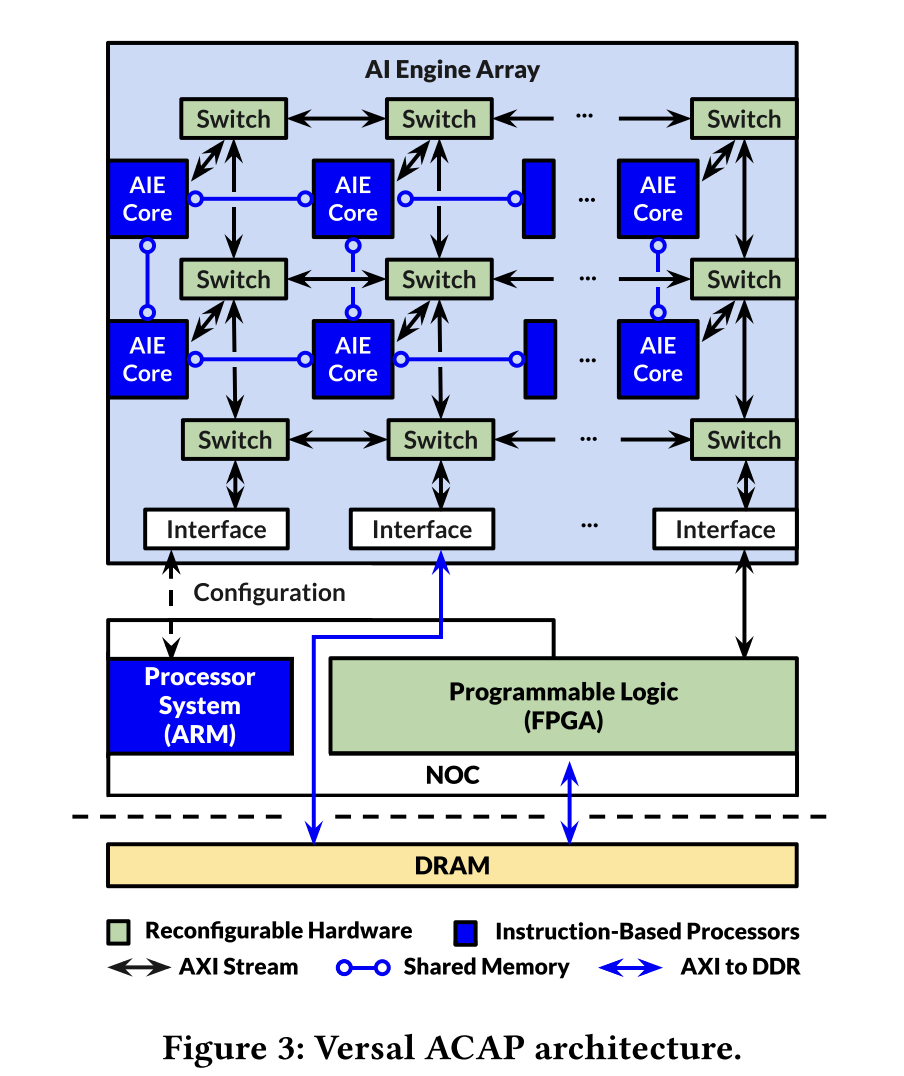
包括传统的通用处理器系统PS(processor system)和可编程逻辑PL(programmable logic)和计算单元AIE(类似GPU),所以说ACAP是一个异构系统
AIE内存模型
每个AIE处理器包含32kb的数据,并且能够在四个方向上(AIE↔邻居AIE)与相邻的AIE共享数据。除了与相邻块共享本地内存外,每个AIE块还连接到一个轴流(AXIS)交换网络,这使得AIE处理器之间的非本地通信(AIE↔非本地)和通过39个接口块中的plio与PL通信(PL↔AIEs)成为可能。VCK190单板在PL和AIEs之间提供1.2 TB/s(PL↔AIEs) / 0.9 TB/s (AIEs)↔PL的带宽,是DDR4和PL之间带宽的46倍。AXIS交换机支持端口之间的电路交换和包交换连接。电路交换连接提供专用的、确定的通信,并支持广播,其中来自单个输入通道的数据同时传输到多个输出通道。分组交换连接允许来自输入通道的数据根据每个数据包开始时的目的地报头动态路由到不同的目的地。这使得数据流可以在单个路由路径上进行时间复用。当AIE的计算-通信(CTC,计算到通信)比率大于1时,我们可以使用分组交换连接。在计算AIE 0的过程中,分配给这个AIE的端口是空闲的,因此可以通过分配一个与AIE 1的目的ID匹配的不同的报头来将数据传输到另一个AIE,比如AIE1。
(分组交换可以看为是另一种的pingpong)
加速器设计
矩阵分块

清单1描述了基本密集矩阵-矩阵乘法的整体四层平铺和映射策略。最内层的循环平铺(第16-20行)在单个AIE核心上实现MM,并通过发出完全流水线的2D-SIMD(向量矩阵乘法)指令来利用指令级并行性和数据级并行性。每个AIE存储一个(TI×TK)LHS和一个(TK×TJ) RHS矩阵,并在其本地内存中计算一个(TI×TJ)输出矩阵。最内层的第二个循环块(行12-14)表示AIE数组中不同AIE内核之间执行的空间分布。这些循环完全展开,并以并行方式在(A×B×C) AIE内核上进行计算。空间分布也对应于所需的IOs数量,这将在4.2节中讨论。第三个最内层时间循环图(行7-9)表示存储在PL片上存储器中的数据的顺序处理。片上PL缓冲区中的数据被多次输入AIE数组


 110


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


