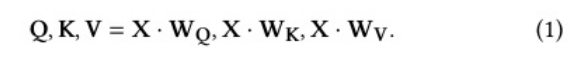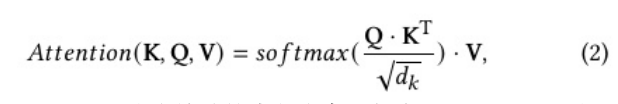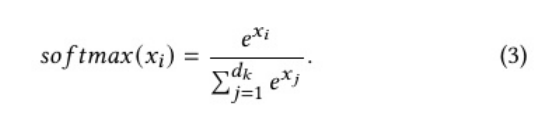论文精读-ReTransformer ReRAM-based Processing-in-MemoryArchitecture for Transformer Acceleration

VIP论文精读-ReTransformer ReRAM-based Processing-in-MemoryArchitecture for Transformer Acceleration
Transformer已经成为一种流行的深度神经网络(DNN)模型,用于神经语言处理(NLP)应用,并在神经机器翻译、实体识别等方面表现出优异的性能。然而,其在自回归解码器中的规模化点积注意机制在推理过程中带来了性能瓶颈。Transformer也是计算和内存密集型的,需要硬件加速解决方案。
开通可读全文 ·1.9k 人阅读
最低0.47元/天 解锁文章

论文精读-ReTransformer: ReRAM-based Processing-in-Memory Architecture for Transformer Acceleration

优点:

1、基于新型存储器ReRAM实现Transformer模型加速,并设计了一个新的PIM结构ReTransformer,其分为三种类型的功能组件,处理子阵列、缓冲子阵列、内存子阵列。

2、使用矩阵分解解决缩放点积中的数据依赖,减少了中间结果频繁重写,降低了计算延迟。

3、实现了低功耗混合softmax函数,通过在新型存储器ReRAM上实现选择和比较操作,并利用函数变形+查找表得到softmax结果,降低了计算功耗。

4、通过矩阵拆分,将输入数据流分割成更小的部分,以实现更细粒度的流水线设计。这种方法相较于传统的层流水设计,显著提升了crossbar的利用率和加速器的计算性能。

概述

Transformer已经成为一种流行的深度神经网络(DNN)模型,用于神经语言处理(NLP)应用,并在神经机器翻译、实体识别等方面表现出优异的性能。然而,其在自回归解码器中的规模化点积注意机制在推理过程中带来了性能瓶颈。Transformer也是计算和内存密集型的,需要硬件加速解决方案。尽管研究人员已经成功地应用了基于基于ReRAM的内存中处理(Processing-in-Memory, PIM)来加速卷积神经网络(cnn)和递归神经网络(rnn),但Transformer中缩放点积注意力的独特计算过程使得这些设计难以直接应用。此外,如何处理矩阵-矩阵乘法(MatMul)中的中间结果以及如何在Transformer的更细粒度上设计管道仍未得到解决。在这项工作中,我们提出了ReTransformer -一种基于ReRAM的变压器加速PIM架构。ReTransformer不仅可以使用基于ReRAM的PIM加速Transformer的缩放点积注意力,而且可以使用所提出的矩阵分解技术避免编写中间结果,从而消除一些数据依赖性。此外,我们提出了一种新的用于多头自关注的子矩阵管道设计。实验结果表明,与GPU和Pipelayer相比,ReTransformer的计算效率分别提高了23.21倍和3.25倍。相应的整体功耗分别降低1086倍和2.82倍。

背景介绍

一个杰出的基于自注意的模型transformer[28]显著减少了远程依赖关系之间的路径长度,从而在许多转导任务中实现了最先进的性能。

然而,由于NLP序列的复杂性,已经为简单性进行了优化的Transformer模型仍然需要大量的计算资源。例如,[28]中提出的原始Transformer模型是许多设计的支柱[1,30,34],它有65M参数。再举一个例子,流行的预训练模型BERT[6]有108M参数。ALBERT[16]提出对参数进行修剪,将总参数数减少到12M,精度下降2.2%。结构级的优化也被开发出来,比如用平均注意力模型[34]代替顺序模型,探索非自回归解码器[9],在相邻层[30]之间共享权重。然而,结构调整要么会导致模型中固有词依赖关系的丧失,要么会导致更复杂的训练过程。而且,这些加速方法没有考虑硬件特征。

为了在不牺牲精度的情况下提高Transformer推理性能,移动和嵌入式系统开始采用节能的特定领域硬件加速器。一个主要的性能瓶颈——在自回归解码器[30]中大量使用点积注意力,需要在加速过程中进行特殊处理。其次,频繁来回移动中间数据存储器和处理单元之间也应该减少,以提高能量效率。

加速器设计

Transformer模型分析

Transformer模型结构

核心:前馈网络(FFN),多头自注意力(MSA)
(LN+MSA,LN+MLP)

变压器由一个编码器堆栈和一个解码器堆栈组成,它们共享相似的模块结构。以[28]中的结构为例,编码器具有6个相同模块的堆栈,如图1(a)所示。每个块由两大功能模块组成:多头自注意和前馈,分别由图1(b)中的浅红色块和蓝色块所示。在这两个主要功能模块之后,都有一个残差块来添加输入和输出,并执行层范数计算,如图1(b)中的绿色块所示。多头注意层从输入嵌入或之前的编码器块中获取输入。解码器堆栈也由6个相同的块组成,但每个解码器块由三个主要功能层组成,包括两个多头自注意层和一个前馈层,如图1©所示。与编码器块相比,解码器块有一个额外的编码器-解码器自注意模块,该模块有一个输入与编码器堆栈的输出相连。
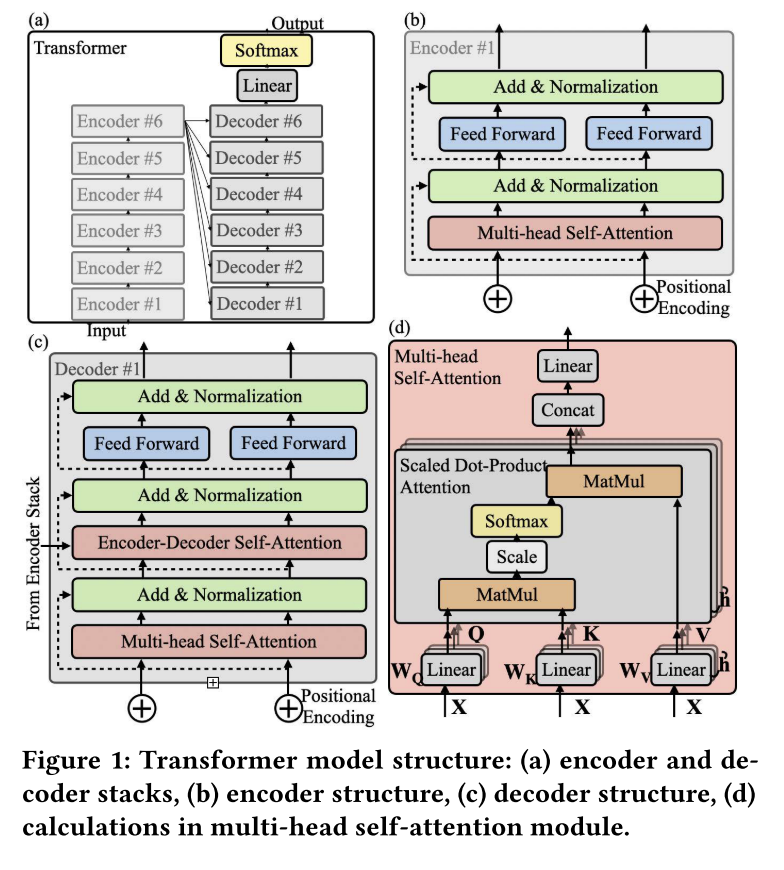
image-20240505180045915

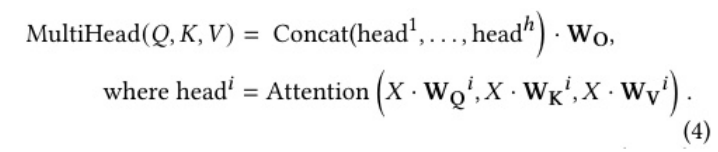
Transformer计算

image-20240505180146108

image-20240505180206719

image-20240505180220813

image-20240505180235912
核心包括点积计算,缩放除法和softmax中的e^x指数运算。
前馈网络输出:
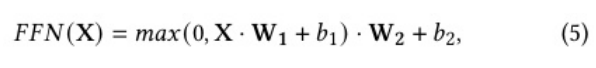
image-20240505180327558

基于ReRAM的存内计算设计

1、基于ReRAM向量矩阵和矩阵矩阵乘法

VIP 告别冯·诺依曼瓶颈:手把手拆解SRAM、ReRAM、Flash三大存算一体芯片的实战差异 本文深度对比SRAM、ReRAM与Flash三种存算一体芯片的技术原理与实战表现,解析其在边缘AI场景下的适配策略。通过实测数据揭示SRAM的数字计算优势、ReRAM的模拟计算潜力以及NOR Flash的量产成熟度,为智能终端选型提供关键参考。存算一体技术突破冯·诺依曼瓶颈,显著提升边缘计算的能效比和实时性。 开通可读全文·589 阅读·10 点赞·5 收藏 阅读全文

相关推荐

《Restormer:高效Transformer架构用于高分辨率图像恢复》学习笔记

由于卷积神经网络(CNN)能够从大规模数据中学习出具有良好泛化性的图像先验,因此这些模型已经被广泛应用于图像恢复及相关任务。最近,另一类神经网络架构——Transformer,在自然语言处理和高层次视觉任务上展现出了显著的性能提升。虽然 Transformer 模型在缓解CNN的缺点(例如有限的感受野和对输入内容的适应性差)方面有优势,但其计算复杂度随着空间分辨率的增加呈平方级增长,因此在涉及高分辨率图像的大多数图像恢复任务中应用起来非常困难。

学无止境。 2786

低功耗,大算力!最适合大模型的AI芯片是它?

RERAM AI芯片

weixin_41496173的博客 1452

ReRAM从原理到量产:打破存储墙的下一代存储技术

随着AI算力对存储带宽和功耗的要求不断攀升,传统DRAM与Flash在先进制程下的扩展瓶颈日益凸显,存储墙问题成为制约系统性能的关键。一种名为阻变存储器(ReRAM)的新型非易失存储技术,凭借其低功耗、高速读写、良好的CMOS工艺兼容性以及可微缩潜力,正从实验室走向工程化量产。ReRAM基于导电细丝机制实现阻态切换,无需电荷存储,天然支持存算一体架构,可有效减少数据搬运开销。在嵌入式领域,ReRAM正逐步替代eFlash成为MCU和SoC的优选方案,并在边缘AI推理、低比特量化网络中展现能效优势。本文从器件

weixin_30315905的博客 411

【入坑存内计算一键指南】存内计算运算原理:算法优化、存储介质探究

本文探讨了存内计算及其面向的架构优化,尤其侧重于图算法优化和存内计算存储介质。文章介绍了存内计算的概念和意义,着重强调了存内计算解决了内存墙问题,提高了计算效率。针对图算法的优化,提出了基于位运算的创新方法,重塑了单源最短路径算法,并介绍了基于局部重叠度的链路预测算法优化设计。接着,文章详细讨论了存内计算存储介质,特别是非易失性存储器,比较了不同类型存储器的性能,并重点介绍了基于ReRAM的存内计算技术,包括其物理模型和交叉阵列结构。

一键难忘的博客 7049

存算一体革命:ReRAM加速K8s实时数据分析

存算一体技术加速K8s实时分析:性能提升97%的ReRAM方案 针对Kubernetes数据分析的三大痛点(CPU瓶颈、IO延迟、高能耗),本文提出基于ReRAM存算一体的创新架构。通过与K8s深度集成,实现了: 性能突破:日志聚类分析从38秒降至0.9秒,时序预测从7.2秒缩至0.3秒 能效优化:能耗降低78%(210W→45W),服务器数量减少60%

python,运维,测试,数据分析,人工智能 926

llama factory

NOTE] 除上述链接以外的其他网站均为未经许可的第三方网站,请小心甄别。

thesky123456的博客 1271

从零开始:用Neo4j构建你的第一个知识图谱(附完整代码示例)

本文提供了一份从零开始的Neo4j知识图谱构建实战指南。通过一个“经典科幻电影宇宙”的具体案例,手把手教你安装环境、设计图谱模式,并使用Cypher查询语言完成节点与关系的创建、数据查询及可视化,帮助你快速掌握自下而上构建知识图谱的核心技能。

weixin_29053073的博客 464

流形优化: Manifold Optimization 的 全网最通俗版本详解 (一)

前言 之前忙于论文, 停更了很久。 接下来的一段时间,出于各种原因, 决定在CSDN平台上做 最近在 混合波束成形 及 智能反射面 领域 非常常见的流形优化 (Manifold Optimization) 算法 的专题介绍。尽管目前已有了不少的中文博客, 但出于其各种弊端, 使得本篇的成文仍有其不可或缺的意义。 而如果要盘点最核心的意义, 就在于这篇是对读者的 数学能力 与 阅读理解能力 要求最低的 流形优化讲解了。 唯一参考的文献为 Manopt 工具包作者 Boumal 的 新书: An introd

B417科研笔记 2万+

idea出现 EXCEPTION_ACCESS_VIOLATION (0xc0000005) 的解决方法

idea启动的时候出现如下问题,以为没啥事,就索性关闭 后面再打开idea的时候发现直接闪退,之后打开其他软件,直接蓝屏

码农研究僧的博客 4808

(计算机组成原理)第二章数据的表示和运算-第二节:数字电路基础知识

本文介绍了计算机组成原理中的逻辑门电路、多路选择器和三态门。逻辑门电路包括基本逻辑运算(与、或、非)和复合逻辑运算(与非、或非、异或、同或),这些运算通过门电路实现,并满足分配律和结合律。多路选择器(MUX)用于从多个输入信号中选择一个输出,广泛应用于数据选择、资源共享和逻辑函数实现等场景。三态门则具有三种输出状态(高电平、低电平、高阻态),常用于总线控制和信号隔离。这些元件在数字电路设计和计算机系统中具有重要作用。

快乐江湖的博客 2455

Unity3D 加密 Assembly-CSharp.dll (Android平台) 防止反编译

0、加密的原理 Unity3D 是基于 Mono的,我们平时写的 C# 脚本都被编译到了 Assembly-CSharp.dll ,然后 再由 Mono 来加载、解析、然后执行。 Mono 加载 Assembly-CSharp.dll 的时候就是读取文件到内存中,和平时读取一个 游戏资源 文件没什么区别。 为了防止别人破解,我们会对游戏资源加密,简单点的 比如修改文件的一个字节 或者 位移一下

Circle 8713

【BlueDroid】【PBAP】蓝牙电话本协议之同步通讯录分析(超详细)

Header - Type = "x-bt/vcard-listing":代表了该Request对应的Function为PullvCardListing;Profile:PBAP (4),上层应用层协议为PBAP,OBEX协议的上层应用层协议除了PBAP,还有OPP、MAP协议;Response in Frame:该request frame-485对应的Response frame为489;在PBAP协议同步通讯录和通讯记录中,都是基于OBEX协议实现的,PBAP协议作为了应用层协议;

风云说通信 2060

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

怀旧版电脑GBC模拟器

再现原版GBC掌机的界面,电脑运行连游戏界面都一样大小,很怀旧,很真实,(英文版)强烈推荐,很小的文件,很难才找到的。

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

上一篇: 论文精读-CHARM Composing Heterogeneous AcceleRators for MatrixMultiply on Versal ACAP Architecture
下一篇: 论文精读-存内计算芯片研究进展及应用

双11狂欢大促

盲盒赢 定制羽绒服

开启惊喜盲盒,抽取你的专属好礼

— 惊喜奖品抢先看 —
看不见的罗辑
看不见的罗辑 新星创作者: 大数据技术领域 新星创作者: 大数据技术领域
博客等级 码龄7年 5318粉丝 86原创
评论 3
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

看不见的罗辑

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值