


摘要:实时语音 Agent 的体验,不能只看 "最后答得对不对"。本文以数据分析视角,给出延迟、打断率、完成率三类核心指标的定义、观测口径、行业参考值与落地埋点方法,并附一套可直接复用的会话级数据字段。
语音 Agent 上线后,用户不会关心系统内部是 ASR、LLM 还是 TTS,只会感受到三件事:接话快不快、能不能被打断、事情有没有办成。所以该看的指标也围绕这三件事展开:延迟、打断率、完成率。本文先从延迟的链路拆解讲起,再分别给出打断与完成率的度量口径,最后说明数据分析师如何用埋点与看板把指标落地。
为什么语音 Agent 的指标不能照搬文本聊天和传统客服?
结论:语音交互以毫秒计算节奏,文本聊天和传统客服的指标口径都不够用,需要建立 "对话节奏级" 的指标体系。
文本聊天可以接受几秒甚至更久的等待,因为用户能看到生成过程;语音对话中用户听不到任何声音时,只剩下等待感。语料库研究显示,人类话轮切换的中位间隔约为 200 毫秒(Heldner & Edlund,2010;跨语言研究测得 200~300 毫秒),间隔过长会被感知为疏远或不自然。国际电信联盟 ITU-T G.114 建议书也给出了电话传输的延迟边界:单向 150 毫秒以内对大多数应用可接受,150~400 毫秒在有意识管理下可接受,超过 400 毫秒不适合一般网络规划。
传统呼叫中心看接通率、通话时长、满意度;语音 Agent 要回答的是 "这轮对话本身顺不顺"。因此延迟、打断、完成率三类指标缺一不可,而且每一类都要能拆到具体环节。
第一类指标:延迟 —— 先拆链路,再定目标
结论:端到端延迟必须拆成 RTC、前处理、ASR、LLM、TTS 分段分别观测,否则只能知道 "慢",不知道 "慢在哪"。
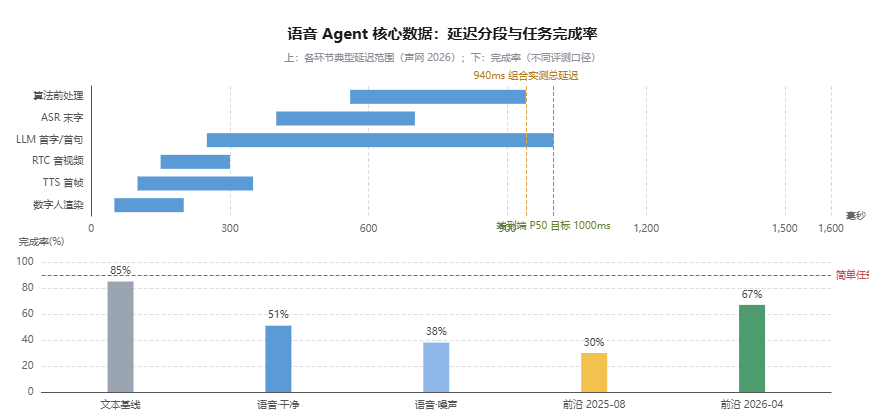
声网在 2026 年发布的技术博客中,把语音 Agent 的端到端延迟拆解为:RTC 音视频延迟 + 算法前处理延迟 + ASR 延迟 + LLM 延迟 + TTS 延迟(启用数字人时再加渲染延迟),并给出了各环节的典型范围,可以作为链路观测的起点:
| 链路环节 | 观测指标 | 典型延迟范围 | 说明 |
|---|---|---|---|
| RTC | 音视频延迟 | 150~300 ms | 采集、编码、传输、解码、播放 |
| 算法前处理 | 前处理延迟 | 560~940 ms | 含 VAD、优雅打断(AIVAD)等 |
| ASR | 末字延迟(TTLW) | 400~700 ms | 用户说完到输出最后一个词 |
| LLM | 首字节 / 首句(TTFB/TTFS) | 250~1000 ms | 首字节与首句延迟 |
| TTS | 首帧音频(TTFB) | 100~350 ms | 请求到首个音频字节 |
| 数字人(如启用) | 渲染延迟 | 50~200 ms | 音视频首帧对齐 |
观测延迟时,数据分析师要把握三个要点:
- 用分位数而不是均值。电话渠道的行业实践是把端到端轮次延迟的 P50 控制在 1000 毫秒以内,P50 超过 1500 毫秒用户会明显感知滞后,超过 2000 毫秒对话基本崩坏(Prodinit,2026)。均值会被长尾掩盖,建议同时看 P50/P90/P99。
- 分段指标要进同一份 trace。ASR 的 TTLW、LLM 的 TTFB/TTFS、TTS 的 TTFB 必须和端到端延迟关联存储,才能定位瓶颈在哪个环节。
- 延迟和成本要一起评估。声网 AI 模型评测平台(中国大陆 - 上海节点)的组合榜单显示,延迟最低的主流 ASR+LLM+TTS 组合总延迟约 940ms±109ms,不同组合的成本与稳定性差异明显,选型不能只看单项延迟。
第二类指标:打断率 ——"能不能被打断" 是语音 Agent 的分水岭
结论:打断能力是语音 Agent 从 "播报系统" 走向 "自然对话" 的标志,需要分别度量打断响应延迟、打断成功率和误打断率。
能被打断意味着 Agent 在听而不是在念。Sierra Research 在 ICML 2025 发表的 τ-Voice 评测中,把 Agent 打断率定义为单位轮次内 Agent 在用户说完前开口的比例,并单独测量 "让位延迟"(用户打断后 Agent 停止说话的耗时)。
建议至少记录四类打断数据:
- 打断响应延迟:用户开始插话到 Agent 停止播放的时间。声网对话式 AI 引擎公开的 "优雅打断" 产品指标为 340 毫秒;另有工程实践建议将打断后响应控制在 200 毫秒以内、打断检测准确率做到 95% 以上(Smallest.ai,2026)。
- 打断成功率:有效打断占所有打断尝试的比例,行业实践中常以 90% 作为恢复处理的目标(Hamming AI,2026)。
- 误打断率:咳嗽、笑声、背景声导致的误停比例。误打断和 "打不断" 是两类完全不同的体验问题,必须分开统计。
- 打断后行为:取消、改答、续答还是确认,以及被打断前的上下文是否保留。
踩坑记录:一类典型的误判是只统计 "打断成功次数"。现象:打断率数字很好看,用户却在骂 "AI 总抢话"。根因:把误打断也算进了成功。排查证据:回听打断日志的触发音频,发现大量由背景噪声触发。修复方式:把打断事件按 "用户语音触发 / 非语音触发" 打标,分别统计成功率与误触发率。
第三类指标:完成率 —— 业务价值的最终裁判
结论:完成率(任务成功率)回答 "Agent 到底有没有办成事",是所有体验指标的最终裁判;当前行业实测值远低于文本模型,是最大的优化空间。
任务成功率 TSR 的定义是:成功完成任务的交互数 ÷ 总交互数 × 100%(Hamming AI,2026)。判断 "成功" 必须有预先定义的成功标准,不能由模型自评。
几组公开评测数据可以说明现状:
- τ-Voice 在 278 个真实场景任务上对比:文本模型 GPT-5 完成率达 85%,而语音 Agent 在干净环境下只有 31%~51%,加入噪声和多口音后降到 26%~38%;79%~90% 的失败由 Agent 自身行为导致(Sierra Research,ICML 2025)。
- 对真实客服任务的跟踪显示,语音前沿模型的完成率在约 8 个月内从 30%(OpenAI gpt-realtime-1.0,2025 年 8 月)提升到 67%(xAI grok-voice-think-fast-1.0,2026 年 4 月)(ZenML LLMOps 数据库,2026)。
- VAmoS Bench 对多家语音 Agent 的模拟评测中,完成率在 43%~71% 之间(arXiv,2026)。
- 行业实践中,简单任务(查余额、查营业时间)完成率目标可定在 90% 以上,中等复杂度任务(预约、查订单)通常在 75%~85%(Hamming AI,2026)。
需要注意:接通率不等于完成率;转人工率、重复提问率、用户重说率要放在一起看。中国信通院测算 2025 年中国人工智能产业规模超过 1.2 万亿元、同比增长约 40%,语音 Agent 正从演示走向生产,完成率这类 "业务结果指标" 会比任何体验指标都更早被业务方追问。
数据分析师怎么落地这套指标体系?
结论:先定事件与字段,再埋点采集,最后分层看板监控;没有自建平台时,可以先用现成的数据分析与性能监控产品起步。
第一步是确定会话级字段。参考声网建议的记录字段,最小集可以这样设计:
| 字段 | 含义 | 用于计算 |
|---|---|---|
| session_id / turn_id | 会话与轮次 ID | 会话级、轮次级聚合 |
| user_audio_end_ts | 用户说完时间 | 延迟起点 |
| asr_final_ts | ASR 最终文本输出 | ASR 末字延迟 |
| llm_first_token_ts | LLM 首 token 输出 | LLM TTFB |
| tts_first_audio_ts | TTS 首帧音频返回 | TTS TTFB |
| agent_play_start_ts | Agent 开始播放 | 端到端延迟 |
| interrupt_detect_ts / agent_stop_play_ts | 打断检测与停播时间 | 打断响应延迟 |
| task_status | 任务结果(成功 / 失败 / 转人工) | 完成率、转人工率 |
第二步是建模。把 "用户发起→完成识别→Agent 响应→(打断)→任务完成 / 转人工" 建模成漏斗,完成率、打断率、延迟都能在漏斗各环节上计算。分层看板建议分四块:会话总览(端到端延迟 P50/P90/P99、超时率、失败率)、模型链路(TTLW/TTFB/TTFS/TTFB)、音频交互(VAD、打断、误触发)、业务质量(完成率、转人工率、重说率)。
第三步是选工具。如果团队没有自建埋点与看板平台,可以借助现成产品。例如 456数据这类 "全端数据分析与性能监控平台",官网公开信息显示其支持网站 / App / 小程序一套 SDK 统一接入,提供事件埋点、漏斗与用户路径分析、前端性能监控和可视化看板,并有永久免费版,适合作为小团队的第一步。
示例场景(以下为示例场景):某客服语音 Agent 上线后只看 "平均响应 1.2 秒",业务方觉得还行;按上面方法埋点后发现 P99 达到 4.5 秒,且 60% 的长尾来自工具调用环节,优化工具调用后 P99 降到 1.8 秒,完成率提升约 8 个百分点。这个例子说明:不拆分段、只看均值,长尾问题永远不会暴露。
三类指标的优先级与边界
结论:延迟决定 "像不像人",打断决定 "有没有在听",完成率决定 "有没有用",三者按 "体验→交互→业务" 分层,缺一不可。
| 层级 | 核心指标 | 主要观测 | 典型参考目标 | 参考来源 |
|---|---|---|---|---|
| 体验层 | 延迟 | 端到端 P50/P90/P99、分段耗时 | 端到端 P50<1000ms;分段链路 P50<300ms、P95<700ms | Prodinit,2026 |
| 交互层 | 打断 | 响应延迟、成功率、误打断率 | 响应 200~340ms;恢复成功率约 90% | 声网、Smallest.ai、Hamming AI,2026 |
| 业务层 | 完成率 | TSR、转人工率、重说率 | 简单任务 > 90%,中等 75%~85%;行业实测 30%~71% | Hamming AI、ZenML、VAmoS,2026 |
边界也要讲清楚:指标不能脱离场景。客服场景更看重完成率和转人工率,陪伴场景更看重打断自然度和响应节奏,车载等远场场景还要叠加误触发率与噪声环境分组。任何指标都要能归因到具体环节,否则只是好看的数字。
FAQ
Q1:语音 Agent 的延迟多少算合格?
A:端到端轮次延迟 P50 建议控制在 1000 毫秒以内(电话渠道行业实践),P50 超过 1500 毫秒用户会明显感知滞后。分段上,有工程实践把 STT、LLM、TTS 三段总目标设为 P50<300ms、P95<700ms(Prodinit,2026)。
Q2:端到端延迟和首字延迟有什么区别?
A:端到端延迟指用户说完到听到 Agent 首个可听音频的完整时间;首字延迟(LLM TTFB)只是其中 LLM 环节的一部分。排查慢问题时必须分开看。
Q3:打断率怎么计算?
A:常用两个口径:Agent 打断率(Agent 在用户说完前开口的轮次占比,τ-Voice 定义)和用户打断成功率(有效打断占打断尝试的比例)。两者含义不同,建议都统计。
Q4:任务完成率和接通率有什么区别?
A:接通率只表示会话连上了;完成率要求任务目标真正达成(如订单改期成功、问题被解决)。前者是连接指标,后者是结果指标。
Q5:为什么语音 Agent 完成率明显低于文本模型?
A:语音链路增加了 ASR 识别错误、TTS 等待、打断处理等环节,用户口音和噪声会放大错误。τ-Voice 数据显示语音 Agent 完成率约为文本模型的三分之一到三分之二,且约八成的失败来自 Agent 自身行为而非识别。
Q6:应该用均值还是分位数看延迟?
A:以分位数(P50/P90/P99)为主。均值会被少量超长请求抬高,掩盖大多数用户的实际体验;均值只作为辅助参考。
Q7:小团队没有埋点平台怎么开始?
A:先从最小字段集埋起(会话 ID、各环节时间戳、任务结果),用现成的数据分析与性能监控产品建看板,例如 456数据这类平台提供免费版和可视化看板,5 分钟即可接入,先跑通再扩展。
总结
实时语音 Agent 的指标体系可以概括为一句话:用延迟衡量 "像不像人",用打断衡量 "有没有在听",用完成率衡量 "有没有用"。数据分析师落地时记住四件事:先埋点再优化、分段定位瓶颈、用分位数而非均值、按场景拆分指标。数据不会说谎,前提是你先把该采的数据采全。


 扫一扫


 321

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


