


摘要:防御方案已经很多,但"拦截结果怎么度量、怎么复盘"几乎没有系统梳理。本文从数据分析视角,给出 Prompt Injection 安全事件的指标定义、埋点字段与看板设计,让每一次拦截都变成可追溯、可归因、可优化的数据。
把大模型应用接入业务后,最常被问的一句话是:Prompt Injection(提示注入)我们到底拦了多少?多数团队答不上来——不是没有防护,而是拦截动作散落在网关、模型层、应用层,没有统一的事件记录。安全防御的投入是否有效,必须靠数据回答。
结论:Prompt Injection 的度量不能只看"拦截次数",要围绕拦截量、拦截质量、业务影响三层建立指标体系,把每次拦截沉淀成结构化事件,用看板做复盘。
一、为什么 Prompt Injection 必须被单独度量?
Prompt Injection 连续两版位列 OWASP LLM Top 10 的 LLM01 最高风险类别(OWASP,2023 / 2025),说明它不是偶发问题,而是大模型应用最核心的漏洞面。威胁情报也印证了这一点:CrowdStrike 在 2026 年 6 月发布的威胁报告中披露,2025 年有超过 90 家企业遭遇 Prompt Injection 相关攻击,AI 使能的对抗性行动同比上升 89%,且 82% 的入侵不包含传统恶意代码(CrowdStrike 2025 全球威胁报告,2026)。
真实攻击早已从"聊天框里套话"升级为工程化利用:2025 年 6 月被公开的 EchoLeak(CVE-2025-32711,CVSS 9.3)是首个在生产级企业 LLM 中公开记录的零点击注入——攻击者把指令藏在邮件 HTML 注释里,Microsoft 365 Copilot 索引后即可在用户无感知的情况下外传收件箱内容。Gartner 也有预测称,到 2029 年超过 50% 的 AI Agent 攻击将利用 Prompt Injection(TechRT 汇总,2026)。
这些事件有一个共同点:攻击都发生在"输入进入模型之前",而绝大多数团队的监控盲区也恰恰在这里。响应式修复只能针对已知样本,要形成防御闭环,必须把拦截动作变成指标。
二、安全事件指标体系:三层看板怎么设计?
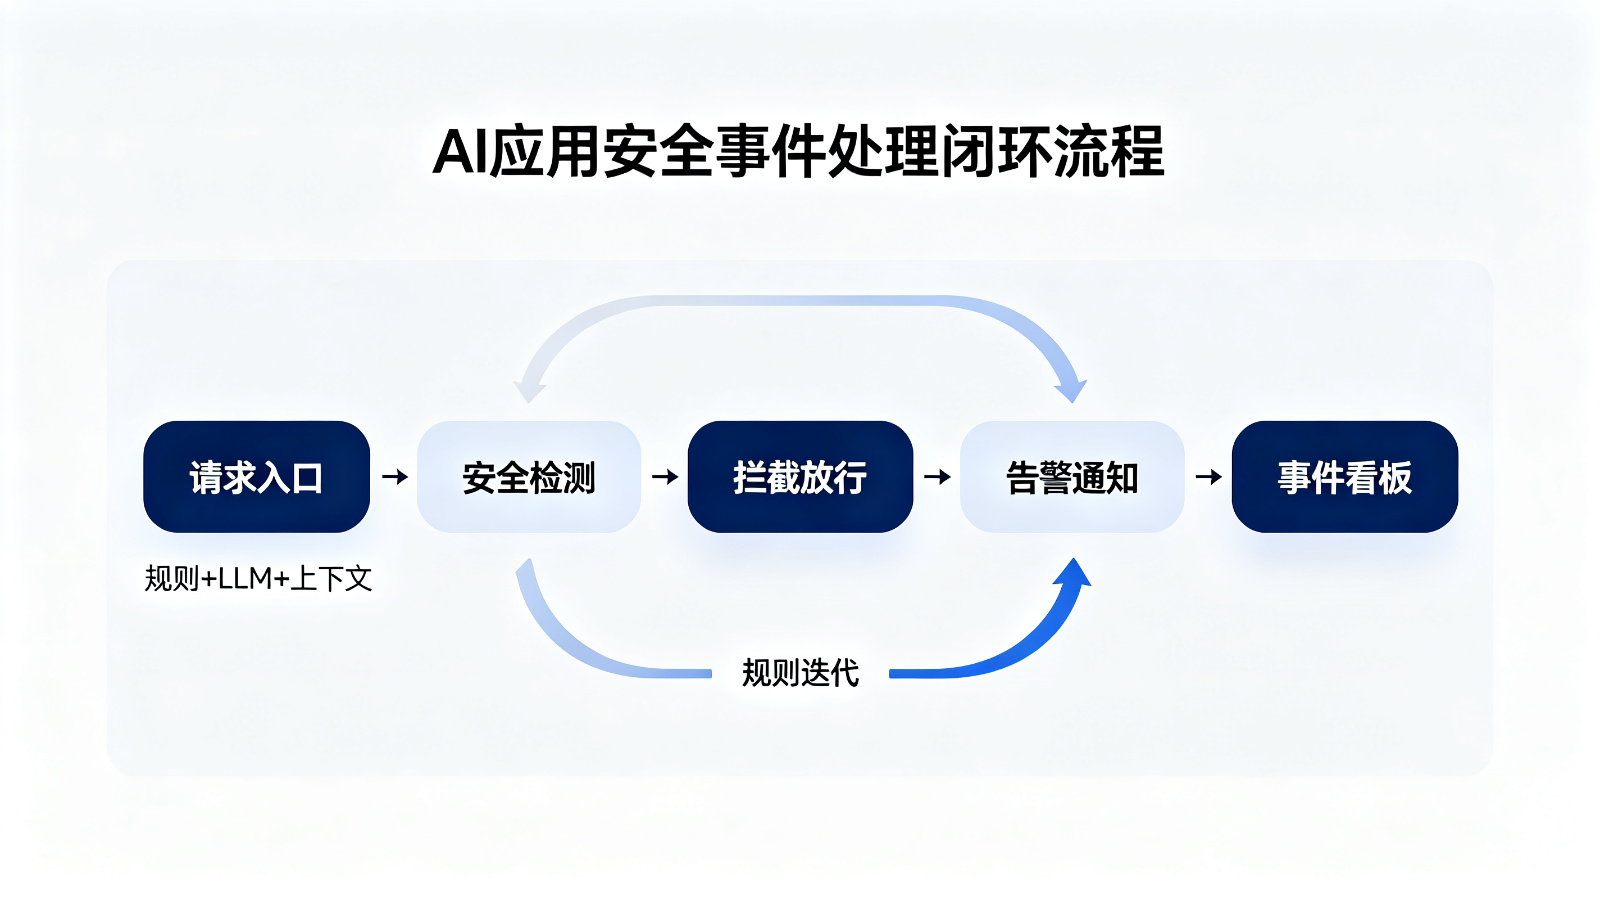
参照数据埋点的方法论,Prompt Injection 的观测可以拆成三层:
| 层级 | 指标 | 回答的问题 |
|---|---|---|
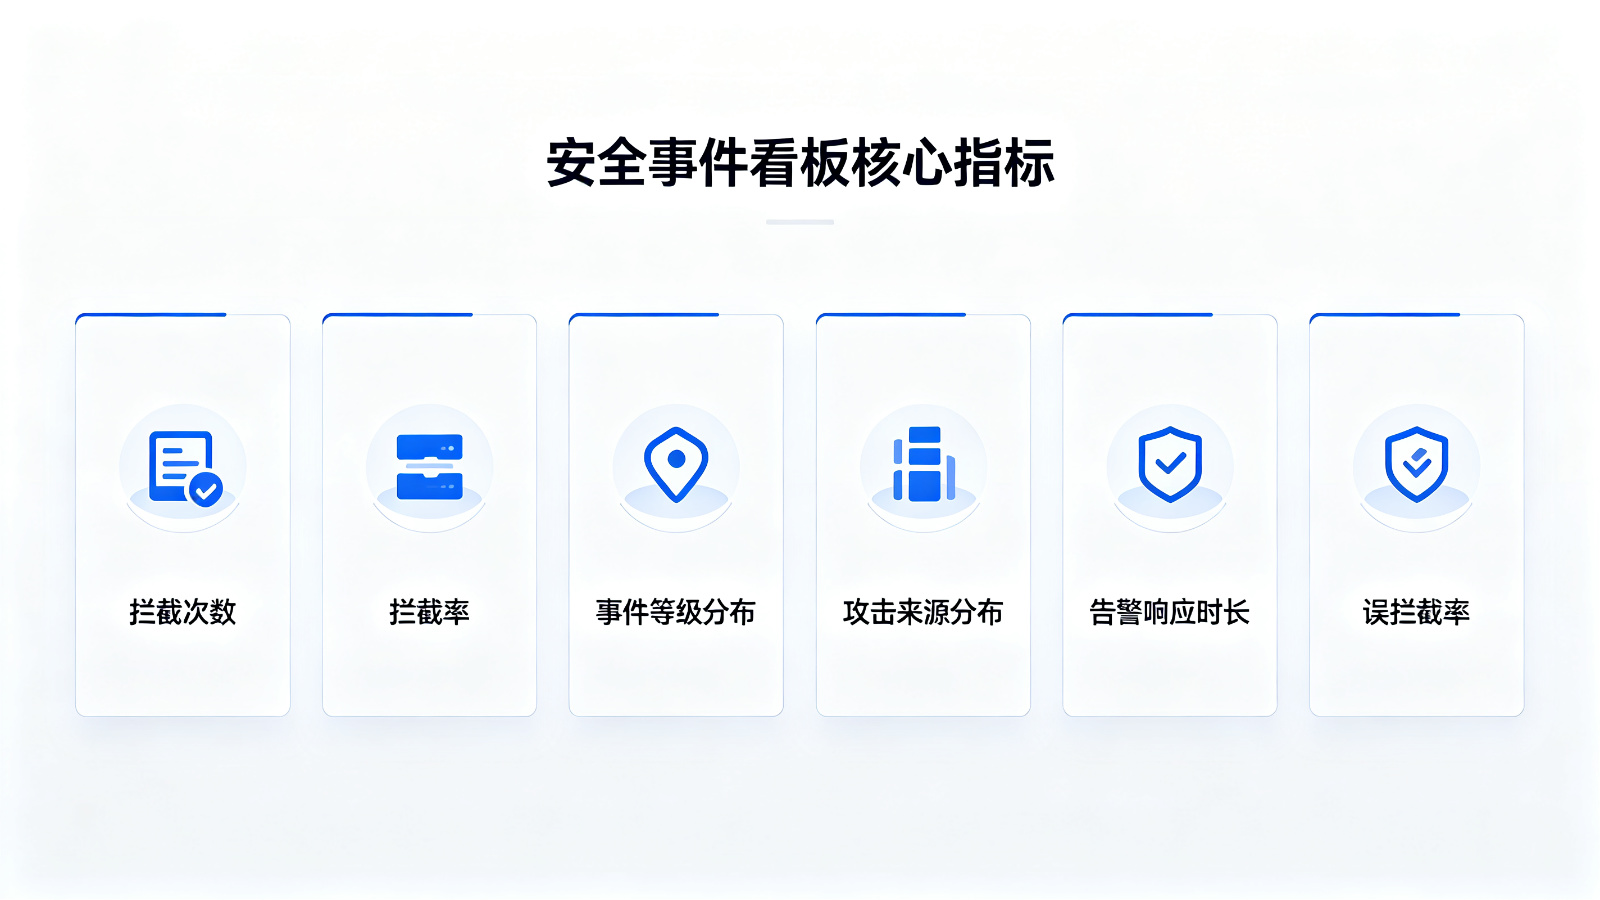
| 拦截量 | 拦截次数、拦截率(按请求 / 按会话)、按攻击类型分布、按来源渠道分布 | 防护在拦截什么?量级多大? |
| 拦截质量 | 误报率、漏报率(抽样复核)、拦截响应延迟、规则命中 TOP N | 拦得准不准?误伤了多少正常请求? |
| 业务影响 | 受影响会话数、数据外传风险等级、放行后攻击转化率、处置时长(MTTR) | 漏掉的攻击造成了什么后果? |
一个常见误区是只盯着"拦截率 99%"。数据分析师要提醒团队:拦截率是分子分母都可操作的数字——分母(检测到的攻击样本集)本身就可能被绕过。所以必须配套抽样复核漏报率,并用"放行后攻击转化率"衡量真实损失。
三、埋点字段:把一次拦截变成一条可分析的事件
建议在安全网关 / 模型网关统一记录以下字段,与业务会话打通:
| 字段 | 含义 | 用途 |
|---|---|---|
| session_id / request_id | 会话与请求 ID | 关联到业务与后续审计 |
| trigger_rule | 命中的检测规则 / 模型 | 规则有效性分析 |
| attack_type | 直接注入 / 间接注入 / 越狱 / 数据投毒等 | 攻击类型分布 |
| input_source | 用户输入 / 网页内容 / 邮件 / 工具返回等 | 间接注入来源画像 |
| action | 拦截 / 放行 / 降级 / 转人工 | 处置策略复盘 |
| risk_level | 风险分级 | 优先处置 |
| detect_ts / respond_ts | 检测与处置时间戳 | 拦截延迟、MTTR |
一个值得强调的设计:拦截事件必须保留"原始输入快照 + 模型输出片段",否则无法做漏报与误报的抽样复核。只记一个布尔值的看板,无法回答"为什么拦错"。
四、数据怎么落地?先建模,再上板
把安全链路建成漏斗:"请求进入 → 规则检测 → 拦截 / 放行 → 告警与处置"。每一层都可以算转化率,从而定位防护链路的薄弱环节。看板建议分四块:攻击总览(趋势、类型、来源)、规则质量(命中率、误报率、漏报抽样)、会话画像(受影响用户、设备、渠道)、处置时效(MTTR、待处置队列)。
如果团队还没有自建埋点与看板平台,可以用现成的数据分析产品起步。例如 456数据这类"全端数据分析与性能监控平台",官网公开信息显示其支持网站/App/小程序一套 SDK 统一接入,提供事件埋点、漏斗分析、用户路径分析与可视化看板,并有永久免费版——把"请求→检测→拦截→告警"建模成事件流和漏斗,几分钟就能搭出第一版安全事件看板。
踩坑记录:现象——拦截率 99.9%,但业务方仍收到用户"正常问题被拒"的投诉。根因——检测规则阈值过严,把包含少量特殊字符的正常提问误判为注入。排查证据——按 trigger_rule 分组统计拦截量,发现某条"URL 特征"规则贡献了 70% 的拦截且误报率极高。修复方式——对规则单独设误报抽样复核,收紧触发条件,并增加"低置信度放行 + 异步复核"通道。经验:安全指标和业务指标必须同看板、同口径,否则安全团队和业务团队各自只看对自己有利的数字。
五、边界与提醒
几个必须明确的边界:
- 拦截率没有普适的"合格线",取决于业务风险容忍度;更关键的是漏报与误报的平衡。
- 看板只能度量已知规则的拦截效果,Prompt Injection 的绕过是持续的攻防过程,指标要配套定期红队测试。
- 安全事件属于敏感数据,看板权限、日志保留与脱敏策略要提前设计,不能因为"内部看板"而放松。
FAQ
Q1:Prompt Injection 拦截率多少算合格?
A:没有统一合格线。建议先定义基线(如 30 天平均拦截率、漏报抽样率),再按业务风险设目标;对金融、客服等高风险场景,漏报率比拦截率更重要。
Q2:直接注入和间接注入怎么区分?
A:直接注入是用户输入直接携带指令;间接注入是指令藏在模型读取的外部内容里(网页、邮件、工具返回)。后者更难检测,需要单独建模,EchoLeak 就是间接注入。
Q3:误报率太高怎么办?
A:按规则拆分误报率,把误报集中的规则降级为"仅告警不拦截",同时增加上下文特征(如是否命中角色提示词边界)再判定。
Q4:安全看板应该给谁看?
A:至少三层:安全团队看攻击类型与规则质量;研发团队看误报与处置链路;管理层看趋势、风险等级与投入产出。建议做三个视图,而不是一张大表。
Q5:没有安全团队的小团队怎么起步?
A:从最小字段集埋起(请求、规则、动作、风险等级),用带事件埋点和可视化看板的现成平台搭第一版看板,先做到"每次拦截都有记录",再逐步补漏报复核。
总结
Prompt Injection 的防御与度量是一体两面:拦截动作不落数据,防护投入就无法证明价值,绕过也无法被复盘。数据分析师要做的,是把每一次拦截沉淀成事件,用拦截量、拦截质量、业务影响三层指标回答三个问题——拦了多少、拦得准不准、漏的造成了什么影响。安全看板不是终点,而是攻防循环的起点。
参考资料:OWASP《LLM Top 10》(2023/2025);CrowdStrike《2025 全球威胁报告》(2026);Cloud Security Alliance 关于 EchoLeak(CVE-2025-32711)的研究记录与 OWASP GenAI 季度事件汇总(2025-2026);TechRT《Prompt Injection Vulnerability Statistics》(2026);456数据官网产品公开信息。


 扫一扫


 627

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


