


引言:语义层的本质不是数据管理,而是世界模型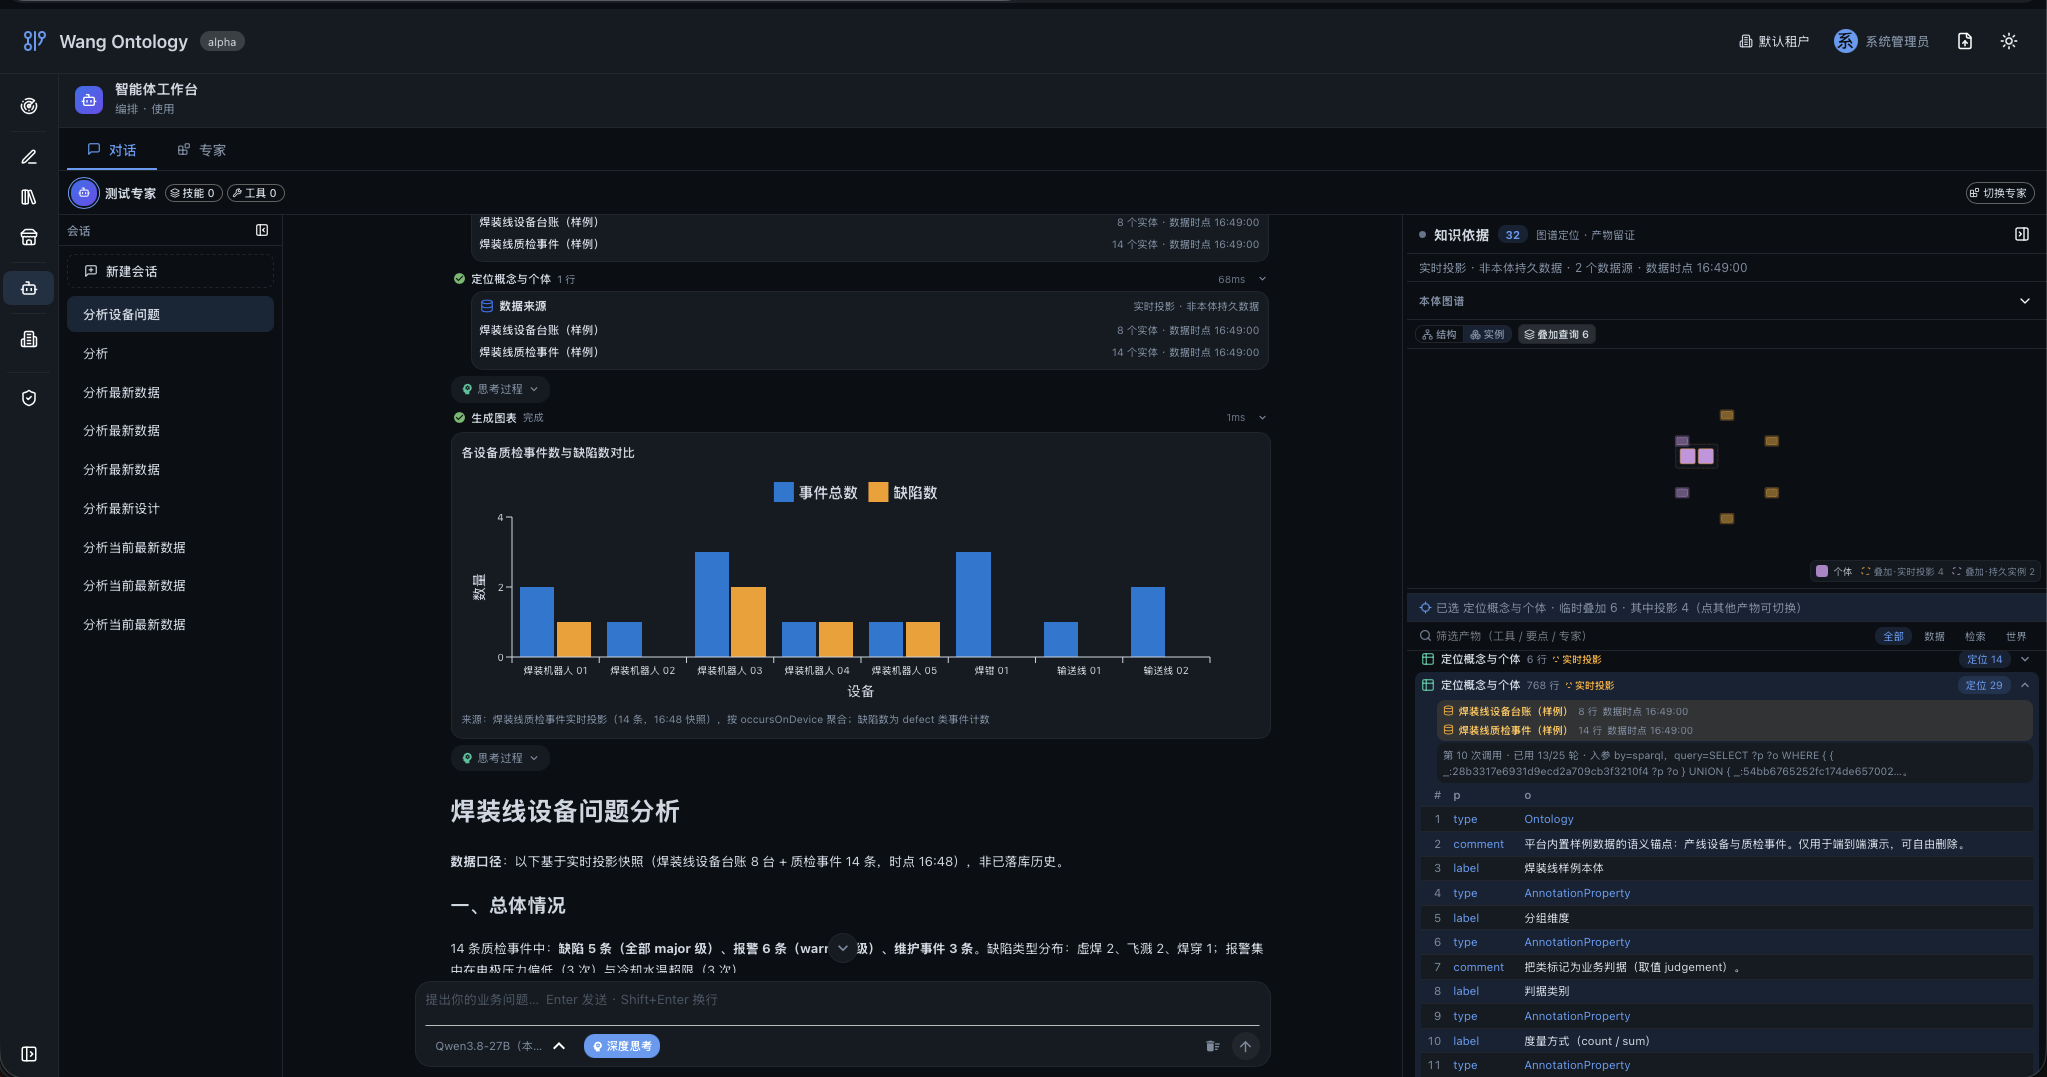
企业Agent落地中最常见的误判,是把“语义层”当作数据治理的延伸——统一指标口径、对齐字段命名、给表和列加上业务描述。这些工作当然有价值,但它们属于语义层的表层,而不是语义层的本质。
华为云社区的一篇分析给出了一个更准确的定位:语义层的本质不是“数据管理系统”,而是企业的世界模型(World Model),也是AI Native企业Agent OS的核心组成部分。它的核心价值是让人与人、人与Agent、Agent与Agent之间能够在企业统一的业务语境下协同工作。这个定位把语义层从“数据工具”提升到了“认知基础设施”的层面。
一篇关于企业Agent瓶颈的万字长文进一步澄清了本体在这个世界模型中的位置:AI本体是一个形式化的、机器可读的模型,定义了AI系统在某个领域内允许使用的概念、关系、规则、约束和含义,它给AI一个共享的世界模型。数据库存储记录,向量数据库检索相似内容,知识图谱存储连接的事实,本体定义这些事实的含义,上下文图选择当前重要的内容,AI Agent决定做什么。本体不是又一个数据存储,而是所有数据存储之上的语义坐标系。
Palantir的官方架构为这个坐标系提供了最成熟的工程表达。Ontology不是语义层的规范化,而是数据、逻辑、行动和安全的四重整合。官方三层——Semantic(Objects、Properties、Links)、Kinetic(Actions、Functions、执行与自动化)、Dynamic(Simulations、AI-Powered Decisions、Decision Capture & Learning)——定义的不仅是一个静态的知识模型,而是一个可以编译为运行时服务的可执行定义体系。
当本体被“编译”成运行时服务,Agent的行为模式发生根本变化。它不直连底层数据库,也不裸调REST API——它围绕语义层转。本文要展开的,正是这个“围绕”的四个通道:感知、行动、治理、追溯。
一、本体作为单一事实源:四种构件与一次编译
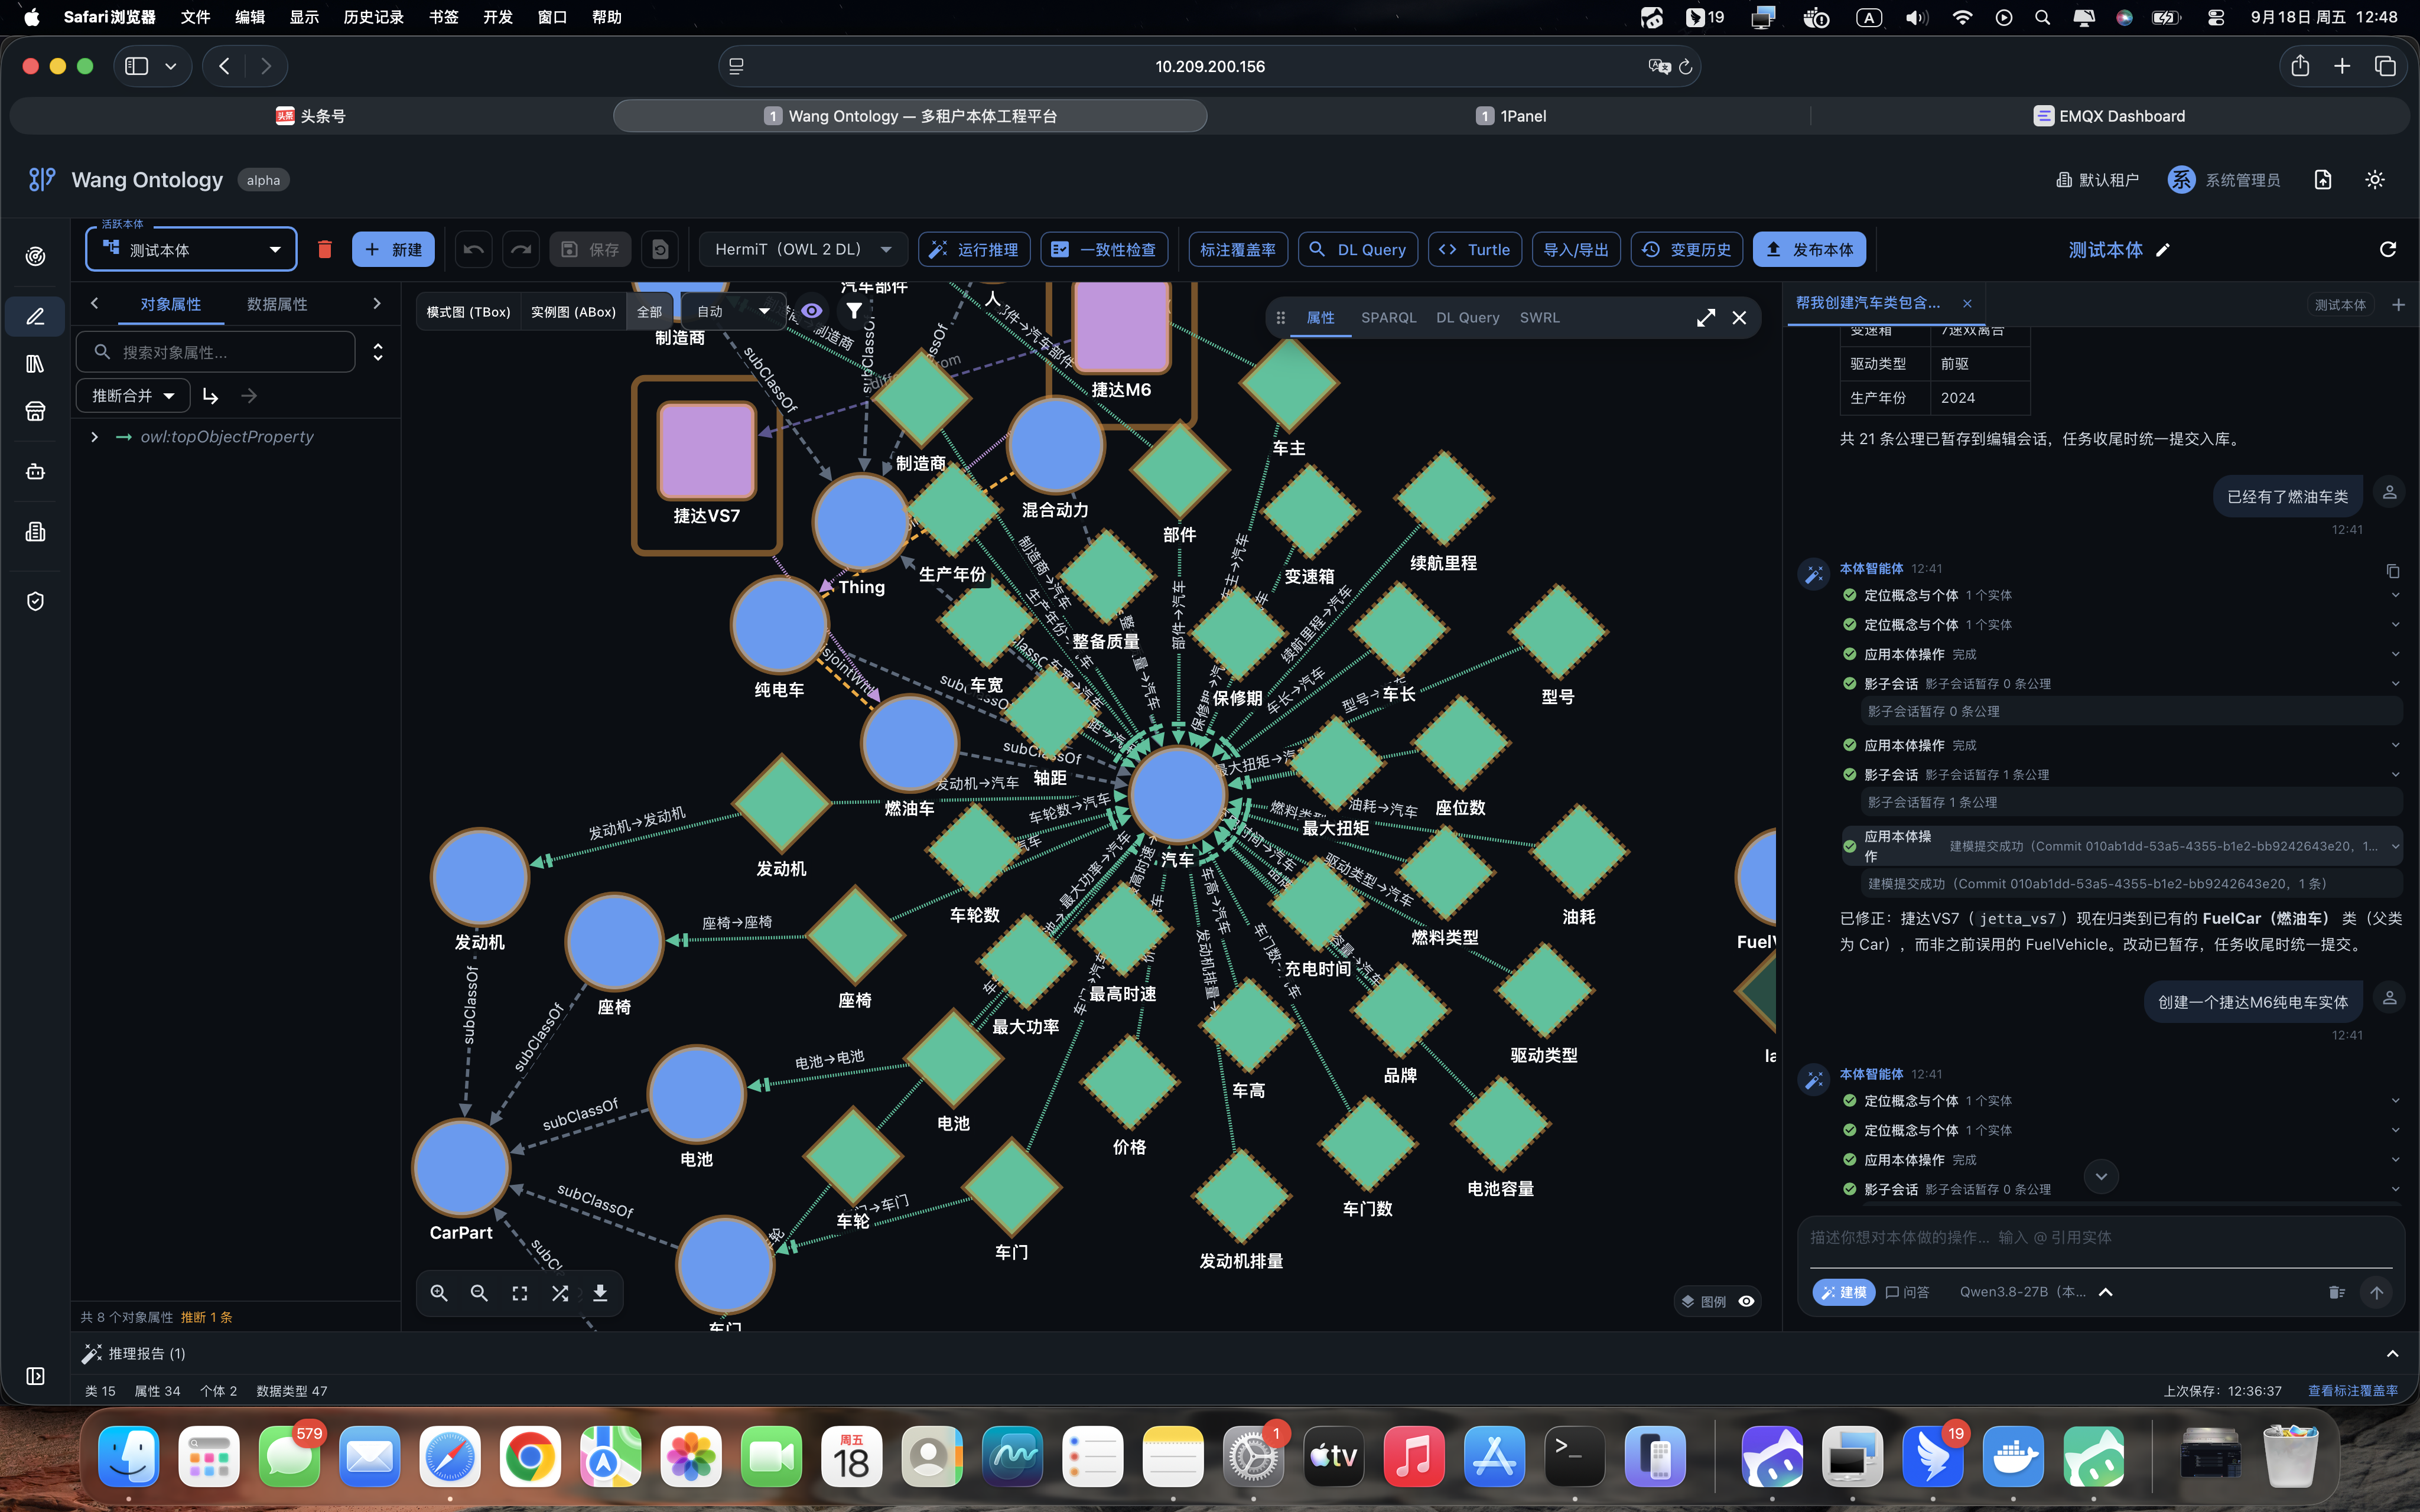
企业系统里从来不缺“事实源”。数据库是数据的事实源,API是接口契约的事实源,权限系统是安全策略的事实源。但它们彼此独立演进,缺乏统一的语义锚点——同一个“设备”在MES里是一张表、在ERP里是另一张表、在质检系统里又是第三套字段。Agent要跨系统操作,必须先“翻译”,而翻译必然产生歧义。
本体的“单一事实源”定位,不是取代数据库或API,而是在它们之上建立一个统一的语义坐标系。这个坐标系用四种基本构件描述企业的业务世界:
对象类型(Object Type) ≈ OWL Class。企业世界中存在哪些实体,每个实体有哪些属性,属性是什么类型。这是世界模型的“名词”。
关系类型(Relation Type) ≈ OWL ObjectProperty。实体之间如何关联,关系的方向、基数、传递性是什么。这是世界模型的“动词”。
行动类型(Action Type) ≈ 可执行的能力/工具。Agent能对实体做什么操作——创建、修改、删除、触发外部系统。Palantir把Action定义为本体中的“执行力单元”,每个Action规定对象如何被创建或修改,也可以触发外部系统。这是世界模型的“操作符”。
风险类型(Risk Type) ≈ 约束/不变量。什么是不被允许的,什么是必须满足的,什么条件下一个操作可以执行、什么条件下必须审批。这是世界模型的“边界条件”。
这四个构件不是文档中的规范,而是被编译成运行时服务的可执行定义。Palantir的Ontology Hydration机制通过声明式Pipeline把原始数据转换为本体对象,映射规则无需代码。Palantir的官方文档说得很直接:Ontology不是语义层,是数据、逻辑、行动和安全的四重整合。只停在语义定义的Ontology是“数字盆景”——远看结构精致,但它不生长、不结果。
当本体成为单一事实源,Agent的行为模式发生了根本变化。它不再问“数据库里有哪些表”,而是问“世界模型里有哪些对象类型”;不再拼SQL,而是声明“我要查询满足某个条件的设备”;不再裸调REST API,而是调用一个在语义层中有明确位置的动作。Agent围绕语义层转,而不是围绕数据层转。
二、感知通道:本体定义Agent“能看到什么”
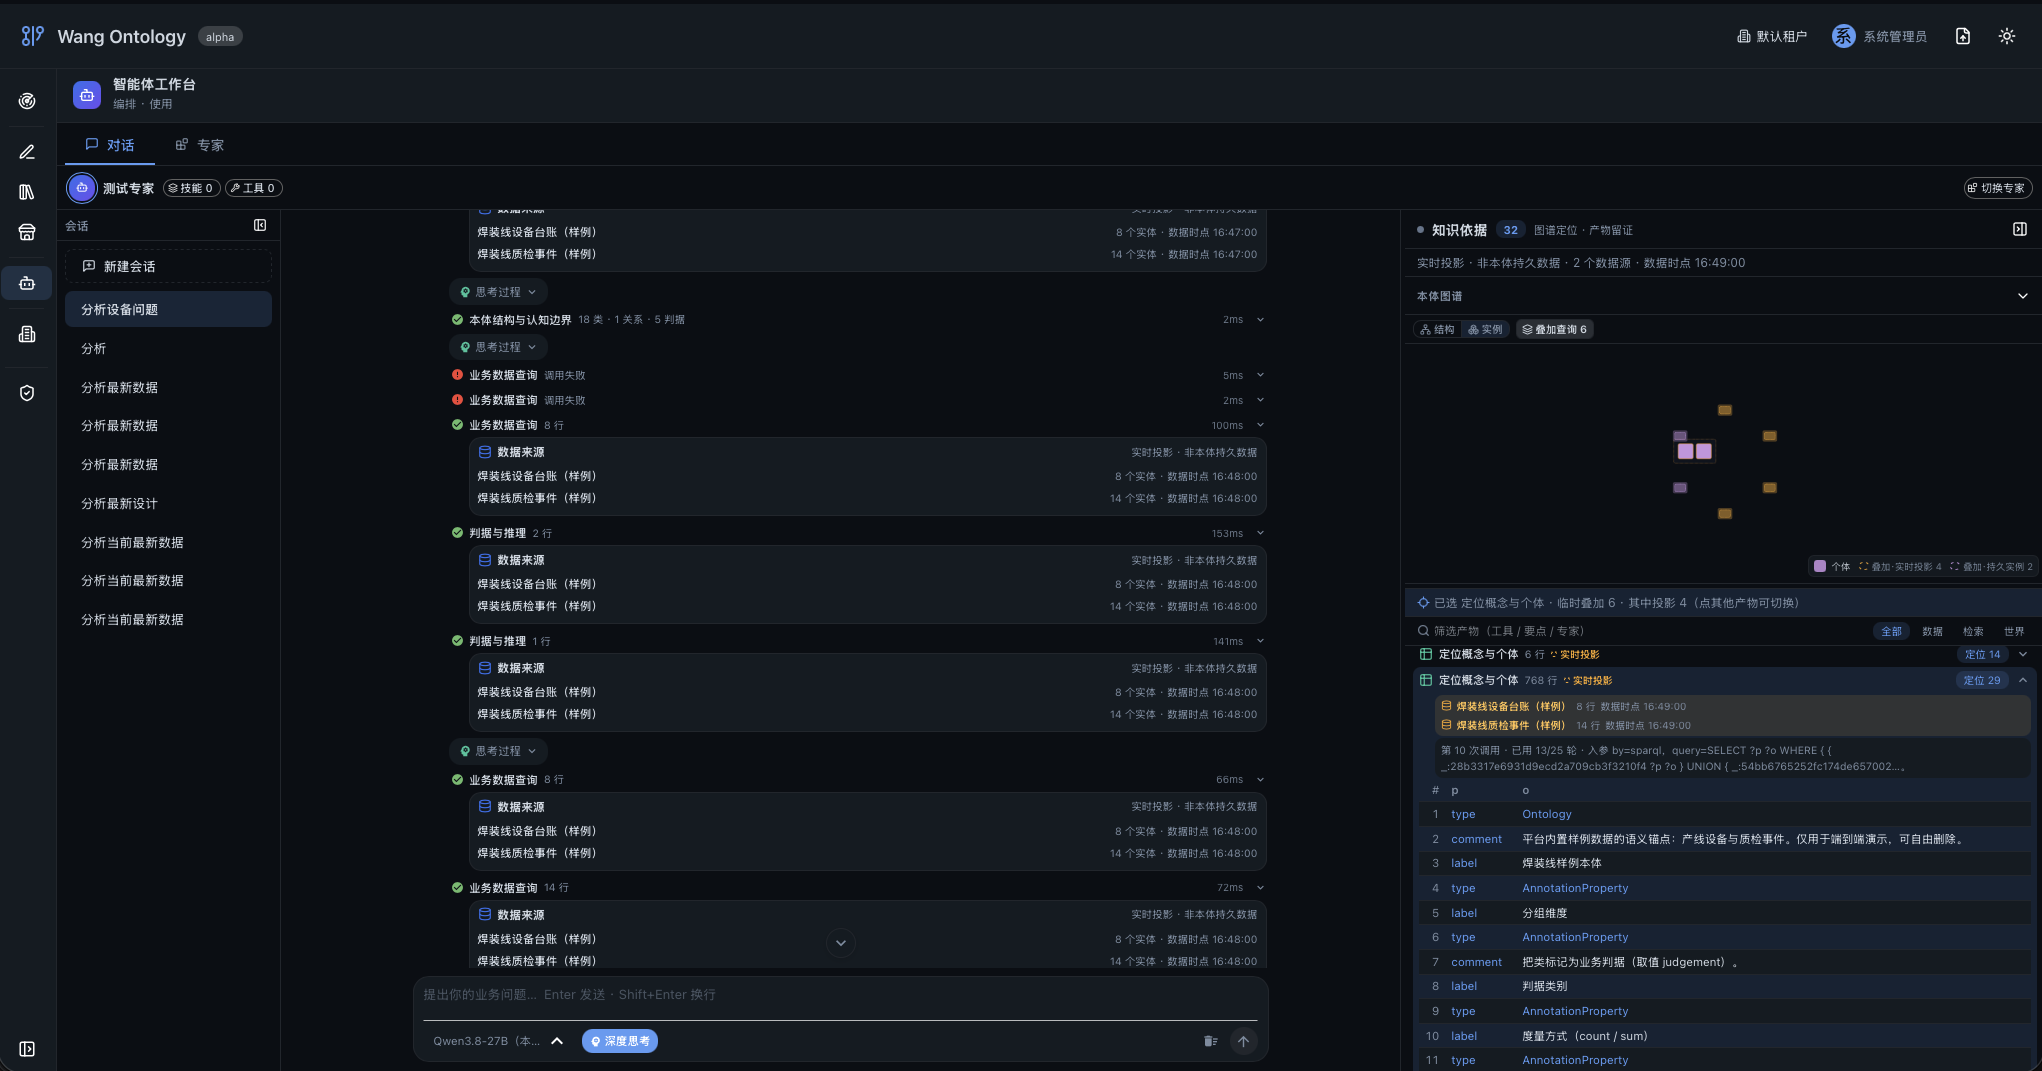
感知通道解决的核心问题是:Agent的上下文从哪来,边界在哪。
当前Agent架构中最大的上下文风险是“全量灌注”——把所有可能相关的知识一股脑塞进prompt。这在企业场景中完全不可行。一个制造业企业的本体可能包含数千个类、数万个属性和关系,全部灌入不仅上下文爆炸,更会引发注意力衰减和幻觉。更根本的问题是:LLM可能认识“客户”这个词,但不会天生知道你的组织是否将客户定义为创建账户的人、有活跃合同的公司、经过验证的法律实体、计费账户,或包含多个子公司的母组织。
本体驱动感知的核心机制是结构化切片。本体被发布成一个标准MCP服务器(Streamable HTTP),Agent通过MCP连接它。AWS的Context Ontology Accelerator正是这一模式的代表:本体以开放W3C标准表达,任何Agent都可以通过内置的MCP服务器消费它。微软Fabric IQ Ontology也定义了MCP服务器终结点,使AI助手和工具能够通过标准化接口发现本体实体,并对本体执行基于自然语言的查询。
内部检索组件做三件事,全部以本体类型为边界:
Schema Discovery。 检索相关的对象、关系和行动类型。Snowflake Cortex Agents的实践表明,本体感知方案相较于基线语义视图方案,在准确性和可解释性上有显著提升,因为本体可以显式建模层级、同义词与约束,弥补关系型数据与领域语义之间的建模鸿沟。
实例查询与子图扩展。 沿关系类型做最多3跳的子图扩展。Palantir的AIP Agent Studio明确将“Ontology context”列为Agent检索上下文的第一类来源,可以静态指定一组对象,也可以基于向量做语义搜索拉取最相关的对象。这比纯RAG可靠得多——Palantir的Ontology-Aware Generation不做文本RAG,而是直接拉取结构化对象,因为对象天然带类型、带关系、带状态。
逻辑属性解析。 解析对象类型上声明的逻辑属性,这些属性可能是派生计算的结果而非直接存储的字段。
关键设计原则是:本体定义了“词汇表”和“检索的边界”,Context Loader决定“这次给多少”。经Ranker排序后只取与任务相关的类型切片,而不是全量注入。
这个通道的价值已经被量化。在DataAgentBench对照实验中,接入语义层后4个旗舰模型均提升10到20个百分点,GLM-5.2达到50.2% pass@1。InfoQ的分析将这个问题概括为“盲人摸象”困境:CPU 88%是对的,P99 2150ms是对的,某条Trace变慢也是对的,问题在于这些只是现象——Agent知道很多碎片,却不知道这些碎片属于哪个对象、对象之间怎么连接、谁依赖谁。本体提供的不是更多数据,而是一张开放的系统地图。
三、行动通道:本体定义Agent“能做什么”
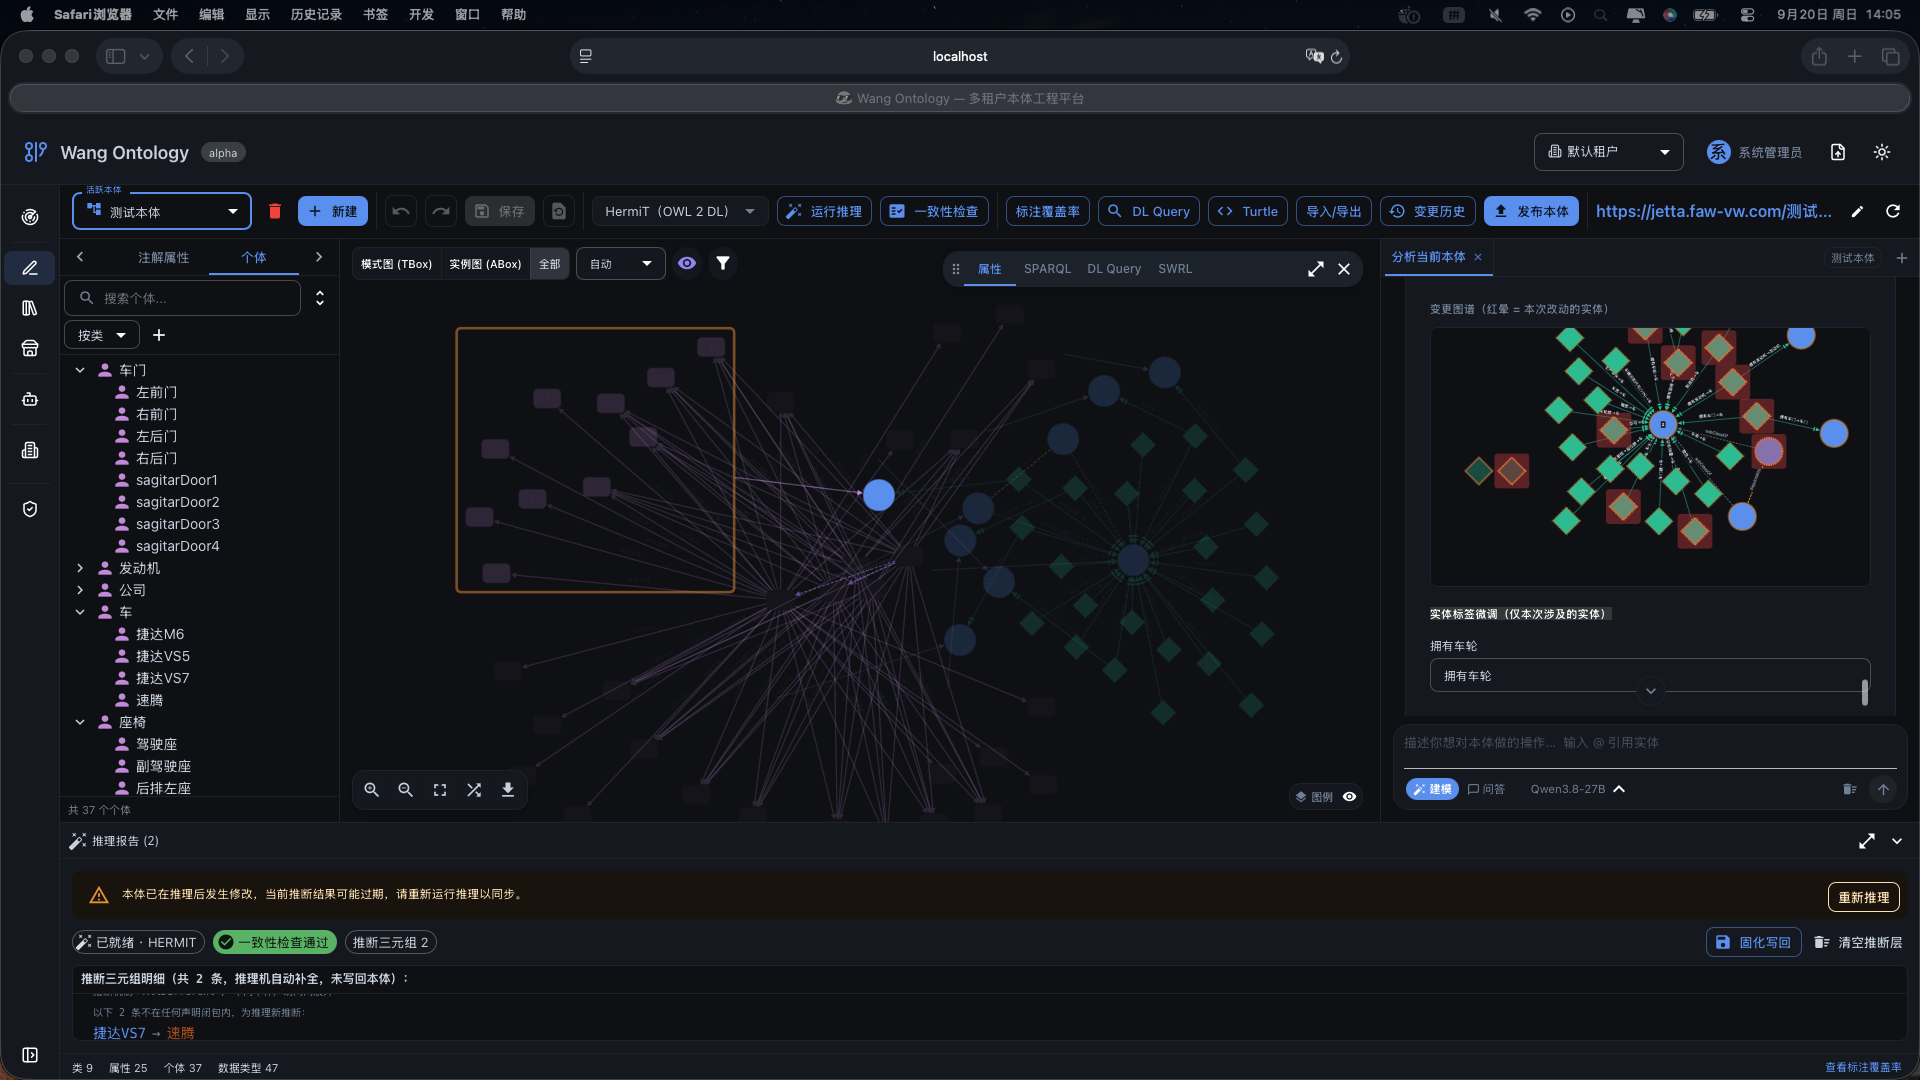
行动通道解决的核心问题是:Agent的能力从哪来,边界在哪。
传统架构中,Agent的工具集由工程师手工定义:一个函数对应一个能力,工具的schema和本体定义之间没有形式化关联。这导致两个问题:工具与业务语义脱节,Agent不知道为什么应该调用这个工具而不是那个;工具集不可发现,新增能力需要重新部署而非从语义层自动派生。
本体驱动行动的机制是编译。行动类型被编译成可执行工具,通过tool surface或MCP暴露给Agent。Palantir的Kinetic层包含Actions、Functions和执行自动化——Functions是围绕本体对象运行的业务计算与处理逻辑,Actions规定对象如何被创建或修改,也可以触发外部系统。Agent调用一个Action本质上就是调用一个工具,但每次调用必须携带语义上下文,把调用绑定到会话、回合和本体。
这意味着Agent的能力边界 = 本体里声明了哪些Action Type。本体就是“能力清单”。
从2026年的技术进展看,MCP正在成为“对象+动作”暴露给AI的事实标准。Palantir已经把MCP接入了Ontology,Atlan把MCP作为上下文层的核心入口。微软Fabric IQ的MCP服务器使任何供应商的Agent都能访问其业务本体,而不仅仅是微软自己的Agent——VentureBeat的评论指出,让本体MCP可访问是“将Fabric IQ从Fabric特定功能转变为多供应商Agent部署共享基础设施”的关键一步。
但MCP标准化的是“连接”——函数在哪里、怎么找到、怎么授权。MCP本身的描述性能力有限,它不表达业务概念之间的层级关系、约束条件和推理规则。这正是本体在行动通道中的独特价值:MCP提供连接的标准化,本体提供语义的标准化。当Agent通过MCP发现一个Action工具时,它不仅仅是发现了一个可调用的函数——它发现的是一个在本体中有明确语义位置的能力,这个能力关联着特定的对象类型、前置条件、后置效果和约束规则。
剑桥大学的一篇论文提出了“Ontology-to-tools compilation”框架,正式将本体到工具的编译过程形式化:本体中的语义约束被编译为可执行的工具规范,使LLM Agent在调用工具时受到形式化语义的约束,而非依赖prompt中的自然语言指令。这代表了行动通道的工程方向:不是让Agent“理解”工具该什么时候用,而是让工具的可用性本身由本体中的语义条件决定。
四、治理通道:本体定义Agent“被允许做什么”
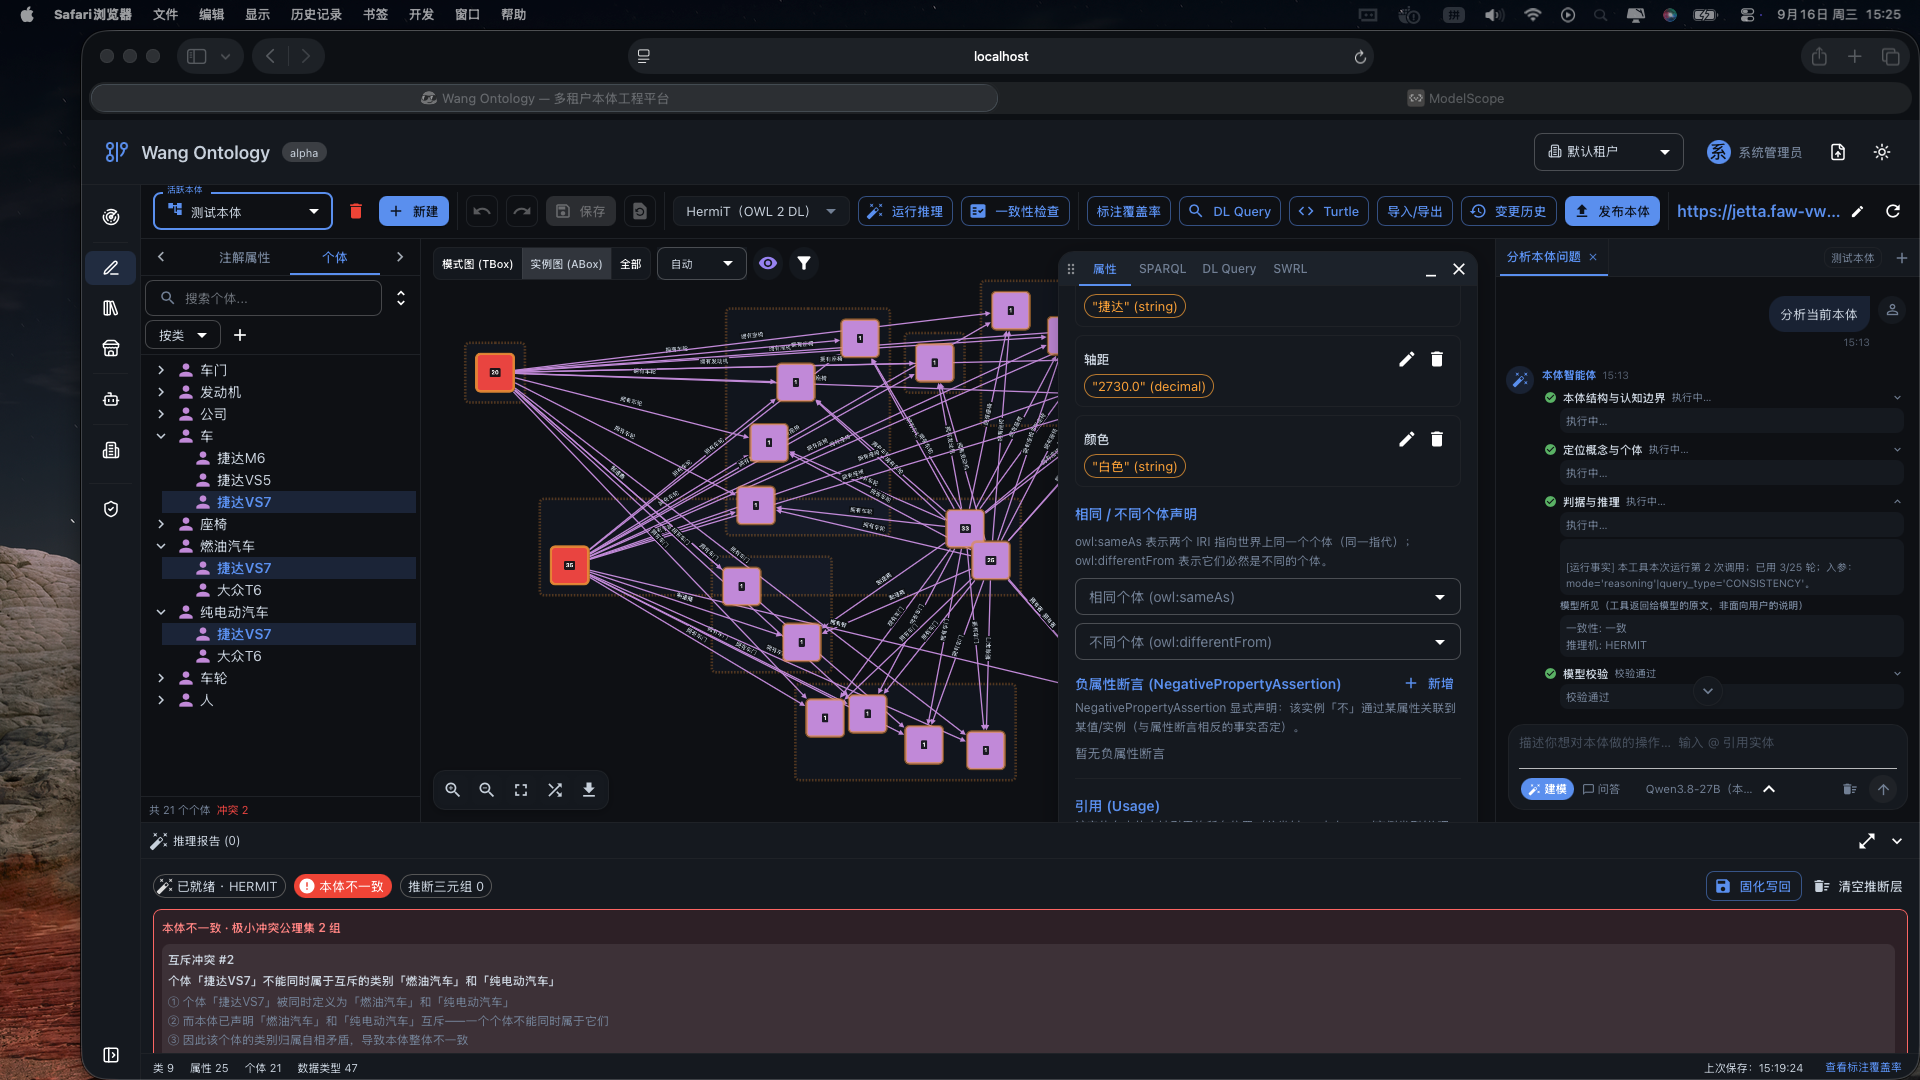
治理通道解决的核心问题是:Agent的行为边界如何以业务语义而非技术接口的方式定义。
传统权限模型建立在API层面:某个角色可以访问某个端点、某个用户拥有某个scope。这种模型在Agent场景中面临根本性挑战——Agent不是以固定角色运行的,它可能在不同会话中代表不同用户、在不同上下文中执行不同任务。API级别的权限控制无法表达“销售Agent只能查看订单金额,不能查看客户银行卡号”这类业务语义约束。
2026年,Agent身份治理正在成为独立的底层议题。蚂蚁集团在外滩大会发布的APASS方案基于“了解你的智能体”(KYA)理念,通过智能体可信身份产品与智能体风控服务构建身份与意图两条信任链,围绕智能体是谁、代表谁、被允许做什么以及行为是否可信,提供身份注册、持续核验、意图安全和可信存证等能力。目前已接入超过100万个Agent,其中已激活11万个,覆盖442家智能体服务供给方。
学术层面的进展同样迅速。IEEE ICWS 2026发表的Deontic Policies研究提出了AgenticRei框架,使用基于Rei框架的道义策略语言,以OWL表达,由完全独立于LLM的高性能逻辑引擎在运行时评估。这篇论文指出了一个关键判断:现有策略引擎(XACML、Rego、Cedar)只处理“允许/禁止”子集,不提供义务生命周期管理、元策略冲突解决、在特定情况下免除义务的豁免机制,以及在领域类层次结构上的本体推理。而Agent治理需要的远不止“允许/禁止”——它需要规定Agent在特定操作后必须履行的义务(如通知CISO),在什么条件下可以免除既定义务,以及当策略冲突时哪些规则优先。
这篇论文的核心设计原则与本文的行动通道形成呼应:LLM推理是非确定性的,安全必须在行动执行点通过独立于LLM的确定性策略层来实施。Wallarm的A2AS、微软的Agent Governance Toolkit、Cisco的MCP策略执行网关都体现了这一前提。CISA、NSA及盟国网络安全机构最近联合发布的建议也独立得出了相同结论,明确建议在每次调用时而非启动时进行策略评估。
从架构视角看,企业Agent治理正在形成一条清晰的分工线:MCP负责“连接”,本体负责“语义”,道义策略引擎负责“约束执行”。三者分层协作,而非混为一谈。正如LOM-action论文所指出的,现有LLM Agent系统的一个共同架构失败是“将工具调用视为在无约束本体上做出的语言模型推理决策,业务规则最多作为prompt指令注入”——这导致了两个结构性故障:规则盲区(Agent遍历全图而不执行组织访问约束)和过早行动(在建立任何合规范围之前就调用工具)。本体治理通道的核心设计原则正是“在可行集内优化”:企业本体授权的业务规则在任何工具被调用之前,先将图过滤为规则合规的子图,所有Action仅在合规子图上执行。
五、追溯通道:本体定义Agent“做了什么可被解释”
追溯通道解决的核心问题是:Agent的决策依据如何被回溯到具体的语义节点。
企业场景中,Agent的行为必须可审计、可解释。但传统的日志记录只能回答“Agent调用了什么API、传了什么参数”,无法回答“Agent为什么做出这个决策”——后者需要把Agent的推理过程追溯到具体的知识节点。
2026年的学术研究提供了清晰的框架。一篇发表于arXiv的企业Agentic系统论文提出了“本体约束的神经推理”架构,定义了“非对称神经符号耦合”的概念:当前企业系统约束Agent的输入(上下文装配、工具发现、治理阈值),但不约束其输出;论文提出将耦合扩展到输出侧验证——响应检查、推理验证、合规执行。实验覆盖5个行业、3个模型、1800次运行,本体耦合的Agent在指标准确性和角色一致性上显著优于未锚定的Agent,且本体增益与LLM训练数据对领域的覆盖度成反比——即在LLM参数知识最弱的领域,本体的价值最大。
本体驱动追溯的核心机制是:每次Agent动作留下证据链——意图到知识节点(本体实体),再到数据源,再到映射和算子。返回的receipt(operation_id加归一化输入哈希)把Agent的决策回溯到具体本体节点。
这意味着让Agent对本体的使用可审计、可解释。LOM-action论文进一步将这一机制形式化:每个动作产生密码学可复现的证据链,使合规性变为可审计的,而非假设的。论文的基准测试揭示了一个被称为“虚幻准确性”的现象:前沿基线模型达到80%的准确率,但工具链F1仅24%到36%——高答案分数伴随零合规推理链。而本体驱动的架构达到93.82%的准确率和98.74%的工具链F1,证明了是本体驱动的架构而非模型规模,决定了企业AI的可信度和生产就绪性。
Graph Engineering综述论文指出,本体可以帮助“标准化任务成功、失败、Agent贡献、恢复、状态一致性和运行时成本的含义”,使执行轨迹在不同系统之间更具可比性,并支持结构化消融和因果分析。本体不替代评估方法,但它阐明了“正在测量什么”以及“某个度量关注的是基础模型能力、个体Agent性能还是系统级组织”。
追溯通道的本质是将Agent的行为从“黑箱”变为“语义可解释的决策链”。当Agent的每一次推理和行动都绑定到本体中的具体节点,审计人员看到的不是“Agent调用了API X”,而是“Agent因为识别到设备类D的某个实例满足判据C,所以触发了行动A”。这种语义级别的可解释性,是本体作为单一事实源在审计维度上的必然延伸。
六、四个通道的闭环:本体即事实源
四个通道并非孤立运作,它们构成一个闭环:
感知通道让Agent看到的世界来自本体,行动通道让Agent能做的操作来自本体,治理通道让Agent被允许的行为边界来自本体,追溯通道让Agent做过的事情被锚定回本体。四者共同以本体为单一事实源,形成“看到什么,到能做什么,到被允许做什么,到做了什么”的完整链路。
Palantir的三层架构报告将这一闭环概括为“从感知、决策、行动到反馈的完整运行链路”,推动“数据由可读、可写走向可判、可学与业务自治,使本体从静态语义模型升级为可运行、可治理、可演化的业务操作系统”。爱分析的洞察进一步指出,建设环节定义对象及行动,运行环节通过Functions与Actions进入业务流程,形成全生命周期的本体运行闭环。
AWS在其语义层规范指南中提炼了本体驱动Agent的三大原则——准确性、一致性、可解释性,被称为支撑可信Agentic AI的ACE原则。这三个原则恰好对应四个通道的核心价值:感知和行动通道保障准确性,治理通道保障一致性,追溯通道保障可解释性。
回到本文的核心命题:本体是整个平台的单一事实源,Agent既不直连底层数据库,也不裸调REST,它围绕这个语义层转。这一架构选择的深层含义是:企业的业务语义不应该散落在数据库schema、API文档、权限配置和工程师的记忆中,而应该集中在一个形式化的、可执行的、可审计的语义层中。当这个语义层成为Agent运行的单一事实源,Agent的行为就从“基于猜测的文本生成”变为“基于语义锚定的受约束推理”。
从“交易信任”到“行动信任”——蚂蚁APASS的发布词准确地概括了这个转变的方向。当智能体从“陪人聊天、回答问题”走向“代表人类在现实世界中办事”,信任机制才决定它能否真正走入现实商业世界。而信任的基础,是一个可理解、可验证、可追溯的世界模型。本体不再只是知识工程师的工作台,而是Agent运行时的基础设施。四个通道,一条事实源。


 扫一扫


 304

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


