


从三星×Palantir合作看半导体良率分析:我用Ontology做了一个MVP
三星把"最高机密"交给了一家AI公司,只为提升几个百分点的良率。本文拆解背后的技术逻辑,并用 Python + Streamlit 复刻了一个最小可运行的良率分析系统。
github:https://github.com/BumbleBee-ZDS/fab_ontology_yed_mvp
一、起因:三星为什么"铤而走险"?
2024年底,三星电子DS(半导体)部门做了一个在业内看来近乎"疯狂"的决定——将晶圆厂核心制造数据接入美国公司Palantir的AI分析平台。
要知道,半导体工艺数据是比芯片设计图纸更敏感的商业机密。台积电、英特尔从来不会让任何第三方触碰产线数据。三星之所以破例,是因为 2nm GAA工艺的良率已经跌到了30%左右:
| 时间节点 | 良率 | 后果 |
|---|---|---|
| 2024年早期 | ~10-20% | 试产失败,客户观望 |
| 2025年Q1 | ~30% | 高通、英伟达转单台积电 |
| 量产门槛 | ≥70% | Exynos 2600无法按时出货 |
30%良率意味着每10片晶圆只有3片能用,成本是台积电的2倍以上。三星急需一个"外力"来打破僵局。
最终三星选择了Palantir,核心条件是:数据不出厂、Palantir不留存任何数据、服务器部署在三星内部机房。
二、理论拆解:Palantir到底怎么帮三星提良率?
2.1 半导体良率问题的本质
一颗2nm芯片要经过300-500+道工艺步骤(光刻、刻蚀、沉积、离子注入、清洗、CMP……),每步有数十到数百个可调参数。产线上数千个传感器实时采集温度、压力、气体流量、薄膜厚度、缺陷分布……
在14nm及以下节点,良率损失的主因不再是随机颗粒污染,而是多参数耦合导致的系统性失效。人类工程师靠经验和传统SPC(统计过程控制)很难从高维数据中快速定位根因。
2.2 Palantir Foundry的核心:Ontology(本体论)建模
Palantir的杀手锏不是某个具体的ML算法,而是其 Ontology数据建模层:
┌─────────────────────────────────────────────┐
│  应用层:仪表盘 / 决策工作流 / AIP对话       │
├─────────────────────────────────────────────┤
│  分析引擎层:ML模型 / 因果推断 / 异常检测     │
├─────────────────────────────────────────────┤
│  数据基础层:数据管道 / Ontology建模          │
└─────────────────────────────────────────────┘
Ontology做的事情:将散落在MES、SPC、缺陷检测、电性测试等几十个异构系统中的数据,统一建模为一张因果关联网络——"晶圆→批次→设备→工艺步骤→参数→缺陷→测试结果"之间的所有关系被显式定义,机器可以直接在这张网络上做关联查询和推理。
2.3 具体怎么提升良率?五个环节
| 环节 | 做什么 | 效果 |
|---|---|---|
| 数据整合 | 将MES/SPC/检测/测试数据统一接入,用Ontology建模 | 消除信息孤岛 |
| 关联分析 | 缺陷空间分布 × 设备 × 工艺步骤自动关联 | 根因定位从"周级"→"小时级" |
| 参数排序 | ML模型对良率影响因子做重要性排序 | 找到Top-N关键参数 |
| 实时预警 | 流处理管道预判批次良率,异常时触发干预 | 减少废品 |
| 知识沉淀 | 每次分析结论回写Ontology,形成可复用知识库 | 避免经验流失 |
一句话总结:Palantir不是"造芯片的AI",而是"帮工程师更快找到问题在哪的AI"。
三、实践:我用Python复刻了一个MVP
理解了上述原理后,我决定做一个最小可运行项目(MVP),验证"Ontology建模 + 关联分析"在良率场景下的可行性。
3.1 项目定位
FabOntology —— 半导体晶圆厂本体论驱动的良率分析MVP
- 不依赖真实Fab数据,用模拟器生成2nm GAA工艺数据
- 不依赖真实AI/ML模型,用统计方法模拟分析能力
- 核心验证点:Ontology能否将异构数据统一,并在其上完成关联分析
3.2 技术栈
Python 3.11+ / Streamlit / Pandas / Plotly / Pydantic v2 / DeepSeek LLM(可选)
3.3 项目结构
fab_ontology_yed_mvp/
├── app.py                      # Streamlit 主入口
├── config.py                   # 全局配置(工艺步骤、设备列表、隐藏规则阈值)
├── requirements.txt
├── .env                        # DeepSeek API Key(可选)
├── .streamlit/config.toml      # 深色主题配置
├── ontology/
│   ├── schema.py               # Pydantic 数据模型(Ontology 核心实体)
│   ├── graph.py                # 本体关系图查询(批次追溯、晶圆谱系)
│   └── knowledge_base.py       # 知识沉淀(历史分析结论存储与检索)
├── data/
│   ├── simulator.py            # 模拟数据生成器(埋入隐藏规律)
│   └── loader.py               # 数据加载与 DataFrame 视图
├── analysis/
│   ├── correlation.py          # 缺陷-设备-步骤关联分析
│   ├── importance.py           # 参数重要性排序(皮尔逊 + 分箱增益)
│   └── yield_tracker.py        # 良率计算与趋势
└── ui/
    ├── sidebar.py              # 侧边栏导航 + 全局筛选器
    ├── dashboard.py            # 总览仪表盘
    ├── wafer_map.py            # 晶圆缺陷图可视化
    ├── lot_trace.py            # 批次追溯视图
    ├── param_analysis.py       # 参数分析页
    └── nl_query.py             # 自然语言查询页(规则匹配 + LLM增强)
3.4 架构分层
┌─────────────────────────────────────────────────┐
│                   Streamlit UI                    │
│  Dashboard │ WaferMap │ LotTrace │ Param │ NL    │
├─────────────────────────────────────────────────┤
│              Analysis Layer(统计分析)            │
│  Correlation │ Importance │ YieldTracker         │
├─────────────────────────────────────────────────┤
│            Ontology Layer(本体服务)              │
│  Schema(Pydantic) │ Graph(关系查询) │ Knowledge  │
├─────────────────────────────────────────────────┤
│              Data Layer(数据管道)                │
│  Simulator(模拟生成) │ Loader(DataFrame视图)     │
├─────────────────────────────────────────────────┤
│                 Config(全局配置)                 │
│  工艺步骤 │ 设备列表 │ 隐藏规则阈值 │ UI配色     │
└─────────────────────────────────────────────────┘
四、核心设计详解
4.1 Ontology数据模型(Pydantic v2)
这是整个系统的"骨架"。我用Pydantic定义了7个核心实体:
class ProcessStepType(str, Enum):
    LITHOGRAPHY = "光刻"
    ETCH = "刻蚀"
    DEPOSITION = "薄膜沉积"
    IMPLANT = "离子注入"
    CLEAN = "清洗"
    CMP = "化学机械抛光"
    INSPECTION = "检测"

class Equipment(BaseModel):
    equipment_id: str
    name: str
    step_type: ProcessStepType
    chamber_count: int = 1
    status: str = "running"

class ProcessStep(BaseModel):
    step_id: str
    name: str
    step_type: ProcessStepType
    equipment: Equipment
    parameters: dict[str, float]          # 参数名 -> 当前值
    parameter_specs: dict[str, tuple[float, float]]  # 参数名 -> (下限, 上限)

class Wafer(BaseModel):
    wafer_id: str
    lot_id: str
    slot_number: int
    defect_map: list[dict]  # [{x, y, defect_type, size_um}]
    is_good: bool = True

class Lot(BaseModel):
    lot_id: str
    product: str           # e.g., "Exynos_2600"
    process_node: str      # e.g., "2nm GAA"
    wafer_count: int = 25
    wafers: list[Wafer]
    status: str = "in_progress"

class DefectRecord(BaseModel):
    defect_id: str
    wafer_id: str
    lot_id: str
    x: float
    y: float
    defect_type: str       # particle / scratch / pattern_bridge / void
    size_um: float
    detected_at_step: str

class ElectricalTest(BaseModel):
    wafer_id: str
    lot_id: str
    param_name: str        # Vth / Ion / Ioff
    value: float
    spec_min: float
    spec_max: float
    is_pass: bool
顶层用 OntologyGraph 将所有实体关联:
class OntologyGraph(BaseModel):
    lots: list[Lot]
    process_steps: list[ProcessStep]
    equipment_list: list[Equipment]
    defects: list[DefectRecord]
    electrical_tests: list[ElectricalTest]
关键设计思想:这不是简单的数据库表,而是一张语义网络。DefectRecord.detected_at_step 指向 ProcessStep,ProcessStep.equipment 指向 Equipment——沿着这条链,任何缺陷都能追溯到具体设备和具体参数。
4.2 模拟数据:埋入"可被发现的规律"
数据模拟器不是随机生成噪声,而是刻意埋入因果关系:
- 12台设备中,ETCH-02被设为异常(RF功率870W > 阈值850W,腔温408°C > 阈值405°C)
- 经过ETCH-02的晶圆,60%概率在右半部分产生
pattern_bridge缺陷 - 隐藏规则:RF功率 > 850W 且 腔温 > 405°C → 良率下降15%
- 50 Lot × 25 Wafer = 1250片晶圆,时间跨度30天
这样,关联分析模块如果能"发现"ETCH-02是罪魁祸首、RF功率是Top-1重要参数,就证明Ontology + 统计方法的有效性。
4.3 分析模块
correlation.py(关联分析):
- 按设备分组统计缺陷率 → 输出"嫌疑设备Top-N"
- 按工艺步骤统计缺陷增量 → 输出"嫌疑步骤Top-N"
- 缺陷空间分布(左/右/上/下/中心)与设备交叉分析
# 伪代码示意
import pandas as pd

def correlate_defects_by_equipment(defects: pd.DataFrame, equipment: pd.DataFrame) -> pd.DataFrame:
    """按设备分组统计缺陷率"""
    merged = defects.merge(equipment, left_on='equipment_id', right_on='equipment_id')
    return merged.groupby('equipment_id').agg(
        defect_rate=('defect_id', 'count'),
        ...
    ).sort_values('defect_rate', ascending=False)
importance.py(参数重要性):
- 皮尔逊相关系数:每个数值参数与良率标签的线性相关性
- 分箱增益:参数分5箱后各箱良率差异(模拟决策树信息增益)
- 输出:参数重要性排行榜
yield_tracker.py(良率追踪):
- 按天/按Lot/按设备/按步骤四个维度计算良率
- 支持时间窗口筛选
4.4 五个页面
| 页面 | 核心功能 |
|---|---|
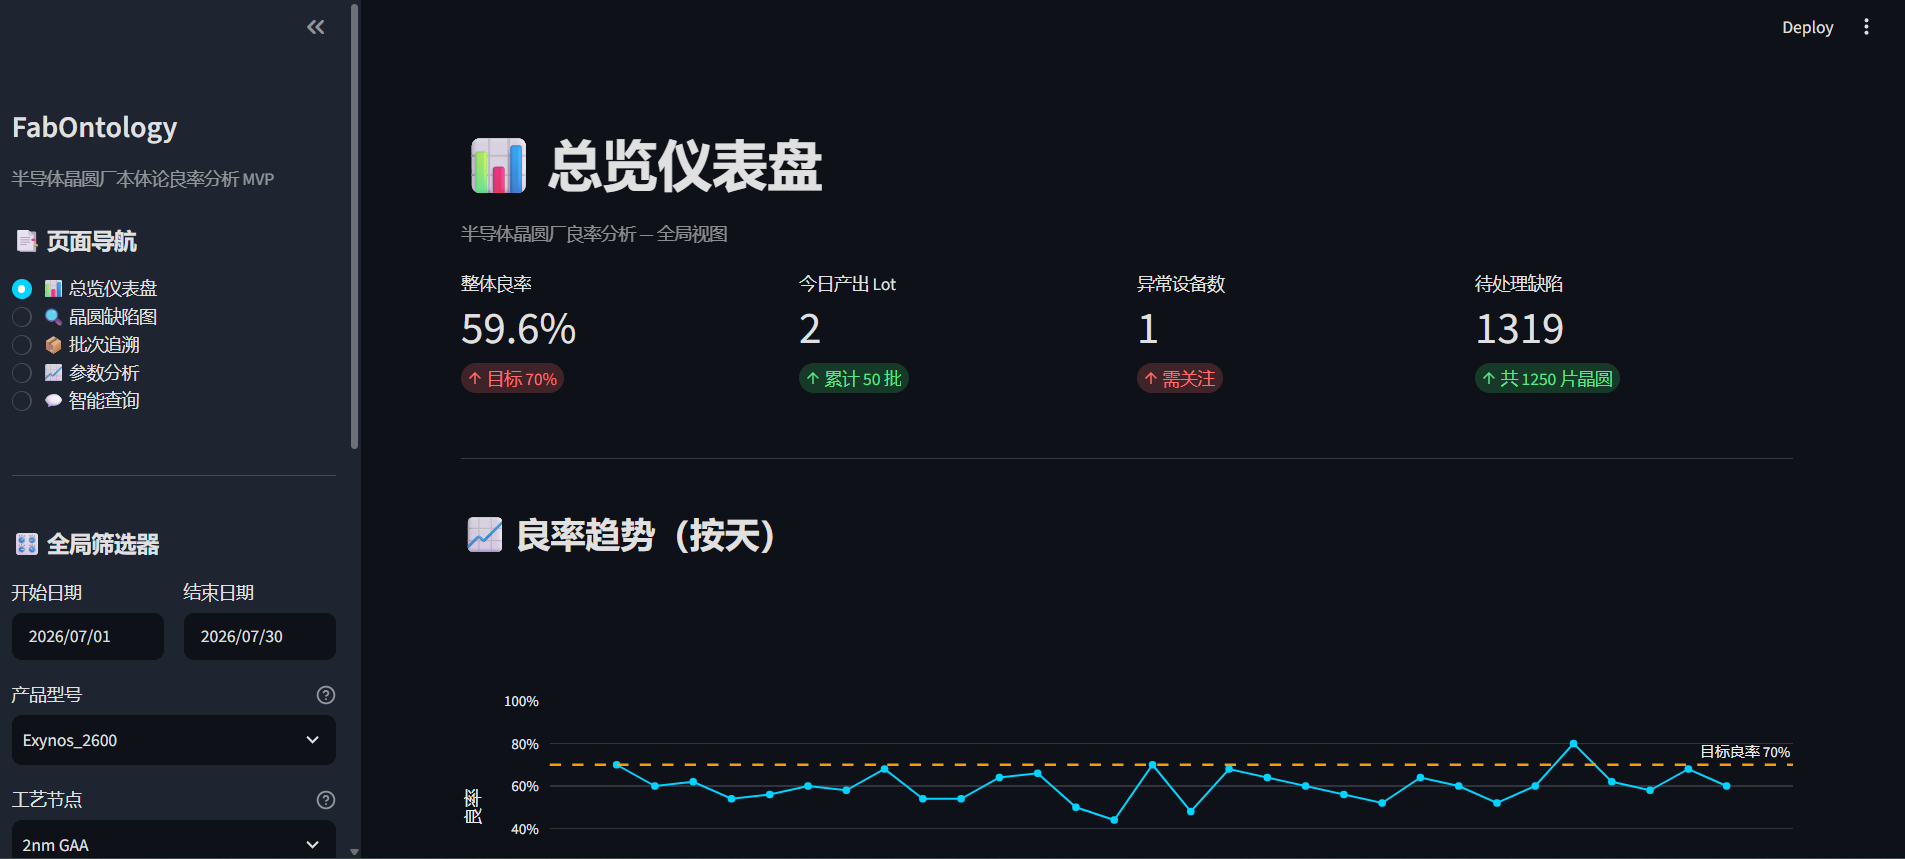
| 📊 总览仪表盘 | KPI卡片、良率趋势折线图(含70%目标线)、设备良率对比、异常告警 |
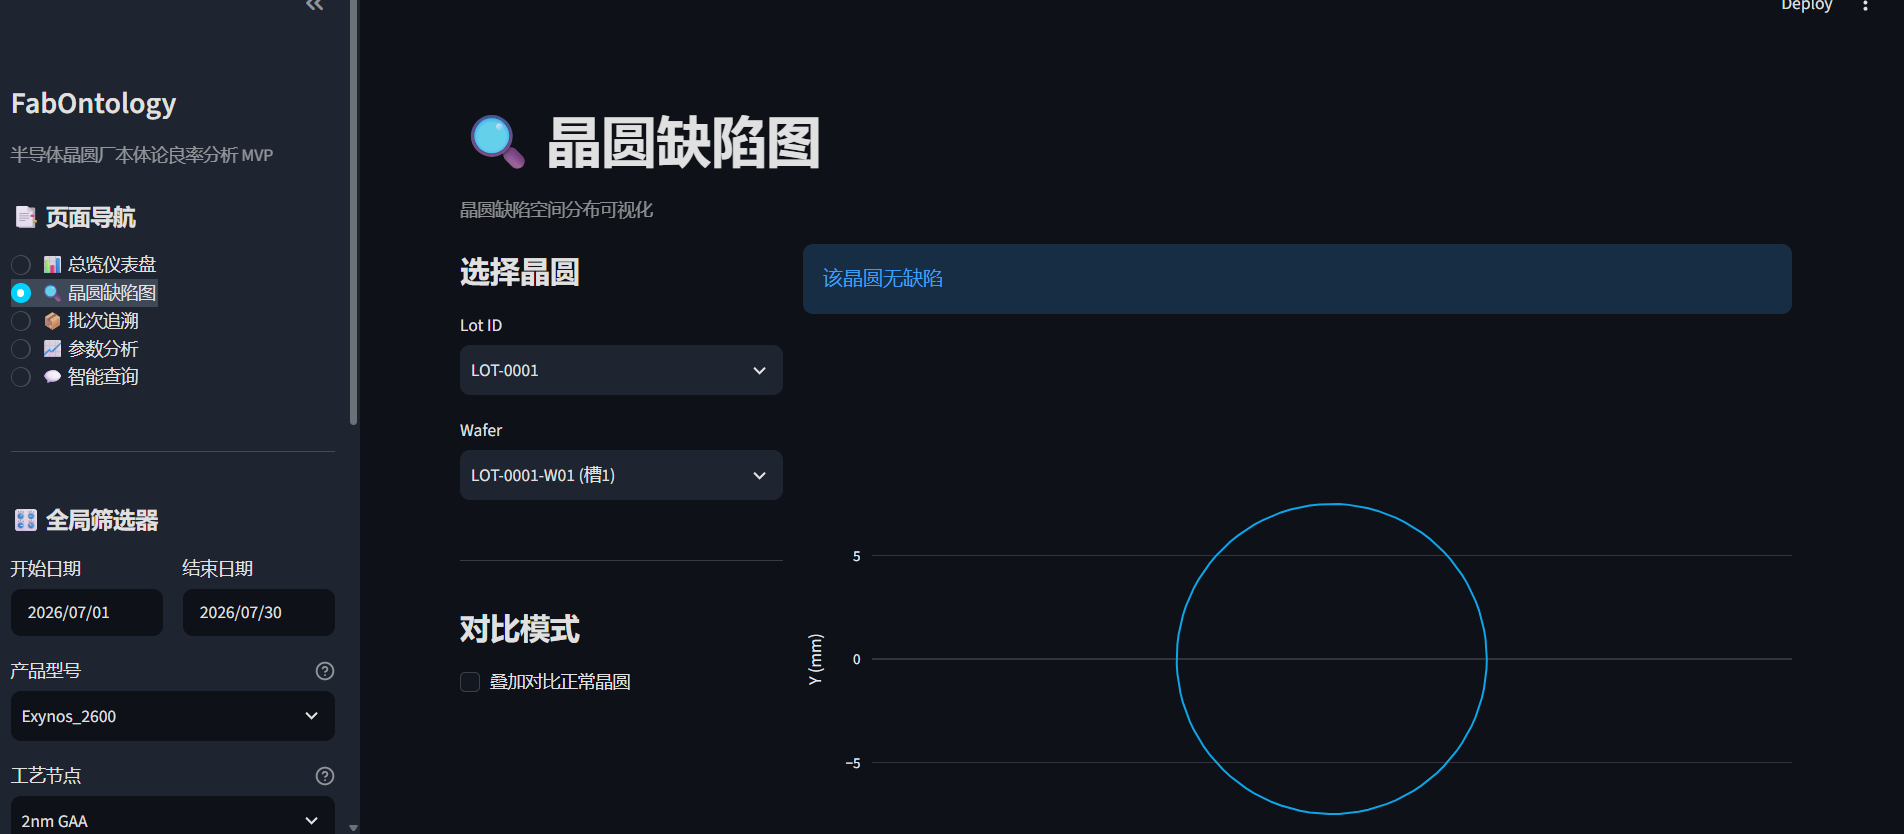
| 🔍 晶圆缺陷图 | 圆形晶圆轮廓 + 缺陷散点(按类型着色)、电性测试、正常vs缺陷对比 |
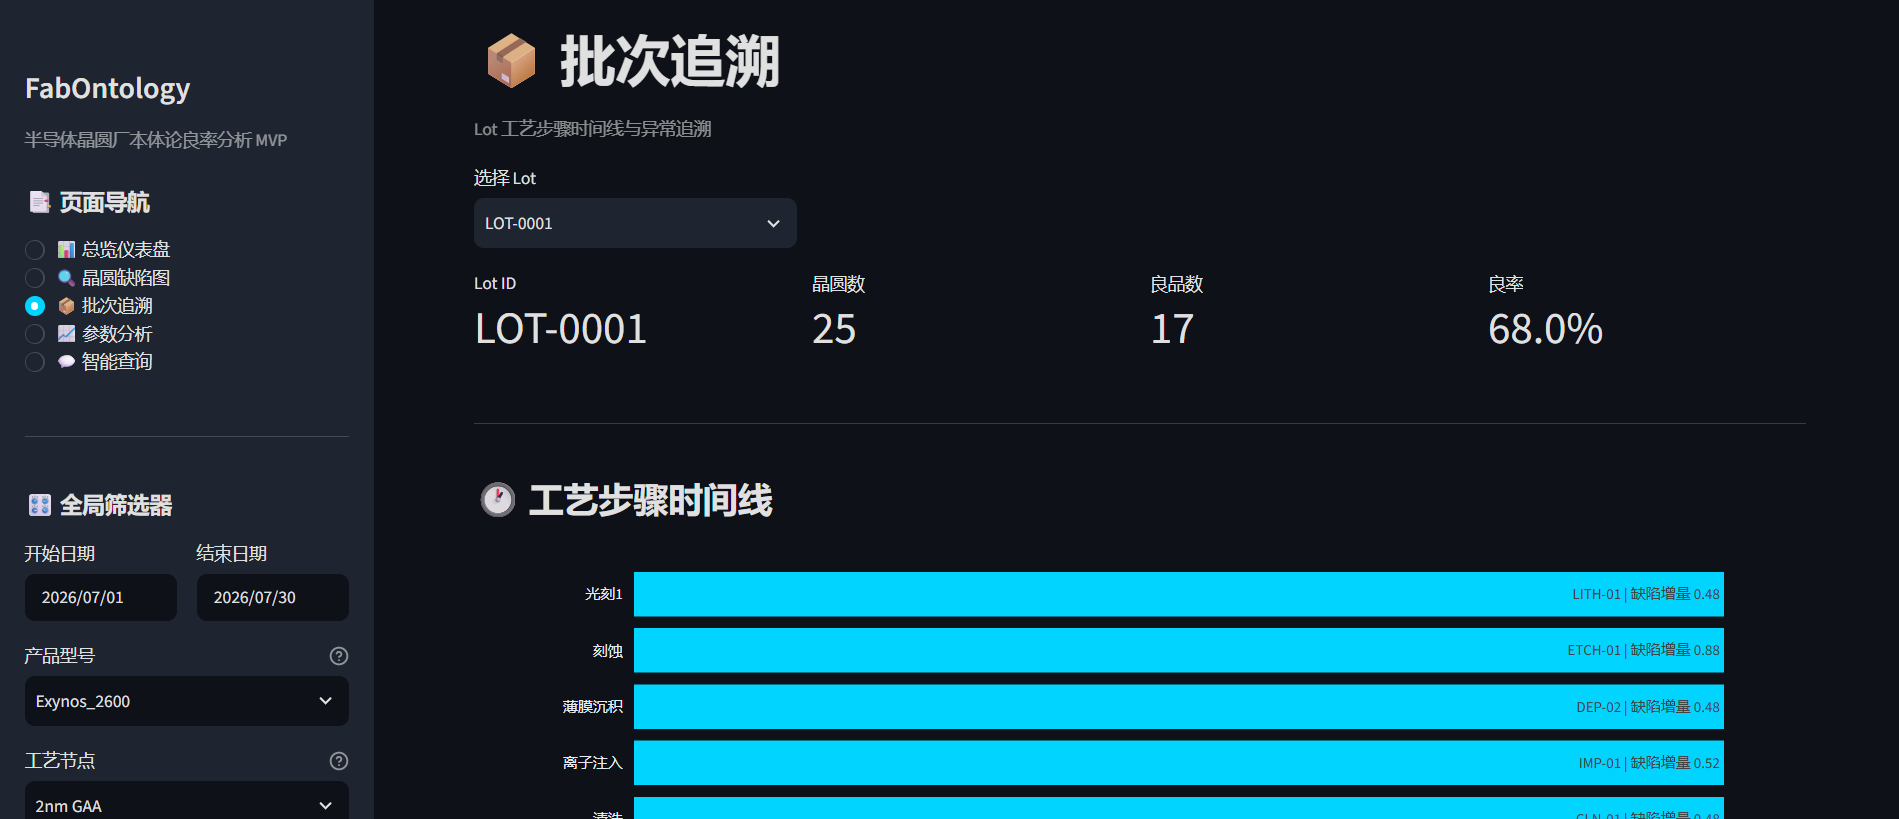
| 📦 批次追溯 | Lot步骤时间线(甘特图)、参数vs Spec对比、异常设备红色高亮🚨 |
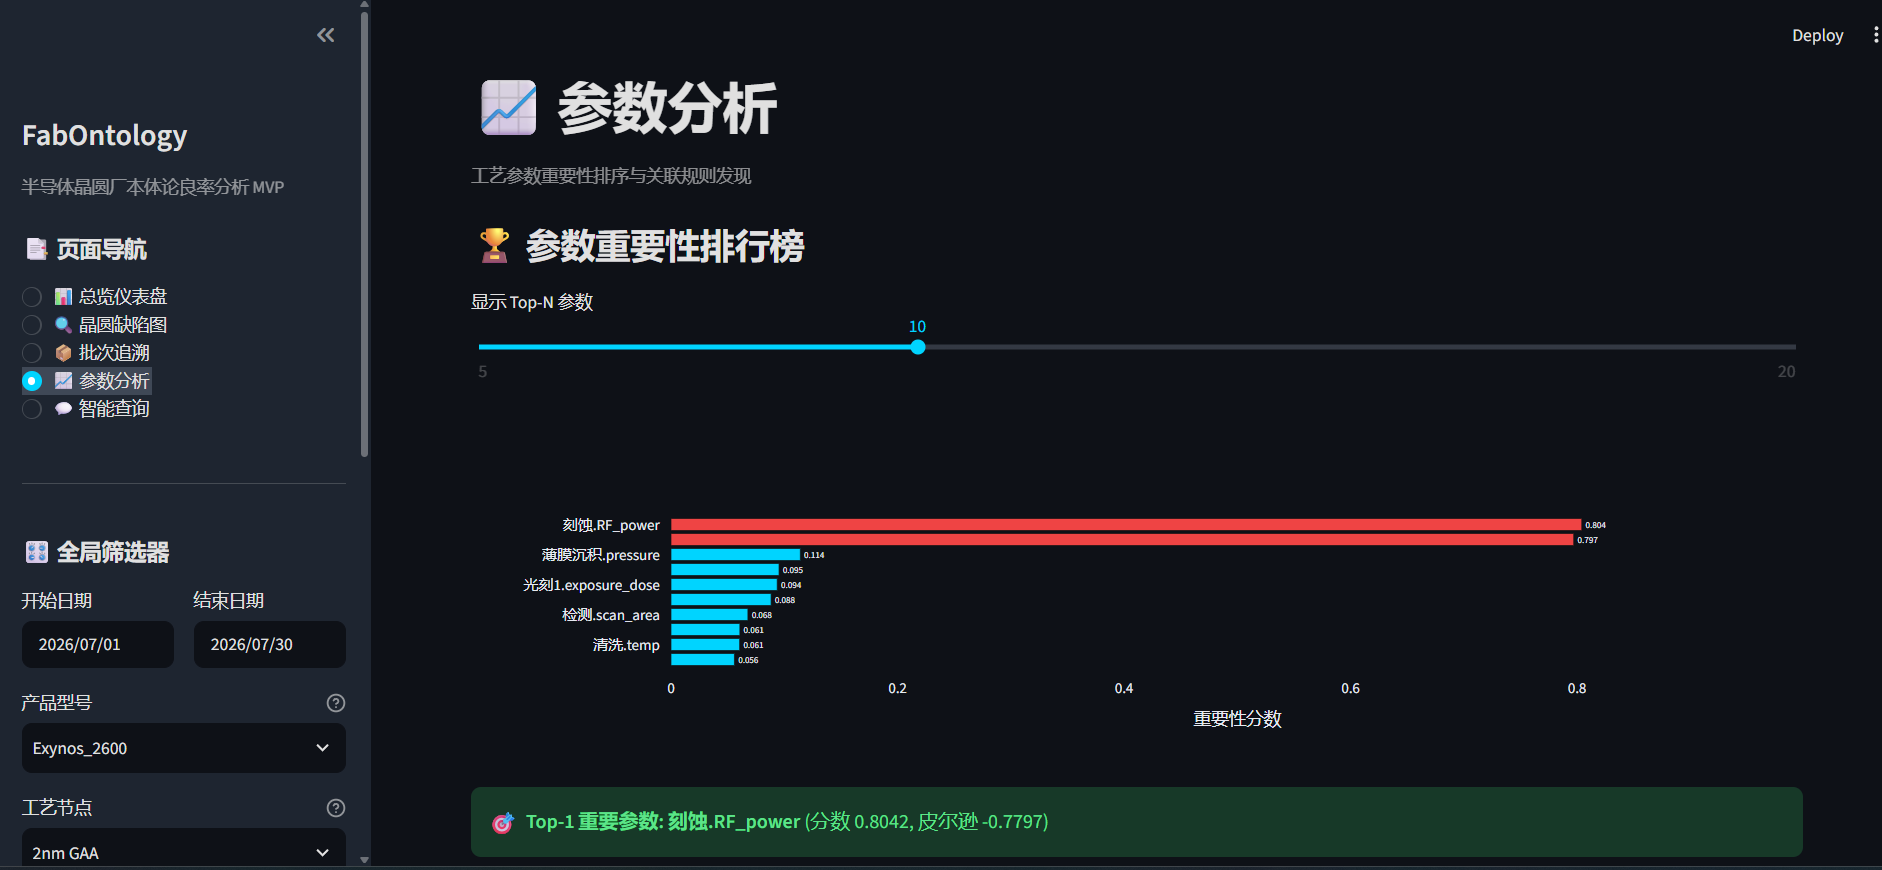
| 📈 参数分析 | 重要性排行榜、散点图、分箱箱线图、关联规则发现卡片 |
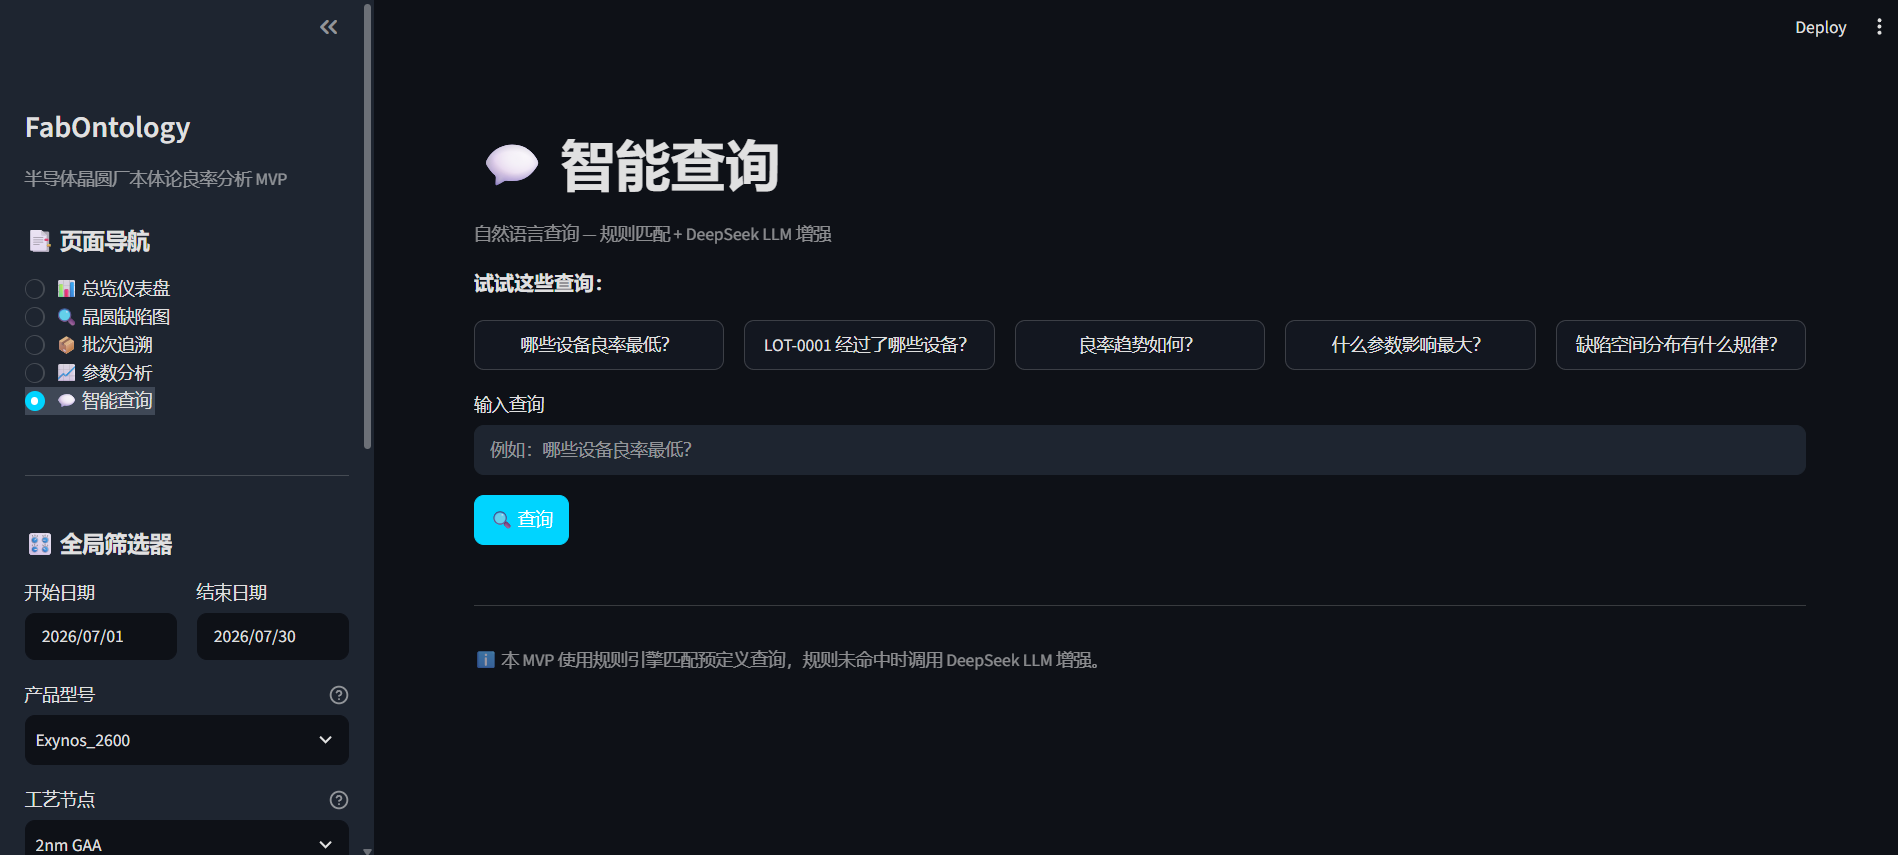
| 💬 智能查询 | 规则匹配5种预定义查询 + DeepSeek LLM增强(规则未命中时调用) |
五、运行效果
启动
python -m venv .venv
.venv\Scripts\pip install -r requirements.txt
.venv\Scripts\streamlit run app.py
浏览器访问 http://localhost:8501 。
界面展示:
验收结果
| 验收项 | 状态 |
|---|---|
| 一键启动无报错 | ✅ |
| 5个页面全部可访问 | ✅ |
| 1250片晶圆数据生成 < 1秒 | ✅ |
| 晶圆图正确显示圆形轮廓+缺陷分布 | ✅ |
| 参数分析识别"刻蚀RF功率"为Top-1(分数0.8042) | ✅ |
| 批次追溯高亮ETCH-02(红色+🚨) | ✅ |
| 智能查询响应5种预定义查询 + LLM增强 | ✅ |
六、从MVP到真实Fab:差距在哪?
这个MVP验证了架构可行性,但距离真实Fab部署还有巨大鸿沟:
| 维度 | MVP | 真实Fab |
|---|---|---|
| 数据规模 | 1250片晶圆 | 数百万片/年 |
| 数据源 | 模拟器 | MES/SPC/EDS/缺陷检测(KLA/AMAT)等20+系统 |
| 协议 | 直接读内存 | OPC-UA / SECS-GEM / GEM300 |
| 实时性 | 离线分析 | 毫秒级流处理 |
| 安全 | 无 | 物理隔离、数据不出厂、审计日志 |
| 模型 | 皮尔逊相关 | 深度学习 + 因果推断 + 物理仿真混合 |
后续迭代路线
| 版本 | 扩展方向 |
|---|---|
| V0.2 | 接入SQLite持久化,支持历史数据积累 |
| V0.3 | 引入真实LLM替换规则引擎做NL查询 |
| V0.4 | 加入Isolation Forest时序异常检测 |
| V0.5 | 支持多Fab/多产品线Ontology扩展 |
| V1.0 | 对接真实MES/SPC数据源(SECS-GEM协议) |
七、总结
三星与Palantir的合作揭示了一个趋势:半导体制造的竞争,正在从"谁的物理工艺更强"扩展到"谁的数据智能更强"。
Ontology不是银弹,但它解决了一个根本问题——让数据从"散落在20个系统里的CSV"变成"机器可推理的因果网络"。有了这张网络,无论是传统的统计方法还是前沿的LLM,都有了施展拳脚的基座。
这个MVP用不到2000行Python代码,验证了这条路径的最小闭环。希望对你有所启发。
参考
- 韩国经济日报:三星DS引入Palantir提升良率(2025.03)
- Palantir Foundry 官方文档:Ontology概念
- 三星2nm GAA工艺良率公开报道(2024-2026)


 扫一扫


 193

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


