


SWIN-Fusion
SwinFusion: Cross-domain Long-range Learning for General Image Fusion via Swin Transformer
方法设计
作者提出了一种基于【跨域远程学习】和【Swin Transformer】的【通用】图像融合框架SwinFusion。
注意力引导的跨域模块,用来实现互补信息和全局信息的充分整合。
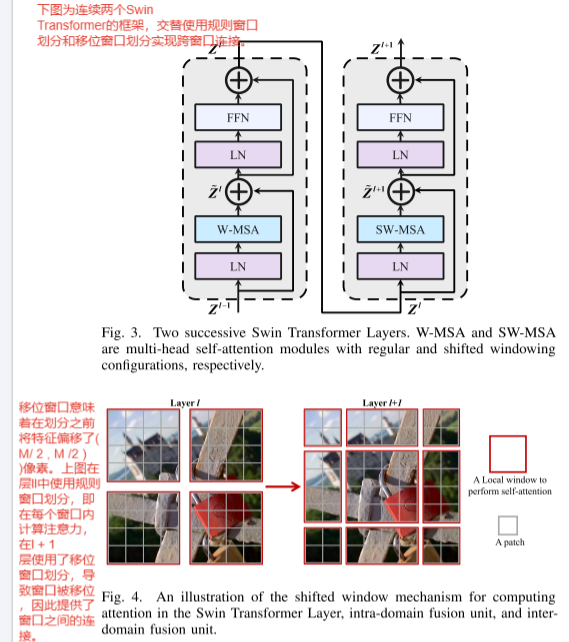
基于自注意力机制的域内融合单元,用来提取特有特征,基于跨域注意力机制的域间融合单元,用来提取互补特征。上述两种注意力机制都是由移位窗口(SwinTransformer)机制实现的,ST允许框架处理任意尺寸的图像
提出了一个多场景图像融合问题的统一框架
设计了由结构、纹理、强度损失构成的损失函数
网络结构
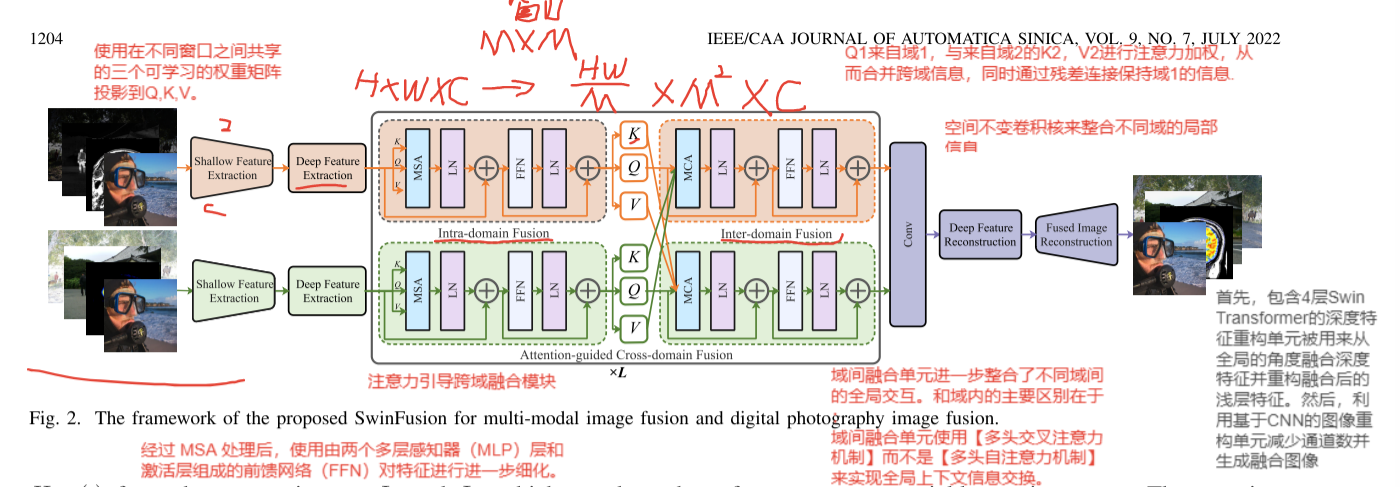
特征提取
shallow features Extraction包含两个卷积层,其内核大小为3 X 3,步长为1,该层用于提取浅层特征,并且将浅层特征的特征数据映射到高维特征,从而使得后期特征的融合和提取有更好的效果。
Deep Feature Extraction包含4个Swin Transformer层,在shallow features Extraction层的基础上,提取包含全局信息的特征。这里的架构其实很简单,较难的是理解Swin Transformer,


 370


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


