


SwinFusion: Cross-domain Long-range Learning for General Image Fusion via Swin Transformer
(SwinFusion:基于Swin Transformer的跨域远程学习通用图像融合)
提出了一种基于跨域远程学习和Swin Transformer的通用图像融合框架SwinFusion。一方面,设计了注意引导的跨域模块,以实现互补信息和全局交互的充分整合。更具体地说,所提出的方法涉及一个基于自我注意力的域内融合单元和基于交叉注意力的跨域融合单元,挖掘和整合在同一个领域和跨域的长依赖关系。通过远程依赖建模,网络能够充分实现特定领域的信息提取和跨领域的互补信息集成,以及从全局角度保持适当的表观强度。特别地,我们将移位窗口机制引入到自注意和交叉注意中,这使得我们的模型能够接收任意大小的图像。另一方面,多场景图像融合问题被推广到一个统一的框架与结构保持,细节保护,并适当的强度控制。此外,一个精心设计的损失函数,包括SSIM损失,纹理损失和强度损失,驱动网络保留丰富的纹理细节和结构信息,以及呈现最佳的表观强度。多模态图像融合和数码摄影图像融合的大量实验证明,我们的SwinFusion与最先进的统一图像融合算法和特定任务替代方案相比具有优越性。
INTRODUCTION
由于硬件设备的限制,由单一类型的传感器或单一拍摄设置捕获的信息不能全面表征成像场景。一方面,不同类型的传感器通常从多个角度捕获特定信息。例如,红外传感器收集热辐射信息,这强调突出的目标。可见光传感器通过捕捉反射光信息生成具有丰富纹理细节的数字图像。近红外传感器可以捕获可能在可见光图像中丢失的补充细节。此外,在医学成像领域,结构系统(例如,磁共振成像(MRI)和计算机断层扫描(CT))通常提供结构和解剖信息。相比之下,诸如正电子发射断层扫描(PET)的功能系统可以提供关于血流和代谢变化的功能信息。另一方面,具有不同拍摄设置的传感器通常从成像场景获取有限的信息。更具体地,具有变化的ISO和曝光时间的相机仅捕获动态范围内的信息,并且不可避免地错过动态范围外的信息。同样,具有特定焦距的相机仅捕获景深(DOF)内的对象。值得一提的是,由不同传感器或在多种拍摄设置下拍摄的图像一般都包含互补信息,这鼓励我们将这些互补特征融入到单个图像中。因此,图像融合技术应运而生。根据成像设备的不同,图像融合可分为多模态图像融合和数字摄影图像融合。这两种类型的图像融合场景的示意图在图1中展示。融合后的单幅图像具有更好的场景表示和视觉感知能力,有利于后续的实际视觉应用,如目标检测、跟踪、语义分割、场景理解等。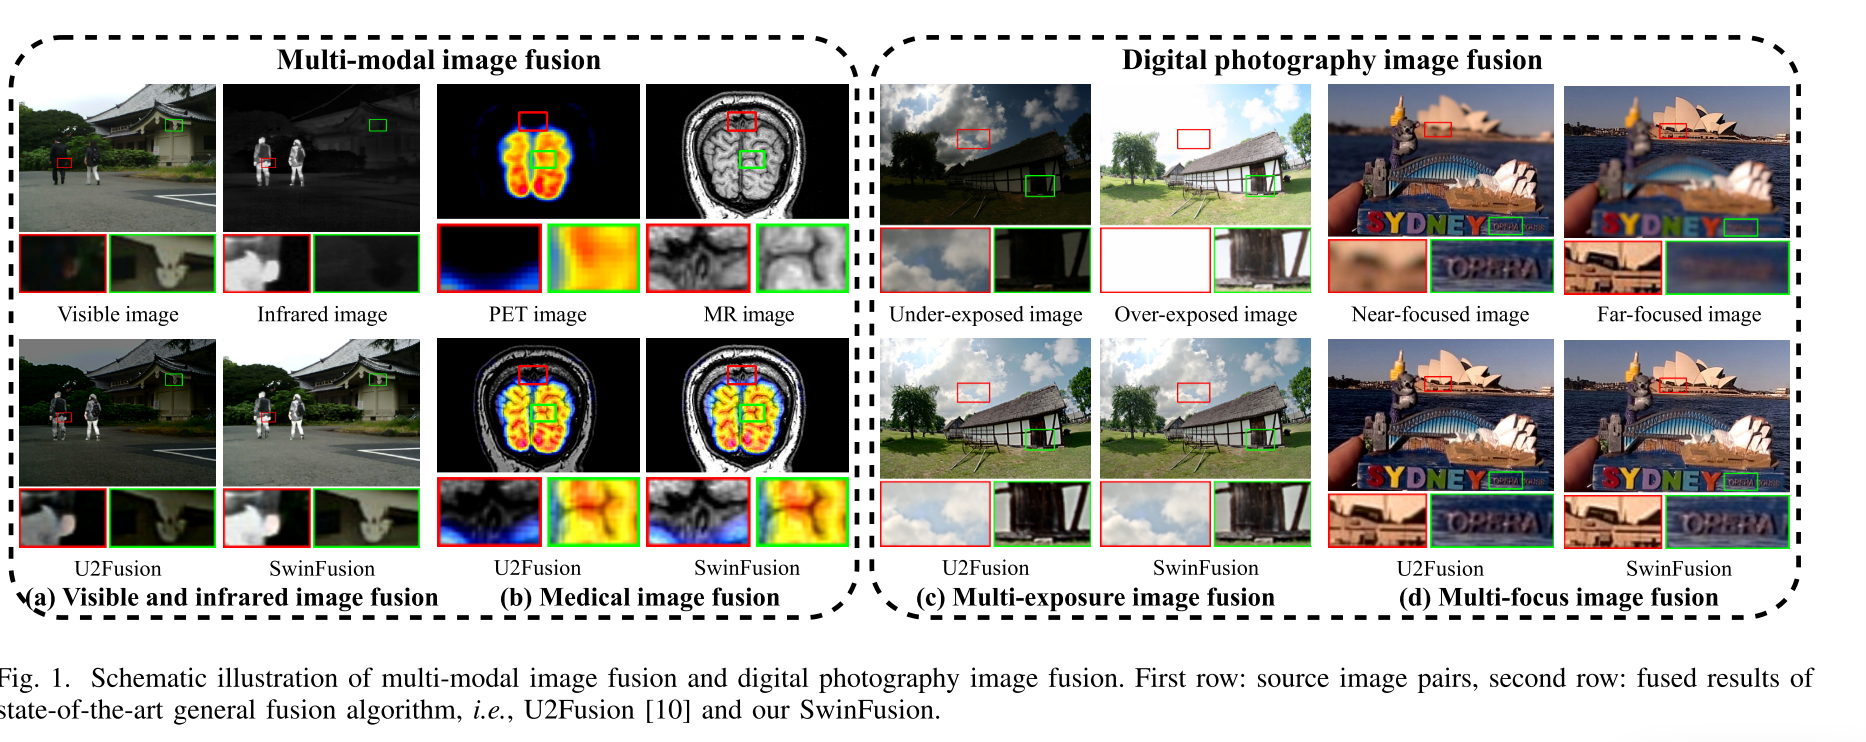
在过去的几十年中,已经提出了许多图像融合技术,其可以大致分为两类,即,任务特定图像融合方案和一般图像融合算法。任务特定图像融合和一般图像融合都可以进一步分为四类,包括传统框架,基于卷积神经网络(CNN)的框架,基于自动编码器(AE)的框架,以及基于生成对抗网络(GAN)的框架。虽然上述框架可以产生相当多的融合结果,但没有一个框架可以充分挖掘和整合领域内和跨领域的全局背景。特别是,我们假设由不同的传感器或多个光学设置下拍摄的图像属于不同的域在本文中。一方面,传统的框架通常在空间域或变换域中实现互补信息聚合,但它们都不能在不相邻的像素之间交换信息。因此,传统的框架无法感知全局环境。另一方面,基于CNN、AE和GAN的框架的基本组件是卷积层,它们只能挖掘感受野内的交互。然而,在利用图像融合的局部信息的同时,这些框架不能利用域内或域间的长程依赖性来进一步改善融合结果。
作为CNN的替代方案,Transformer设计了一种自我注意机制来捕获上下文之间的全局交互,并在几个视觉问题中表现出有希望的性能。特别是,图像融合社区还引入了Transformer来对域间长程依赖性进行建模,并提供了有竞争力的融合结果。然而,仍然存在一些需要解决的缺点。首先,现有的基于Transformer的方法只探索域内的相互作用,但不能集成跨域的背景下,这是必不可少的图像融合任务。第二,用于图像融合的视觉Transformer通常请求可以被整形为固定大小的输入图像(例如,256 × 256),这导致融合图像中的失真场景。第三,现有的融合Transformer被设计用于特定的融合场景,而不考虑不同的融合任务之间的内在联系。
为了解决上述挑战,我们设计了一个通用的图像融合框架的基础上跨域远程学习和Swin Transformer的多模态图像融合和数字摄影图像融合。我们的设计主要从以下几个方面展开。一方面,我们模型的所有图像融合的情况下,结构维护,纹理保存,和适当的强度控制。特别是,我们统一的损失函数的形式,包括SSIM损失,纹理损失,强度损失,所有融合问题。所有子损失项遵循不同融合任务的相同建模方式,除了强度损失,这是定制的特定融合使命更合适的强度感知。另一方面,我们设计了一个联合CNN-Transformer图像融合框架,充分挖掘源图像中的局部和全局依赖关系。基于CNN的浅层特征提取单元挖掘源图像中的局部信息。基于Transformer的深度特征提取单元探索浅层特征之间的全局交互,并生成包含高级语义信息的深度特征。然后,精心设计的注意力引导的跨域融合模块有效地集成了深层特征中的域内和域间交互。具体地,域内融合单元经由自注意机制聚合相同域中的全局上下文。域间融合单元对多个源图像之间的长程依赖关系进行建模,通过交换来自不同域的查询、键和值来实现全局特征融合。最后,基于Transformer的深度特征重建单元和基于CNN的融合图像重建单元利用全局和局部信息来重建具有上级视觉感知的融合图像。值得注意的是,自我注意和交叉注意都是通过移位窗口机制(即,Swin Transformer),它允许我们的框架处理任意大小的输入图像。
综上所述,本工作的主要贡献可概括如下:
1)我们提出了一个联合CNN-Transformer融合框架,用于多模态图像融合和数字摄影图像融合。所提出的框架可以充分利用本地和全球信息,以实现更好的互补特征集成。
2)设计了一个基于自注意的域内融合单元和一个基于交叉注意的域间融合单元,分别对同一域内和跨域的长程依赖关系进行建模和集成。
3)多模态图像融合和数字摄影图像融合都被推广到结构保持、纹理保持和适当的强度控制。特别地,定义了统一的损失函数形式来约束所有的图像融合问题。
4)大量的实验表明,我们的框架比目前最先进的特定任务和一般的融合算法的多模态图像融合和数字摄影图像融合还要好。
RELATED WORK
图像融合和视觉变换是两个最相关的技术,我们在这里回顾一些代表性的研究,介绍他们的发展。
Task-specific Image Fusion Methods
图像融合作为一种重要的图像增强技术,近年来受到越来越多的关注。主流的图像融合方案,特别是针对特定任务的图像融合,可以分为以下四种类型的框架。
Traditional Image Fusion Framework: 传统的融合框架通常在空间域和变换域实现图像融合。一方面,在空间域中整合像素级信息是传统图像融合的主要类型之一。GTF 将红外和可见光图像融合定义为空间域中的整体强度保持和纹理结构保持,并通过优化目标函数来产生融合图像。Awad等人开发了一种空间域中的自适应近红外和可见光融合方案,用于可见光图像细节增强。此外,Liu等人设计了一种基于形态成分分析(CS-MCA)的卷积稀疏模型,以实现像素级的医学图像融合。他们还引入了局部特征描述符(即,Dense SIFT)到多焦点图像融合任务中,以执行活动水平测量并匹配不同源图像之间的未配准像素。另一方面,研究人员也尝试通过相关的数学变换将源图像映射到变换域,并在变换域中手工设计融合规则来实现图像融合。Ma等人采用结构路径分解技术将源图像变换成三个概念上独立的分量,即,信号强度、信号结构和平均强度。然后,分别对这三个分量进行融合,实现多曝光图像的融合。此外,Li等人提出了一种基于变换域的多聚焦图像融合算法,结合稀疏特征矩阵分解和形态滤波技术。
CNN-based Image Fusion Framework: 近年来,卷积神经网络(CNN)逐渐成为图像融合的主要主力,并表现出显着的优势。参与图像融合的CNN的一种形式采用预先训练的网络来实现活动水平测量并为手工制作的特征生成权重图。但整个融合过程仍然基于传统的融合框架,如拉普拉斯金字塔和引导滤波。另一种类型的基于CNN的图像融合框架是利用CNN以端到端的方式学习源图像和融合图像(或聚焦图)之间的直接映射。各种研究将特定任务的先验信息集成到基于CNN的框架中,以设计损失函数和网络结构。具体地,Ma等人提出了一种α-matte边界散焦模型,以精确模拟散焦扩散效应,并为多聚焦图像融合网络的训练生成真实数据。为了解决聚焦/散焦边界周围的模糊水平估计的困难,Li等人引入了深度回归对学习,直接将整个图像转换为二进制掩码,而无需任何补丁操作。Zhao等人提出了一种通过考虑深度线索的深度蒸馏多聚焦图像融合方法。他们还专注于特征的多样性,以提高融合性能。此外,Han 等人设计了一个用于多曝光图像融合的深度感知增强网络,其中包含两个单独的模块,分别用于收集内容细节和校正颜色失真。对于可见光和红外图像融合,Long等人在CNN的基础上设计了一个聚合的残差密集网络,结合了ResNet和DenseNet的结构优势。此外,SeAFusion首次将语义约束纳入图像融合建模中,并提出了梯度残差密集块,以提高对细粒度细节的描述能力。
AE-based Image Fusion Framework: 同时,研究人员也探索了基于自动编码器的图像融合框架。具体地说,采用在大规模数据集上预训练的自动编码器作为特征提取器和图像重建器,然后针对深度特征设计专门的融合策略以实现图像融合。DeepFuse是这种融合框架的先驱。之后,Li等人引入了密集连接和嵌套连接以增强编码器的特征提取能力。此外,Jian等人将注意力机制注入到基于AE的融合框架中,以加强编码器提取的显著特征。为了提取具有更大可解释性的特征,Xu等人将解纠缠表示定制为基于AE的融合框架。然而,所有上述方法采用手工制作的融合策略,例如,元素加法、元素加权求和和元素最大值,以合并深度特征,这阻碍融合模型实现其最佳性能。为此,Xu等人基于像素分类显著性和可解释重要性评估设计了一个可学习的融合规则。
GAN-based Image Fusion Framework: 生成式对抗网络(GAN)可以在没有监督信息的情况下有效地对数据分布进行建模,这与图像融合任务不谋而合。Ma等人将图像融合问题定义为生成器和鉴别器之间的博弈。然后,他们将GAN应用于一系列融合任务,例如红外和可见光图像融合,多曝光图像融合,多聚焦图像融合和泛锐化。然而,单个鉴别器未能考虑多个域的数据分布。因此,Xu等人提出了双鉴别器条件生成对抗网络(DDcGAN),它利用两个鉴别器来约束融合结果的分布。随后,Hung等人设计了用于医学图像融合的多生成器多鉴别器条件生成对抗网络(MGMDcGAN)。此外,Li等人将多尺度注意力机制注入到基于GAN的融合框架中,以鼓励生成器和鉴别器更多地关注有意义的区域。


 369


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


