智谱 GLM-5 实测

GLM-4.5 vs GLM-4.7 vs GLM-5 全方位技术演进对比 智谱AI在7个月内快速迭代三代大模型(GLM-4.5至GLM-5),技术路线从统一推理/编码/Agent能力(ARC)演进到全面Agentic Engineering。架构上从GQA发展为MLA+DSA混合注意力,MoE专家数从160增至256,层数从92减至80,总参数量翻倍至744B。训练数据量从23T扩展到28.5T tokens,创新引入中期训练阶段,后训练策略从专家迭代升级为三阶段顺序强化学习。这一系列技术突破使GLM-5实现了从写代码到写工程的系统级能力跃迁。 阅读详情

智谱AI在春节前夕正式发布了新一代旗舰模型GLM-5。官方定位为面向”复杂系统工程与长程智能体任务”的开源模型,在编程与Agent能力上实现了开源模型SOTA。我们对GLM-5与GLM-4.7两个版本进行了全面的对比评测,测试其在准确率、响应时间、token消耗和成本等关键指标上的表现差异。

需要特别说明的是,GLM-5官方主打的是编程与Agent能力,而此次评测侧重于中文综合能力场景。模型在不同评测维度上可能呈现不同的特点,建议读者结合自身使用场景综合判断。

GLM-5版本表现:

- 测试题数:约1.5万
- 总分(准确率):71.0%
- 平均耗时(每次调用):130s
- 平均token(每次调用消耗的token):3569
- 平均花费(每千次调用的人民币花费):61.2

1、新旧版本对比

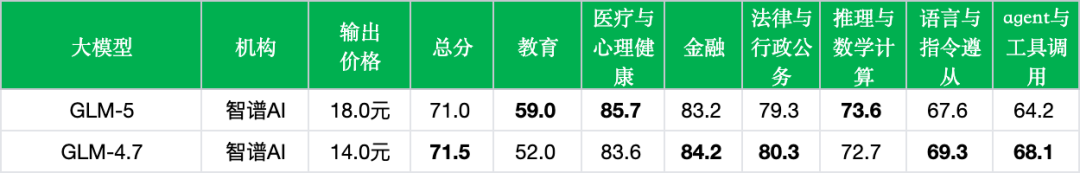
首先对比上个版本(GLM-4.7),数据如下:
*数据来源:非线智能ReLE评测https://github.com/jeinlee1991/chinese-llm-benchmark

*输出价格单位: 元/百万token

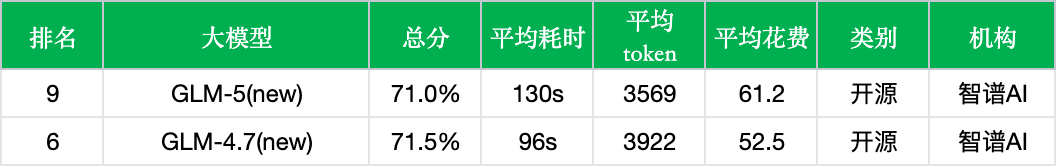
- 整体准确率略有下降:新版本准确率从71.5%降至71.0%,下降了0.5个百分点,排名从第6位下滑至第9位。考虑到GLM-5的核心定位是编程与Agent任务,这一变化在预期范围内。
- 部分领域显著提升:从细分来看,新版本在”教育”领域表现亮眼,从52.0%大幅提升至59.0%,增幅达7.0个百分点。“医疗与心理健康”领域也有明显提升,从83.6%增至85.7%(+2.1%),表明模型在知识密集型任务上有所强化。
- 数学推理能力小幅提升:“推理与数学计算能力”从72.7%提升至73.6%(+0.9%),与官方强调的推理能力提升方向一致。
- 部分能力出现分化:值得注意的是,“agent与工具调用”能力从68.1%降至64.2%(-3.9%),“语言与指令遵从”从69.3%降至67.6%(-1.7%),“金融”从84.2%降至83.2%(-1.0%)。这与官方宣称的Agent能力提升形成对比。
- 响应时间明显增加:每次调用的平均耗时从96s大幅增加至130s,增幅约35%,这与模型参数规模从355B扩展至744B有直接关系。
- Token消耗有所优化:尽管响应时间增加,每次调用平均消耗的token从3922降至3569,减少约9%。
- 调用成本上升:由于输出价格从14.0元/M token上调至18.0元/M token,每千次调用的费用从52.5元增加至61.2元,增幅约16.6%。

2、对比其他模型

在当前主流大模型竞争格局中,GLM-5表现如何?我们选择了具有代表性的模型进行横向对比分析(本评测侧重中文场景,模型在其他语言和专业领域的表现可能有所不同):
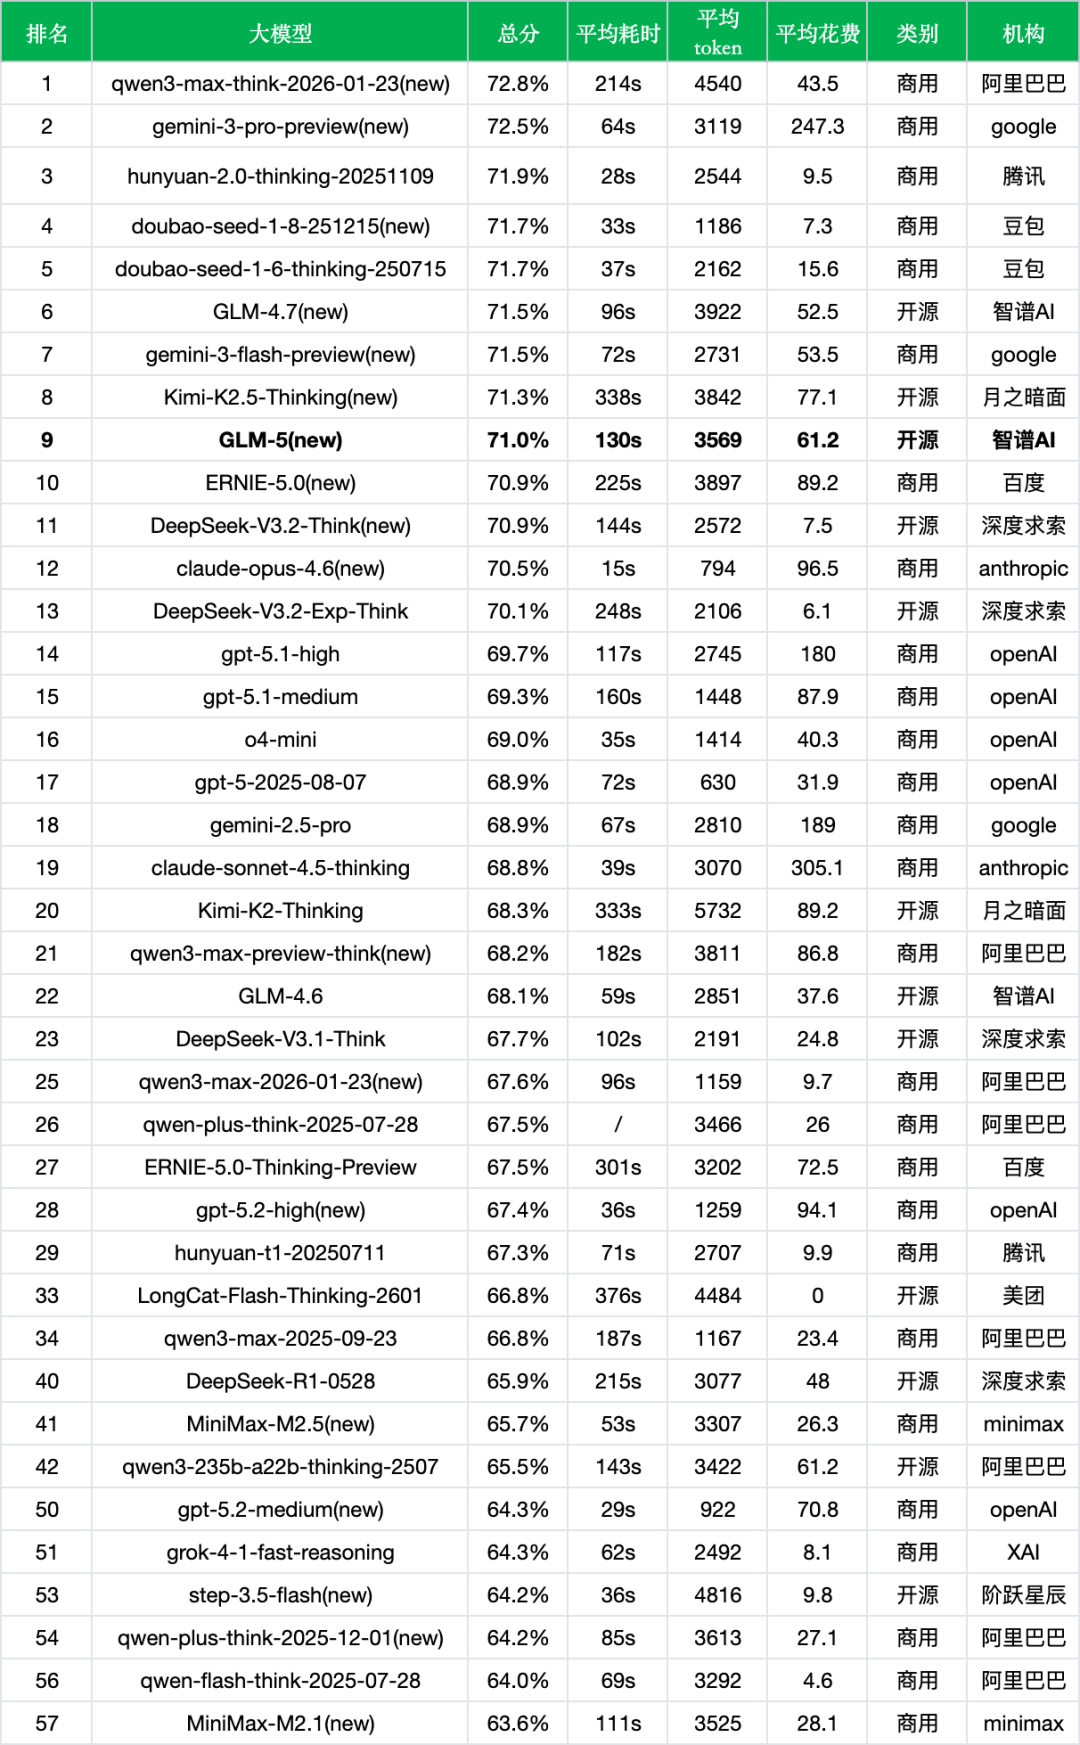
*数据来源:非线智能ReLE评测https://github.com/jeinlee1991/chinese-llm-benchmark

同成本档位对比

- 高成本档位竞争激烈:GLM-5以61.2元/千次的成本在榜单中处于较高水平,与qwen3-235b-a22b-thinking-2507(61.2元,65.5%)成本相同但准确率更高。在相近成本区间,gpt-5.2-high(94.1元,67.4%)和claude-opus-4.6(96.5元,70.5%)成本更高但准确率接近或略低。
- 中低成本档位选择丰富:准确率相近的doubao-seed-1-8-251215(71.7%)成本仅7.3元/千次,doubao-seed-1-6-thinking-250715(71.7%)成本为15.6元/千次,在成本敏感场景下更具竞争力。
- 智谱产品线内部对比:GLM-4.7以52.5元/千次的成本实现了71.5%的准确率,在当前评测维度下成本效率比优于GLM-5,用户可根据具体场景选择。

新旧模型迭代对比

- 与其他厂商新模型对比:近期各厂商发布的新模型中,qwen3-max-think-2026-01-23以72.8%位居榜首,gemini-3-pro-preview以72.5%紧随其后,hunyuan-2.0-thinking-20251109达到71.9%。GLM-5的71.0%在新模型中处于前列。
- 行业迭代趋势:从榜单可以看出,国产大模型正加速向编程与Agent能力方向演进。豆包、混元、Kimi等厂商纷纷推出thinking系列模型,GLM-5主打的”Agentic Engineering”定位正是这一趋势的体现。本次评测侧重中文场景,未能充分展现GLM-5在编程与Agent场景的优势。

开源VS闭源对比

- 开源模型竞争格局:GLM-5作为开源模型,其71.0%的准确率在开源阵营中处于前列。同为开源的Kimi-K2.5-Thinking(71.3%)、DeepSeek-V3.2-Think(70.9%)等模型各有特色。
- 闭源模型成本分化明显:闭源模型呈现两极分化态势。一方面,doubao-seed-1-6-thinking-250715(71.7%)以7.3元/千次的超低成本展现极致成本效率比;另一方面,gpt-5.1-high(69.7%)、claude-opus-4.6(70.5%)等海外模型成本高达80-180元/千次。
- 开源部署优势:GLM-5遵循MIT License开源,支持本地部署,已适配vLLM、SGLang等主流推理框架。对于高频调用或数据安全敏感的企业用户,本地部署可显著降低长期成本。

3、官方评测

根据智谱官方发布的技术博客(https://z.ai/blog/glm-5)和GitHub仓库信息(https://github.com/zai-org/GLM-5),GLM-5在多项基准测试中取得了亮眼成绩。

模型架构升级

GLM-5相比GLM-4.5实现了显著的架构升级:参数规模从355B(激活32B)扩展至744B(激活40B),预训练数据从23T提升至28.5T tokens。模型采用MoE(混合专家)架构,并首次集成DeepSeek Sparse Attention(DSA),在维持长文本效果的同时大幅降低部署成本。

编程能力评测
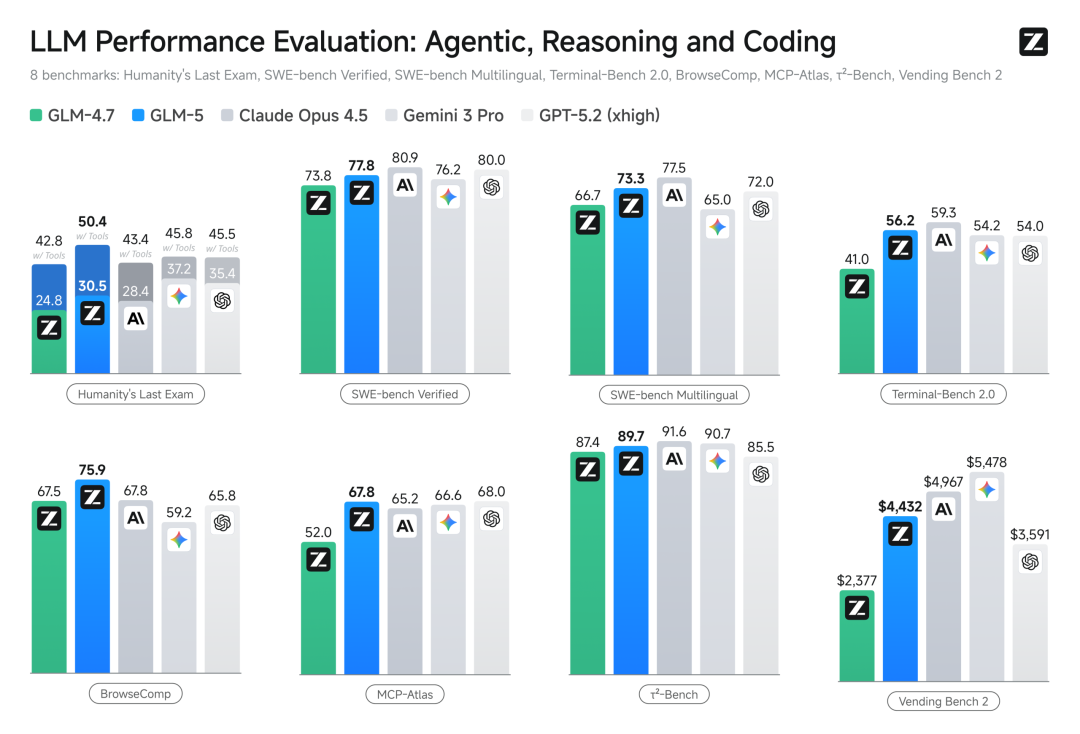
GLM-5 在编程领域实现了与 Claude Opus 4.5 的实力对齐,在多项业内公认的主流基准测试中拿下开源 SOTA。具体来看,它在 SWE-bench-Verified 和 Terminal Bench 2.0 中分别取得了 77.8 和 56.2 的高分,性能表现超越了 Gemini 3 Pro。
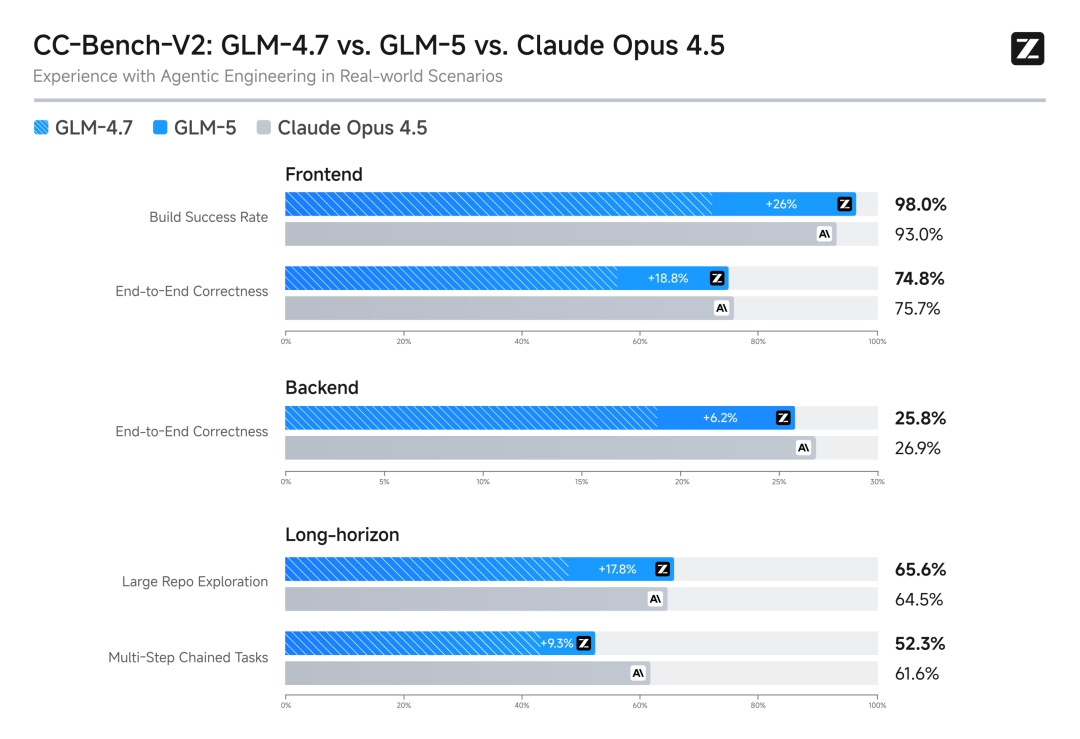
在内部的 Claude Code 评估集中,GLM-5 在前端、后端开发及长线任务上的表现远超 GLM-4.7(平均提升超 20%)。它能以极低的人工干预,自主完成 Agentic 长程规划、后端重构及深度调试等系统工程任务,使用手感与 Opus 4.5 极为接近。

Agent能力评测
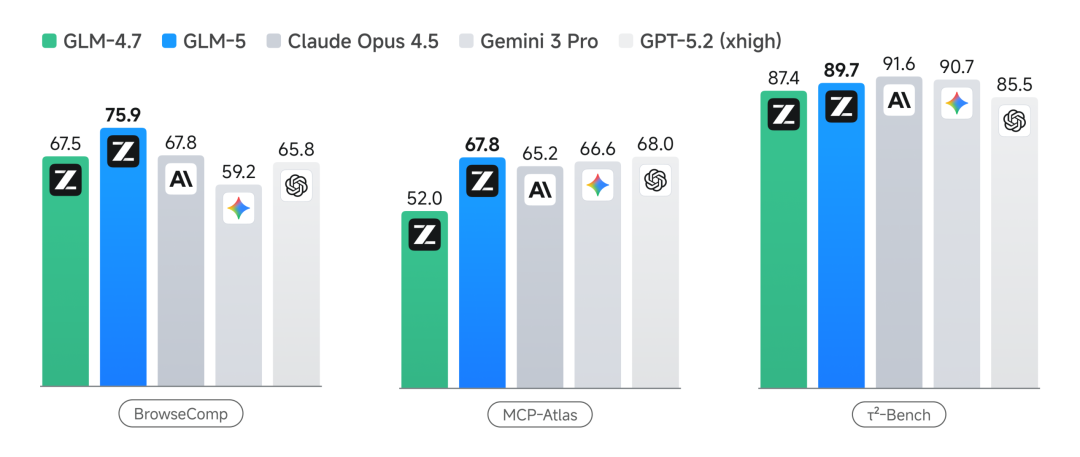
GLM-5 在智能体(Agent)领域同样摘得开源 SOTA 桂冠,在多个评测基准中位列第一:包括联网检索与信息理解(BrowseComp)、工具调用和多步执行(MCP-Atlas)以及复杂多工具场景下的规划执行(τ²-Bench)。
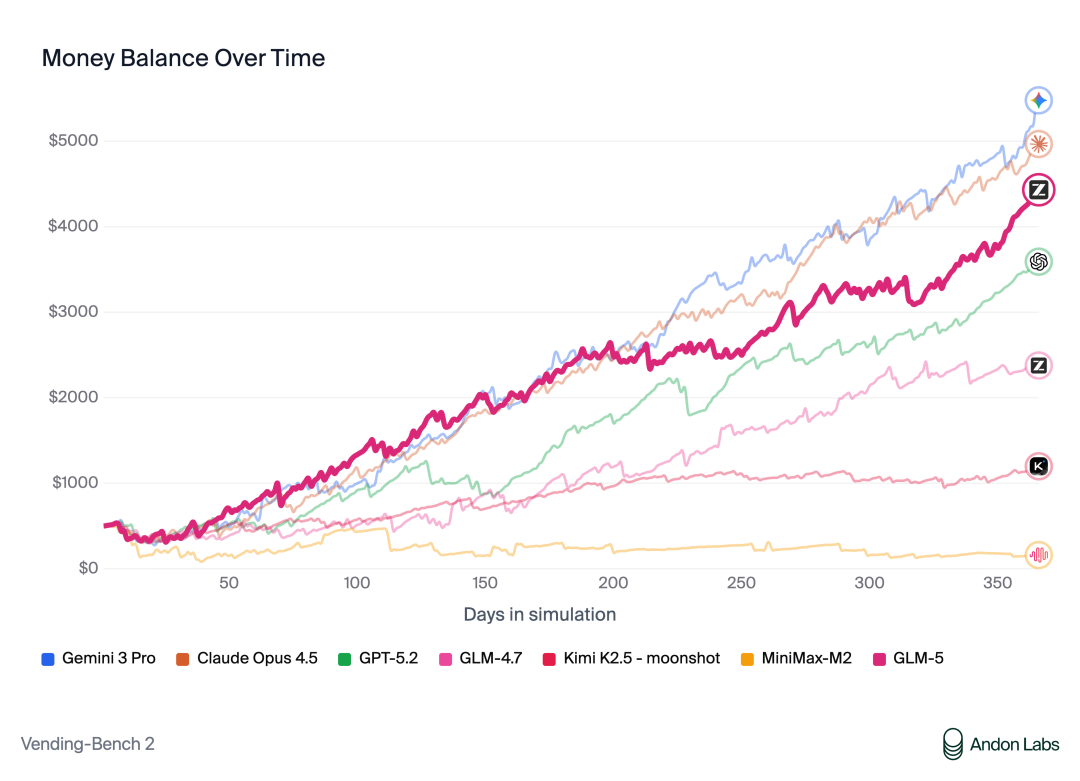
在考察模型经营能力的 Vending Bench 2 测试中,GLM-5 斩获开源模型第一。该测试要求模型模拟经营一年的自动售货机业务,GLM-5 最终账户余额达到 4432 美元,展现出逼近 Claude Opus 4.5 的长期规划与资源调度能力。

目前所有大模型评测文章在公众号:大模型评测及优化NoneLinear

GLM-5本地部署实战:24GB显存跑通20万上下文保姆级指南 大语言模型本地部署是AI工程落地的关键环节,其核心在于平衡显存占用、推理延迟与上下文长度三大约束。GLM-5作为新一代MoE架构模型,凭借动态稀疏激活与20万上下文支持,在代码生成、工具调用等场景展现强大能力;但真实部署需直面CUDA版本兼容性、量化方案选型(如UD-IQ2_XXS)、Flash Attention启用时机等硬核细节。尤其在单卡RTX 4090(24GB)环境下,显存利用率达99.6%成为常态,必须通过n-gpu-layers分层卸载、PagedAttention内存管理、hy-smi进程级 阅读详情

相关推荐

智谱GLM-5.3-Flash实测:国产芯片上的AI编程新体验

随着大模型能力的持续突破,AI编程助手正成为开发者日常工作中不可或缺的伙伴。基于Transformer架构的代码生成模型,通过理解自然语言指令和上下文,能够自动生成、补全和重构代码。这类工具的价值不仅在于提升编码效率,更在于降低复杂任务的门槛,例如在嵌入式开发中,利用国产芯片推理平台运行的大模型,甚至可以辅助生成STC单片机寄存器配置代码。在实际工程中,模型还展现出对Git Worktree多分支并行开发等复杂场景的理解与支持。智谱GLM-5.3-Flash作为一款轻量级高性能大模型,在国产算力平台上表现出

weixin_29061531的博客 378

Ollama本地运行大模型完整教程(亲测有效)

本文详细介绍如何使用Ollama框架在本地运行开源大语言模型。内容包括下载安装Ollama、运行Microsoft的phi-2模型、自定义模型配置,以及实现流式传输、思考能力、结构化输出、视觉任务和工具调用等高级功能。通过Ollama,开发者可以在本地轻松部署LLM,并与各种编排框架集成,便于构建LLM应用。

2401_85390073的博客 984

GLM-5-Turbo实测:超越GPT-5.4?智谱API接入与VSCode配置全攻略

大模型能力的评估不能只看榜单总分,更要关注分项指标与真实业务场景的匹配度。当前主流模型在中文理解、代码生成与逻辑推理等维度上各有侧重,而API接入的稳定性、成本与生态支持同样决定落地效果。本文从大模型评测原理出发,解析GLM-5-Turbo与GPT-5.4在第三方测试中的真实表现,并给出智谱API从注册、SDK调用到报错处理的完整工程实践路径。同时覆盖VSCode中通过Continue等插件接入国产大模型的配置方法,以及GLM与Kimi、AutoGLM在长文本处理、代码生成和浏览器智能体等场景下的选型建议。

weixin_29054195的博客 385

最新版 GLM-5 全栈实战全教程:从本地开源部署到 API 接入(多 Agent 架构 + 全栈编程 + 就业级项目实战)

本文完整覆盖了GLM-5从本地开源部署、工程化API封装、多Agent架构设计到全栈项目实战的全流程,所有代码与方案均经过生产环境验证,可直接复用与二次开发。通过本文的学习,开发者可掌握大模型落地的全栈技术能力,完成从入门到就业级项目开发的进阶。

学海无涯,笃行致远 5289

实测智谱 GLM 5.2 探索:真超长上下文与 Agent 能力的实践分享

输入简单指令后,它输出了可交互的代码,支持 WASD 移动、跳跃和方块放置。在 LiveBench Agent Coding 相关榜单上,它也进入了前列,显示出在 Agent 编程领域的潜力。AI 领域的发展日新月异,最近智谱 AI 发布了 GLM 5.2 并选择开源,这为开源社区带来了新的讨论话题。整体来看,在这些任务中,模型的规划和调试能力有明显进步。此外,还测试了其他交互式网页项目,如声音波形、捕获等模拟,展示了它生成完整前端应用的能力。

qq_34004131的博客 203

GLM-5开源大语言模型:从核心原理到本地部署与微调实战

大语言模型作为自然语言处理领域的核心技术,通过海量文本数据预训练,掌握了语言的深层规律与知识表示。其核心原理基于Transformer架构,通过自注意力机制捕捉长距离依赖关系,实现上下文理解与文本生成。这一技术价值在于将通用语言能力封装为可调用的基础组件,极大降低了AI应用开发门槛。在实际应用场景中,开发者可基于开源模型进行私有化部署,保障数据安全与定制化需求。本文聚焦GLM-5这一最新开源大语言模型,详细解析其技术架构,并提供从环境搭建、模型推理到参数高效微调的完整工程实践指南,特别针对LoRA微调与生产

weixin_27188815的博客 384

智谱 GLM-5-Turbo 实测

官方发布的ZClawBench基准显示,GLM-5-Turbo在龙虾场景中的表现相比GLM-5有显著提升,在多项关键任务上整体领先于多家主流模型。:在近期发布的新模型中,GLM-5-Turbo(71.5%)的准确率与Doubao-Seed-2.0-mini(71.8%)、doubao-seed-1-8-251215(71.7%)基本持平,但低于Doubao-Seed-2.0-pro(76.5%)、gemini-3.1-pro-preview(74.8%)、qwen3.5-plus(74.6%)等模型。

easyllm的博客 1455

基于立创·天猛星MSPM0G3507的简易PID电机控制入门项目实战

本文详细介绍了基于立创·天猛星MSPM0G3507开发板的简易PID电机控制入门项目实战。从硬件选型、电路设计、PCB布局,到软件编程中的编码器读取、PID算法实现与调参,手把手教你完成一个带屏幕显示的电机定速与定距控制项目,是学习嵌入式开发和经典PID控制算法的绝佳实践。

weixin_42596011的博客 502

智谱GLM-4.5-Air量化大模型,本地部署,实测

大家好,我是 Ai 学习的老章之前对智谱 AI 的关注比较少,最近发布的的 GLM4.6 非常能打GLM-4.6 在编程能力、长文本处理、逻辑推理、信息检索、内容创作及智能体应用等六大核心领域实现全面升级。在公开测试基准中,该模型的代码生成能力已达到国际领先水平,与 Claude Sonnet 4 模型持平,是国内目前表现最优的编程专用模型。GLM-4.6 在在综合性能评估中位列全球第四,与阿里巴巴旗下 Qwen3-Max-Preview 模型并列中国区榜首,同时摘得全球开源模型桂冠。

2196

【R语言-生存分析之观察生存率计算】

全人群肿瘤登记资料常用的统计分析指标包括发病率、死亡率、现患率以及生存率等,其中肿瘤生存率是评估肿瘤治疗效果和肿瘤负担的必要指标,其计算涉及肿瘤患者的发病、 死亡和随访三个方面的资料, 数据整理和计算过程均较为复杂, 如何及时、 准确地计算肿瘤生存率, 并使其可以在不同地区、 不同人群、不同时期间被客观公正地比较和评价,仍然是统计学家们一直在研究的主题。

weixin_46579654的博客 5432

C#:WPF格式转Winform格式

WPF格式转Winform格式

Hello C++ 1291

智谱GLM-5.1实测

官方将其定位为"面向长程任务的开源第一模型",核心升级方向集中在代码工程能力和长程Agent任务上——GLM-5.1能够在单次任务中独立、持续工作超过8小时,在SWE-Bench Pro等代码基准上取得了全球模型第三、开源模型第一的成绩。官方选取了业内最具代表性的三个代码评测基准进行综合评估,GLM-5.1取得全球模型第三、国产模型第一、开源模型第一的成绩。GLM-5.1此次迭代的核心升级集中在代码工程能力和长程Agent任务两个方向,以下为官方公布的Benchmark数据。

easyllm的博客 1954

微信小程序中蓝牙打印机中文编码处理:使用iconv-lite库

本文介绍了微信小程序集成蓝牙打印机时中文乱码问题的解决方案。由于打印机通常仅支持GBK/GB2312编码,而小程序使用UTF-8,导致中文显示异常。通过引入轻量级iconv-lite库进行编码转换,可高效解决该问题。文章详细说明了从库安装、编码转换到蓝牙发送的实现步骤,并提供了完整代码示例。关键注意事项包括编码验证、分段发送和兼容性测试。该方法经实际验证,能有效保障中文打印的准确性,适用于零售、物流等场景。

canglingyue的专栏 1303

GLM-5.2 实测:智谱这次,确实有点东西 适配

智谱 GLM-5.2 已接入 OpenStarry,1M 真长上下文,3 步切过去。实测跨文件重构、单元测试生成,单次仅 4 厘。附完整配置教程。

scarry2026的博客 601

从ViT到Swin Transformer:一文搞懂Transformer在CV中的进化史(附实战代码)

本文系统梳理了Transformer在计算机视觉领域的演进历程,从开创性的Vision Transformer(ViT)引入全局注意力机制,到DETR实现端到端目标检测,再到里程碑式的Swin Transformer通过滑动窗口和层次化设计高效桥接CNN与ViT。文章深入剖析了各模型的核心思想、技术突破与实战应用,并提供了可运行的代码示例,帮助读者从理论到实践全面掌握这一关键技术脉络。

cola5的博客 711

分级 API Key 的使用案例

分级 API Key 的使用案例 1. 背景介绍 1.1 问题由来 随着网络服务的普及,API(Application Programming Interface,应用程序编程接口)成为了连接不同系统和应用的关键桥梁。API Key(API密钥)

欢迎来到我的CSDN空间!这里聚焦AI大模型应用实战,分享前沿技术、实战案例与开发经验。 985

智谱GLM-5.2实测,一部黑洞诞生动画之后,我认真考虑换掉Claude了

前几天Fable 5发布的时候,黑洞模拟是全网做得最多的AI Coding测试。引力透镜、旋转的吸积盘、幽暗的事件视界,全部在单个HTML文件里用Three.js实现。但我不想做一个静态的黑洞。我想搞个更有野心的,让GLM-5.2把黑洞的「诞生过程」做成一部电影。从一颗红超巨星开始,经历引力坍缩,超新星爆发,最终形成黑洞。

2503_90848750的博客 316

AI系统架构原理与代码实战案例讲解

人工智能的概念可以追溯到上世纪50年代,图灵测试的提出标志着人工智能作为一门学科的诞生。早期的研究主要集中在符号推理、专家系统等领域,取得了一些突破,例如机器定理证明、西洋跳棋程序等。上世纪80年代,随着专家系统的兴起,人工智能进入了一个黄金时期。专家系统通过模拟人类专家的知识和经验进行推理和决策,在医疗诊断、故障诊断等领域取得了成功应用。进入90年代,由于计算能力的限制和数据量的不足,人工智能的发展陷入低谷。近年来,随着深度学习技术的突破、大数据的兴起以及计算能力的提升,人工智能迎来了第三次发展浪潮,在图

AI天才研究院 1786

智谱 GLM-5-Turbo 实测:在 OpenClaw 里配 TaoToken 跑通 Agent 任务

在 OpenClaw 里通过 TaoToken 接入 GLM-5-Turbo 跑通 Agent 任务,实测 ZClawBench 风格链路约 52 秒完成。本文给出 config.toml 与 settings.json 可复制配置,并附 401、模型名、超时等常见报错排查。访问 https://taotoken.net/?utm_source=taotoken_aicg_blog_end 获取统一 Key。

weixin_42587866的博客 13

CAN轴控制流【6041,6040】

【代码】CAN轴控制流【6041,6040】

cfqq1989的博客 1777

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

智谱GLM-5.3+ZCode Agent,真实项目第一手实测!

智谱推出ZCode智能体开发环境,与旗舰模型GLM-5.3深度协同,实现“原生模型+原生Agent”高效配合。实测显示,ZCode提升任务通过率2.39%,缓存命中率超98%,显著降本增效。零配置、多平台、支持SSH/Docker,真实项目重构验证其开箱即用与工程落地能力。

测试开发技术 445

IDEA的使用指南

IDEA基于java的使用手册,可以最快速的上手,在使用中不断的丰富自己的使用技巧.

智谱突发更新,GLM-5.1直接上线,实测 1 个小时从零搭了一个内容付费系统

但到了十几步左右,问题开始出现:数据库表结构在后端实际写的和前面设计阶段定义的对不上,字段名变了,类型也变了,需要我手动纠正。它先是按照我的猜测去检查问题去了,但是,它发现数据库设计的时候字段并没有限制,它就开始自查了,查了路由跳转的时候是不是截断了,发现也不是,最后它发现是文章付费解锁的逻辑导致的。当然了,当我深度体验之后,也并不是没有任何 Bug ,其中还是有一个 Bug 的,就是发布文章的时候,可以选择锁定和不锁定,我发现当我选择不锁定,发布了一个长文之后,点击文章详情页,文章只显示了一半。

非著名程序员 1372

STM32F407中文手册

STM32f407中文手册 本参考手册面向应用开发人员,提供有关使用 STM32F405xx/07xx、STM32F415xx/17xx、 STM32F42xxx 和 STM32F43xxx 微控制器存储器与外设的完整信息。STM32F405xx/07xx、STM32F415xx/17xx、STM32F42xxx 和 STM32F43xxx 构成一个微 控制器系列,各产品具有不同的存储器大小、封装和外设。有关订购信息以及器件的机械与电气特性,请参见数据手册。有关 ARM Cortex™-M4F 内核的信息,请参见《Cortex™-M4F 技术参考手册》。

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

41个榜单SOTA!智谱最新开源GLM-4.5V实测:看图猜地址、视频秒变代码

在RL阶段,引入全领域多模态课程强化学习,通过构建多领域奖励系统(Reward System),结合可验证奖励强化学习(RLVR)与基于人类反馈的强化学习(RLHF),GLM-4.5V在STEM问题、多模态定位、Agent任务等方面获得全面优化。开头我们介绍了GLM-4.5V基于智谱新发布的新一代旗舰文本基座模型GLM-4.5-Air,沿用GLM-4.1V-Thinking的结构。GLM-4.1V-Thinking是一个小参数模型,而全新的GLM-4.5V拥有106B总参数,12B的激活参数。

fengdu78的博客 339

智谱 GLM-5.1 开源实测:编程能力登顶 SWE-bench Pro

需求:当用户输入灵感选题时,全网搜索并调研抖音、小红书上相关讨论的热度、热门角度、常见观点、读者最关心的问题,以及同类内容是否已经同质化,结合热度、竞争情况、内容差异化空间和传播潜力,对该选题值不值得写给出明确判断(评分0-100)。要求支持新增、编辑、删除 API 配置,保存 Base URL、API Key、模型名、请求头等信息;但 GLM-5.1 的长文本记忆和目标感极其稳定,经过一个半小时的极限抗压,完美展现了它从多步任务规划到、复杂联网检索、逻辑综合、代码编写、本地文件I/O 的全链路能力。

weixin_49199926的博客 654

智谱 GLM-5 实测:开源模型编程与 Agent 能力全解析

用 vLLM 本地部署智谱 GLM-5 做编程与 Agent 实测,从 settings.json 到 auth.json 配置一次跑通。GLM-5 作为开源模型在代码修复与多步工具调用上表现稳定,长程任务断链明显减少。通过 TaoToken 统一接入可快速切换模型对比,官网 https://taotoken.net/?utm_source=taotoken_aicg_blog_end 提供完整配置与报错排查方案。

weixin_35752645的博客 16

智谱 GLM-5 深度实测:开源 Agent 的常识与安全,TaoToken 统一通道下能通关吗?

用 TaoToken 统一通道实测智谱 GLM-5 开源 Agent:先配好统一 Key 与 Base URL,再用 JSON/TOML 片段落地配置,构造洗车常识题与多层越狱安全题逐项验证,并排查 401、model not found 等常见报错。官网 https://taotoken.net/?utm_source=taotoken_aicg_blog_end

weixin_42168902的博客 203
上一篇: MiniMax M2.5实测
下一篇: 小米 MiMo-V2-Flash-think-0204实测
easyllm
博客等级 码龄2年 251粉丝 82原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值