


目录
2、后台线程kprobe_optimizer替换被探测指令处的BRK指令
(代码:linux 6.3.1,架构:arm64)
One look is worth a thousand words. —— Tess Flanders
相关链接:
【原创】Linux kprobe 实现原理 图文详解 (一) kprobe实现原理
【原创】Linux kprobe 实现原理 图文详解 (二) kretprobe实现原理
【原创】Linux kprobe 实现原理 图文详解 (四) 指令替换、cpu stopper
一、背景介绍
之前两篇文章中(kprobe实现原理、kretprobe实现原理),详细讲述了kprobe与kretprobe的实现原理。两者都有一个共同点:需要借助brk断点指令,触发 2次 同步异常,借助异常处理的流程,去执行注册的钩子函数。
但是,频繁地触发同步异常会给性能造成严重的影响(陷入、陷出时,寄存器保存恢复等操作,会造成较大的开销)。因此,linux内核社区在2009年12月,提出了kprobe jump optimization 方案。
该方案的思路是利用跳转指令,代替brk断点异常处理的方式,直接跳转到 kprobe注册 的 “钩子”处继续执行。该方案使得优化的kprobe会带来10倍的性能提升,以下是linux官方提供的一些测试结果:
在2005年常见的CPU上,处理命中kprobe要花费0.5~1.0微妙;命中kretprobe比命中kprobe多花费50%~75%的时间。

通常命中已优化的kprobe,花费0.07 ~ 0.1微妙来处理。

本文主要聚焦arm64架构下kprobe的跳转优化实现,对于x86这种cisc架构的实现原理也是一样的,仅一些细节会有些出入,对x86下实现感兴趣的小伙伴可以自行去研究下相关代码。
二、kprobe 跳转优化 实现原理
kprobe跳转优化方案的核心思想:摒弃brk断点指令触发异常带来的额外开销,使用相对跳转的方式,来代替异常处理流程中调用 kprobe钩子函数 的方式。大体流程如下:
1)在 “执行到被探测指令” 时,跳转到一块内核准备好的 “detour buffer指令槽代码” 执行;
2)在 “detour buffer指令槽代码” 中,直接执行 “kprobe注册的钩子函数”;
3)执行完 “kprobe注册的钩子函数” 后,接着执行 “被探测指令”;
4)最后,通过相对跳转,返回到 “被探测指令地址 + 4” 处,回到原本的执行流。
以上过程中,并没有涉及到同步异常,通过 “相对跳转” 的方式节省了很多brk带来的开销。好了,接下来就一起看下所谓的 “kprobe跳转优化” 的详细实现原理。
主要分成3个部分:跳转优化的指令槽准备阶段、后台线程kprobe_optimizer替换被探测指令处的BRK指令、优化后的kprobe探测点被执行到时的处理流程;
1、跳转优化的指令槽准备阶段
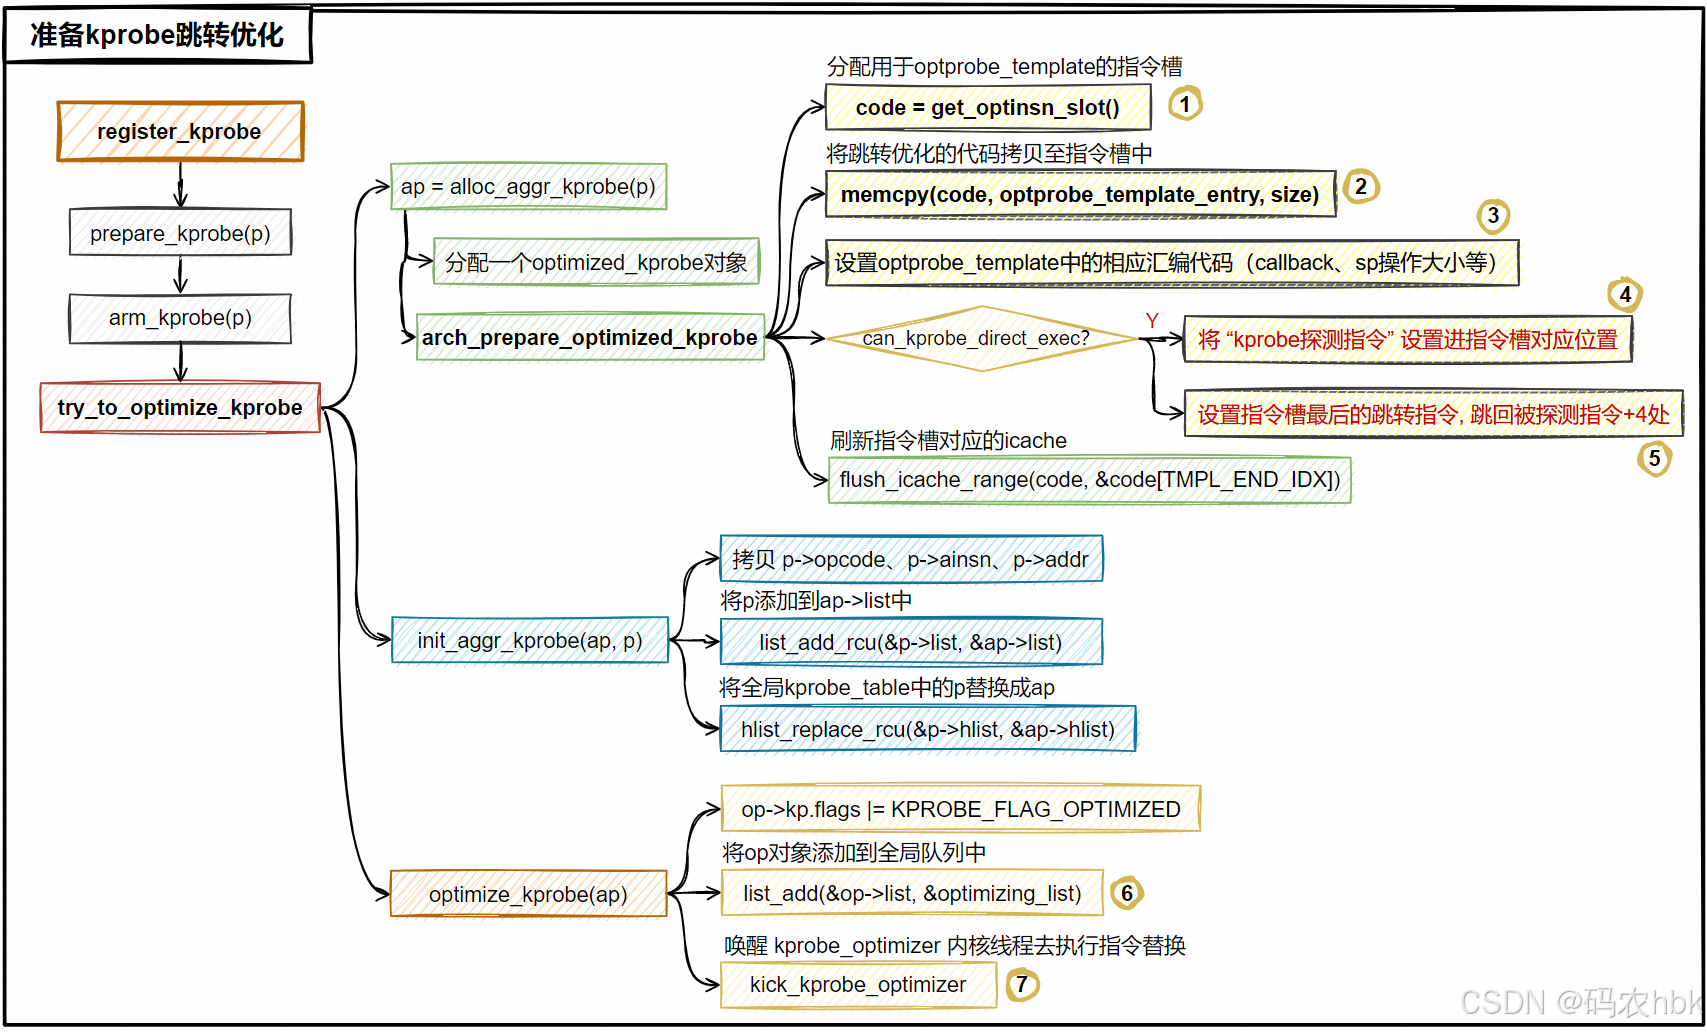
1)分配一块用于存放跳转优化指令的指令槽;
2)将跳转优化的代码拷贝至上面分配的指令槽;
3)调整拷贝到指令槽中的 “跳转优化指令optprobe_template” 的内容,如:将这块指令中“标签2”地址上的内容修改为 “optimized_callback函数”地址,用于optprobe_template汇编代码跳转到该处执行pre_handler等操作;
4)将 “kprobe探测指令” 内容,设置到指令槽中相应的位置(用于执行完kprobe钩子后,直接执行被探测指令);
5)将指令槽最后一条指令,设置为 bl相对跳转指令,用于跳转回 “被探测指令地址 + 4”处;
6)将这个要优化的kprobe任务,添加到全局optimizing_list队列中;
7) 唤醒内核线程kprobe_optimizer,去执行执行替换的工作;
可以看出,kprobe跳转优化分成2个步骤,第1个步骤是准备跳转优化的指令槽内容,而实际的指令替换工作是交由内核线程去负责完成的。
上述提到的 “跳转优化指令” 如下所示:
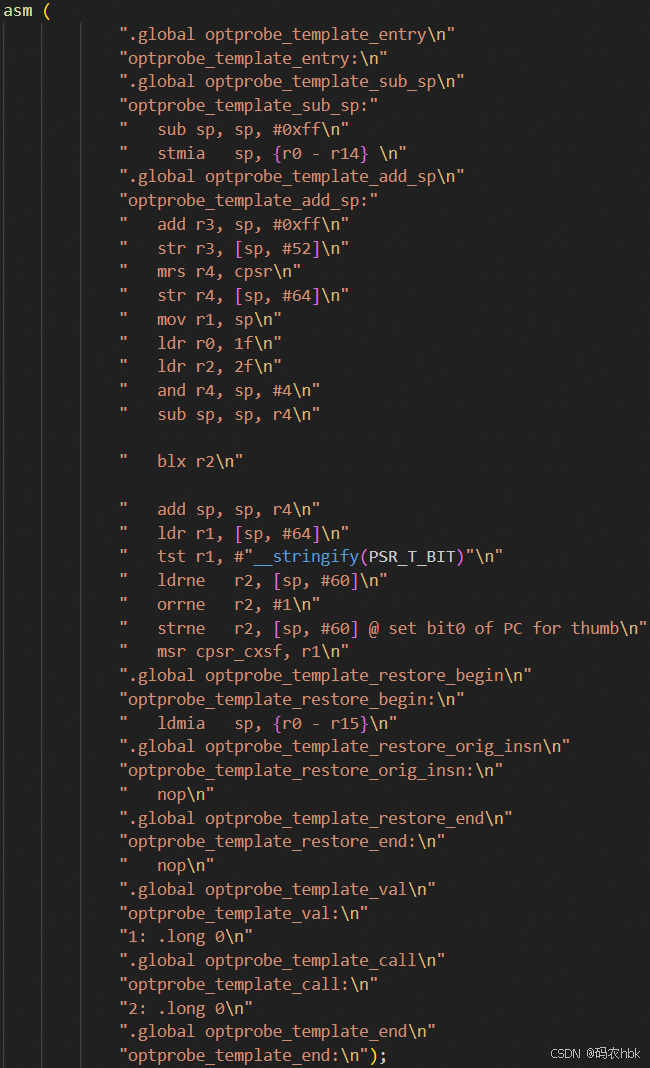
以上这块汇编代码的内容,会被拷贝到分配好的指令槽中,然后由arch_prepare_optimized_kprobe函数负责对这块汇编代码的内容进行一些调整。
2、后台线程kprobe_optimizer替换被探测指令处的BRK指令
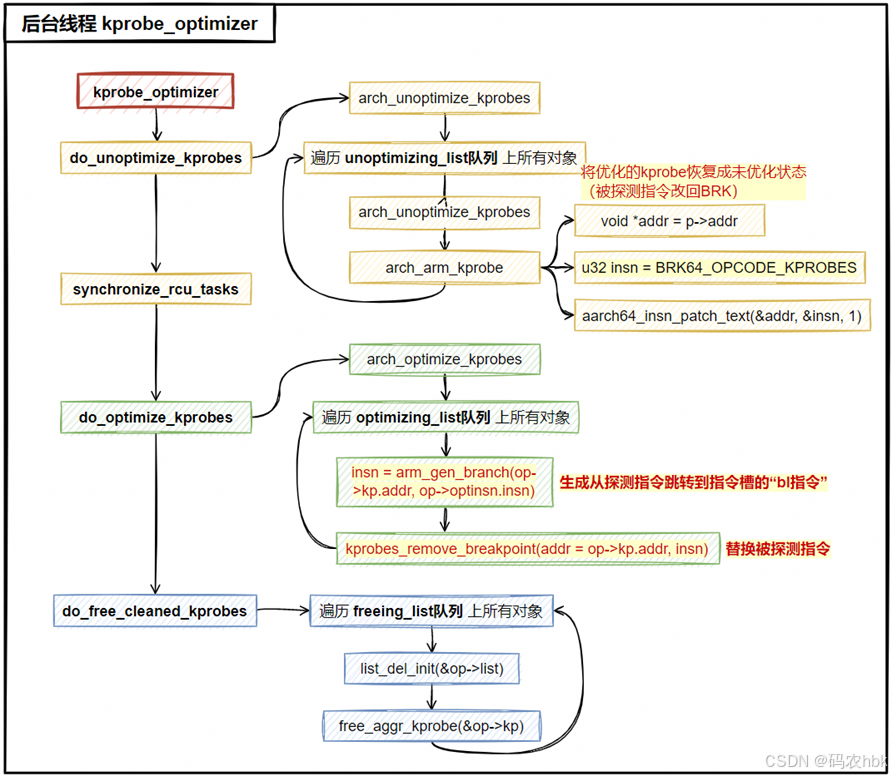
内核线程kprobe_optimizer,被唤醒后,会遍历并执行 3个 全局队列(unoptimizing_list、optimizing_list、freeing_list)中的任务。第1步中放入optimizing_list队列的任务,被取出后,会生成 1条 “bl相对跳转指令”,用于从被探测指令地址跳转到第1步准备好的指令槽处。
这条相对跳转指令,会被设置到被探测指令处,替换上面的brk指令;这样一来,当执行到kprobe被探测指令时,程序就会跳转到上述准备好的指令槽中,继续执行了。
3、优化后的kprobe探测点被执行到时的处理流程
假设kprobe探测的代码段如下:

执行到优化过的kprobe探测指令后,处理逻辑如下:
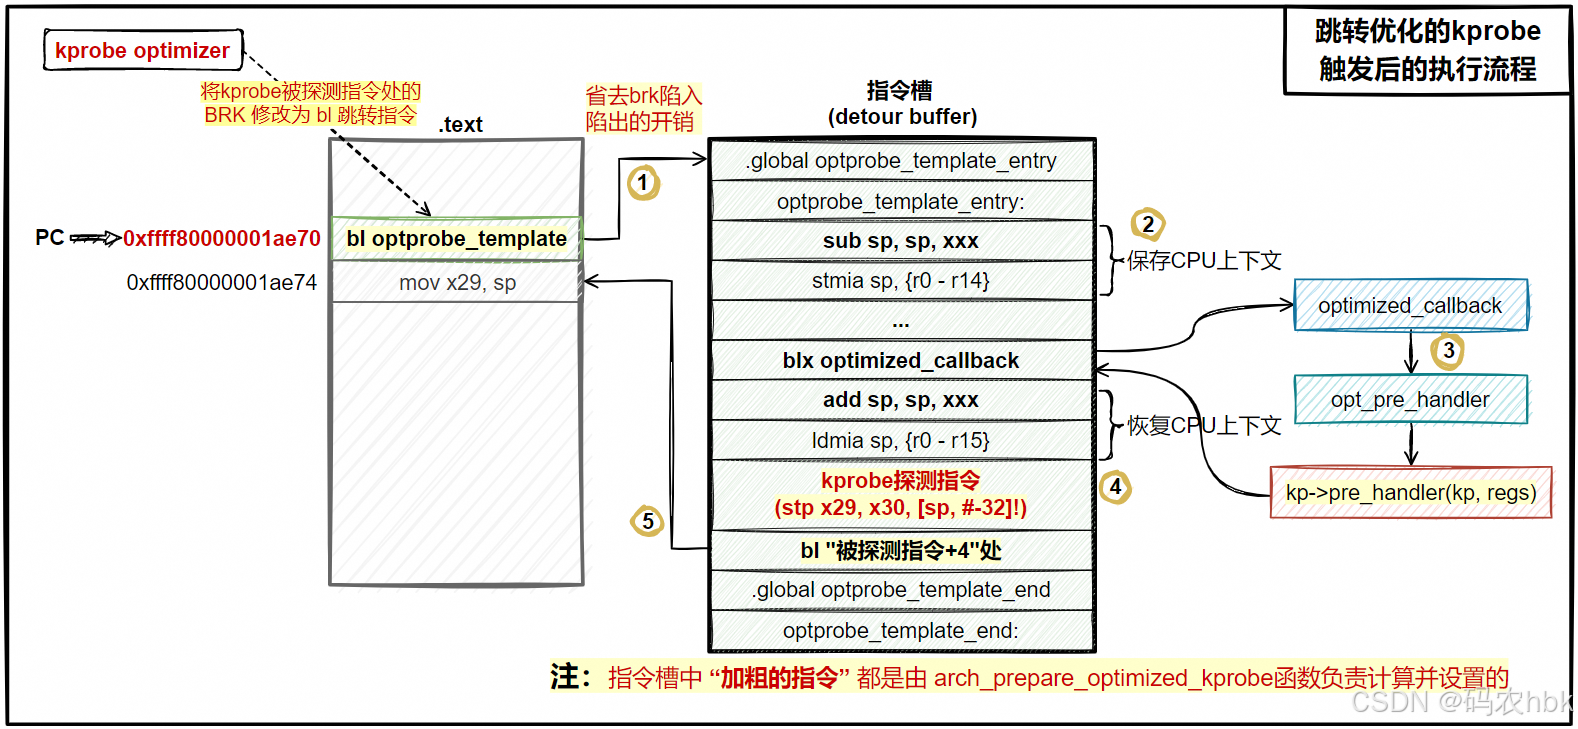
1)当程序执行到“跳转优化过的kprobe被探测指令”时, 会执行相对跳转指令, 跳转到预先设置好的指令槽处, 执行optprobe_template汇编代码
2)optprobe_template首先会将CPU上下文保存到内核栈上, 然后通过blx指令, 跳转到提前设置好的optimized_callback函数继续运行
3)optimized_callback函数中会设置当前CPU的kprobe状态, 然后执行原始kprobe的pre_handler函数, 执行完后ret返回到optprobe_template汇编代码中
4)在optprobe_template中, 将一开始进入时的CPU上下文从内核栈中恢复出来, 然后执行真正的被探测指令
5)当被探测指令执行完毕后, 跳转回 “被探测指令+4” 处继续运行原本的代码路径
三、kprobe跳转优化的一些限制
1)只支持优化不含post_handler的kprobe;
2)对于开启内核抢占(CONFIG_PREEMPT=n)的内核,不支持kprobe优化;
3)对于ARM架构,“被探测指令”与“detour buffer指令槽”之间的距离不能超过32MiB(因为ARM相对跳转指令允许的范围就是32MiB);
四、具体代码
1、注册kprobe时, 准备跳转优化的汇编代码
/* For optimized_kprobe buffer */
struct kprobe_insn_cache kprobe_optinsn_slots = {
	.mutex = __MUTEX_INITIALIZER(kprobe_optinsn_slots.mutex),
	.alloc = alloc_optinsn_page,
	.free  = free_optinsn_page,
	.sym   = KPROBE_OPTINSN_PAGE_SYM,
	.pages = LIST_HEAD_INIT(kprobe_optinsn_slots.pages),
	/* .insn_size is initialized later
	 * .insn_size = MAX_OPTINSN_SIZE	// MAX_OPTINSN_SIZE: (optprobe_template_end - optprobe_template_entry)
	 */
	.nr_garbage = 0,
};

struct arch_optimized_insn {
	/* copy of the original instructions.  Different from x86, ARM kprobe_opcode_t is u32. */
#define MAX_COPIED_INSN	DIV_ROUND_UP(RELATIVEJUMP_SIZE, sizeof(kprobe_opcode_t))
	kprobe_opcode_t copied_insn[MAX_COPIED_INSN]

	/* detour code buffer */
	kprobe_opcode_t *insn
	/*
	 * We always copy one instruction on ARM, so size will always be 4, and unlike x86, there is no need for a size field.
	 * 即: x86的arch_optimized_insn结构体中会多一个size字段
	 */
}

/*
 * Internal structure for direct jump optimized probe
 */
struct optimized_kprobe {
	struct kprobe kp					/*  */
	struct list_head list				/* list for optimizing queue */
	struct arch_optimized_insn optinsn	/* 用于跳转优化的汇编指令块 */
};

/* 全局待跳转优化kprobe队列 */
static LIST_HEAD(optimizing_list);


register_kprobe(struct kprobe *p) {
	...
	prepare_kprobe(p)
	...
	if (!kprobes_all_disarmed && !kprobe_disabled(p)) {
		arm_kprobe(struct kprobe *kp = p) {
			cpus_read_lock()
			mutex_lock(&text_mutex)

			__arm_kprobe(struct kprobe *p = kp) {
				/* Find the overlapping optimized kprobes. */
				struct kprobe *_p = get_optimized_kprobe(p->addr)
				if (unlikely(_p))
					/* Fallback to unoptimized kprobe */
					unoptimize_kprobe(_p, true)

				arch_arm_kprobe(p)

				### Optimize kprobe jump
				optimize_kprobe(p)	/* Try to optimize (add kprobe to a list) */
			}

			mutex_unlock(&text_mutex)
			cpus_read_unlock()
		}
	}

	/*【try_to_optimize_kprobe 函数功能】
	 * 新分配一个aggr_kprobe用于跳转优化本次注册的kprobe, 分配指令槽并设置好optprobe_tmplate跳转优化汇编代码, 然后将aggr_kprobe->optimized_kprobe对象
	 * 添加到全局optimizing_list队列并唤醒optimizing_work去执行跳转优化
	 *
	 *【try_to_optimize_kprobe 实现逻辑】
	 * 1) 新分配一个aggr_kprobe
	 * 2) 继承kprobe探测指令地址
	 * 3) 分配用于跳转优化的指令槽, 将optprobe_template代码拷贝置该指令槽, 并设置这块跳转优化的汇编代码
	 * 4) 根据新分配aggr_kprobe对象, 找到optimized_kprobe对象
	 * 5) 检查用于jump optimization的detour buffer是否已经分配并设置好
	 * 6) 初始化新分配的aggr_kprobe, 将原本的kprobe对象内容拷贝至新分配的aggr_kprobe中
	 * 7) 判断本个kprobe是否可以进行跳转优化, 若可以的话, 将optimized_kprobe对象添加到全局optimizing_list队列并唤醒optimizing_work去执行跳转优化
	 *
	 */
	try_to_optimize_kprobe(struct kprobe *p = p) {
		struct kprobe *ap;
		struct optimized_kprobe *op

		/* Impossible to optimize ftrace-based kprobe. */
		is_ftrace_kprobe = kprobe_ftrace(p) {
			return p->flags & KPROBE_FLAG_FTRACE
		}
		if (is_ftrace_kprobe)
			return

		/* For preparing optimization, jump_label_text_reserved() is called. */
		cpus_read_lock()
		jump_label_lock()
		mutex_lock(&text_mutex)

		/* 1) 新分配一个aggr_kprobe */
		ap = alloc_aggr_kprobe(p) {
			struct optimized_kprobe *op
			op = kzalloc(sizeof(struct optimized_kprobe), GFP_KERNEL)

			INIT_LIST_HEAD(&op->list)

			/* 2) 继承kprobe探测指令地址 */
			op->kp.addr = p->addr

			/* 3) 分配用于跳转优化的指令槽, 将optprobe_template代码拷贝置该指令槽, 并设置这块跳转优化的汇编代码 */
			__prepare_optimized_kprobe(op, p) {
				if (!kprobe_ftrace(p)) {
					/*【arch_prepare_optimized_kprobe函数功能】
					 * 分配用于跳转优化的指令槽, 将optprobe_template代码拷贝置该指令槽, 并设置这块跳转优化的汇编代码;
					 * 这块跳转优化的代码会先执行pre_handler, 然后执行被探测指令, 最后跳转回被探测指令+4处
					 *
					 *【arch_prepare_optimized_kprobe 实现逻辑】
					 * 1) 分配用于跳转优化的“optprobe_template汇编代码”的指令槽空间
					 *   (指令槽大小: kprobe_optinsn_slots.insn_size = MAX_OPTINSN_SIZE = optprobe_template_end - optprobe_template_entry)
					 * 2) 检查kpeobe探测指令处, 与optprobe_template code之间的距离是否超过32MiB(因为ARM相对跳转允许的范围就是32MiB)
					 * 3) 将用于跳转优化的汇编代码(即: optprobe_template)拷贝到新分配的这块指令槽中
					 * 4) 修改optprobe_template汇编代码中的sub sp指令内容, 用于预留保存CPU上下文(即: struct pt_regs)的栈内存
					 * 5) 修改optprobe_template汇编代码中的add r3, sp指令内容, 用于计数sub sp指令执行前原始的栈指针位置并记录到r3中
					 * 6) 将optimized_kprobe对象指针设置到“optprobe_template汇编代码的标签1处”, 后续作为optimized_callback的入参
					 * 7) 将optimized_callback函数地址, 设置到“optprobe_template汇编代码的标签2处”, 用于optprobe_template汇编代码跳转到该处执行pre_handler等操作
					 * 8) 判断被探测指令是否可以直接在optprobe_template中直接执行
					 *   (判断条件: 被探测指令是否使用了PC寄存器, 若未使用则可以直接执行被探测指令, 不需要任何模拟执行)
					 * 9) 若可以直接执行被探测指令, 则手动计算一条跳转(branch)指令, 用于从 “optprobe_template_restore_end标签处” 跳转到 “被探测指令+4位置处”
					 * 10) 对于可以直接执行被探测指令的场景, 修改optprobe_template_restore_begin标签处用于“恢复CPU上下文”的指令, 修改为不恢复PC
					 * 11) 将被探测指令(orig->opcode)写入optprobe_template_restore_orig_insn标签处, 用于在optprobe_template中直接执行被探测指令
					 * 12) 将用于跳转回“被探测指令+4处”的指令, 写到optprobe_template_restore_end标签处, 用于返回到原本的程序执行流
					 * 13) 刷新指令槽对应的icache
					 * 14) 将用于跳转优化的汇编代码块首地址, 保存到optimized_kprobe->optinsn.insn中, 后续由kprobe_optimizer负责将op->optinsn.insn保存的指令设置到被探测指令处
					 */
					arch_prepare_optimized_kprobe(struct optimized_kprobe *op = op, struct kprobe *orig = p) {
						kprobe_opcode_t *code
						unsigned long rel_chk
						unsigned long val
						unsigned long stack_protect = sizeof(struct pt_regs)

						/*  TODO  */
						ret = can_optimize(struct kprobe *kp = orig) {
							if (kp->ainsn.stack_space < 0)
								return 0
							/* 255 is the biggest imm can be used in 'sub r0, r0, #<imm>'. Number larger than 255 needs special encoding. */
							if (kp->ainsn.stack_space > 255 - sizeof(struct pt_regs))
								return 0
							return 1
						}
						if (!ret)
							return -EILSEQ

						/* 1) 分配用于跳转优化的“optprobe_template汇编代码”的指令槽空间
						 * 指令槽大小: kprobe_optinsn_slots.insn_size = MAX_OPTINSN_SIZE = optprobe_template_end - optprobe_template_entry */
						code = get_optinsn_slot() {
							return __get_insn_slot(struct kprobe_insn_cache *c = &kprobe_optinsn_slots)
						}

						/* 2) 检查kpeobe探测指令处, 与optprobe_template code之间的距离是否超过32MiB(因为ARM相对跳转允许的范围就是32MiB)
						 *    Verify if the address gap is in 32MiB range, because this uses a relative jump. Kprobe opt use a 'b' instruction to branch to optinsn.insn.
						 *
						 * ARM branch instruction:
						 *   31  28 27           24 23             0
						 *  +------+---+---+---+---+----------------+
						 *  | cond | 1 | 0 | 1 | 0 |      imm24     |
						 *  +------+---+---+---+---+----------------+
						 *
						 * imm24 is a signed 24 bits integer.
						 * So the maximum forward branch should be: (0x007fffff << 2) = 0x01fffffc =  0x1fffffc
						 * The maximum backword branch should be:   (0xff800000 << 2) = 0xfe000000 = -0x2000000
						 */
						rel_chk = (unsigned long)((long)code - (long)orig->addr + 8) & 0xfe000003
						if ((rel_chk != 0) && (rel_chk != 0xfe000000)) {
							/* Different from x86, we free code buf directly instead of calling __arch_remove_optimized_kprobe() because
							 * we have not fill any field in op. */
							free_optinsn_slot(code, 0)
							return -ERANGE
						}

						/* 3) 将用于跳转优化的汇编代码(即: optprobe_template)拷贝到新分配的这块指令槽中;  Copy arch-dep-instance from template. */
						memcpy(code, (unsigned long *)optprobe_template_entry, TMPL_END_IDX * sizeof(kprobe_opcode_t))

						stack_protect += orig->ainsn.stack_space

						/* 4) 修改optprobe_template汇编代码中的sub sp指令内容, 用于预留保存CPU上下文(即: struct pt_regs)的栈内存
						 * Create a 'sub sp, sp, #<stack_protect>' */
						code[TMPL_SUB_SP] = __opcode_to_mem_arm(0xe24dd000 | stack_protect)

						/* 5) 修改optprobe_template汇编代码中的add r3, sp指令内容, 用于计数sub sp指令执行前原始的栈指针位置并记录到r3中
						 * Create a 'add r3, sp, #<stack_protect>' */
						code[TMPL_ADD_SP] = __opcode_to_mem_arm(0xe28d3000 | stack_protect)

						/* 6) 将optimized_kprobe对象指针设置到“optprobe_template汇编代码的标签1处”, 后续作为optimized_callback的入参
						 * Set probe information */
						val = (unsigned long)op
						code[TMPL_VAL_IDX] = val

						/* 7) 将optimized_callback函数地址, 设置到“optprobe_template汇编代码的标签2处”, 用于optprobe_template汇编代码跳转到该处执行pre_handler等操作
						 * Set probe function call */
						val = (unsigned long)optimized_callback
						code[TMPL_CALL_IDX] = val

						/* 8) 判断被探测指令是否可以直接在optprobe_template中直接执行.
						 *   (判断条件: 被探测指令是否使用了PC寄存器, 若未使用则可以直接执行被探测指令, 不需要任何模拟执行)
						 * If possible, copy insn and have it executed during restore */
						orig->ainsn.kprobe_direct_exec = false
						ret = can_kprobe_direct_exec(m = orig->ainsn.register_usage_flags) {
							return !test_bit(ARM_REG_PC, &(m))		// #define ARM_REG_PC	15
						}
						if (ret) {
							/* 9) 若可以直接执行被探测指令, 则手动计算一条跳转(branch)指令, 用于从 “optprobe_template_restore_end标签处” 跳转到 “被探测指令+4位置处”
							 *
							 * (final_branch指令: 在optprobe_template中执行完pre_handler后, 并接着执行完被kprobe探测的指令后, 跳转回被探测指令的下一条指令接着运行)
							 */
							kprobe_opcode_t final_branch = arm_gen_branch(pc = (unsigned long)(&code[TMPL_RESTORE_END]), addr = (unsigned long)(op->kp.addr) + 4) {
								return __arm_gen_branch(pc, addr, bool link = false, bool warn = true) {
									return __arm_gen_branch_arm(pc = &code[TMPL_RESTORE_END], addr = (op->kp.addr) + 4, link = false, warn = true) {
										unsigned long opcode = 0xea000000
										long offset

										if (link)
											opcode |= 1 << 24

										offset = (long)addr - (long)(pc + 8)
										if (unlikely(offset < -33554432 || offset > 33554428)) {
											return 0
										}
										offset = (offset >> 2) & 0x00ffffff

										return opcode | offset
									}
								}
							}//arm_gen_branch
							if (final_branch != 0) {
								/* 10) 对于可以直接执行被探测指令的场景, 修改optprobe_template_restore_begin标签处用于“恢复CPU上下文”的指令, 修改为不恢复PC
								 * Replace original 'ldmia sp, {r0 - r15}' with 'ldmia {r0 - r14}', restore all registers except pc. */
								code[TMPL_RESTORE_BEGIN] = __opcode_to_mem_arm(0xe89d7fff)

								/* 11) 将被探测指令(orig->opcode)写入optprobe_template_restore_orig_insn标签处, 用于在optprobe_template中直接执行被探测指令
								 * The original probed instruction */
								code[TMPL_RESTORE_ORIGN_INSN] = __opcode_to_mem_arm(orig->opcode)

								/* 12) 将用于跳转回“被探测指令+4处”的指令, 写到optprobe_template_restore_end标签处, 用于返回到原本的程序执行流
								 * Jump back to next instruction */
								code[TMPL_RESTORE_END] = __opcode_to_mem_arm(final_branch)
								orig->ainsn.kprobe_direct_exec = true
							}
						}
						/* 13) 刷新指令槽对应的icache */
						flush_icache_range((unsigned long)code, (unsigned long)(&code[TMPL_END_IDX]))

						/* 14) 将用于跳转优化的汇编代码块首地址, 保存到optimized_kprobe->optinsn.insn中,
						 *     后续由kprobe_optimizer负责将op->optinsn.insn保存的指令设置到被探测指令处 */
						op->optinsn.insn = code
						return 0
					}//arch_prepare_optimized_kprobe
				}
			}//__prepare_optimized_kprobe
			return &op->kp
		}//alloc_aggr_kprobe

		/* 4) 根据新分配aggr_kprobe对象, 找到optimized_kprobe对象 */
		op = container_of(ap, struct optimized_kprobe, kp)

		/* 5) 检查用于jump optimization的detour buffer是否已经分配并设置好 */
		ret = arch_prepared_optinsn(struct arch_optimized_insn *optinsn = &op->optinsn) {
			/* ARM can always optimize an instruction when using ARM ISA, except instructions like 'str r0, [sp, r1]'
			 * which store to stack and unable to determine stack space consumption statically. */
			return optinsn->insn != NULL
		}
		if (!ret)
			goto out

		/* 6) 初始化新分配的aggr_kprobe, 将原本的kprobe对象内容拷贝至新分配的aggr_kprobe中 */
		# 注: 对于optimize kprobe, 新分配的aggr_kprobe的pre_hander实际上是不会被执行到的!执行的是opt_pre_handler->kprobe's pre_handler
		init_aggr_kprobe(struct kprobe *ap = ap, struct kprobe *p = p)
		{
			/* Copy the insn slot of 'p' to 'ap'. */
			copy_kprobe(p, ap) {					// 将orig_kprobe(即:p)的insn slot指令槽拷贝给新分配的aggr_kprobe(即:ap)
				memcpy(&ap->opcode, &p->opcode, sizeof(kprobe_opcode_t))
				memcpy(&ap->ainsn, &p->ainsn, sizeof(struct arch_specific_insn))
			}

			ap->addr  = p->addr						// 拷贝探测指令地址, flag等属性
			ap->flags = p->flags & ~KPROBE_FLAG_OPTIMIZED

			ap->pre_handler = aggr_pre_handler		// *** 为aggr_kprobe设置pre_handler ***

			if (p->post_handler && !kprobe_gone(p))
				ap->post_handler = aggr_post_handler// *** 为aggr_kprobe设置post_handler ***

			INIT_LIST_HEAD(&ap->list)				// 初始化用于挂载到aggr_kprobe->list上的node节点
			INIT_HLIST_NODE(&ap->hlist)				// 初始化用于挂载到全局哈希表kprobe_table上的node节点

			list_add_rcu(&p->list, &ap->list)		// 将orig_kprobe(即:p)头插到新分配的aggr_kprobe(即:ap)的list链表上
			hlist_replace_rcu(&p->hlist, &ap->hlist)// 将全局哈希表kprobe_table中的orig_kprobe替换成新分配的aggr_kprobe
		}//init_aggr_kprobe

		/*【optimize_kprobe函数功能】
		 * 7) 判断本个kprobe是否可以进行跳转优化, 若可以的话, 将optimized_kprobe对象添加到全局optimizing_list队列并唤醒optimizing_work去执行跳转优化
		 *
		 * This just kicks optimizer thread. */
		optimize_kprobe(struct kprobe *p = ap) {
			struct optimized_kprobe *op

			/* 通过查看optinsn->insn是否为NULL, 判断optimize kprobe的跳转优化代码是否准备完毕 */
			ready = kprobe_optready(p) {
				if (kprobe_aggrprobe(p)) {
					op = container_of(p, struct optimized_kprobe, kp)
					return arch_prepared_optinsn(struct arch_optimized_insn *optinsn = &op->optinsn) {
						return optinsn->insn != NULL
					}
				}
				return 0
			}
			if (!ready || !kprobes_allow_optimization || (kprobe_disabled(p) || kprobes_all_disarmed))
				return

			/* 若kprobe有post_handler, 则不能被优化
			 * kprobes with 'post_handler' can not be optimized */
			if (p->post_handler)
				return

			op = container_of(p, struct optimized_kprobe, kp)
			/* Check there is no other kprobes at the optimized instructions */
			if (arch_check_optimized_kprobe(op) < 0)		// ARM always return 0
				return

			/* Check if it is already optimized. */
			if (op->kp.flags & KPROBE_FLAG_OPTIMIZED) {
				if (optprobe_queued_unopt(op)) {
					list_del_init(&op->list)
				}
				return
			}
			op->kp.flags |= KPROBE_FLAG_OPTIMIZED

			if (WARN_ON_ONCE(!list_empty(&op->list)))
				return

			/* 将optimized_kprobe对象添加到全局optimizing_list队列中 */
			list_add(&op->list, &optimizing_list)

			/* 唤醒optimizing_work工作线程, 去替换kprobe指令进行跳转优化 */
			kick_kprobe_optimizer() {
				schedule_delayed_work(struct delayed_work *dwork = &optimizing_work, unsigned long delay = OPTIMIZE_DELAY)
					queue_delayed_work(system_wq, dwork, delay)
			}
		}//optimize_kprobe
	out:
		mutex_unlock(&text_mutex)
		jump_label_unlock()
		cpus_read_unlock()
	}//try_to_optimize_kprobe

	return 0
}
2、后台线程kprobe_optimizer对指定kprobe进行优化
optimizing_work(struct work_struct *work)
A.K.A
kprobe_optimizer(struct work_struct *work) {
	mutex_lock(&kprobe_mutex)
	cpus_read_lock()
	mutex_lock(&text_mutex)

	/* 1) 将unoptimizing_list队列上挂载的optimized_kprobe对象都unoptimize掉, 将被探测指令替换会BRK指令 */
	do_unoptimize_kprobes() {
		struct optimized_kprobe *op, *tmp

		if (!list_empty(&unoptimizing_list)) {
			arch_unoptimize_kprobes(struct list_head *oplist = &unoptimizing_list, struct list_head *done_list = &freeing_list) {
				struct optimized_kprobe *op, *tmp

				list_for_each_entry_safe(op, tmp, oplist, list) {
					arch_unoptimize_kprobe(op) {
						/* install breakpoint in text */
						arch_arm_kprobe(struct kprobe *p = &op->kp) {
							void *addr = p->addr
							u32 insn = BRK64_OPCODE_KPROBES
							aarch64_insn_patch_text(&addr, &insn, 1)
						}
					}
					list_move(&op->list, done_list)
				}
			}//arch_unoptimize_kprobes
		}

		list_for_each_entry_safe(op, tmp, &freeing_list, list) {
			op->kp.flags &= ~KPROBE_FLAG_OPTIMIZED
			if (kprobe_disabled(&op->kp) && !kprobe_gone(&op->kp))
				arch_disarm_kprobe(&op->kp)
			if (kprobe_unused(&op->kp)) {
				hlist_del_rcu(&op->kp.hlist)
			} else
				list_del_init(&op->list)
		}
	}//do_unoptimize_kprobes

	/* 2) 确保所有活跃的中断在调用 synchronize_rcu() 的时候已经完成 */
	synchronize_rcu_tasks()

	/* 3) 优化optimizing_list队列上挂载的所有optimized_kprobe对象, 将被探测指令处的BRK替换成“相对跳转到op->optinsn.insn指令槽”的相对跳转指令 */
	do_optimize_kprobes() {
		if (kprobes_all_disarmed || !kprobes_allow_optimization || list_empty(&optimizing_list))
			return

		arch_optimize_kprobes(&optimizing_list) {
			struct optimized_kprobe *op, *tmp

			list_for_each_entry_safe(op, tmp, oplist, list) {
				unsigned long insn

				/* Backup instructions which will be replaced by jump address */
				memcpy(op->optinsn.copied_insn, op->kp.addr, RELATIVEJUMP_SIZE)		// define RELATIVEJUMP_SIZE   4

				### 生成: “从kprobe探测指令跳转到Jump Optimization code(即: op->optinsn.insn)” 的跳转指令
				insn = arm_gen_branch((unsigned long)op->kp.addr, (unsigned long)op->optinsn.insn)

				/* Make it a conditional branch if replaced insn is consitional */
				insn = (__mem_to_opcode_arm(op->optinsn.copied_insn[0]) & 0xf0000000) | (insn & 0x0fffffff)

				### >>>>>>>>>>>>>>>>  将原本kprobe设置的brk指令替换为“跳转到optprobe_template指令块的跳转指令”  <<<<<<<<<<<<<<<<<<
				kprobes_remove_breakpoint(void *addr = op->kp.addr, insn) {
					struct patch p = {
						.addr = addr,
						.insn = insn,
					}
					stop_machine_cpuslocked(__kprobes_remove_breakpoint, &p, cpu_online_mask) {
						/* Detail see above */
					}
				}

				list_del_init(&op->list)
			}
		}//arch_optimize_kprobes
	}//do_optimize_kprobes

	/* 4) 回收所有挂载在freeing_list队列上的optimized_kprobe对象 */
	do_free_cleaned_kprobes() {
		struct optimized_kprobe *op, *tmp

		list_for_each_entry_safe(op, tmp, &freeing_list, list) {
			list_del_init(&op->list)
			if (WARN_ON_ONCE(!kprobe_unused(&op->kp))) {
				/* This must not happen, but if there is a kprobe still in use, keep it on kprobes hash list. */
				continue
			}
			free_aggr_kprobe(struct kprobe *p = &op->kp) {
				struct optimized_kprobe *op
				op = container_of(p, struct optimized_kprobe, kp)

				arch_remove_optimized_kprobe(op) {
					__arch_remove_optimized_kprobe(struct optimized_kprobe *op = op, int dirty = 1) {
						if (op->optinsn.insn) {
							free_optinsn_slot(op->optinsn.insn, dirty)
							op->optinsn.insn = NULL
						}
					}
				}
				arch_remove_kprobe(p) {
					if (p->ainsn.api.insn) {
						free_insn_slot(p->ainsn.api.insn, 0)
						p->ainsn.api.insn = NULL
					}
				}

				kfree(op)
			}
		}
	}//do_free_cleaned_kprobes

	mutex_unlock(&text_mutex)
	cpus_read_unlock()
	/* Step 5: Kick optimizer again if needed */
	if (!list_empty(&optimizing_list) || !list_empty(&unoptimizing_list))
		kick_kprobe_optimizer()

	mutex_unlock(&kprobe_mutex)
}
3、跳转优化的kprobe, 触发时, 执行对应pre_handler
optimized_callback(struct optimized_kprobe *op, struct pt_regs *regs) {
	unsigned long flags
	struct kprobe *p = &op->kp
	struct kprobe_ctlblk *kcb

	/* Save skipped registers */
	regs->ARM_pc = (unsigned long)op->kp.addr
	regs->ARM_ORIG_r0 = ~0UL

	local_irq_save(flags)

	kcb = get_kprobe_ctlblk() {
		return this_cpu_ptr(&kprobe_ctlblk)
	}

	is_running = kprobe_running() {
		return __this_cpu_read(current_kprobe)
	}
	if (is_running) {
		kprobes_inc_nmissed_count(&op->kp) {
			if (!kprobe_aggrprobe(p)) {
				p->nmissed++
			} else {
				list_for_each_entry_rcu(kp, &p->list, list)
					kp->nmissed++
			}
		}//kprobes_inc_nmissed_count
	} else {
		__this_cpu_write(current_kprobe, &op->kp)
		kcb->kprobe_status = KPROBE_HIT_ACTIVE

		opt_pre_handler(struct kprobe *p = &op->kp, struct pt_regs *regs = regs) {
			struct kprobe *kp
			list_for_each_entry_rcu(kp, &p->list, list) {
				if (kp->pre_handler && likely(!kprobe_disabled(kp))) {
					set_kprobe_instance(kp) {
						__this_cpu_write(kprobe_instance, kp)
					}

					### 执行kprobe的pre_handler!
					kp->pre_handler(kp, regs)
				}
				reset_kprobe_instance() {
					__this_cpu_write(kprobe_instance, NULL)
				}
			}
		}//opt_pre_handler
		__this_cpu_write(current_kprobe, NULL)
	}

	if (!p->ainsn.kprobe_direct_exec) {
		op->kp.ainsn.insn_singlestep(p->opcode, &p->ainsn, regs)
	}

	local_irq_restore(flags)
}//optimized_callback
以上就是 kprobe跳转优化 的全部内容,感谢大伙的收看 !~
 802


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


