


大家好,我是一名深耕AI Agent领域的开发者。最近参与了一个医疗健康AI Agent的完整项目开发,从架构设计到生产部署踩过了无数坑。今天把整个项目的技术细节和盘托出,希望能帮到正在做Agent开发的朋友们。
如果你觉得这篇文章对你有帮助,欢迎点赞、关注、转发三连支持~后续我会持续输出更多Agent开发实战干货。
项目背景与挑战
医疗领域的AI问答系统面临着专业性、准确性、安全性三大核心挑战:
- 专业性要求极高:医学知识容不得半点错误,一个错误的回答可能直接影响用户健康
- 知识体系庞杂:中西医结合,既有现代医学文献,又有中医古籍,数据格式多样
- 用户体验敏感:用户往往带着焦虑提问,响应速度和对话体验至关重要
- 合规与追溯:医疗内容必须可追溯、可审核、可迭代优化
我们的目标是打造一个生产级医疗多模态AI Agent系统,基于 Multi-Agent RAG 架构,提供中西医问答、语音对话、数据飞轮等核心能力。
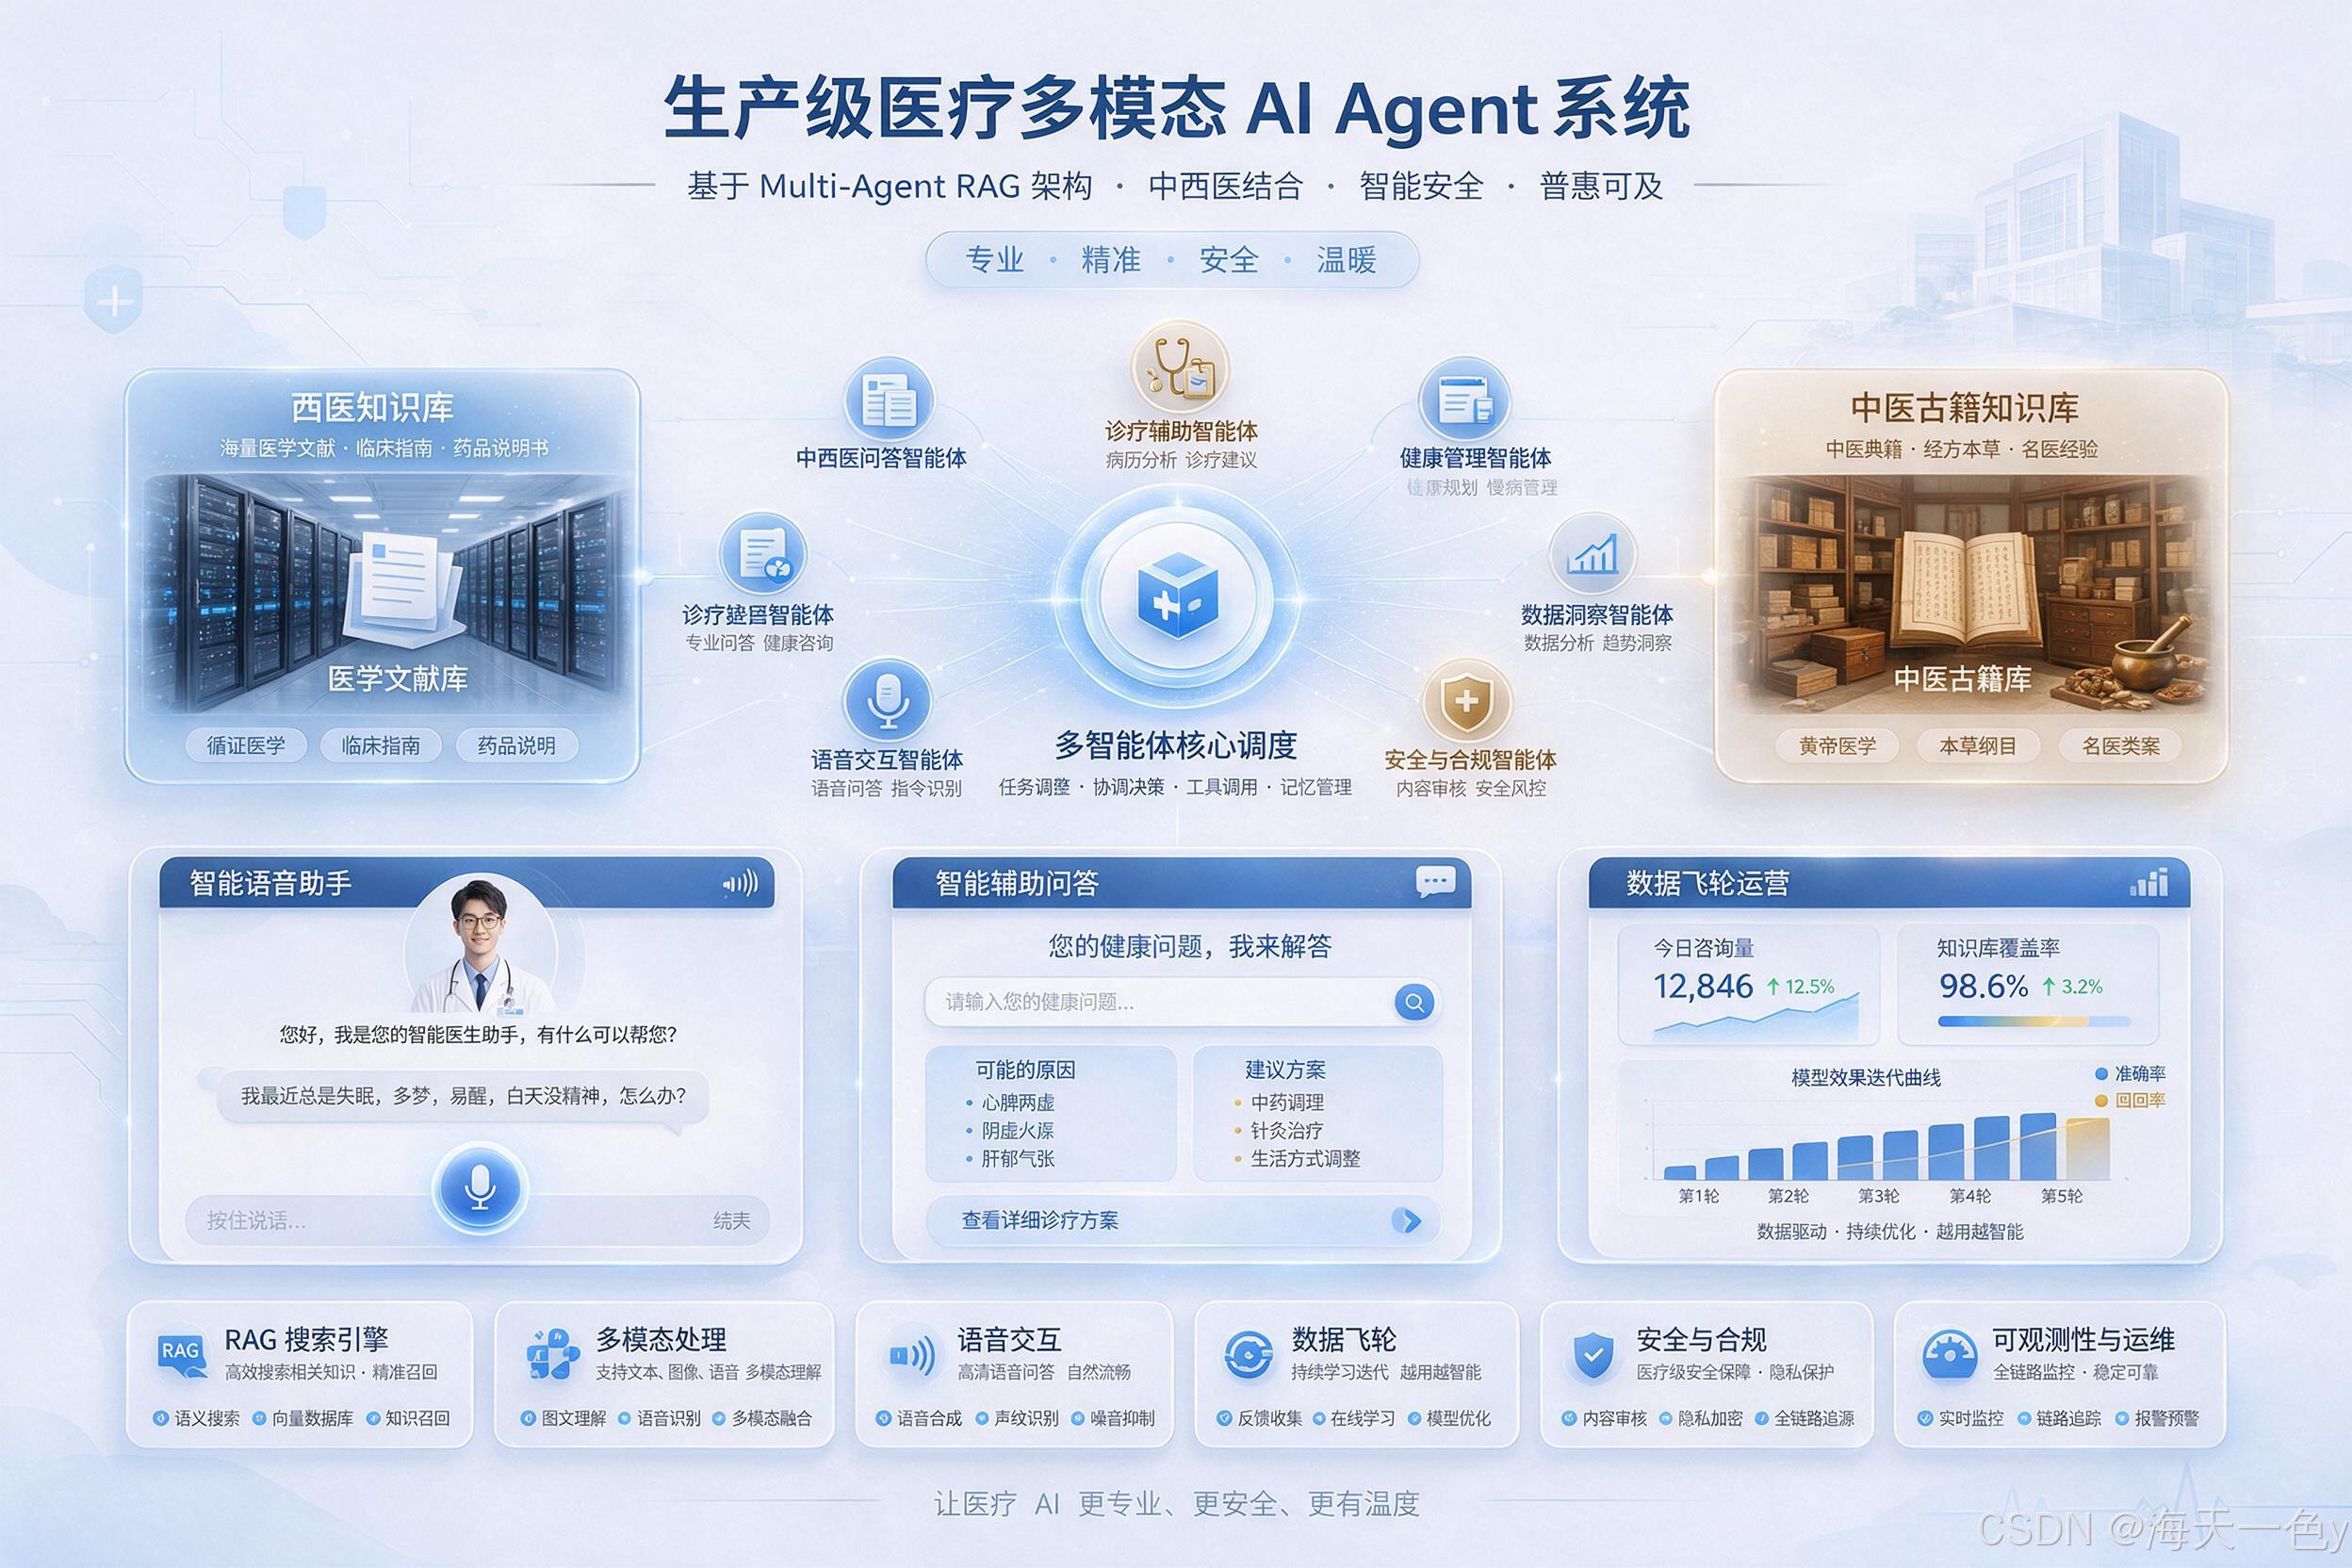
整体架构概览
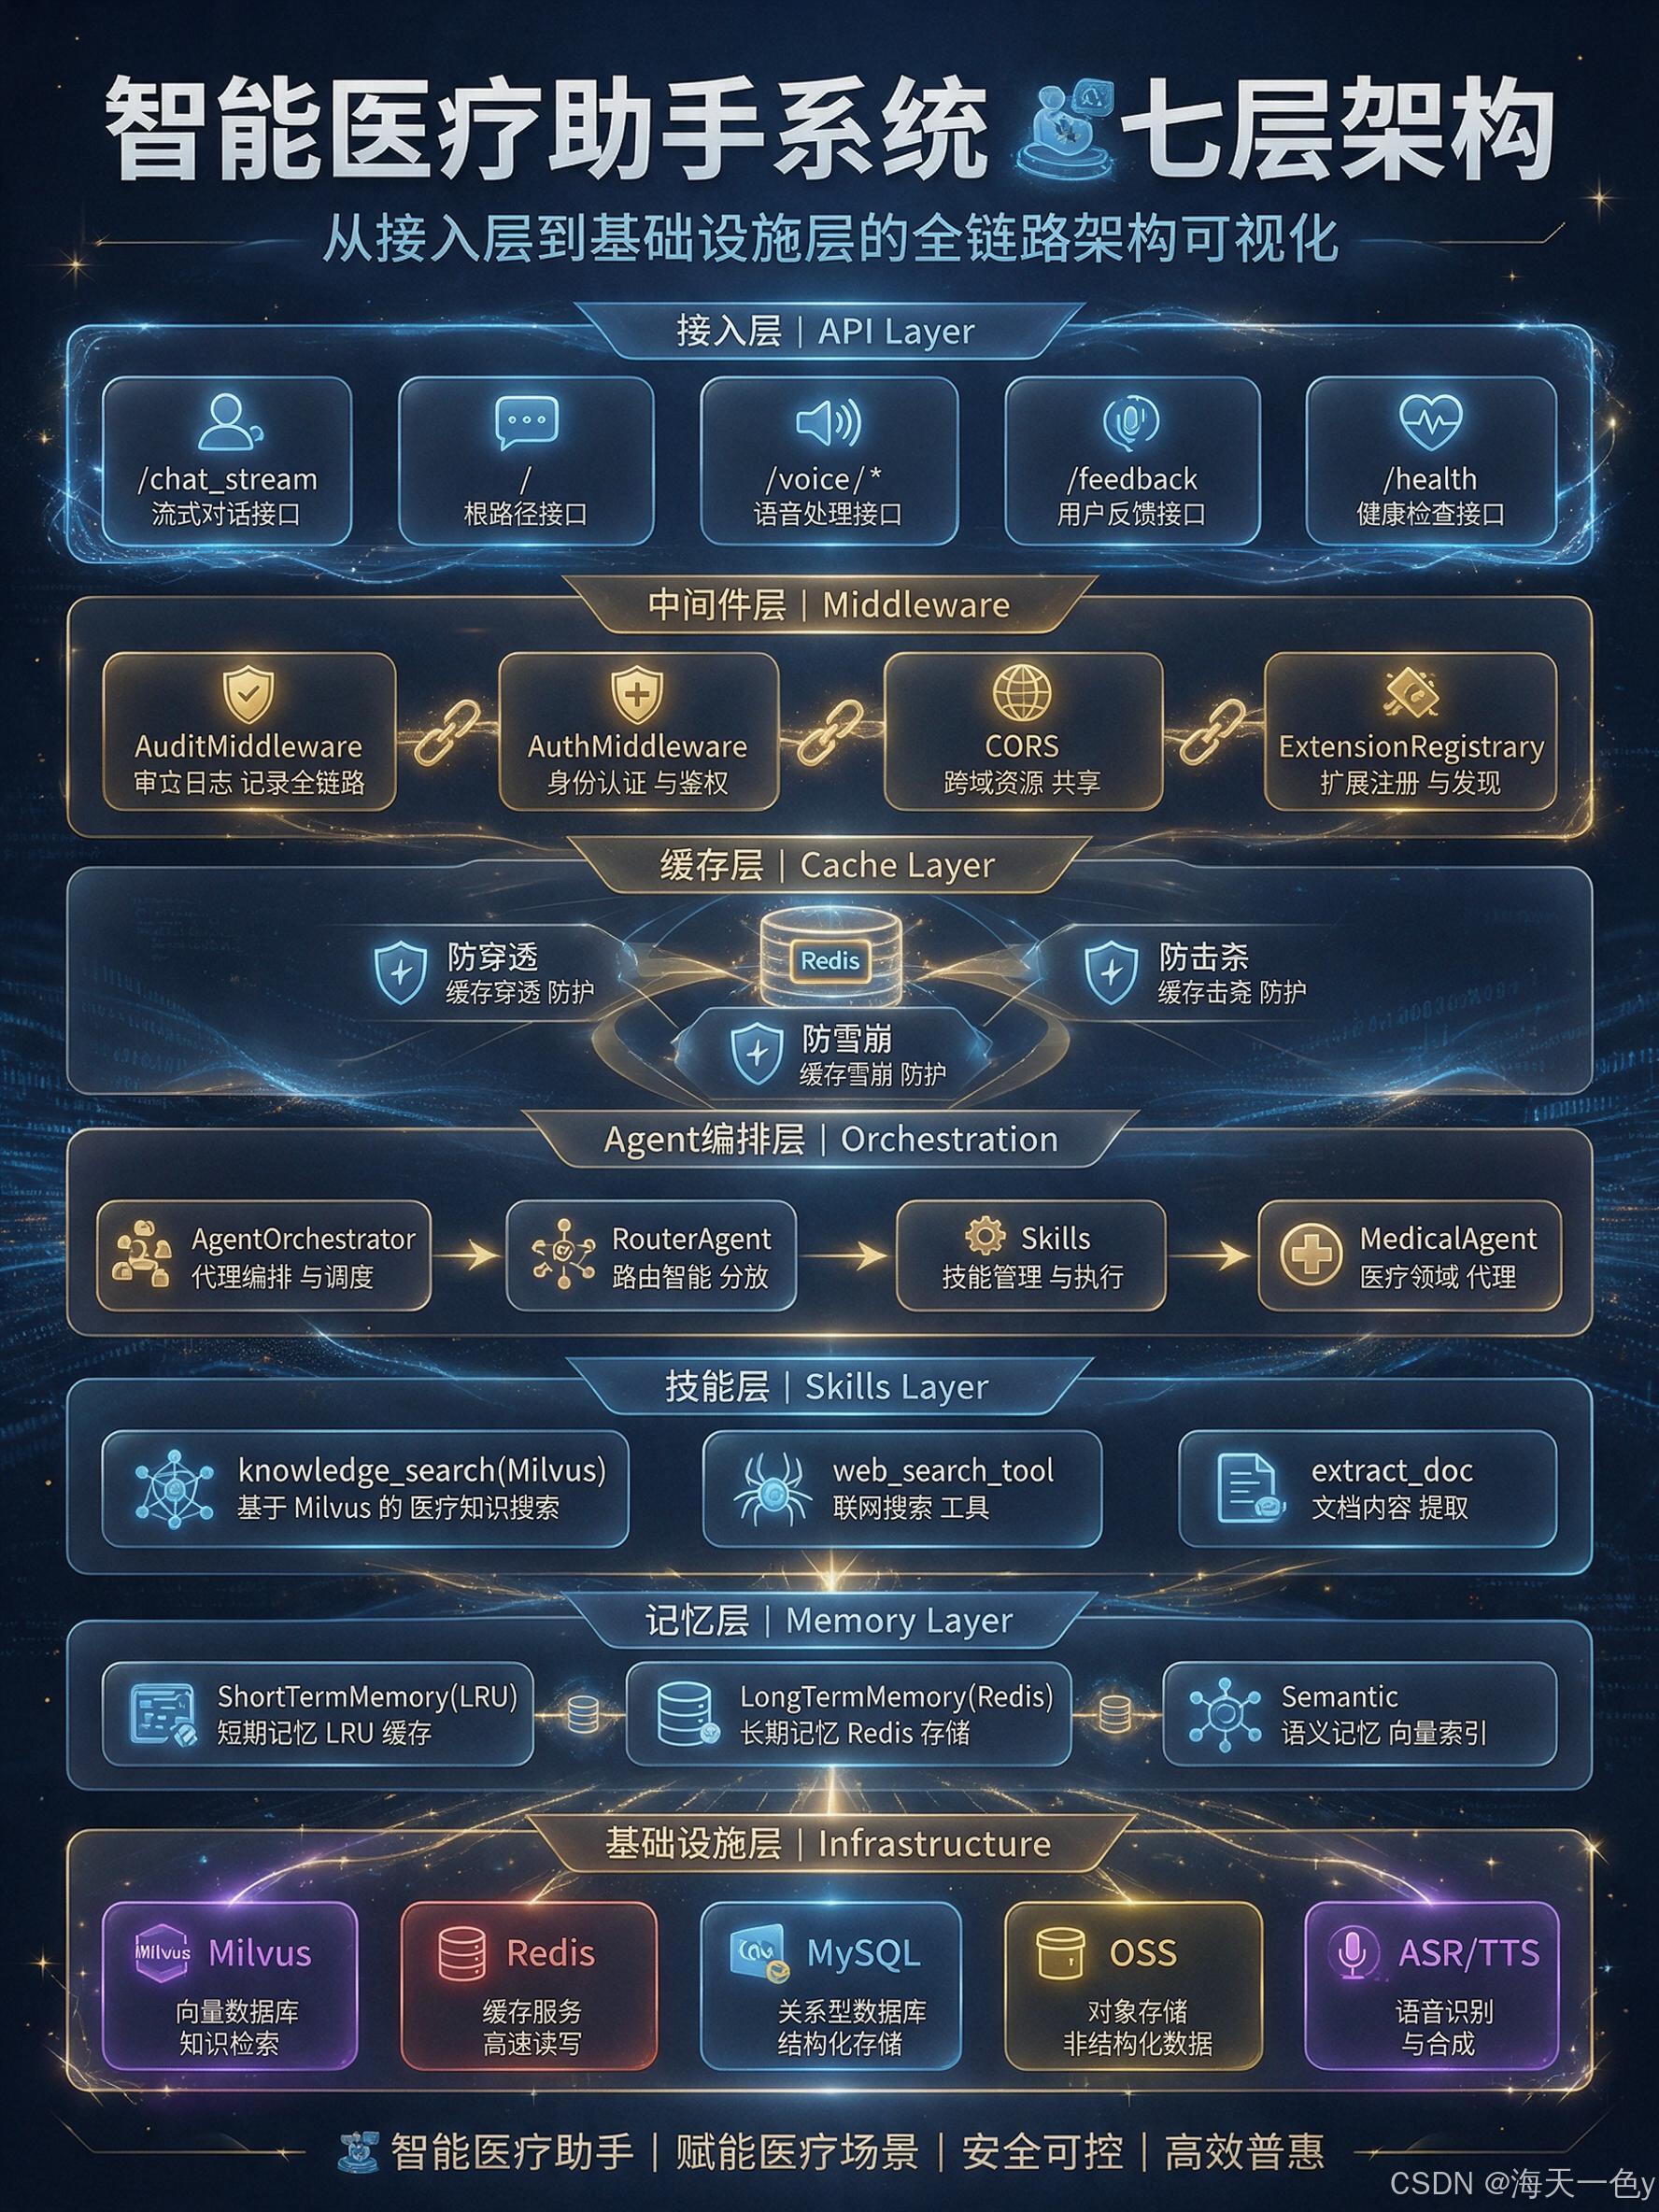
整个系统采用七层分层架构,从接入层到基础设施层各司其职:
接入层 (API Layer)
  POST /chat_stream | POST / | /voice/* | /feedback | /health

中间件层 (Middleware)
  AuditMiddleware | AuthMiddleware | CORS | ExtensionRegistry

缓存层 (Cache Layer)
  Redis 三层防护: 防穿透 + 防击穿 + 防雪崩

Agent编排层 (Orchestration)
  AgentOrchestrator -> RouterAgent -> Skills -> MedicalAgent

技能层 (Skills Layer)
  knowledge_search(Milvus) | web_search_tool | extract_doc

记忆层 (Memory Layer)
  ShortTermMemory(LRU) | LongTermMemory(Redis) | Semantic

基础设施层 (Infrastructure)
  Milvus | Redis | MySQL | OSS | ASR/TTS
核心技术栈
| 层级 | 技术选型 |
|---|---|
| 服务框架 | FastAPI + Uvicorn(异步高性能) |
| 大模型 | DeepSeek-V4、GLM-5.2、Doubao-2.1 |
| 向量数据库 | Milvus 2.x(HNSW + BM25 混合检索) |
| 缓存 | Redis(分布式锁 + 三层防护) |
| 关系数据库 | MySQL(用户、会话、计费数据) |
| 语音 | 火山引擎 ASR/TTS、智谱 GLM-4-Voice、阶跃星辰 StepAudio 2.5 |
| 对象存储 | 阿里云 OSS |
Multi-Agent 架构深度解析
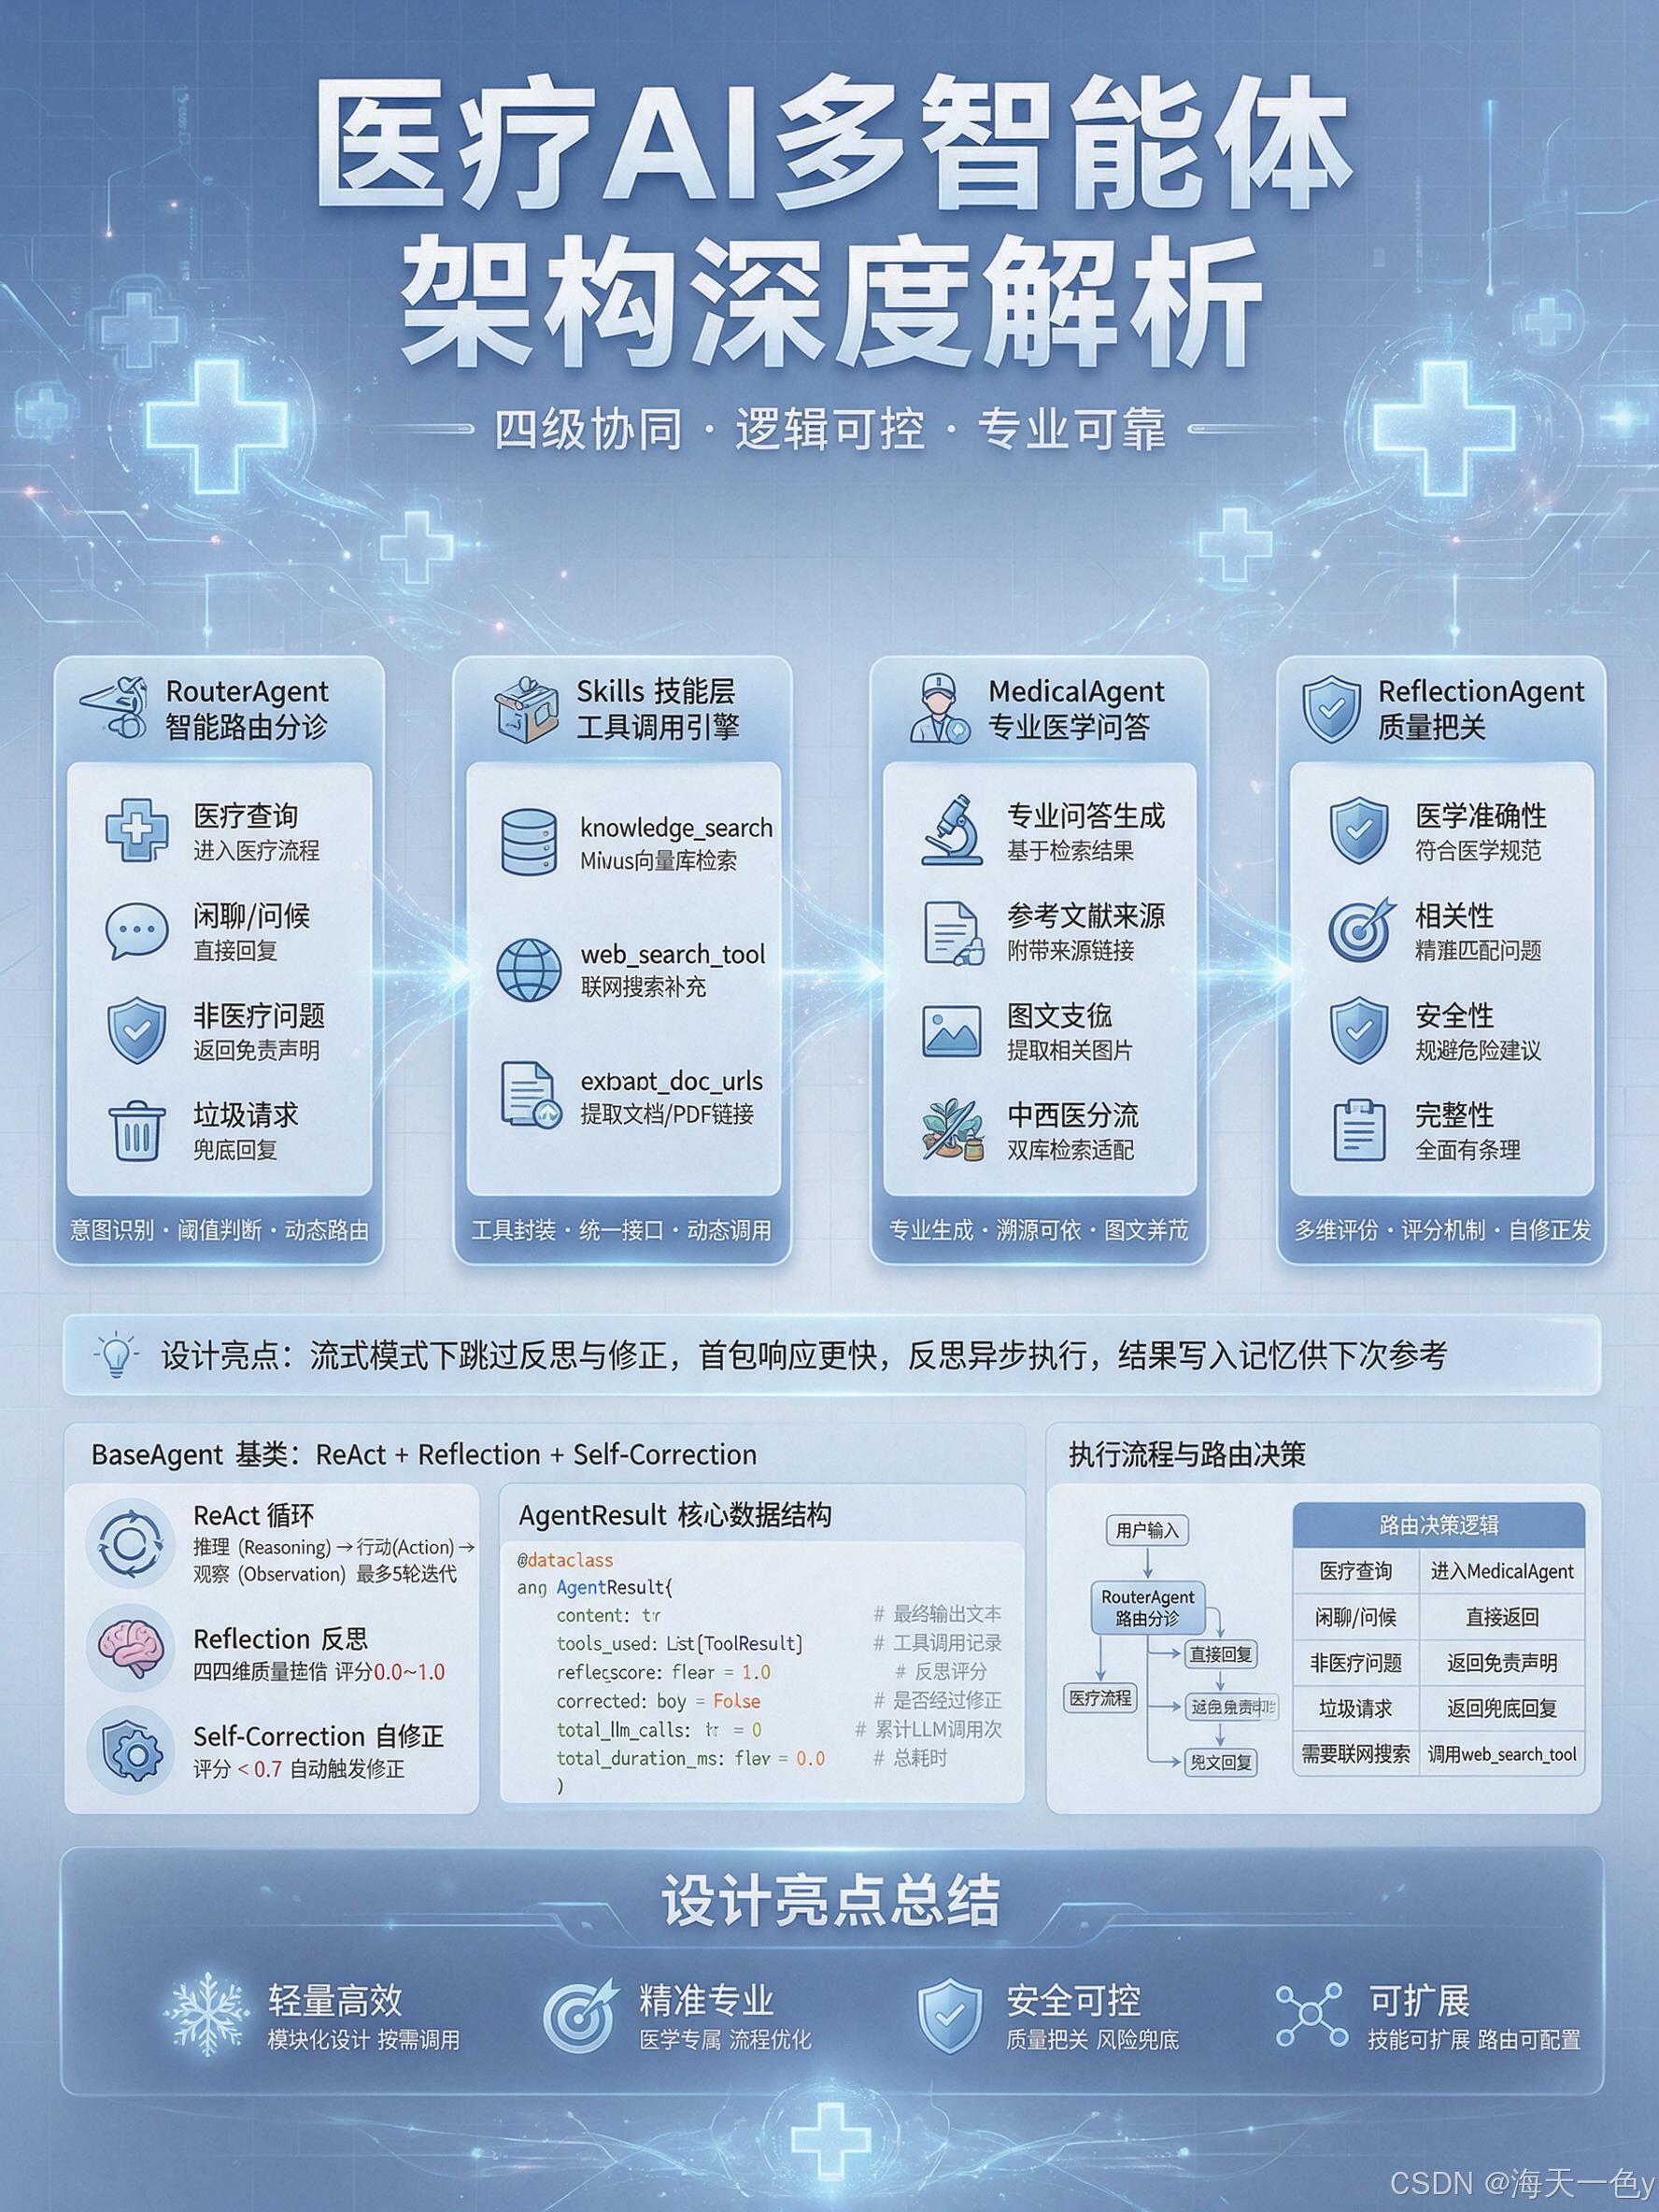
这是整个系统的核心,也是最有技术含量的部分。我们没有采用简单的单向RAG流水线,而是构建了四级Multi-Agent流水线:
RouterAgent -> Skills -> MedicalAgent -> ReflectionAgent
1. BaseAgent 基类:ReAct + Reflection + Self-Correction
所有Agent都继承自 BaseAgent,内置三重机制:
- ReAct 循环:推理(Reasoning) -> 行动(Action) -> 观察(Observation),最多5轮迭代
- Reflection 反思:对输出进行四维度质量评估(0.0~1.0分)
- Self-Correction 自修正:评分 < 0.7 时自动触发修正
核心数据结构:
@dataclass
class AgentResult:
    content: str                    # 最终输出文本
    tools_used: List[ToolResult]    # 工具调用记录
    reflect_score: float = 1.0      # 反思评分
    corrected: bool = False         # 是否经过修正
    total_llm_calls: int = 0        # 累计LLM调用次数
    total_duration_ms: float = 0.0  # 总耗时
执行流程:
run() -> Phase 1: _react_loop()
      -> Phase 2: _reflect() [可选]
      -> Phase 3: _correct() [仅当 score < threshold]
设计亮点:流式模式下为了优化TTFT(首token时间),会跳过反思和修正步骤,反思在流式结束后异步执行,结果写入记忆供下次参考。
2. RouterAgent:智能路由分诊
RouterAgent是系统的"门卫",负责判断用户意图:
- 医疗查询 -> 进入MedicalAgent处理
- 闲聊/问候 -> 直接返回寒暄话术
- 非医疗问题 -> 返回免责声明
- 垃圾请求 -> 返回默认兜底回复
- 需要联网搜索 -> 先调用web_search_tool再进入医疗流程
这一层虽然简单,但极其重要——它能有效拦截无关请求,节省Token成本,同时确保医疗回答的专业性。
3. Skills 技能层:工具调用引擎
Skills层封装了三类核心工具:
| 工具名称 | 功能 | 调用时机 |
|---|---|---|
knowledge_search |
Milvus向量库检索 | 所有医疗问题默认调用 |
web_search_tool |
联网搜索补充 | 需要最新医学资讯时 |
extract_doc_urls |
提取检索结果中的文档/PDF链接 | 返回参考资料时 |
RouterAgent根据意图决定调用哪些工具,工具结果以结构化方式注入MedicalAgent的上下文。
4. MedicalAgent:专业医学问答
MedicalAgent是系统的"专家",基于检索到的医学知识生成专业回答。它的核心设计原则:
- 严格基于检索结果:不凭空编造医学建议
- 给出参考文献:回答末尾附带来源文档链接
- 图文并茂:支持从检索结果中提取图片URL
- 中西医分流:现代医学和中医古籍分库检索
5. ReflectionAgent:质量把关
ReflectionAgent是系统的"质检员",从四个维度评估回答质量:
- 医学准确性:内容是否符合医学规范
- 相关性:是否真正回答了用户的问题




 扫一扫


 1296

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


