


【导航台账】制造业数据与AI践行者老蒋的技术博客全系列文章汇总(持续更新)
📌 文章摘要
针对制造企业数据平台 “既要实时写入、又要复杂查询、还要低运维” 的选型难题,本文基于智联工坊真实场景,对比传统数仓、ClickHouse、Hadoop 生态等主流方案,详解最终选定 Apache Doris + Apache DolphinScheduler 组合的决策逻辑。附完整部署验证步骤与落地效果数据,可直接作为中小企业数据底座建设的选型参考。
目录
五、Doris + DolphinScheduler:一个“存储+计算+调度”的完整数据底座
6.3 DolphinScheduler部署与MySQL持久化
6.4 集成验证:DolphinScheduler调度Doris SQL任务
开篇:选型这件事,真的让人头大
【先说结论】最终我们选定「Apache Doris 作为实时 OLAP 引擎 + Apache DolphinScheduler 作为分布式调度系统」的组合,这套方案覆盖了三大核心场景的全部需求,运维成本仅为 Hadoop 全栈方案的 1/5。
兄弟们,上篇文章我们聊了湖仓一体架构(点击链接查看),讲了“为什么制造企业需要它”。今天咱们接着聊一个更实际的问题——技术选型。
事情是这样的。智联工坊的数据平台要升级了。领导给了三个要求:
-
实时性:设备数据写入后,希望在秒级内就能查到,不能等T+1
-
查询能力:既要能跑复杂的多表Join分析,又要能支持高并发的点查询
-
可运维:不要引入太多组件,运维团队就那么几个人,复杂了玩不转
我当时的第一反应是:这不科学啊……😀😀😀
又要实时、又要复杂查询、又要简单运维——这三大需求放在一起,简直是在为难选型的人。
传统数仓扛不住实时写入。ClickHouse多表Join能力弱。Hadoop体系组件太多,运维成本太高。
选型这件事,真的让人头大。
本文要解决的问题:用智联工坊的真实选型经历,讲清楚“为什么最终选择了Apache Doris + Apache DolphinScheduler”这个组合。
适合谁读:正在为数据平台选型发愁的数仓工程师、数据架构师,以及想了解开源大数据组件组合方案的IT管理者。
脱敏声明:本文基于智联工坊虚拟场景的真实选型过程提炼,所有数据和决策背景均已脱敏处理。
一、选型前的灵魂拷问:我们到底需要什么?
在开始对比各种方案之前,我们先把需求理清楚。
智联工坊的数据平台,核心要解决三类场景:
| 场景 | 数据特征 | 查询特征 | 时效要求 |
|---|---|---|---|
| 设备实时监控 | 传感器数据持续写入,每秒数千条 | 单设备点查、短时间范围查询 | 秒级可见 |
| 经营分析报表 | 订单、工单、库存等结构化数据 | 多表Join、聚合计算、趋势分析 | 分钟级 |
| 质量追溯 | 订单→工单→设备→质检全链路 | 复杂关联查询,需追溯历史 | 交互式(秒级响应) |
这三个场景对技术栈的要求几乎是对立的:
-
场景一要高并发写入和点查快
-
场景二要复杂Join和聚合快
-
场景三要数据一致性和历史数据查询
一个组件搞定所有场景,几乎不可能。
所以我们的选型思路是:选一个能覆盖80%核心场景的OLAP引擎,再搭配一个调度系统把剩下的20%管起来。
二、候选方案对比:为什么排除了几个“热门选手”
根据当下市场情况认真评估了几个主流方案:
| 方案 | 优点 | 缺点 | 结论 |
|---|---|---|---|
| 传统数仓(Oracle/GP) | 成熟稳定,SQL支持完善 | 实时写入能力弱,扩展成本高 | ❌ 不适合实时场景 |
| ClickHouse | 单表查询极快,列存压缩率高 | 多表Join能力弱,更新删除麻烦 | ❌ Join是硬伤 |
| Hadoop生态(Hive/Spark) | 生态丰富,能处理海量数据 | 组件太多,运维复杂,实时性差 | ❌ 太重了 |
| Apache Doris | MPP架构,支持实时写入,多表Join强,兼容MySQL协议 | 相对较新,生态不如老牌成熟 | ✅ 值得深入评估 |
我们按照以下《选型决策权重表》综合多维度进行评估:
| 评估维度 | 权重 | 传统数仓 | ClickHouse | Hadoop 生态 | Apache Doris |
|---|---|---|---|---|---|
| 实时写入能力 | 30% | 3 分 | 8 分 | 6 分 | 9 分 |
| 多表关联查询 | 30% | 9 分 | 4 分 | 8 分 | 9 分 |
| 运维复杂度 | 20% | 5 分 | 7 分 | 2 分 | 8 分 |
| 建设成本 | 15% | 2 分 | 8 分 | 5 分 | 9 分 |
| 生态适配性 | 5% | 7 分 | 6 分 | 10 分 | 7 分 |
| 综合得分 | 100% | 5.3 分 | 6.6 分 | 5.7 分 | 8.7 分 |
ClickHouse被排除的核心原因:智联工坊的经营分析场景需要大量多表关联查询(订单→工单→设备→物料),ClickHouse在多表Join场景下的表现确实不尽如人意。虽然单表查询快,但数仓的核心价值恰恰在于“把多张表关联起来分析”。
Hadoop生态被排除的核心原因:组件太多。Hive + Spark + HBase + Kafka + Zookeeper……运维团队只有3个人,维护这么一套东西,光是日常巡检就能把人累死。
最终进入决赛圈的,是Apache Doris。
补充说明:很多工厂跟风上 ClickHouse,最后发现订单、工单、物料的多表关联报表根本跑不动,又得花双倍成本重构。数仓的核心价值恰恰在关联分析,不在单表跑分。
三、为什么是Apache Doris?
Doris能打动我们的,是下面这几个点:
3.1 MPP架构 + 列式存储:查得快
Doris采用典型的Shared-Nothing MPP架构,所有节点对等,数据按Hash或Range分片存储。查询时,多个节点并行计算,最后汇总结果。
配合列式存储和向量化执行引擎,Doris在复杂分析查询上能做到亚秒级响应。
简单说就是:数据量再大,查询也不慢。
3.2 实时写入能力:写得快
传统数仓的痛点之一就是“写入慢”。数据要先ETL清洗、转换、加载,一套流程走下来,T+1是常态。
Doris支持秒级数据摄入,可以直接从Kafka消费实时数据流,也可以批量导入。设备传感器数据写入后,几秒钟就能查到。
简单说就是:数据来了就能查,不用等到明天。
3.3 多表Join能力强:分析深
这是Doris相比ClickHouse最大的优势。
Doris的MPP架构天生支持分布式Shuffle Join,多张大表关联查询时,数据会在节点间重分布,并行计算。ClickHouse在这个场景下就会比较吃力。
对于智联工坊这种需要“订单→工单→设备参数→质检结果”全链路追溯的场景,Doris的多表Join能力是刚需。
3.4 兼容MySQL协议:上手快
Doris兼容MySQL协议,意味着可以直接用MySQL的客户端、JDBC驱动、各种BI工具连接Doris。
团队不需要学习新的查询语言,直接用SQL就能干活。
3.5 运维简单:活少
Doris的架构相对简单,FE(Frontend)+ BE(Backend)两层,不像Hadoop生态那样动辄十几个组件。
扩容就是加机器、配参数、重启,几分钟的事。
这对只有3个人的运维团队来说,非常友好。
四、为什么是DolphinScheduler?
有了存储和查询引擎,还需要一个调度系统来管理所有的数据任务。
智联工坊的离线调度需求包括:
每天凌晨从业务系统同步数据到ODS层
ODS→DWD→DWS→ADS的逐层ETL任务
数据质量校验任务
报表生成任务
这些任务之间有依赖关系,需要按顺序执行,失败了要能重试,执行完了要能通知。
我们评估了几个调度方案:
| 方案 | 优点 | 缺点 | 结论 |
|---|---|---|---|
| Crontab + Shell脚本 | 简单直接 | 无依赖管理,无可视化,难运维 | ❌ 太原始 |
| Azkaban | 轻量级,Web界面 | 社区不活跃,功能有限 | ❌ 生态弱 |
| Apache DolphinScheduler | 可视化DAG,高可用,任务类型丰富 | 相对较新 | ✅ 最终选择 |
DolphinScheduler打动我们的几个点:
可视化DAG工作流设计:不需要写代码,在Web界面上拖拽组件就能定义任务依赖关系。ODS→DWD→DWS→ADS的依赖关系,画出来一目了然。
丰富的任务类型:支持Shell、SQL、Spark、Flink、DataX等十几种任务类型。智联工坊的ETL任务既有Hive SQL,也有Spark作业,还有DataX同步任务,都能在一个平台上调度。
高可用架构:多Master多Worker的去中心化架构,支持横向扩展,单节点故障不影响整体调度。
定时调度灵活:支持分钟、小时、天、周甚至Cron表达式,日批、小时批都能覆盖。
五、Doris + DolphinScheduler:一个“存储+计算+调度”的完整数据底座
把Doris和DolphinScheduler组合在一起,就形成了一个完整的数据平台底座,架构图如下:
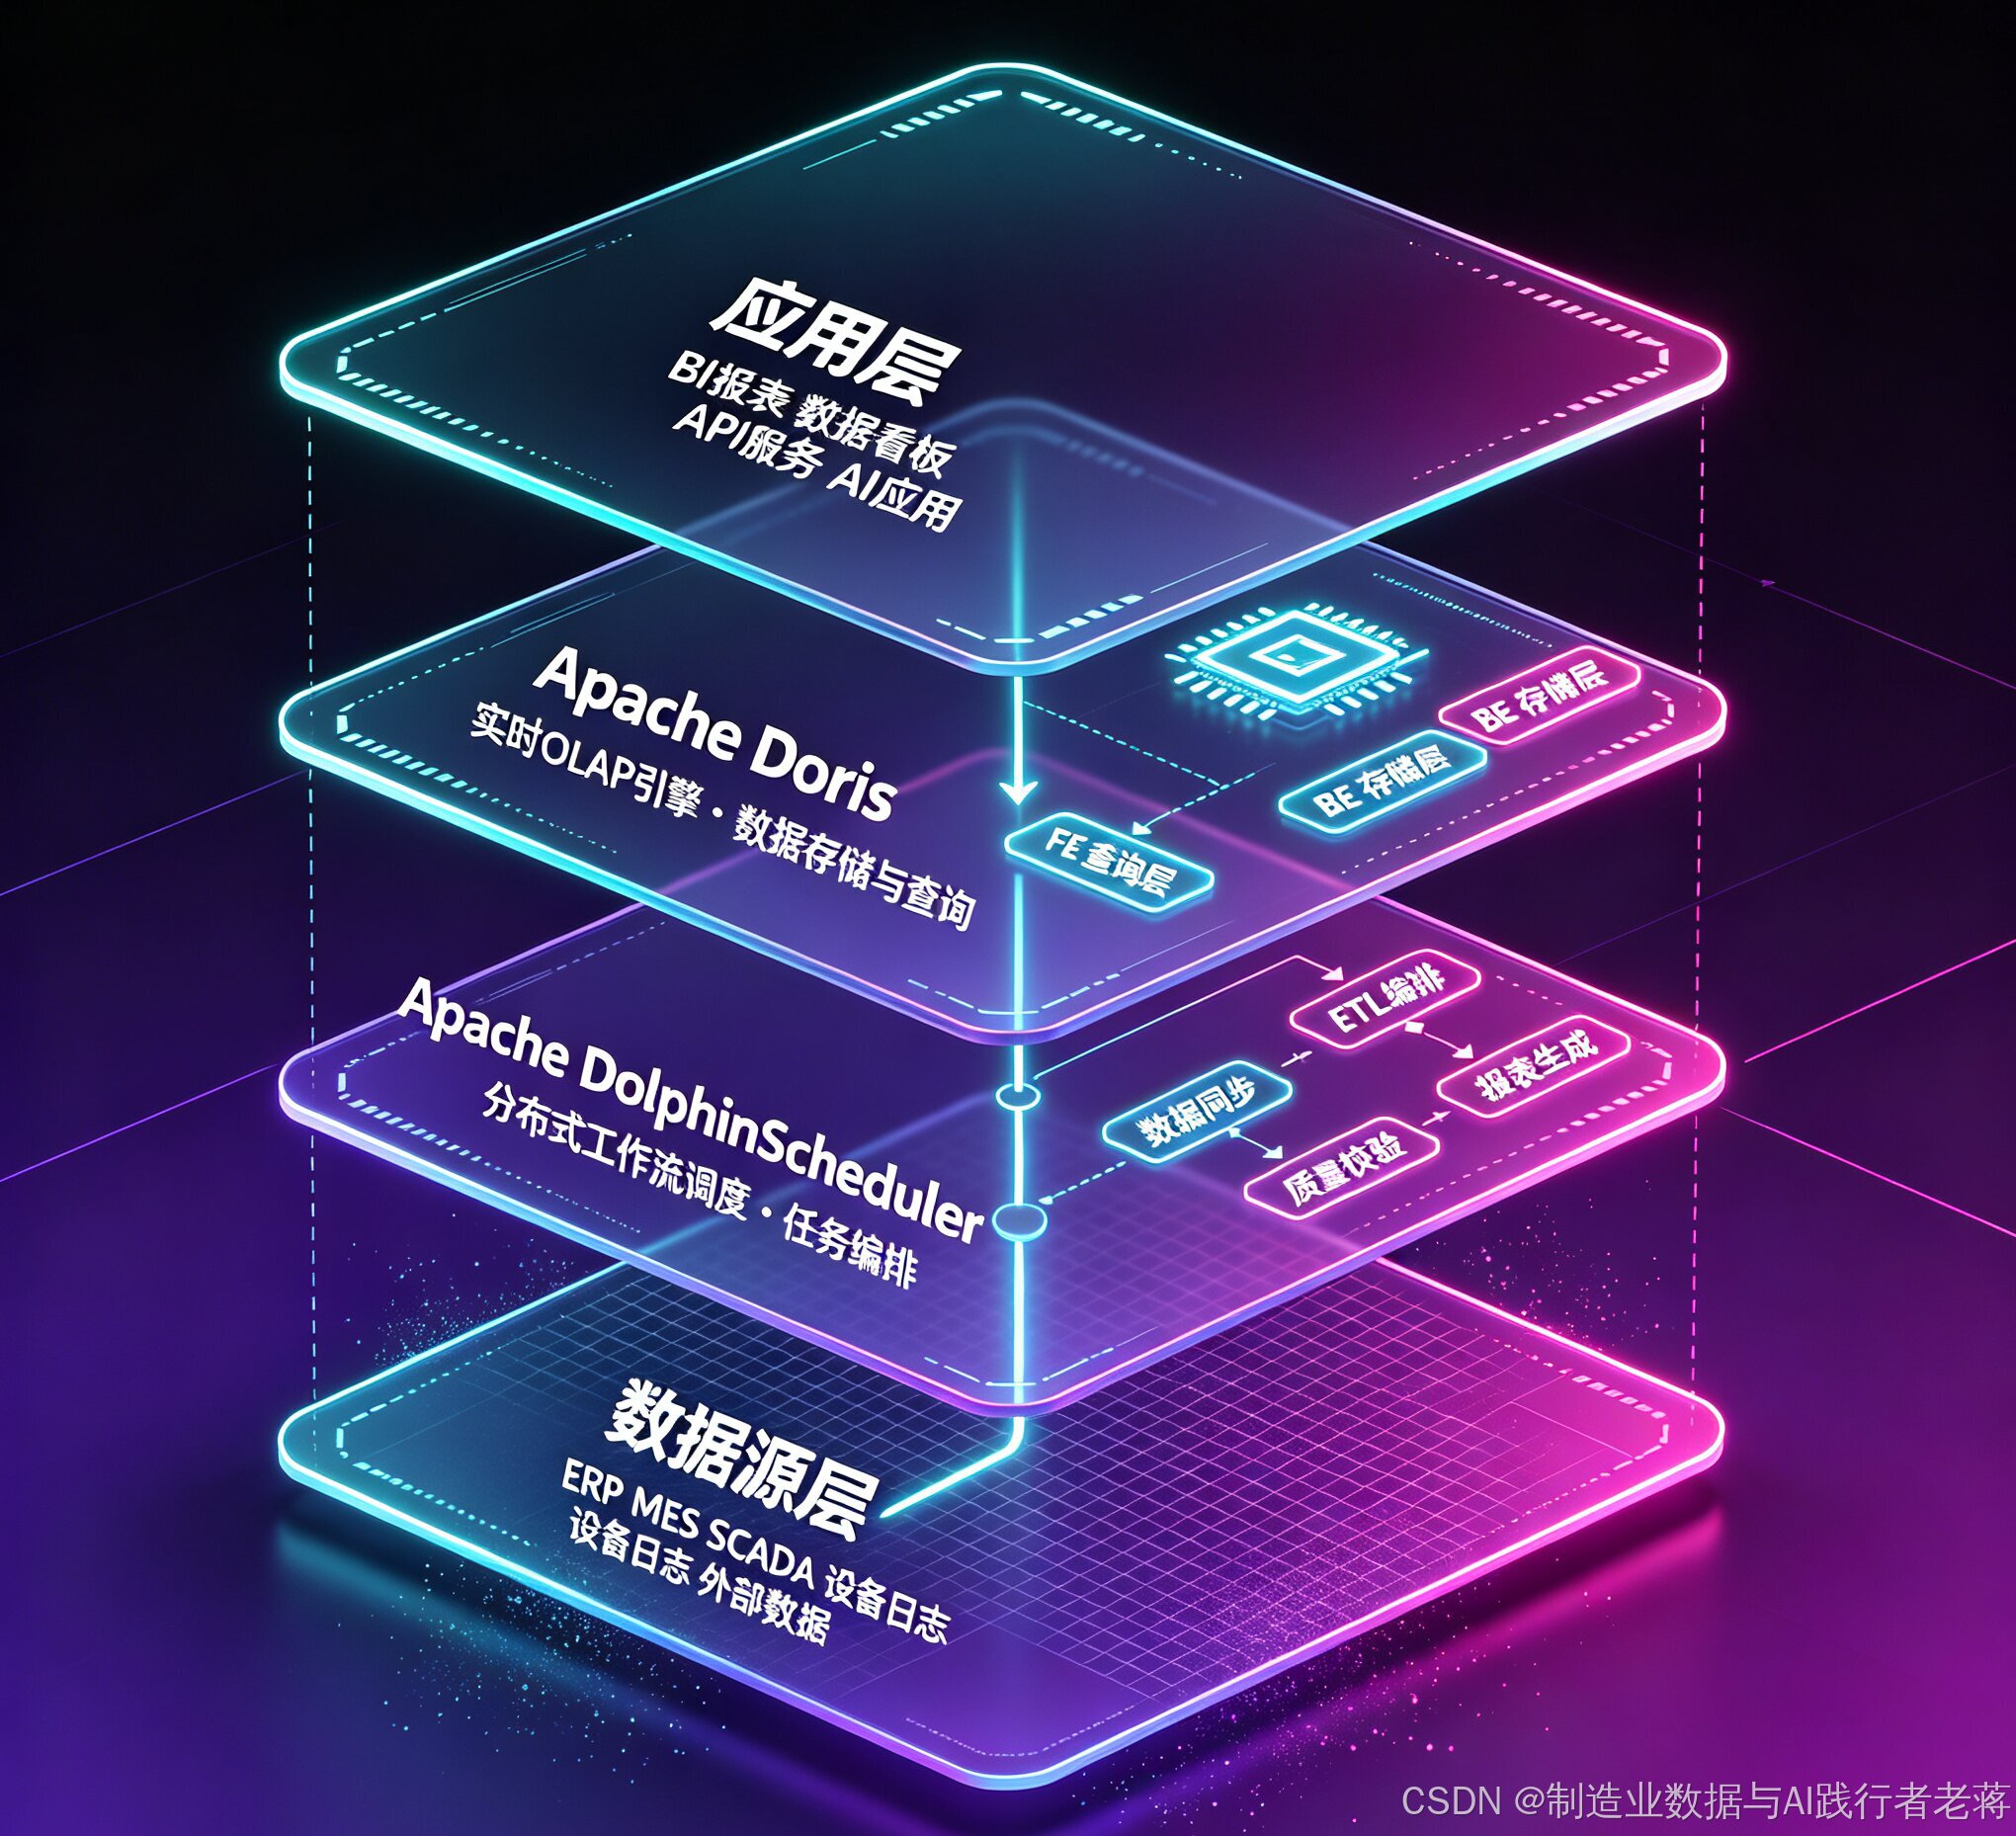
这个组合解决的核心问题:
| 需求 | 谁来承担 | 怎么实现 |
|---|---|---|
| 实时数据写入与查询 | Doris | 秒级数据摄入,亚秒级查询响应 |
| 复杂多表关联分析 | Doris | MPP架构支持分布式Shuffle Join |
| 离线ETL任务编排 | DolphinScheduler | 可视化DAG工作流,依赖管理 |
| 定时调度与监控 | DolphinScheduler | 灵活定时策略,高可用架构 |
| 统一运维 | Doris+DolphinScheduler | 组件少,架构简单,易扩展 |
六、部署实战:从零到跑通
6.1 环境准备
虚拟机配置:AlmaLinux 9.8 + 8核CPU + 16GB内存 + 100GB磁盘,Java 17。
关键前置步骤:
永久关闭Swap分区(Doris官方要求)
安装Java 17并正确设置
JAVA_HOME配置静态IP和国内镜像源
6.2 Doris部署验证
下载Apache Doris 4.0.8,配置FE和BE:
# FE配置
meta_dir = /opt/doris/doris-4.0.8/fe/doris-meta
priority_networks = 192.168.174.100/24

# BE配置
storage_root_path = /opt/doris/doris-4.0.8/be/storage
priority_networks = 192.168.174.100/24
启动后验证:
SHOW FRONTENDS\G;  -- isMaster = true, Alive = true
SHOW BACKENDS\G;   -- Alive = true
创建测试表并验证读写:
CREATE TABLE test_table (
    id INT, name VARCHAR(50), value INT
) DISTRIBUTED BY HASH(id) BUCKETS 1
PROPERTIES ("replication_num" = "1");

INSERT INTO test_table VALUES (1, 'test1', 100), (2, 'test2', 200);
SELECT * FROM test_table;  -- 返回2行数据
6.3 DolphinScheduler部署与MySQL持久化
部署Apache DolphinScheduler 3.4.2 Standalone模式。默认使用H2内存数据库,重启后数据丢失。
将元数据库切换到MySQL:
# application.yaml 配置
spring:
  datasource:
    driver-class-name: com.mysql.cj.jdbc.Driver
    url: jdbc:mysql://127.0.0.1:3306/dolphinscheduler?useUnicode=true&characterEncoding=UTF-8&useSSL=false
    username: ds_user
    password: Ds@2026#Secure
初始化表结构并重启服务,验证数据持久化生效。
6.4 集成验证:DolphinScheduler调度Doris SQL任务
创建数据源:测试连接成功 ✅
创建SQL工作流:执行建表、插入、查询,日志显示:
[INFO] row 1 : {"id":1,"name":"dolphin-test","create_time":"2026-08-23 11:56:18"}
[INFO] TaskExecutionStatus{code=7, desc='success'}✅定时调度验证:配置Cron表达式 0 0 2 * * ? *(每日凌晨2点执行),定时任务成功上线
✅复杂工作流验证:通过Conditions节点实现条件分支(数据质量检查成功→继续分析;失败→发送告警),DAG正确路由
✅参数传递验证:Shell任务算日期 → 通过 ${setValue()} 传递给SQL任务,下游成功接收参数
七、选型后的实际效果
目前智联工坊的数据平台已经基于这套架构在运行:
| 指标 | 效果 |
|---|---|
| 数据写入延迟 | 传感器数据写入后3-5秒可查 |
| 复杂查询响应 | 多表Join分析查询平均1-3秒 |
| 每日调度任务 | 200+个任务,由DolphinScheduler统一编排 |
| 运维人力 | 1人兼职维护,月均故障0次 |
| 存储成本 | 列式存储压缩比约5:1,相比行存储节省80%空间 |
这个组合不是最“炫”的,但确实是最适合智联工坊当前阶段的。
💡 方案适用边界
- 适配场景:中小规模离散制造企业,数据量百 TB 级以内,核心需求为实时监控、经营分析、质量追溯,运维团队人力有限
- 不建议场景:PB 级超大规模数据湖、极复杂的多源异构数据融合、深度机器学习训练为主的场景
总结:选型的核心逻辑是“匹配”,不是“追新”
怕你忘了,我再啰嗦一遍😀😀😀 技术选型的核心不是选“最好的”,而是选“最匹配的”。 智联工坊选择Doris+DolphinScheduler,不是因为它们是最新最火的技术,而是因为它们刚好能覆盖我们的核心需求,同时运维成本可控。
三个核心认知:
实时写入 + 复杂查询 + 简单运维,三者能同时满足的方案不多。 Doris的MPP架构+列式存储+MySQL协议兼容性,在这三个维度上取得了很好的平衡。Doris 4.0还新增了向量索引、AI函数等能力,面向AI时代的数据挑战已经做好了准备。
调度系统是数据平台的“隐形骨架”。 很多人只关注存储和查询引擎,忽略了调度系统的重要性。DolphinScheduler的可视化DAG和丰富任务类型,让ETL任务的编排和维护变得简单可控。
开源组件的组合拳,可以替代昂贵的商业软件。 Doris + DolphinScheduler + DataX的组合,基本覆盖了商业数据平台80%以上的功能,成本却是后者的零头。
智能工厂对标:本方案对应GB/T 39116-2020中“数据资源”能力域(辅域)——实现制造企业多元化数据资产的统一存储、高效查询与自动化调度管理。
系列导航
-
系列传送门: 【制造业数据与AI落地实战】 【WorkBuddy工作场景应用实践】 【AI赋能数据开发工程手册】
【热榜文&精品推荐】
TOP1、我用 WorkBuddy 分析了 30 篇 CSDN 博客,发现 3 个反直觉的流量真相
TOP2、还在翻 git log 写周报?WorkBuddy 一键生成结构化周报
TOP3、老攻城狮的AI开发环境搭建全记录:从零到跑通本地大模型(一日速通版)
TOP4、LangChain Agent 反复调用工具死循环?结构化返回 + Prompt 规则
TOP5、智联工坊实战:多工具协同Agent,让AI像人类一样规划与执行复杂任务
TOP6、代码审查不想得罪人?WorkBuddy 先做第一轮审查
互动与交流
你在数据平台选型中踩过哪些坑?是选了ClickHouse后发现Join跑不动,还是上了Hadoop全家桶后被运维拖垮?欢迎评论区分享你的选型经历,咱们一起避坑——说实话,选型这件事,选错了真的会后悔很久。
关于作者
制造业数据与AI践行者老蒋,23年IT老兵。聚焦制造业数据架构与AI融合落地。全流程实战,全源码开源。
标签:#制造业数据 #数据架构 #Apache Doris #DolphinScheduler #数仓选型 #实时数仓 #OLAP #大数据 #智能制造


 扫一扫


 249


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


