



小模型时代:当效率重新定义智能
4B参数模型把Postgres官方优化器甩在身后。DeepSeek v4.1 Flash登顶开源编码榜单。三元量化突破坚守了12年的1.58-bit理论屏障。三件事发生在同一周——不是巧合,是一条技术轨道的必然交点。
引言
2026年9月中旬,三件看似无关的事件在同一天冲击了AI社区的技术讨论:
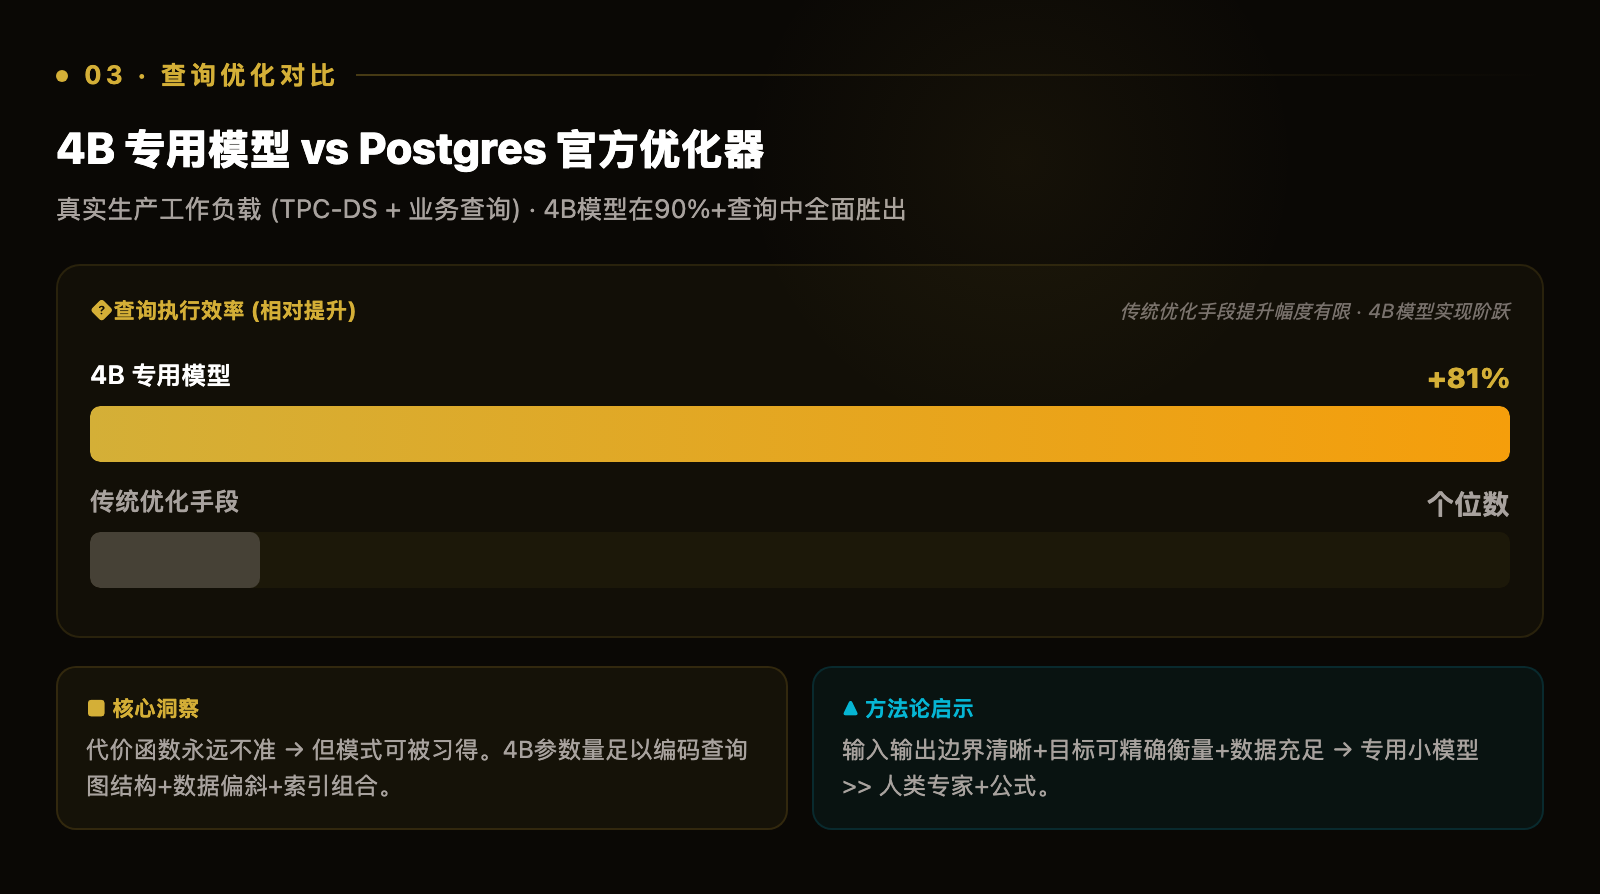
- 4B参数模型在Postgres查询规划上超越官方优化器81% — 历经40年迭代的代价公式被一个「tiny model」系统性击败
- DeepSeek v4.1 Flash登顶开源编码榜单 — 不是最强参数,而是在特定任务甜点精准卡位
- 三元量化突破1.58-bit理论屏障 — 乘法可以消失了,端侧推理的最后拼图到位
这三件事的共同指向,不是「AI正在变得更强」,而是「AI正在变得更精准、更高效、更可信」。本文将从工程实践和理论基础两个维度,解析这场「效率革命」的结构性含义。
一、4B参数 vs 40年工程积累:查询优化的新范式
1.1 Postgres的代价函数困境
Postgres查询优化器的核心方法论是基于代价的优化(CBO):根据表的统计信息(行数、唯一值数量、数据分布直方图)估算不同执行计划的I/O、CPU、内存代价,选择最低者。
这套方法论统治了数据库系统设计超过半个世纪。它的根本问题是:代价函数只能逼近真实代价,永远无法精确。 原因有三:
- 统计信息总是过期的 — 数据在写入和更新,直方图只能定时刷新
- 相关性被忽略 — 列A和列B的联合分布难以用单列统计捕捉
- 硬件行为被简化 — CPU缓存、预取、SIMD等微架构特性很少计入代价模型
1.2 4B模型的差异化路径
HN社区热议的这项研究走了一条完全不同的路:不写代价函数,直接让模型从大量「(查询文本 + 数据统计)→ 最优执行计划」的样本中学习映射。
# 概念示意:小模型查询规划
def predict_plan(query_sql: str, table_stats: dict) -> ExecutionPlan:
    """
    4B模型接收查询和统计信息作为输入
    输出预测的最优执行计划
    """
    inputs = tokenize(query_sql, table_stats)
    plan_logits = small_model(inputs)  # 4B参数
    return decode_plan(plan_logits)
为什么4B参数足够?因为查询规划的核心复杂度来源于:
- 查询图的结构特征(join顺序、谓词选择性)
- 数据分布偏斜(zipf分布、热点行)
- 索引组合模式(哪些索引组合有效)
这些信息可以被编码为适中的特征维度,4B参数的容量足以覆盖。
1.3 启示:什么问题适合小模型替代?
| 条件 | 说明 |
|---|---|
| 输入输出边界清晰 | 代码→代码,查询→执行计划,不存在模糊边界 |
| 训练数据充足 | 大量真实工作负载日志可用 |
| 目标函数可精确衡量 | 查询延迟、测试通过率、benchmark分数 |
当这三个条件同时满足时,专用小模型系统性地优于「人类专家 + 数学公式」。
二、三元量化突破1.58-bit:乘法的消失
2.1 信息论的底数
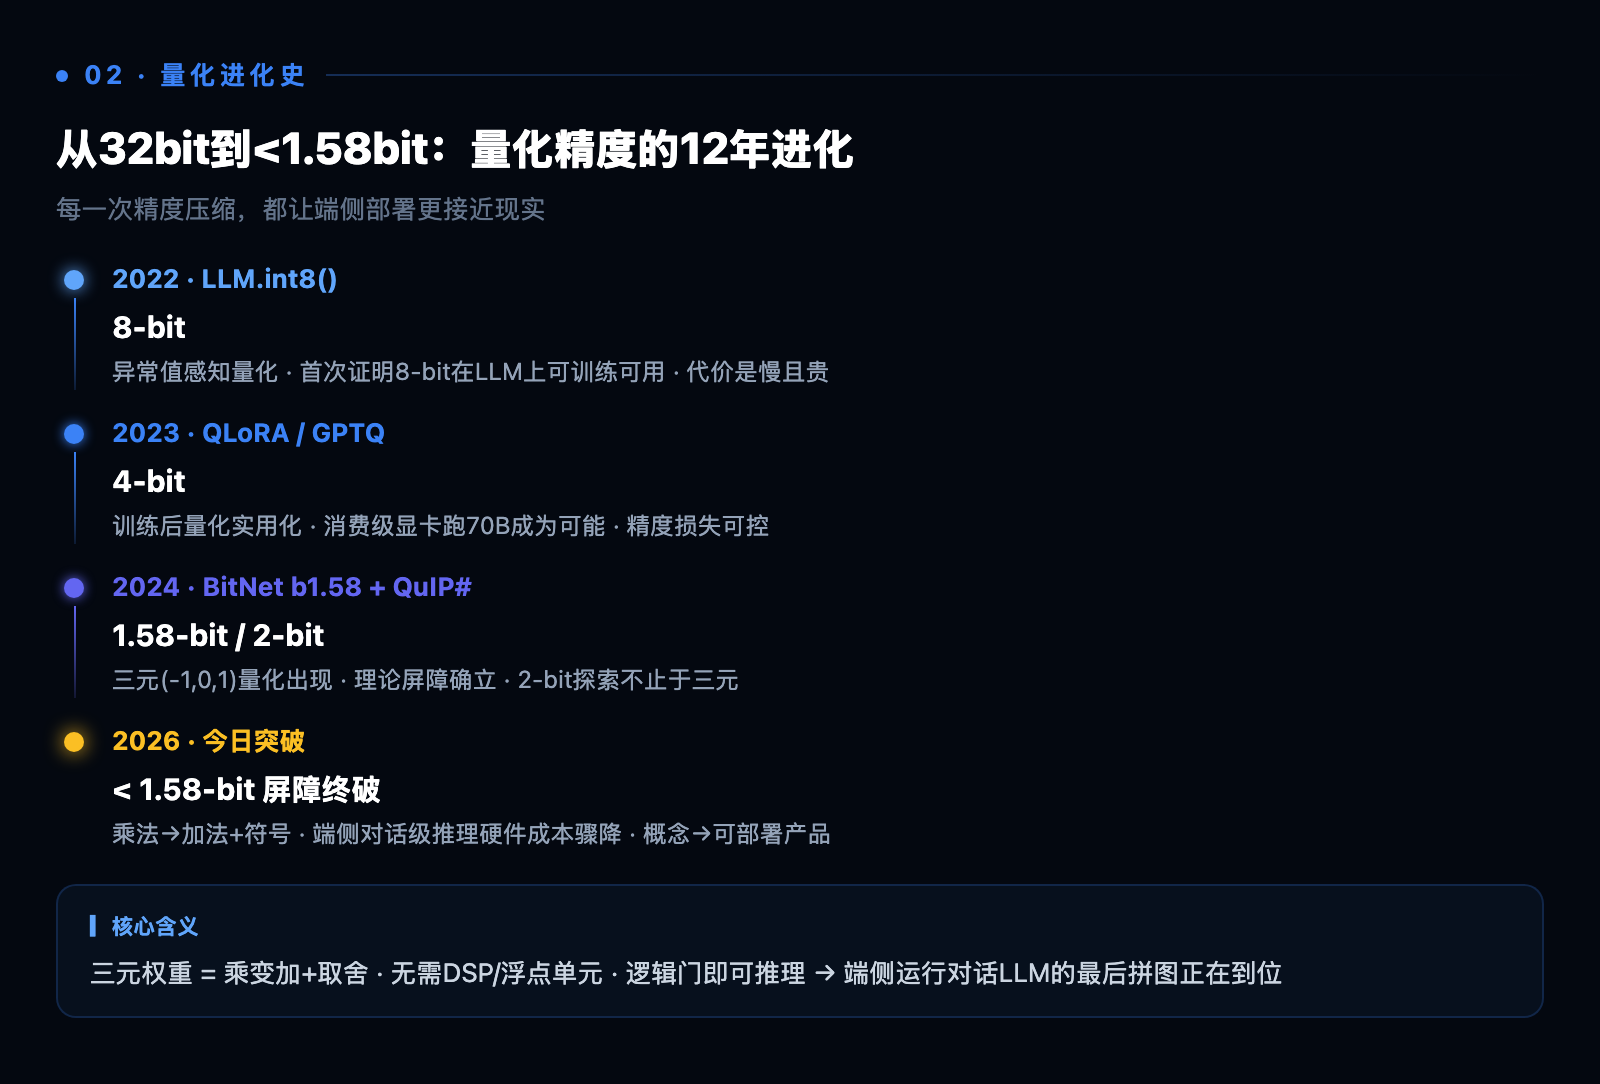
1.58-bit不是一个随意数字。三值变量(-1, 0, +1)的信息熵为:
H = log₂(3) ≈ 1.585 bits
这是三元权重表达力的理论上限。今天的突破将实际可部署精度压到了1.58-bit以下。
2.2 乘法消失意味着什么
传统神经网络推理中,矩阵乘法是计算能耗的绝对主体。以FP16矩阵乘法为例,一个N×N乘法的能耗约为对应加法的10-20倍(取决于实现工艺)。
三元权重的本质是:乘法简化为符号判断。
# 传统: result = input * weight
# 三元量化后:
#   weight = +1  → result =  input      (无需乘法)
#   weight =  0  → result =  0          (无需计算)
#   weight = -1  → result = -input      (无需乘法,仅取反)
没有了乘法器、没有了浮点单元、甚至不需要DSP——逻辑门即可完成推理。这不是一种渐进式改进,而是计算范式级别的跃迁。
三、Flash的卡位术:从参数规模竞争到精准度竞争
DeepSeek v4.1 Flash登顶开源编码榜单的技术细节,直接指向了行业结构的转型。
3.1 Flash的甜点定位
| 任务类型 | 复杂度 | Flash表现 |
|---|---|---|
| 函数补全 | 中 | ⭐⭐⭐⭐⭐ |
| Bug修复 | 中 | ⭐⭐⭐⭐☆ |
| 架构设计 | 高 | ⭐⭐⭐☆☆ |
| 跨文件重构 | 中 | ⭐⭐⭐⭐☆ |
Flash的设计哲学不是「成为最强」,而是「在对的地方精准最强」。
3.2 小模型时代的含义
- 不是一刀切替代,而是精准重组:每个任务匹配最优规模的模型
- 不是参数竞赛,而是效率竞赛:更快、更便宜、更可靠
- 端侧部署成为常规:三元量化使手表级设备运行对话模型成为现实
四、Dream-RSI的诚实与自改进的遥远
arXiv论文Dream-RSI探索了一条与炒作截然不同的路径:不直接修改模型权重,而是在自生成的虚拟环境中反复练习。
其实验结果显示:改进曲线是对数型的——先快后慢,渐近收敛。这与「能力爆炸」「奇点将至」的叙事形成鲜明对比。
Dream-RSI与4B优化器构成了一组绝妙的对照:
- 抽象任务(如通用推理):对数级进步,收敛缓慢 → Dream-RSI
- 具体任务(如查询优化):戏剧性碾压,效果显著 → 4B优化器
它们画出了AI能力的真实边界:在可定义的问题上强得不可思议,在开放式的问题上慢得令人发急。
五、PS5 Linux事件:放大器的两副面孔
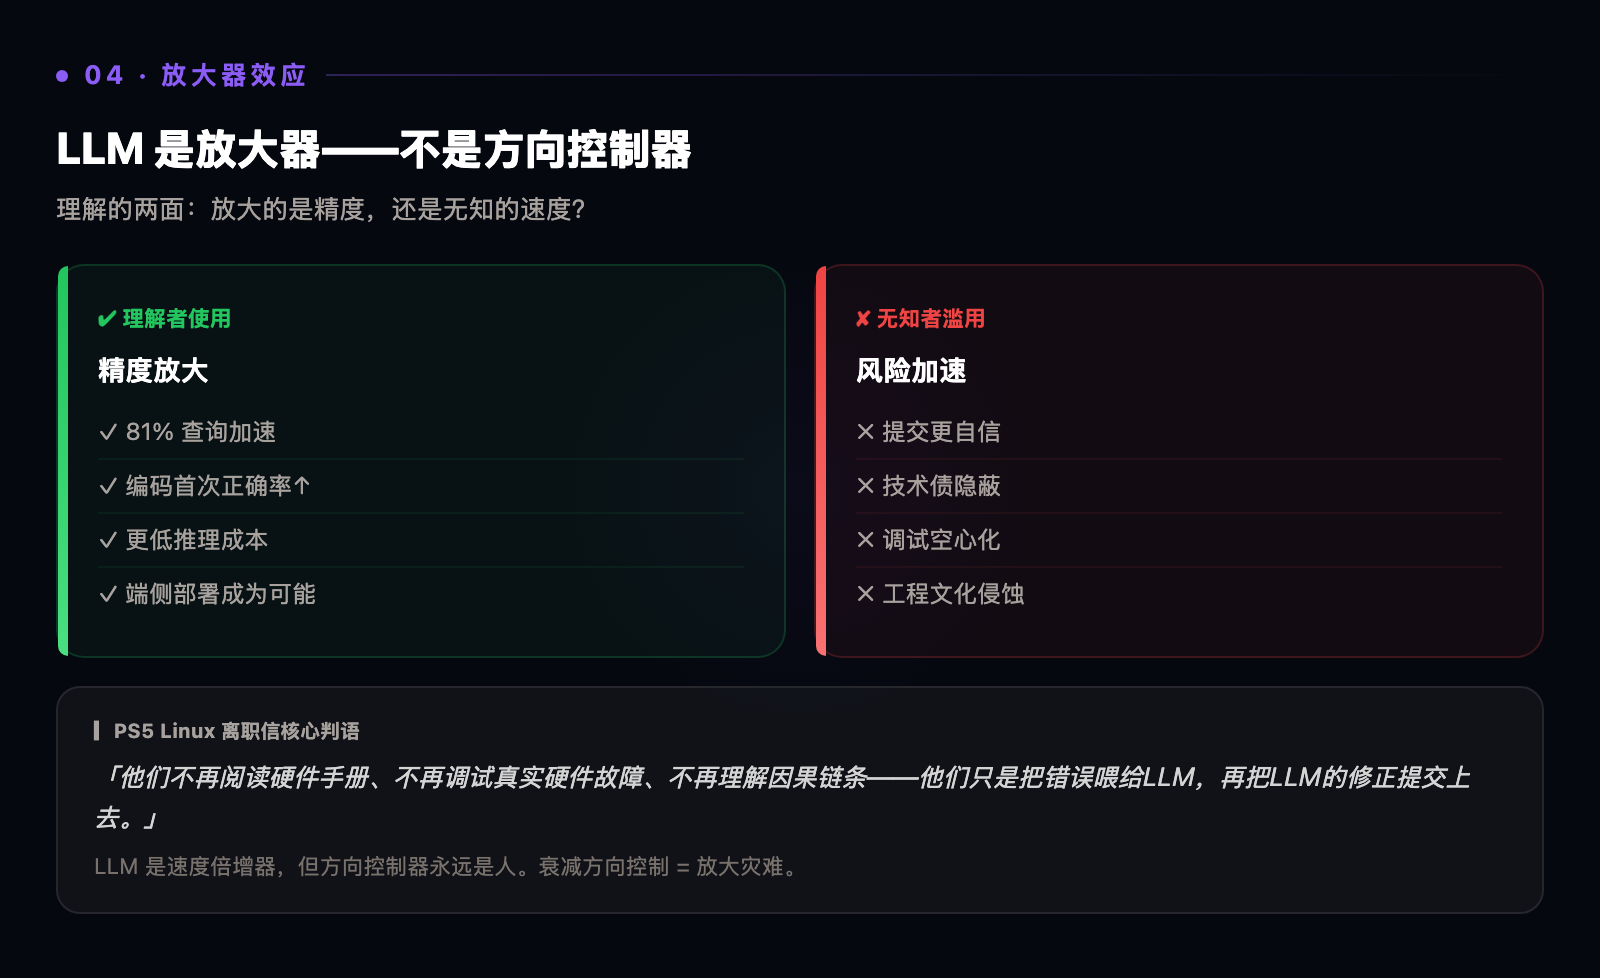
在所有本期新闻中,最具工程方法论价值的不是任何论文,而是PS5 Linux负责人的离职信。
他的核心判语可做如下技术化表述:
LLM映射 f: understanding → output_quality 满足:当input_understanding↑,output_quality↑;当input_understanding→0,output_quality的方差↑但偏度→负值。
简单来说:LLM放大了理解者的能力,也放大了无知者的自信。
六、工程师实操建议
6.1 模型选择策略
- 函数补全、日志分析等边界明确任务 → 小模型(Flash级别)
- 架构设计、跨系统调试等开放决策 → 大模型 + 人工判断
- 终端设备推理 → 三元量化后的1-3B模型
6.2 API安全防护清单
| 防护动作 | 优先级 | 说明 |
|---|---|---|
| 密钥定期轮换 | P0 | GitHub泄露后的止损底线 |
| 设置用量告警 | P0 | 异常消耗10分钟内感知 |
| Agent调用频率限制 | P1 | 防止死循环烧完配额 |
| 环境变量管理密钥 | P1 | 预防硬编码泄露 |
| 审计Agent代码 | P2 | 发现隐藏的循环调用 |
6.3 理解力投资
在AI助手时代,比「会用AI」更重要的是「能判断AI的输出是否正确」。这需要:
- 持续投资于你所负责系统的底层理解
- 关键决策时亲自验证AI的推理链条
- 保持调试AI输出(而非只是接受AI输出)的技能
结语
4B胜Postgres、三元量化破极限、Flash登顶开源编码、Dream-RSI的诚实探索——它们的共同主题是:下一代AI的进步来自更聪明的精度分配,而非更大的参数规模。
效率革命的引擎正在切换。在工程实践中,这意味着从「永远用最贵的模型」转变为「精确匹配任务的规模和精度」。时代的引擎正在切换——你换档位了吗?


 扫一扫


 336

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


