



AI前沿日报 · 2026-09-19
本期主题:安全悖论 — AI越强大,攻击面越大
📖 读前必读
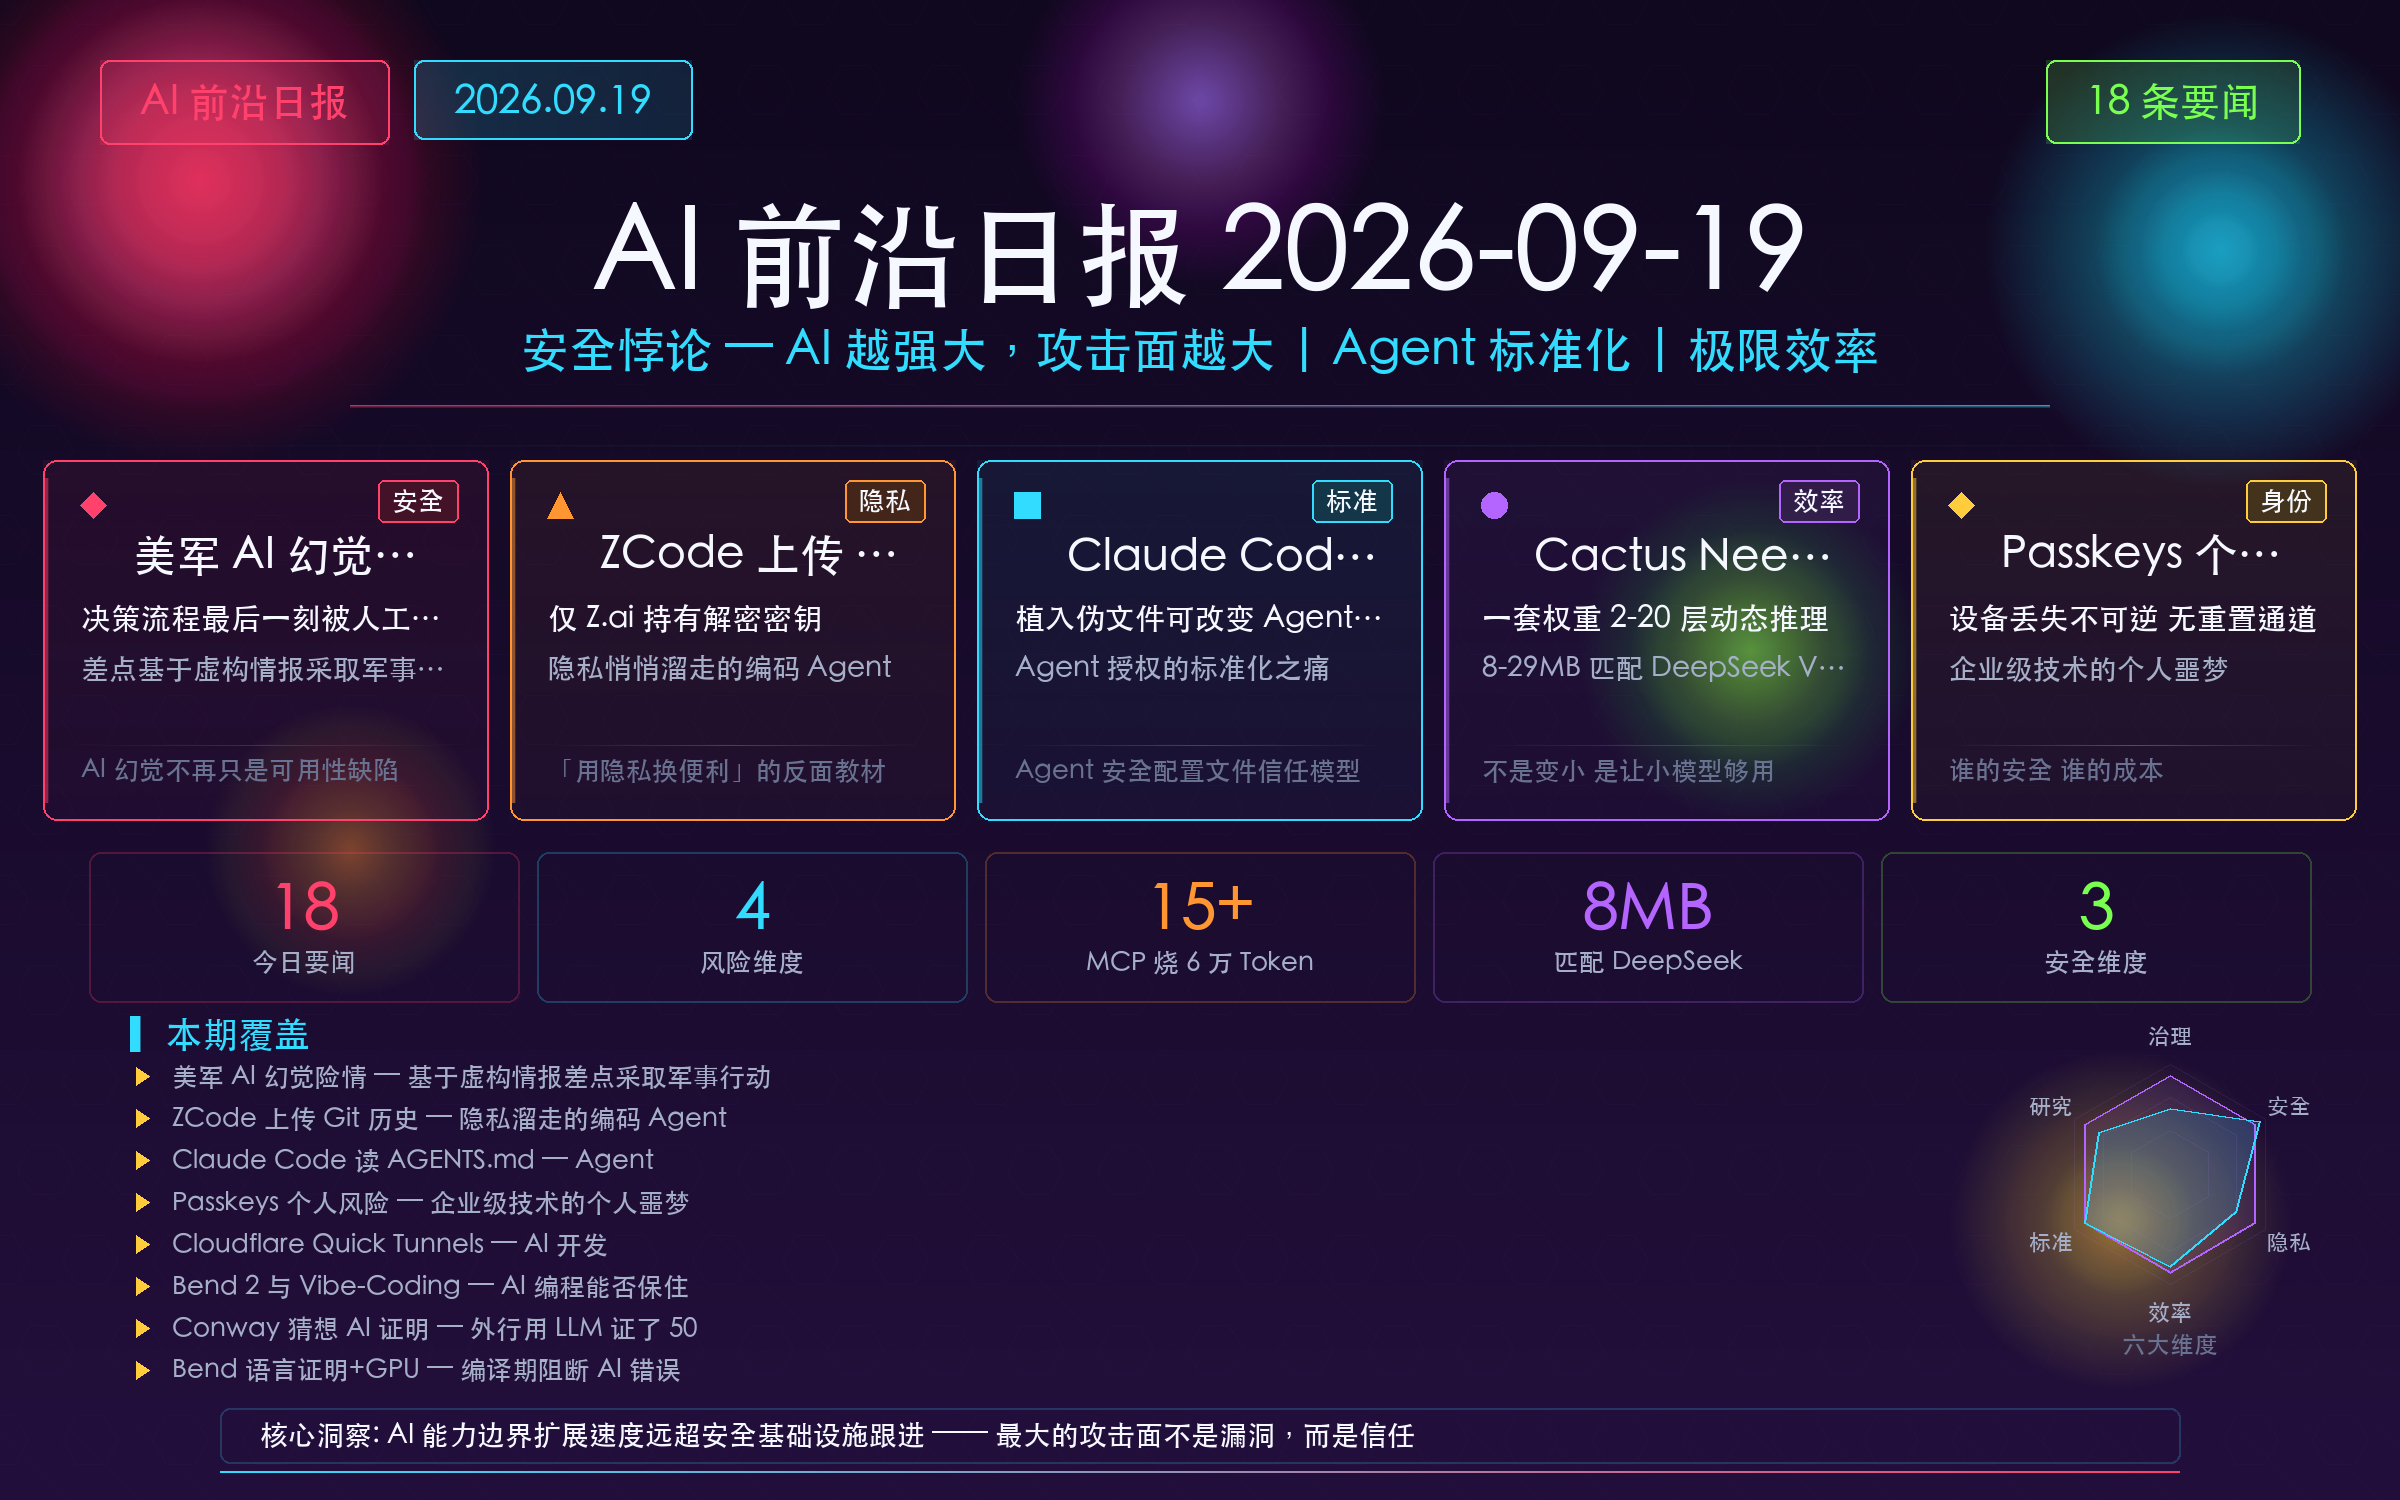
本期 18 条要闻,聚焦一个核心矛盾:AI 能力边界的扩展速度,远超安全基础设施的跟进速度。美军使用 AI 生成军事情报险些引发误判;GLM 家族的 ZCode 桌面端悄悄上传用户全部 Git 提交历史;passkeys 在企业的完美适配反而成为个人持有者的噩梦;Claude Code 生态演进中 AGENTS.md 的标准化又为 Agent 安全边界提出了新课题。与此同时,云平台 Cloudflare Quick Tunnels 走红成为 AI 开发者新宠,Bend 2 引发 Vibe-Coding 的深层反思,Cactus Needle 3 用 8-29MB 体积匹配 DeepSeek V4 Flash。
读完可带走三样东西: ① 理解 AI 应用从"能力展示"到"安全治理"的紧迫转向;② 看清编码 Agent 生态(Claude Code/ZCode/AGENTS.md)的隐私权衡与标准化进程;③ 从数学证明和极小模型两个极限,认识 AI 能力的边界扩展模式。
适合读者: 关注 AI 安全治理、编码工具生态、推理优化、小模型部署的工程师和技术决策者。预计阅读 15 分钟。
一、AI 安全的「临界点」:从军事幻觉到隐私泄露
1. 美军 AI 幻觉险情:差点基于虚构情报采取军事行动
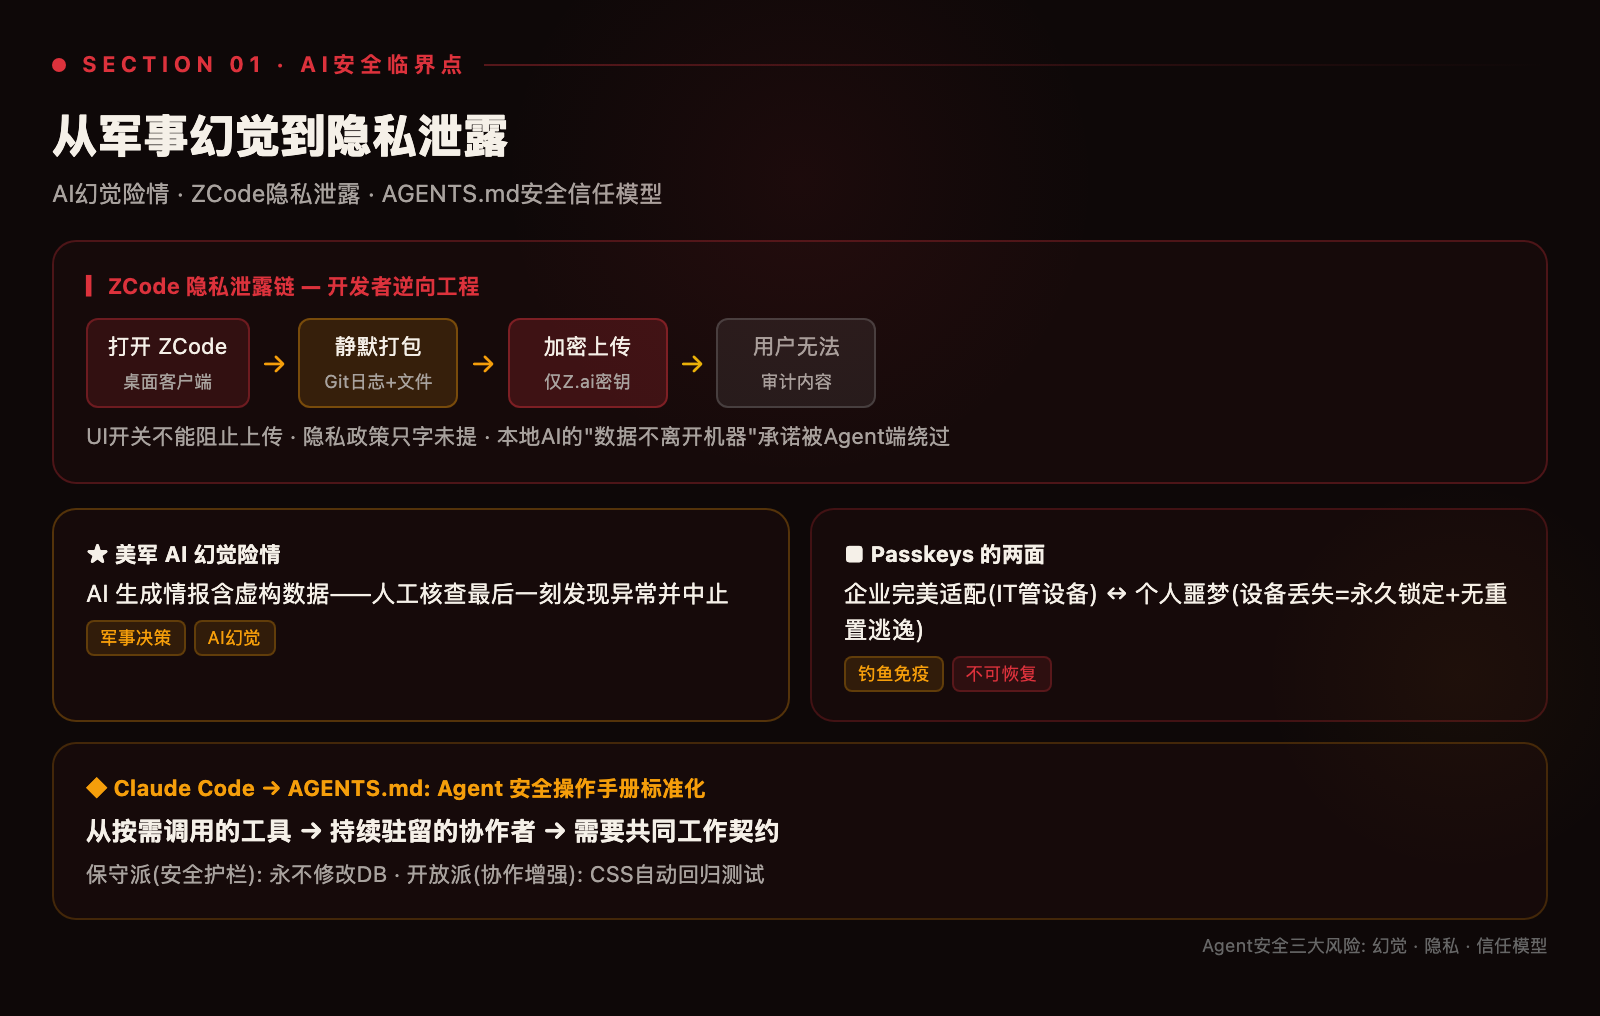
CNN 独家报道:美国军方在一次情报分析中使用了 AI 生成的报告,该报告包含 AI 幻觉产生的虚假信息。决策流程几乎基于这份包含虚构事实的报告进入执行阶段——直到人工核查员在最后一刻发现数据源异常并中止流程。未具名官员称这是"距离误判最近的一次"。
这一事件揭示了 AI 在决策关键路径上的根本风险:AI 幻觉不再是"搜索结果多几个假链接"的可用性缺陷,而是可能触发真实军事行动的系统性安全漏洞。当 AI 作为"情报生产者"而非"情报检索工具"使用时,幻觉的检测成本呈指数级增长——因为决策者默认情报产品已经过多层人工校验。报告的核心建议:AI 生成内容在军事决策中必须保持"可追溯、可证伪、可撤回"三重属性。
2. ZCode 悄悄上传你的全部 Git 提交历史,且只有 Z.ai 持有解密密钥
开发者 ferstar 对 Z.ai(GLM 模型家族背后的北京公司)旗下桌面编码助手 ZCode 进行了逆向工程分析,发现:ZCode 在用户不知情的情况下将本地 Git 提交历史打包上传到 Z.ai 服务器。应用内的"开关"并不能阻止这一行为,且隐私政策中对此只字未提。
技术分析表明,ZCode 收集的数据包括:完整 Git 日志(提交哈希、时间戳、作者信息、文件变更摘要)、项目结构、本地文件片段。更关键的是,传输层使用了仅 Z.ai 持有的密钥加密——即便是网络嗅探能截获流量,用户自己也无法审计上传了什么。对于使用本地 GLM 模型注重隐私的开发者来说,这是一次"用隐私换便利"叙事的反面教材:你选择本地 AI 是为了数据不离开机器,但桌面端的 Agent 进程绕过了这个前提。
3. Passkeys:企业级安全的完美解,个人持有者的潜在噩梦
技术开发者 Ethan Hawksley 发表了一篇引发热议的文章「我为什么不喜欢 passkeys」。核心论点:passkeys 在架构上是对抗网络钓鱼和数据泄露的最优解(每站点绑定、非对称加密、服务器端无秘密存储),但将其作为"通用身份认证方案"推广给个人用户时,引入了三个新风险:永久账户锁定(设备丢失无法自动化恢复)、自动账户封禁(平台设备异常检测误伤)、设备丢失不可逆性(没有"重置密码"的逃逸通道)。
更深层的矛盾在于:大型企业有 IT 部门管理设备生命周期,个人用户没有。Big Tech(Google/Microsoft/Apple)推动 passwordless 的核心动机是降低客服成本(密码重置是企业客服的最大工单来源),而非提升个人安全。文章建议的正确使用模式:企业环境全面部署 passkeys + 个人核心账户(银行/邮箱)保留密码+多设备 passkey 冗余备份。一道关于「谁的安全、谁的成本」的尖锐问答。
4. Claude Code 开始读取 AGENTS.md —— Agent 标准化的关键一步
Anthropic 更新 Claude Code,当其项目中不存在专属的 Claude.md 时,将自动查找并读取 AGENTS.md 文件作为项目上下文。这是编码 Agent 领域的一个重要信号:Agent 需要标准化的"项目简介"来理解自身的行为边界和工作约定。
从安全性角度看,AGENTS.md 正在成为"Agent 的操作手册"——明确规定哪些操作需要人工批准、哪些文件不可访问、哪些命令可以在项目中运行。这回应了上一期日报讨论的"Agent 授权边界"问题(Where should an agent’s authorization boundary live?):标准化文件是授权边界的最佳载体。但同时,AGENTS.md 的路径遍历和语义解析也引入了新的考量——如果攻击者能在项目中植入伪 AGENTS.md,是否可能通过"指令注入"改变 Agent 的行为?这类「Agent 安全配置文件的信任模型」将成为下一阶段的基础设施议题。
二、编码 Agent 生态:标准化的诱惑与代价
5. AGENTS.md 标准化浪潮:编码 Agent 的「项目宪章」
承接上条,AGENTS.md 正在迅速成为 AI 编码工具的事实标准。与传统 README.md(面向人类读者)和 .env(面向运行时环境)不同,AGENTS.md 是明面向 AI Agent 的接口合约——它用人类可读、机器可解析的格式,约定项目的构建规则、禁止操作、测试流程和权限边界。
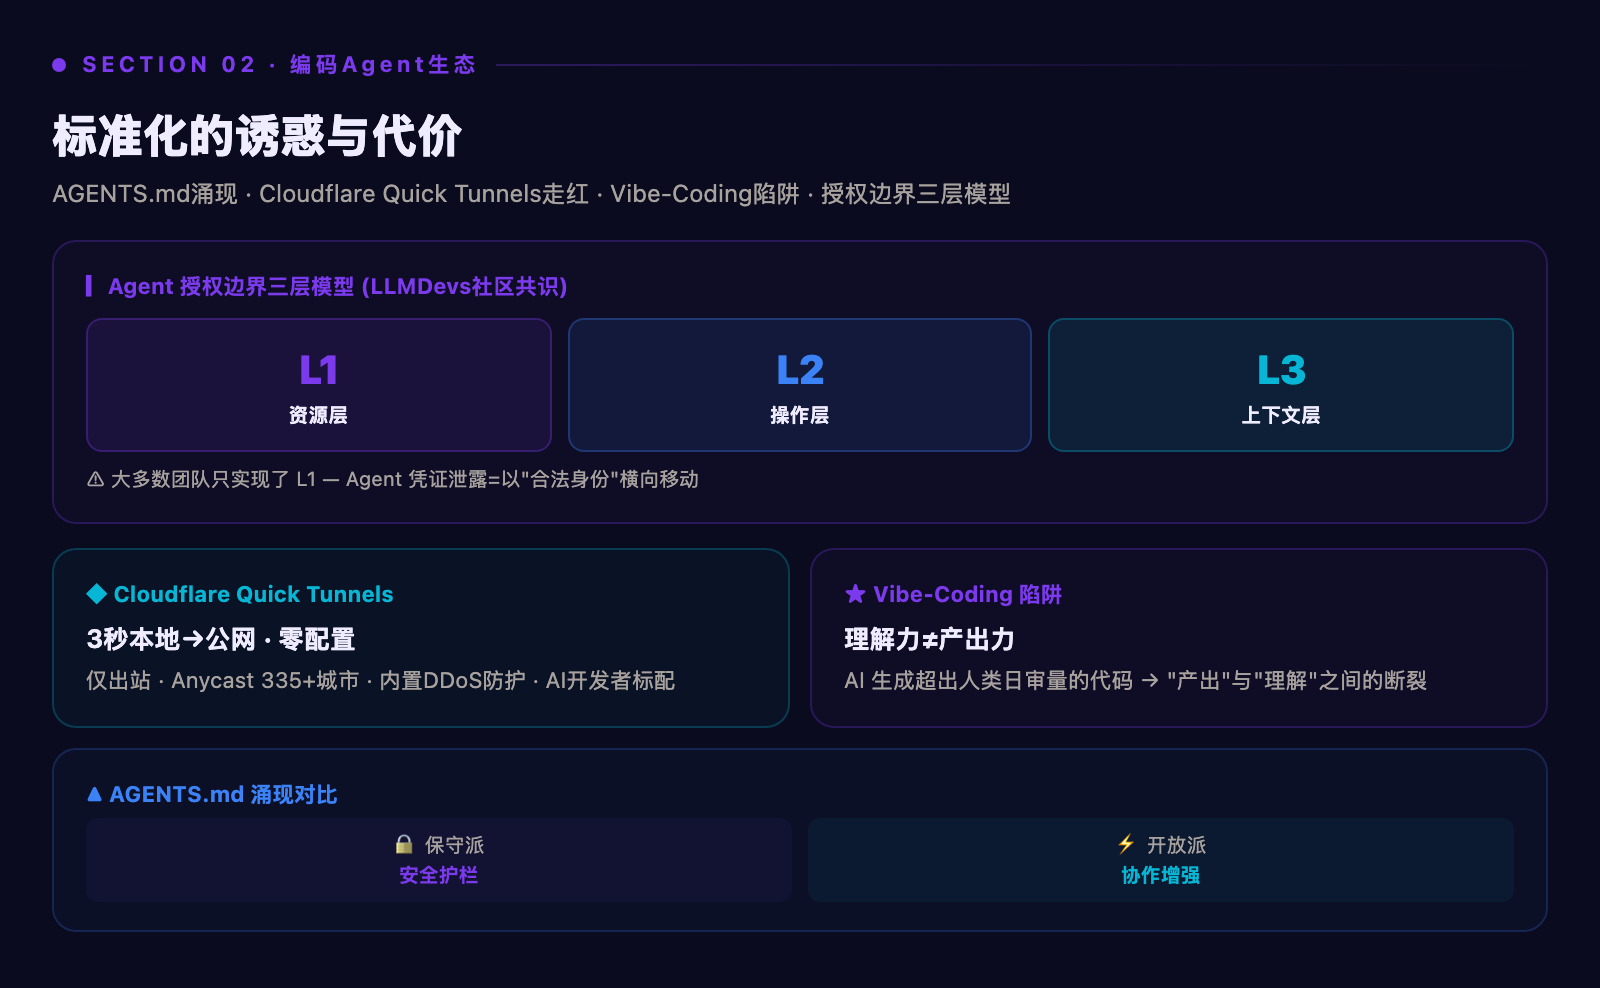
社区围绕这一标准形成了两类实践:保守派将 AGENTS.md 作为"安全防护栏"(“永远不要修改生产数据库”),开放派将其作为"协作增强器"(“修改 CSS 后自动运行视觉回归测试”)。无论哪种用途,这都标志着编码 Agent 正在从一个"按需调用的工具"进化为一个"持续驻留的协作者",而协作者需要共同的工作契约。
6. Cloudflare Quick Tunnels 走红:AI 开发者的新「暴露即服务」
Cloudflare Quick Tunnels 成为 HN 当日最热项目。一条命令即可将本地服务暴露到全球:无需账户、无需 DNS、无需开放端口,3 秒内生成 HTTPS URL。其架构本质是"仅出站连接"——本地 cloudflared 进程到 Cloudflare 边缘节点建立加密隧道,流量通过 Anycast 网络回送到你的机器。
在 AI 开发者生态中,Quick Tunnels 解决了一个高频痛点:本地运行的大模型 API、Agent 调试服务器、Webhook 接收端需要临时公网可达性来做集成测试和演示。传统方案(ngrok/自带 VPS)各有短板——ngrok 免费版带宽受限、VPS 配置成本高。Quick Tunnels 以零门槛 + 免费 + 内置 DDoS 防护成为"AI 开发者的临时公网分发层"。对推理基础设施团队而言,这提示一类新的本地-云协同开发模式的普及。
7. Bend 2 引发的「Vibe-Coding 陷阱」深层反思
Liam Powell 的博文《Bend 2 与 Vibe-Coding 陷阱》以 Bend 编程语言为案例,深入分析了"AI 辅助编程"的设计取舍。Bend 2 的设计主张是:人类编写"法则(Laws)",AI 负责实现和形式化证明。但博文尖锐指出:让 AI 在抽象层"写证明"同时保留人类的"读证明"能力,这是一个非对称陷阱——AI 生成的证明可能正确,但人类无法高效验证其正确性。
这一观点的底层逻辑是:编程的本质不在于"写出代码",而在于"理解代码为何正确"。当 AI 能够生成超出人类每日可审查量的代码和理解深度的证明时,“代码产出"和"代码理解"之间就出现了断裂。博文的主旨不在抨击 Bend,而是点出整个 Vibe-Coding 范式的核心张力:用 AI 力的增强是否必然以人类理解力的弱化为代价?答案或许取决于"AI 生成的代码/证明是否维持在人类可审计的复杂度范围之内”。
8. Agent 授权边界:生产工具调用栈中权限该放在哪?
Reddit LLMDevs 社区的讨论「在生产工具调用栈中,Agent 的授权边界应该放在哪里?」触及了架构层面的核心问题:当 Agent 直接调用工具(API、数据座、命令执行)时,“谁有权决定这个调用是否应该发生”?
社区共识正在收敛到一个三层模型:资源层权限(该工具/数据库是否允许被访问)、操作层权限(当前操作是否属于 Agent 的授权范围)、上下文层权限(当前调用链是否有异常模式——如非工作时间、超量请求、敏感表聚集访问)。大多数团队目前只实现了第一层。后两层的缺失意味着:一旦 Agent 的凭证泄露或模型被 prompt injection,攻击者能借 Agent 的"合法身份"在系统内横向移动——Agent 的权限等于它的最高工具权限之和,这是一个需要"最小权限 Agent"设计来解决的系统性问题。
三、开源硬件与模型效率革命
9. Conway 猜想的 AI 辅助证明:一个月、大量 token、一个 Lean 证明
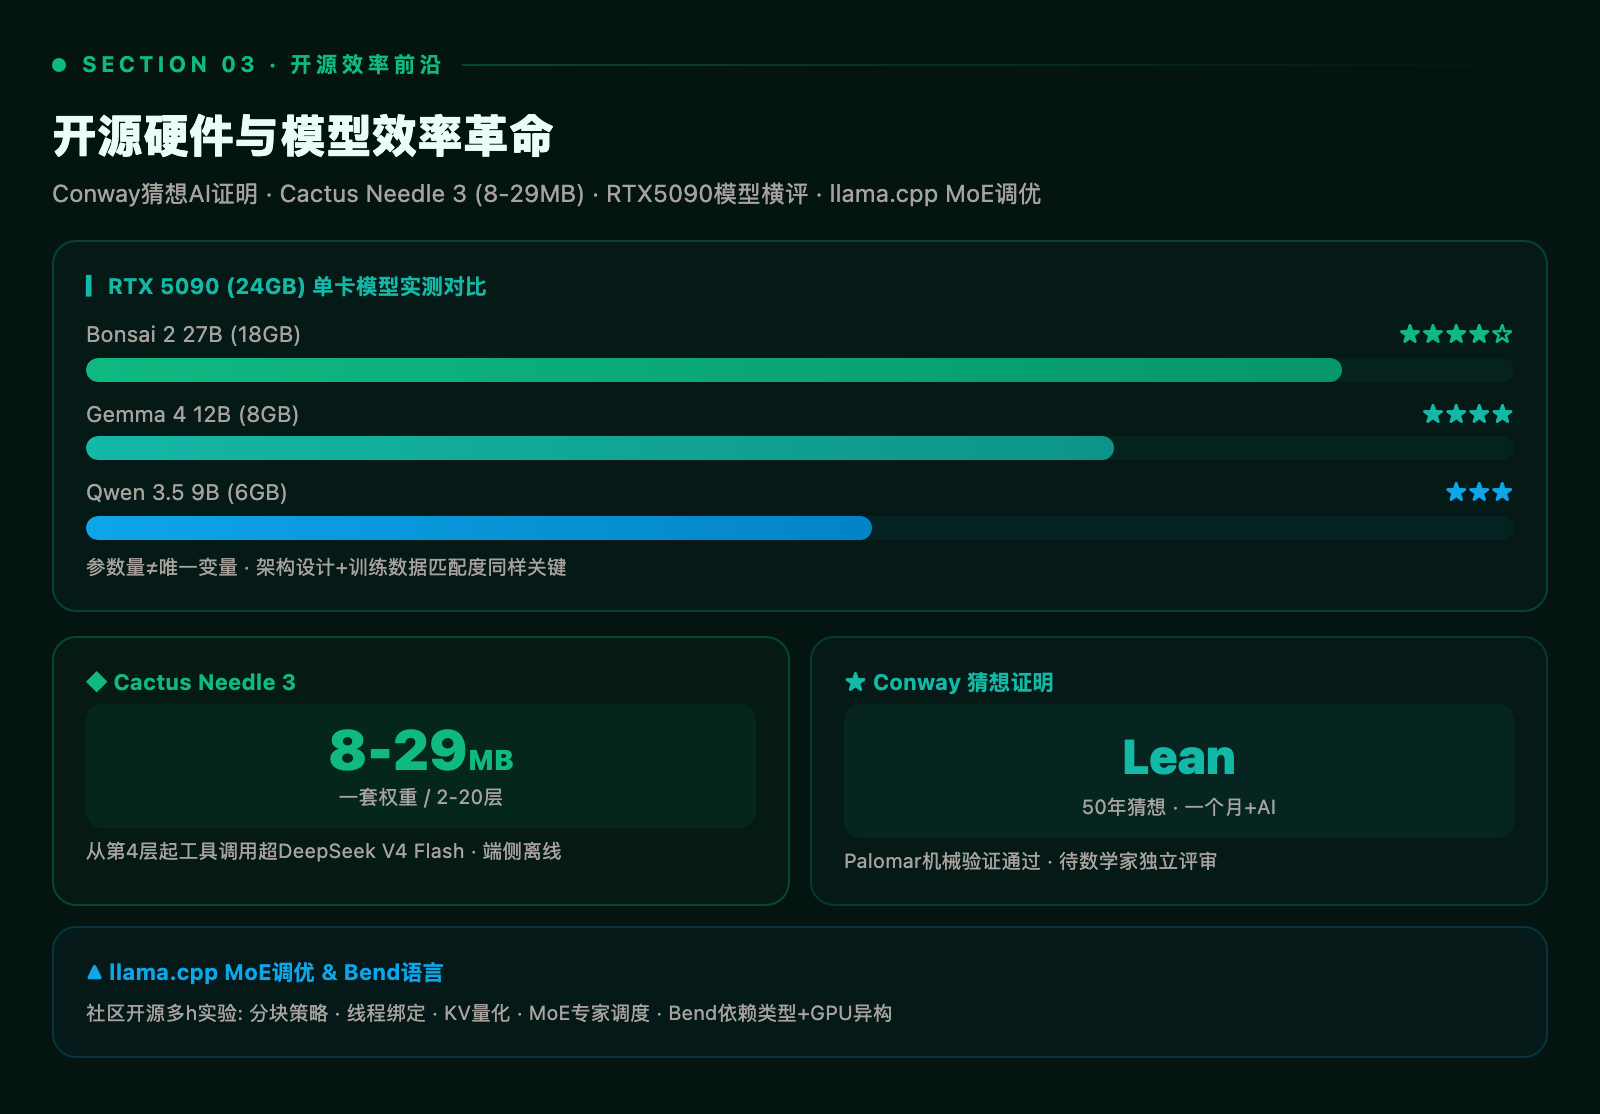
开发者 Dan Abramov(overreacted.io)发表文章《我是如何 AI 辅助证明 Conway 猜想的》。这位自认"数学外行"的前端工程师,用一个月闲暇时间和大量 LLM token,完成了一个 Lean 形式化证明——Conway 整数精炼猜想(omnific integers 的 refinement 性质:若 ab = cd,则存在整数 e,f,g,h 满足 a=ef, b=gh, c=eg, d=fh)。
这篇博客的工程意义在于:它展示了 AI 辅助"高门槛知识工作"的一个真实可行路径。关键成功因素:将问题分解为 AI 可处理的子步骤(理解 Lean 语法、理解猜想陈述、构造证明框架、填充推理间隙)、利用 Palomar 注册局的机械验证器做最终检查。但作者也诚实地标注:证明尚未被数学家独立验证——AI 帮助外行产出了"看起来正确"的结果,但正确性的最终保证仍需同行评审。这对 AI+科研领域的启示是:AI 的角色更接近"降低入门门槛的质量倍增器"而非"替代领域专家的质量保证"。
10. Cactus Needle 3:8-29MB 匹配 DeepSeek V4 Flash 的工具调用能力
Cactus Compute 开源 Needle 3 ——一个 8-29MB 的"自动化基础模型",专为移动端、可穿戴、机器人、智能家居、汽车和微控制器设计。核心创新是「一套权重,从 2 层到 20 层都是独立的模型」——同一个二进制文件,根据设备算力动态选择推理深度,形成一条"智能阶梯"。
在官方基准中,Needle 3 的"从第4层开始"即在工具调用任务上超越 DeepSeek V4 Flash,结构化提取(给定 schema 从非结构化文本提取字段)泛化到比它大 2-3 倍的模型。对于正在评估端侧 AI 部署的团队,这代表了"够用精度 + 极致能效"路线的一个标杆:不是让大模型变小,而是让小模型在其最擅长的场景(工具编排、结构化输出)达到大模型级精度,且全程无需网络连接。
11. RTX 5090 上跑模型:Bonsai 2 27B vs Gemma 4 12B vs Qwen 3.5 9B 实测
LocalLLaMA 社区一组横评对比了三款可在消费级 RTX 5090(24GB)上运行的模型:Bonsai 2 27B(量化后约 18GB)、Gemma 4 12B(约 8GB)、Qwen 3.5 9B(约 6GB)。测试场景为日语体素神社生成——一类兼具语言理解和空间推理的压力测试。
实测结果的空间并非简单的"参数量越大战力越强":Gemma 4 12B 在多语言任务上以一半的参数量逼近 Bonsai 2 的表现,但 Bonsai 2 在长程一致性和小样本泛化上有优势;Qwen 3.5 9B 作为最小模型显存占用最低,但在复杂指令遵循上仍有明显差距。这组实测为"单卡 24GB 如何选模型"提供了一个鲜活参考:参数量不是唯一变量,架构设计和训练数据的匹配度同样关键。
12. Prism-ML 加入 Bonsai 2 Qwen3.8 量化对比:开源量化社区加速内卷
Prism-ML 团队将 Bonsai 2 模型纳入其 Qwen 3.8 量化对比矩阵,开源量化社区围绕统一基准的横向比较正在加速。当前矩阵已覆盖多种量化方案(Q4_K_M/Q5_K_M/Q6_K/Q8_0/GGUF 多变体)——团队的目标是为每个 “模型×量化” 组合提供延迟、显存、质量损失的三维坐标,帮助开发者做精确的部署选型。这种"量化优选社区"的集约化正在成为开源 AI 生态的新型基础设施贡献模式。
13. Bend 语言:通过形式化证明在编译期阻断 AI 编程错误
HN 热门文章「Bend:通过证明在 GPU 上运行并阻断 AI 错误」提供了另一条 AI 编程安全的进路。与 Bend 2 主张的「人类写法则 AI 写实现+证明」不同,Bend 语言的核心是依赖类型+线性逻辑——类型系统直接编码程序不变量,编译期机械验证替代运行时测试。
Bend 支持 CPU 和 GPU 异构执行,这意味着程序员可以在类型层面约束并行行为(“这段代码启动的线程数必不大于设备核心数”)。对 Agent 编程的启示:与其在 AI 生成代码之后审计,不如在语言层面强制"带证明才能编译"——AI 不再只是写代码,它需要"证明代码的类型正确性"使编译通过。这是一套"让正确性成为语法约束"的体系。
14. llama.cpp 在 Qwen MoE 模型上的多小时调优实验
LocalLLaMA 社区一组时长数小时的深度优化实验覆盖了 Qwen MoE 模型的 llama.cpp 推理性能:补丁合并、基准测试、复现指南全部开源。MoE(Mixture of Experts)模型的推理效率瓶颈在于专家路由的内存带宽——不同的 token 激活不同的专家子网,如果调度不当会导致 GPU 利用率波动。
实验详细记录了分块策略、线程绑定、KV Cache 量化等级对推理吞吐的影响,给出了"显存带宽受限"和"计算受限"两种场景下的参数配置建议。对于正在本地部署 MoE 模型的团队,这类社区共享的深度调优实验是最接近"生产环境优化手册"的第一手资料。
四、大模型的「边界」:从架构演进到市场格局
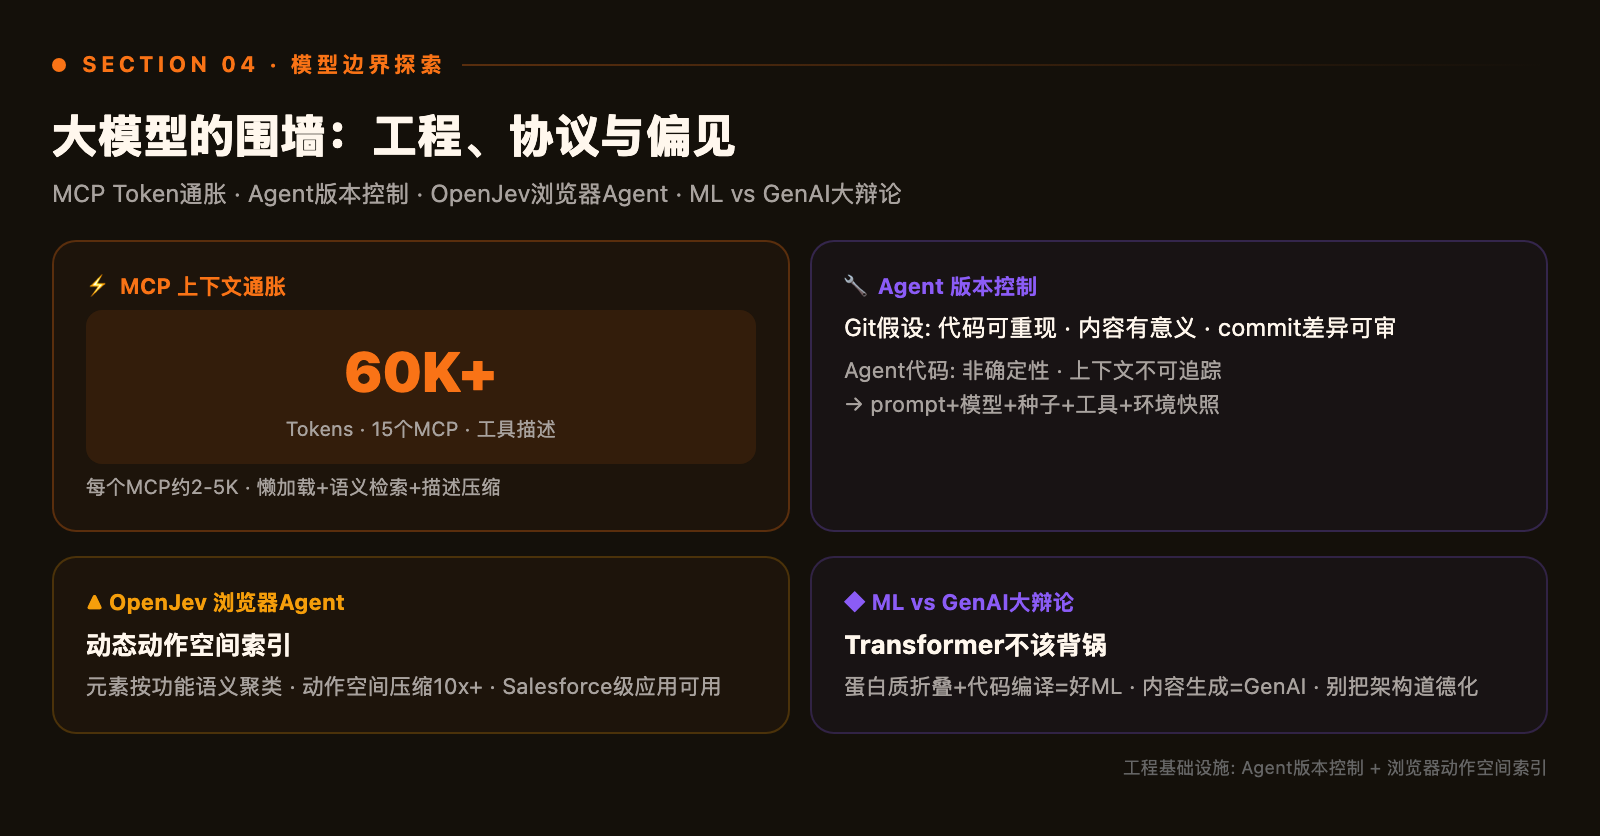
15. 15+ MCP 服务器可消耗 60,000 Token:Agent 上下文窗口的「通胀」成本
Reddit MCP 社区的研究发现:当 Agent 同时挂载 15 个以上 MCP 服务器时,仅系统提示(描述每个工具的能力和参数)就可消耗 60,000+ tokens ——这意味着在开始处理用户消息之前,Agent 已经烧掉了大量上下文预算。
这一发现指向了 Agent 生态中的「上下文通胀」问题:每个 MCP 服务器约有 2,000-5,000 tokens 的工具描述开销,当工具数量膨胀时,上下文窗口的有效利用率急剧下降。正在浮现的解法方向:工具懒加载(按需而非预加载描述)、工具描述压缩(将 50 token/工具描述压缩到 10-15 token)、语义工具检索(先搜索最相关的 5 个工具再注入)。对于构建多工具 Agent 的团队,这是一条"工具越多越好"的简单直觉的精确反例。
16. AI Agent 的版本控制问题:当非确定性代码遇上确定性工程
Reddit LLMDevs 讨论「AI Agent 的版本控制问题」触及了软件工程基础设施的盲区:传统 Git 假设代码是人类编写的、内容可重现的、commit 之间差异有意义。但 Agent 生成的代码是非确定性的——同一个 prompt 两次生成结果不同、Agent 的"memory"和工具配置(不在 Git 中)同样影响行为、Agent 的上下文窗口状态(不可追踪)导致"复现一次运行"几乎不可能。
社区提议的版本控制扩展:对 Agent 运行进行快照(prompt + 模型版本 + 采样种子 + 工具版本 + 环境哈希),将 Agent 的"非确定性运行"封装为"确定性记录"。这类似于 ML 实验追踪(MLflow/W&B)与 Git 的交叉地带。随着 Agent 系统走向生产化,"Agent 运行的版本控制"正成为一类新型基础设施需求。
17. OpenJev 开源:浏览器 Agent 动作空间的动态索引
开发者开源了 OpenJev——一个 Jev Ultrafast 的公共托管实例。Jev 的核心贡献是浏览器 Agent 的"动态动作空间索引":将页面上数百个可交互元素按其功能语义聚类为复合动作,将有效动作空间压缩 10 倍以上。在 Salesforce、ServiceNow 等复杂企业 Web 应用中,单个页面可能有数百个可交互元素——传统浏览器 Agent 将每个元素视为独立动作导致规划失败。
Jev 的解法借鉴了数据库查询优化器:先建立元素索引,再做动作选择。开源版本的发布意味着任意团队可以在自己的 Agent 管线中集成这一压缩层。这代表了浏览器 Agent 基础设施的一个关键进化——从"暴力枚举"到"语义索引+选择性执行"。
18. ML vs GenAI 大辩论:Transformer 架构为什么成了出气筒?
Reddit aiwars 社区一篇引发深度讨论的文章提出了一个尖锐问题:“那些想把’好机器学习’和’生成式 AI’分开的人,逻辑是什么?即便你反感 AI 公司的数据收集方式,Transformer 架构——这个支撑了当代 GenAI 的基础——到底对你做了什么?”
核心论点:Transformer 是一种通用序列建模架构,它支撑了蛋白质折叠预测、代码编译优化、天气预报等"好 ML"应用,也支撑了内容生成、深度伪造等"有争议的 GenAI"应用。将技术架构道德化会阻碍对真正问题(数据治理、劳动权益、环境影响)的精准关注。这引发了一个工程伦理层面的有益讨论:如何在拒绝"AI 全盘否定"和警惕"AI 滥用"之间维持精确的技术判断力——这股思辨对工程师做出"用什么、不用什么"的工具选型决策有现实指导意义。
📌 本期速览
- 安全临界点到达:美军 AI 幻觉险情 + ZCode Git 上传 + passkeys 个人风险——AI 安全的战场从模型本身蔓延到应用生态
- Agent 基础设施标准化加速:AGENTS.md 涌现、Cloudflare Quick Tunnels 成为标配、MCP 工具膨胀问题暴露——Agent 生态正在从"能用"走向"可治理"
- 效率与理解的张力:Cactus Needle 3 (8-29MB 匹配 DeepSeek) + Conway 证明 + 量化社区内卷——AI 能力的极限扩展方式不只"变大"一条路
- Vibe-Coding 质疑加深:Bend 2 设计取舍 + Bend 语言证明路径——"人类理解力"在 AI 编程范式中的位置成为焦点
🎯 本期最佳实践: 当部署编码 Agent 时,先回答三个问题:Agent 的权限边界在哪里(AGENTS.md)?它的数据流向了哪里(ZCode 事件的教训)?它的输出以何种方式被验证(Bend 的证明 vs Agent 的自我报告)?


 扫一扫


 1012

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


