



读完本文,你会得到一条可运行的短视频流水线:输入一首古诗词,输出带字幕的成片,以及按平台写好的发布文案。项目基于兼容 OpenAI 的 LLM 接口(文本 / 图像 / 视频生成)实现,从 200 万+ 首古诗词中智能选题,AI 生成文案与分镜,出图出视频,多平台适配,全流程可视化。
仓库地址(MIT 协议,GitHub / Gitee 双仓同步):
- GitHub:https://github.com/liuchangng/verse-reel
- Gitee:https://gitee.com/liuchangng/verse-reel
一、项目效果
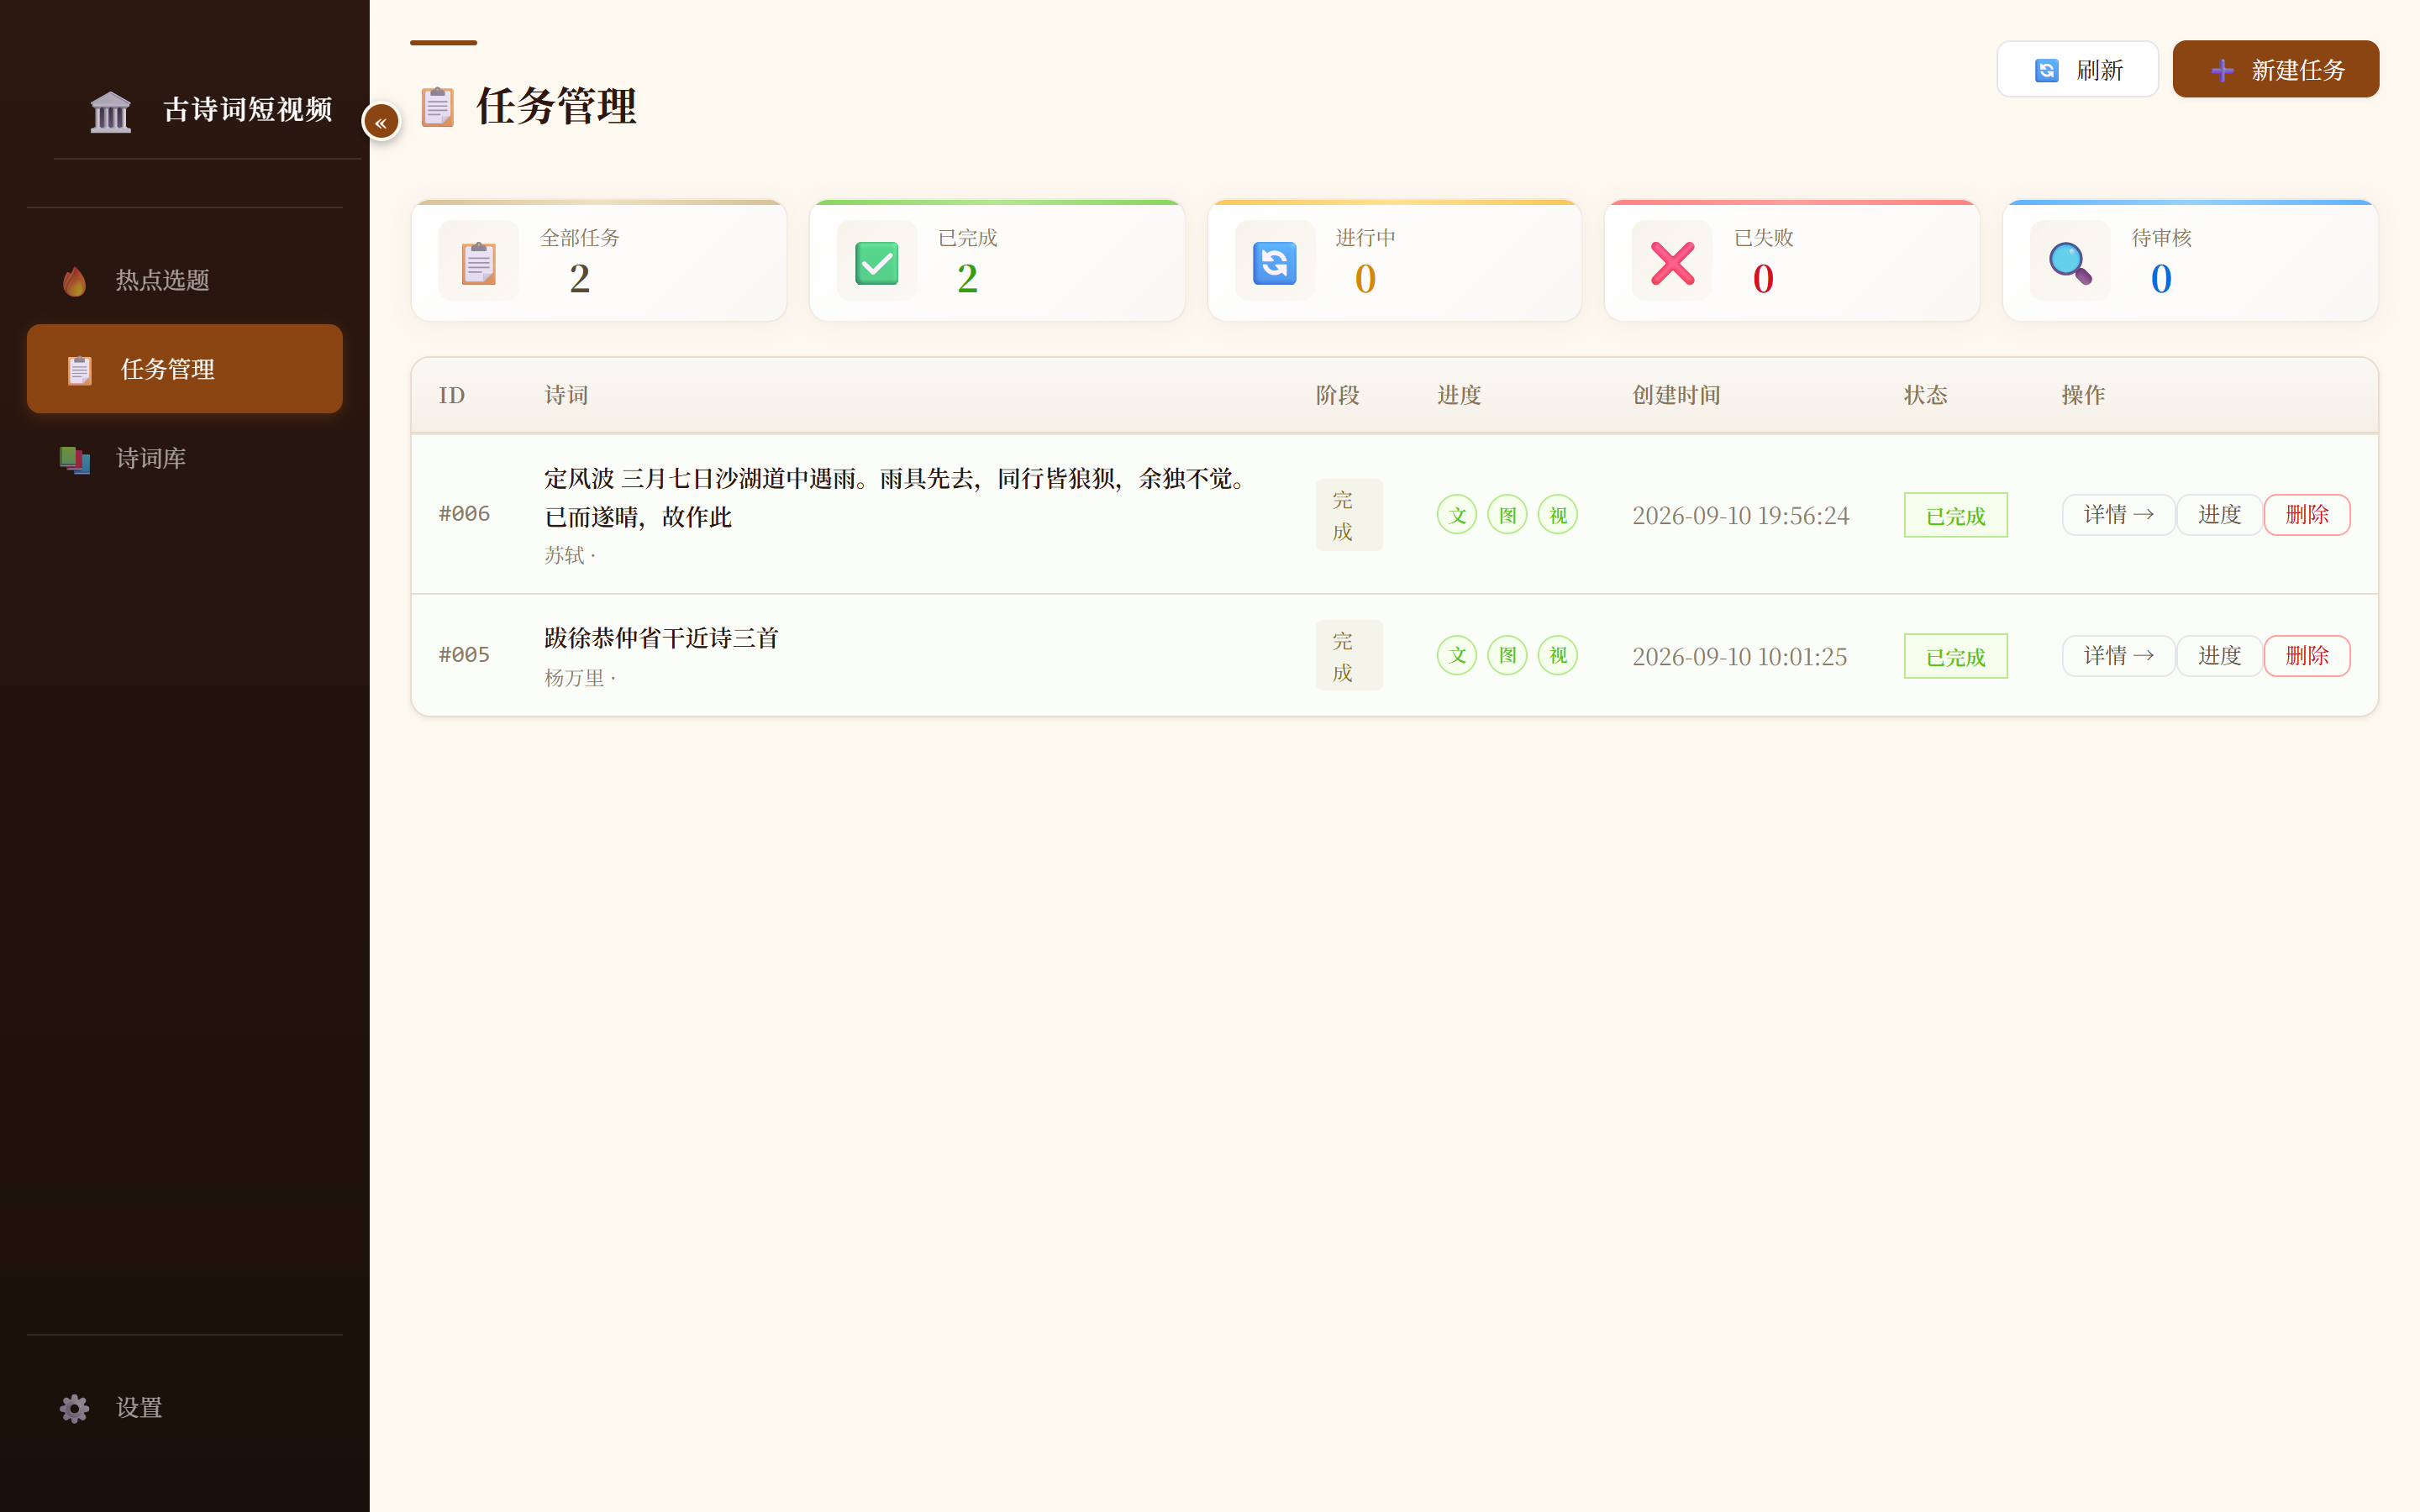
一条流水线把一首古诗词变成可直接发布到抖音、快手、小红书、B站、YouTube 的短视频。核心能力三块:
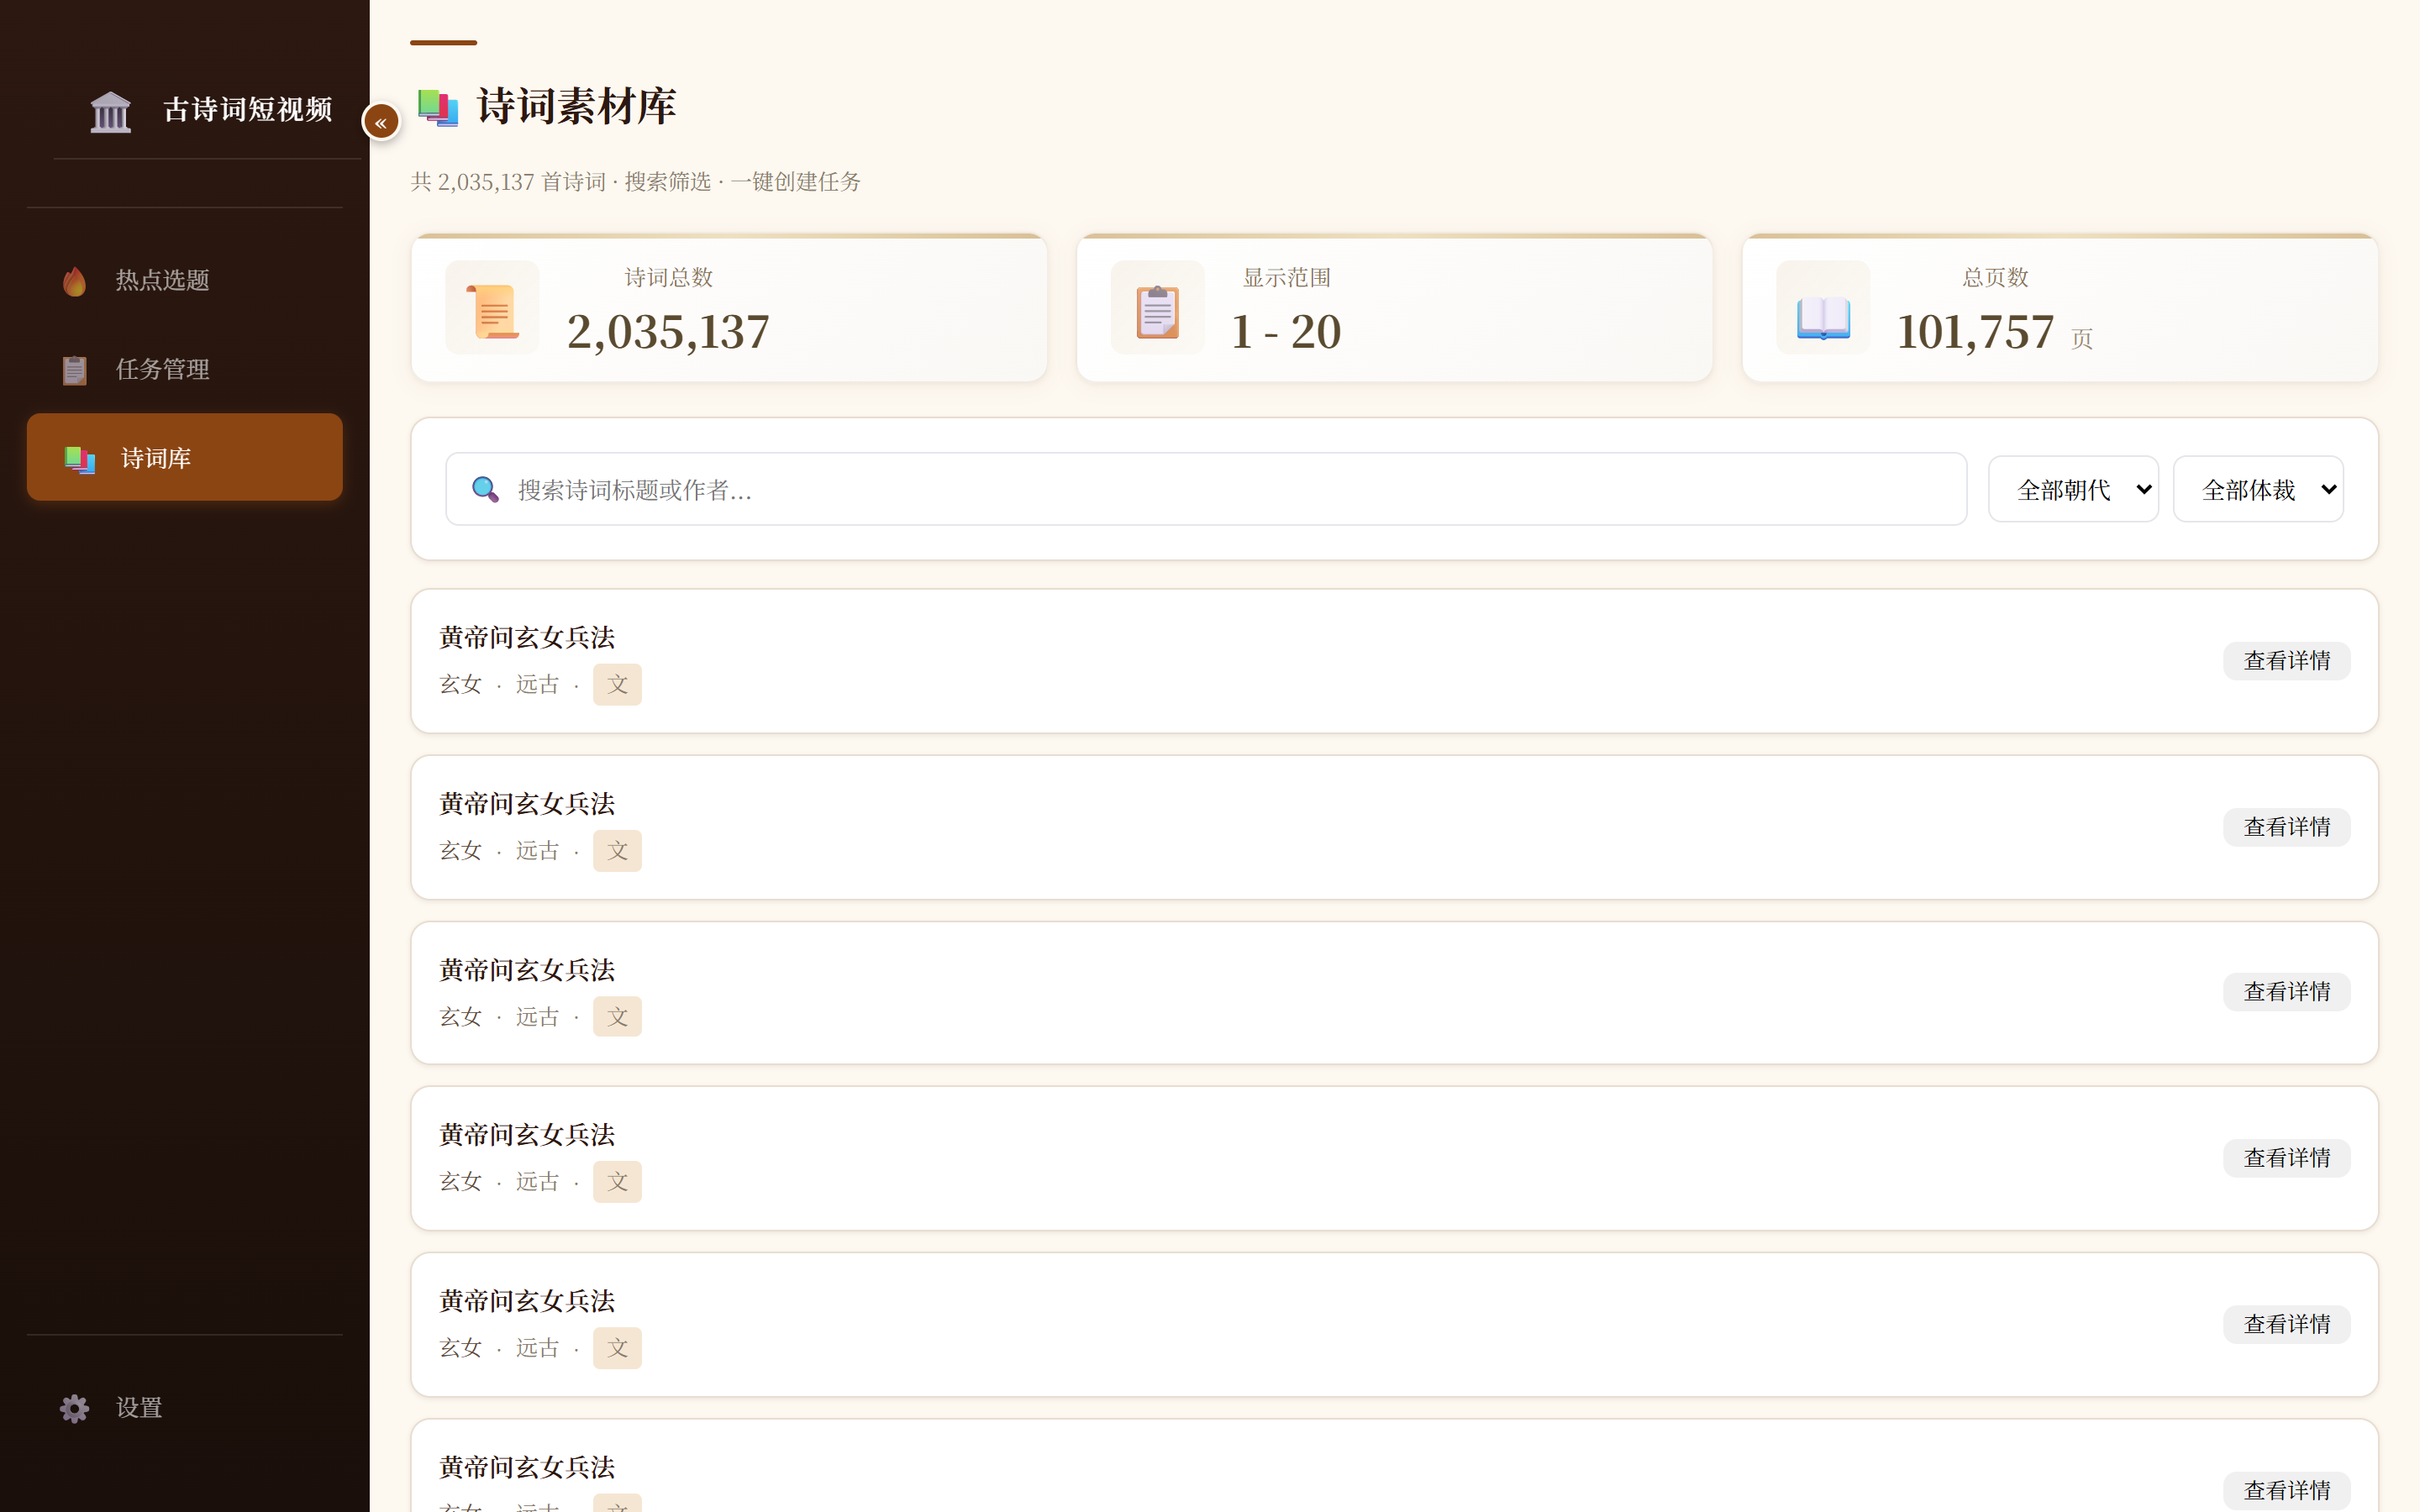
- 智能选题:从 200 万+ 首古诗词(CNKGraph 语料)中筛选,支持热搜匹配与诗词库检索两种入口
- AI 生产:文案、角色定妆照、分镜图、配音、视频、字幕,六环节自动串联,低分自动重写
- 多平台适配:一套生成多画幅,LLM 按各平台规范生成标题、描述、话题标签
二、技术选型
| 模块 | 技术 | 作用 |
|---|---|---|
| 后端 | FastAPI + Python 3.12(uv 托管) | REST API 与 WebSocket 实时进度推送 |
| 前端 | Vue 3 + Arco Design + Vite + Pinia | 热点 / 任务 / 详情 / 诗词库 / 设置五大页面 |
| 文本模型 | 任意 OpenAI 兼容 LLM | 文案、分镜、评分、发布文案 |
| 图像模型 | OpenAI 兼容 images 接口 | 角色定妆照、分镜出图 |
| 视频模型 | OpenAI 兼容视频接口 | 图生视频(多画幅) |
| 配音 | edge-tts / CosyVoice 双引擎 | TTS 配音,SRT 字幕 ffmpeg 烧录 |
| 存储 | SQLite(9 张表) | 首次启动自动建表,无需额外数据库 |
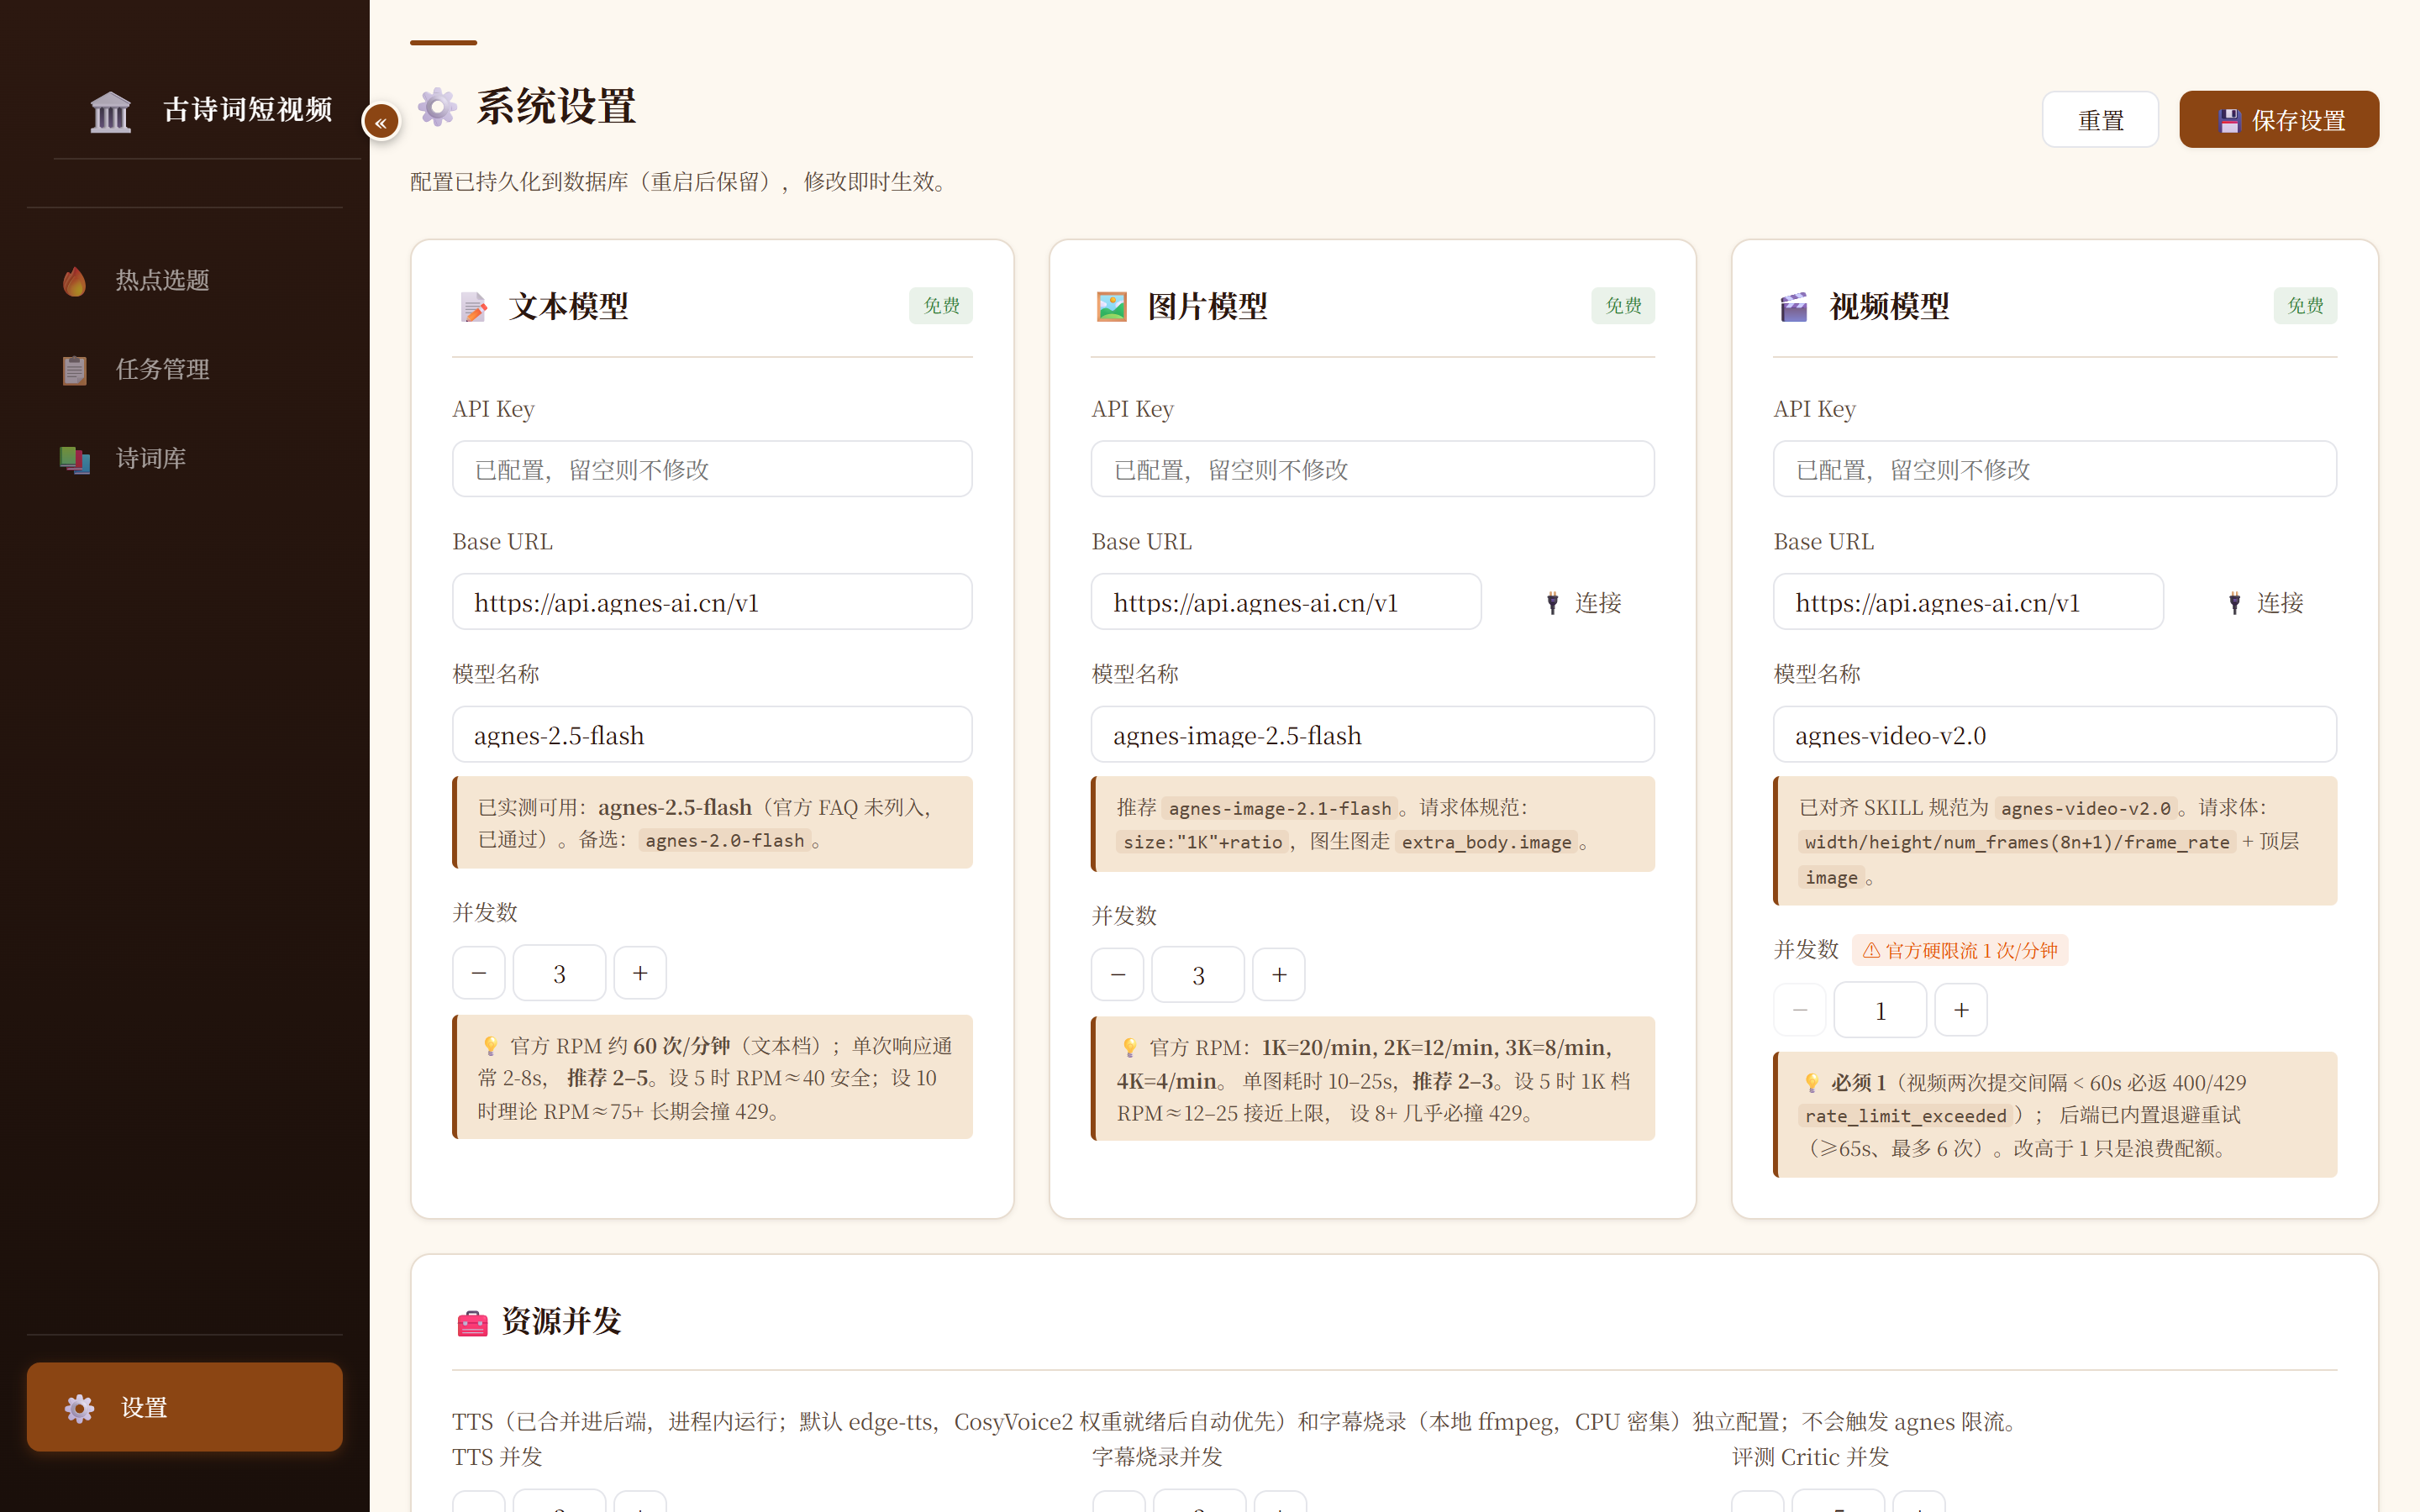
模型名、Base URL、API Key 均在设置页可配置,项目不绑定任何特定厂商,任何兼容 OpenAI 协议的服务均可接入。
三、项目结构
模块级结构如下(各模块内文件按功能组织):
verse-reel/
├── server/        # 后端(FastAPI)
│   ├── app/api    # API 路由
│   ├── app/services # 业务逻辑(流水线/文案/图片/视频/TTS/发布)
│   ├── app/models # 数据模型
│   ├── scripts    # 数据导入 / ETL / 生成脚本
│   └── pyproject.toml  # uv 依赖声明(核心 + cosyvoice extra)
├── client/        # 前端(Vue 3)
│   ├── src/views  # 热点/任务/详情/诗词库/设置 五大页面
│   ├── src/api    # API 客户端
│   └── src/styles # 样式
└── docs/          # 设计文档与截图
后端各阶段拆成独立 service,替换或扩展某个环节时无需改动整条流水线。
四、安装与启动
环境要求:uv(含 Python 3.12 托管)、Node.js 18+、ffmpeg(需在 PATH,提供 ffmpeg / ffprobe)、任意兼容 OpenAI 的 LLM API Key。
# 后端依赖(uv 托管,不占全局 Python)
cd server
uv sync

# 如需启用 CosyVoice 高质量 TTS(可选)
uv sync --extra cosyvoice

# 前端依赖
cd client
npm install

# 配置 API Key(兼容 OpenAI 的接口,任意厂商)
cp server/.env.example server/.env
cp client/.env.example client/.env

# 启动(Windows 可一键)
start.bat
后端基于 SQLite(server/data/poems.db,9 张表),首次启动自动建表,无需额外数据库。
五、导入古诗词数据
数据源为 CNKGraph 古诗词语料(约 200 万+ 首)。下载后将 CNKGraph.Writings.xml 导入:
cd server
python scripts/import_xml.py --file "path/to/CNKGraph.Writings.xml"
导入后即可在诗词库检索与建任务。
六、流水线六环节
任务创建后自动执行一条六环节流水线:
文案 → 定妆照 → 分镜图 → 配音 → 视频 → 字幕
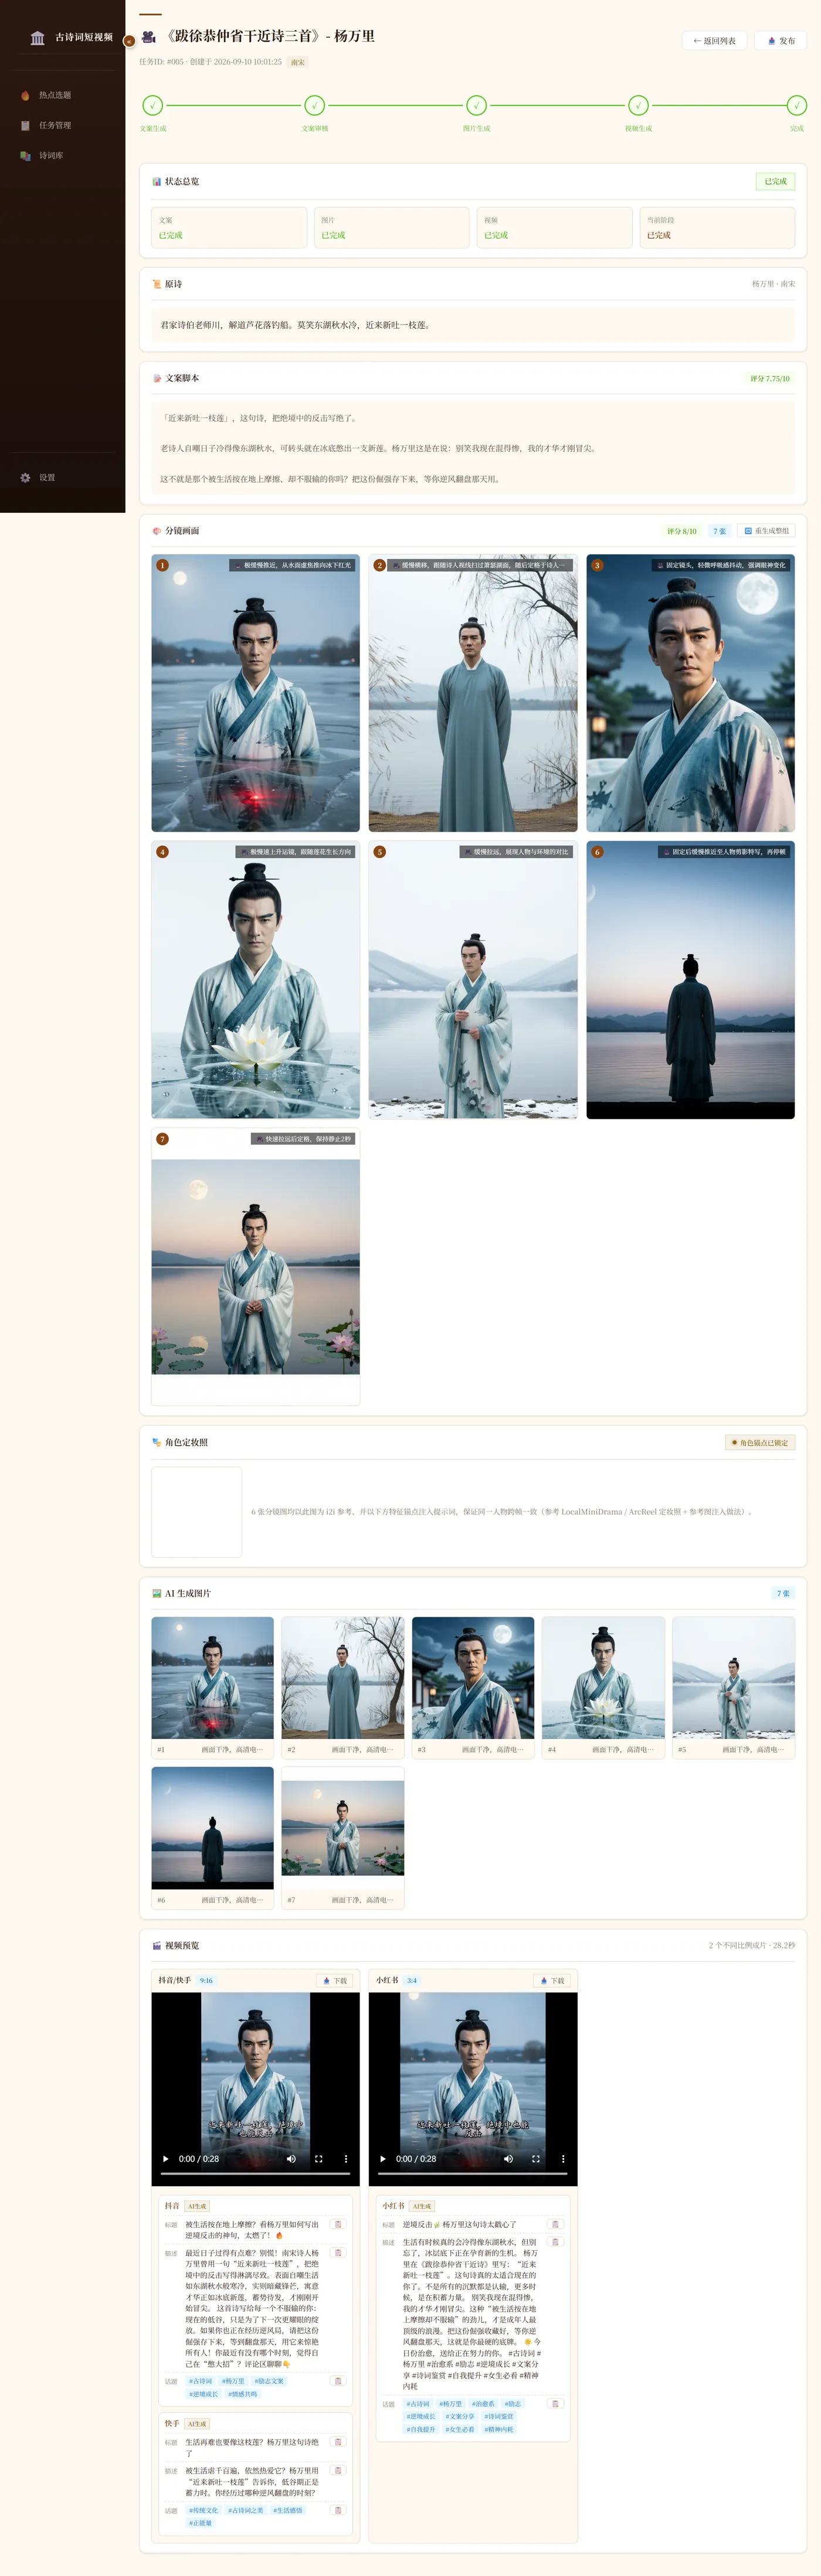
进度通过 WebSocket 实时推送到任务详情页,无需手动刷新。任一环节不满意,可单独重跑该阶段(/regenerate?stage=...),不必整条重来。
七、工程细节(三条设计决策)
以下三点是实际跑通后的取舍,均有可验证的依据:
- 并发不对称:文案、出图、评分各 5 并发;视频生成只开 1 并发。视频调用最贵、最易触发 API 限速,试过视频也上 5 并发后失败重试激增,压回 1 并发后稳定
- Generator-Critic 同模型:生成与评判角色由同一个 LLM 扮演,审美标准不冲突,成本显著低于双模型方案
- TTS 双引擎:默认 edge-tts(快、免费),高质量场景切 CosyVoice(可选依赖),字幕统一由 ffmpeg 烧录
模型名、Base URL、API Key、并发度都在设置页调整,无需改代码。
八、多画幅与发布文案
同一任务一次生成三种画幅,覆盖各平台竖屏与横屏要求:
| 平台 | 画幅 |
|---|---|
| 抖音、快手、小红书 | 9:16 / 3:4 竖屏 |
| B站、YouTube | 16:9 横屏 |
成片生成后,LLM 按各平台字数与话题规范生成对应的吸睛标题、描述、话题标签,一键复制后粘贴到各 App 发布。需要说明:本系统不自动上传,"自动"止于可复制的发布文案,最终发布动作由操作人完成。
九、上手流程
完整跑一条片子按四步走:
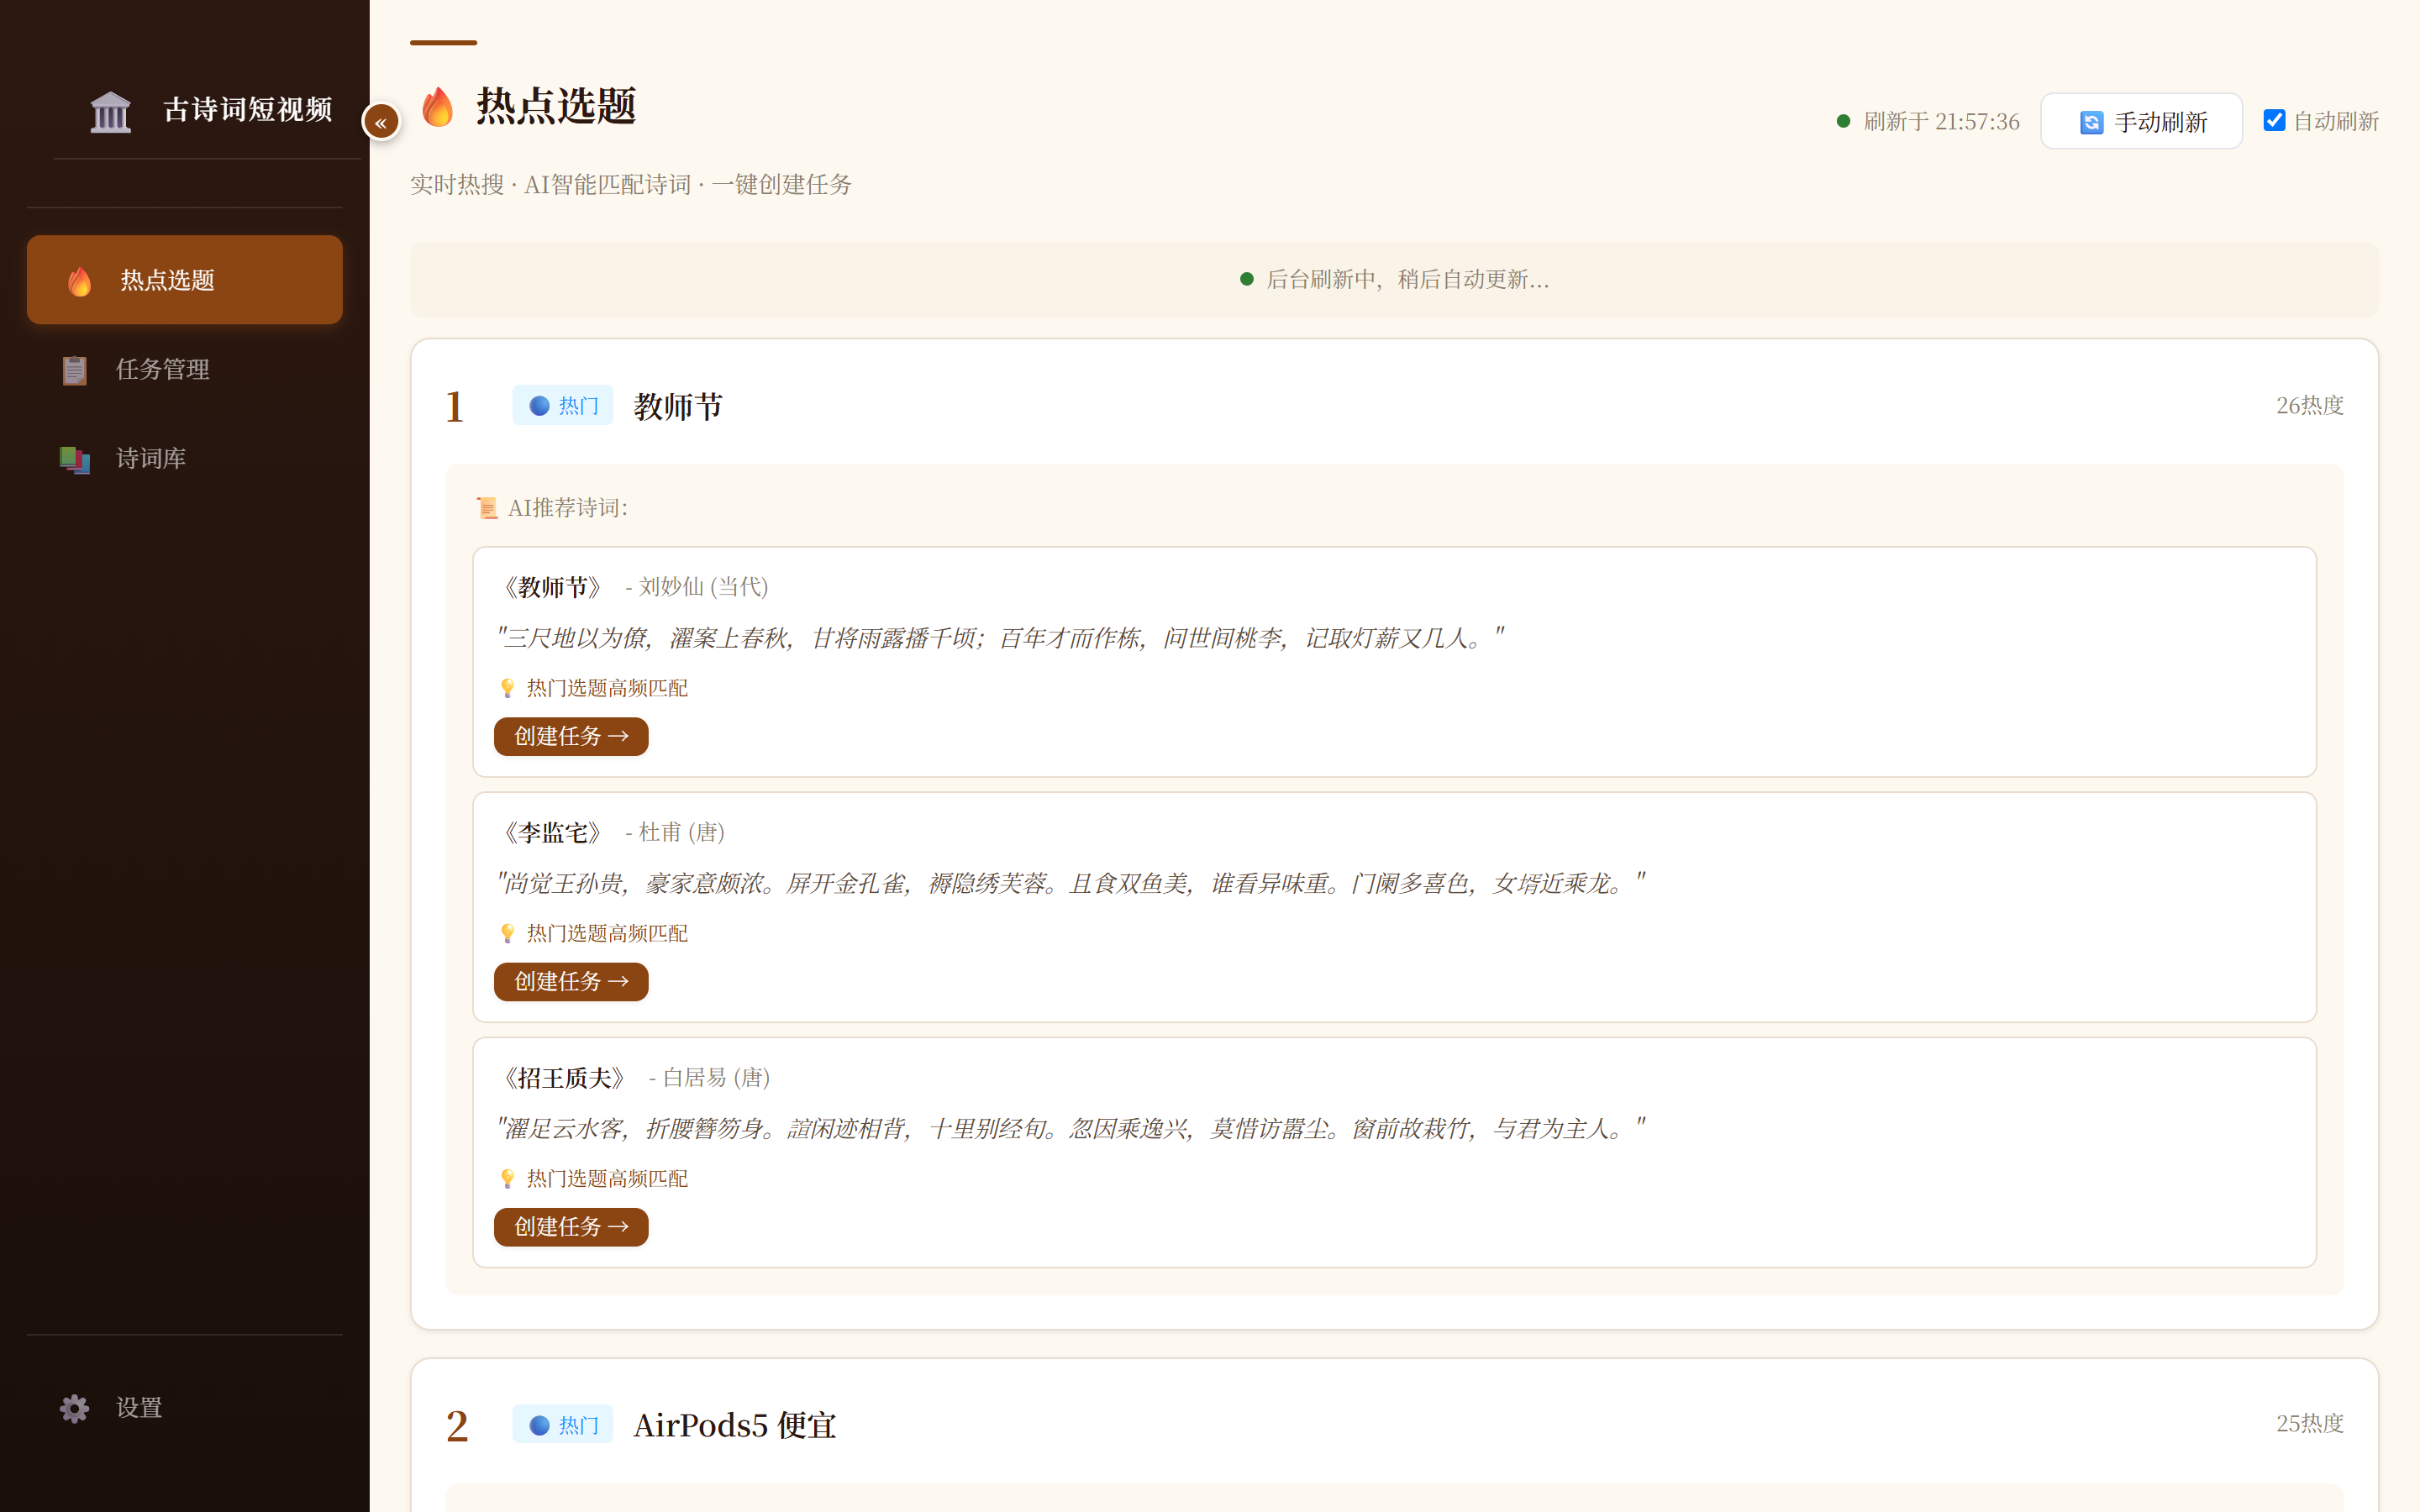
- 选题。两条入口任选:
- 热点匹配:拉取当前热搜,LLM 把热搜词映射到库里最贴切的诗。热搜源基于 NowNews(
ghcr.io/ourongxing/newsnow:latest自建镜像)聚合,抓取失败时自动回退到内置的兜底数据源,不影响选题流程 - 诗词库检索:直接按词、作者、朝代在已导入的库里定位,精准选题
- 热点匹配:拉取当前热搜,LLM 把热搜词映射到库里最贴切的诗。热搜源基于 NowNews(
- 建任务。选中一首诗,填写角色设定与分镜偏好,提交后任务自动进入流水线
- 看进度。任务详情页通过 WebSocket 实时推送六环节进度,任一环节可单独重跑
- 审核发布。成片 + 各平台文案生成后,人工审核再复制到对应 App 发布
十、局限与适用
几点需要先说清楚,避免预期偏差:
- 视频环节最吃成本与时间:图生视频调用最贵、出片最慢,单条任务耗时取决于所接模型的响应速度,并发已压到 1 保证稳定
- 成片质量 = 模型上限 + 角色设定质量:接的 LLM / 视频模型越好,出片越好;提示词写得多具体,风格越稳定
- 面向"古诗→短视频"这一垂直场景,跨领域题材(如产品、生活)需自行调提示词模板
适用人群:有短视频矩阵内容需求、想用古诗词做差异化题材的团队与个人。想直接试跑,按第四节装好环境、导入诗词库,五分钟能出第一条片子。
项目基于 MIT 协议开源,欢迎 PR 与 Issue:
- GitHub:https://github.com/liuchangng/verse-reel
- Gitee:https://gitee.com/liuchangng/verse-reel


 扫一扫


 266

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


