CUED-RNNLM:一个有效训练评估RNN语言模型的开源工具包

RNNLM的使用方法 最近做的一个项目要用到语言模型,在网上找了一些开源的工具包试了一下。废话不多说,下面直接介绍一下 RNNLM的安装方法。 我实在ubuntu14.04底下使用SRILM。    SRILM的下载地址(我使用的是rnnlm-0.4b版本) 1、编译   解压缩之后,在终端中进入所在目录,输入以下命令 make有可能会出现如下错误: make: x86_64-linux 阅读详情

摘要

  近年来,循环神经网络语言模型(RNNLMs)在包括语音识别在内的一系列应用中越来越流行。然而,RNNLMs的训练计算开销巨大,这就限制了可使用的数据量和网络大小。为了充分利用RNNLMs的能力,要求有效的训练实现。本文介绍了CUED-RNNLM,一个开源工具包,它能支持高效的基于GPU的RNNLMs训练。与现有的使用基于class的输出目标不同,它支持大规模词级别输出目标的RNNLM训练。并包含了对HTK和Kaldi格式lattices的N-best和lattice-based重打分的支持。本文展示了一个使用该工具包训练和评估RNNLMs的例子,其用于一个使用AMI语料库的基于Kaldi的语音识别系统。所有必要的资源都可在网上获取,包括源码、文档和recipe。
  
索引词:语言模型,循环神经网络,语音识别,GPU,开源工具包

1. 介绍

  语言模型在许多语音和语言处理应用中是关键性的组件,例如语音识别、机器翻译。由于n-gram语言模型的优异性能和高效实现,其作为统治性的语言建模方法已经有数十年了。然而关于n-gram语言模型有两个众所周知的问题 。第一个问题是数据稀疏性,鲁棒性参数估计需要复杂的平滑技术。第二个问题在于n阶马尔科夫假设,预测的词概率值依赖于前n-1个词,这样更长距离上下文依赖就被忽略了。
  循环神经网络语言模型(RNNLMs)将每个词映射到一个紧凑的连续向量空间,该空间使用相对小的参数集合并使用循环连接来建模长距离上下文依赖。这样RNNLMs就为n-gram的两个关键问题提供了解决方案。并且,RNNLMs在语音识别任务中相对于n-gram语言模型表现出了重大的提升,这导致了其大范围的应用。
  然而,训练RNNLMs对计算量要求苛刻,处理大量数据时缓慢的训练速度限制了RNNLMs的使用。在我们之前的工作中,通过使用一种新的句子拼接串模式并行算法,RNNLMs在GPU上被高效地训练,取得了相比Mikolov在CPU上运行的RNNLM工具包27倍的重大加速。为了减小词到class映射的性能敏感度,提高串模式训练的效率,采用了带全输出层的RNNLMs(FRNNLM),而不是广泛使用的基于class的RNNLM(CRNNLM)。
  输出层的softmax归一化严重影响FRNNLM的评估速度,特别是当建模大词汇表时,或许包含数十万个词的情况。为了解决这个问题,提出了两个改进的RNNLM训练准则:方差正则化和噪声对比估计。两种方法都允许使用一个常量的历史独立的归一化项,因而在CPU上相当提升了RNNLM的评估速度。
  本文介绍了CUED-RNNLM工具包,包含了以上基于GPU的RNNLM训练和改进的训练准则的高效实现。文章剩余部分组织如下。第2部分是对RNNLMs的简要回顾。第3部分讨论了3个现有的训练神经网络语言模型的开源工具包。CUED-RNNLM工具包的高效训练、评估和实现对应地展示在第4、5、6部分。构建于AMI语料库的Kaldi语音识别系统之上的实验展示在第7部分。第8部分作出结论并讨论未来工作。

2. 循环神经网络语言模型

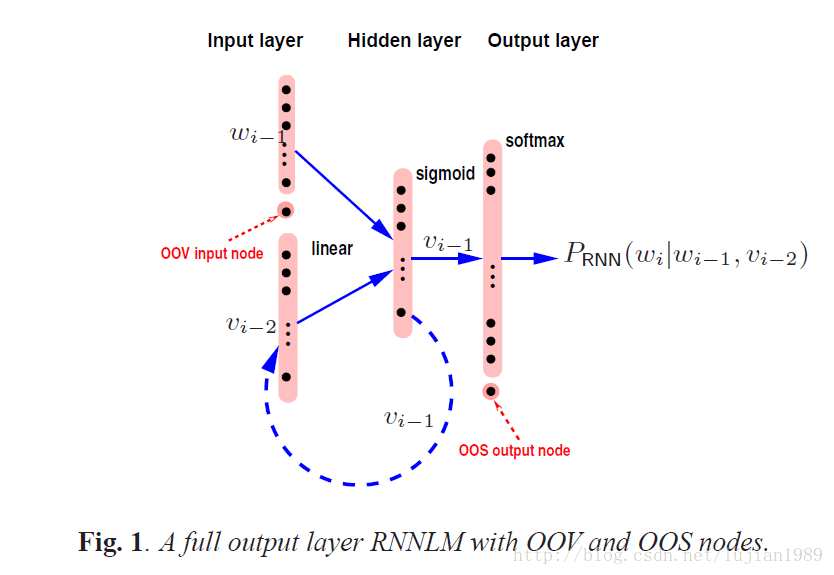
  RNNLMs使用前一个词 wi−1 的1-of-k编码和一个表示剩余上下文的连续向量 vi−2 来表现词 wi 的完整未截断历史 hi=<wi−1,...,w1> 。一个未登录词(OOV)输入节点也能用来表示不在选中识别词典中的任意输入词。用来计算LM概率 PRNN(wi|wi−1,vi−2) 的循环神经网络结构包含三层。连接 wi−1 和 vi−2 的完整历史向量被送入输入层。隐藏层压缩来自这两个输入的信息,并使用sigmoid激活函数计算新的表达式 vi−1 以获取非线性。然后传递到输出层,使用softmax激活函数生成归一化的RNNLM概率,同时递归地反馈到输入层,作为“将来的”剩余历史来计算下一个词的LM概率 PRNN(wi+1|wi,vi−1) 。
  这里写图片描述
  一个带有非聚类完整输出层的示例RNNLM结构如图1所示。RNNLMs可以使用随时间反向传播(BPTT)算法来训练,其误差通过循环连接传递回去特定的时间步长,比如4或5。为了减小计算消耗,一个候选列表(shortlist)可用于限制输出层至最常用词。为了减小RNNLMs训练中至候选列表词的偏差以及提高鲁棒性,一个额外节点被添加至输出层,以建模候选列表外(OOS)词的概率质量。
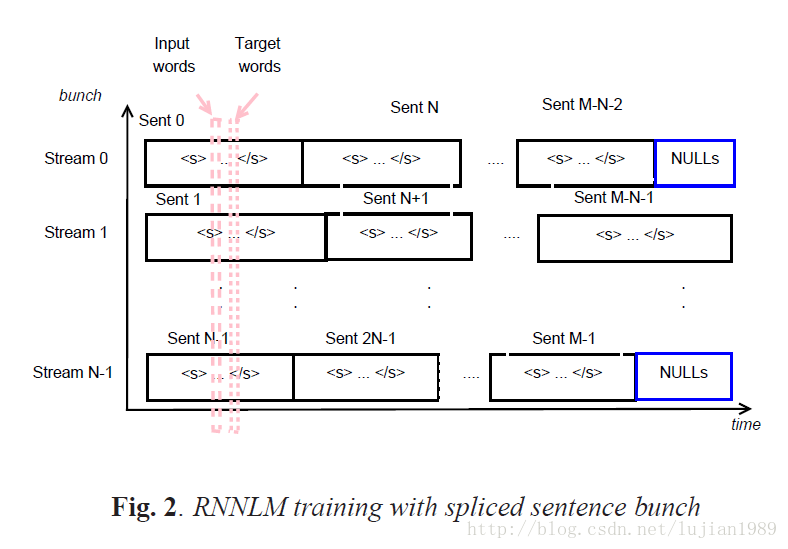
  带完整输出层的RNNLMs训练计算开销巨大。一个流行的解决方法是使用基于class的RNNLMs。输出层词典中的单词被映射到classes。由于class的数量和每个class中词的数量显著小于输出层词典,基于class的RNNLMs能够在CPU上高效训练。然而,基于class的RNNLMs的使用不仅引进了词分类时的性能敏感性,也很难将不规则大小class特定权重矩阵的训练并行化以便进一步加速。在我们之前的工作中,采用了带完整输出层的RNNLMs,在GPU上以串(或minibatch)模式有效训练,能并行处理多路训练句子。拼接句子串技术用来最小化句子长度变化引入的串流之间的同步开销。拼接句子串的想法在图2中描述。多个句子被拼接进N个串流之一(N为串的规模)。在训练过程中,一个N维的输入词向量通过在每个流中取一个词而构成。目标词向量通过在每个流中取下一个词而构成。
  这里写图片描述
  在最先进的语音识别系统中,RNNLMs通常与n-gram语言模型进行线性插值,以取得良好的上下文覆盖和强泛化能力。差值权重 λ 能够在留存数据集上通过EM算法优化。为了简化,本文中 λ 固定取0.5。在上述插值中,通过RNNLM组件指定的OOS词的概率质量以所有OOS词相同概率进行重新分派,以确保有效的概率。

3. NNLM/RNNLM训练工具包

  目前有许多实现了循环神经网络的工具包,比如Theano、Torch、TensorFlow、Chainer和CNTK。对于语言建模,还有若干专用于神经网络语言模型训练的开源工具包。当前展示3个流行的工具包。
  CSLM是前馈神经网络语言模型的一个有效实现。它包含CPU和GPU版本,允许通过高效并行算法和重采样技术处理大量训练数据。
  RNNLM可能是第一个专为语言建模设计的RNNLM工具包。它允许基于class的RNNLMs使用少量数据在CPU上高效训练。当隐藏层大小增加时训练速度急剧降低。RNNLM工具包也提供各类函数的recipes,包括困惑度评估、N-best重打分和文本生成。CUED-RNNLM工具包最初基于RNNLM工具包,提供类似的调试信息和模型格式。
  RWTHLM提供基于长短时记忆(LSTM)RNNLMs的实现以及基于class的输出层。该工具包的特色是基于CPU的RNNLM训练的更有效实现。然而,随着隐藏层大小增加训练速度下降的类似问题仍然存在。
  在本文中,我们描述了CUED-RNNLM,全输出层RNNLM高效训练的基于GPU的实现。CUED-RNNLM工具包以C++实现,在BSD许可下自由获取,版权来自于RNNLM工具包。

4. CUED-RNNLM中的训练

  CUED-RNNLM包含FRNNLM训练、评估以及通过采样进行文本生成。训练和采样使用GPU,模型评估在CPU上进行。

4.1 交叉熵(CE)训练

  RNNLM训练的常用目标函数基于交叉熵(CE),
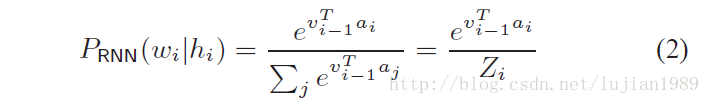
JCE(θ)=−1Nw∑i=1NwlnPRNN(wi|hi)(1)
其中, Nw 是训练语料库中词的数量。全输出层RNNLM通过串(例如minibatch)模式在GPU上高效训练。然而输出层的softmax层需要归一化计算,如式2所示。其中 ai 是词 wi 关联的权重向量。归一化项 Zi 的计算在训练和测试阶段都开销巨大。
   这里写图片描述
  对于以上问题我们的解决方法是在RNNLM训练过程中学习一个常量的历史独立的softmax归一化项。如果归一化项 Zi 能够近似于常量D,式3中的未归一化RNNLM概率能够在测试阶段提供极大的速度提升。
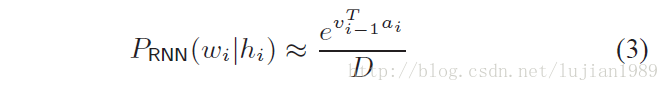
  这里写图片描述
  使用这一理念,CUED-RNNLM实现了两个改进的训练准则:方差正则化(VR)和噪声对比估计(NCE)。

4.2 方差正则化(VR)

  方差正则化(VR)显式添加正则化项的方差至标准的CE目标函数。相关的目标函数如下:
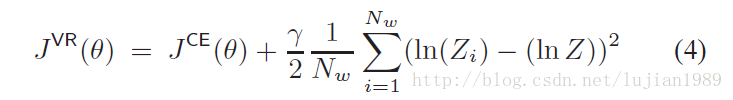
  这里写图片描述
  其中 lnZ 是归一化项的log平均。添加至式1给出的CE目标函数的第2项建模了归一化项的log方差。参数 γ 用来调整方差项相对标准CE准则的影响。在测试阶段,RNNLM的输出概率可以通过式3中的未归一化概率近似。

4.3 噪声对比估计(NCE)

  在NCE训练时,训练语料库中的每个词假定通过两种不同的分布生成。一个是数据分布,也就是RNNLM,另一个是噪声分布,通常使用一元模型。目标函数是为了在训练数据和一组随机生成的噪声样本上区分这两种分布。如下式所示:
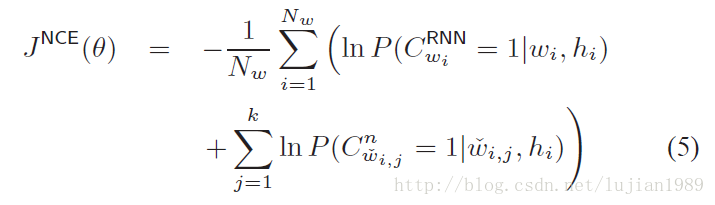
这里写图片描述
  其中, wi 是第i个目标词, wˇi,j 是为词 wi 生成的第j个噪声词,k是噪声样本的数量。 P(CRNNwi=1|wi,hi) 是RNNLM生成的词 wi 的后验概率, P(Cnwˇi,j=1|wˇi,j,hi) 是噪声分布生成的词 wi 的后验概率。
  在NCE训练过程中,归一化项 Zi 的方差能被隐式限制为常量。训练步骤只与输出层的目标词和k个样本相关,而不是整个输出层。这样,输出层的计算消耗不再对词典大小敏感,且有显著下降。和方差正则化一样,式3中的未归一化概率能在测试阶段使用。

5. CUED-RNNLM中的模型评估

  测试集的困惑度(PPL)和词错误率(WER)用来评估语音识别任务中语言模型的性能。CUED-RNNLM工具包提供函数来计算困惑度、N-best重打分和lattice重打分。

5.1 困惑度计算

  困惑度能够使用RNNLMs单独计算,或者与n-gram语言模型线性插值。通过CPU来计算使用归一化概率的全输出RNNLMs的实际困惑度效率很低,加入GPU困惑度计算是未来的工作。

5.2 N-best重打分

  N-best列表能通过诸如SRILM工具包,由词lattices生成。然后,由RNNLM计算的带语言模型打分的句子级log似然被推算出,N-best列表重新排列。注意当使用VR或NCE训练的RNNLMs时,式3中的未归一化概率能够使用。

5.3 Lattice重打分

  同样支持使用RNNLMs的lattice重打分。使用CUED-RNNLM训练的模型可通过HTK3.5的lattice处理工具HLRescore的一个扩展来使用。这一lattice重打分扩展也能够作为HTK3.4.1的补丁获得。通过一个转换工具,也能支持Kaldi格式的lattices。

6. 其他特色

  RNNLM可通过采样来生成大量文本。然后在生成的文本上训练一个n-gram语言模型,并与一个基线语言模型进行插值。所得语言模型能作为初始RNNLM的近似,直接用于初步解码和/或lattice重打分。
  在CUED-RNNLM中还有一些其他特色。支持含多个隐藏层的RNNLM。当前,只有第一个隐藏层允许有循环连接。额外的值能添加至输入层,例如主题特征。同时实现了RNNLM的句子独立/依赖模式训练。在句子独立模式的RNNLM训练中,输入层的历史向量 vi−2 在每个句子的开头被重置为初始值(比如0.1)。对于句子依赖的RNNLM训练,句子边界作为一个正常词来处理,而不用重置历史。默认使用句子独立的RNNLM训练。
  在许多应用中,训练数据来自不同的源。在RNNLM训练中训练数据的顺序显著影响性能。为了在领域内测试数据上获得优异性能,建议在RNNLM训练时首先将领域外数据输入网络,在更重要的领域内训练数据处理之前。因此,训练时训练数据不是随机打乱的。建议对于每个数据源,将句子顺序随机化作为前置处理步骤,同时保持数据源之间的顺序。
  工具包除了标准的NVIDIA CUDA库用于基于GPU的计算之外,不依赖其他第三方库。调试信息和输出类似于RNNLM工具包。命令参数的详细描述可在网上的工具包文档中查找。

7. 实验

  实验基于AMI会议语料库,评估在语音识别上下文中不同类型RNNLM的性能。在用于声学模型训练的全部78小时语音中,包含了大约1M声学转写的词(包括句子开头和结尾)。另外有8个会议独立于训练集,作为开发和测试集。
  一个以序列训练为特色的Kaldi声学模型训练recipe应用至深度神经网络(DNN)训练中。将FMLLR转换的MFCC特征作为输入,4000个聚类状态(senones)作为聚类目标。训练的DNN有6个隐藏层,每层有2048个隐藏节点。
  Fisher语料库的13M词汇的第一部分也用来进一步提高语言建模性能。使用了49k词汇的解码词典。33k的RNNLM输入词典构建于解码词典和LM训练数据中所有词汇的交集。22k最常用词选取作为输出词典。BPTT算法用于之前5词误差反向传播的RNNLM训练。本文所有RNNLM使用了一个隐藏层。平均训练10个迭代至收敛。当前部分所有语言模型在(AMI+Fisher)联合的14M词汇训练集上训练。使用AMI转写的1M词汇的实验结果可在网上的文档中找到。
  第一个实验是评估RNNLMs的性能。一个剪枝的3-gram语言模型用于初步解码,随后是未剪枝的4-gram语言模型用于lattice重打分。在RNNLM训练过程中,AMI语料库(1M)置于Fisher数据(13M)之后。带512个隐藏节点的RNNLMs使用交叉熵准则训练。表1展示了通过RNNLM和CUED-RNNLM工具包训练的RNNLMs的性能。RNNLMs相对于基线的4-gram语言模型在困惑度和词错率(WER)上有了显著提升。CUED-RNNLM训练的完整输出层RNNLM稍微胜于RNNLm训练的基于class的模型。重打分lattices和50-best列表给出了可比较的1-best(Viterbi)性能。通过RNNLM重打分lattices的混淆网络解码,取得了额外的词错率绝对减少0.2%,而通过重打分50-best列表的混淆网络解码则没有提升。
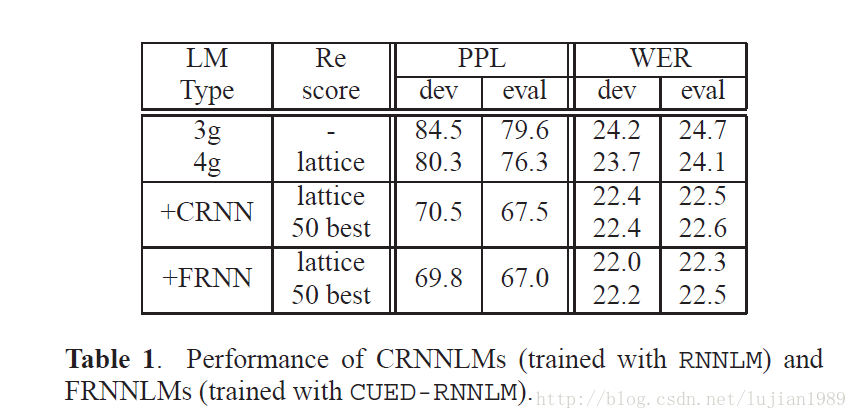
这里写图片描述
  下一个实验研究使用50-best重打分时不同准则训练的FRNNLMs性能。Fisher和AMI语料库在连接放进一个训练数据文件前被单独打乱。打乱数据能使词错率稍微下降(注:数据打乱对于CRNNLMs没有提升)。VR和NCE训练的RNNLMs性能在表2中展示。使用CE、VR及NCE各自训练的RNNLMs给出了可比较的性能。为了取得稳定的收敛,基于NCE的训练相比CE基线需要多两个迭代。
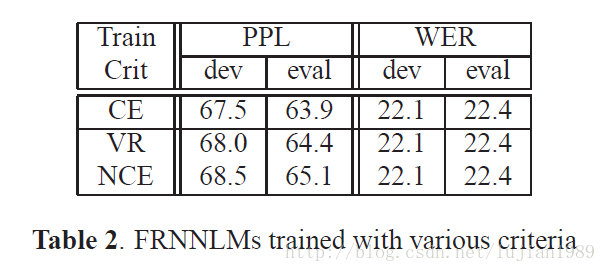
这里写图片描述
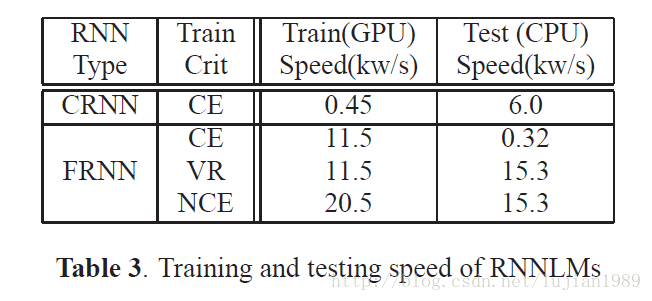
  表3展示了RNNLMs的训练和评估速度。使用一台带双Intel Xeon E5-2680 2.5GHz处理器的电脑,单进程进行基于CPU的CRNNLM训练和评估。使用NVIDIA GeForce GTX TITAN GPU训练FRNNLMs。正如期望一样,在GPU上的FRNNLM训练比在CPU上训练的CRNNLM快得多,且NCE训练提供了进一步的速度提升。在测试阶段,使用VR和NCE准则训练的FRNNLMs也比CRNNLMs要快2.5倍以上。
这里写图片描述
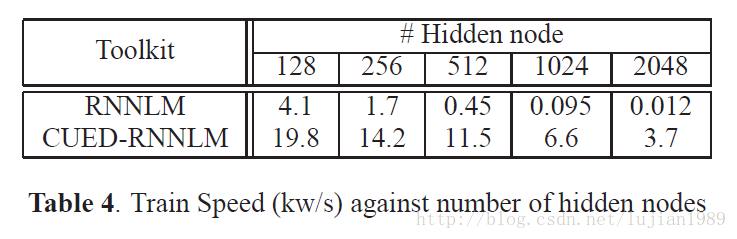
  训练速度严重依赖隐藏层大小。表4比较了一系列隐藏节点数时,使用RNNLM和CUED-RNNLM的训练速度。可以看到较小隐藏层时CRNNLMs是高效的。然而当隐藏层大小提高时,训练速度急剧下降。当隐藏层大小从128提高到2048节点,CRNNLM每秒处理的词数量下降至1/340,即12个词。相比之下,FRNNLMs的训练速度对于隐藏层大小的提升不那么敏感。这表现了CUED-RNNLM对于网络大小较好的伸缩性。
这里写图片描述

8. 结论和未来工作

  我们介绍了CUED-RNNLM工具包,其提供了基于GPU训练RNNLMs的高效实现。全输出层RNNLMs使用方差正则化或噪声对比估计在GPU上训练,然后在CPU上高效评估。还有若干特色计划在将来添加进来。包括基于RNNLM的长短时记忆(LSTM),以及支持更多灵活的RNNLM模型结构。关于该工具包的所有资源可以从http://mi.eng.cam.ac.uk/projects/cued-rnnlm/下载

【AI理论学习】n-gram语言模型和神经网络语言模型 语言模型是自然语言处理中的重要技术,假设一段长度为TTT的文本中的词依次为w1,w2,…,wTw1​,w2​,…,wT​P(w1,w2,...,wT)P(w1​,w2​,...,wT​)语言模型有助于提升自然语言处理任务的效果,例如在语音识别任务中,给定一段“厨房里食油用完了”的语音,有可能会输出“厨房里食油用完了”和“厨房里石油用完了”这两个读音完全一样的文本序列。 阅读详情

相关推荐

rwthlm工具包安装步骤

本篇介绍rwthlm在linux上的安装,我用的系统是ubuntu, 在windows上的安装我没去试,可以参考看看这个博客。 1.首先编译器得支持c++11, 可以在终端中输入 g++ -v 在我的机器上得到如下结果:gcc version 4.8.2 (Ubuntu 4.8.2-19ubuntu1) ,官方文档上写的是g++ 4.6.3 or 4.8.0

天道酬勤,做一个务实的理想主义者 2819

机器学习——python训练RNN模型实战(傻瓜式教学,小学生都可以学会)代码开源

在本例中,我们使用交叉熵作为损失函数,并使用随机梯度下降 (SGD) 优化器进行模型训练。第五章 python训练贝叶斯分类器模型实战。第四章 python训练支持向量机模型实战。第三章 python训练神经网络模型实战。第六章 python训练集成学习模型实战。第二章 python训练决策树模型实战。第八章 python训练KNN模型实战。第九章 python训练CNN模型实战。第十章 python训练RNN模型实战。第一章 python训练线性模型实战。第七章 python训练聚类模型实战。

m0_69235635的博客 2426

Python实现RNN算法对MFCC特征的简单语音识别

Python实现RNN算法对MFCC特征的简单语音识别

LDC,公众号【轻松学编程】 2560

【亲测免费】 推荐开源项目:RNN-From-Scratch - 手把手教你实现循环神经网络

推荐开源项目:RNN-From-Scratch - 手把手教你实现循环神经网络 项目简介 是一个由 pangolulu 创建的开源项目,它提供了一种逐步的方式,让开发者从零开始理解并实现循环神经网络(Recurrent Neural Networks, RNN)。该项目旨在帮助初学者深入理解深度学习的基本原理,而不仅仅是使用现成的库。 技术分析 RNNs 是一种特殊的神经网络结构,它们能够处理序列...

gitblog_00085的博客 680

从零搭建PIC MCU开发环境:MPLAB IDE与HI-TECH编译器安装破解全攻略

本文详细介绍了从零搭建PIC MCU开发环境的完整流程,包括MPLAB IDE 8.85的安装配置、HI-TECH C编译器的安装与破解,以及PICkit3编程器的使用技巧。通过清晰的步骤说明和常见问题解决方案,帮助开发者快速搭建稳定的PIC单片机开发环境,适用于PIC16/18系列MCU开发。

weixin_29188997的博客 283

深入解析Lora SX1268:从基础配置到高级应用

本文深入解析了LoRa SX1268芯片从基础配置到高级应用的全过程。详细介绍了LoRa与FSK模式选择、核心参数(BW、SF、CR、LDRO)的配置策略、数据帧结构、缓冲区管理以及CAD模式等关键概念,旨在帮助开发者充分发挥SX1268在远距离、低功耗物联网通信中的潜力,并提供实用的调试技巧。

weixin_29168393的博客 111

Kaldi实战:LibriSpeech语音识别案例解析

Kaldi实战:LibriSpeech语音识别案例解析 本文深入解析了Kaldi框架在LibriSpeech语音识别案例中的完整实现,涵盖了数据集介绍与预处理、完整语音识别流水线配置、模型训练与超参数调优以及识别结果评估与性能分析四个核心部分。LibriSpeech作为包含约1000小时英语朗读语音的大规模语料库,是语音识别研究的标准基准。文章详细介绍了其数据结构、Kaldi预处理流程,并系统阐述...

gitblog_00116的博客 840

pynq-z2 HLS开发

定制Overlay一.用HLS生成一个定制IP功啊啊是合理的创建标题,有助于目录的生成如何改变是式插入链接与图片如何插入一段漂亮的代码片生成一个适合你的列表创建一个表格设定内容居中、居左、居右SmartyPants创建一个自定义列表如何创建一个注脚注释也是必不可少的KaTeX数学公式新的甘特图功能,丰富你的文章UML 图表FLowchart流程图导出与导入导出导入 一.用HLS生成一个定制IP ...

qq_38769280的博客 4152

引言:RNNLM Toolkit —— 探索语言模型的新边界

引言:RNNLM Toolkit —— 探索语言模型的新边界 [:warning:] 请注意 - 该项目已由Intel停止维护,但如果您对其仍有兴趣或希望独立开发,可以创建自己的fork继续进行。 RNNLM Toolkit 是一个C++实现的循环神经网络语言模型(Recurrent Neural Network Language Model)工具包,它支持三种算法:标准RNNLM,噪声对比估计(...

gitblog_00084的博客 419

手把手教你用ADIsimCLK和GUI搞定HMC7044时钟配置(附避坑指南)

本文详细解析了HMC7044时钟芯片的配置方法,通过ADIsimCLK和HMC7044 Configuration GUI工具,从频率规划到硬件验证全流程实战演示。特别针对PLL模式选择、分频链配置等易错环节,提供量产验证的配置模板和实测数据,帮助工程师快速掌握高性能时钟解决方案。

weixin_30755393的博客 790

树莓派4B学习笔记(5)—— 来个GPIO操作吧

一. GPIO库介绍 对于树莓派,现在有wiringPi,BCM2835,python三种库可以使用。 python 开发语言:python 简单介绍:树莓派官方资料中推荐且容易上手,毫无疑问的说python非常适合树莓派,树莓派也非常适合python。 wiring PI 开发语言:C、C++ 简单介绍:功能很强大,适合那些具有C语言基础,在接触树莓派之前已经接触过单片机或者嵌入式开发的人群。wiring Pi的API函数和arduino非常相似,且作者也给出了很多示例代码,这也使得它广受欢迎。

weixin_44415639的博客 8743

RNN模型

RNN模型 我们先来看一个RNN经典结构,图1展示了一个典型按时间展开后的RNN结构。 从图1可以看出,RNN在每一个时刻都有一个输入Xt,然后根据当前节点的状态At计算输出值ht,而At是根据上一时刻的状态At-1和当前的输入Xt共同决定的。和卷积神经网络卷积核或池化核的参数共享类似,这里RNN结构中的参数在不同时刻中也是共享的。 1.2.1 RNN前向传播过程 图2 RNN的前...

Houser_ 的 博客 1万+

深入解析:el-table合并单元格

  在企业级应用开发中,我们经常需要处理复杂的数据展示需求。在构建复杂的数据展示后台时,我们常常需要将表格中具有相同属性的行进行视觉上的合并,以提升信息的聚合度和可读性。在 Element Plus 的 el-table 组件中,span-method 属性是实现单元格合并的核心机制,允许开发者自定义单元格的合并逻辑,开发者可以通过实现自定义合并策略来满足各种负责需求。  合并行的本质是通过计算相邻行数据的相似性,确定满足合并的单元格范围,然后通过 DOM 操作将多个单元格合并为一个。这种操作在前端数据可视

独泪了无痕 222

Cued In(水题)

DescriptionSnooker is a cue sport played by two players on a rectangular table. The players take turns topot a series of balls of varying colours, where each colour represents a distinct point value f...

Baiyi_destroyer的博客 456

桌面运维工程师面试题详解(一)

桌面运维工程师面试题详解(一)

jks212454的博客 1412

使用 MATLAB/Simulink + Simscape Electrical + SimPowerSystems + Stateflow,构建一个多能互补微电网系统的动态响应仿真模型

本文详细介绍了使用MATLAB/Simulink构建多能互补微电网动态响应仿真模型的方法。文章从系统架构设计入手,包含光伏、风电、柴油发电机、锂电池储能等多种组件,重点讲解了建模过程、控制策略(下垂控制、PLL、SOC管理)和模式切换逻辑(Stateflow)。通过四种典型场景(负荷突增、光伏出力骤降、并网/孤岛切换、电动机启动)的仿真分析,验证了微电网在动态响应中的关键性能指标,并提出了高可靠性设计建议。该模型为微电网的稳定性分析和优化设计提供了有效工具,特别强调了储能系统在快速功率支撑中的重要作用。

amy_mhd的博客 153

[RNN]RNNLM模型

前面的所有模型,思考角度都是从当前全连接的神经网络架构下的,最大的局限就是n,即只能根据,且仅仅是n个词,来预测下一个词的功能。随着RNN的普及,通过输入词序列的方式来“动态”输出下一个词得以实现。RNN的具体概念可以查看之前的RNN草图,这里只是再做一个比方来辅助记忆,RNN看似是时间序列的叠加,最终形成的结果,就像开发一个软件一样,不断的进行迭代。但是,如果从观察者的角度,总有一天,整个软...

小蜗牛之家 860

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

语言模型(一) 工具和使用简介

一、常用工具 1.      Kenlm https://kheafield.com/code/kenlm/ C++版本,最大特点是速度快、占用内存少 2.      Srilm http://www.speech.sri.com/projects/srilm/ SRI(Standford ResearchInstitute)开发,使用比较广泛,c++版本 3.      IRSTL

xmdxcsj的专栏 7231

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

蓝牙模块HM-10手册

蓝牙模块HM-10手册,该手册对蓝牙模块HM-10进行了详细的介绍和使用方法以及一些AT指令。

开源语言模型工具

开源语言模型工具: SRILM( http://www.speech.sri.com/projects/srilm/ )IRSTLM( http://hlt.fbk.eu/en/irstlm )MITLM( http://code.google.com/p/mitlm/ )BerkeleyLM( http://code.google.com/p/berkeleylm/ ) 开源 n-g

wangxiaolei_2008的专栏 1430

廖雪峰Python教程[完整版]

廖雪峰的python教程整理的,已经排好版了,而且还是完整的,适合小白

lstm做NER

1、我在网上下载了人民日报语料库199801.txt文件,nerTest将该文档里的全角符号改为半角符号 然后利用nerTest_1文件对该语料库进行预处理:将语料库中的英文、数字、不正规的写法去除 2、将语料库分为train、test、valid数据集(7:2:1) 3、将语料库中的word与tag分开,然后将所有的word与tag合并排序,并且建立tag_to_id、word_to_id

emmaczw的博客 2607

Cued In

7024: Cued In 时间限制: 1 Sec  内存限制: 128 MB 提交: 127  解决: 54 [提交] [状态] [讨论版] [命题人:admin] 题目描述 Snooker is a cue sport played by two players on a rectangular table. The players take turns to pot a series ...

这里RevolIA,_(:з」∠)_ 369

Kaldi各种已经训练好的模型

做个记录 http://kaldi-asr.org/models.html 这网站是Kaldi中各种语音任务pretrained过的模型 有视源ASR的, xvector做声纹识别的, emebedding做diarization的, 大部分是用LDC的死贵死贵的语料训练的 直接把这些模型拿去解码或者拿去用都可以得出一个很不错的效果, 我们在x-vector参加的NIST评测和自己实验的...

robingao1994的博客 9958

语音识别中的WFST和语言模型

导读 在语音识别系统中,有限加权状态转换机(Weighted Finite State Transducers, WFST)扮演着重要角色。本文主要介绍发音词典、语言模型和WFST的原理,以及在实践过程中的一些优化方法。 背景 目前的实际场景中的语音识别系统更多是基于HMM的传统语音识别框架,如:DNN-HMM,这种框架是由声学模型、发音词典、语言模型和解码器构成的pipeline结构,其中声学模型建模粒度为比音素还小的三音素状态,而语言模型和WFST在其中扮演着重要的角色。 本文将主要围绕三个问题

暮木的博客 3317

Kaldi中的Chain模型

Chain模型的训练流程 链式模型的训练过程是MMI的无网格的版本,从音素级解码图生成HMM,对其使用前向后向算法,获得分母状态后验,通过类似的方式计算分子状态后验,但限于对应于转录的序列。 对于神经网络的每个输出索引(即对于每个pdf-id),我们计算(分子占有概率 - 分母占用概率)的导数,并将它们在网络中反向传播。 分母FST 对于计算中的分母部分,我们对HMM进行前向-后向计算...

weixin_30564901的博客 692

TensorFlow-Course:深度学习训练监控与日志分析完整指南

TensorFlow-Course是一个专注于为初学者和普通用户提供简单易用TensorFlow教程的开源项目。这个项目通过清晰的代码实现和详细的文档,帮助用户快速掌握深度学习的核心概念和实践技能,特别是训练监控和日志分析的关键技术。 ## 为什么深度学习训练监控如此重要? 🎯 在深度学习模型训练过程中,监控训练进度和性能指标至关重要。TensorFlow-Course通过实战教程展示了如何

gitblog_01141的博客 482
上一篇: Linux iptables防火墙规则配置的两个坑
下一篇: 【论文翻译】Tacotron:端到端语音合成
lujian1989
博客等级 码龄16年 73粉丝 15原创
评论 3
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值