


AiBrainBox列车长隧道内外定位-RTK隧道外绝对基准,超宽带隧道内时间基准与测距约束,三目VIO+双IMU高频运动估计,视觉标识绝对位置校正
GNSS-Denied Railway Localization
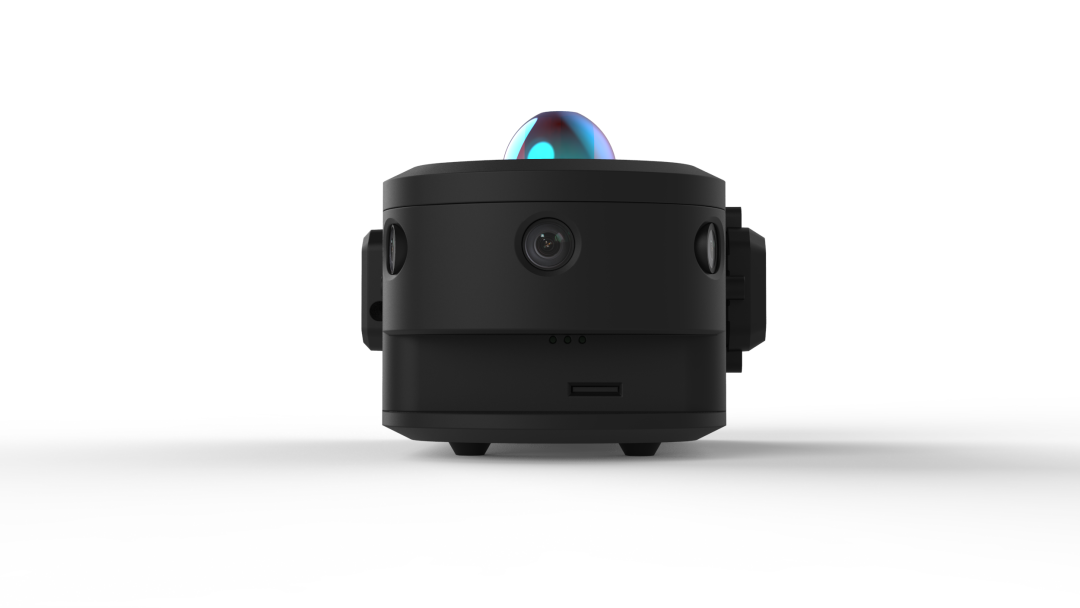
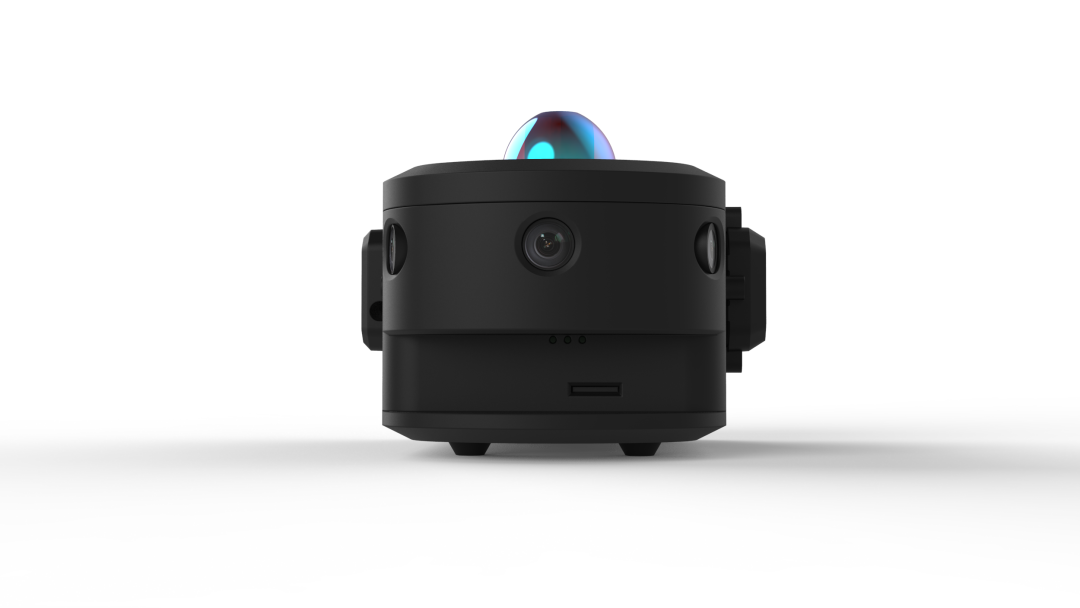
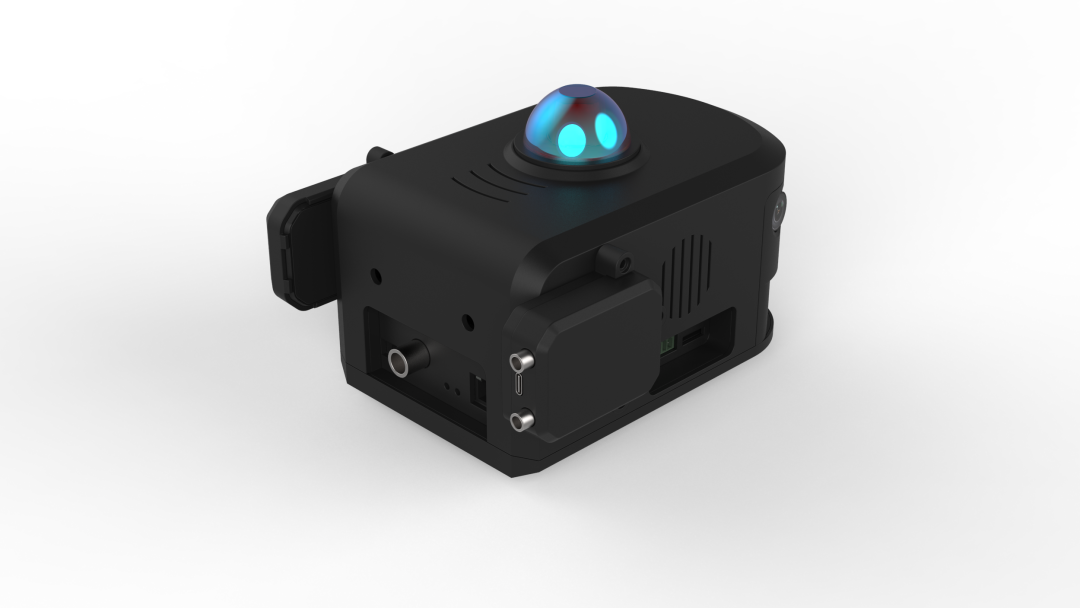
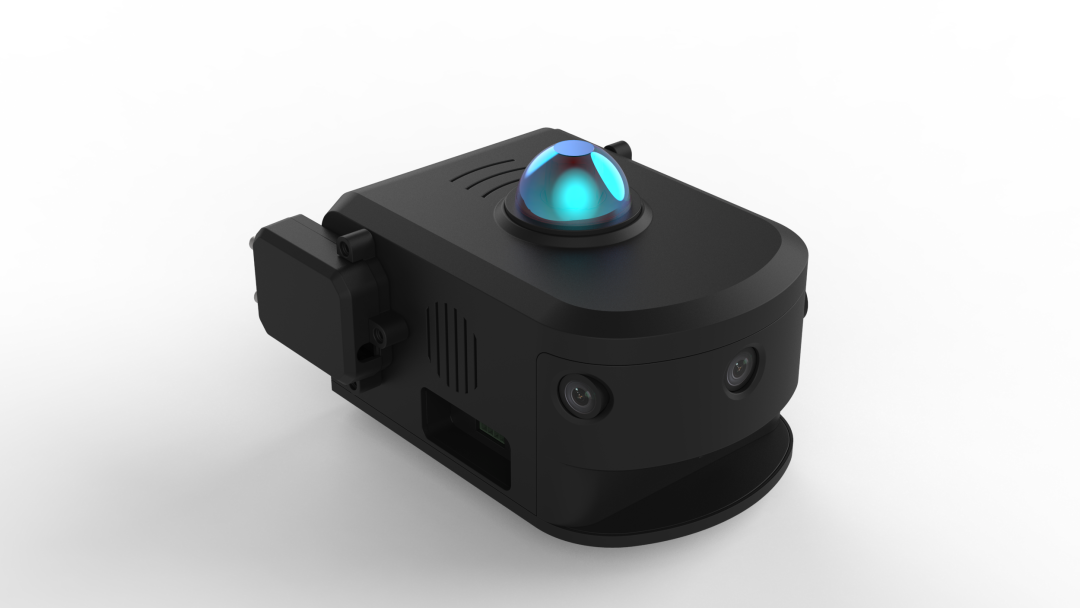
AiBrainBox-UGV 的硬件形态非常适合做成“列车车载定位前端”。但有一个关键判断:
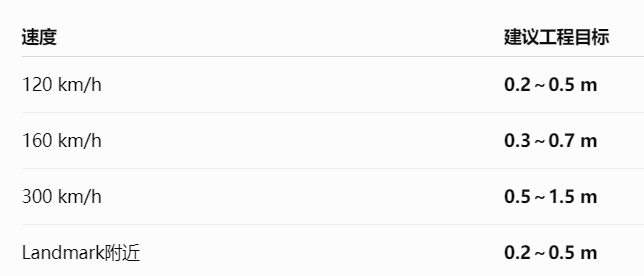
120/160 km/h 下,3目 120 FPS + 双IMU + RTK + 隧道视觉标识,可以做到比较稳定的亚米级定位;300 km/h 下也可以做,但不能把“3目SLAM本身”作为绝对定位保证,必须把 200–300 m 视觉标识作为周期性绝对位置校正,并最好增加车轮里程计/轴速信息或者UWB作为第四类约束。
已有铁路研究也基本印证这个技术方向:GNSS 在隧道中失效后,单纯 MEMS INS 会快速积累误差,而视觉/VIO、里程计、运动约束或 UWB 等外部约束都是解决这一问题的典型路线。近期也已经有 GNSS/INS 与视觉定位切换用于铁路隧道定位的研究,实测 RMS 约 1 m。
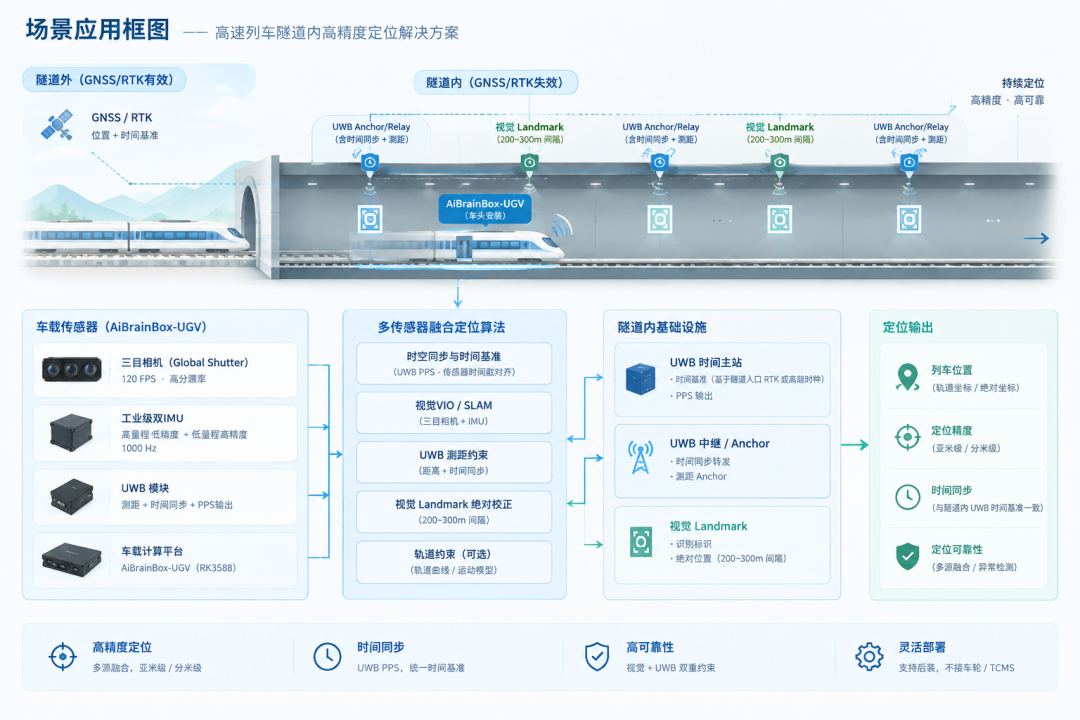
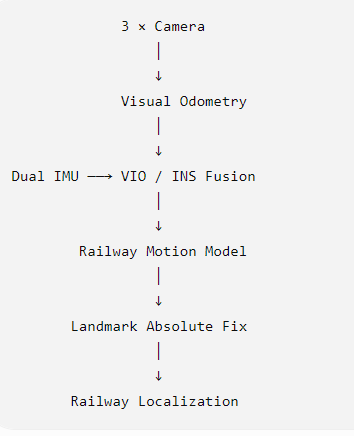
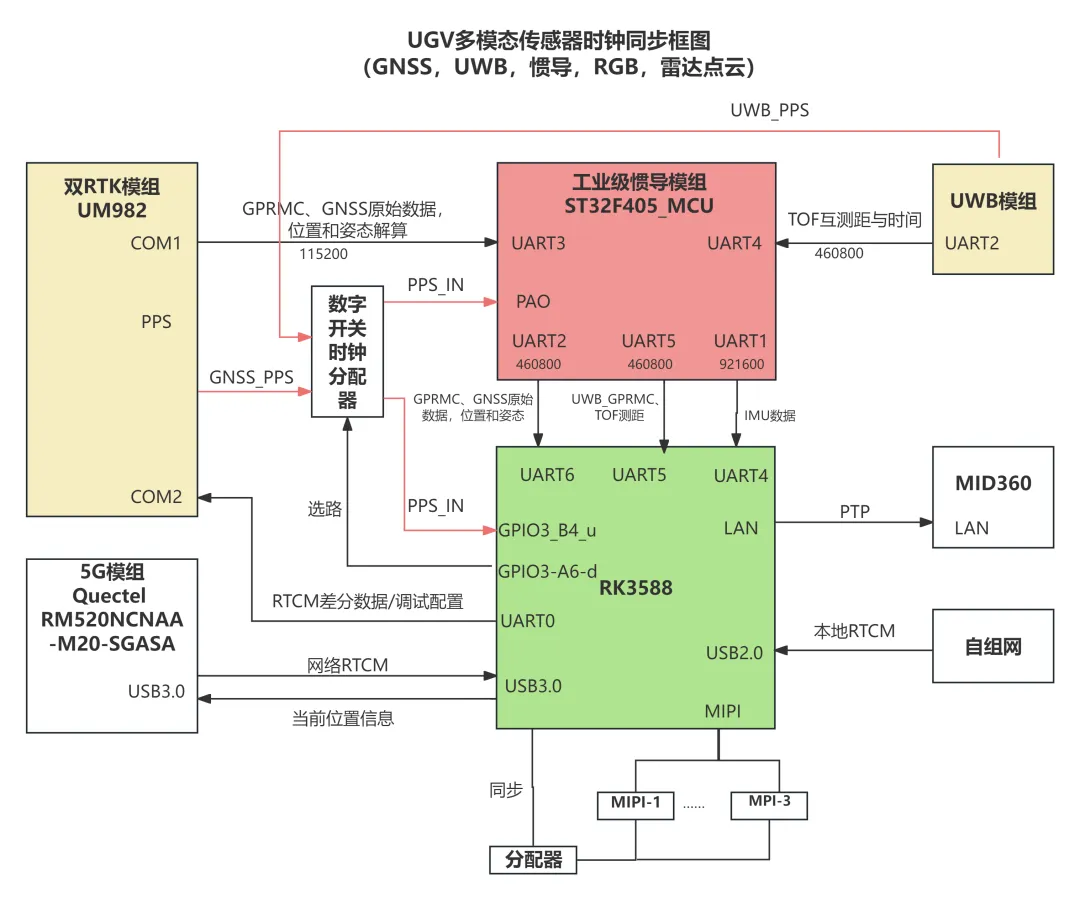
底层:
-
3-Camera VIO(120 FPS全局)
-
Dual-IMU(1000HZ )
-
RTK Initialization(双RTK 位姿)
-
UWB
-
Railway Motion Constraint
-
Visual Landmark Absolute Correction
最终形成:
绝对位置 + 相对连续位姿 + 定位置信度
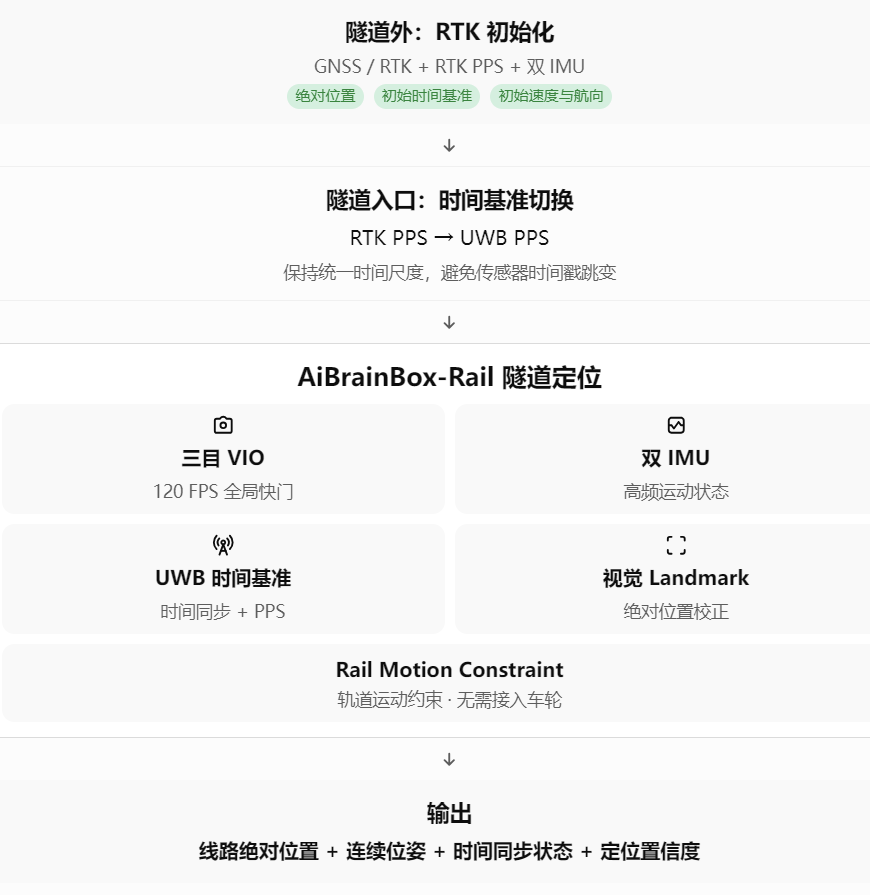
-
三层定位
Layer 1:连续定位
Dual IMU + 3 Camera VIO
120 FPS / 1000 Hz
↓
厘米~分米级短时相对运动
一、列车速度对 120 FPS 的影响
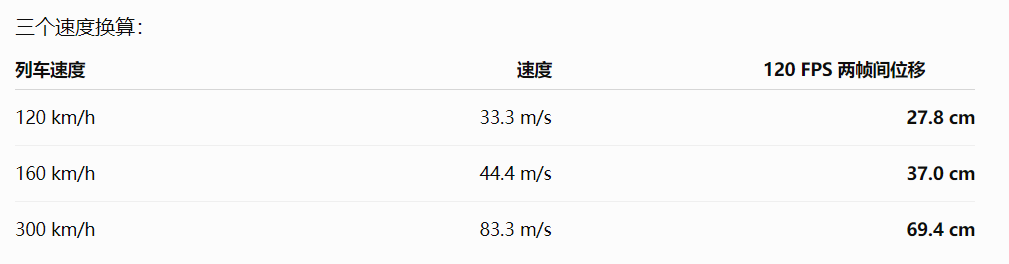
这其实是整个方案最重要的指标。
120 km/h
每帧前进约 28 cm。
对于 120 FPS 三目相机,这已经是一个比较舒服的工作区间。
如果相机:
-
Global Shutter
-
120 FPS
-
曝光时间 1/1000 s 左右
-
前视 FOV 70°~100°
-
有足够纹理
那么连续帧之间虽然已经存在明显位移,但是仍然有大量可跟踪特征。
120 km/h:方案比较稳。
160 km/h
每帧前进约 37 cm。
仍然可以做,但对:
-
镜头焦距
-
分辨率
-
曝光时间
-
特征密度
-
IMU预积分
-
三目几何约束
要求明显提高。
160 km/h:仍属于比较合理的目标。
300 km/h
每帧前进接近:
70 cm / frame
这就开始进入真正需要认真设计的高速视觉里程计区域。
问题不是“120 FPS够不够”,而是:
连续两帧之间的视觉变化已经非常大。
如果隧道比较单调,例如:
-
混凝土壁
-
重复灯具
-
重复电缆
-
重复支架
-
重复轨道结构
SLAM 很容易出现:
-
特征点数量下降
-
特征匹配错误
-
短时间 tracking loss
-
局部尺度/姿态漂移
-
重复结构导致错误匹配
已有铁路视觉里程计研究也特别指出,铁路场景存在尺度漂移、特征关联等问题,需要结合场景信息进行约束。
所以:
300 km/h不是不能做,而是不能把它理解成普通机器人SLAM直接跑到300 km/h。
Layer 2:绝对校正
Visual Landmark
100~300m
↓
绝对位置校正
Layer 3:独立交叉验证
UWB
↓
距离约束 + 时间基准 + 定位完整性检查
最终:
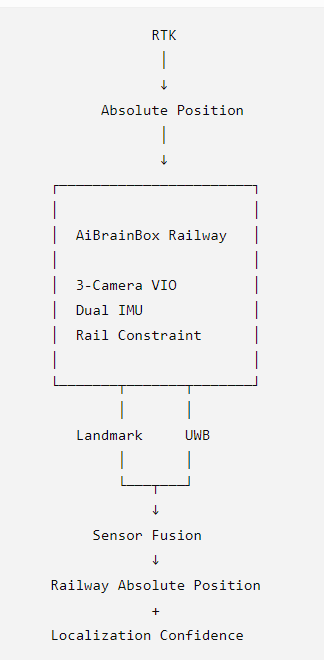
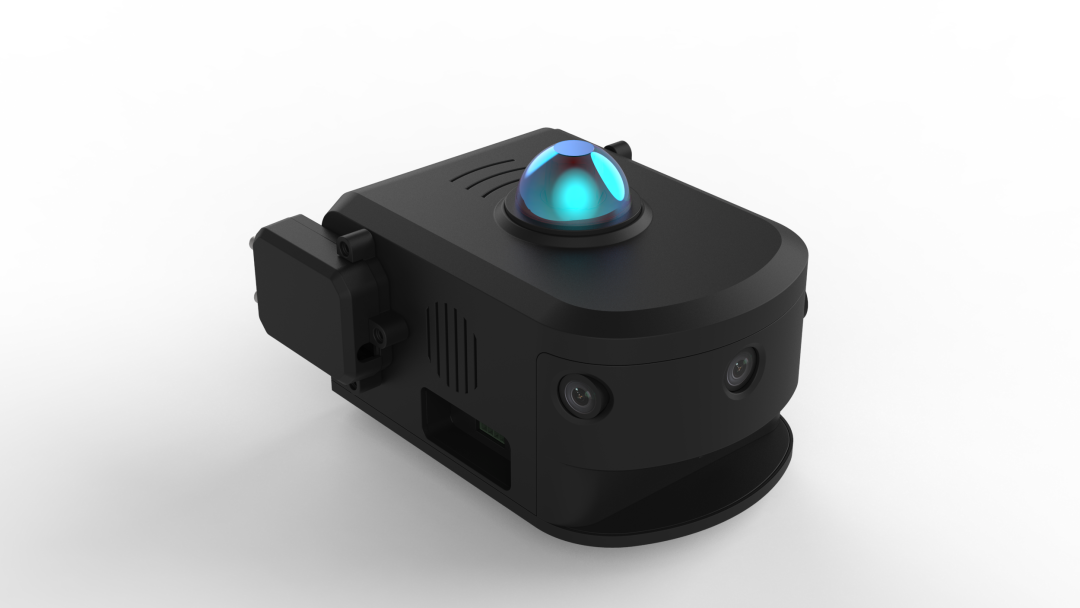
AiBrainBox-UGV 三目是:
-
Front + Left + Right
Front
负责:
-
主视觉里程计
-
隧道纵向结构
-
标识识别
-
轨道/隧道几何
-
前方语义特征
Left + Right
主要价值不是传统意义上的“左右双目测深”,而是:
增加横向环境特征,增强空间约束和长期特征跟踪。
这样做对于隧道特别有价值。
因为前视方向在高速情况下变化太快,而左右墙壁上的:
-
电缆
-
支架
-
洞壁纹理
-
接缝
-
标牌
-
灯具
可以形成相对稳定的侧向特征。
所以把这个系统定义为:
3-camera Railway Visual-Inertial Odometry
而不是简单叫“三目SLAM”。
Front:
-
Global Shutter
-
120 FPS
-
2MP~4MP
-
2.8~4mm左右广角,根据安装高度/FOV确定
-
短曝光
-
HDR
-
硬件同步
Left / Right
-
Global Shutter
-
120 FPS
-
1.3~2MP即可
-
更偏向广视场
-
HDR
-
硬件同步
而且三路必须做到:
Hardware Trigger / FSIN 同步
-
双 IMU 方案
高量程低精度 IMU + 低量程高精度 IMU
这个设计,非常适合高速列车应用。
因为列车车头的振动环境与普通机器人完全不同。
尤其在:
-
道岔
-
接缝
-
高速运行
-
隧道入口
-
隧道内结构变化
情况下,可能出现瞬时较大的角速度/加速度。
所以可以做:
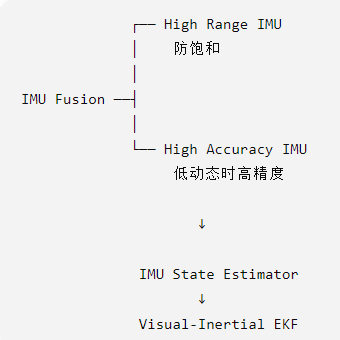
更重要的是:
不要简单做:
两个 IMU 数据平均
而应该做:
Dual-IMU Adaptive Fusion
根据:
-
acceleration
-
angular velocity
-
saturation
-
vibration
-
innovation
动态决定哪个 IMU 更可信。
这会成为 AiBrainBox-UGV 在这个项目里的一个比较有技术含量的地方。
-
RTK 最重要的作用实际上是:
建立进入隧道之前的高精度绝对初始位置和姿态/速度状态。
整个过程应该设计成:
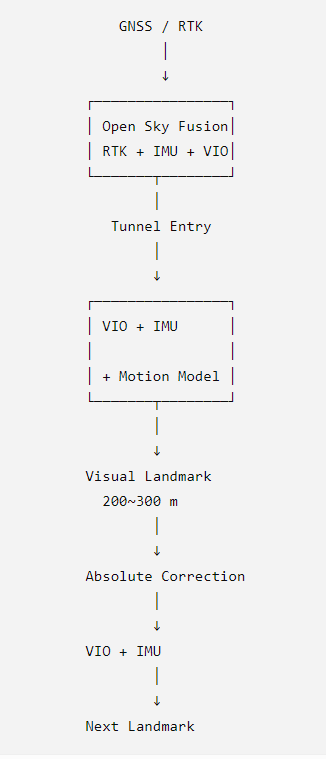
这就是一个非常标准的:
GNSS → VIO/INS → Landmark → VIO/INS → Landmark
的“绝对—相对—绝对”定位体系。
近期铁路定位研究也采用了 GNSS/INS 与视觉定位在 GNSS-denied 环境之间切换的思路。
-
列车本身有很强的运动先验:
基本沿轨道纵向运动;
横向速度相对很小;
垂向运动受轨道约束;
高速运行时速度连续;
转弯时曲率是连续变化的。
因此可以在 VIO/INS 后面增加一个 Rail Motion Constraint:
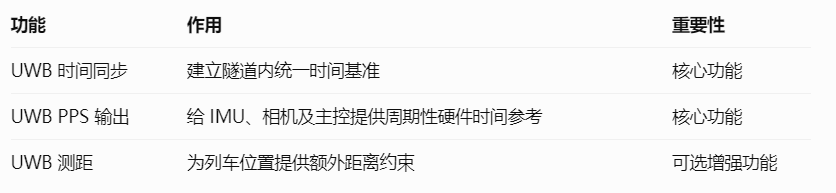
UWB 至少承担三个功能:
Front:主VIO + Landmark
Left/Right:增加隧道壁面的横向特征
这样即使正前方:
灯光变化
轨道区域纹理重复
视觉特征不足
左右两侧仍然可以提供辅助特征。
-
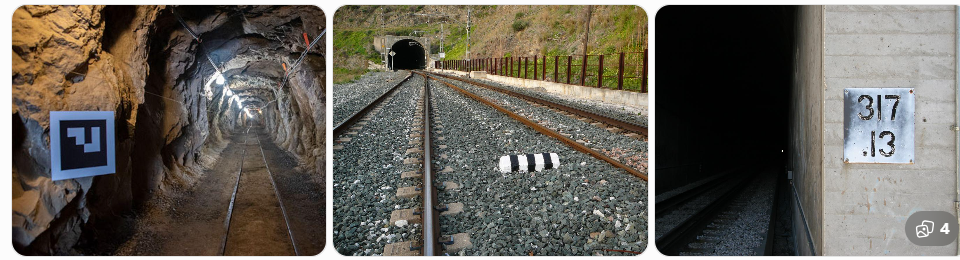
200~300 m 一个视觉标识,这个设计非常关键
这个设计是整个方案能不能做到稳定亚米级的关键。
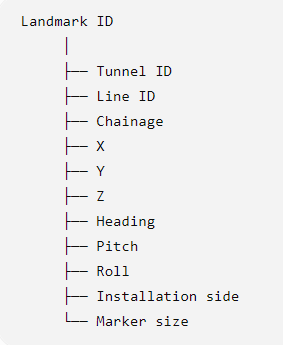
应该设计成:
Railway Localization Landmark
包括:
-
唯一ID
-
精确线路坐标
-
轨道方向
-
安装高度
-
安装横向位置
-
可视尺寸
-
多尺度编码
-
几何定位特征
视觉识别之后不是简单:
“我看到了 Landmark 23”
而是:
“Camera 相对于 Landmark 23 的 6DoF 位姿是多少?”
这样才能真正给 SLAM/INS 提供:
绝对位置观测量。
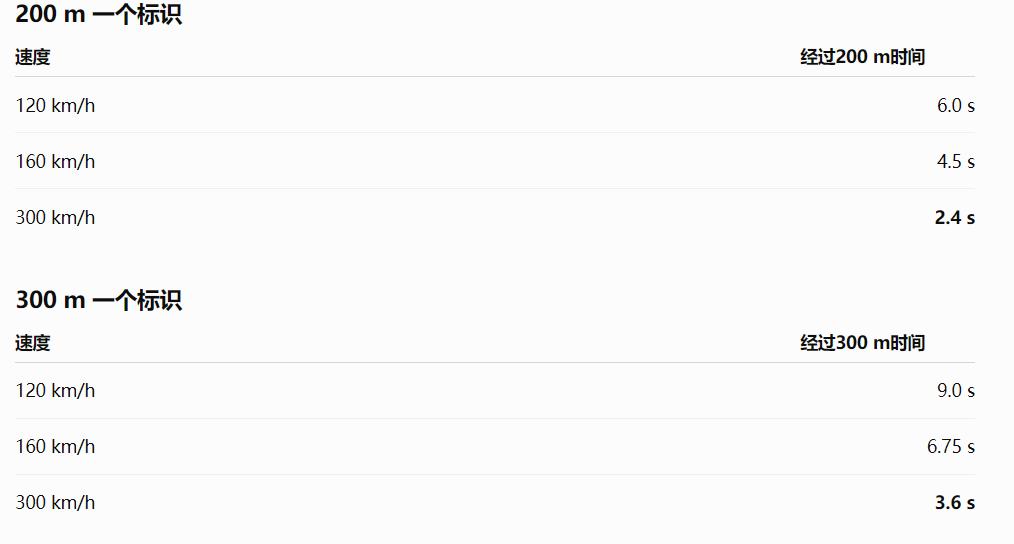
所以对于 300 km/h:
200~300 m 一个 Landmark,相当于每 2.4~3.6 秒给系统一次绝对位置校正。
这其实是比较好的。
Landmark
是:
在列车高速通过时,能够稳定检测 → 唯一识别 → 精确估计相对6DoF位姿 → 转换为线路绝对坐标。
推荐尺寸
初期原型可以测试:
600 × 600 mm
以及:
800 × 800 mm
两个规格。
甚至在某些隧道条件下:
1000 × 1000 mm
原因很简单:
300 km/h:
83.3 m/s
如果只在经过 Landmark 的瞬间才识别,那就已经太晚。
应该做到:
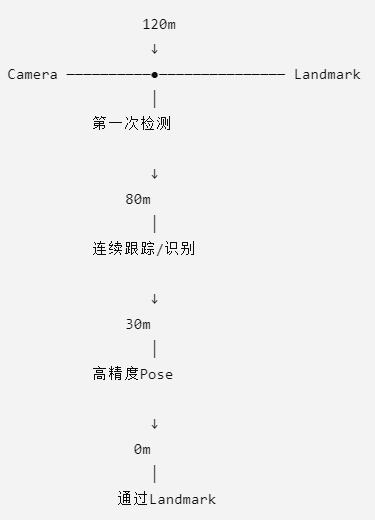
这样系统不是“看到一次”,而是:
几十米范围内连续观测同一个 Landmark。
这对精度非常重要。
Landmark 应该包含“绝对线路坐标”
在列车高速通过时,能够稳定检测 → 唯一识别 → 精确估计相对6DoF位姿 → 转换为线路绝对坐标。
实际效果高度依赖:
-
隧道纹理;
-
相机FOV;
-
分辨率;
-
曝光时间;
-
Landmark尺寸;
-
Landmark安装精度;
-
双IMU性能;
-
VIO算法;
-
隧道照明;
-
列车振动。
视觉算法建议
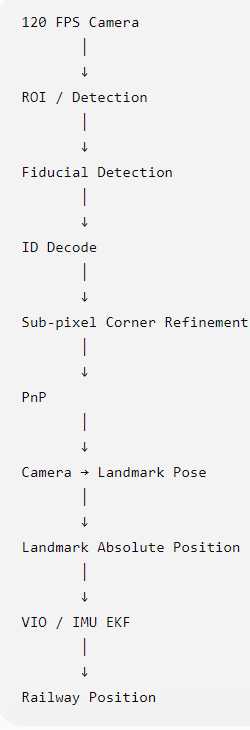
其中:
Sub-pixel Corner Refinement
Phase 1|可用性验证
30 km/h
三目VIO + 双IMU + UWB时间同步 + Landmark
证明:
系统能连续定位。
Phase 2|高速定位验证
120 / 160 km/h
不同Landmark间距
证明:
亚米级连续定位。
Phase 3|极限工况验证
300 km/h
高速视觉 + UWB + Landmark
证明:
高速GNSS-denied环境下仍具备连续定位能力。
AiBrainBox-UGV铁路后装定位方案的核心技术路线
“GNSS/RTK提供隧道外绝对基准,UWB提供隧道内统一时间基准与测距约束,三目VIO+双IMU提供高频连续运动估计,视觉Landmark提供周期性绝对位置校正。”


 扫一扫


 590

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


