


 本文详述了Hadoop MapReduce的相关知识,包括MapReduce的框架结构、工作流程、核心函数Map与Reduce的职责,以及在WordCount案例中的应用。此外,还探讨了MapReduce与Hadoop的关系、适合MapReduce处理的任务特点、故障处理和数据传输优化策略。
** 本专栏的Hadoop复习计划文章内容主要包含以下几个部分:
【简单】学习通习题
【进阶】课本课后练习
【操作】相关章节实验回顾
让我们开始吧!
学习通 - 习题
1. 下列说法错误的是
A.MapReduce框架采用了Master/Slave架构,包括一个Master和若干个Slave
B.Hadoop框架是用Java实现的,MapReduce应用程序则一定要用Java来写
C.不同的Map任务之间不能互相通信
D.Map函数将输入的元素转换成<key,value>形式的键值对
我的答案:B
解析:
A.MapReduce框架采用了Master/Slave架构,包括一个Master和若干个Slave - 正确
- Master:运行JobTracker
- Slave:运行TaskTracker
B.Hadoop框架是用Java实现的,MapReduce应用程序则一定要用Java来写 - 错误
hadoop 可以通过 hadoop streaming 的方式调用其他编程语言实现 MapReduce,例如c++,Python等
C.不同的Map任务之间不能互相通信 - 正确
D.Map函数将输入的元素转换成<key,value>形式的键值对 - 正确
2. 在使用MapReduce程序WordCount进行词频统计时,对于文本行“hello hadoop hello world”,经过WordCount程序的Map函数处理后直接输出的中间结果,应该是下面哪种形式
A.<"hello",1>、<"hello",1>、<"hadoop",1>和<"world",1>
B.<"hello",2>、<"hadoop",1>和<"world",1>
C.<"hello",<1,1>>、<"hadoop",1>和<"world",1>
D.<"hello",1,1>、<"hadoop",1>和<"world",1>
我的答案:A
解析:
1)map之后的“中间结果”(只产生键值对)
<"hello",1>、<"hello",1>、<"hadoop",1>、<"world",1>
2)shuffle之后的结果(整合)
<"hello",<1,1>>、<"hadoop",1>和<"world",1>
3)reduce之后的结果(统计)
<"hello",2>、<"hadoop",1>和<"world",1>
3. 对于文本行“hello hadoop hello world”,经过WordCount的Reduce函数处理后的结果是
A.<"hello",1,1><"hadoop",1><"world",1>
B.<"hello",1><"hello",1><"hadoop",1><"world",1>
C.<"hello",2><"hadoop",1><"world",1>
D. <"hello",<1,1>><"hadoop",1><"world",1>
我的答案:C
解析:
流程同上一题,可知应选C
课本 - 课后练习
1. 试述mapreduce与hadoop的关系
hadoop mapreduce运行在分布式文件系统HDFS上
2. 试述适合mapreduce处理的任务或者数据集应该满足怎样的要求
待处理的数据集可以分解成许多小数据集,而且每一个小数据集都可以完全并行地进行处理
3. mapreduce模型采用master(jobtracker) / slave(tasktracker)的结构,试描述jobtracker和tasktracker的功能
1)JobTracker(master上运行)
- 资源监控:监控所有TaskTracker与Job的健康状况,一旦发现失败,就将相应的任务转移到其他节点
- 作业调度:会跟踪任务的执行进度、资源使用量等信息,并将这些信息告诉任务调度器(TaskScheduler),而调度器会在资源出现空闲时,选择合适的任务去使用这些资源
2)TaskTracker(slave上运行)
- 周期性地发送“心跳”信息:周期性地将本节点上资源的使用情况和任务的运行进度汇报给JobTracker
- 执行命令:接收JobTracker 发送过来的命令并执行相应的操作
- 使用“slot”等量划分本节点上的资源量:一个Task 获取到一个slot 后才有机会运行,而Hadoop调度器的作用就是将各个TaskTracker上的空闲slot分配给Task使用,slot 分为Map slot 和Reduce slot 两种,分别供MapTask 和Reduce Task 使用
4. tasktracker出现故障会有什么影响?该故障如何处理的?
** 找不到标准答案,以下是非官方答案:
很不幸,JobTracker 存在单点故障,一旦出现故障,整个集群就不可用。这个是1.0里面出现的问题,在2.0里面这个问题已经得到了解决。 不过大家放心,即使在1.0中,MapReduce也不会经常出现故障。它可能一年也就是出现几次故障,出现故障之后,你重启一下,再把作业重新提交就可以了,它不会像HDFS那样出现数据的丢失。 因为 MapReduce 是一个计算框架,计算过程是可以重现的,即使某个服务挂掉了,你重启一下服务,然后把作业重新提交,也是不会影响你的业务的。
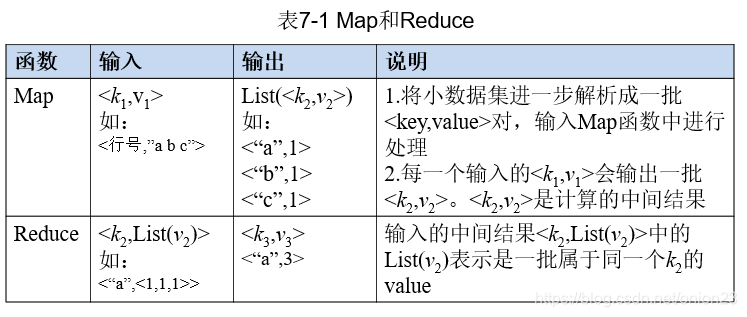
5. mapreduce计算模型的核心是map函数和reduce函数,试述这两个函数各自的输入、输出、处理过程
6. 试述mapreduce的工作流程
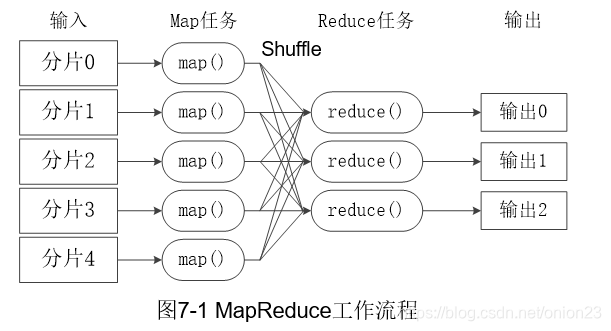
简单过程:
- map任务
- shuffle阶段
- reduce任务
- 输出
简单示意图:
7. 分析shuffle过程的作用
- 对map任务的输出结果进行分区、排序、合并等
- 交给reduce任务
8. 分别描述map端和reduce端的shuffle过程(spill、sort、merge、fetch)
1)map端shuffle
- 输入数据,执行map任务
- 写入缓存
- 溢写 spill(分区、排序 sort、合并 combine)
- 文件归并 merge
** 注:合并(Combine)和归并(Merge)的区别
两个键值对<“a”,1>和<“a”,1>,如果合并,会得到<“a”,2>,如果归并,会得到<“a”,<1,1>>
2)reduce端shuffle
- reduce任务会从来自不同map端领回属于自己所要处理的分区的数据
- 然后对数据进行归并 (merge) ,交给reduce处理
9. 试述什么是本地计算,并分析为何要采用本地计算
- 本地计算:在一个集群中,map程序尽量在就近的HDFS数据节点上进行运行
- 优点:可以避免大规模数据移动带来的网络传输开销
10. 试说明一个mapreduce程序在运行期间所启动的map任务数量和reduce任务数量分别是由什么因素决定的
- map任务数量:取决于map作业的大小,即数据量的大小
- reduce任务数量:取决于map任务输出结果中key的数量
11. 是否所有的mapreduce程序都需要经过map和reduce这两个过程?如果不是,请举例说明
不是,对于关系的选择运算,只需要 Map 过程就能实现,对于关系 R 中的每个元组 t,检测是否是满足条件,如果满足条件,则输出键值对,也就是说,键和值都是 t,这时的 Reduce 函数就只是一个恒等式,对输入不做任何变换就直接输出
12. 试分析为何采用combiner可以减少数据传输量?是否所有的mapreduce程序都可以采用combiner?为什么?
- 合并(combine)是指将那些具有相同键的键值对的值加起来,经过合并操作这些键值对就会变成一个键值对,减少了键值对的数量
- 不过,并不是所有mapreduce程序都可以进行combiner,只有在不改变reduce任务最终计算结果的前提下,才能进行combine操作,一般在累加,求和场景下都可进行
13. mapreduce程序的输入文件、输出文件都储存在HDFS中,而在map任务完成时的中间结果则储存在本地磁盘中,试分析中间结果储存在本地磁盘而不是HDFS上有何优缺点
1)优点
- reduce任务一旦输出最终结果,就可将map任务生成的中间结果删除,存储在hdfs上有些小题大做
2)缺点
- 当任务在map将中间结果传送给reduce时失败,hadoop只能将其在另一个节点上运行以获得中间结果
14. 早期版本的HDFS,其默认块(block)大小为64MB,而较新的版本默认为128MB,采用较大的块有什么优缺点?
1)优点
- 最小化寻址开销
- 减少Namenode内存消耗
2)缺点
- 一个map任务处理一个块的数据,如果数据过大,会导致map任务数量减少,从而使得map运行并行度降低,map阶段处理速度将变得缓慢
- 系统需要重新启动时,启动过程需要重新加载数据,数据块越大,数据加载时间越长,系统恢复过程越长
15. 试画出使用mapreduce来对英语句子"whatever is worth doing is worth doing well"进行单词统计的过程
1)map输入
whatever is worth doing is worth doing well
2)map输出
<whatever,1>
<is,1>
<worth,1>
<doing,1>
<is,1>
<worth,1>
<doing,1>
<well,1>
3)map端shuffle后
<whatever,1>
<is,<1,1>>
<worth,<1,1>>
<doing,<1,1>>
<well,1>
4)reduce输出
<whatever,1>
<is,2>
<worth,2>
<doing,2>
<well,1>
16. 在基于mapreduce的单词统计中,mapreduce是如何保证相同的单词数据会划分到同一个reduce上进行处理以保证结果的正确性?
- map溢写时会根据key值进行分区,相同key的键值对保存在一个分区,并对相同key的键值对进行归并
- reduce会领取map端处理后的数据,此时同一个分区的键值对正是key值相同的键值对
17. - 22. 个人感觉超纲了,忽略,最重要的是,没时间写了= =
** 课后习题参考:大数据技术课后习题
实验操作 - MapReduce实现数字排序
详见我之前的写的:【hadoop学习之路】MapReduce实现数字排序


 扫一扫


 1万+


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


