


文章目录
- 一、Redis主从
- 二、Redis 高可用进阶(二):Sentinel 哨兵与选主算法
- 1. 一次大促事故:Redis 切了主,业务却没有恢复
- 2. 先明确边界:Sentinel 能做什么,不能做什么
- 3. Sentinel 如何认识整个拓扑
- 4. SDOWN、ODOWN 与两个完全不同的门槛
- 5. 第一次选举:谁来执行故障转移
- 6. 第二次选择:哪一个 Replica 应晋升
- 7. 故障转移状态机:切主不只是 `REPLICAOF NO ONE`
- 8. 数据一致性:切换成功不等于零丢失
- 9. 生产架构:把故障限制在缓存域内
- 10. Redis 与 Sentinel 的生产配置
- 11. Kubernetes 落地:稳定身份不等于固定角色
- 12. Spring Boot 生产级接入
- 13. 高并发治理:切换时最危险的是放大效应
- 14. 可观测性:要同时看控制面、数据面和客户端
- 15. 故障演练:验证的是完整链路,不是“Pod 能重启”
- 16. 常见错误方案与修正
- 17. 从告警到恢复的操作手册
- 18. 最终设计清单
- 19. 总结
- 参考资料
。
一、Redis主从
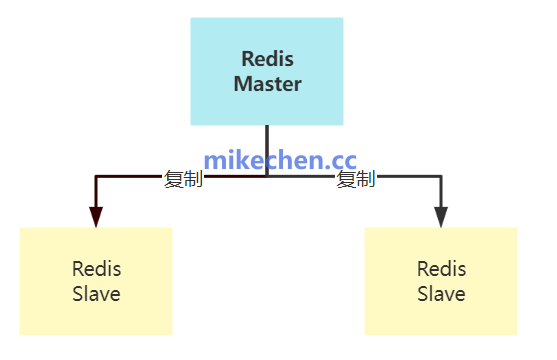
Redis 主从是指:一个 Redis 实例作为主节点(Master),负责写入。
一个或多个 Redis 实例作为从节点(Slave/Replica),从主节点同步数据并提供读服务。
主从复制的核心目的主要有三个:
数据冗余与高可用基础:主节点数据可以复制到多个从节点,降低单点故障风险。
读写分离:写请求集中到主节点,读请求可以分散到从节点,从而提升整体吞吐量。
故障恢复与弹性扩展:当主节点出现问题时,从节点可以在一定机制下接管服务,保证业务连续性。
1. Redis主从架构
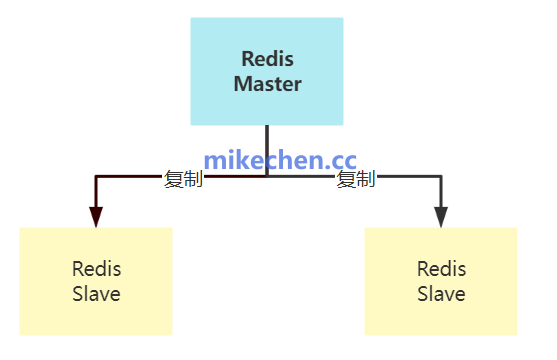
Redis主从架构,主要就是两部分:Redis Master(主)和Redis Slave(从)。
Application
|
+-------+-------+
||
写读
||
    v               v
+--------++----------+
|Master|---->|Replica1|
+--------++----------+
|+----------+
+--------->|Replica2|
+----------+
|
+--------->+----------+
|Replica3|
+----------+
Master负责写:
SETuser:1001
然后把数据变化复制给多个 Replica。
读请求可以分散到:
Replica1;Replica2;Replica3;
这样可以提高 Redis 的读吞吐能力。
2. Redis主从原理
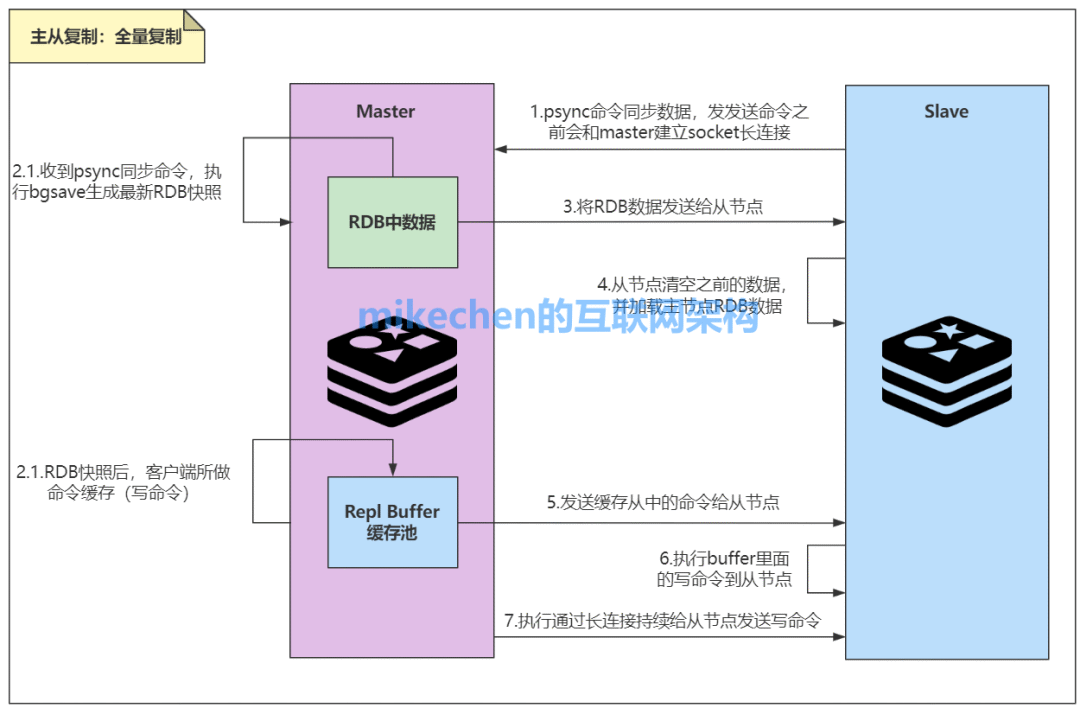
Redis 的主从复制流程,如下:
 -mikechen")
- 建立复制关系
从节点通过配置或命令指定主节点地址,随后向主节点发起连接请求。
连接建立后,从节点会向主节点发送同步请求。
- 全量同步
当从节点首次连接主节点,或者复制断开时间较长、无法通过增量补齐时,主节点会进行全量同步。
全量同步的特点是数据完整,但代价较高,尤其在数据量大时会占用较多 CPU、磁盘和网络资源。
- 增量同步
当主从连接短暂中断后,如果主节点仍保留断线期间的复制积压数据。
节点可通过增量同步补齐差异,而无需重新执行全量同步。
增量同步显著降低了复制成本,也是 Redis 主从复制高效的重要原因。
二、Redis 高可用进阶(二):Sentinel 哨兵与选主算法
Redis Sentinel 解决的不是“Redis 永不故障”,而是三个更具体的问题:谁来判断主库不可用,谁有权执行切换,以及应用如何找到切换后的新主库。
这三个问题看似简单,实际横跨故障检测、分布式投票、异步复制、客户端服务发现和云原生网络。生产环境中常见的“Sentinel 明明部署了,为什么仍中断两分钟”,通常不是单点错误,而是控制面、数据面和客户端同时存在缺口。
本文以一个大促商品详情缓存集群为贯穿案例,完整拆解 Sentinel 的内部机制、选主算法、故障转移状态机与工程边界,并给出可落地的 Redis、Sentinel、Spring Boot 和 Kubernetes 配置。
说明:本文使用 Redis 官方现行术语
master/replica;旧版本配置中的slave-*已对应为replica-*。文中的容量数字是案例的设计目标和演练条件,不是未经验证的性能结论。上线前必须用自己的数据结构、命令比例和网络环境压测。
1. 一次大促事故:Redis 切了主,业务却没有恢复
1.1 业务背景
某电商商品域用 Redis 缓存商品详情、营销标签和短时库存展示值:
-
日常读取约 2 万 QPS,大促设计峰值 12 万 QPS;
-
读写比约 200:1,单个热销商品可能占总请求的 15%;
-
PostgreSQL 是商品真相源,Redis 数据可以重建;
-
Redis 为一主两副本,3 个 Sentinel,应用部署 60 个 Pod;
-
目标是单 Redis 节点故障后自动恢复,缓存故障不得拖垮数据库。
零点流量上升后,主库宿主机发生网络故障。Sentinel 最终完成了主从切换,但业务仍持续出现 5xx。事故链路如下:
-
down-after-milliseconds设为 30 秒,故障发现本身就不可能在 5 秒内完成;
-
- 一个 Sentinel 与主库部署在同一节点,节点故障后只剩两个 Sentinel,网络抖动期间无法稳定形成多数派;
-
- 一部分应用直连旧主 IP,没有使用 Sentinel-aware 客户端;
-
- 其余应用在切换时立即无退避重试,60 个 Pod 同时重建连接,形成连接风暴;
-
- Redis miss 被不加限制地回源数据库,最终 Redis 故障演变为数据库雪崩。
这次事故暴露出一个核心事实:
Sentinel 只负责 Redis 主从拓扑的故障转移,不负责业务降级、数据库保护、命令幂等,也不会替客户端自动更换一个写死的 IP。
1.2 故障预算应该如何拆
切换时间不是一个 failover-timeout 参数,而是一条端到端链路:
业务不可用窗口 ≈ 故障检测 + ODOWN 协商 + Leader 选举 + Replica 晋升 + 配置传播 + 客户端发现/重连
每一项都受网络 RTT、事件循环阻塞、Sentinel 存活数、Replica 数据新鲜度和客户端行为影响。因此 SLO 应通过故障演练得到分位数,而不能把某个配置值直接写成“保证 5 秒切换”。
2. 先明确边界:Sentinel 能做什么,不能做什么
2.1 四项职责
根据 Redis Sentinel 官方文档,Sentinel 同时承担四类职责:
-
- 监控:周期性检查 master、replica 和其他 Sentinel;
-
- 通知:通过日志、Pub/Sub 或通知脚本输出状态变化;
-
- 自动故障转移:选出执行者,把合适的 replica 提升为 master,并重配其余 replica;
-
- 配置提供者:客户端通过 master name 查询当前 master 地址。
在逻辑上,Sentinel 是控制面,Redis 是数据面,客户端是流量切换执行者:
客户端对 Sentinel 的正确使用方式,不是把 Sentinel 当数据代理。应用先从 Sentinel 获取 master 地址,再直接连接 Redis 数据节点。官方的 Sentinel client specification 要求客户端具备显式 Sentinel 支持。
2.2 Sentinel 不提供的能力
-
不分片:一个 master group 的写吞吐仍受单 Redis 主线程和单节点资源上限约束;
-
不提供强一致复制:Redis 主从复制默认异步,故障切换存在丢失最近写入的窗口;
-
不保证业务写幂等:超时可能发生在服务端执行成功、客户端收到响应之前;
-
不保护下游数据库:缓存失效后的并发回源必须由应用治理;
-
不自动修复错误客户端:直连 IP、错误 DNS 缓存、无限重试都在 Sentinel 的职责之外;
-
不等同于跨地域容灾:跨地域 RTT、分区和复制延迟需要独立的灾备设计。
因此,Sentinel 最适合“数据量能放入单主、以读为主、允许短暂切换窗口、应用支持 Sentinel 服务发现”的场景。
3. Sentinel 如何认识整个拓扑
3.1 为什么只配置 master
最小配置只需声明 master:
sentinel monitor orders-cache redis-0.redis-headless.cache.svc.cluster.local 6379 2
Replica 由 Sentinel 查询 master 的 INFO replication 自动发现。监控同一 master group 的 Sentinel 则通过 Redis 节点上的 __sentinel__:hello Pub/Sub 频道互相发现,并传播自己的地址、run ID 和配置纪元。
这带来两个容易忽略的结论:
-
- Sentinel 不只是要能访问初始 master,还必须能访问 master 报告出来的每个 replica 地址;
-
- NAT、端口映射或错误的容器通告地址会让“看起来已启动”的 Sentinel 找不到可晋升节点。
3.2 健康探测不是一次 PING
Sentinel 的事件循环会周期性发送 PING、INFO 和 hello 消息。down-after-milliseconds 表示在整个窗口内没有收到可接受响应,Sentinel 才把实例标为主观下线;它不是 TCP connect timeout,也不是“连续失败次数”。
有效响应包括 PONG、LOADING 和 MASTERDOWN;其他错误或无响应都不能证明实例可用。除此之外,如果逻辑 master 在 INFO 中宣称自己是 replica,Sentinel 也会把它视作异常。
Redis 事件循环被超长 Lua 脚本、大 Key 删除、内存换页或宿主机 CPU throttling 阻塞时,即使进程没有退出,也可能无法及时回答 PING。这是 Sentinel 把“进程活着但服务不可用”判为故障的必要设计,却也意味着阈值必须覆盖正常抖动。
4. SDOWN、ODOWN 与两个完全不同的门槛
4.1 SDOWN:单个 Sentinel 的本地判断
当 Sentinel S1 在 down-after-milliseconds 窗口内收不到 master 的有效回复,S1 将其标记为 SDOWN(Subjectively Down,主观下线)。
SDOWN 是本地意见:S1 认为 master 不可用,不代表其他 Sentinel 同意。
4.2 ODOWN:达到 quorum 的故障共识
S1 随后通过 SENTINEL is-master-down-by-addr 询问其他 Sentinel。若在有效时间窗口内,至少 quorum 个 Sentinel 都认为该 master 下线,master 才进入 ODOWN(Objectively Down,客观下线)。
ODOWN 只用于 master。Replica 或 Sentinel 自身只需要 SDOWN,因为它们下线不会直接触发 master failover。
4.3 quorum 不等于多数派
这是 Sentinel 配置中最常见的误解:
-
quorum决定“多少 Sentinel 同意故障,才能标记 ODOWN”; -
多数派授权决定“某个 Sentinel 是否有权真正执行 failover”。
若有 5 个 Sentinel、quorum=2:两个 Sentinel 同意即可 ODOWN,但至少 3 个 Sentinel 可通信并投票,切换才会执行。执行授权的有效门槛可理解为:
max(配置的 quorum, floor(已知 Sentinel 总数 / 2) + 1)
| Sentinel 总数 | 建议 quorum | 可容忍 Sentinel 故障数 | 说明 |
|---|---|---|---|
| 2 | 不推荐 | 0 | 任一节点故障后无多数派 |
| 3 | 2 | 1 | 常见最小生产配置 |
| 5 | 3 | 2 | 更高控制面容错,运维成本也更高 |
奇数并不是算法的硬性语法要求,但能避免偶数部署付出更多节点却没有增加多数派容错能力。比“奇数”更重要的是独立故障域:3 个 Sentinel 放在同一宿主机或同一可用区,逻辑上仍接近单点。
4.4 状态变化全景
5. 第一次选举:谁来执行故障转移
多个 Sentinel 可能几乎同时观察到 ODOWN,但只能有一个执行者,否则它们可能提升不同的 replica。Sentinel 使用配置纪元 configuration epoch 和投票来解决这个问题。
5.1 Leader 选举过程
-
- 候选 Sentinel 增加当前 epoch;
-
- 通过
SENTINEL is-master-down-by-addr请求其他 Sentinel 在该 epoch 投票;
- 通过
-
- 每个 Sentinel 在一个 epoch 内只能投一票,先收到的合法请求通常先得票;
-
- 候选者获得所需授权后成为本轮 Leader;
-
- 若无人获胜,后续在新的 epoch 中重试。
它借鉴了 Raft 的 term/单轮单票思想,但 Sentinel 不是一个通用 Raft 日志复制系统,不应简单写成“Sentinel 使用 Raft”。更准确的表述是 Raft-like Leader election。
5.2 epoch 为什么重要
epoch 是故障转移配置的逻辑版本号。网络分区恢复后,Sentinel 会倾向接受更新 epoch 的拓扑,使旧 master 最终被重新配置为新 master 的 replica。
Sentinel 的安全目标不是永远不出现两个能接收写入的进程——异步复制和网络分区下仍可能短暂脑裂——而是让控制面在每个配置纪元只授权一个故障转移,并让新配置最终收敛。
5.3 为什么 3 个 Sentinel 仍可能切不了
“有 3 个进程”不等于“有 3 张有效票”。以下任一问题都可能阻止授权:
-
Sentinel 之间的 26379 端口被 NetworkPolicy 或安全组阻断;
-
两个 Sentinel 实际落在同一故障节点;
-
announce-ip/ hostname 错误,其他 Sentinel 无法回连; -
Sentinel 的持久化配置不可写,重启后丢失发现状态;
-
配置的 master name 不一致,节点监控的并不是同一 master group;
-
旧 Sentinel 长期未清理,被计入“已知 Sentinel 总数”,抬高多数派门槛。
应持续执行并监控:
redis-cli -h sentinel-0 -p 26379 SENTINEL CKQUORUM orders-cache redis-cli -h sentinel-0 -p 26379 SENTINEL MASTER orders-cache redis-cli -h sentinel-0 -p 26379 SENTINEL SENTINELS orders-cache
CKQUORUM 会同时检查 ODOWN 所需 quorum 和执行 failover 所需多数派,比只看进程存活更有价值。
6. 第二次选择:哪一个 Replica 应晋升
Leader 产生后,还要从 replica 集合中挑选新 master。算法不是“随机选一个活着的从库”,而是先过滤,再稳定排序。
6.1 第一阶段:淘汰不可靠 Replica
以下节点不会成为候选者:
-
已处于 SDOWN;
-
连接断开、无法获得有效
INFO; -
replica-priority=0; -
与旧 master 断开时间过长。
官方给出的关键过滤条件是,replica 与 master 的断连时间若超过:
(down-after-milliseconds × 10) + master 已处于 SDOWN 的时间
则认为数据过旧,不适合晋升。这也是为什么只看 Pod Ready 没有意义:进程可用不代表复制数据足够新。
6.2 第二阶段:按三个键排序
通过过滤的 replica 按以下顺序选择:
-
replica-priority越小越优先;
-
- 优先级相同时,replication offset 越大越优先;
-
- offset 也相同时,run ID 字典序越小越优先,仅用于确定性决胜。
| Replica | priority | offset | run ID | 结果 |
|---|---|---|---|---|
| A | 50 | 9,991,000 | b91... | 胜出:优先级最低 |
| B | 100 | 9,999,900 | a12... | offset 更新,但优先级劣后 |
| C | 0 | 10,000,000 | c33... | 永不晋升 |
这个例子说明:priority 的权重高于数据新鲜度。不要为了“主 AZ 优先”设置悬殊 priority,却忽略它可能让 offset 更旧的 replica 晋升。
6.3 跨机房 priority 的取舍
同城双 AZ 场景常把本 AZ replica 设为 50,远端设为 100,以降低正常切换后的访问 RTT。但这是一种可用性/延迟偏好,不是数据一致性保证。
若业务更关心少丢数据,应该:
-
尽量让候选 replica 使用相同 priority,让 offset 决胜;
-
监控
master_repl_offset - slave_repl_offset; -
使用
min-replicas-to-write限制孤立 master 写入; -
对极少数关键写按需使用
WAIT/WAITAOF,同时承认它们仍不把 Redis 变成强一致数据库。
7. 故障转移状态机:切主不只是 REPLICAOF NO ONE
Leader 的完整动作可以概括为六个阶段:
Sentinel-aware Client其他 Replica候选 Replica其他 SentinelsLeader Sentinel旧 MasterSentinel-aware Client其他 Replica候选 Replica其他 SentinelsLeader Sentinel旧 Master旧 Master 恢复后会被纠正为新 Master 的 ReplicaPING 超时,标记 SDOWNis-master-down-by-addr同意下线与 epoch 投票达到 quorum,ODOWN;获得多数票REPLICAOF NO ONEINFO 显示 role=masterREPLICAOF new-master传播更高 configuration epoch查询时返回新 Master 地址新建连接并恢复命令
对应的内部语义是:
-
- WAIT_START:等待 Leader 授权;
-
- SELECT_SLAVE:筛选并选择 replica;
-
- SEND_SLAVEOF_NOONE:发送
REPLICAOF NO ONE;
- SEND_SLAVEOF_NOONE:发送
-
- WAIT_PROMOTION:通过 INFO 确认其角色已变为 master;
-
- RECONF_SLAVES:按
parallel-syncs并发度重配其余 replica;
- RECONF_SLAVES:按
-
- UPDATE_CONFIG:发布新配置并结束 failover。
Sentinel 在确认新节点已晋升后即可把 failover 视为成功;其他 replica 的重新同步可能仍在继续。因此“主写已恢复”和“整个副本拓扑完全健康”是两个不同的观测点。
7.1 failover-timeout 的真实作用
failover-timeout 不是单一的“整个切换必须在 N 毫秒内完成”。它参与多处超时和重试节奏,包括限制同一 master 再次尝试 failover、等待晋升以及 replica 重配置。把它机械地从默认值压到 10 秒,可能在慢网络或大实例上制造反复切换。
正确做法是先测量:
-
正常网络 P99/P99.9 RTT;
-
Redis 最长可接受事件循环延迟;
-
replica 晋升观察时间;
-
全量/增量同步耗时;
-
客户端重新发现与连接建立时间。
然后再定义阈值和告警,而不是照抄“3 秒检测、15 秒切换”。
8. 数据一致性:切换成功不等于零丢失
8.1 异步复制的窗口
Redis master 接受写入后通常立即响应客户端,再异步把命令传播给 replica。若 master 在命令尚未到达 replica 时故障,新主可能缺少这部分数据。Redis replication 文档 明确指出异步复制始终存在数据丢失窗口。
因此,商品案例把 PostgreSQL 作为真相源,Redis 只保存可重建数据。订单、支付、最终库存扣减不能只存在 Redis。
8.2 用 min-replicas-* 限制脑裂写入
# 至少有 1 个延迟不超过 5 秒的 replica,master 才接受写入 min-replicas-to-write 1 min-replicas-max-lag 5
当旧 master 落入少数网络分区,无法与 replica 正常复制时,它会停止接受写入,从而限制脑裂期间的错误写窗口。但这只是 best effort:延迟判断有采样粒度,不能提供线性一致性,也会在唯一 replica 维护时主动牺牲写可用性。
8.3 WAIT 和 WAITAOF 应按风险使用
WAIT 1 100 可让当前连接等待此前写命令被至少一个 replica 确认;较新 Redis 还提供 WAITAOF 等待 AOF fsync。它们能降低数据丢失概率,但仍不使 Redis 成为强一致存储。
不要给所有缓存 SET 增加同步等待。更合理的策略是:
-
普通可重建缓存:异步复制,优先吞吐;
-
高价值但仍可补偿的短状态:按命令使用 WAIT,并记录失败补偿;
-
订单、资金、不可重建事实:先写事务数据库/持久事件,再异步更新或删除缓存。
8.4 超时后的“未知结果”
客户端写超时不代表 Redis 没执行。若服务端已执行 SET,但响应在网络中丢失,盲目重试非幂等命令会重复扣减。
生产规则是:
-
GET、MGET 等只读命令可做有界重试;
-
SET 覆盖写只有在业务语义幂等时才能重试;
-
INCR、列表 push、Lua 扣减等不得无条件自动重试; -
关键写必须携带业务幂等键,并在同一 Lua 脚本或真相数据库中原子判重。
9. 生产架构:把故障限制在缓存域内
9.1 推荐拓扑
设计要点:
-
应用通过多个 Sentinel 地址和固定 master name 发现写主,不直连 Redis Pod IP;
-
Redis 和 Sentinel 分离部署,并使用 topology spread / anti-affinity 分散故障域;
-
L1 只保存 1~5 秒可容忍旧值,既削热 Key,也为切换提供短暂缓冲;
-
数据库回源使用并发舱壁,宁可部分降级,也不能把数据库打死;
-
商品缓存默认从 master 读取,避免 failover 后 replica 读产生额外陈旧窗口;
-
Sentinel 是 HA,不是扩容。单主写瓶颈出现时转 Redis Cluster,而不是增加 Sentinel。
9.2 为什么不推荐“Controller 修改 Redis Service Endpoints”作为默认方案
有些方案监听 +switch-master,再修改 Kubernetes Endpoints,让应用始终连接一个固定 Service。这会创造第二个控制面:Sentinel 认为 A 是 master,而自定义 Controller 或 EndpointSlice controller 可能暂时仍把流量发给 B。
它还需要处理事件丢失、Controller 重启、乐观锁冲突、EndpointSlice 所有权、readiness 与角色切换的竞态。除非遗留客户端完全不支持 Sentinel,并且团队愿意为这个控制器承担严格的对账与测试,否则优先使用成熟 Sentinel-aware 客户端、经过验证的 Operator 或托管 Redis。
9.3 Sentinel、Cluster、Proxy 和托管服务怎么选
| 方案 | 适用条件 | 优势 | 主要代价 |
|---|---|---|---|
| Sentinel | 单主容量足够,需自动切换 | 简单成熟;保留非分片语义 | 写入不能水平扩展;客户端必须感知 |
| Redis Cluster | 数据或写吞吐超过单主 | 原生分片与分片级 HA | 多 Key/事务受 hash slot 约束;迁移复杂 |
| Proxy + Sentinel | 大量遗留客户端、需连接收敛 | 对应用屏蔽拓扑 | 多一跳、代理 HA、命令兼容性成本 |
| Operator | 自建 K8s 且有平台团队 | 声明式编排、自动修复 | 质量取决于 Operator;升级需验证 |
| 云托管 Redis | 团队希望购买 SLA 和运维能力 | 备份、监控、补丁更完整 | 成本、厂商约束、网络与功能差异 |
10. Redis 与 Sentinel 的生产配置
下面是配置基线,不是可脱离环境照抄的“万能参数”。密码和证书必须来自 Secret 或外部密钥系统,不能写入 ConfigMap 和 Git。
10.1 Redis 数据节点
# redis.conf port 6379 protected-mode yes # 持久化按恢复目标选择;缓存也建议保留可接受的重启恢复能力 appendonly yes appendfsync everysec aof-use-rdb-preamble yes # 限制孤立主继续接受写入的窗口 min-replicas-to-write 1 min-replicas-max-lag 5 # 依据“峰值复制字节速率 × 可容忍断链时间 × 安全系数”估算 # 例如不是按实例内存固定百分比拍脑袋配置 repl-backlog-size 256mb repl-backlog-ttl 3600 # 每个节点都要配置,因为今天的 master 明天可能成为 replica replica-priority 100 replica-read-only yes # 防止慢 replica 的输出缓冲无限增长;阈值需结合带宽与全量同步测试 client-output-buffer-limit replica 512mb 128mb 60 # 避免危险命令造成全实例阻塞;具体值由平台 ACL 与运维流程决定 lazyfree-lazy-eviction yes lazyfree-lazy-expire yes
repl-backlog-size 的工程估算方式:
backlog >= 峰值复制字节率 × 预期最大断链秒数 × 1.5~2 安全系数
例如峰值复制流量 20 MiB/s,希望 10 秒闪断后仍能部分同步,至少需要约 300~400 MiB。最终要通过 INFO replication、网络故障演练和内存预算校准。
10.2 Sentinel
# sentinel.conf 必须可写,Sentinel 会持久化发现结果和新拓扑 port 26379 protected-mode yes sentinel monitor orders-cache redis-0.redis-headless.cache.svc.cluster.local 6379 2 sentinel down-after-milliseconds orders-cache 5000 sentinel failover-timeout orders-cache 60000 sentinel parallel-syncs orders-cache 1 # Redis 数据节点启用 ACL 时,给 Sentinel 单独的最小权限账号 sentinel auth-user orders-cache sentinel-replication sentinel auth-pass orders-cache ${SENTINEL_REDIS_PASSWORD} # Redis 6.2.4+ 可解析配置中的 hostname;上线前核对实际 Redis 版本 sentinel resolve-hostnames yes # 若客户端和节点证书依赖 DNS SAN,可让 Sentinel 对外通告 hostname sentinel announce-hostnames yes
关键解释:
-
down-after-milliseconds=5000是案例起点,必须大于正常 P99.9 延迟、最长 GC/调度抖动和可接受事件循环阻塞; -
parallel-syncs=1让 replica 逐个指向新主,降低同时载入数据造成的读容量骤降; -
Sentinel 会自动重写配置,因此只读 ConfigMap 不能直接作为运行时
sentinel.conf;可由 initContainer 复制模板到可写卷,再从该文件启动; -
${...}是否会被容器自动替换取决于启动脚本。Redis 配置本身不会通用地完成环境变量插值,实际部署应通过 Secret 挂载生成最终配置或使用启动参数,避免误以为占位符已生效; -
若 Sentinel 自身启用 ACL/TLS,客户端也必须配置 Sentinel 凭据/信任链;数据节点凭据与 Sentinel 控制端凭据是两套身份。
10.3 参数取舍表
| 参数 | 过小的风险 | 过大的风险 | 调优依据 |
|---|---|---|---|
down-after-milliseconds | 网络抖动误切主 | 故障发现慢 | RTT、事件循环延迟、SLO |
failover-timeout | 反复失败、拓扑振荡 | 失败重试慢 | 晋升与同步演练 |
parallel-syncs | 值大时复制/加载并发冲击 | 值小时副本恢复慢 | 网络、磁盘、可用读副本数 |
repl-backlog-size | 闪断后频繁全量同步 | 占用 master 内存 | 写字节率 × 断链预算 |
min-replicas-to-write | 值大时维护期拒写 | 值小时数据保护弱 | 可用性与 RPO 取舍 |
11. Kubernetes 落地:稳定身份不等于固定角色
11.1 StatefulSet 的正确理解
StatefulSet 提供稳定 Pod 名称和持久卷身份,但 redis-0 不会永远是 master。Sentinel 切换后,redis-1 可能成为 master,旧主恢复后成为 replica。任何把 Pod 序号等同角色的脚本都存在隐患。
Headless Service 提供每个 Pod 的稳定 DNS:
apiVersion: v1 kind: Service metadata: name: redis-headless namespace: cache spec: clusterIP: None publishNotReadyAddresses: true selector: app: redis ports: - name: redis port: 6379
publishNotReadyAddresses 是否开启要结合启动发现流程评估:它能帮助节点在未 Ready 时互相发现,但也意味着 DNS 可解析不等于服务已就绪。应用不能把这个 headless service 当成 master Service 使用。
11.2 Sentinel 的调度和可用性约束
apiVersion: policy/v1 kind: PodDisruptionBudget metadata: name: redis-sentinel namespace: cache spec: minAvailable: 2 selector: matchLabels: app: redis-sentinel --- apiVersion: apps/v1 kind: Deployment metadata: name: redis-sentinel namespace: cache spec: replicas: 3 selector: matchLabels: app: redis-sentinel template: metadata: labels: app: redis-sentinel spec: topologySpreadConstraints: - maxSkew: 1 topologyKey: kubernetes.io/hostname whenUnsatisfiable: DoNotSchedule labelSelector: matchLabels: app: redis-sentinel containers: - name: sentinel image: redis:<组织验证并锁定的版本> args: ["redis-server", "/run/redis/sentinel.conf", "--sentinel"] ports: - name: sentinel containerPort: 26379
这里故意没有伪造完整镜像版本和 Secret 名称。生产清单还必须补齐:固定镜像 digest、资源 request/limit、startup/readiness probe、只读根文件系统、非 root 用户、NetworkPolicy、TLS、可写配置卷和 initContainer。它们依赖组织镜像布局与证书体系,不能从文章中替你决定。
11.3 云原生部署的五个硬检查
-
- 可达地址:Sentinel 发现的 replica 地址能否从所有 Sentinel 和应用网络访问;
-
- 配置可写:运行时
sentinel.conf是否可原子重写且重启后保留;
- 配置可写:运行时
-
- 故障域分散:Redis replica 与 Sentinel 是否跨 node/AZ;
-
- PDB 不滥用:PDB 只约束自愿驱逐,不防节点宕机;不能把维护永久卡死;
-
- 角色探针正确:readiness 只判断“可服务”,还是要求当前 role=master,取决于该 Service 的用途。
如果没有平台团队持续验证自建拓扑,优先选择成熟 Operator 或托管服务,而不是维护一套依赖脆弱 shell 脚本的主从编排。
12. Spring Boot 生产级接入
以下示例基线为 Java 21、Spring Boot 3.x、Lettuce。依赖版本应由组织 BOM 锁定,并用集成测试验证;官方属性可参考 Spring Boot Redis 文档。代码的核心目标是:
-
由 Sentinel 发现当前 master;
-
Redis 故障时用短时 L1 缓存降级;
-
限制数据库回源并发;
-
只对可安全重试的读取做恢复;
-
暴露命中、降级和拒绝指标。
12.1 目录结构
src/main/java/com/acme/catalog/ ├── CatalogApplication.java ├── api/ProductController.java ├── application/ProductQueryService.java ├── domain/ProductView.java ├── infrastructure/ProductRepository.java └── infrastructure/RedisClientConfig.java src/main/resources/ └── application.yml
12.2 Maven 依赖
<dependencies> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-web</artifactId> </dependency> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-data-redis</artifactId> </dependency> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-actuator</artifactId> </dependency> <dependency> <groupId>com.github.ben-manes.caffeine</groupId> <artifactId>caffeine</artifactId> </dependency> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-validation</artifactId> </dependency> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-test</artifactId> <scope>test</scope> </dependency> </dependencies>
不要同时引入 Jedis 和 Lettuce,也不要为了“连接池看起来专业”默认给 Lettuce 套池。Lettuce 的普通非阻塞连接线程安全且可复用;只有阻塞命令、事务等独占连接场景才应单独评估池化。
12.3 配置文件
spring: application: name: catalog-service data: redis: database: 0 username: ${REDIS_DATA_USERNAME:catalog-app} password: ${REDIS_DATA_PASSWORD} connect-timeout: 500ms timeout: 800ms sentinel: master: orders-cache nodes: - sentinel-0.redis-sentinel.cache.svc.cluster.local:26379 - sentinel-1.redis-sentinel.cache.svc.cluster.local:26379 - sentinel-2.redis-sentinel.cache.svc.cluster.local:26379 username: ${REDIS_SENTINEL_USERNAME:sentinel-client} password: ${REDIS_SENTINEL_PASSWORD} lettuce: shutdown-timeout: 200ms management: endpoints: web: exposure: include: health,prometheus health: redis: enabled: true catalog: cache: redis-ttl: 10m local-ttl: 3s local-maximum-size: 10000 db-bulkhead-permits: 32
注意区分数据节点认证和 Sentinel 自身认证。不同 Spring Boot 小版本的属性模型可能变化,升级时要以所用版本的配置元数据和启动日志为准,不能只看 IDE 没报红。
12.4 连接配置:一致性优先时只读 master
package com.acme.catalog.infrastructure; import io.lettuce.core.ReadFrom; import org.springframework.boot.autoconfigure.data.redis.LettuceClientConfigurationBuilderCustomizer; import org.springframework.context.annotation.Bean; import org.springframework.context.annotation.Configuration; @Configuration public class RedisClientConfig { @Bean LettuceClientConfigurationBuilderCustomizer masterReadOnly() { return builder -> builder.readFrom(ReadFrom.MASTER); } }
原方案常见的 REPLICA_PREFERRED 会把读流量发送到异步 replica,切换或网络抖动时可能读到旧值。只有业务明确接受最终一致,并且已测试读路由与故障行为时,才考虑 replica 读。商品详情案例优先 master 读,通过 L1 缓存扩展读容量。
12.5 领域对象和仓储边界
package com.acme.catalog.domain; import java.math.BigDecimal; public record ProductView( long productId, String title, BigDecimal displayPrice, boolean saleable, long version) { }
package com.acme.catalog.infrastructure; import com.acme.catalog.domain.ProductView; import java.util.Optional; public interface ProductRepository { Optional<ProductView> findPublishedById(long productId); }
实际项目可用 Spring Data JDBC/JPA 实现该接口。Redis 只保存 ProductView,不让领域层依赖 Redis API;这样降级和迁移到 Cluster/托管服务时,业务模型不受影响。
12.6 查询服务:L1 合并请求、Redis L2、受控回源
package com.acme.catalog.application; import com.acme.catalog.domain.ProductView; import com.acme.catalog.infrastructure.ProductRepository; import com.fasterxml.jackson.core.JsonProcessingException; import com.fasterxml.jackson.databind.ObjectMapper; import com.github.benmanes.caffeine.cache.Cache; import com.github.benmanes.caffeine.cache.Caffeine; import io.micrometer.core.instrument.Counter; import io.micrometer.core.instrument.MeterRegistry; import java.time.Duration; import java.util.NoSuchElementException; import java.util.concurrent.Semaphore; import java.util.concurrent.ThreadLocalRandom; import org.slf4j.Logger; import org.slf4j.LoggerFactory; import org.springframework.beans.factory.annotation.Value; import org.springframework.dao.DataAccessException; import org.springframework.data.redis.core.StringRedisTemplate; import org.springframework.stereotype.Service; @Service public class ProductQueryService { private static final Logger log = LoggerFactory.getLogger(ProductQueryService.class); private static final String KEY_PREFIX = "catalog:product:"; private final StringRedisTemplate redis; private final ProductRepository repository; private final ObjectMapper objectMapper; private final Cache<Long, ProductView> localCache; private final Semaphore dbBulkhead; private final Duration redisTtl; private final Counter redisFailure; private final Counter dbRejected; public ProductQueryService( StringRedisTemplate redis, ProductRepository repository, ObjectMapper objectMapper, MeterRegistry meterRegistry, @Value("${catalog.cache.redis-ttl:10m}") Duration redisTtl, @Value("${catalog.cache.local-ttl:3s}") Duration localTtl, @Value("${catalog.cache.local-maximum-size:10000}") long localMaximumSize, @Value("${catalog.cache.db-bulkhead-permits:32}") int dbPermits) { if (dbPermits < 1 || localMaximumSize < 1) { throw new IllegalArgumentException("cache capacity and db permits must be positive"); } this.redis = redis; this.repository = repository; this.objectMapper = objectMapper; this.redisTtl = redisTtl; this.localCache = Caffeine.newBuilder() .maximumSize(localMaximumSize) .expireAfterWrite(localTtl) .recordStats() .build(); this.dbBulkhead = new Semaphore(dbPermits); this.redisFailure = meterRegistry.counter("catalog.cache.redis.failure"); this.dbRejected = meterRegistry.counter("catalog.cache.db.rejected"); } public ProductView get(long productId) { if (productId <= 0) { throw new IllegalArgumentException("productId must be positive"); } // Caffeine Cache#get 会在单 Pod 内合并同一个 Key 的并发加载。 return localCache.get(productId, this::loadFromRedisOrDatabase); } public void evict(long productId) { localCache.invalidate(productId); try { // UNLINK 将实际内存回收异步化,适合 value 可能较大的缓存对象。 redis.unlink(KEY_PREFIX + productId); } catch (DataAccessException ex) { redisFailure.increment(); log.warn("redis eviction failed, productId={}", productId, ex); // Redis TTL 是删除失败的最终兜底;强一致场景应使用事务 Outbox 重试删除。 } } private ProductView loadFromRedisOrDatabase(long productId) { String key = KEY_PREFIX + productId; try { String json = redis.opsForValue().get(key); if (json != null) { return objectMapper.readValue(json, ProductView.class); } } catch (DataAccessException | JsonProcessingException ex) { redisFailure.increment(); log.warn("redis read degraded, productId={}", productId, ex); } if (!dbBulkhead.tryAcquire()) { dbRejected.increment(); throw new CacheOriginOverloadedException("database fallback is saturated"); } try { ProductView product = repository.findPublishedById(productId) .orElseThrow(() -> new NoSuchElementException("product not found: " + productId)); writeRedisBestEffort(key, product); return product; } finally { dbBulkhead.release(); } } private void writeRedisBestEffort(String key, ProductView product) { try { long jitterSeconds = ThreadLocalRandom.current().nextLong(0, 61); redis.opsForValue().set( key, objectMapper.writeValueAsString(product), redisTtl.plusSeconds(jitterSeconds)); } catch (DataAccessException | JsonProcessingException ex) { redisFailure.increment(); log.warn("redis refill failed, productId={}", product.productId(), ex); } } public static final class CacheOriginOverloadedException extends RuntimeException { public CacheOriginOverloadedException(String message) { super(message); } } }
这段代码落实了四个高并发策略:
-
每个 Pod 内,同一 Key 的冷启动由 Caffeine 合并为一次加载;
-
Redis 切换的短窗口由 3 秒 L1 缓冲;
-
miss 回源最多 32 个并发,保护数据库连接池;
-
TTL 加随机抖动,降低同一批 Key 集中过期。
它没有使用 Redis 分布式锁阻止全局回源,因为 failover 时锁本身也不可用或可能丢失。对于 60 个 Pod,最坏同一冷 Key 仍可能有约 60 次回源;若数据库不能承受,应增加请求合并层、热点预热或专用查询缓存,而不是把可靠性建立在同一个故障中的 Redis 锁上。
12.7 API 与异常映射
package com.acme.catalog.api; import com.acme.catalog.application.ProductQueryService; import com.acme.catalog.application.ProductQueryService.CacheOriginOverloadedException; import com.acme.catalog.domain.ProductView; import jakarta.validation.constraints.Positive; import java.util.NoSuchElementException; import org.springframework.http.HttpStatus; import org.springframework.http.ResponseEntity; import org.springframework.validation.annotation.Validated; import org.springframework.web.bind.annotation.ExceptionHandler; import org.springframework.web.bind.annotation.GetMapping; import org.springframework.web.bind.annotation.PathVariable; import org.springframework.web.bind.annotation.RequestMapping; import org.springframework.web.bind.annotation.RestController; @Validated @RestController @RequestMapping("/api/products") public class ProductController { private final ProductQueryService queryService; public ProductController(ProductQueryService queryService) { this.queryService = queryService; } @GetMapping("/{productId}") public ProductView get(@PathVariable @Positive long productId) { return queryService.get(productId); } @ExceptionHandler(NoSuchElementException.class) ResponseEntity<ErrorResponse> notFound(NoSuchElementException ex) { return ResponseEntity.status(HttpStatus.NOT_FOUND) .body(new ErrorResponse("PRODUCT_NOT_FOUND", ex.getMessage())); } @ExceptionHandler(CacheOriginOverloadedException.class) ResponseEntity<ErrorResponse> overloaded(CacheOriginOverloadedException ex) { return ResponseEntity.status(HttpStatus.SERVICE_UNAVAILABLE) .header("Retry-After", "1") .body(new ErrorResponse("CACHE_ORIGIN_OVERLOADED", ex.getMessage())); } record ErrorResponse(String code, String message) {} }
503 + Retry-After 比让请求在线程池里无限排队更可控。网关只能对 GET 做小次数、带抖动的重试,且总重试时长必须小于调用方预算;服务端不要再叠加多层重试,避免乘法放大。
12.8 写后失效与一致性
商品更新应先提交数据库事务,再删除缓存:
更新数据库成功 → 事务提交 → 删除 L1/L2 → 下次读取回填
如果删除失败,短 TTL 提供最终兜底;若业务不能接受 10 分钟旧值,应使用事务 Outbox:数据库事务内同时写商品变更和 outbox,后台消费者幂等执行缓存删除,成功后标记事件完成。不要使用“数据库 + Redis 双写事务”的假原子方案。
更新并发时可把 ProductView.version 带入 value,并在回填 Lua 中拒绝旧版本覆盖新版本;这比依赖请求到达顺序更可靠。
13. 高并发治理:切换时最危险的是放大效应
13.1 连接风暴
60 个应用 Pod 如果每个维护 100 个连接,切换时最多可能同时创建数千条 TCP/TLS 连接。处理策略:
-
使用客户端默认共享连接,不盲目增大池;
-
连接建立和命令分别设置超时;
-
重连采用指数退避与随机抖动;
-
设置连接总量、文件描述符和 Redis
maxclients预算; -
发布时滚动启动,避免应用和 Redis 同时全量重启;
-
TLS 场景单独压测握手 CPU。
13.2 缓存击穿与雪崩
| 风险 | 典型症状 | 处理方式 |
|---|---|---|
| 热 Key | 单 Key 占据大量带宽/CPU | L1 缓存、拆 value、热点预热、业务分片 |
| 缓存击穿 | 一个热 Key 失效后并发回源 | 单机请求合并、全局回源限额 |
| 缓存雪崩 | 大批 Key 同时过期或 Redis 切换 | TTL 抖动、L1、降级、限流 |
| 缓存穿透 | 不存在 ID 持续查询 | 参数校验、短时 negative cache、布隆过滤器 |
| 大 Key | 删除/序列化/复制阻塞 | 拆 Key、UNLINK、持续扫描 bigkeys/memory usage |
13.3 资源隔离
-
Redis I/O 不与数据库回源共用自定义线程池;
-
数据库连接池大小应与回源 Semaphore 对齐,而不是让 500 个请求争 30 个连接;
-
管理/探针流量与业务流量设置独立超时;
-
Sentinel 端口只向应用和 Redis 管理网络开放;
-
大促前冻结高风险全量扫描、AOF rewrite 和宿主机迁移,或至少把它们纳入容量预算。
13.4 Sentinel 的扩展性边界
增加 replica 只能扩读、增强 HA;增加 Sentinel 只增强控制面容错;两者都不能扩 master 写吞吐。出现以下信号时应评估 Redis Cluster:
-
单实例内存接近安全上限,fork/COW 成本不可接受;
-
master CPU 或网络带宽持续接近预算;
-
写吞吐需要水平扩展;
-
单个复制/恢复单元过大,RTO 无法满足。
迁移到 Cluster 前必须盘点 Lua、事务、multi-key 命令和 key tag,不能只替换连接地址。
14. 可观测性:要同时看控制面、数据面和客户端
14.1 Sentinel 指标与事件
至少监控:
-
SENTINEL CKQUORUM orders-cache是否通过; -
已知 Sentinel 数、可用 replica 数;
-
s_down、o_down标志; -
+sdown、+odown、+try-failover、+elected-leader、+selected-slave、+promoted-slave、+switch-master、-odown事件; -
failover 持续时间和单位时间 failover 次数。
__sentinel__:hello 是 Sentinel 自动发现频道,不是应用监听主切换的频道。运维事件可以 PSUBSCRIBE * 或订阅 +switch-master,但 Pub/Sub 不持久化;监控系统必须同时轮询当前状态,不能把事件订阅当唯一事实源。
14.2 Redis 数据面
-
connected_slaves、master_repl_offset、每个 replica offset/lag; -
master_sync_in_progress、sync_partial_ok/err、sync_full; -
instantaneous_ops_per_sec、网络输入输出、连接数; -
used_memory、mem_fragmentation_ratio、evicted keys; -
latest_fork_usec、AOF rewrite/RDB 状态; -
command latency、slowlog、event-loop latency。
不要仅用 CPU 作为容量指标。Redis 常先受单核、网络带宽、大 Key、fork 或客户端输出缓冲影响。
14.3 客户端与业务指标
-
Redis 命令成功率、超时率和 P50/P95/P99;
-
当前连接的 master 地址变化;
-
重连次数和连接建立耗时;
-
L1/L2 命中率、数据库回源量、回源拒绝数;
-
503 降级率、接口整体延迟和错误预算消耗。
建议告警关联而不是孤立触发:例如 +odown 同时伴随 Redis timeout、DB 回源上升,才是影响业务的高优先级事件。
14.4 日志安全
日志可记录 master name、节点地址、epoch、切换耗时和业务 trace ID,但不得打印 Redis 密码、ACL token、完整缓存 value 或用户敏感数据。Sentinel 与 Redis 审计账号分离,轮换 Secret 时要演练 Sentinel、replica 和客户端三条认证链。
15. 故障演练:验证的是完整链路,不是“Pod 能重启”
15.1 上线前检查
# 1. 从每个 Sentinel 检查 quorum 和多数派 redis-cli -h sentinel-0 -p 26379 SENTINEL CKQUORUM orders-cache # 2. 确认当前主地址 redis-cli -h sentinel-0 -p 26379 SENTINEL GET-MASTER-ADDR-BY-NAME orders-cache # 3. 确认候选 replica、priority、flags、offset redis-cli -h sentinel-0 -p 26379 SENTINEL REPLICAS orders-cache # 4. 从数据节点确认复制健康 redis-cli -h current-master -p 6379 INFO replication # 5. 确认 Sentinel 配置文件可写且重启后保留新 master redis-cli -h sentinel-0 -p 26379 SENTINEL FLUSHCONFIG
认证和 TLS 参数应从安全注入,不应出现在 shell history。
15.2 五类演练矩阵
| 演练 | 注入方式 | 必须验证 |
|---|---|---|
| master 进程退出 | 优雅停止 Redis | 检测、选举、晋升、客户端恢复 |
| master 节点宕机 | 排空/关停工作节点 | Redis 与 Sentinel 是否同故障域 |
| 网络分区 | NetworkPolicy/故障注入工具 | 少数派不切主,旧主是否限写 |
| replica 落后 | 限带宽或暂停 replica | 选主是否避开旧副本 |
| Sentinel 丢失 | 停 1 个、再停第 2 个 | CKQUORUM、告警和不可切换边界 |
不要在生产直接用 SENTINEL FAILOVER 冒充所有故障测试:手工 failover 跳过了真实的故障判定和部分授权路径。它适合验证计划切换,不足以验证网络分区。
15.3 验收指标
一次演练至少记录:
T0 故障注入 T1 首个 Sentinel 标记 SDOWN T2 ODOWN T3 Leader elected T4 replica promoted T5 client first successful command to new master T6 all replicas healthy
以 T5 - T0 衡量业务恢复,以 T6 - T0 衡量拓扑恢复;同时统计错误请求数、DB 峰值回源、是否出现未知结果写入和是否消耗错误预算。
15.4 自动化集成测试思路
在测试环境启动 1 master + 2 replicas + 3 Sentinels:
- 写入带版本号的商品缓存;
- 查询 Sentinel 记录旧 master 地址;
- 停止旧 master 或隔离网络;
- 轮询多个 Sentinel,直到它们报告同一个新 master;
- 用应用客户端执行 GET/幂等 SET;
- 恢复旧 master,断言其变为 replica;
- 检查整个过程中数据库回源并发没有超过配置值。
测试必须有总超时,失败时保存 Sentinel 日志、INFO replication 和应用连接日志,避免只得到一个模糊的“等待超时”。
16. 常见错误方案与修正
错误一:两个 Sentinel 也算高可用
两个 Sentinel 任一故障后都无法形成多数派。修正为至少 3 个,并分散到独立故障域。
错误二:quorum=2 就表示两票可以切主
两票只可能完成 ODOWN;真正执行还需要多数派授权。使用 CKQUORUM 同时验证两个条件。
错误三:应用订阅 __sentinel__:hello 就能感知切换
该频道服务于 Sentinel 互相发现。应用应使用支持 Sentinel 的驱动,通过 master name 查询并重连;运维若监听事件,使用 +switch-master 等频道并配合状态轮询。
错误四:StatefulSet 的 redis-0 永远是 master
Pod 身份稳定,Redis 角色会变化。应用和探针都不能用序号推断角色。
错误五:切换时重试所有命令
非幂等写可能重复执行。只对安全读取做有界重试,写入使用业务幂等与补偿。
错误六:Replica 读取天然提升可用性
Replica 读会引入异步复制陈旧窗口,failover 期间更明显。先确认业务一致性需求,再选择 REPLICA_PREFERRED。
错误七:Sentinel 能解决 Redis 容量问题
Sentinel 不分片。单主资源不足时,优化数据模型、拆实例或迁移 Cluster。
错误八:把 sentinel.conf 挂在只读 ConfigMap
Sentinel 必须重写配置保存拓扑和 epoch。应将模板复制到可写持久卷,或交给经过验证的 Operator 管理。
错误九:通知脚本直接修改 Nacos/Endpoints
脚本有超时、重试和并发限制,Pub/Sub 事件也不持久。把它变成关键流量控制面会扩大故障面;优先使用客户端原生发现。
错误十:min-replicas-to-write 可以彻底消除脑裂
它只限制风险窗口,并以写可用性为代价,不提供强一致。真相数据仍需可靠持久存储和补偿流程。
17. 从告警到恢复的操作手册
17.1 自动切换正常时
- 确认
+odown、Leader、晋升和+switch-master事件顺序; - 从至少两个 Sentinel 查询新 master,避免读取单个过期视图;
- 验证新 master 的 role、复制 offset、连接数和延迟;
- 验证客户端已迁移,旧 master 不再有业务写连接;
- 等旧 master 恢复为 replica 后再解除事件状态;
- 对比数据库真相源,评估切换窗口是否有缓存写丢失。
17.2 ODOWN 但未切换时
按顺序检查:
-
CKQUORUM是否缺多数派; -
SENTINEL SENTINELS是否包含陈旧或不可达节点; -
SENTINEL REPLICAS是否存在健康、priority 非 0 的候选; -
Sentinel 到 replica 的认证、TLS、DNS、端口是否通;
-
failover 是否处于等待/重试窗口;
-
日志是否出现
-failover-abort-no-good-slave等终止事件。
在原因未知时不要连续执行手工 failover;先保留现场,再决定恢复多数派、修复候选 replica 或执行受控切换。
17.3 客户端没有恢复时
- 确认应用使用 master name,而非旧 IP;
- 从应用 Pod 访问所有 Sentinel,并查询新 master;
- 检查数据节点 ACL/TLS 是否允许新连接;
- 检查连接池是否耗尽、DNS 是否缓存、重连是否被熔断;
- 检查新 master
maxclients、CPU 和握手负载; - 必要时滚动恢复客户端,但不要同时重启全部 Pod。
18. 最终设计清单
上线 Sentinel 前,逐项回答“是”:
-
至少 3 个 Sentinel,并跨独立 node/AZ;
-
quorum 和多数派均经
CKQUORUM验证; -
至少两个健康 replica,复制延迟有监控;
-
所有候选节点都正确设置
replica-priority; -
Sentinel 配置可写、可持久化、可在重启后恢复;
-
应用使用 Sentinel-aware 客户端和统一 master name;
-
数据节点与 Sentinel 的 ACL/TLS 身份分离;
-
读写命令有明确超时,重试只用于安全操作;
-
L1 缓存、回源限额、TTL 抖动已经落实;
-
Redis 不是订单/支付等不可重建数据的唯一真相源;
-
min-replicas-*的可用性代价已被业务接受; -
K8s 反亲和、PDB、资源和 NetworkPolicy 已验证;
-
master 宕机、网络分区、replica 落后和 Sentinel 丢失均完成演练;
-
指标覆盖 Sentinel、Redis、客户端和数据库回源四层;
-
有明确的 Cluster/托管服务容量演进阈值。
19. 总结
理解 Redis Sentinel,要抓住五条主线:
-
故障判定有两层:SDOWN 是单节点意见,ODOWN 需要达到 quorum;
-
ODOWN 不等于可以切主:执行 failover 还需要 Sentinel 多数派授权;
-
选主先过滤再排序:健康度 → priority → replication offset → run ID;
-
切主是状态机:晋升新主、重配副本、传播配置、客户端重连缺一不可;
-
高可用是端到端能力:Sentinel 只解决控制面,数据一致性、缓存降级、回源保护、幂等和演练仍由架构与工程体系负责。
Sentinel 的价值不在于把故障藏起来,而在于让故障有确定的判断者、唯一的执行者和可收敛的新拓扑。真正生产级的方案,还要确保切换期间数据库不会被击穿、客户端不会形成连接风暴、非幂等写不会被重复执行,并且团队能用演练数据说明系统在故障中究竟会发生什么。
当单主容量仍满足业务、数据可重建且团队能管理这些边界时,Sentinel 是简单而成熟的选择;当写吞吐、数据规模或跨地域一致性超出单主模型时,就应果断演进到 Redis Cluster、托管服务或更适合的数据系统,而不是继续给 Sentinel 堆职责。
参考资料
-
Redis Sentinel:High availability with Redis Sentinel
-
Redis Sentinel client specification
-
Redis replication
-
Redis WAITAOF command
-
Spring Boot:Working with NoSQL Technologies
本文的引用仅限自我学习如有侵权,请联系作者删除。
参考知识
Redis主从最全详解(原理+架构+流程)
Redis 高可用进阶(二):Sentinel 哨兵与选主算法


 扫一扫


 505

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


