



文章目录
- 一、问题背景:为什么“导出 10 亿数据”从来不是一个脚本问题
- 二、真实业务场景:从一次凌晨事故开始
- 三、先说结论:企业级方案到底长什么样
- 四、为什么很多导出方案会失败:原理层面的三个误区
- 五、核心原理:为什么选择 PIT + search_after + slice
- 六、总体架构:从脚本升级为平台
- 七、核心数据模型:任务、切片、文件清单必须分开设计
- 八、任务全流程:正常链路、失败链路、恢复链路
- 九、生产级代码设计:不是几段片段,而是完整职责拆分
- 十、高并发与可扩展设计:怎么逼近“每秒 50 万条”
- 十一、可靠性设计:企业级导出最难的不是跑得快,而是失败后还能继续跑
- 十二、性能优化:真正影响吞吐的不是一个参数,而是一整条链路
- 十三、安全与治理:生产平台不能只有性能,没有边界
- 十四、可观测性:不看见,就无法运维
- 十五、Kubernetes 部署建议
- 十六、常见错误方案与边界条件
- 十七、方案演进:从离线导出平台继续往前走
- 十八、总结:真正的难点,不是从 ES 读数据,而是把“读数据”变成一种稳定能力
10 亿数据从 Elasticsearch 导出:从脚本到企业级离线数据平台的完整设计
主题聚焦:如何把一次性导出脚本,升级为可调度、可恢复、可扩展、可观测的企业级离线数据导出平台。
文章目录
- 一、问题背景:为什么“导出 10 亿数据”从来不是一个脚本问题
- 二、真实业务场景:从一次凌晨事故开始
- 三、先说结论:企业级方案到底长什么样
- 四、为什么很多导出方案会失败:原理层面的三个误区
- 五、核心原理:为什么选择 PIT + search_after + slice
- 六、总体架构:从脚本升级为平台
- 七、核心数据模型:任务、切片、文件清单必须分开设计
- 八、任务全流程:正常链路、失败链路、恢复链路
- 九、生产级代码设计:不是几段片段,而是完整职责拆分
- 十、高并发与可扩展设计:怎么逼近“每秒 50 万条”
- 十一、可靠性设计:企业级导出最难的不是跑得快,而是失败后还能继续跑
- 十二、性能优化:真正影响吞吐的不是一个参数,而是一整条链路
- 十三、安全与治理:生产平台不能只有性能,没有边界
- 十四、可观测性:不看见,就无法运维
- 十五、Kubernetes 部署建议
- 十六、常见错误方案与边界条件
- 十七、方案演进:从离线导出平台继续往前走
- 十八、总结:真正的难点,不是从 ES 读数据,而是把“读数据”变成一种稳定能力
10 亿数据从 Elasticsearch 导出:从脚本到企业级离线数据平台的完整设计
主题聚焦:如何把一次性导出脚本,升级为可调度、可恢复、可扩展、可观测的企业级离线数据导出平台。
一、问题背景:为什么“导出 10 亿数据”从来不是一个脚本问题
很多团队第一次做 Elasticsearch 大规模数据导出时,直觉往往很简单:
- 调一个查询接口把数据拉下来。
- 落一个 JSON 文件。
- 再上传到对象存储或数据湖。
小数据量时这套方式能跑通,但当数据规模从几百万上涨到几亿、十亿后,问题会迅速从“功能实现”变成“分布式系统治理”:
• 查询一旦走深分页,Elasticsearch 协调节点和数据节点的内存压力会明显升高。
• 导出进程如果把整批数据先堆到本地内存,再统一编码或写盘,很容易 OOM。
• 单机脚本没有任务编排、断点续传和失败恢复能力,任何网络抖动都可能导致整批任务从头再来。
• 导出链路如果直接打在线集群,很容易和线上搜索、推荐、订单查询等业务争抢 CPU、IO、heap、segment cache。
• 下游如果要的是 Hive、Spark、Trino 可直接消费的数据,JSON 文本往往并不是最终形态,真正需要的是分区化、压缩化、可回放的离线数据集。
所以,10 亿级 Elasticsearch 数据导出,本质上不是“写一个脚本”,而是设计一套离线数据抽取平台。
二、真实业务场景:从一次凌晨事故开始
我们以一个典型场景贯穿全文。
某电商平台需要把订单域索引 orders_v3 中过去 12 个月的数据导出到对象存储,供以下系统使用:
• 算法平台做用户画像和风控训练
• 数据仓库做离线明细回灌
• 稽核系统做历史抽样和合规留存
业务约束如下:
• 数据规模:约 10 亿文档,原始 _source 总量约数 TB
• 导出窗口:凌晨离峰执行,但不能明显冲击在线集群
• 输出格式:Parquet + Snappy,支持按日期分区
• 导出语义:允许切片级重试,但不能因为重试生成不可控重复文件
• 恢复要求:任一 Worker 宕机后可自动续跑
• 运维要求:任务进度、吞吐、失败原因、热点切片必须可观测
最初团队用的是类似下面的脚本:
elasticdump \
  --input=http://es-prod:9200/orders_v3 \
  --output=/data/orders.json \
  --type=data \
  --limit=10000
结果出现了四类经典事故:
• 导出进程本地 OOM,文件越写越大,GC 频繁抖动。
• Scroll 上下文过多,占用集群资源,导致线上查询延迟升高。
• 跑到一半网络闪断,任务没有检查点,只能从头开始。
• 文件是大 JSON,后续 Spark 读取慢、压缩率差、字段模式不稳定。
这也是很多团队的共同拐点:问题已经不是“导不导得出来”,而是“能否把导出能力平台化”。
三、先说结论:企业级方案到底长什么样
最终目标不是一个 dump.sh,而是一套分层清晰的离线导出平台:
• 控制面负责建任务、切片、调度、状态管理、限流配置和运维观测
• 数据面负责从 Elasticsearch 稳定拉数、做流式编码、分片写文件、上传对象存储
• 状态面负责保存检查点、任务状态、分片进度和幂等结果
整体思路是:
- 不再用单机脚本串行导。
- 不再依赖深度分页。
- 不再把“大文件生成”当作一个本地内存动作。
- 不再把“失败重跑”理解成“整批重来”。
本文采用的核心技术组合是:
• Elasticsearch:PIT + search_after + sliced query
• 消息队列:Kafka,承接切片任务和失败重试
• 元数据存储:MySQL,保存任务与切片状态
• 缓存与检查点:Redis,保存游标、租约和速率控制信号
• 输出介质:S3/MinIO,统一落地 Parquet 分片文件
• 运行环境:Kubernetes,支持弹性扩缩容
• 可观测体系:Prometheus + Grafana + 结构化日志 + TraceId
四、为什么很多导出方案会失败:原理层面的三个误区
4.1 误区一:把导出当成“分页查询”
普通业务查询里的 from + size 适合浅分页,不适合十亿级数据拉取。原因很直接:
• 深分页需要跳过大量文档,查询成本随着页码上升而快速变差。
• 协调节点需要维护排序结果集,CPU 和内存压力会被放大。
• 任何一次失败都很难从稳定位置恢复。
因此,十亿级导出必须放弃传统分页。
4.2 误区二:把 Scroll 当成唯一标准答案
Scroll 比 from + size 更适合批量读取,但它也不是企业级导出的终点。
Scroll 的问题主要有三类:
• 服务端要维护 scroll context,导出任务一多,会对集群内存形成持续压力。
• Scroll 生命周期和客户端连接关系紧密,网络抖动和长时间任务下更脆弱。
• Scroll ID 失效后,恢复通常比较麻烦,断点续传体验并不好。
Scroll 并不是不能用,而是更适合中小规模的一次性批处理,不适合需要长时间运行、可恢复、可水平扩展的平台型场景。
4.3 误区三:把“导出成功”理解成“读完数据”
真正的平台化导出,成功标准至少包括:
• 读到了正确时间点的数据快照
• 每个切片都可重试且可恢复
• 文件能被下游稳定消费
• 多次执行结果可追踪、可核对、可审计
• 导出过程不会拖垮线上集群
这决定了设计重点必须从“查询代码”上升到“任务系统设计”。
五、核心原理:为什么选择 PIT + search_after + slice
5.1 Point In Time 解决的是什么问题
PIT,Point In Time,本质上是让查询在一个逻辑一致的快照视图上执行。
它解决的是两个核心问题:
• 导出过程很长,如果没有一致性视图,不同批次可能看到不同版本的数据。
• 导出时如果索引还在持续写入,不同批读取到的结果边界会漂移。
PIT 并不意味着把全部数据复制一份,而是在 Elasticsearch 内部为查询提供稳定视图引用。相比长生命周期 Scroll,它通常更轻量,也更适合和 search_after 组合。
5.2 search_after 为什么适合断点续传
search_after 的本质是“基于上一批最后一条排序值继续向后读”。
例如排序条件是:
• create_time asc
• _shard_doc asc 或 _id asc
那么每一批取回后,都能得到最后一条文档的排序键。这个排序键就是天然的检查点,可以持久化到 Redis 或 MySQL 中。
它的优势在于:
• 不需要维护大偏移量
• 检查点很轻
• 容易恢复
• 和切片并行天然兼容
5.3 slice 为什么是并发扩展的关键
十亿级数据想跑得快,核心不是把单批拉得更大,而是让多个切片并行稳定前进。
切片的价值是:
• 一个导出任务可以拆成多个独立子任务
• 每个子任务有自己独立的游标和产出文件
• Worker 可以水平扩容,按切片并发消费
• 某个切片失败时,只重试该切片,不影响整体任务
从工程视角看,slice 让“一个大任务”变成了“很多可调度、可重试、可观测的小任务”。
5.4 为什么不是直接全量扫 _source
很多线上索引的 _source 很大,包含大量下游不需要的字段,例如:
• 原始请求报文
• 冗余扩展属性
• 调试信息
• 历史兼容字段
导出时如果不做字段裁剪,代价会出现在三个地方:
• Elasticsearch 反序列化与网络传输开销变大
• Worker 堆内存占用上升
• Parquet 编码与压缩效率下降
所以生产环境里,导出不是“全拿”,而是“按离线用途定义投影字段”。
六、总体架构:从脚本升级为平台
6.1 架构分层
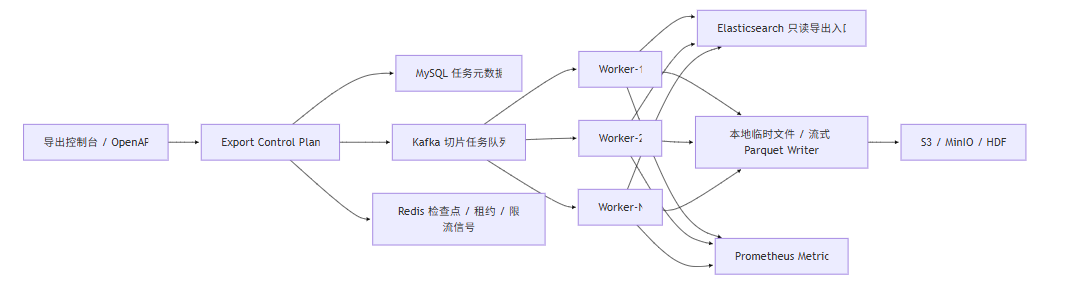
平台可以分为三层:
• 控制面:任务创建、切片规划、调度下发、状态汇总、速率配置
• 执行面:Worker 消费切片任务,按检查点持续拉数并写出文件
• 存储面:元数据、检查点、对象文件、日志与指标
6.2 组件职责
- Export Control Plane
职责包括:
• 接收导出请求
• 做参数校验和权限校验
• 固化导出快照范围与导出配置
• 计算切片数、批大小、目标分区
• 生成 slice task 投递到 Kafka
• 汇总各切片进度,形成任务级视图
2. Export Worker
职责包括:
• 抢占切片租约
• 打开 PIT
• 执行带排序的切片查询
• 流式编码成 Parquet
• 周期性上传 part 文件
• 持久化 search_after 检查点
• 完成后提交 manifest
3. MySQL
保存强一致元数据:
• 导出任务主记录
• 切片任务状态
• 输出文件清单
• 失败原因与重试次数
4. Redis
保存高频状态:
• 当前切片游标
• 切片租约锁
• 任务级计数器
• 动态限流参数快照
5. Kafka
承担两件事:
• 切片任务的并发分发
• 失败重试和削峰填谷
如果没有消息队列,也可以用调度器直接分发到执行器,但在高并发与容错上通常不如 Kafka 灵活。
七、核心数据模型:任务、切片、文件清单必须分开设计
如果只保留“任务表”,后续会很快遇到三个问题:
• 不知道哪个切片卡住了
• 不知道已经产出了哪些文件
• 不知道失败重试是否造成重复文件
因此建议至少设计三类表。
7.1 导出任务表
CREATE TABLE export_job (
    id BIGINT PRIMARY KEY AUTO_INCREMENT,
    job_id VARCHAR(64) NOT NULL UNIQUE,
    index_name VARCHAR(128) NOT NULL,
    query_dsl JSON NOT NULL,
    source_fields JSON NOT NULL,
    output_uri VARCHAR(512) NOT NULL,
    output_format VARCHAR(32) NOT NULL,
    snapshot_mode VARCHAR(32) NOT NULL,
    slice_count INT NOT NULL,
    status VARCHAR(32) NOT NULL,
    expected_doc_count BIGINT NULL,
    exported_doc_count BIGINT NOT NULL DEFAULT 0,
    failed_slice_count INT NOT NULL DEFAULT 0,
    created_by VARCHAR(64) NOT NULL,
    created_at DATETIME NOT NULL,
    updated_at DATETIME NOT NULL,
    started_at DATETIME NULL,
    finished_at DATETIME NULL
);
7.2 切片任务表
CREATE TABLE export_job_slice (
    id BIGINT PRIMARY KEY AUTO_INCREMENT,
    job_id VARCHAR(64) NOT NULL,
    slice_id INT NOT NULL,
    lease_owner VARCHAR(128) NULL,
    checkpoint_json JSON NULL,
    status VARCHAR(32) NOT NULL,
    retry_count INT NOT NULL DEFAULT 0,
    exported_doc_count BIGINT NOT NULL DEFAULT 0,
    current_part_no INT NOT NULL DEFAULT 0,
    last_error TEXT NULL,
    started_at DATETIME NULL,
    finished_at DATETIME NULL,
    updated_at DATETIME NOT NULL,
    UNIQUE KEY uk_job_slice(job_id, slice_id)
);
7.3 导出文件清单表
CREATE TABLE export_file_manifest (
    id BIGINT PRIMARY KEY AUTO_INCREMENT,
    job_id VARCHAR(64) NOT NULL,
    slice_id INT NOT NULL,
    part_no INT NOT NULL,
    object_key VARCHAR(512) NOT NULL,
    row_count BIGINT NOT NULL,
    file_size_bytes BIGINT NOT NULL,
    file_checksum VARCHAR(128) NOT NULL,
    status VARCHAR(32) NOT NULL,
    created_at DATETIME NOT NULL,
    UNIQUE KEY uk_job_slice_part(job_id, slice_id, part_no)
);
这三张表分离后,平台具备几个关键能力:
• 任务级看总进度
• 切片级看热点和失败
• 文件级做幂等校验、审计回放和下游消费登记
八、任务全流程:正常链路、失败链路、恢复链路
8.1 正常导出流程
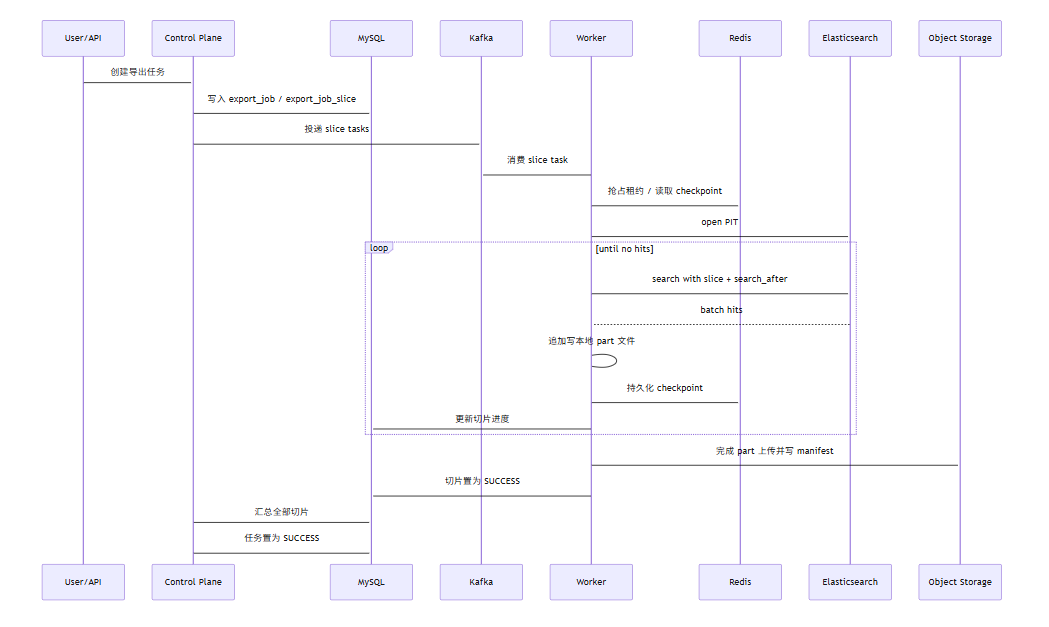
8.2 异常与恢复流程
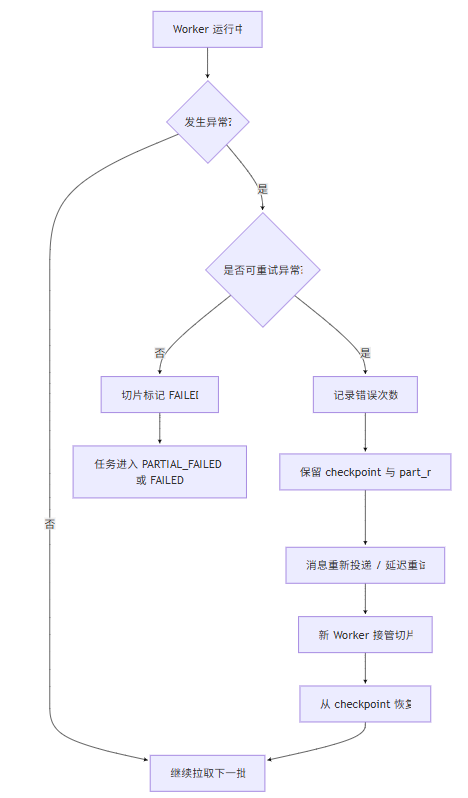
8.3 状态机建议
任务状态建议至少覆盖:
• INIT
• RUNNING
• PARTIAL_FAILED
• SUCCESS
• FAILED
• CANCELLED
切片状态建议至少覆盖:
• PENDING
• LEASED
• RUNNING
• RETRYING
• SUCCESS
• FAILED
状态设计清晰后,很多恢复逻辑会简单很多,因为“能否重试”和“是否允许接管”都能通过状态机明确判断。
九、生产级代码设计:不是几段片段,而是完整职责拆分
下面给出一套更接近生产项目的代码组织方式。这里用 Java/Spring Boot 举例,重点是职责分层,而不是语言本身。
9.1 推荐包结构
com.example.export
├── api
│   ├── ExportJobController.java
│   └── dto
├── application
│   ├── ExportJobApplicationService.java
│   ├── SlicePlanner.java
│   └── SliceTaskDispatcher.java
├── domain
│   ├── model
│   ├── repository
│   └── service
├── infrastructure
│   ├── es
│   ├── kafka
│   ├── redis
│   ├── storage
│   └── persistence
└── worker
    ├── ExportSliceConsumer.java
    ├── ExportSliceExecutor.java
    └── ParquetPartWriter.java
9.2 任务创建接口
package com.example.export.api;

import com.example.export.api.dto.CreateExportJobRequest;
import com.example.export.api.dto.ExportJobResponse;
import com.example.export.application.ExportJobApplicationService;
import jakarta.validation.Valid;
import lombok.RequiredArgsConstructor;
import org.springframework.web.bind.annotation.PostMapping;
import org.springframework.web.bind.annotation.RequestBody;
import org.springframework.web.bind.annotation.RequestHeader;
import org.springframework.web.bind.annotation.RequestMapping;
import org.springframework.web.bind.annotation.RestController;

@RestController
@RequestMapping("/api/export-jobs")
@RequiredArgsConstructor
public class ExportJobController {

    private final ExportJobApplicationService applicationService;

    @PostMapping
    public ExportJobResponse createJob(@Valid @RequestBody CreateExportJobRequest request,
                                       @RequestHeader("X-Operator") String operator) {
        return applicationService.createJob(request, operator);
    }
}
请求对象需要把字段投影、切片策略、输出路径显式配置出来:
package com.example.export.api.dto;

import jakarta.validation.constraints.Min;
import jakarta.validation.constraints.NotBlank;
import jakarta.validation.constraints.NotEmpty;
import jakarta.validation.constraints.NotNull;
import java.util.List;

public record CreateExportJobRequest(
        @NotBlank String indexName,
        @NotBlank String queryDsl,
        @NotEmpty List<String> sourceFields,
        @NotBlank String outputUri,
        @NotNull @Min(1) Integer sliceCount,
        @NotNull @Min(100) Integer batchSize
) {
}
9.3 任务创建应用服务
package com.example.export.application;

import com.example.export.api.dto.CreateExportJobRequest;
import com.example.export.api.dto.ExportJobResponse;
import com.example.export.domain.model.ExportJob;
import com.example.export.domain.model.ExportJobSlice;
import com.example.export.domain.repository.ExportJobRepository;
import com.example.export.domain.repository.ExportJobSliceRepository;
import java.time.LocalDateTime;
import java.util.ArrayList;
import java.util.List;
import java.util.UUID;
import lombok.RequiredArgsConstructor;
import org.springframework.stereotype.Service;
import org.springframework.transaction.annotation.Transactional;

@Service
@RequiredArgsConstructor
public class ExportJobApplicationService {

    private final ExportJobRepository jobRepository;
    private final ExportJobSliceRepository sliceRepository;
    private final SliceTaskDispatcher dispatcher;

    @Transactional
    public ExportJobResponse createJob(CreateExportJobRequest request, String operator) {
        String jobId = "job-" + UUID.randomUUID();
        LocalDateTime now = LocalDateTime.now();

        ExportJob job = ExportJob.newJob(
                jobId,
                request.indexName(),
                request.queryDsl(),
                request.sourceFields(),
                request.outputUri(),
                request.sliceCount(),
                request.batchSize(),
                operator,
                now
        );
        jobRepository.save(job);

        List<ExportJobSlice> slices = new ArrayList<>();
        for (int i = 0; i < request.sliceCount(); i++) {
            slices.add(ExportJobSlice.newPending(jobId, i, now));
        }
        sliceRepository.saveAll(slices);

        dispatcher.dispatch(job, slices);
        return ExportJobResponse.from(job);
    }
}
这里要注意两个工程点:
-
• 任务和切片元数据必须先落库,再投递消息,避免“消息发出去了但数据库没记录”
-
• 更严格的实现可以用本地消息表或事务消息,确保分发一致性
9.4 Kafka 消费者与切片执行器
package com.example.export.worker;

import com.example.export.worker.message.SliceTaskMessage;
import lombok.RequiredArgsConstructor;
import lombok.extern.slf4j.Slf4j;
import org.springframework.kafka.annotation.KafkaListener;
import org.springframework.kafka.support.Acknowledgment;
import org.springframework.stereotype.Component;

@Slf4j
@Component
@RequiredArgsConstructor
public class ExportSliceConsumer {

    private final ExportSliceExecutor executor;

    @KafkaListener(topics = "export-slice-task", groupId = "export-worker")
    public void onMessage(SliceTaskMessage message, Acknowledgment ack) {
        try {
            executor.execute(message.jobId(), message.sliceId());
            ack.acknowledge();
        } catch (Exception ex) {
            log.error("slice execute failed, jobId={}, sliceId={}",
                    message.jobId(), message.sliceId(), ex);
            throw ex;
        }
    }
}
9.5 切片执行核心:检查点、租约、PIT、流式写
package com.example.export.worker;

import com.example.export.domain.model.ExportJob;
import com.example.export.domain.model.ExportJobSlice;
import com.example.export.domain.repository.ExportJobRepository;
import com.example.export.domain.repository.ExportJobSliceRepository;
import com.example.export.infrastructure.es.EsExportClient;
import com.example.export.infrastructure.es.SearchAfterCheckpoint;
import com.example.export.infrastructure.redis.SliceLeaseService;
import com.example.export.infrastructure.redis.SliceCheckpointStore;
import com.example.export.infrastructure.storage.ObjectStorageGateway;
import java.util.List;
import lombok.RequiredArgsConstructor;
import lombok.extern.slf4j.Slf4j;
import org.springframework.stereotype.Service;

@Slf4j
@Service
@RequiredArgsConstructor
public class ExportSliceExecutor {

    private final ExportJobRepository jobRepository;
    private final ExportJobSliceRepository sliceRepository;
    private final SliceLeaseService leaseService;
    private final SliceCheckpointStore checkpointStore;
    private final EsExportClient esExportClient;
    private final ObjectStorageGateway objectStorageGateway;
    private final ParquetPartWriterFactory writerFactory;

    public void execute(String jobId, int sliceId) {
        ExportJob job = jobRepository.findByJobId(jobId)
                .orElseThrow(() -> new IllegalArgumentException("job not found"));
        ExportJobSlice slice = sliceRepository.findByJobIdAndSliceId(jobId, sliceId)
                .orElseThrow(() -> new IllegalArgumentException("slice not found"));

        String leaseToken = leaseService.tryAcquire(jobId, sliceId)
                .orElseThrow(() -> new IllegalStateException("slice leased by another worker"));

        try {
            sliceRepository.markRunning(jobId, sliceId);
            SearchAfterCheckpoint checkpoint = checkpointStore.load(jobId, sliceId).orElse(null);

            try (ParquetPartWriter writer = writerFactory.create(job, slice)) {
                String pitId = esExportClient.openPit(job.getIndexName());
                try {
                    while (true) {
                        List<EsDocument> docs = esExportClient.searchNextBatch(
                                job, sliceId, checkpoint, pitId);
                        if (docs.isEmpty()) {
                            break;
                        }

                        for (EsDocument doc : docs) {
                            writer.write(doc.source());
                        }

                        checkpoint = SearchAfterCheckpoint.fromLast(docs.get(docs.size() - 1));
                        checkpointStore.save(jobId, sliceId, checkpoint);
                        sliceRepository.updateProgress(jobId, sliceId, docs.size(), writer.currentPartNo());

                        if (writer.shouldFlushPart()) {
                            var fileMeta = writer.flushCurrentPart();
                            objectStorageGateway.upload(fileMeta.localPath(), fileMeta.objectKey());
                            sliceRepository.recordPart(jobId, sliceId, fileMeta.partNo(), fileMeta.rowCount());
                        }

                        leaseService.renew(jobId, sliceId, leaseToken);
                    }

                    var finalFile = writer.complete();
                    if (finalFile != null) {
                        objectStorageGateway.upload(finalFile.localPath(), finalFile.objectKey());
                        sliceRepository.recordPart(jobId, sliceId, finalFile.partNo(), finalFile.rowCount());
                    }
                } finally {
                    esExportClient.closePit(pitId);
                }
            }

            checkpointStore.clear(jobId, sliceId);
            sliceRepository.markSuccess(jobId, sliceId);
            jobRepository.refreshJobProgress(jobId);
        } catch (Exception ex) {
            sliceRepository.markRetrying(jobId, sliceId, ex.getMessage());
            throw ex;
        } finally {
            leaseService.release(jobId, sliceId, leaseToken);
        }
    }
}
这段代码体现了几个生产级原则:
-
• 执行权靠租约控制,避免同一切片被多个 Worker 并发执行
-
• 检查点按批次持久化,而不是任务结束后一次性写
-
• part 文件滚动上传,避免本地堆积超大文件
-
• 切片成功与文件落地分开记录,便于幂等校验
9.6 检查点设计
package com.example.export.infrastructure.es;

import java.io.Serializable;
import java.util.List;

public record SearchAfterCheckpoint(List<Object> sortValues) implements Serializable {

    public static SearchAfterCheckpoint fromLast(EsDocument document) {
        return new SearchAfterCheckpoint(document.sortValues());
    }
}
检查点不要保存成复杂对象,只要保存能恢复查询位置的最小必要信息即可。
9.7 Parquet Writer 的关键设计点
Parquet Writer 不是简单封装一个 write() 方法,生产环境里要额外解决:
-
• 文件滚动:按行数或字节数滚动 part
-
• schema 演进:字段缺失、空值、类型兼容
-
• 临时文件命名:避免重试覆盖错误文件
-
• 完成语义:只有上传成功并登记 manifest 后,该 part 才算完成
一个建议的对象 key 规范如下:
s3://offline-lake/es/orders_v3/dt=2026-08-06/job_id=job-xxx/slice=0003/part-0007.parquet
样设计有几个好处:
• 便于按任务隔离
• 便于按切片回溯
• 便于做生命周期清理
• 便于下游按分区读取
十、高并发与可扩展设计:怎么逼近“每秒 50 万条”
先说明边界:50 万条/秒 不是一个脱离环境的固定结论,它取决于索引结构、字段体积、分片数、集群拓扑、网络带宽、对象存储性能和下游编码开销。工程上我们讨论的不是“绝对数字”,而是“系统如何具备逼近该吞吐的能力”。
10.1 并发不是越高越好,而是要分层控流
导出吞吐主要受四类资源约束:
• Elasticsearch 查询吞吐
• Worker CPU 与堆内存
• 本地磁盘或临时卷写入能力
• 对象存储上传带宽
因此并发控制必须分层:
• 任务级:同一时间允许多少个导出任务运行
• 切片级:单任务允许多少切片并发
• Worker 级:单实例允许多少 slice executor 并发
• 请求级:单 executor 每秒允许发多少次 ES 查询
10.2 推荐的并发控制策略
一个稳妥的做法是:
• Kafka 分区数大于等于最大切片数
• 一个 Worker 内部用固定线程池执行切片
• 每个切片串行推进自己的游标,不要在单切片内再做无序并发
• 对 ES 请求使用令牌桶限流
• 对对象存储上传使用独立线程池,和拉数线程池隔离
这样可以避免两个常见问题:
• 拉数线程被上传阻塞
• 上传线程太多反向挤占 CPU,导致 Parquet 编码变慢
10.3 资源隔离建议
建议至少隔离三类线程池:
• slice-fetch-pool:负责 Elasticsearch 拉数
• file-upload-pool:负责对象存储上传
• job-control-pool:负责任务汇总、状态修正和补偿
如果全部共用一个线程池,故障时会出现连锁阻塞。
10.4 扩容策略
在 Kubernetes 中,扩容不应只看 CPU,还应结合 Kafka lag 和任务堆积。
可采用两类指标触发自动扩容:
• kafka_consumer_lag
• export_running_slices
简单来说:
• lag 持续高,说明切片消费能力不够
• running slice 已接近上限但任务等待多,说明需要更多 Worker
十一、可靠性设计:企业级导出最难的不是跑得快,而是失败后还能继续跑
11.1 幂等性怎么做
导出天然很难做到严格意义上的“全局 exactly once”,因为会跨越 Elasticsearch、Worker、本地文件系统和对象存储多个系统。
更现实的策略是做“切片级幂等 + 文件级去重 + manifest 提交语义”:
• 切片有独立租约,避免同一时间被多个 Worker 重复执行
• 每个 part 文件用 (jobId, sliceId, partNo) 唯一标识
• 上传成功后再登记 manifest,登记前不对下游可见
• 下游消费只读 manifest 中状态为 READY 的文件
这样即使出现重复上传,也能通过唯一键和 manifest 状态控制可见性。
11.2 重试策略
要区分可重试错误和不可重试错误。
可重试错误通常包括:
• 网络超时
• Elasticsearch 短暂拒绝
• 对象存储瞬时失败
• Worker 节点被驱逐
不可重试错误通常包括:
• 查询 DSL 非法
• 字段 schema 与输出 schema 严重不兼容
• 权限缺失
• 目标路径不可写
推荐策略:
• 可重试错误:指数退避重试,最多 N 次
• 不可重试错误:切片直接失败,任务转人工处理
• 多次失败后:写入 DLQ,并附最近一次检查点和错误快照
11.3 故障恢复的关键不是“重试”,而是“可接管”
如果一个 Worker 宕机,系统不能要求它“自己恢复”。真正的平台化恢复应该是:
• Redis 租约超时后自动失效
• Kafka 或调度器重新分发切片
• 新 Worker 读检查点后从上次位置继续
也就是说,恢复能力必须建立在“状态外置”之上,而不是“进程内记忆”之上。
十二、性能优化:真正影响吞吐的不是一个参数,而是一整条链路
12.1 Elasticsearch 侧优化
- 只读导出入口
如果条件允许,优先从以下入口导出:
• 只读副本集群
• 跨集群复制后的离线查询集群
• 热点业务隔离后的专用协调节点
不要默认直接冲击主生产集群。
-
字段投影
只拉需要的字段,禁止全量 _source 无脑透传。 -
批大小
batchSize 太小会导致 RPC 次数过多,太大会导致单批内存和编码成本升高。这个值必须通过压测确定,不能照搬。 -
切片数
切片数通常不是越多越好。切片过多会导致:
• 协调开销上升
• Kafka 消息数量暴涨
• Worker 频繁切换上下文
合理做法是结合索引分片数、文档规模、节点数和目标吞吐做估算,再通过压测微调。
12.2 Worker 侧优化
-
流式写,不攒大集合
每批文档到达后立即编码写入 Parquet,不要先聚合成大 List 再统一处理。 -
控制对象分配
高吞吐场景下,临时对象过多会导致 GC 压力增大。常见优化点包括:
• 复用 schema 转换对象
• 避免反复创建大型中间 Map
• 减少字符串拼接与日志对象构建
3. 文件滚动
按行数和字节双阈值滚动 part 文件,避免出现单文件过大导致上传慢、恢复慢、下游读取慢的问题。
12.3 对象存储侧优化
对象存储往往是被忽略的瓶颈。优化点包括:
• 使用多段上传
• 合理设置 part 大小
• 上传线程池独立
• 为 bucket 和路径规划合理前缀,避免热点集中
十三、安全与治理:生产平台不能只有性能,没有边界
13.1 权限控制
导出平台至少应校验:
• 谁可以创建导出任务
• 谁可以访问某个索引的数据
• 谁可以把数据导出到某个对象存储路径
否则“导出能力”本身就可能变成数据泄露通道。
13.2 敏感字段治理
对于手机号、身份证号、邮箱、地址等字段,建议支持三种策略:
• 禁止导出
• 脱敏导出
• 加密导出
不要把敏感字段治理留给下游补救。
13.3 多环境与配置管理
关键配置必须外置:
• ES 地址与认证信息
• 限流阈值
• 默认切片数
• 默认 batch size
• Parquet 滚动阈值
• 对象存储 bucket 与前缀
同时要区分:
• 开发环境
• 测试环境
• 生产环境
不要在代码里写死任何生产集群地址和密钥。
十四、可观测性:不看见,就无法运维
企业级导出平台必须至少具备三类可观测能力。
14.1 指标
建议埋点:
• export_job_running_total
• export_slice_running_total
• export_slice_retry_total
• export_docs_exported_total
• export_part_upload_seconds
• export_es_query_seconds
• export_checkpoint_save_fail_total
• export_object_upload_fail_total
这些指标能回答四个关键问题:
• 现在有多少任务在跑
• 导得快不快
• 卡在哪
• 哪个环节在失败
14.2 日志
日志必须结构化,至少包含:
• jobId
• sliceId
• traceId
• pitId 或其摘要
• partNo
• checkpoint
• errorCode
否则线上排障时只能靠全文搜索和猜测。
14.3 告警
建议建立如下告警:
• 某切片长时间无进度
• 某任务重试次数异常升高
• ES 查询 P99 激增
• 对象存储上传失败率升高
• Kafka lag 持续堆积
告警不是越多越好,重点是能直接指向处理动作。
十五、Kubernetes 部署建议
下面给出一个精简版部署示例,用于体现资源隔离和弹性伸缩思路。
apiVersion: apps/v1
kind: Deployment
metadata:
  name: export-worker
spec:
  replicas: 6
  selector:
    matchLabels:
      app: export-worker
  template:
    metadata:
      labels:
        app: export-worker
    spec:
      containers:
        - name: export-worker
          image: registry.example.com/export-worker:1.0.0
          env:
            - name: SPRING_PROFILES_ACTIVE
              value: prod
          resources:
            requests:
              cpu: "1"
              memory: "2Gi"
            limits:
              cpu: "2"
              memory: "4Gi"
          volumeMounts:
            - name: tmp-dir
              mountPath: /data/tmp
      volumes:
        - name: tmp-dir
          emptyDir:
            sizeLimit: 20Gi
如果需要基于 Kafka lag 自动扩容,可以接入 KEDA 或自定义 HPA 指标。
部署时还要注意两个点:
• 本地临时卷必须有容量上限,避免异常任务把节点磁盘写满
• 上传线程数不能无上限增长,否则会把容器 CPU 吃空
十六、常见错误方案与边界条件
16.1 常见错误方案
错误方案一:一个超大 JSON 文件导到底
问题:
• 不可恢复
• 失败代价极大
• 下游消费效率差
错误方案二:单机多线程直接扫生产集群
问题:
• 缺少全局控流
• 没有平台级观测
• 很难做故障接管
错误方案三:把导出状态只保存在内存
问题:
• 进程一挂,进度全丢
• 无法跨实例接管
错误方案四:切片只做并发,不做幂等
问题:
• 重试后文件重复
• 下游无法确认最终结果集
16.2 适用边界
本文方案适用于:
• 十亿级或多 TB 级 Elasticsearch 离线导出
• 需要断点续传和平台化治理的场景
• 下游以数据湖、数仓、批处理系统为主的场景
不一定适合:
• 几百万以内的一次性临时导出
• 低频人工操作且失败代价很低的场景
• 更适合直接做 CDC 或业务库直采的场景
如果你的目标是持续实时同步,而不是离线抽取,那么更应该评估 CDC、日志订阅、双写或流处理架构,而不是把 Elasticsearch 反向当主数据源。
十七、方案演进:从离线导出平台继续往前走
当平台跑稳之后,常见演进方向有四个。
17.1 全量 + 增量一体化
初次全量导出后,后续只导出增量分区,减少重复扫描成本。
17.2 冷热分层导出
近期热数据走高频增量导出,历史冷数据走低频大批次归档导出。
17.3 统一数据抽取平台
把 Elasticsearch、MySQL、ClickHouse、MongoDB 等源统一纳入同一导出平台,而不是每个系统单独写一套脚本。
17.4 编排化
让导出任务不只停留在“拉数据”,而是支持后续动作:
• 校验
• 合并
• 分区注册
• 元数据登记
• 下游通知
这时它就不再是单点工具,而会逐步演进成离线数据编排底座。
十八、总结:真正的难点,不是从 ES 读数据,而是把“读数据”变成一种稳定能力
回到文章开头那个问题:为什么一个看上去很简单的导出任务,最后会演变成一套平台设计?
因为十亿级数据导出真正考验的,从来都不只是 Elasticsearch API 的使用,而是完整的工程能力:
• 你是否理解快照一致性与导出边界
• 你是否能把大任务拆成可调度、可恢复的小任务
• 你是否能在高并发下控制对源集群的冲击
• 你是否能让失败重试不引入重复和混乱
• 你是否能让任务状态、文件状态和进度状态都可见
所以,一个成熟的方案应该是这样的:
• 查询层面,用 PIT + search_after + slice
• 架构层面,用“控制面 + 执行面 + 状态面”解耦
• 工程层面,用 Kafka、Redis、MySQL、对象存储共同构建可恢复链路
• 运维层面,用指标、日志、告警把问题前置暴露
从脚本到平台,表面上是在解决“导出慢、导不完、导挂了”的问题,实质上是在建设企业级离线数据能力。
如果你也准备做类似系统,最重要的不是先写 Worker,而是先回答三个问题:
- 你的导出语义是什么,是一次性成功,还是可恢复成功。
- 你的下游真正需要什么,是 JSON 文本,还是可治理的数据集。
- 你的线上集群能承受多大代价,是否应该先做只读隔离。
这三个问题想清楚了,后面的实现才不会再次回到那个熟悉的起点:一个凌晨两点运行、天亮前还不知道能不能结束的脚本。
本文的引用仅限自我学习如有侵权,请联系作者删除。
参考知识
10 亿数据从 Elasticsearch 导出:从脚本到企业级离线数据平台的完整设计
本文的引用仅限自我学习如有侵权,请联系作者删除。
参考知识
10 亿数据从 Elasticsearch 导出:从脚本到企业级离线数据平台的完整设计


 扫一扫


 2701

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


