大模型面试无非就是这些题!网易NLP大模型实习面试题8道|含解析

4月22日-5月7日腾讯nlp算法实习面试题14道 问题1:决策树有多少种,分别的损失函数是什么? 决策树有多少种,分别的损失函数是什么?决策树有三种:分别为ID3,C4.5,Cart树 ID3损失函数︰ C4.5损失函数∶ Cart树损失函数∶ 问题2:决策树的两种剪枝策略分别是什么? 决策树的剪枝基本策略有预剪枝(Pre-Pruning)和后剪枝(Post-Pruning)。 预剪枝核心思想︰ 在每一次实际对结点进行进一步划分之前,先采用验证集的数据来验证如果划分是否能提高划分的准确性。如果不能,就把结点标记为叶结点并退出进一步划分﹔如果可以就继续 阅读详情

问题1:文本生成的几大预训练任务?

  • GPT(Generative Pre-trained Transformer)系列:包括GPT、GPT-2、GPT-3等。这些模型使用Transformer架构进行预训练,在大规模语料上学习语言模型,能够生成连贯、具有语义的文本。

  • BART(Bidirectional and Auto-Regressive Transformer):BART是一种基于Transformer的生成式预训练模型。它通过自回归解码器实现文本生成,通过自编码器预训练目标来重构输入文本,能够生成流畅、连贯的文本。

  • T5(Text-to-Text Transfer Transformer):T5是一种通用的文本生成模型,使用了编码器-解码器结构。它将不同的自然语言处理(NLP)任务转换为文本到文本的转换任务,可用于机器翻译、摘要生成、问题回答等多个NLP任务。

  • XLNet:XLNet是一种基于Transformer架构的预训练模型,采用了自回归和自编码器的组合方式进行训练。它在语言建模任务上引入了全局的上下文信息,能够生成更加准确和连贯的文本。

  • UniLM(Unified Language Model):UniLM是一种多任务学习的预训练模型,将不同的自然语言处理任务转化为统一的生成式任务。它可以用于文本摘要、问答系统、机器翻译等多个任务。

问题2:多模态中常见的SOTA模型有哪些?

  • Vision Transformer (ViT): 将自注意力机制引入计算机视觉领域,通过将图像划分为图像补丁并应用Transformer模型,实现了在图像分类和目标检测等任务上的出色表现。

  • CLIP (Contrastive Language-Image Pretraining): 结合了图像和文本的对比学习,通过训练一个模型,使其能够根据图像和文本之间的相互关系进行推理,实现了图像与文本之间的联合理解和表示学习。

  • UNITER (UNiversal Image-Text Representation): 使用Transformer架构,联合学习图像和文本表示,提供了一个通用的图像和文本特征提取框架,适用于多个视觉和语言任务。

  • LXMERT (Cross-Modal Transformer): 结合了视觉和语言信息,通过Transformer模型对图像和文本进行交互学习,可以用于视觉问答、图像描述生成等任务。

问题3:介绍一下stable diffusion的原理。

stable diffusion是一种生成模型,其原理基于Langevin动力学和扩散过程。其核心思想是通过多次迭代,逐渐将噪声信号演化为目标分布所对应的样本。具体原理如下:

  • 初始化噪声信号为服从高斯分布的随机向量。

  • 通过一系列的演化步骤,将噪声信号迭代地转化为目标分布的样本。每一步中,将当前噪声信号与目标分布的梯度信息结合,通过Langevin动力学方程进行更新,使噪声信号逐渐接近目标分布。

  • 迭代的次数越多,噪声信号越接近目标分布,并最终生成目标分布的样本。

stable diffusion通过合理的选择演化步长和迭代次数,可以在生成样本的过程中平衡样本质量和生成速度。

问题4:instructGPT的原理,讲讲rlhf和reward。

instructGPT是一种基于强化学习的文本生成模型,其核心原理涉及两个概念:RLHF(Reinforcement Learning from Human Feedback)和reward shaping(奖励塑造)。

  • RLHF:在训练instructGPT时,首先使用有人类生成的示例对模型进行预训练。然后,通过与人类评估者进行交互,收集评估结果,以创建一个用于强化学习的数据集。该数据集包含了人类评估者对生成结果的评分或反馈,用于指导模型的强化学习训练。

  • Reward shaping:为了更好地引导模型的训练,reward shaping用于调整模型的奖励信号。通过将人类评估者的反馈与模型生成的文本进行比较,可以计算出一个差异度量,用作奖励信号的一部分。这样,模型可以根据这个奖励信号进行训练,并进行强化学习的训练。模型根据当前的状态(对话历史)生成文本,并通过奖励信号来评估生成文本的质量。模型的目标是最大化预期累积奖励,从而生成更高质量的文本。

通过RLHF和reward shaping的结合,instructGPT能够通过人类评估者的反馈指导模型的生成过程,并逐步提升生成文本的质量和一致性。

问题5:讲讲T5和Bart的区别,讲讲bart的DAE任务。

T5(Text-to-Text Transfer Transformer)和Bart(Bidirectional and Auto-Regressive Transformer)是两个常见的预训练模型,它们之间的区别如下:

  • T5是一种基于Transformer的通用文本生成模型。T5的训练目标是将不同的自然语言处理(NLP)任务统一为文本到文本的转换任务。它采用了编码器-解码器结构,通过输入一个自然语言文本,输出另一个相关的自然语言文本,可以应用于机器翻译、摘要生成、问题回答等多个NLP任务。

  • Bart是建立在T5模型基础上的一个变种,它专注于生成式任务。Bart模型使用了自回归解码器,通过训练一个自编码器来重构原始文本,同时采用了标准的语言模型预训练目标,从而使得生成的文本更加流畅和连贯。Bart的主要应用领域包括文本生成、摘要生成、对话系统等。

在任务类型上,T5更加通用,适用于多种NLP任务的文本转换,而Bart则更加专注于生成式任务,并且在生成文本的质量和连贯性上有所优化。

关于Bart的DAE(Denoising AutoEncoder)任务,它是Bart模型的一种预训练目标。DAE任务要求模型从输入的有噪声的文本中恢复原始的无噪声文本。通过在训练过程中向输入文本中添加噪声,并要求模型重建无噪声的文本,Bart可以学习到更好的文本表示和重构能力,从而提高生成文本的质量和准确性。

问题6:讲讲Bart和Bert的区别****。****

Bart和Bert是两个不同的预训练模型,它们之间的区别如下:

  • Bart是一种基于Transformer的生成式预训练模型,主要应用于文本生成、摘要生成、对话系统等任务。Bart采用了自回归解码器,通过自编码器预训练目标来重构输入文本,从而生成流畅、连贯的文本。

  • Bert(Bidirectional Encoder Representations from Transformers)是一种双向的预训练模型,用于生成文本的上下文表示。与Bart不同,Bert采用了双向的Transformer编码器,通过将上下文的信息融合到表示中,提供了更全面的语境理解能力。Bert主要应用于词嵌入、文本分类、命名实体识别等任务。

总体上说,Bart侧重于生成式任务和文本生成,而Bert侧重于上下文表示和语境理解。它们在模型结构和应用场景上存在一定的差异。

问题7:对比学习负样本是否重要?负样本构造成本过高应该怎么解决?

对比学习中负样本的重要性取决于具体的任务和数据。负样本可以帮助模型学习到样本之间的区分度,从而提高模型的性能和泛化能力。然而,负样本的构造成本可能会较高,特别是在一些领域和任务中。

为了解决负样本构造成本过高的问题,可以考虑以下方法:

  • 降低负样本的构造成本:通过设计更高效的负样本生成算法或采样策略,减少负样本的构造成本。例如,可以利用数据增强技术生成合成的负样本,或者使用近似采样方法选择与正样本相似但不相同的负样本。

  • 确定关键负样本:根据具体任务的特点,可以重点关注一些关键的负样本,而不是对所有负样本进行详细的构造。这样可以降低构造成本,同时仍然能够有效训练模型。

  • 迁移学习和预训练模型:利用预训练模型或迁移学习的方法,可以在其他领域或任务中利用已有的负样本构造成果,减少重复的负样本构造工作。

问题8:介绍一下lora的原理和ptuning的原理。

Lora方法的核心是在大型语言模型上对指定参数增加额外的低秩矩阵,也就是在原始PLM旁边增加一个旁路,做一个降维再升维的操作。并在模型训练过程中,固定PLM的参数,只训练降维矩阵A与升维矩阵B。

ptuning方法的核心是使用可微的virtual token替换了原来的discrete tokens,且仅加入到输入层,并使用prompt encoder(BiLSTM+MLP)对virtual token进行编码学习。

​

如何学习AI大模型?

作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

这份完整版的大模型 AI 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】

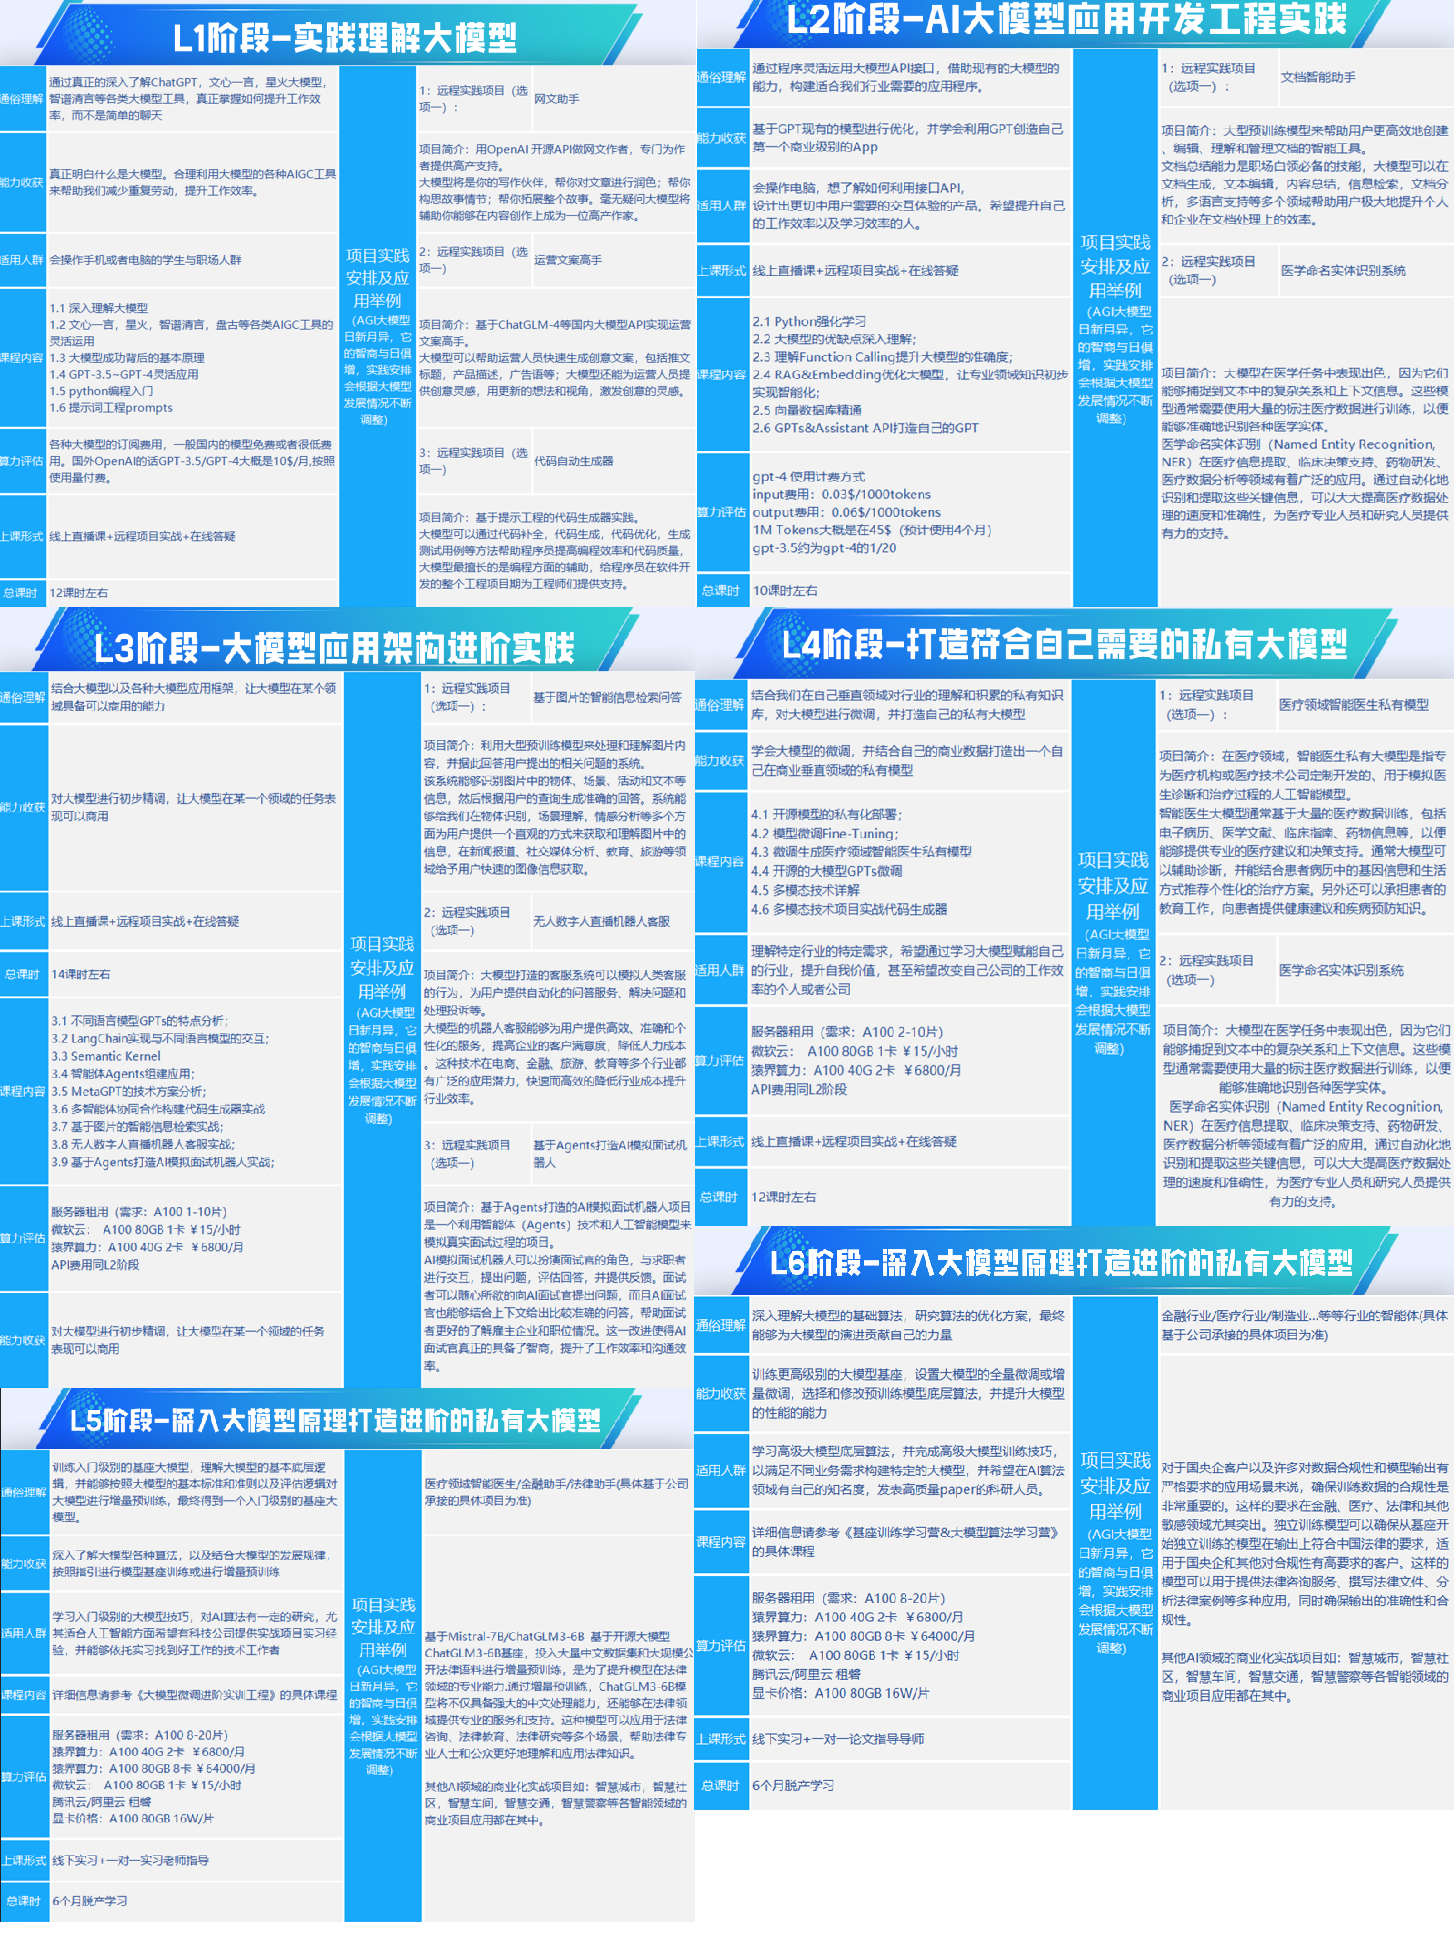
一、全套AGI大模型学习路线

AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!
img

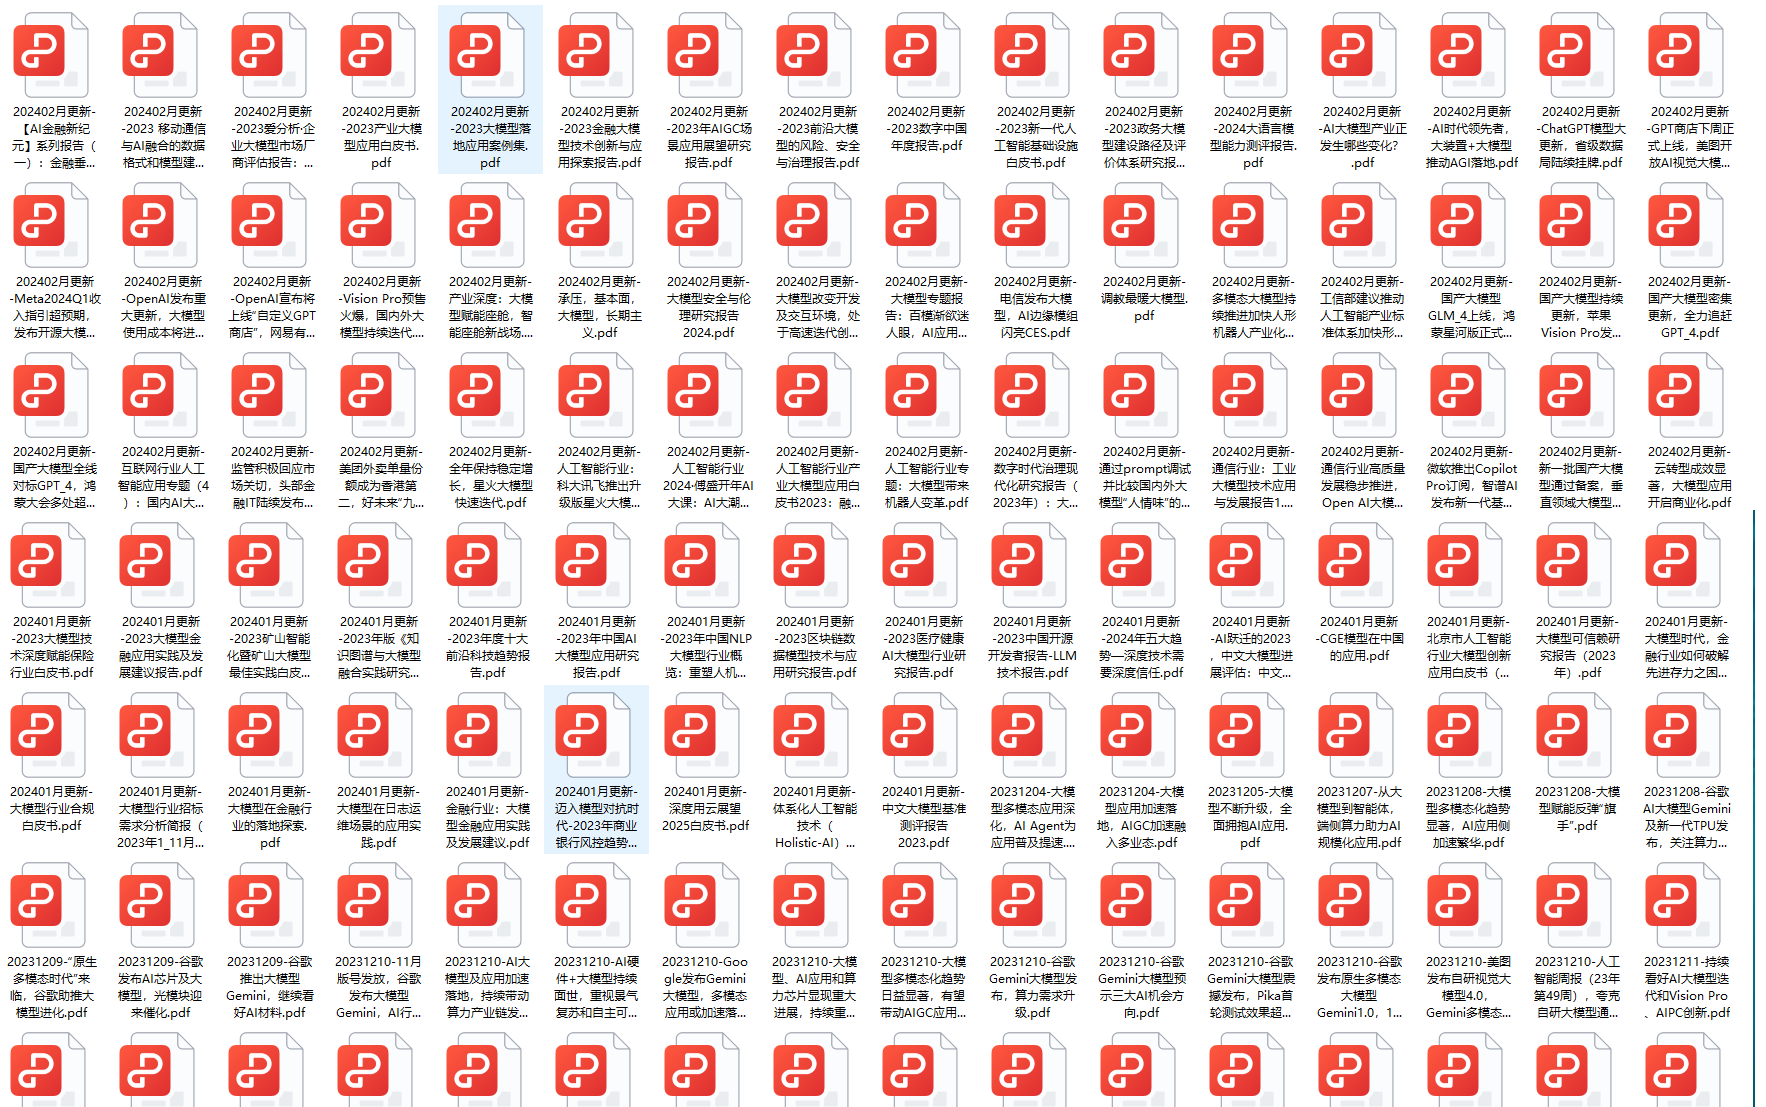
二、640套AI大模型报告合集

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。
img

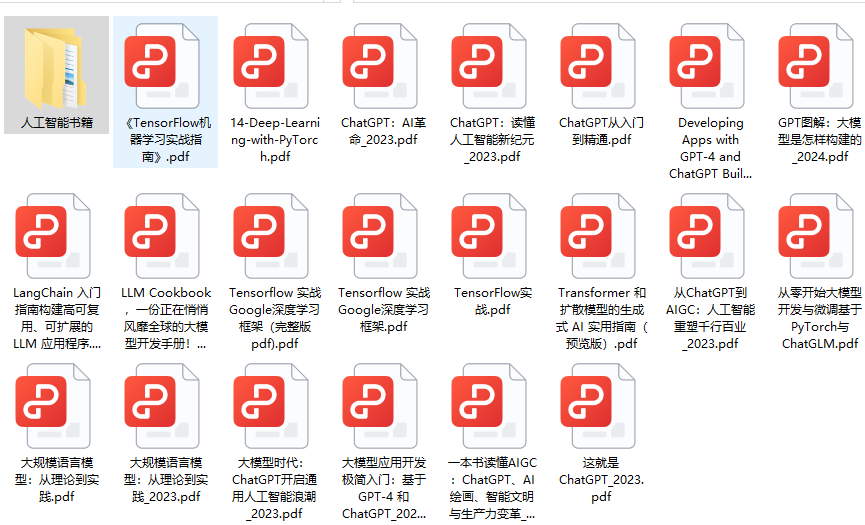
三、AI大模型经典PDF籍

随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。
img

四、AI大模型商业化落地方案

img

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。

NLP常见面试题,必知必答系列大全:(面试问题持续更新) 阅读详情

相关推荐

2025秋招NLP算法面试真题(一)-史上最全Transformer面试题

史上最全Transformer面试题

weixin_41496173的博客 1232

NLP面试宝典:38个最常见NLP问题答案一文get

新智元报道来源:greatlearning自然语言处理(Natural Language Processing,NLP)是指帮助机器理解和分析自然语言;它是利用机器学习算法从数据...

机器学习算法与Python学习 8056

Apple CarPlay Certification Guide December 2022 解析V1.0

Apple CarPlay Certification Guide December 2022更新说明

m0_74450450的博客 697

推荐收藏!网易 NLP 大模型(实习)面试题8道(含答案)!

stable diffusion是一种生成模型,其原理基于Langevin动力学和扩散过程。其核心思想是通过多次迭代,逐渐将噪声信号演化为目标分布所对应的样本。具体原理如下:初始化噪声信号为服从高斯分布的随机向量。通过一系列的演化步骤,将噪声信号迭代地转化为目标分布的样本。每一步中,将当前噪声信号与目标分布的梯度信息结合,通过Langevin动力学方程进行更新,使噪声信号逐渐接近目标分布。迭代的次数越多,噪声信号越接近目标分布,并最终生成目标分布的样本。

2301_78285120的博客 2435

STM32使用LORA模块通信

目录 一、模块使用方法 1、模块简介 2、硬件及功能 3、传输方式 二、模块上手 1、连接 2、编写代码 usart3.h usart3.c lora.h lora.c 一、模块使用方法 本文以正点原子ATK-LORA-01模块为例进行介绍。 1、模块简介 ATK-LORA-01-V3.0(V3.0是版本号,下面均以ATK-LORA-01表示该产品)是ALIENTEK推出的一款体积小、微功率、低功耗、高性能远距离LORA无线串口模块。模块设计是采用高效的IS...

qq_54706971的博客 3万+

学习 Bootstrap 5 之 Tables

学习 Bootstrap 5 之 表格表格 (Tables)1. 创建表格(1). 使用原生的表格标签(2). 使用Bootstrap 5 的提供的表格标签类(3). 原生与Bootstrap创建出来的表格的对比2. 表格样式(1). 表格样式的效果(2). 表格样式的使用1). 用于 <table> 标签2). 用于 <thead> <tbody> <tfoot> 标签 表格 (Tables) 1. 创建表格 (1). 使用原生的表格标签 <tabl

qq_37354060的博客 2128

网易 NLP 大模型实习面试题8道|含解析

通过在训练过程中向输入文本中添加噪声,并要求模型重建无噪声的文本,Bart可以学习到更好的文本表示和重构能力,从而提高生成文本的质量和准确性。Bart模型使用了自回归解码器,通过训练一个自编码器来重构原始文本,同时采用了标准的语言模型预训练目标,从而使得生成的文本更加流畅和连贯。CLIP (Contrastive Language-Image Pretraining): 结合了图像和文本的对比学习,通过训练一个模型,使其能够根据图像和文本之间的相互关系进行推理,实现了图像与文本之间的联合理解和表示学习。

2201_75499313的博客 1412

论文阅读:ICLR 2023 FINE-TUNING ALIGNED LANGUAGE MODELS COMPROMISES SAFETY, EVEN WHEN USERS DO NOT INTEND

对大型语言模型(LLMs)进行微调以适应特定用例通常涉及对预训练的LLMs进行进一步的定制。Meta公开发布Llama模型和OpenAI的API允许在自定义数据集上微调GPT-3.5 Turbo,也鼓励这种做法。但是,这种自定义微调与安全成本有何关联?我们注意到,尽管现有的安全对齐基础设施可以在推理时限制LLMs的有害行为,但它们并未涵盖将微调权限扩展到最终用户时的安全风险。我们的红队研究发现,即使是只有几个设计有敌意的训练示例进行微调,也可以破坏LLMs的安全对齐。

CSPhD-winston的博客 807

【干货大礼包】NLP大模型开发18个干货资料合集(高频面试问题答案)

1. 如何定义“大模型”在现代AI领域的概念?2. GPT的全称是什么,其中每个词汇的具体含义是什么?描述ChatGPT、GPT和大模型之间的关系和区别。3.如何定义AGI这一概念?AIGC代表的是什么概念或技术?4.对于OpenAI来说,语言类大模型有哪些,其基座模型是什么?5.OpenAI的文本向量化模型是用来做什么的?6.请描述LLM的涌现能力及其主要包含的方面,以及其激活方法7.定义提示工程是什么?8.在提示工程中,主要采用哪些方式添加提示?9.微调的定义是什么?

xiangxueerfei的博客 1100

【二】MADDPG多智能体算法实现(parl)【追逐游戏复现】

论文全称:Multi-Agent Actor-Critic for Mixed Cooperative-Competitive Environments 论文原文:https://download.csdn.net/download/sinat_39620217/16203960 论文翻译:https://blog.csdn.net/qiusuoxiaozi/article/details/79066612 ...

丨汀、的博客 2万+

YOLO26改进 - SPPF模块 | 发论文神器!LSKA注意力改进SPPF,增强多尺度特征提取能力,高效涨点!!!

本文介绍了Large Separable Kernel Attention (LSKA)模块及其在YOLO26中的结合应用。LSKA旨在解决Visual Attention Networks (VAN)使用大内核卷积时的计算效率问题,通过将2D深度卷积层的卷积核分解为级联的水平和垂直1-D卷积核,降低了计算复杂度和内存占用,且使VAN更关注物体形状。我们将集成LSKA的SPPF_LSKA模块引入YOLO26,大量实验表明,改进后的模型在对象识别、检测、分割和稳健性测试上表现出色。

魔改工程师的博客 245

【面试收藏】大模型算法工程师大厂面试真题汇总

本文汇总了网易、美团、理想等多家知名企业大模型算法岗面试真题,涵盖文本生成、多模态模型、Transformer结构、RLHF等核心知识点,分享了面试者的真实经历与应对策略,为准备大模型岗位的求职者提供全面指导,并推荐AI算法交流群作为技术交流平台。

star_nwe的博客 1006

43、FMCW雷达高度计仿真

本文介绍了FMCW雷达高度计的波形级建模与仿真过程,重点模拟了着陆和倾斜两种飞行场景以评估其性能。通过结合高程数据和飞行轨迹构建雷达场景,使用自定义信号处理器分析IQ样本并估计高度。结果表明,该高度计在多数情况下满足性能要求,但也存在误差较大的点,提出了地面检测算法优化的潜在方向。

neovim7hacker的博客 133

你是否适合学习AI?从核心能力到职业路径的全面解析!AI大模型学习路线路径+资源推荐,巨详细!!

《人工智能学习者的核心特质与成长路径》 人工智能学习需要兼具数学基础、编程能力与持续学习动力。数学方面,需掌握线性代数、概率统计及优化理论;编程则需精通Python及主流框架(TensorFlow/PyTorch)。成功案例显示,理工科背景(计算机/数学)及开发工程师转型更具优势。此外,兴趣驱动、跨学科整合能力(如AI+医疗/金融)及伦理意识同样关键。学习路径建议分三阶段:基础(数学/Python)、核心(机器学习/深度学习)、实战(Kaggle/开源项目)。行业数据显示,医疗AI工程师年薪达45万,量化研

2401_85390073的博客 1543

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

DeepSeek在教育辅导中的应用技巧有哪些?

关注我,持续分享逻辑思维&管理思维&面试题;可提供大厂面试辅导、及定制化求职/在职/管理/架构辅导;推荐专栏,目前已完成所有内容。一顿烧烤不到的费用,让人能紧跟时代的浪潮。从普通网站,到公众号、小程序,再到AI大模型网站。干货满满。学成后可接项目赚外快,绝对划算。不仅学会如何编程,还将学会如何将AI技术应用到实际问题中,为您的职业生涯增添一笔宝贵的财富。

借雨醉东风的博客 1254

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

常见的面试问题————NLP篇(持续更新)

1、Word2Vec的原理,使用的技巧? https://mp.weixin.qq.com/s/lerKdFXkhqQaaVl4BGgblA 2、fasttext 、word2vec、glove、elmo、bert、GPT、xlnet的区别 3、textcnn原理 4、Transformer的结构,multi-headAttention的作用 5、Transformer的位...

Matrix_cc的博客 6271

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

nlp面试汇总

这些面试题是在各个平台上搜取的,方便大家面试的时候使用,主要偏向nlp方向 词向量 词向量平均法做分类的优劣势是什么? 优势 词向量平均的方法做分类模型,主要的优势是模型简单 有参数模型,无参数模型都可以尝试使用,模型选择大 模型速度极快,训练的参数量少 在语句少的场景下,效果好 劣势 在语句长的长的场景下,效果会变的很差 语句长,分出的词多,词越多,信息量越杂,简单的做平均的话,重要的词的信息会在平均的过程中极大的被消弱,从而分类效果差 词向量的基础上如何做优化? 映入一个新的向量,做attent

lzay的博客 6545

NLP面试常考题(以前面试被问得题,答案为个人理解,仅供参考)

面试常考题(答案为个人理解,仅供参考) 1: 词向量是什么, 有哪些方式生成词向量, 句子的词向量是什么? 答: 词向量 将词汇为表示成向量,称作词向量 生成词向量的方式 生成词向量的方法有很多,这些方法都依照一个思想:任一词的含义可以用它的周边词来表示。生成词向量的方式可分为:基于统计的方法和基于语言模型(language model)的方法。 基于统计的方法: 共现矩阵 SVD(奇异值分解) 基于语言模型的方法: 而如果是拿一个词语的上下文作为输入,来预测这个词语本身,则是 『CBOW 模型』 如果是

T752462536的博客 2299

nlp面试题目集锦

(1)介绍dropout,为什么可以起到防止过拟合的作用 答 : Dropout是什么?为什么Dropout可以防止过拟合? (2). 使用的模型的计算量,Flops (3)共享参数,为什么可以提升效果(起到正则化的作用) (4)LSTM和transformer的各自的优缺点,以及复杂度分析 (5)BN层和LN层的区别,为什么自然语言处理里面用LN层 关于batch normalization和layer normalization的理解 (6)有什么神经网络的语言模型,不用dropout的结果更好(Al

ltochange的博客 1607

推荐收藏!大模型算法工程师面试题来了(附答案)

自 ChatGPT 在去年 11 月底横空出世,大模型的风刮了整一年。历经了百模大战、Llama 2 开源、GPTs 发布等一系列里程碑事件,将大模型技术推至无可争议的 C 位。基于大模型的研究与讨论,也让我们愈发接近这波技术浪潮的核心。最近大模型相关的招聘也非常多,小编整理了一些大模型面试常见问题,供大家参考。希望在找相关机会的同学能有好的收获。大模型面试题更新速度比较快,我们会第一时间在技术群和星球及时更新,向关注的朋友,可以加入我们。

2301_78285120的博客 3094

大模型算法工程师面试题,看这一篇就够了!

春季招聘(简称春招)是诸多互联网领军企业面向在校学生的实习生招募活动,通常在春节假期结束后不久便启动简历接收流程,如阿里巴巴等企业在新年伊始即展开行动;而整个春招周期可能延续至五六月份,像美团等公司在这一阶段仍可能安排面试环节。春招的核心目标在于通过获取在大型互联网企业的实习岗位,从而把握住转为正式员工的机会,或者积累宝贵的实习经验以增强秋季校园招聘时的竞争力。

2401_85375298的博客 1955

NLP与机器学习经典习题

经典的NLP习题整合

DaVenci的博客 1328

NLP面试题总结

NLP面试总结

qq_40812236的博客 1207
上一篇: 在LangChain中初识向量数据库-LLM与向量数据库的惺惺相惜
下一篇: NLP入门+实战必读:一文教会你最常见的10种自然语言处理技术(附代码)
AI程序猿人
博客等级 码龄2年 6517粉丝 561原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值