


自然语言处理(NLP)是一种艺术与科学的结合,旨在从文本数据中提取信息。在它的帮助下,我们从文本中提炼出适用于计算机算法的信息。从自动翻译、文本分类到情绪分析,自然语言处理成为所有数据科学家的必备技能之一。
在这篇文章中,你将学习到最常见的10个NLP任务,以及相关资源和代码。

为什么要写这篇文章?
对于处理NLP问题,我也研究了一段时日。这期间我需要翻阅大量资料,通过研究报告,博客和同类NLP问题的赛事内容学习该领域的最新发展成果,并应对NLP处理时遇到的各类状况。
因此,我决定将这些资源集中起来,打造一个对NLP常见任务提供最新相关资源的一站式解决方案。下方是文章中提到的任务列表及相关资源。那就一起开始吧。
目录:
\1. 词干提取
\2. 词形还原
\3. 词向量化
\4. 词性标注
\5. 命名实体消岐
\6. 命名实体识别
\7. 情感分析
\8. 文本语义相似分析
\9. 语种辨识
\10. 文本总结
1. 词干提取
什么是词干提取?词干提取是将词语去除变化或衍生形式,转换为词干或原型形式的过程。词干提取的目标是将相关词语还原为同样的词干,哪怕词干并非词典的词目。例如,英文中:
1.beautiful和beautifully的词干同为beauti
2.Good,better和best 的词干分别为good,better和best。
相关论文:Martin Porter的波特词干算法原文
相关算法:在Python上可以使用Porter2词干算法(https://tartarus.org/martin/PorterStemmer/def.txt)
程序实现:这里给出了在python的stemming库中使用(https://bitbucket.org/mchaput/stemming/src/5c242aa592a6d4f0e9a0b2e1afdca4fd757b8e8a/stemming/porter2.py?at=default&fileviewer=file-view-default)
Porter2算法做词干提取的代码:
#!pip install stemmingfrom stemming.porter2 import stemstem("casually")
2. 词形还原
什么是词形还原? 词形还原是将一组词语还原为词源或词典的词目形式的过程。还原过程考虑到了POS问题,即词语在句中的语义,词语对相邻语句的语义等。例如,英语中:
1.beautiful和beautifully被分别还原为beautiful和beautifully。
2.good, better和best被分别还原为good, good和good
相关论文1: 这篇文章详细讨论了词形还原的不同方法。想要了解传统词形还原的工作原理必读。(http://www.ijrat.org/downloads/icatest2015/ICATEST-2015127.pdf)
相关论文2: 这篇论文非常出色,讨论了运用深度学习对变化丰富的语种做词形还原时会遇到的问题。(https://academic.oup.com/dsh/article-abstract/doi/10.1093/llc/fqw034/2669790/Lemmatization-for-variation-rich-languages-using)
数据集: 这里是Treebank-3数据集的链接,你可以使用它创建一个自己的词形还原工具。(https://catalog.ldc.upenn.edu/ldc99t42)
程序实现:下面给出了在spacy上的英语词形还原代码
#!pip install spacy
#python -m spacy download en
import spacy
nlp=spacy.load("en")
doc="good better best"
for token in nlp(doc):
    print(token,token.lemma_)
3. 词向量化
什么是词向量化?词向量化是用一组实数构成的向量代表自然语言的叫法。这种技术非常实用,因为电脑无法处理自然语言。词向量化可以捕捉到自然语言和实数间的本质关系。通过词向量化,一个词语或者一段短语可以用一个定维的向量表示,例如向量的长度可以为100。
例如:“Man”这个词语可以用一个五维向量表示。
这里的每个数字代表了词语在某个特定方向上的量级。
相关博文:这篇文章详细解释了词向量化。
(https://www.analyticsvidhya.com/blog/2017/06/word-embeddings-count-word2veec/)
相关论文:这篇论文解释了词向量化的细节。深入理解词向量化必读。
(https://www.analyticsvidhya.com/blog/2017/10/essential-nlp-guide-data-scientists-top-10-nlp-tasks/)
相关工具:这是个基于浏览器的词向量可视化工具。
(https://ronxin.github.io/wevi/)
预训练词向量:这里有一份facebook的预训练词向量列表,包含294种语言。
(https://github.com/facebookresearch/fastText/blob/master/pretrained-vectors.md)
这里可以下载google news的预训练词向量。
(https://drive.google.com/file/d/0B7XkCwpI5KDYNlNUTTlSS21pQmM/edit)
#!pip install gensim
fromgensim.models.keyedvectors import KeyedVectors
word_vectors=KeyedVectors.load_word2vec_format('GoogleNews-vectors-negative300.bin',binary=True)
word_vectors['human']
程序实现:这段代码可以用gensim训练你自己的词向量
sentence=[['first','sentence'],['second','sentence']]
model = gensim.models.Word2Vec(sentence, min_count=1,size=300,workers=4)
4. 词性标注
什么事词性标注?简单来说,词性标注是对句子中的词语标注为名字、动词、形容词、副词等的过程。例如,对句子“Ashok killed the snake with a stick”,词性标注会识别:
Ashok 代词
killed 动词
the 限定词
snake 名词
with 连词
a 限定词
stick 名词
. 标点
论文1:
choi aptly的这篇《The Last Gist to theState-of-the-Art 》介绍了一种叫动态特征归纳的新方法。这是目前词性标注最先进的方法。(https://aclweb.org/anthology/N16-1031.pdf)
论文2:这篇文章介绍了通过隐马尔科夫模型做无监督词性标注学习的方法。(https://transacl.org/ojs/index.php/tacl/article/viewFile/837/192)
程序实现:这段代码可以在spacy上做词性标注
#!pip install spacy
#!python -m spacy download en
nlp=spacy.load('en')
sentence="Ashok killed the snake with a stick"
for token in nlp(sentence):
   print(token,token.pos_)
5. 命名实体消歧
什么是命名实体消岐?命名实体消岐是对句子中的提到的实体识别的过程。例如,对句子“Apple earned a revenue of 200 Billion USD in 2016”,命名实体消岐会推断出句子中的Apple是苹果公司而不是指一种水果。一般来说,命名实体要求有一个实体知识库,能够将句子中提到的实体和知识库联系起来。
论文1:Huang的这篇论文运用了基于深度神经网络和知识库的深层语义关联模型,在命名实体消岐上达到了领先水平。
(https://arxiv.org/pdf/1504.07678.pdf)
论文2:Ganea and Hofmann的这篇文章运用了局部神经关注模型和词向量化,没有人为设置特征。(https://arxiv.org/pdf/1704.04920.pdf)
6. 命名实体识别
体识别是识别一个句子中有特定意义的实体并将其区分为人名,机构名,日期,地名,时间等类别的任务。例如,一个NER会将一个这样的句子:
“Ram of Apple Inc. travelled to Sydney on 5th October 2017”
返回如下的结果:
Ram
of
Apple ORG
Inc. ORG
travelled
to
Sydney GPE
on
5th DATE
October DATE
2017 DATE
这里,ORG代表机构组织名,GPE代表地名。
然而,当NER被用在不同于该NER被训练的数据领域时,即使是最先进的NER也往往表现不佳。
论文:这篇优秀的论文使用双向LSTM(长短期记忆网络)神经网络结合监督学习和非监督学习方法,在4种语言领域实现了命名实体识别的最新成果。(https://arxiv.org/pdf/1603.01360.pdf)
程序实现:以下是如何使用spacy执行命名实体识别。
import spacy
nlp=spacy.load('en')sentence="Ram of Apple Inc. travelled to Sydney on 5th October 2017"
for token in nlp(sentence):
   print(token, token.ent_type_)
7. 情感分析
什么是情感分析?情感分析是一种广泛的主观分析,它使用自然语言处理技术来识别客户评论的语义情感,语句表达的情绪正负面以及通过语音分析或书面文字判断其表达的情感等等。例如:
“我不喜欢巧克力冰淇淋”—是对该冰淇淋的负面评价。
“我并不讨厌巧克力冰激凌”—可以被认为是一种中性的评价。
从使用LSTMs和Word嵌入来计算一个句子中的正负词数开始,有很多方法都可以用来进行情感分析。
博文1:本文重点对电影推文进行情感分析(https://www.analyticsvidhya.com/blog/2016/02/step-step-guide-building-sentiment-analysis-model-graphlab/)
博文2:本文重点对印度金奈洪水期间的推文进行情感分析。(https://www.analyticsvidhya.com/blog/2017/01/sentiment-analysis-of-twitter-posts-on-chennai-floods-using-python/)
论文1:本文采用朴素贝叶斯的监督学习方法对IMDB评论进行分类。(https://arxiv.org/pdf/1305.6143.pdf)
论文2:本文利用LDA的无监督学习方法来识别用户生成评论的观点和情感。本文在解决注释评论短缺的问题上表现突出。(http://www.cs.cmu.edu/~yohanj/research/papers/WSDM11.pdf)
资料库:这是一个很好的包含相关研究论文和各种语言情感分析程序实现的资料库。(https://github.com/xiamx/awesome-sentiment-analysis)
数据集1:多域情感数据集版本2.0(http://www.cs.jhu.edu/~mdredze/datasets/sentiment/)
数据集2:Twitter情感分析数据集(http://www.sananalytics.com/lab/twitter-sentiment/)
竞赛:一个非常好的比赛,你可以检查你的模型在烂番茄电影评论的情感分析任务中的表现。(https://www.kaggle.com/c/sentiment-analysis-on-movie-reviews)
8. 语义文本相似度
什么是语义文本相似度分析?语义文本相似度分析是对两段文本的意义和本质之间的相似度进行分析的过程。注意,相似性与相关性是不同的。
例如:
汽车和公共汽车是相似的,但是汽车和燃料是相关的。
论文1:本文详细介绍了文本相似度测量的不同方法。是一篇可以一站式了解目前所有方法的必读文章。(https://pdfs.semanticscholar.org/5b5c/a878c534aee3882a038ef9e82f46e102131b.pdf)
论文2:本文介绍了用CNN神经网络去比对两个短文本。(http://casa.disi.unitn.it/~moschitt/since2013/2015_SIGIR_Severyn_LearningRankShort.pdf)
论文3:本文利用Tree-LSTMs方法得到了文本的语义相关和语义分类的最新成果。(https://nlp.stanford.edu/pubs/tai-socher-manning-acl2015.pdf)
语言识别
什么是语言识别?语言识别指的是将不同语言的文本区分出来。其利用语言的统计和语法属性来执行此任务。语言识别也可以被认为是文本分类的特殊情况。
博文:在这篇由fastText撰写的博文中介绍了一种新的工具,其可以在1MB的内存使用情况下识别170种语言。(https://fasttext.cc/blog/2017/10/02/blog-post.html)
论文1:本文讨论了285种语言的7种语言识别方法。(http://www.ep.liu.se/ecp/131/021/ecp17131021.pdf)
论文2:本文描述了如何使用深度神经网络来实现自动语言识别的最新成果。(https://repositorio.uam.es/bitstream/handle/10486/666848/automatic_lopez-moreno_ICASSP_2014_ps.pdf?sequence=1)
10. 文本摘要
什么是文本摘要?文本摘要是通过识别文本的重点并使用这些要点创建摘要来缩短文本的过程。文本摘要的目的是在不改变文本含义的前提下最大限度地缩短文本。
论文1:本文描述了基于神经注意模型的抽象语句梗概方法。(https://arxiv.org/pdf/1509.00685.pdf)
论文2:本文描述了使用序列到序列的RNN在文本摘要中达到的最新结果。(https://arxiv.org/pdf/1602.06023.pdf)
资料库:Google Brain团队的这个资料库拥有使用为文本摘要定制的序列到序列模型的代码。该模型在Gigaword数据集上进行训练。(https://github.com/tensorflow/models/tree/master/research/textsum)
应用程序:Reddit的autotldr机器人使用文本摘要来梗概从文章到帖子的各种评论。这个功能在Reddit用户中非常有名。(https://www.reddit.com/r/autotldr/comments/31b9fm/faq_autotldr_bot/)
程序实现:以下是如何用gensim包快速实现文本摘要。
fromgensim.summarization import summarize
sentence="Automatic summarization is the process of shortening a text document with software, in order to create a summary with the major points of the original document. Technologies that can make a coherent summary take into account variables such as length, writing style and syntax.Automatic data summarization is part of machine learning and data mining. The main idea of summarization is to find a subset of data which contains the information of the entire set. Such techniques are widely used in industry today. Search engines are an example; others include summarization of documents, image collections and videos. Document summarization tries to create a representative summary or abstract of the entire document, by finding the most informative sentences, while in image summarization the system finds the most representative and important (i.e. salient) images. For surveillance videos, one might want to extract the important events from the uneventful context.There are two general approaches to automatic summarization: extraction and abstraction. Extractive methods work by selecting a subset of existing words, phrases, or sentences in the original text to form the summary. In contrast, abstractive methods build an internal semantic representation and then use natural language generation techniques to create a summary that is closer to what a human might express. Such a summary might include verbal innovations. Research to date has focused primarily on extractive methods, which are appropriate for image collection summarization and video summarization."
summarize(sentence)
如何学习AI大模型?
作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
这份完整版的大模型 AI 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】

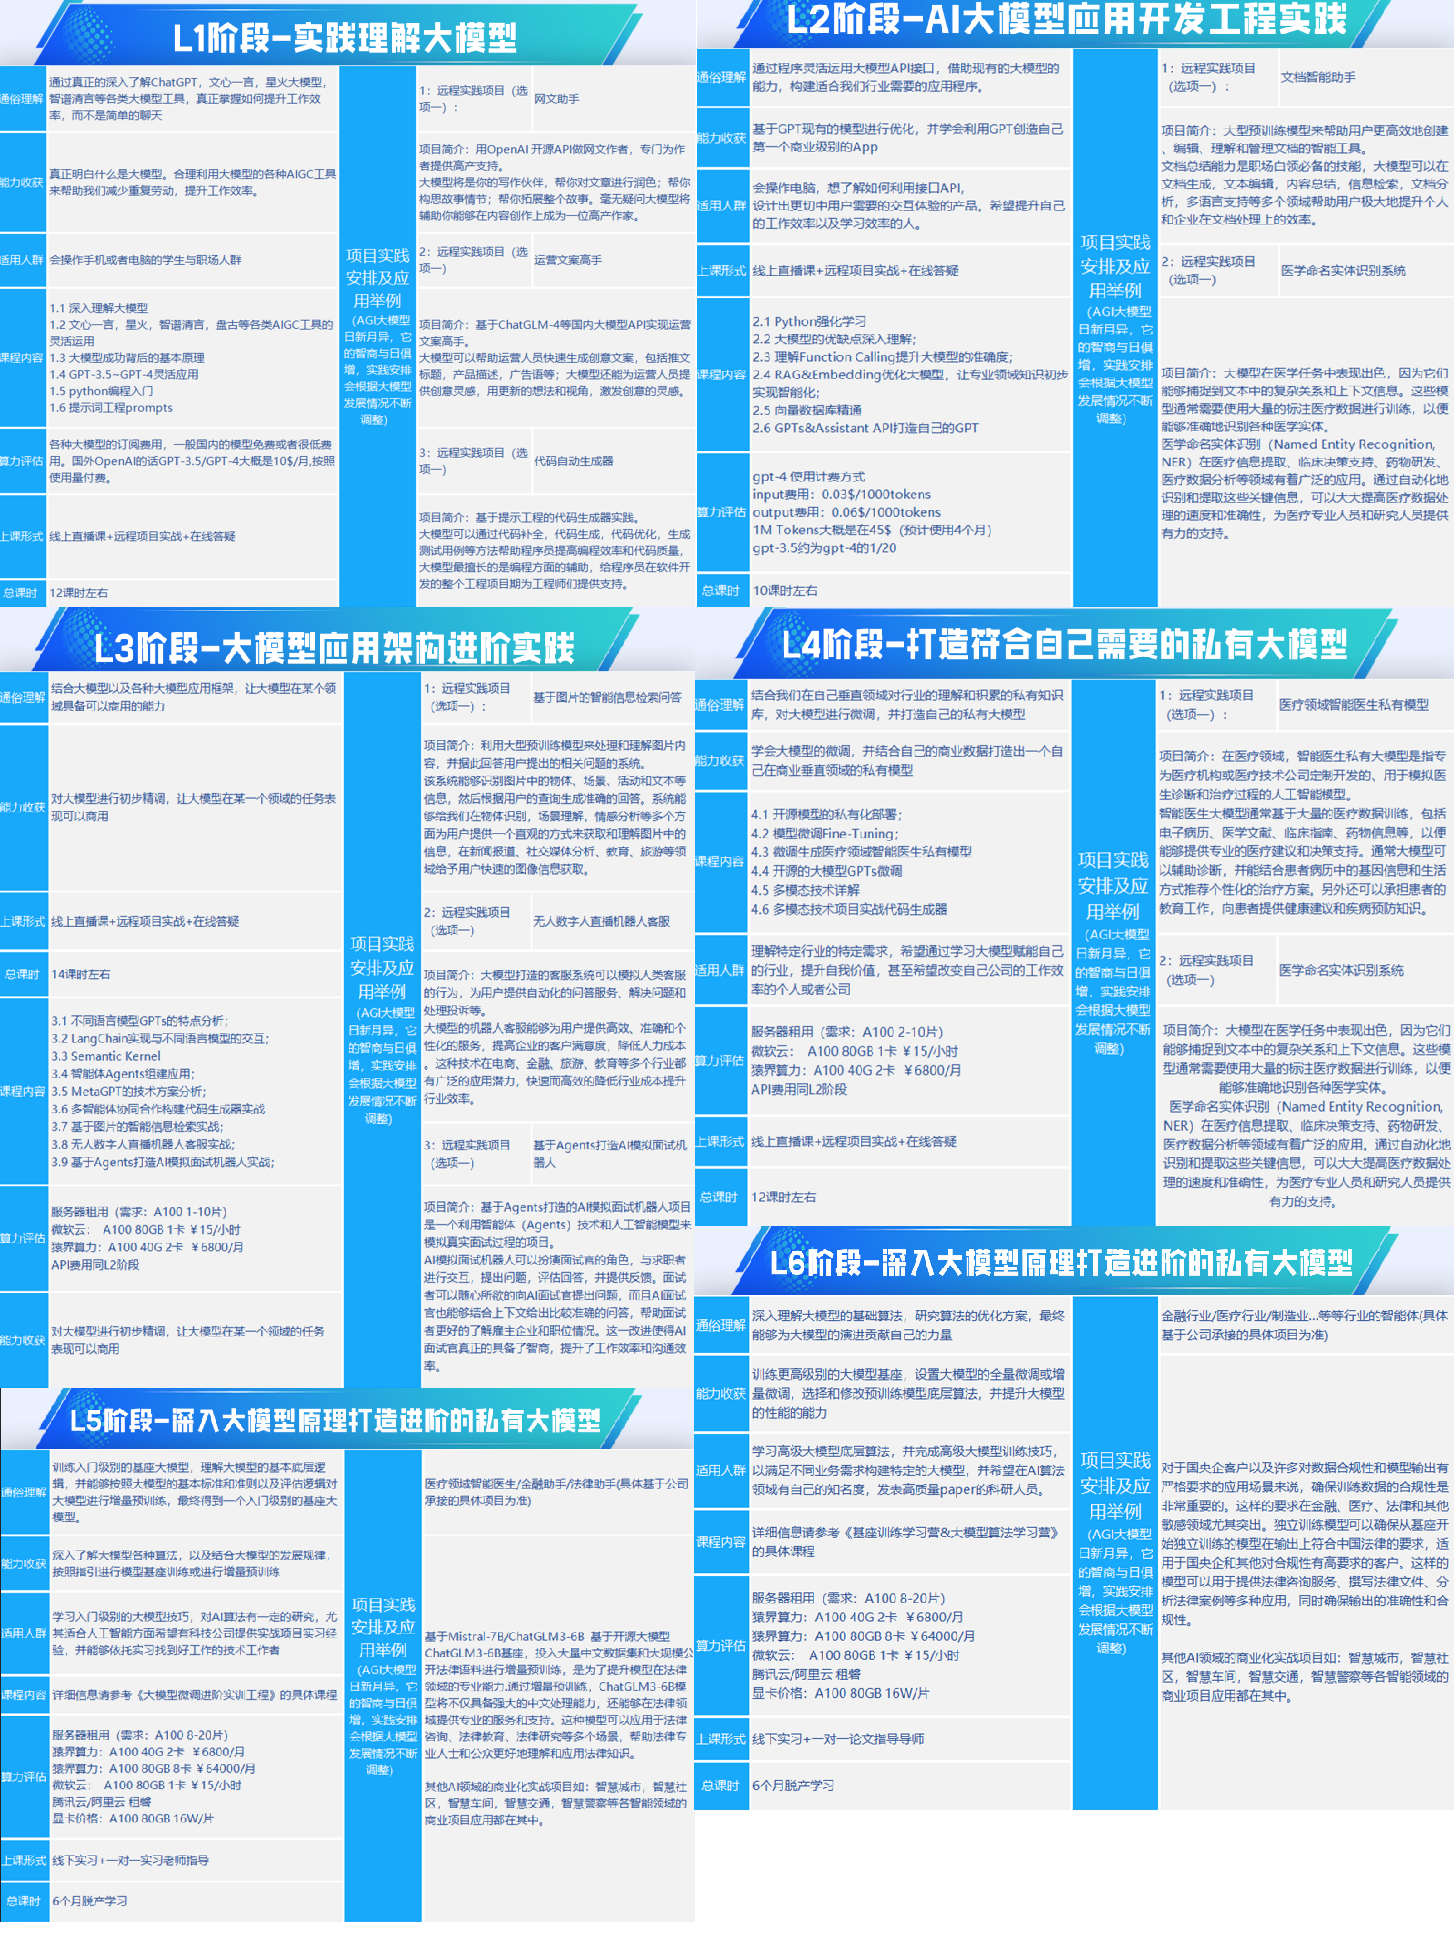
一、全套AGI大模型学习路线
AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!
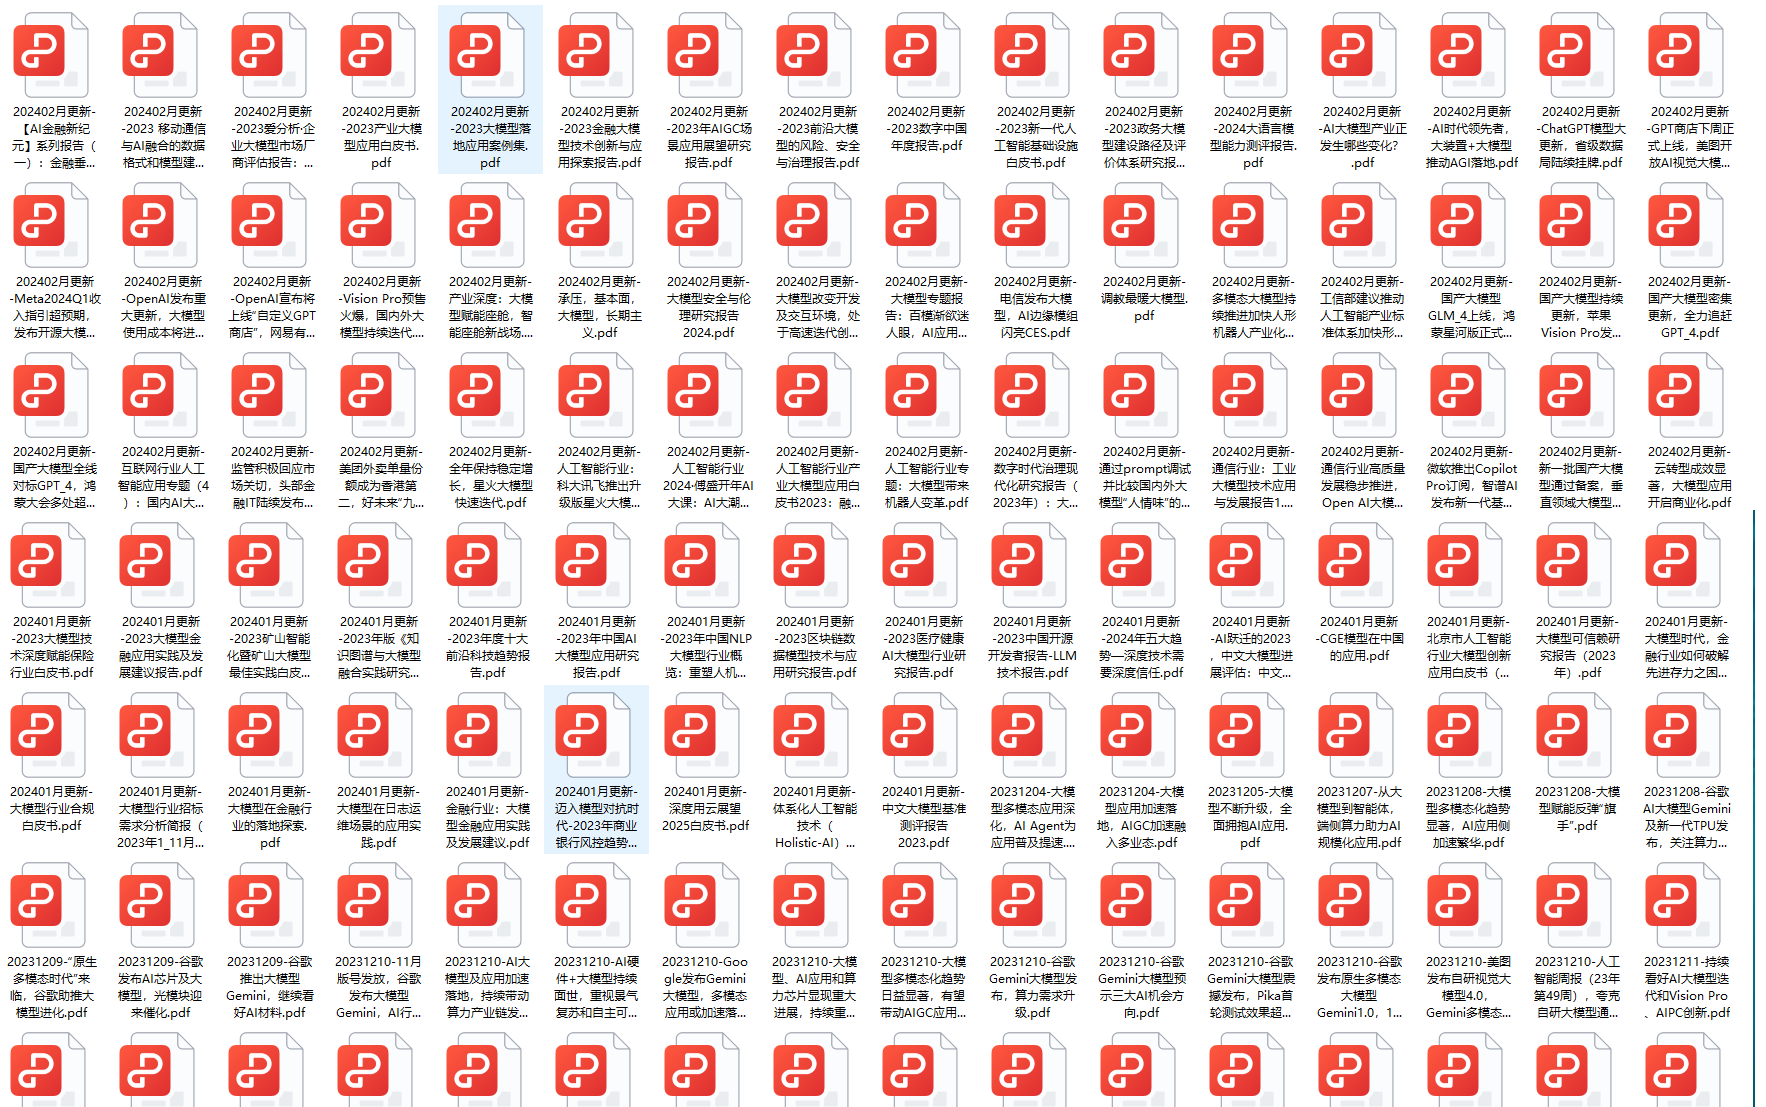
二、640套AI大模型报告合集
这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。
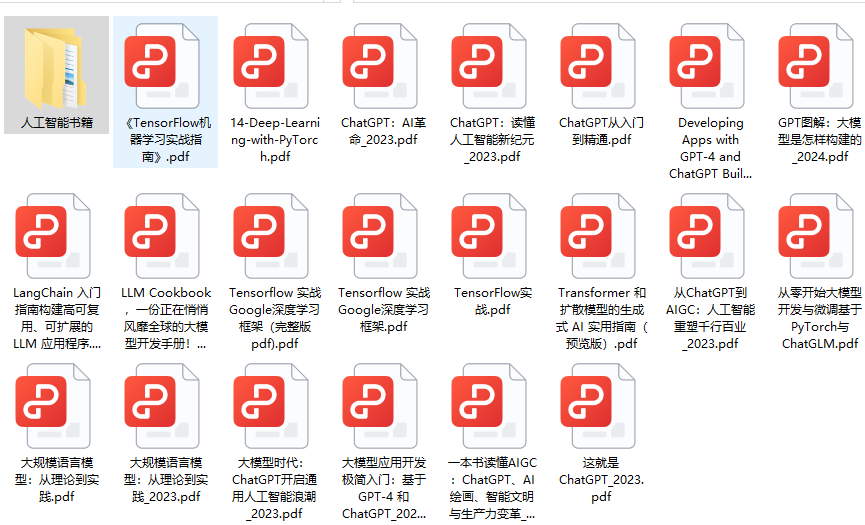
三、AI大模型经典PDF籍
随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。
四、AI大模型商业化落地方案

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。
 4093


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


