实战 Transformers 模型微调之数据集处理库 Hugging Face Datasets

Hugging face Transformers(5)—— Datasets datasets 是一个简单易用的数据集加载库,可方便地从本地或 HF hub 加载数据集,并完成数据划分、清洗、数据集和加载器构造等工作 阅读详情

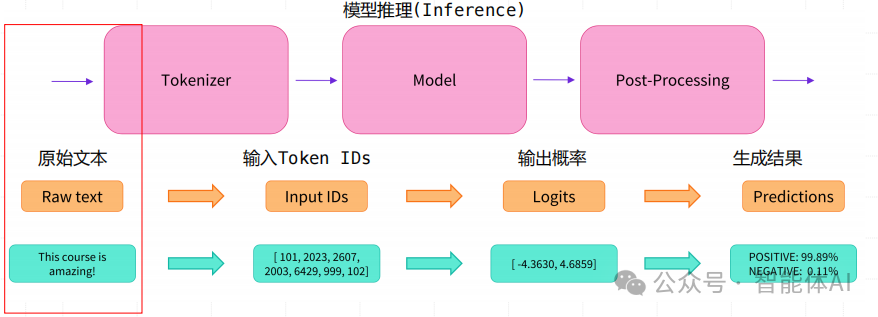
在深度学习中,数据处理是模型训练的关键环节之一。Hugging Face Datasets 库提供了一套强大的工具来简化这一过程,使数据集的管理和预处理变得高效且直观。本文将详细介绍 Hugging Face Datasets 库的基本用法和数据预处理策略,并结合实际代码示例,帮助您掌握这一工具的使用方法。
图片

一、Hugging Face Datasets 库简介

1. Hugging Face Datasets 库是什么?

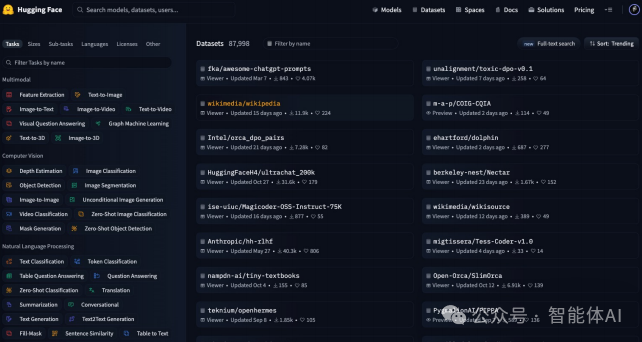
Hugging Face Datasets 是一个开源 Python 库,旨在简化自然语言处理(NLP)、计算机视觉(CV)和音频任务的数据集处理。通过这个库,您可以轻松加载、处理和共享数据集,仅需一行代码即可完成大部分数据集的加载工作。它与 Hugging Face Hub 深度集成,使得数据集的管理和共享变得更加便捷。
图片

2. 使用 Datasets 下载开源数据集

通过 datasets 库,您可以轻松下载和加载各种开源数据集。以下是一个示例,演示如何下载并加载 GLUE 数据集中的 MRPC 任务:
在这里插入图片描述

在上述代码中,我们使用 load_dataset 函数加载了 GLUE 数据集的 MRPC 任务。这个函数会自动从 Hugging Face Hub 下载数据集并进行基本的预处理。

3. Datasets.load_dataset 实现原理简介
图片

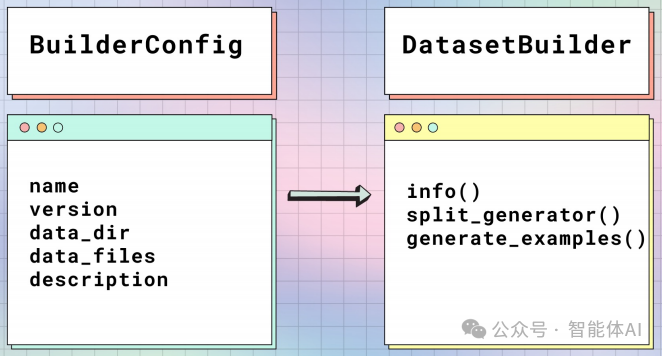
datasets.load_dataset() 函数背后使用了 DatasetBuilder 类,该类负责数据集的下载和构建。该函数首先检查本地缓存是否存在数据集,如果缓存中没有,则从 Hugging Face Hub 下载数据。然后,DatasetBuilder 类将数据集加载到内存中,并进行初步的处理。

4. 构造 DatasetBuilder 类的主要配置 BuilderConfig

在构造自定义数据集时,DatasetBuilder 类使用 BuilderConfig 类来配置数据集的各种属性。例如,您可以指定数据集的类别标签或其他属性。以下是如何创建自定义配置的示例:

from datasets import DatasetBuilder, BuilderConfig

class CustomDatasetBuilder(DatasetBuilder):
    BUILDER_CONFIGS = [     
        BuilderConfig(name="custom_config", description="A custom dataset configuration")    
    ]    
    
    def _info(self):    
        return DatasetInfo(     
            description="Custom dataset",            
            features=Features({          
                "text": Value(dtype="string"),                
                "label": ClassLabel(names=["negative", "positive"])            
            })        
        )    
        
    def _split_generators(self, dl_manager):   
        # 实现数据下载和划分的逻辑        
        pass    
      
    def _generate_examples(self, filepath):   
        # 实现数据生成的逻辑        
        pass

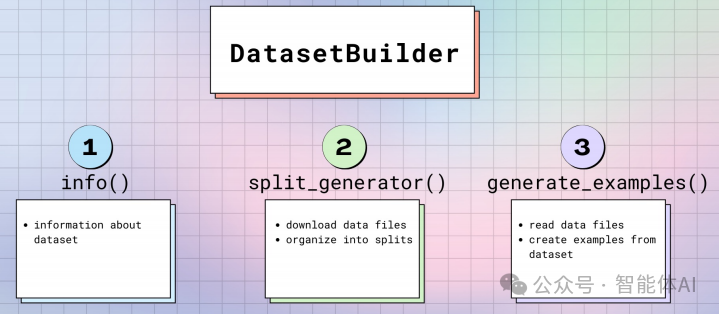
在这个示例中,我们定义了一个名为 CustomDatasetBuilder 的数据集构建器,并指定了一个自定义的 BuilderConfig。_info 方法定义了数据集的基本信息,包括数据特征和标签。

5. 实际构造数据集的类 DatasetBuilder
图片

DatasetBuilder 类是数据集构建的核心,通过继承和实现其中的方法,我们可以创建自定义的数据集。例如,您可以实现数据的下载、处理和生成逻辑:

from datasets import DatasetBuilder

class MyDatasetBuilder(DatasetBuilder):
    def _split_generators(self, dl_manager):     
        # 下载数据集并返回数据划分        
        return [    
            SplitGenerator(name="train", gen_kwargs={"filepath": "path/to/train_data"}),            
            SplitGenerator(name="test", gen_kwargs={"filepath": "path/to/test_data"})        
        ]    
        
    def _generate_examples(self, filepath):   
        # 从文件中读取数据并生成示例        
        with open(filepath, "r") as file:      
            for id_, line in enumerate(file):           
                yield id_, {"text": line.strip(), "label": 1}  # 示例标签

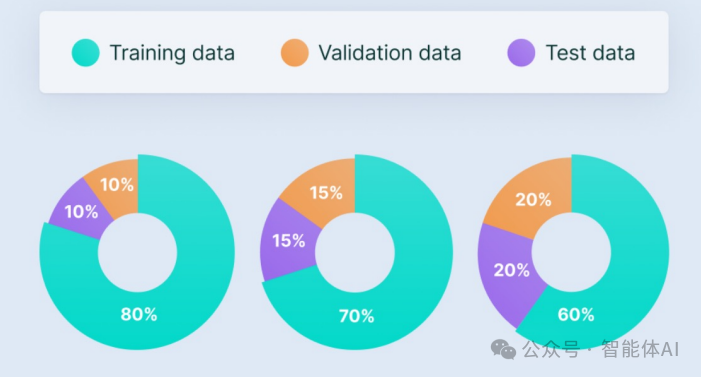
6. Datasets 帮助构建不同用途的数据集
图片

使用 Hugging Face Datasets 库,您可以轻松创建训练集、验证集和测试集。只需在数据集构建器中定义不同的数据划分,即可实现这一目标:

dataset = load_dataset('glue', 'mrpc', split='train')  # 加载训练集

二、数据预处理策略:填充与截断

在处理数据时,填充(Padding)和截断(Truncation)是两种常见的预处理策略。这些策略确保模型输入的数据符合要求,并提高训练效率。

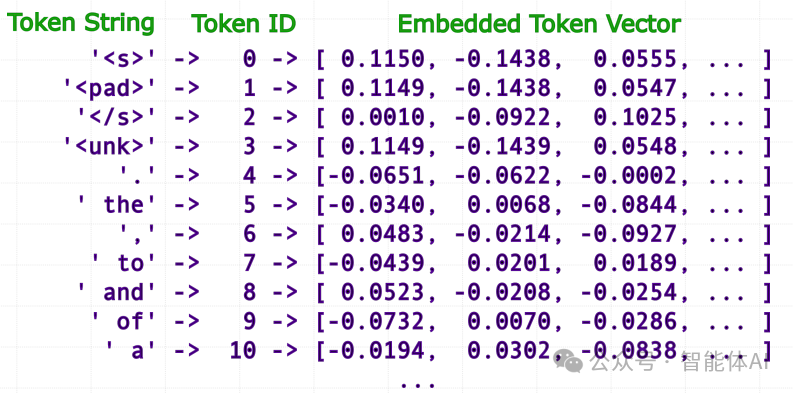
1. 数据预处理策略:填充(Padding)
图片

填充是将序列扩展到固定长度,以便于批处理。以下是使用 Hugging Face Datasets 库进行填充的示例:

from transformers import AutoTokenizer

tokenizer = AutoTokenizer.from_pretrained("bert-base-uncased")

def preprocess_function(examples):
    return tokenizer(examples['text'], padding='max_length', truncation=True, max_length=128)

dataset = load_dataset('glue', 'mrpc')   
dataset = dataset.map(preprocess_function, batched=True)

在这个示例中,我们使用 AutoTokenizer 对数据进行填充,将所有输入序列扩展到最大长度 128。

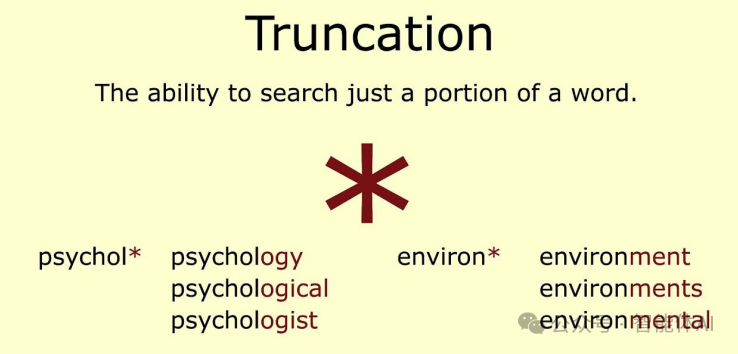
2. 数据预处理策略:截断(Truncation)
图片

截断是将超出最大长度的数据裁剪掉,以避免模型处理过长的输入数据:

def preprocess_function(examples):
    return tokenizer(examples['text'], padding='max_length', truncation=True, max_length=128)

dataset = load_dataset('glue', 'mrpc')
dataset = dataset.map(preprocess_function, batched=True)

在上述代码中,truncation=True 参数确保了输入序列被截断到最大长度 128。

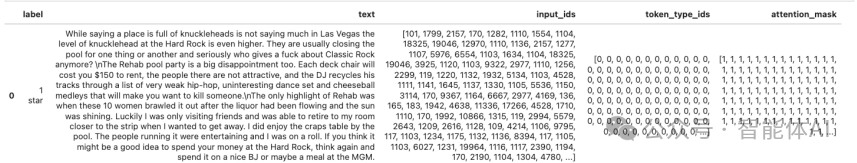
三、使用 Datasets.map 方法处理数据集
图片

datasets.map 方法允许我们对数据集进行批量处理。通过将自定义的预处理函数应用于数据集,可以实现高效的数据处理和转换:

def preprocess_function(examples):
    return tokenizer(examples['text'], padding='max_length', truncation=True, max_length=128)

# 使用 map 方法应用预处理函数
processed_dataset = dataset.map(preprocess_function, batched=True)

# 打印处理后的数据集样本
print(processed_dataset)

在这个示例中,datasets.map 方法将 preprocess_function 应用到整个数据集,从而实现批量的填充和截断。

四、总结

Hugging Face Datasets 库提供了强大的数据集管理和处理功能,使得数据的准备和处理变得更加高效。通过掌握库的基本用法和数据预处理策略,您可以更好地为 Transformers 模型的微调做好数据准备。希望本文能帮助您更好地理解和使用 Hugging Face Datasets 库,提高模型训练的效果。

​

如何学习AI大模型?

作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习还有100套面试题等录播视频免费分享出来。

这份完整版的大模型 AI 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】
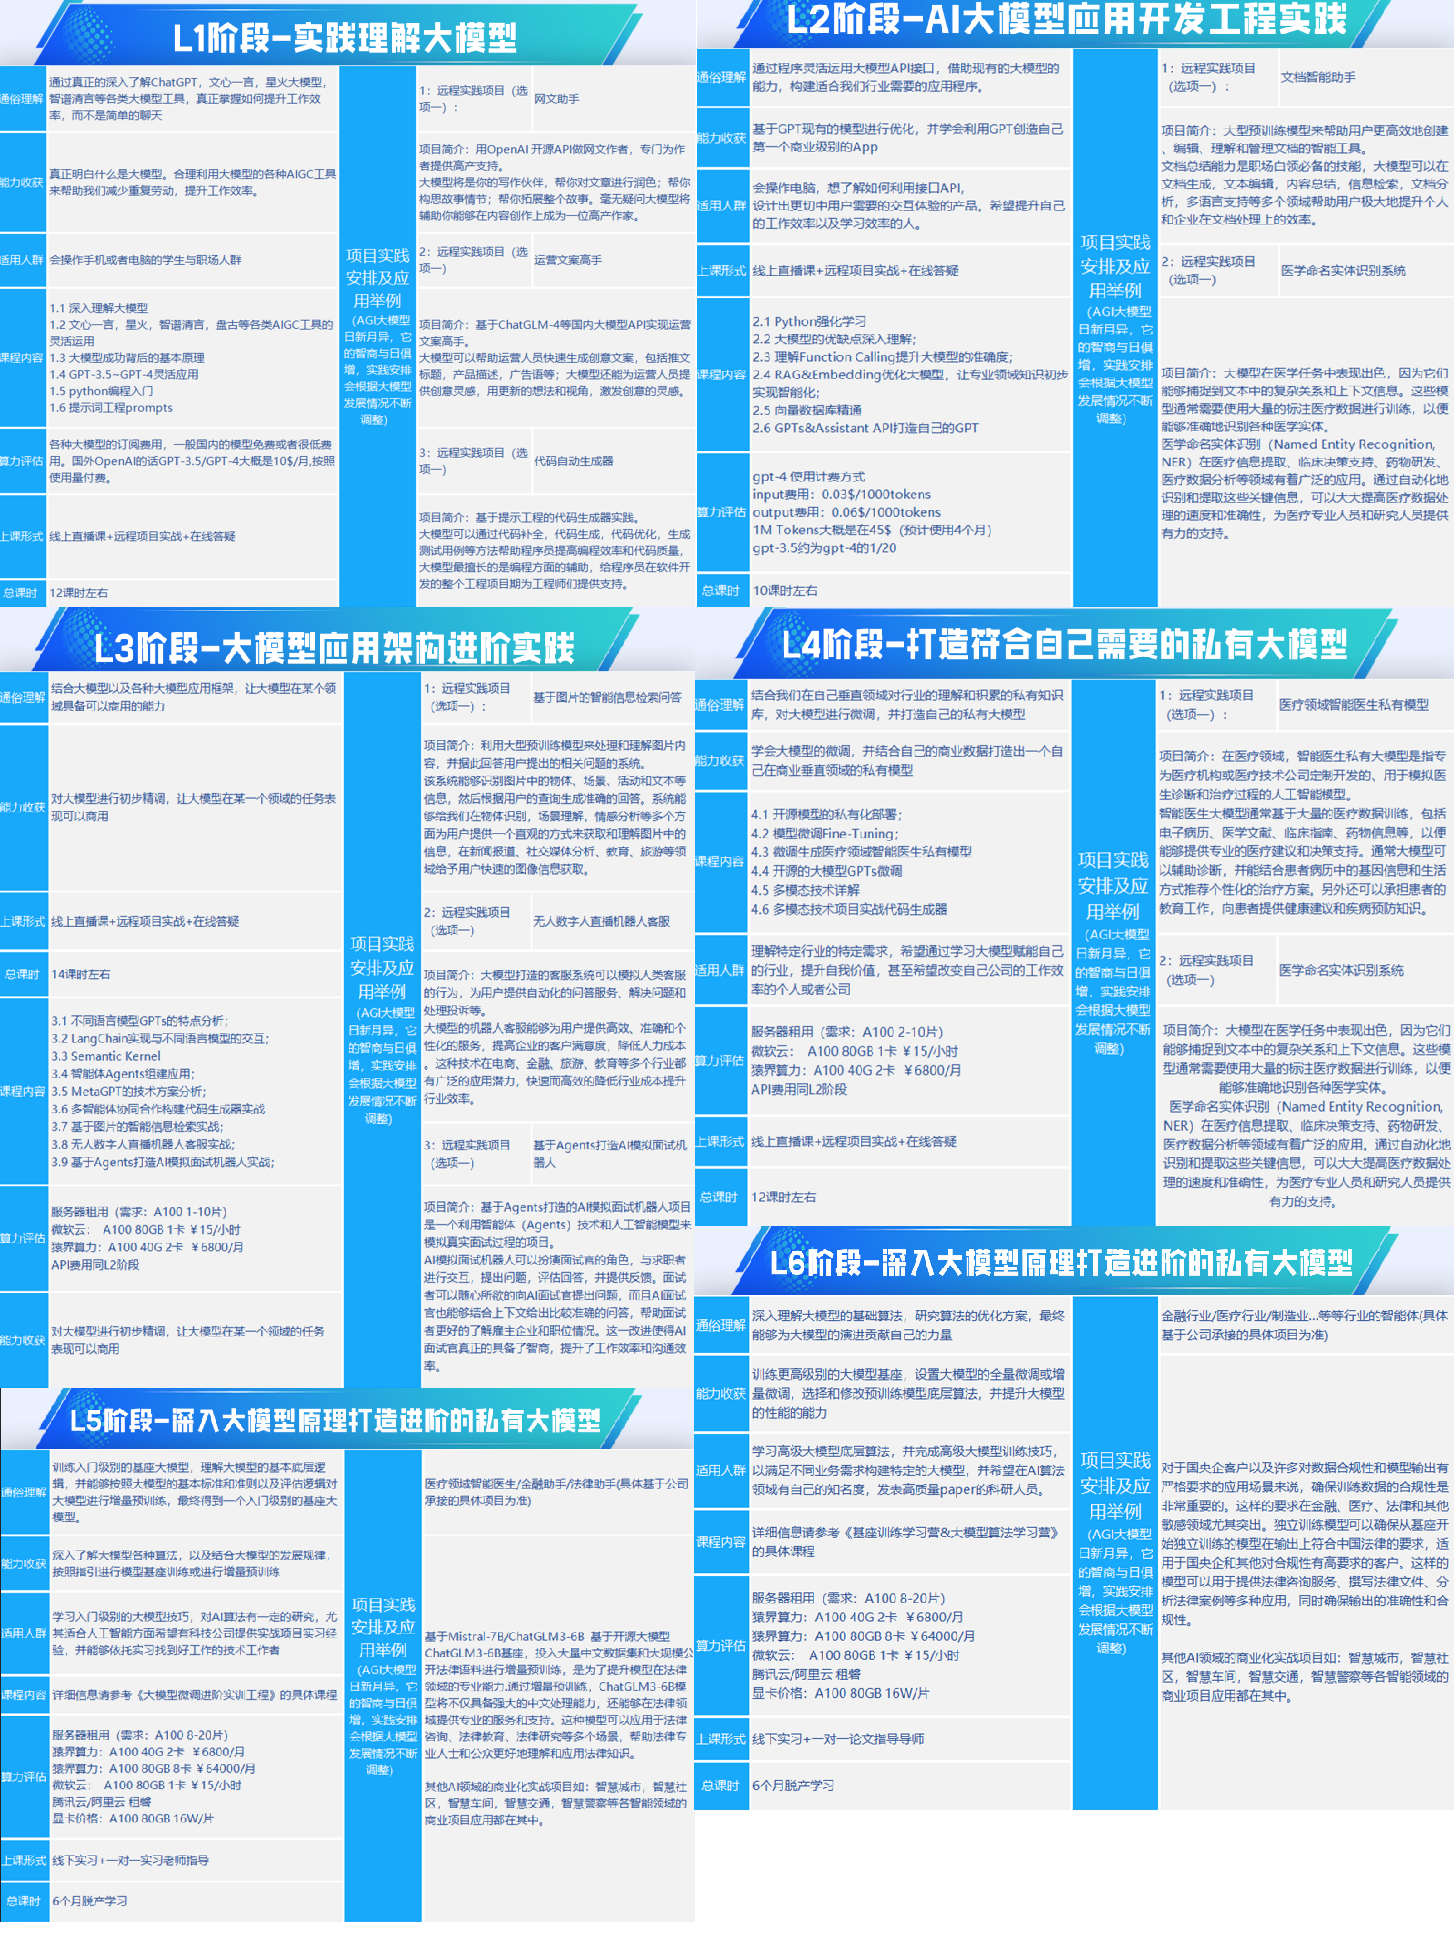
一、全套AGI大模型学习路线

AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!
img

二、640套AI大模型报告合集

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。
img

三、AI大模型经典PDF籍

随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。
img

四、AI大模型商业化落地方案

img

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。

【HuggingFace文档学习】datasets库加载数据 我只需要记住几行模板,而后便能轻松加载各类模型和数据,不会将大把时间浪费在查看浩如烟海的API或者接口文档上。:这是最常见的使用方式,只需要提供数据集的名称即可,在能正常访问huggingface的情况下简单易行。库是Hugging Face平台的,用于轻松访问和共享用于音频、计算机视觉和自然语言处理任务的数据集的库。然而学校的服务器因某种原因,不能在代码中远程访问huggingface,因而整个程序便会卡在这行代码。它们将各式各样的模型和数据,在格式上和加载方式上实现了规范统一。最终得以过了这一关。 阅读详情

相关推荐

Hugging Face生态实战指南:从环境搭建到模型微调与部署

在深度学习与自然语言处理领域,预训练模型已成为推动技术发展的核心驱动力。其原理在于通过大规模无监督学习,让模型从海量文本中学习通用语言表示,从而为下游任务提供强大的语义理解基础。这一技术价值在于显著降低了AI应用的门槛,使开发者无需从零开始训练模型,即可在文本分类、情感分析、问答系统等多种场景中快速构建高性能解决方案。Hugging Face生态通过提供标准化的工具链,如Transformers和Datasets库,进一步简化了模型加载、数据处理和微调流程。本文聚焦于如何高效利用这一生态,涵盖环境配置、核心

weixin_29092031的博客 373

NLP(六十二)HuggingFace中的Datasets使用

本文可作为dataset库的入门,详细介绍了数据集的各种操作,这样方便后续进行模型训练。

山阴少年 1万+

微调Whisper模型实现中文方言识别:从原理到部署实战

语音识别(ASR)技术通过将语音信号转换为文本,其核心原理涉及声学建模、语言建模和解码搜索。这项技术的价值在于打破人机交互的语音壁垒,广泛应用于智能助手、实时字幕和语音搜索等场景。针对特定领域或方言识别准确率不足的问题,模型微调成为关键解决方案。本文聚焦于使用Transformer架构的Whisper模型,通过微调技术提升其对中文方言(如潮州话)的识别能力。实践环节详细介绍了从数据准备、模型训练到服务部署的全流程,特别关注了显存优化和性能评估,为低资源语音识别和文化遗产数字化提供了可行的工程路径。

weixin_30721077的博客 496

Hugging Face-Datasets库

datasets是 Hugging Face 提供的一个轻量级数据处理库,专为自然语言处理任务设计,能够高效地支持模型训练流程中的数据加载与预处理操作。加载方便:支持读取本地文件(如 CSV、JSON),也支持加载在线公开数据集;结构清晰:数据集的内部结构类似表格,每条样本由若干字段组成;无缝协作:与 tokenizer 等 Hugging Face 模块高度集成,可直接构造模型输入;功能丰富。

JZ171717的博客 1819

基于LoRA微调Whisper实现中文方言语音识别:低成本实战指南

语音识别作为人工智能的重要分支,其核心是将音频信号转化为文本。传统模型在通用场景表现良好,但面对中文方言时,由于训练数据偏差,识别准确率显著下降。参数高效微调技术通过冻结预训练模型大部分参数、仅训练少量新增模块,实现了在有限计算资源下对特定任务的快速适配。这一技术大幅降低了领域适应的门槛,使消费级GPU也能完成专业模型定制。在方言保护、区域化智能服务等场景中,基于LoRA对Whisper模型进行微调,成为解决方言识别难题的高性价比方案。通过构建高质量方言数据集并优化训练流程,开发者可快速获得针对潮州话、粤语

weixin_34198762的博客 404

ESCUCHA基准:提升西班牙语语音模型在真实声学环境下的鲁棒性

语音鲁棒性是语音技术领域的核心挑战,指模型在复杂声学条件下保持性能稳定的能力。其原理在于通过数据增强和模型优化,使系统能够抵抗噪声、混响等干扰。这一技术对于实现可靠的自动语音识别和语音情感识别至关重要,尤其在嘈杂街道、回声房间等真实场景中。ESCUCHA基准作为西班牙语语音处理的评估标准,专门针对异构声学条件设计,通过系统化的扰动库和评估协议,帮助开发者全面测试和提升语音模型的鲁棒性。

weixin_34239169的博客 396

Transformers模型微调

若果想向数据集添加额外的属性,例如标签。

cancer_s的博客 631

Hugging Face快速入门(重点讲解模型(Transformers)和数据集部分(Datasets))

1. Hugging Face是什么,提供了哪些内容 2. Hugging Face模型的使用(Transformer类库) 3. Hugging Face数据集的使用(Datasets类库)

iioSnail的博客 8万+

10分钟跑通音频分类:环境音识别完整指南

门铃视频里识别狗吠声、工厂产线上预警设备异响,这类环境音识别项目里最耗时的往往不是采集音频,而是把预处理、训练、评估、部署整条流水线串起来。Transformers 是覆盖文本、视觉、音频的开源模型框架,它的 `AutoModelForAudioClassification` 能把 Wav2Vec2 这类自监督预训练模型(先在海量大段无标注音频上自学声学特征,再用少量标签微调)直接落到你的录音上,

gitblog_00163的博客 1006

7.数据集处理库Hugging Face Datasets

只需一行代码便可以访问数十种不同领域(自然语言处理、计算机视觉、强化学习等)的评估方法。Evaluate 库 是一个用于轻松评估机器学习模型和数据集的 Python 库。构造 DatasetBuilder 类的主要配置 BuilderConfig。Datasets.load_dataset 实现原理简介。使用 datasets.map 方法全量应用预处理策略。实际构造数据集的类 DatasetBuilder。Datasets 帮助构建不同用途的数据集。使用 Datasets 下载开源数据集。

YPeng_Gao的博客 841

ArcFace vs 传统算法:实测MTCNN+ArcFace在PyCharm中的识别准确率(含完整对比数据)

本文通过PyCharm开发环境实测MTCNN+ArcFace组合在人脸识别中的性能表现,并与传统算法进行多维度对比。实验数据显示,ArcFace在LFW数据集上达到99.83%的准确率,显著优于传统方法。文章还提供了完整的代码实现和工程优化建议,为开发者提供实用的技术参考。

醉三国 230

Sapiens2-Pose-1B进阶应用:结合开源数据集训练自定义姿态估计模型

Sapiens2-Pose-1B是一款强大的开源姿态估计模型,能够精准检测人体308个关键点,包括详细的面部(274个关键点)、手部和足部关键点,预测结果遵循Sociopticon关键点格式。本文将详细介绍如何结合开源数据集训练自定义姿态估计模型,帮助开发者快速掌握模型的进阶应用技巧。 ## 一、模型核心功能与优势 Sapiens2-Pose-1B采用先进的深度学习架构,在config.jso

gitblog_00784的博客 438

kubeadm init 运行时kebelet启动失败问题

解决k8s kubeadm init时遇到的kubelet问题

ZDPZN的博客 6068

Orca大模型安装实战:从环境配置到训练部署全流程解析

大语言模型(LLM)的微调技术是当前人工智能领域的热点,其核心在于通过知识蒸馏等方法,让小规模模型学习大规模模型的推理能力。这一过程涉及深度学习环境配置、模型训练优化等关键技术环节。PyTorch作为主流框架,其与CUDA版本的兼容性是GPU加速的基础。在实际应用中,环境隔离与版本管理是保障项目稳定运行的前提。本文以Orca模型的安装部署为例,详细解析了从虚拟环境搭建、依赖库安装到训练任务启动的全流程,涵盖了PyTorch环境配置、CUDA驱动适配等常见痛点,并提供了针对显存优化、依赖冲突等实际问题的解决方

weixin_34074740的博客 324

告别黑窗口:XShell+X11转发图形化界面的5分钟保姆级教程(附Xming配置)

本文详细介绍了如何使用XShell和X11转发技术快速实现Linux图形化界面的远程访问。通过5分钟快速配置指南,包括服务端设置、客户端工具选择及XShell+Xming的完美配置,帮助用户高效运行GUI应用程序,提升远程工作效率。特别适合需要图形化操作的开发者和运维人员。

weixin_29223603的博客 320

自适应粒子群优化(Adaptive Particle Swarm Optimization,APSO

下面是一个关于自适应粒子群优化(Adaptive Particle Swarm Optimization,APSO)的博客,希望可以帮助您。提示:以下是本篇文章正文内容,下面案例可供参考在上面的代码中,表示粒子的数量,表示解空间的维度,表示迭代次数,表示优化的目标函数。在__init__方法中,我们初始化了粒子群的位置和速度,并将每个粒子的位置作为其最优解,将其适应度值初始化为正无穷。我们还初始化了学习因子和惯性权重的参数。在run方法中,我们迭代了次,计算每个粒子的适应度值和最优解。

weixin_52026057的博客 9908

环境音识别入门:用 Transformers 两步跑通声音分类

这篇教程写给没有音频背景的 Python 开发者,带你走通环境音识别的一条完整链路:先用 pipeline 做推理,再改几个参数完成 wav2vec2 训练,最后按场景选参数。 ## 选型:对比 3 种声音分类路线 🧭 先说结论:用自监督预训练模型加 Transformers 的音频分类工具链,是覆盖智能家居、安防、医疗、工业监测多数场景的最省事路线。环境音识别(环境音分类、声音事件分类)是

gitblog_00694的博客 484

【RViz2】导入urdf模型时报错:Could not load resource xxx,Unable to open file xxx,Error retrieving file xxx

初学ROS2,想要在RViz2中显示urdf模型。其中.urdf文件引用了外部的meshes文件夹。

qq_43557907的博客 9480

Flux 3音频生成实战:从扩散模型原理到AI音乐创作全流程

扩散模型作为生成式AI的核心技术,通过加噪和去噪过程学习数据分布,在图像和音频生成领域展现出强大潜力。其技术价值在于能够从文本描述直接生成高质量多媒体内容,大幅降低创作门槛。在音频处理中,模型通常先将波形信号转换为频谱图这一二维表示,既保留时序频域特征又降低计算复杂度。结合声码器技术,可实现从文本到高保真音频的端到端生成。Stability AI推出的Flux 3作为先进扩散模型,在音频生成领域实现重大突破,能够根据复杂文本提示生成具有丰富细节的自然音频。本文基于音频生成和扩散模型等热词,深入解析Flux

weixin_33868027的博客 352

STM32H743必要外围电路分析

写在前面:这篇博客是我第一次绘制STM32最小系统板的过程记录。 2020-1-11 BOOT STM32采用ARM内核,和ARM处理器一样,都有专门的boot脚决定单片机从何处启动。 在官方数据手册的第105页,我们可以看到 系统复位后,在SYSTICK的第四个上升沿锁存BOOT引脚的值,复位后,BOOT引脚可以由用户自由配置而不会影响系统正常运行。 BOOT引脚决定了自举存储器地址,当BO...

Cui_Hongwei的博客 1万+

华为路由器 VRRP主备配置

3、R3 出口路由器。

一直被模仿,从未被超越 5580

基于微调策略的声音模仿查询系统:从原理到工程实践

音频检索是多媒体信息处理中的关键技术,旨在从海量音频库中快速定位目标声音。其核心原理在于将音频信号转换为可计算的特征表示,并通过相似度匹配实现检索。传统方法依赖文本标签,但难以描述声音的复杂纹理与情感。通过微调(Finetuning)预训练音频模型,可以使其适应特定任务,例如跨越人声模仿与真实环境声之间的语义鸿沟,实现更精准的查询。这项技术在声音模仿查询(Querying Sounds by Vocal Imitation)场景中价值显著,它允许用户通过哼唱或拟声词直接搜索,极大地提升了交互自然性与检索效率

weixin_30727835的博客 435

Android 15.0 系统开机屏幕设置默认横屏显示

在15.0的系统ROM产品定制化开发中,对于产品需求来说,由于是宽屏设备所以产品需要开机默认横屏显示,开机横屏显示这就需要从 两部分来实现,一部分是系统开机动画横屏显示,另一部分是系统屏幕显示横屏显示,从这两方面就可以做到开机默认横屏显示了

安卓兼职framework和app工程师的博客 710

仓颉编程语言字符类型(Rune)详解:字面量、转义与类型转换实战

字符是文本处理的基本单元。在仓颉(Cangjie)编程语言中,字符类型使用 `Rune` 表示,能够覆盖 Unicode 字符集中的全部字符,为多语言文本处理提供了统一的数据基础。本文将以官方开发者文档为基础,系统讲解 `Rune` 的三种字面量写法、可用的关系运算,以及它与整数类型之间的转换规则,并结合仓颉文档仓库中的相关章节与配套示例,帮助你彻底掌握字符类型的使用方法。 ## 字符类型概述:

gitblog_00657的博客 381

Data-Structures-and-Algorithm-Analysis-in-Java.pdf

作者: Weiss, Mark A. 出版社: Addison Wesley Data Structures and Algorithm Analysis in Java is an “advanced algorithms” book that fits between traditional CS2 and Algorithms Analysis courses. In the old ACM Curriculum Guidelines, this course was known as CS7. This text is for readers who want to learn good programming and algorithm analysis skills simultaneously so that they can develop such programs with the maximum amo...

IMSL CNL 7.0.0 (x86-64)Crack

IMSL CNL 7.0.0 (x86-64)Crack intel的算法库破解文件,这是C++版本的破解文件

AI音乐检测实战:从原理到部署,基于Treblo开源项目的完整指南

音频分类是机器学习领域的重要分支,其核心原理是通过深度学习模型学习音频信号的特征表示,从而实现对音频内容的识别与归类。在技术价值上,它使得机器能够理解并处理复杂的音频信息,为语音识别、音乐信息检索和内容安全等应用奠定了基础。随着AI生成技术的飞速发展,AI生成音乐的质量已逼近人类创作水平,这使得AI音乐检测技术变得至关重要。其典型应用场景包括音乐流媒体平台的内容审核、版权管理公司的原创性验证,以及音频研究领域的数据标注。本文以Treblo开源AI音乐检测器为例,深入探讨了如何利用预训练Transformer

weixin_33834137的博客 300

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

CSM 1B与传统TTS的对比:为什么它是下一代对话式语音的首选

CSM 1B(Conversational Speech Model)是由Sesame公司开发的革命性对话式语音合成模型,它彻底改变了传统TTS(文本转语音)系统的局限,为用户带来更自然、更流畅的语音交互体验。作为基于Llama架构的创新模型,CSM 1B不仅能生成高质量语音,还能理解对话上下文,实现真正意义上的交互式语音交流。 ## 传统TTS的瓶颈:为什么对话体验总是"不自然"? 传统TT

gitblog_00835的博客 307

深度学习工具包 DeepLearningToolbox

深度学习工具包Deprecation notice.-----This toolbox is outdated and no longer maintained.There are much better tools available for deep learning than this toolbox, e.g. [Theano](http://deeplearning.net/software/theano/), [torch](http://torch.ch/) or [tensorflow](http://www.tensorflow.org/)I would suggest you use one of the tools mentioned above rather than use this toolbox.Best, Rasmus.DeepLearnToolbox================A Matlab toolbox for Deep Learning.Deep Learning is a new subfield of machine learning that focuses on learning deep hierarchical models of data.It is inspired by the human brain's apparent deep (layered, hierarchical) architecture.A good overview of the theory of Deep Learning theory is[Learning Deep Architectures for AI](http://www.iro.umontreal.ca/~bengioy/papers/ftml_book.pdf)For a more informal introduction, see the following videos by Geoffrey Hinton and Andrew Ng.* [The Next Generation of Neural Networks](http://www.youtube.com/watch?v=AyzOUbkUf3M) (Hinton, 2007)* [Recent Developments in Deep Learning](http://www.youtube.com/watch?v=VdIURAu1-aU) (Hinton, 2010)* [Unsupervised Feature Learning and Deep Learning](http://www.youtube.com/watch?v=ZmNOAtZIgIk) (Ng, 2011)If you use this toolbox in your research please cite [Prediction as a candidate for learning deep hierarchical models of data](http://www2.imm.dtu.dk/pubdb/views/publication_details.php?id=6284)```@MASTERSTHESIS\{IMM2012-06284, author = "R. B. Palm", title = "Prediction as a candidate for learning deep hierarchical models of data", year = "2012",}```Contact: rasmusbergpalm at gmail dot comDirectories included in the toolbox-----------------------------------`NN/` - A library for Feedforward Backpropagation Neural Networks`CNN/` - A library for Convolutional Neural Networks`DBN/` - A library for Deep Belief Networks`SAE/` - A library for Stacked Auto-Encoders`CAE/` - A library for Convolutional Auto-Encoders`util/` - Utility functions used by the libraries`data/` - Data used by the examples`tests/` - unit tests to verify toolbox is workingFor references on each library check REFS.mdSetup-----1. Download.2. addpath(genpath('DeepLearnToolbox'));Example: Deep Belief Network---------------------```matlabfunction test_example_DBNload mnist_uint8;train_x = double(train_x) / 255;test_x = double(test_x) / 255;train_y = double(train_y);test_y = double(test_y);%% ex1 train a 100 hidden unit RBM and visualize its weightsrand('state',0)dbn.sizes = [100];opts.numepochs = 1;opts.batchsize = 100;opts.momentum = 0;opts.alpha = 1;dbn = dbnsetup(dbn, train_x, opts);dbn = dbntrain(dbn, train_x, opts);figure; visualize(dbn.rbm{1}.W'); % Visualize the RBM weights%% ex2 train a 100-100 hidden unit DBN and use its weights to initialize a NNrand('state',0)%train dbndbn.sizes = [100 100];opts.numepochs = 1;opts.batchsize = 100;opts.momentum = 0;opts.alpha = 1;dbn = dbnsetup(dbn, train_x, opts);dbn = dbntrain(dbn, train_x, opts);%unfold dbn to nnnn = dbnunfoldtonn(dbn, 10);nn.activation_function = 'sigm';%train nnopts.numepochs = 1;opts.batchsize = 100;nn = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.10, 'Too big error');```Example: Stacked Auto-Encoders---------------------```matlabfunction test_example_SAEload mnist_uint8;train_x = double(train_x)/255;test_x = double(test_x)/255;train_y = double(train_y);test_y = double(test_y);%% ex1 train a 100 hidden unit SDAE and use it to initialize a FFNN% Setup and train a stacked denoising autoencoder (SDAE)rand('state',0)sae = saesetup([784 100]);sae.ae{1}.activation_function = 'sigm';sae.ae{1}.learningRate = 1;sae.ae{1}.inputZeroMaskedFraction = 0.5;opts.numepochs = 1;opts.batchsize = 100;sae = saetrain(sae, train_x, opts);visualize(sae.ae{1}.W{1}(:,2:end)')% Use the SDAE to initialize a FFNNnn = nnsetup([784 100 10]);nn.activation_function = 'sigm';nn.learningRate = 1;nn.W{1} = sae.ae{1}.W{1};% Train the FFNNopts.numepochs = 1;opts.batchsize = 100;nn = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.16, 'Too big error');```Example: Convolutional Neural Nets---------------------```matlabfunction test_example_CNNload mnist_uint8;train_x = double(reshape(train_x',28,28,60000))/255;test_x = double(reshape(test_x',28,28,10000))/255;train_y = double(train_y');test_y = double(test_y');%% ex1 Train a 6c-2s-12c-2s Convolutional neural network %will run 1 epoch in about 200 second and get around 11% error. %With 100 epochs you'll get around 1.2% errorrand('state',0)cnn.layers = { struct('type', 'i') %input layer struct('type', 'c', 'outputmaps', 6, 'kernelsize', 5) %convolution layer struct('type', 's', 'scale', 2) %sub sampling layer struct('type', 'c', 'outputmaps', 12, 'kernelsize', 5) %convolution layer struct('type', 's', 'scale', 2) %subsampling layer};cnn = cnnsetup(cnn, train_x, train_y);opts.alpha = 1;opts.batchsize = 50;opts.numepochs = 1;cnn = cnntrain(cnn, train_x, train_y, opts);[er, bad] = cnntest(cnn, test_x, test_y);%plot mean squared errorfigure; plot(cnn.rL);assert(er<0.12, 'Too big error');```Example: Neural Networks---------------------```matlabfunction test_example_NNload mnist_uint8;train_x = double(train_x) / 255;test_x = double(test_x) / 255;train_y = double(train_y);test_y = double(test_y);% normalize[train_x, mu, sigma] = zscore(train_x);test_x = normalize(test_x, mu, sigma);%% ex1 vanilla neural netrand('state',0)nn = nnsetup([784 100 10]);opts.numepochs = 1; % Number of full sweeps through dataopts.batchsize = 100; % Take a mean gradient step over this many samples[nn, L] = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.08, 'Too big error');%% ex2 neural net with L2 weight decayrand('state',0)nn = nnsetup([784 100 10]);nn.weightPenaltyL2 = 1e-4; % L2 weight decayopts.numepochs = 1; % Number of full sweeps through dataopts.batchsize = 100; % Take a mean gradient step over this many samplesnn = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.1, 'Too big error');%% ex3 neural net with dropoutrand('state',0)nn = nnsetup([784 100 10]);nn.dropoutFraction = 0.5; % Dropout fraction opts.numepochs = 1; % Number of full sweeps through dataopts.batchsize = 100; % Take a mean gradient step over this many samplesnn = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.1, 'Too big error');%% ex4 neural net with sigmoid activation functionrand('state',0)nn = nnsetup([784 100 10]);nn.activation_function = 'sigm'; % Sigmoid activation functionnn.learningRate = 1; % Sigm require a lower learning rateopts.numepochs = 1; % Number of full sweeps through dataopts.batchsize = 100; % Take a mean gradient step over this many samplesnn = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.1, 'Too big error');%% ex5 plotting functionalityrand('state',0)nn = nnsetup([784 20 10]);opts.numepochs = 5; % Number of full sweeps through datann.output = 'softmax'; % use softmax outputopts.batchsize = 1000; % Take a mean gradient step over this many samplesopts.plot = 1; % enable plottingnn = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.1, 'Too big error');%% ex6 neural net with sigmoid activation and plotting of validation and training error% split training data into training and validation datavx = train_x(1:10000,:);tx = train_x(10001:end,:);vy = train_y(1:10000,:);ty = train_y(10001:end,:);rand('state',0)nn = nnsetup([784 20 10]); nn.output = 'softmax'; % use softmax outputopts.numepochs = 5; % Number of full sweeps through dataopts.batchsize = 1000; % Take a mean gradient step over this many samplesopts.plot = 1; % enable plottingnn = nntrain(nn, tx, ty, opts, vx, vy); % nntrain takes validation set as last two arguments (optionally)[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.1, 'Too big error');```[![Bitdeli Badge](https://d2weczhvl823v0.cloudfront.net/rasmusbergpalm/deeplearntoolbox/trend.png)](https://bitdeli.com/free "Bitdeli Badge")

上一篇: NLP入门+实战必读:一文教会你最常见的10种自然语言处理技术(附代码)
下一篇: 从LoRA到QLoRA:量化技术如何改变预训练模型的微调方式
AI程序猿人
博客等级 码龄2年 6517粉丝 561原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值