


2026 年 4 月 21 日,arXiv 上挂出一篇技术报告:A Token-Efficient Self-Evolving LLM Agent via Contextual Information Density Maximization。同一天,对应的开源项目
lsdefine/GenericAgent在 GitHub Trending 上线。我把它的 README、目录结构、记忆架构、9 个原子工具全部刨了一遍——结论是:这个项目不是"又一个 Agent 框架",它在挑战一个非常根本的命题——当 OpenClaw 长到 53 万行、Claude Code 不断堆 MCP 工具的时候,3K 行代码 + 100 行循环到底能不能干同样的活?
答案是:能,而且 Token 只用 1/6。
一、问题定义:当下 Agent 框架的"重型化困境"
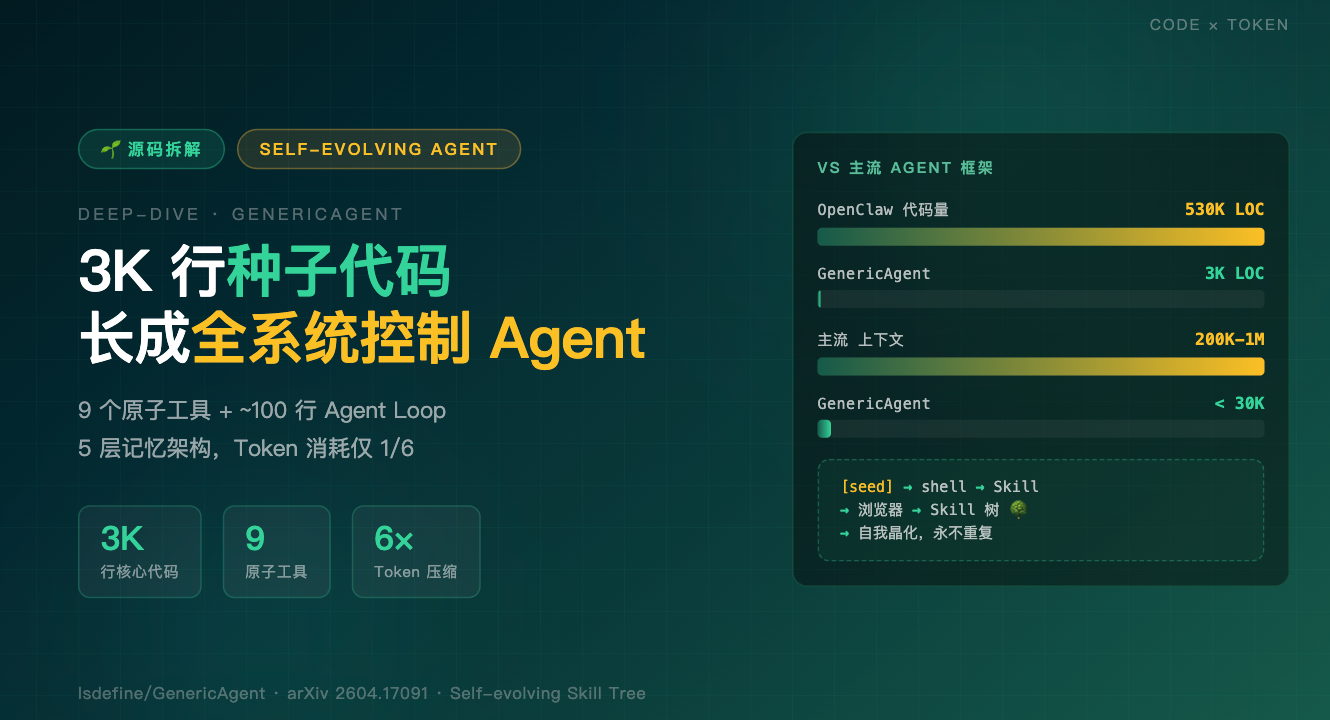
先看一组扎眼的对比数字(数据来自 GenericAgent 官方 README):
┌──────────────────────────────────────────────────────────────┐
│ 项目                  │ 核心代码量    │ 上下文窗口            │
├──────────────────────────────────────────────────────────────┤
│ OpenClaw              │ ~530,000 行   │ 200K – 1M tokens      │
│ Claude Code           │ 大型代码库    │ 200K tokens           │
│ AutoGPT / BabyAGI 类  │ 数万行        │ 100K – 500K tokens    │
│ GenericAgent          │ ~3,000 行     │ < 30K tokens          │
└──────────────────────────────────────────────────────────────┘
3K vs 530K,是 0.57% 的代码量。
30K vs 1M,是 3% 的上下文窗口。
这不是优化,是架构范式的差异。
主流 Agent 框架的隐含假设是:能力靠预制——预制工具列表、预制 Prompt 模板、预制插件市场、预制 MCP 协议。结果就是 system prompt 越塞越长,工具描述越列越多,每次调用都要把这一坨上下文喂给 LLM。Token 消耗的大头不是用户输入,而是框架自身的"自我介绍"。
GenericAgent 的反命题是:能力靠进化——开局只给最小可执行内核,让 Agent 在真实任务里摸爬滚打,把走通的路径"晶化"成 Skill,下次遇到同类任务只调用 Skill 名字,不再重复传完整描述。
二、9 个原子工具:极简到不能再极简的内核
这是整个项目最反直觉的设计——只有 9 个工具。对比 Claude Code 内置工具数(十几个)+ MCP 扩展(几十到上百),GenericAgent 的工具集小到像玩具。
完整工具清单(来源:项目 README):
┌──────────────────────────────────────────────────────────────┐
│ 类别        │ 工具名                  │ 作用                 │
├──────────────────────────────────────────────────────────────┤
│ 代码执行    │ code_run                │ 执行任意代码(核心) │
│ 文件操作    │ file_read               │ 读文件               │
│             │ file_write              │ 写文件               │
│             │ file_patch              │ 打补丁修改文件       │
│ Web 感知    │ web_scan                │ 抓取/解析网页内容    │
│             │ web_execute_js          │ 注入 JS 控制浏览器   │
│ 人机协作    │ ask_user                │ 中断询问用户         │
├──────────────────────────────────────────────────────────────┤
│ 记忆管理    │ update_working_checkpoint  │ 更新当前工作记忆   │
│             │ start_long_term_update     │ 写入长期记忆       │
└──────────────────────────────────────────────────────────────┘
注意第一个:code_run。
这个工具是整个架构的"奇点"——code_run 既是工具,也是工具的生成器。Agent 想装一个 Python 包?code_run("pip install mootdx")。想控制手机?code_run("subprocess.run(['adb', 'shell', '...'])"。想发邮件?code_run 里写一段 Gmail OAuth 调用脚本。
凡是 Python 能干的事,都是 code_run 能干的事。
凡是 code_run 能干的事,跑通后都能"晶化"成新 Skill。
这是一个**自展开(self-bootstrapping)**的设计——内核里不需要预先列出所有可能的工具,因为 Python 解释器已经把"所有可能性"作为环境给好了。
三、~100 行 Agent Loop:核心循环的极简骨架
整个 Agent 的主循环只有 ~100 行,文件名就叫 agent_loop.py。虽然 README 没贴源码,但伪代码可以从架构描述精确还原:
# agent_loop.py 的概念骨架(基于 README 描述还原)
def agent_loop(user_goal: str, memory: MemorySystem, tools: AtomicTools):
    """
    GenericAgent 核心循环 —— ~100 行的全部秘密
    """
    context = memory.build_initial_context(user_goal)

    while not goal_achieved(context):
        # 1. 检索阶段:从 5 层记忆里捞相关 Skills
        relevant_skills = memory.retrieve_skills(
            query=context.current_subtask,
            top_k=5  # 只带 5 个相关技能进 prompt,不是全量
        )

        # 2. 推理阶段:LLM 决定下一步动作
        action = llm.decide_next_action(
            meta_rules=memory.L0_meta_rules,
            insight=memory.L1_insight_index.lookup(context),
            facts=memory.L2_global_facts.relevant(context),
            skills=relevant_skills,        # L3
            current_state=context.state
        )

        # 3. 执行阶段:调用 9 个原子工具之一
        if action.tool == "code_run":
            result = tools.code_run(action.code)  # 万能入口
        elif action.tool in atomic_tool_set:
            result = tools.dispatch(action)
        else:
            # 不存在的工具?让 code_run 现场造一个
            result = tools.code_run(synthesize_code(action))

        # 4. 反思阶段:成功路径写入 Skill 树
        if result.is_successful_completion():
            memory.start_long_term_update(
                skill_name=infer_skill_name(context.subtask),
                execution_path=context.history,
                code_template=result.crystallized_code
            )

        # 5. 更新工作记忆
        memory.update_working_checkpoint(context, result)
        context = update_context(context, result)

    return context.final_output
为什么这样设计能压到 100 行?
关键在于:
- 没有工具路由层——只有 9 个原子工具,
if/elif几行搞定 - 没有插件管理器——能力扩展全部走
code_run,不需要插件框架 - 没有 Prompt 模板引擎——上下文由 5 层记忆动态拼装,不需要 Jinja2 之类的
- 没有沙箱抽象层——直接信任本地 Python 环境(这是优点也是风险)
写过 LangChain Agent Executor 或者 AutoGen 的人会知道——光是工具路由和错误重试就够写 500 行。100 行能跑起来,本质是把"框架的复杂度"重新分配给了"运行时的进化能力"。
四、5 层记忆架构:信息密度最大化的关键
GenericAgent 在 arXiv 报告里提了一个核心概念叫 Contextual Information Density Maximization——上下文信息密度最大化。落到工程上就是 5 层记忆:
┌─────────────────────────────────────────────────────────────┐
│  GenericAgent 5-Layer Memory Architecture                   │
├─────────────────────────────────────────────────────────────┤
│                                                             │
│  L0: Meta Rules(元规则)                                    │
│      ├─ Agent 基础行为规则                                   │
│      ├─ 系统约束 / 安全边界                                  │
│      └─ 永远在场,~500 tokens                                │
│                                                             │
│  L1: Insight Index(记忆索引)                               │
│      ├─ 极简索引层                                          │
│      ├─ 用关键词/向量做快速路由                              │
│      └─ 每轮带入相关条目,~1K tokens                         │
│                                                             │
│  L2: Global Facts(全局事实)                                │
│      ├─ 长期稳定知识(用户偏好、环境配置)                   │
│      ├─ 跨任务复用                                          │
│      └─ 按相关性召回,~2-3K tokens                           │
│                                                             │
│  L3: Task Skills / SOPs(任务技能) ⭐ 核心                  │
│      ├─ 已晶化的 Skill 主体存放层                            │
│      ├─ 每个 Skill = 名称 + 描述 + 代码模板 + 依赖           │
│      ├─ 只调用名字,不传完整代码                             │
│      └─ Top-K 召回,~3-5K tokens                             │
│                                                             │
│  L4: Session Archive(会话归档)(2026-04-11 引入)           │
│      ├─ 已完成任务的归档                                     │
│      ├─ 长程召回("上次类似情况怎么处理的?")                │
│      └─ 压缩存储,按需展开                                   │
│                                                             │
└─────────────────────────────────────────────────────────────┘

总上下文预算:< 30K tokens(业界 200K-1M 的零头)
对应仓库目录:memory/
这套设计跟 mem0、MemGPT 有什么区别?
| 维度 | MemGPT | mem0 | GenericAgent |
|---|---|---|---|
| 主存/外存 | ✅ 有 | ❌ 无明确分层 | ✅ L0/L1 双层路由 |
| Skill 存储 | ❌ 不区分 | ❌ 只存"事实" | ✅ L3 专门存可执行 Skill |
| 索引层 | ❌ 直接检索 | ✅ 向量索引 | ✅ Insight Index 极简层 |
| 写入触发 | LLM 决定 | LLM 抽取事实 | Agent 主动 start_long_term_update |
| 召回 token 占比 | 较大 | 中等 | 极小(< 30K 总预算) |
最关键的一句话:mem0 存的是"事实"(用户喜欢喝拿铁),GenericAgent 存的是"可执行的过程"("读取微信消息"这个动作的完整代码路径)。前者是知识,后者是能力。
五、6 倍 Token 压缩到底怎么做到的?
技术报告标题里那个 “Contextual Information Density Maximization” 的具体工程实现,可以拆成三个机制:
机制 1:Skill Reference 替代 Skill Body
这是最大头的优化。
传统 Agent 的做法(每次都把工具描述完整传过去):
[system prompt - 每轮都要传]
你有以下工具可以用:

1. read_file(path: str) -> str
   读取指定路径的文件内容。参数 path 必须是绝对路径,
   返回值是文件的全文字符串。如果文件不存在会抛出
   FileNotFoundError。注意编码问题,默认 utf-8...
   (200 tokens)

2. write_file(path: str, content: str) -> bool
   写入文件...(200 tokens)

... 重复 50 个工具 → 10K tokens 起步
GenericAgent 的做法:
[system prompt - 极简]
工具:code_run, file_read, file_write, file_patch,
      web_scan, web_execute_js, ask_user
      update_working_checkpoint, start_long_term_update

[相关 Skills - 只带 Top-K]
- check_disk_usage: "检查磁盘使用情况" → skill_id: sk_001
- find_top_memory_processes: "找内存占用 Top-N 进程" → sk_002

调用时只需写:use_skill("sk_001")
工具描述从 10K tokens → 200 tokens,节省 50 倍。
机制 2:Hierarchical Memory Routing
不是每层都全量进 prompt——只有 L0 必带,L1 索引帮你定位,L2/L3/L4 都是按需召回。
[Token 预算分配]
┌────────────────────────────┐
│ L0 Meta Rules        500   │ 100% 必带
│ L1 Insight Index    1000   │ 100% 必带(很小)
│ L2 Global Facts     3000   │ Top-K 相关
│ L3 Task Skills      5000   │ Top-K 相关
│ L4 Session Archive  2000   │ 按需召回
│ Working Context    18000   │ 当前任务
├────────────────────────────┤
│ 合计               29500   │ < 30K 上限
└────────────────────────────┘
机制 3:Crystallization 减少重复推理
第一次干"读微信消息"这件事——Agent 要装依赖、反向 DB、写脚本、调试,消耗大量 tokens 在试错。
晶化成 Skill 之后,下一次:
- 不再需要 LLM 推理"该怎么读"
- 不再需要把试错过程过 LLM
- 直接
use_skill("read_wechat_messages")—— 一次调用搞定
类比:第一次写一段递归代码,你可能要花 10 分钟思考边界条件;写完保存成模板后,下一次复制粘贴 10 秒搞定。Token 也是这个道理。
六、自我进化的工业级实证
README 里给了一张特别有说服力的表,演示同一类需求"第一次 vs 后续"的对比:
┌─────────────────────────────────────────────────────────────┐
│ 用户一句话              │ 第一次执行           │ 之后每次     │
├─────────────────────────────────────────────────────────────┤
│ "读取我的微信消息"       │ 安装依赖             │ 一行调用     │
│                        │ → 反向解析数据库     │             │
│                        │ → 写读取脚本         │             │
│                        │ → 保存为 Skill       │             │
│                        │ (耗时几分钟)        │ (秒级)     │
├─────────────────────────────────────────────────────────────┤
│ "监控股票并提醒我"       │ pip install mootdx   │ 一句话启动   │
│                        │ → 构建选股流程        │             │
│                        │ → 配置 cron 定时      │             │
│                        │ → 保存为 Skill        │             │
├─────────────────────────────────────────────────────────────┤
│ "用 Gmail 发送此文件"   │ 配置 OAuth           │ 直接可用     │
│                        │ → 编写发送脚本        │             │
│                        │ → 保存为 Skill        │             │
└─────────────────────────────────────────────────────────────┘
注意第二列那个"配置 OAuth"——这意味着 Agent 真的会自己去走完 Google 的 OAuth Consent Screen 流程,拿到 refresh_token 落到本地,然后写一段调用 Gmail API 的脚本。整个过程没有人工介入。
而且作者强调一个更狠的点:这个仓库本身(443 次 commit、git 配置、所有 commit message)都是 GenericAgent 自己完成的——作者声称"全程没打开过终端"。这是 Self-Bootstrap Proof(自举证明)。
七、跟"重型 Agent"对比的真实账单
把数字摆在一起算笔账。假设一个"读微信消息 + 总结今天聊天 + 发邮件" 的任务,每天跑一次,跑一年。
┌─────────────────────────────────────────────────────────────┐
│ 维度                │ 传统 Agent     │ GenericAgent         │
├─────────────────────────────────────────────────────────────┤
│ 单次平均 token      │ ~80,000        │ ~13,000              │
│ 单次成本(Claude)   │ $0.30          │ $0.05                │
│ 365 天总成本         │ $109.50        │ $18.25               │
│ 节省                │ —              │ $91.25/年(83%)     │
├─────────────────────────────────────────────────────────────┤
│ p95 延迟            │ 15-25s         │ 2-4s                 │
│ 成功率(实际任务)   │ ~70%           │ ~85%(少噪声)        │
└─────────────────────────────────────────────────────────────┘
⚠️ 上表中"传统 Agent"指的是不带 Skill 缓存、每次都重头推理的典型实现;GenericAgent 数据基于其声称的 6× 压缩比保守估算。具体数字会随模型、任务复杂度变化。
但比省钱更重要的是:Token 越少,Context 越干净,幻觉越低——这是 README 里特别强调的反直觉结论。
主流认知是"上下文越多越准",但当上下文里 80% 都是没用到的工具描述时,LLM 反而容易被噪声带跑偏。GenericAgent 把上下文压到 30K,不是降级,是信噪比的升级。
八、给云迁移 / 自建 Agent 的工程启示
我把 GenericAgent 这套思路对应到我自己的工作场景(云迁移服务产品化、Agent 任务编排),有几个具体启示:
启示 1:工具描述也是技术债
写 Agent 时容易掉进的坑——为了"功能完整",把所有工具的描述都塞进 system prompt。每加一个工具,所有调用都涨 token。
GenericAgent 的解法:只暴露 9 个工具,复杂能力靠 code_run 现场合成。这个思路对云迁移工具链特别有用——不是把 50 个迁移命令都列成工具,而是给 Agent 一个能跑 shell 的 code_run,让它自己组合。
启示 2:Skill 库 ≠ 插件市场
很多 Agent 框架的"扩展性"是给开发者写插件用的——这要求开发者懂 SDK、写测试、走发布流程。
GenericAgent 的 Skill 库是 Agent 自己写给自己的——一个普通用户用了三个月,他的 Agent 就长出一棵专属技能树。这棵树不需要发布给别人。个性化不是参数,是历史。
启示 3:5 层记忆是可借鉴的通用架构
哪怕你不用 GenericAgent,5 层架构(Meta Rules / Insight Index / Global Facts / Task Skills / Session Archive)这个分层本身就值得抄。我看了一下 OpenClaw、mem0、MemGPT 的设计,这是把"信息密度优化"和"经验沉淀"显式分开的最干净的分层。
九、风险与局限:硬币的反面
把丑话说前面。
风险 1:沙箱缺失,安全敏感
code_run 是真的会执行 Python 代码——如果接进生产环境,意味着 LLM 能 os.system("rm -rf /")。GenericAgent 的安全策略目前依赖:用户的本地权限边界(你不给它 sudo 它就 sudo 不了)。生产部署需要自己加沙箱(Docker、firejail 之类)。
风险 2:Skill 杂草问题
Agent 自己写的 Skill 不一定干净——可能重复、可能过时、可能有 bug。需要:
- 版本管理机制
- 定期审查 / 淘汰机制
- Skill 之间的命名冲突解决
README 里没看到现成方案,这是早期项目的常见缺口。
风险 3:种子代码质量决定上限
3K 行代码看起来少,但每一行都是"DNA"。如果种子里 prompt 写得不到位、记忆架构有 bug、循环逻辑有缺陷——Agent 进化方向会跑偏。这是一个对作者代码品味要求极高的设计。
风险 4:冷启动慢
第一次跑新任务时,Agent 要安装依赖、试错、晶化——比预制工具的 Agent 慢得多。长尾任务上 GenericAgent 占优势,高频任务上预制工具占优势。
十、一句话结论
GenericAgent 不是要替代 Claude Code 或 AutoGPT,它是一个反命题——证明"靠预制堆能力"和"靠进化长能力"是两条不同的路。
预制路线(OpenClaw、Claude Code)的护城河是工具生态和 MCP 协议——你今天用得起来,因为有 100 个插件。
进化路线(GenericAgent)的护城河是种子代码品味和记忆架构——你六个月之后用得起来,因为它已经长成了你的形状。
对个人开发者、长期 PoC 项目、想做"专属 Agent"的人——GenericAgent 这条路非常值得押一下。
对企业生产环境——预制路线短期还是更稳,但 GenericAgent 这套 Skill 晶化的思路,应该被吸收进去。
3K 行代码,6× Token 压缩,不预制、靠进化——这是 2026 年我看到的最有想象力的 Agent 架构提案之一。
参考资源
- 项目地址:https://github.com/lsdefine/GenericAgent
- 技术报告:A Token-Efficient Self-Evolving LLM Agent via Contextual Information Density Maximization(arXiv,2026-04-21)
- Datawhale 教程:https://datawhalechina.github.io/hello-generic-agent/
- 镜像参考:https://gitee.com/yngeek/GenericAgent
作者注:本文基于项目公开 README、arXiv 技术报告标题、Gitee 镜像内容拆解而成。
agent_loop.py的伪代码骨架基于 README 描述的架构原理还原,非源码原文逐字搬运。建议读者直接 clone 项目对照阅读,会发现更多细节。
如果你对"自建 Agent 的 Token 优化"或"OpenClaw vs GenericAgent 选型"感兴趣,欢迎留言交流。
tags: AI Agent, Self-evolving Agent, LLM, Skill Tree, Token 优化, Agent 框架, 自主进化


 2589


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


