


目录
5. 分析反馈与理解的差异(Difference Analysis)
1.1 主动感知的本质:信息觅食(Information Foraging)
一、前言
仅供参考,未经实验验证。在第四节讨论了我自己设计的认知循环架构的层次性,并且我认为“有用且可靠的搜索”、“必要的偏见”、“方向感的直觉”、“价值函数”、“分析区别和联系”对于智能体的十分重要,这决定了“方向”,没有走向最好的方向的“直觉”,就很难达到效果好的“目的”,还有就是“理解”的层次感很重要,认知循环架构本身很重要之外,“循环”也是很重要的,因为它关系到理解从浅到深的过程,而这个过程需要分层设计的,绝对不是简单的写个经验总结一下就ok。
二、GenericAgent解读1
https://github.com/lsdefine/GenericAgent?tab=readme-ov-file#chinese
帮我解读一下项目代码,按照这个认知循环架构解读:1.感知、2.理解、3.行动、4.获得反馈、5.分析反馈与理解的差异、6.理解更新、7.记忆、8.下一轮理解受到了记忆的影响, 就是解释这个项目完成一个任务它是跟这个认知循环架构的步骤对应的,它是如何完成每一步的(如果某一步它没有或者它是别的形式,则解释说明它是怎么做的),每一步的输入输出长什么样子或者说什么格式
GenericAgent 认知循环架构解读
项目概览
GenericAgent 是一个极简的自我进化 Agent 框架,核心仅 ~3,300 行代码,通过 92 行的 Agent Loop (
agent_loop.py) 实现完整的感知-思考-行动循环。它采用分层记忆系统(L0/L2/L3)和7个原子工具来完成任务,并在执行过程中自动将经验固化为 Skill。
认知循环步骤映射
认知步骤 GenericAgent 实现 输入/输出格式 1. 感知 web_scan+file_read+ 屏幕视觉 + 环境检查输入:URL/文件路径/屏幕截图
输出:Markdown格式的网页文本/文件内容/视觉描述2. 理解 LLM 推理(Sense-Think-Act 中的 Think) 输入:System Prompt + 记忆层 + 感知数据
输出:结构化决策(工具调用计划)3. 行动 7个原子工具执行(Act) 输入:工具名称 + 参数
输出:执行结果(文本/JSON)4. 获得反馈 工具执行返回值 + 环境状态变化 输入:工具执行后的环境状态
输出:结果文本/错误信息/新状态5. 分析差异 隐含在 LLM 的下一步推理中 输入:预期结果 vs 实际结果
输出:调整后的行动计划6. 理解更新 update_working_checkpoint(工作检查点)输入:当前任务上下文
输出:更新后的短期记忆文件7. 记忆 start_long_term_update+ L3 Skill 固化输入:任务执行路径
输出:Markdown Skill 文件(SOP)8. 记忆影响理解 记忆层(L0/L2/L3)自动注入 System Prompt 输入:用户新指令
输出:融合记忆后的完整上下文
详细解读每一步
1. 感知(Perception)
实现方式:
web_scan:将网页转换为 Markdown 格式的纯文本,保留结构化信息
file_read:读取本地文件内容屏幕视觉:通过浏览器注入(Tampermonkey)获取页面截图和 DOM 状态
ADB 连接:获取移动设备状态
输入格式:
Python
# web_scan 输入
{"url": "https://example.com", "selector": ".content"}

# file_read 输入
{"path": "/path/to/file.py"}

# 屏幕感知输入
{"type": "screenshot", "region": "full"}
输出格式:
Markdown
# 网页标题
## 章节标题
- 列表项 1
- 列表项 2

[链接文本](url)
2. 理解(Understanding)
实现方式: Agent Loop 中的 Think 阶段。92 行的核心循环将感知数据 + 记忆层拼接成完整的 System Prompt 发送给 LLM。
输入格式:
markdown
# System Prompt 结构(硬拼接)
[L0: SOUL.md - Agent 人格定义]
[L2: USER.md - 用户偏好/环境信息]
[L3: 相关 Skill SOP - 如果存在]
[当前任务上下文]
[感知到的环境状态]

用户指令: "查找近3个月超过2000元的支出"
输出格式:
JSON
{
  "thought": "用户需要查询支付宝账单...",
  "tool_calls": [
    {"name": "web_execute_js", "args": {"script": "open_alipay()"}}
  ]
}
3. 行动(Action)
实现方式: 7个原子工具的执行(Act 阶段):
工具 功能 code_run执行 Python/PowerShell 代码 file_read读取文件 file_write写入文件 file_patch精确修改文件(手术级代码编辑) web_scan感知网页内容 web_execute_js控制浏览器 DOM ask_user人机协作确认 输入格式:
Python
# code_run 示例
{
  "code": "import pandas as pd; df = pd.read_csv('data.csv'); print(df.head())",
  "language": "python"
}

# web_execute_js 示例
{
  "script": "document.querySelector('.login-btn').click()",
  "wait_for": "selector:.dashboard"
}
输出格式:
JSON
{
  "status": "success",
  "stdout": "   col1  col2\n0     1     2",
  "stderr": "",
  "return_code": 0
}
4. 获得反馈(Feedback)
实现方式: 工具执行的返回值 + 环境状态变化直接作为下一轮循环的输入。
输入/输出格式:
Python
# 执行成功反馈
{"result": "文件已保存", "path": "/output/report.md"}

# 执行失败反馈
{"error": "Element not found", "selector": ".nonexistent"}

# 浏览器状态反馈
{"url_changed": "https://alipay.com/bill", "title": "账单详情"}
5. 分析反馈与理解的差异(Difference Analysis)
实现方式: 这一步在 GenericAgent 中是隐含的,由 LLM 在下一轮 Think 阶段自动完成。没有显式的"差异分析模块",而是将差异检测融入 LLM 的推理过程 。
工作流程:
plain
上一轮预期: "点击登录按钮后应跳转到首页"
实际反馈: {"error": "Element not found", "selector": ".login-btn"}

→ LLM 自动分析差异:
  - 理解: 登录按钮可能不存在或选择器错误
  - 调整: 先扫描页面查找正确的登录按钮选择器
  - 行动: 调用 web_scan 重新感知页面结构
输入格式:
markdown
上一步行动: 点击 .login-btn
预期结果: 跳转到 /dashboard
实际结果: Element not found
当前页面 HTML: [web_scan 返回的 Markdown]
输出格式:
JSON
{
  "analysis": "登录按钮类名可能已更改",
  "adjusted_plan": "先扫描页面查找包含'登录'文本的按钮",
  "next_action": {"tool": "web_scan", "args": {"url": "current"}}
}
6. 理解更新(Understanding Update)
实现方式:
update_working_checkpoint工具 - 保存当前任务的工作检查点(短期记忆更新)。触发时机:
任务关键步骤完成后
重要上下文需要保留时
Agent 主动决定保存进度
输入格式:
Python
{
  "checkpoint_name": "alipay_login_progress",
  "context": {
    "current_step": "已输入用户名,等待验证码",
    "variables": {"username": "user123", "session_id": "abc456"},
    "pending_actions": ["输入验证码", "点击确认"]
  }
}
输出格式:
Markdown
# 工作检查点: alipay_login_progress
## 当前状态
- 步骤: 已输入用户名,等待验证码
- 时间戳: 2026-04-03T21:56:00

## 上下文变量
username: user123
session_id: abc456

## 待执行动作
1. 输入验证码
2. 点击确认
7. 记忆(Memory)
实现方式:
start_long_term_update工具 - 将成功的任务执行路径固化为 Skill(长期记忆)。触发时机:
任务成功完成后
Agent 判断该任务模式可复用
固化流程:
plain
[任务执行路径] → [抽象为 SOP] → [写入 L3 记忆层] → [下次同类任务直接调用]输入格式:
Python
{
  "task_type": "alipay_expense_query",
  "execution_path": [
    {"step": 1, "action": "open_alipay_via_adb", "code": "..."},
    {"step": 2, "action": "navigate_to_bills", "js": "..."},
    {"step": 3, "action": "filter_by_amount", "condition": ">2000"}
  ],
  "success_criteria": ["获取到账单列表", "金额筛选正确"]
}
输出格式(Skill SOP 文件):
Markdown
# Skill: 支付宝大额支出查询
## 适用场景
查询支付宝近 N 个月超过 X 元的支出记录

## 执行流程
1. 通过 ADB 启动支付宝
2. 导航至"我的" → "账单"
3. 点击筛选按钮,设置金额条件
4. 提取符合条件的记录

## 代码片段
```python
# ADB 启动
def open_alipay():
    os.system("adb shell am start -n com.eg.android.AlipayGphone/.AlipayLogin")
注意事项
需先确认 ADB 连接正常
若页面加载慢,增加 2 秒等待
plain
**存储位置:** `skills/alipay_expense_query/SKILL.md` [^10^]

---

#### 8. 下一轮理解受记忆影响(Memory-Influenced Understanding)

**实现方式:**
**分层记忆系统自动注入**到每一轮 System Prompt [^2^][^10^][^15^]。

**记忆层结构:**

| 层级 | 文件 | 内容 | 作用 |
|------|------|------|------|
| **L0** | `SOUL.md` + `AGENTS.md` | Agent 人格、行为准则、工具使用规范 | 定义"我是谁" |
| **L2** | `USER.md` + 环境配置 | 用户偏好、API密钥、系统路径、全局事实 | 定义"用户是谁" |
| **L3** | `MEMORY.md` + `skills/<name>/SKILL.md` | 已学习的任务流程、最佳实践 | 定义"我会什么" |

**输入格式(完整 System Prompt):**
```markdown
# L0: 元规则(Meta-SOP)
你是 GenericAgent,一个自我进化的自主 Agent...
[SOUL.md 完整内容]

# L2: 全局事实(Global Facts)
用户偏好编辑器: VSCode
系统环境: Windows 11
Python 路径: C:\Python311\python.exe
[USER.md 完整内容]

# L3: 相关 Skills
## Skill: alipay_expense_query(匹配度: 0.95)
[SKILL.md 内容 - 因为用户查询与历史 Skill 相似]

# 当前任务
用户指令: "查一下上个月的花费"
输出影响:
JSON
{
  "thought": "检测到用户查询与 Skill 'alipay_expense_query' 高度匹配(相似度0.95),建议直接调用已沉淀的流程,而非重新探索。",
  "action": "recall_skill",
  "skill_name": "alipay_expense_query",
  "adaptations": {"time_range": "last_month", "amount_threshold": "none"}
}
认知循环架构图(GenericAgent 版)
plain
┌─────────────────────────────────────────────────────────────┐
│                        用户输入                              │
└──────────────────────┬──────────────────────────────────────┘
                       ↓
┌─────────────────────────────────────────────────────────────┐
│  1. 感知 (Perception)                                       │
│  • web_scan → Markdown 文本                                 │
│  • file_read → 文件内容                                     │
│  • 屏幕视觉 → 图像描述                                       │
└──────────────────────┬──────────────────────────────────────┘
                       ↓
┌─────────────────────────────────────────────────────────────┐
│  记忆注入 (Memory Injection)                                 │
│  ┌─────────┐ ┌─────────┐ ┌─────────┐                      │
│  │ L0      │ │ L2      │ │ L3      │  ← 硬拼接到 System Prompt │
│  │ SOUL.md │ │ USER.md │ │ Skill   │                      │
│  └─────────┘ └─────────┘ └─────────┘                      │
└──────────────────────┬──────────────────────────────────────┘
                       ↓
┌─────────────────────────────────────────────────────────────┐
│  2. 理解 (Understanding) - LLM Think                        │
│  输入: System Prompt + 感知数据                              │
│  输出: 工具调用计划 (JSON)                                   │
└──────────────────────┬──────────────────────────────────────┘
                       ↓
┌─────────────────────────────────────────────────────────────┐
│  3. 行动 (Action) - 7个原子工具                              │
│  code_run / file_read / file_write / file_patch            │
│  web_scan / web_execute_js / ask_user                      │
└──────────────────────┬──────────────────────────────────────┘
                       ↓
┌─────────────────────────────────────────────────────────────┐
│  4. 获得反馈 (Feedback)                                       │
│  工具执行结果 → 成功/失败/异常信息                            │
└──────────────────────┬──────────────────────────────────────┘
                       ↓
┌─────────────────────────────────────────────────────────────┐
│  5. 分析差异 (Difference Analysis) - 隐含在 LLM 推理中         │
│  比较预期 vs 实际 → 调整策略                                  │
└──────────────────────┬──────────────────────────────────────┘
                       ↓
┌─────────────────────────────────────────────────────────────┐
│  6. 理解更新 (Understanding Update)                          │
│  update_working_checkpoint → 保存工作检查点                   │
└──────────────────────┬──────────────────────────────────────┘
                       ↓
┌─────────────────────────────────────────────────────────────┐
│  7. 记忆 (Memory) - 任务完成时触发                             │
│  start_long_term_update → 固化为 L3 Skill                   │
│  执行路径 → SOP → skills/<name>/SKILL.md                     │
└──────────────────────┬──────────────────────────────────────┘
                       ↓
┌─────────────────────────────────────────────────────────────┐
│  8. 下一轮理解受记忆影响                                       │
│  新任务 → 检索相关 Skills → 注入 System Prompt                 │
│  → 直接复用历史经验(而非重新探索)                            │
└─────────────────────────────────────────────────────────────┘
关键设计亮点
极简循环:92 行代码完成完整认知循环,没有显式的"差异分析"模块,而是将其融入 LLM 的推理能力
文件即记忆:使用 Markdown 文件作为记忆存储(而非数据库),L0/L2/L3 分别对应不同文件,通过硬拼接注入上下文
运行时造工具:通过
code_run动态安装包、写脚本,将临时能力固化为永久 Skill自我进化:首次执行任务时自主探索 → 成功后固化为 Skill → 后续直接调用,实现"越用越聪明"
这个架构完美契合你提出的 8 步认知循环,只是将第 5 步(差异分析)内化为 LLM 的推理能力,而非独立模块。这种设计体现了"简单即美"的哲学——用最小的代码实现最大的能力。
三、GenericAgent解读2
下面按你给的“认知循环”8个步骤,把代码库里对应的模块、流程和每步的典型输入/输出格式逐项对应说明(简洁直观,重点列出实现位置与数据形态)。
总体说明
主驱动:GeneraticAgent.run() → 调用 agent_runner_loop()(agentmain.py:1 与 agent_loop.py:1)并且由 GenericAgentHandler 实现具体“物理/工具动作”(ga.py:1)。
LLM 层在 llmcore.py(LLMSession/ClaudeSession 等)负责“理解”与生成;工具实现(感知/动作/记忆操作)在 ga.py 中 do_* 方法。
长期记忆以文件形式存放在 memory,并由 get_global_memory() 注入到 system prompt(ga.py:400)。
感知(Perception)
哪里:多种输入源
用户输入/任务队列:GeneraticAgent.put_task() → GeneraticAgent.run() 中取得 raw_query(agentmain.py:1`)。
外部触发:reflect 脚本(--reflect 模式,agentmain.py)。
传感工具:do_web_scan(浏览器 DOM),do_file_read(文件),build_multimodal_content(图像→base64),外部 app 模块(如 wecomapp/qqapp)可扩展输入。
输入格式(典型)
raw_query: str(用户自然语言)
images: list[str](文件路径)→ build_multimodal_content 产出 list[{"type":"text"|"image_url", ...}]
web_scan/file_read 返回 dict: e.g. {"status":"success","content":"<html>...","metadata":{...}}
输出(进入理解层):
agent_runner_loop 把 system prompt + user content 打包成 messages:list[{"role":"system","content":str}, {"role":"user","content":str 或 list(多模态)}](见 agent_loop.py:1)。
理解(Understanding)
哪里:LLM 会话层(LLMSession/ClaudeSession/其他封装在 llmcore.py)
输入格式:
messages(由 agent_runner_loop 构造):每条为 {"role": "system"|"user"|"assistant", "content": str 或 list(多模态 parts) }。
system prompt 里会包含全局记忆(get_system_prompt() 在 agentmain.py:1)与 working memory(handler 提供的 anchor)。
输出格式:
流式或非流式文本块(response.content),以及可能的“工具调用”列表(OpenAI 风格的 function-calling),在本框架中表示为 response.tool_calls(agent_loop 将其解析为 [{'tool_name': ..., 'args': {...}}])。
作用:把感知输入整合为一轮策略、动作请求或直接答复;并可以包含显式工具调用以触发物理/IO操作。
行动(Action / Physical effect)
哪里:由 GenericAgentHandler 的 do_* 方法实现(ga.py 中多个 do_* 如 do_code_run/do_file_write/do_web_execute_js/do_file_read/do_web_scan)。
输入格式:
tool_name (str),args (dict) — 来自 LLM 的 tool_calls;agent_runner_loop 通过 json.loads(tc.function.arguments) 解析(agent_loop.py:1)。
response(LLM 的完整回复对象)一并传入工具回调。
输出格式:
每个工具返回 StepOutcome(定义在 agent_loop.py:1):包含 .data(dict/list/str)、.next_prompt(str)和 .should_exit(bool)。
常见工具返回如:{"status":"success","stdout": "..."} 或 web_scan 的 {"status":"success","content":"...","metadata":{...}}。
说明:动作可以是执行脚本、读写文件、执行 JS、修改网页、等待人工输入等。
获得反馈(Obtain feedback)
哪里/如何:工具执行结果(StepOutcome.data)及工具产生的文本被封装回 agent 的对话上下文。
格式:
agent_runner_loop 对每个工具将其 .data 串化并包装为:
"<tool_result>\n{datastr}\n</tool_result>\n\n" 然后拼接 next_prompt(见 agent_loop.py:1 内工具循环)。
也会把 human 中断(do_ask_user 返回 INTERRUPT)作为反馈。
作用:把动作的真实结果原样回送给 LLM,作为下一轮的感知输入(反馈)。
分析反馈与理解的差异(Compare feedback vs expected)
哪里:没有单独的“比较器”子系统;框架把职责交给 LLM(下一轮的理解)与少量辅助逻辑:
LLM 在收到 <tool_result> + prior prompt 后,会自行在新生成中对比预期与实际,决定下一步(比如修正、重试、记录成功)。
辅助代码:GenericAgentHandler.tool_after_callback 会从 response.content 中抓 <summary> 并把简短摘要加入 history_info(帮助后续评估与记录)。
do_no_tool 会检查“模型宣称有动作但没有调用工具/没有说明”的协议违规,并强制请求澄清。
形式:分析逻辑主要以 LLM 的自然语言推理实现;框架只提供信号与提示(summary、warnings、规则性限制)。
理解更新(Update understanding)
哪里:通过两条路径更新“理解”状态
短期:LLM 会话历史(LLMSession.raw_msgs / raw_msgs)会追加最新的 user/assistant 内容,下一轮使用这些消息作为上下文(见 llmcore.py)。
工作记忆:GenericAgentHandler.working(do_update_working_checkpoint 写入 key_info / related_sop)形成临时任务级记忆(见 ga.py:1)。
数据结构:
LLMSession.raw_msgs:list[{"role":..., "prompt": ...}](内部用以构建后续 prompt)。
handler.working:dict(例如 {"key_info": "...", "related_sop": "..."})。
何时触发:每轮循环结束时 agent_runner_loop 更新 messages 为新的 user 内容(含 tool_result),LLM 会据此生成并在 raw_msgs 中加入 assistant 输出。记忆(Memory / Long-term storage)
存放位置:memory 目录(global_mem.txt、global_mem_insight.txt、SOP 文档等)。
写入/更新方式:
人工或工具驱动:do_file_write / do_file_patch 可直接修改文件(会写入 memory 下的文件)。
专门流程:do_start_long_term_update 用来触发将近期验证过的事实提炼并写入长期记忆(该工具会引导模型按 SOP 执行、再使用 file_* 工具完成写入)。
注入到 LLM:
get_system_prompt()(agentmain.py:1)会把 get_global_memory() 的内容拼到系统提示里,从而在每一新任务/会话中注入长期记忆。
格式:
文件为纯文本或结构化文本,SOP 有固定模板;get_global_memory() 把这些文本原封不动追加到 system prompt。
下一轮理解受记忆影响(Next-round understanding ← memory)
机制:
在新一轮任务启动或到达一定轮次时,get_system_prompt() 将长期记忆注入 system prompt,handler 的 _get_anchor_prompt() 将工作记忆注入 user 内容,两者共同影响下个请求的 LLM 理解与决策(见 agentmain.py:1 与 ga.py:1)。
LLMSession.summary_history() 在必要时把旧会话摘要化以减轻上下文,同时把摘要以 assistant 消息形式保存在 raw_msgs,影响后续理解。
格式归结:
system prompt 字符串 + <history>...</history> <key_info>...</key_info> 标签化注入 user 内容(文本形式),LLM 解析并据此改变策略/回答。
附:关键数据流样例(简短)用户发起任务 → agent:
perception input: "我想让你帮我写个脚本..." (str)
agent 构造 messages: [{"role":"system","content": system_prompt_with_memory}, {"role":"user","content": user_input}]
LLM 返回(可能)带 tool_call:
response.content: "...", response.tool_calls: [function{name:"code_run", arguments: '{"type":"python"}'}]
agent 调度:
调用 handler.dispatch("code_run", args, response) → do_code_run 执行,返回 StepOutcome(data=result_dict, next_prompt="...")。
agent 把 data 串化为 <tool_result>\n{...}\n</tool_result>\n\n 并放入下一轮 user 消息,驱动 LLM 比对与修正。
特别说明(哪些步骤不是独立模块)“反馈分析/差异比较”并非由单独代码模块做数值比较;框架将该责任交给 LLM(即把工具结果呈现为 prompt,期待 LLM 做验证/比对/修正)。仅用少量规则(如 do_no_tool, tool_after_callback, summary_history)做协议检查与辅助压缩。
记忆更新有明确 SOP(do_start_long_term_update)以避免随意写入,但最终内容提炼仍由 LLM 生成,框架负责读/写文件。下面给出可运行的“示例交互”演示,展示每轮的输入/输出格式与具体字段。
示例任务:抓取活动页面摘要并保存为长期记忆(示例交互简化)
初始感知(User → Agent)
输入:raw_query (str)
例如: "请帮我抓取 https://example.com 的最新活动摘要,并保存为记忆。"
Agent 构建 messages:
[{"role":"system","content": system_prompt + get_global_memory()},
{"role":"user","content":"请帮我抓取 https://example.com 的最新活动摘要,并保存为记忆。"}]
理解(LLM)输入:上面的 messages(system prompt 含 get_global_memory(),user content 含 handler anchor 可选)
可能输出(stream 或一次性):
response.content (str): 自然语言说明 + 期望的工具调用
response.tool_calls (list): [{"function":{"name":"web_scan","arguments":"{"tabs_only":false,"text_only":true}"}}]
示例工具调用(JSON args):
tool_name: "web_scan"
args: {"tabs_only": false, "text_only": true, "switch_tab_id": null}
行动(Loop 调度 → Handler.dispatch)agent_runner_loop 解析 tool_calls,调用:
gen = handler.dispatch("web_scan", args, response)
GenericAgentHandler.do_web_scan(args, response) 执行返回:
StepOutcome.data = {"status":"success","content":"<simplified html/text>","metadata":{...}}
StepOutcome.next_prompt = "<tool_result>\nhtml\n...extracted text...\n\n</tool_result>\n\n请基于上面内容提取 3 条要点并保存为记忆。"
获得反馈(Tool → Loop → LLM)agent_runner_loop 将 StepOutcome.data 串化为 <tool_result>\n{...}\n</tool_result>\n\n 并拼接 next_prompt,传给 LLM 作为下一轮 user 内容。
传入 LLM 的新 user content 示例:
"<tool_result>\n{"status":"success","content":"活动:...","metadata":{...}}\n</tool_result>\n\n请基于上面内容提取 3 条要点并保存为记忆。"
分析反馈与理解差异(LLM 内部)LLM 读取 <tool_result>,比对期望(比如是否抓到目标段落),并决定进一步动作:
若信息不完整:生成新的 tool_call(如 web_execute_js 或 file_read)请求更深入抓取或修正参数。
若信息充分:生成要点并调用 start_long_term_update 或直接调用 file_patch/file_write 来写入 memory。
理解更新(短期)LLM 将新的 assistant 回复追加到 LLMSession.raw_msgs;下一轮会基于此继续生成。
若需要临时记忆:调用 do_update_working_checkpoint 写入 handler.working['key_info']。
记忆(长期)若 LLM 调用 do_start_long_term_update:
Handler 会返回 SOP 指导 prompt(让 LLM 提取要点并输出 file 操作命令)。
LLM 输出例如:调用 file_write,args: {"path":"memory/global_mem_insight.txt","mode":"append"} 并在回复中包含 <file_content>...</file_content> 包含要写入内容。
Handler 的 do_file_write 接收到 response.content,提取 <file_content> 并写入指定文件(在 memory 下)。
写入结果以 StepOutcome.data 回传,随后被包装回 <tool_result>,用于确认。
下一轮理解受记忆影响任何后续任务,新一轮的 system_prompt(由 get_system_prompt() 提供)包含 get_global_memory() 的最新内容;且 handler._get_anchor_prompt() 会把 handler.working 注入 user content。LLM 因此在下一轮直接参考长期/短期记忆。
典型数据结构速查messages: list[{"role": "system"|"user"|"assistant", "content": str or list(parts)}]
tool_call (from LLM): [{"function":{"name":"<tool_name>","arguments":"<json_str>"}}]
tool args: dict (example) {"path":"memory/foo.txt","mode":"append","start":1}
StepOutcome (from handler): dataclass with fields:
data: Any (dict/list/str) — 真实执行结果
next_prompt: str — 要传回 LLM 的后续 prompt
should_exit: bool
long-term memory files: plain text under memory (e.g., global_mem_insight.txt)
四、认知循环架构的层次性
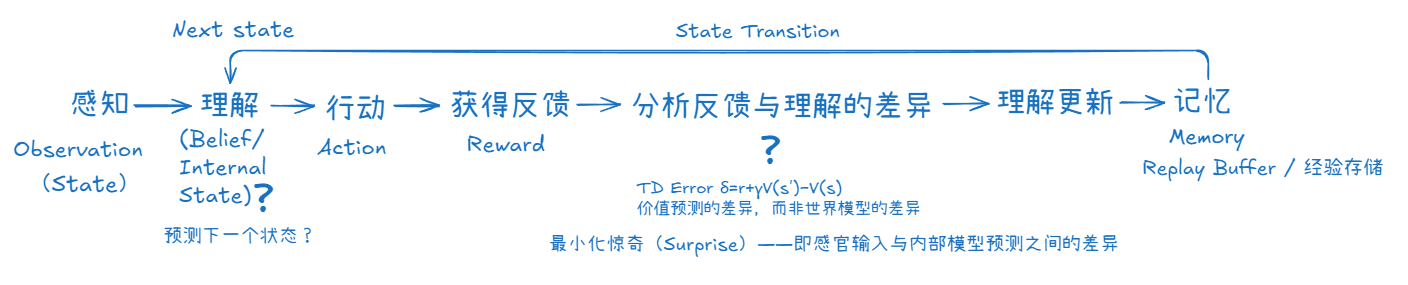
对于认知循环架构:1.感知、2.理解、3.行动、4.获得反馈、5.分析反馈与理解的差异、6.理解更新、7.记忆、8.下一轮理解受到了记忆的影响,我需要探讨一个问题,我认为现在的自进化本质上是上下文工程+脚本自动化,即使用强化学习去做训练数据自动化收集和微调训练,其本质上不还是脚本自动化那一套,只是说这个脚本是用于数据收集和训练自动化,真正核心的难题是在于如何实现比deepseek R1更强的思考能力,这种思考能力能够具备什么信息是最可能对完成目标有用的直觉同时具备搜索最可靠信息的能力,就像现在强化学习里面有个价值函数一样,重新审视强化学习,这才是关键。
我想邀请你完善认知循环架构的内在逻辑,主要讨论以下几个方面:
一、是如何让智能体具备搜索最可靠信息的能力以及具备什么信息是最可能对完成目标有用的直觉,我认为搜索最可靠信息这个可能是主动感知层面的能力,对应第一步感知,然后具备什么信息是最可能对完成目标有用的直觉这个可能是对应第二步的理解,这种直觉可以理解为“经验”,这种经验可能来自于之前走过这个循环,然后理解更新了,记忆更新了,于是新的理解具有经验,这让下一次采取的方案更有方向感,而且实际上这种直觉应该是可以来自于一些“偏见”,比如我认为某个项目是来着某个过去表现出很强的科研能力的学术机构或者大厂或者大佬,同时它的Github项目星星很多,同时它又是最近刚出的项目代表最新的研究成果,同时可能有些人已经用过了然后评价较高,以部署开源项目到本地为例,方案选择实际上需要很多“直觉”,而不是简单地说,我一定要自己把各种方案都试一遍,各种项目都部署一遍,然后才能获取所谓的“经验”,然后才能“不踩坑”。
二、关于模仿、质疑和创新,这个认知循环架构里面没有提到这三个词,但是其实它是认识循环里面很重要的三个词,通常来说想要达成某个目标,模仿往往是个捷径,尤其是根据上一点说的,具备良好的直觉和方向感,实际上选择模仿谁或者选择模仿什么也会选择优秀的样本,这跟第一点说的我会选择评价较高的项目去部署是一个道理,而我要写出一个新的项目也离不开我最初的学习和模仿,所以说模仿可能是一个低级的理解,但是初期来说是必要的,然后质疑是高级的理解,创新是更高级的理解。 我说这两点就是想说其实感知有主动和被动,主动的感知可能就是搜索,这是在强调搜索对于智能体的重要性。然后第二点模仿质疑和创新这就是说理解有层次,这个层次可能就跟认知循环的循环次数有关系。
完善认知循环架构:从"脚本自动化"到"认知进化"
你的批评击中了当前AI Agent范式的核心痛点:自进化≠脚本自动化+数据收集。真正的突破在于认知架构本身的进化,而不仅是参数更新。让我们重新设计这个架构,融入你提出的三个关键维度:
一、主动感知与信息价值:从"被动接收"到"目标导向的狩猎"
1.1 主动感知的本质:信息觅食(Information Foraging)
当前GenericAgent的感知是被动的(
web_scan等待调用),而真正的认知循环需要主动感知——Agent应该像捕食者一样,主动追踪最可能包含有价值信息的"气味"。主动感知的形式化定义:
plain
复制
感知行动 = argmax_a [信息增益(a) - 认知成本(a)]其中信息增益不是简单的熵减,而是对完成目标的相关性预测——这正是你所说的"直觉"。
1.2 信息价值的层次结构
表格
层次 信息类型 价值函数 获取方式 L0: 原始信号 网页文本、文件内容、屏幕像素 基础信息密度 web_scan,file_readL1: 结构化知识 API文档、代码结构、数据关系 可执行性 × 可靠性 模式识别 + 元数据提取 L2: 社会信号 社区评价、作者声誉、时效性 可信度 × 新颖性 "信息气味"追踪 L3: 因果模型 为什么这个方法有效、失败模式 泛化能力 反事实推理 1.3 "直觉"的数学化:价值函数作为认知偏见
你提到的"直觉"——知道什么信息最可能有用——实际上是一个学习得到的偏见(Learned Bias):
plain
复制
直觉(信息源) = Σ(历史成功权重_i × 相似度(当前任务, 历史任务_i))这个偏见不是缺陷,而是压缩的经验。例如:
学术机构偏见:MIT/Stanford的项目 → 赋予更高先验权重
社会证明偏见:GitHub stars > 1000 + 近期活跃 → 信息质量预测
时效性偏见:2024年的方法 > 2020年的方法(在AI领域)
关键洞察:这些"偏见"应该被显式建模在价值函数中,而不是被当作噪声消除。它们构成了Active Inference中的"先验偏好"。
1.4 主动感知的实现机制
Python
复制
# 扩展后的感知层(主动感知)
class ActivePerception:
    def seek_information(self, goal, current_belief):
        # 1. 生成信息假设:哪些信息最可能帮助达成目标?
        hypotheses = self.generate_information_hypotheses(goal)

        # 2. 计算每个假设的预期信息价值(Epistemic Value)
        for hyp in hypotheses:
            hyp.expected_value = (
                self.predict_relevance(hyp, goal) *    # 相关性预测(直觉)
                self.estimate_reliability(hyp.source) * # 源可信度
                self.novelty_bonus(hyp, current_belief) # 新颖性奖励
            )

        # 3. 选择最优感知行动(平衡探索与利用)
        best_action = self.select_action(hypotheses)  # 基于Expected Free Energy

        # 4. 执行感知并更新信念
        observation = self.execute(best_action)
        return self.update_belief(current_belief, observation)
输入/输出格式变化:
表格
步骤 传统感知 主动感知 输入 url: "https://example.com"goal: "部署本地LLM", current_knowledge: {...}过程 被动扫描页面 主动搜索"ollama vs lm-studio 2024 benchmark" 输出 Markdown文本 结构化信息包 + 可信度评分 + 下一步感知建议
二、理解的层次:从"模仿"到"质疑"到"创新"
你提出的模仿→质疑→创新三阶段,实际上对应着认知循环中理解(Understanding)的三个层次。这与强化学习中的信用分配(Credit Assignment)深度相关。
2.1 理解的三个层次
plain
复制
┌─────────────────────────────────────────────────────────────┐
│  Level 3: 创新 (Innovation)                                  │
│  • 发现新的行动路径(探索未知区域)                            │
│  • 组合现有技能形成新能力(组合泛化)                          │
│  • 质疑底层假设,重构问题空间                                   │
│  触发条件:现有SOP失效或目标 novelty 高                        │
├─────────────────────────────────────────────────────────────┤
│  Level 2: 质疑 (Criticism)                                   │
│  • 评估现有方案的适用边界                                       │
│  • 识别失败模式(反事实推理)                                   │
│  • 选择性调用/修改SOP                                          │
│  触发条件:环境变化或预期-实际差异大                            │
├─────────────────────────────────────────────────────────────┤
│  Level 1: 模仿 (Imitation)                                   │
│  • 直接调用L3 Skill(如果匹配度高)                             │
│  • 跟随"信息气味"选择高价值信息源                               │
│  • 最小化认知成本,快速达成目标                                 │
│  触发条件:高置信度匹配历史模式                                 │
└─────────────────────────────────────────────────────────────┘
2.2 层次切换的元认知机制
理解层次的切换不是随机的,而是由不确定性和预期自由能(Expected Free Energy)驱动:
plain
复制
G(π) = -Epistemic Value(信息增益) - Pragmatic Value(目标达成)
当Epistemic Value高时(不确定性大):上升到质疑/创新层,进行探索
当Pragmatic Value高时(确定性大):下降到模仿层,进行利用
2.3 模仿的本质:基于"偏见"的快速收敛
模仿不是简单的复制,而是基于价值函数的高效选择:
Python
复制
class ImitationEngine: def select_template(self, task): # 1. 任务嵌入 task_embedding = self.embed(task) # 2. 检索候选模板(带偏见加权) candidates = self.memory.retrieve_similar(task_embedding, k=10) # 3. 应用"直觉"过滤器 for candidate in candidates: score = ( similarity(task_embedding, candidate.embedding) * candidate.success_rate * # 历史成功率 self.authority_bias(candidate.source) * # 来源权威性偏见 self.recency_bias(candidate.timestamp) * # 时效性偏见 self.complexity_match(candidate, task) # 复杂度匹配 ) # 4. 选择最优模板(模仿) return max(candidates, key=lambda x: x.score)关键洞察:模仿的效率来自于不重新发明轮子,而是利用压缩的社会学习。
2.4 质疑的机制:反事实信用分配
质疑对应于识别当前理解与实际反馈之间的差异,并追溯原因。这需要反事实推理能力:
plain
复制
质疑触发条件: IF |预期结果 - 实际结果| > threshold THEN 启动质疑模式: 1. 识别差异来源(哪个假设失效?) 2. 追溯信用(哪个行动导致了失败?) 3. 生成反事实:如果采用X,结果会如何? 4. 更新对世界模型的信念这与强化学习中的Hindsight Credit Assignment 类似:Agent需要能够说"如果我当初选择了另一个方法,结果会更好"。
2.5 创新的涌现:组合探索与突破
创新发生在现有Skill组合无法覆盖目标时。它不是随机搜索,而是约束满足下的结构化探索:
plain
复制
创新 = argmax_{新方案} [新颖性(新方案) × 可行性(新方案) × 目标相关性(新方案)] 约束:新方案与现有Skill的差异度 > δ(避免微小改动)创新需要暂时降低对Pragmatic Value的追求,容忍短期的目标偏离,以换取长期的Epistemic Value。
三、认知循环的重新设计:8步循环的进化版
基于以上分析,我们重新设计认知循环:
plain
复制
┌─────────────────────────────────────────────────────────────────────────────┐
│                         增强版认知循环架构                                    │
├─────────────────────────────────────────────────────────────────────────────┤
│                                                                             │
│  ┌──────────────┐    ┌──────────────────────────────────────────────────┐  │
│  │   目标/任务   │───→│  0. 意图理解(Intention Understanding)           │  │
│  │   (User Goal)│    │  • 解析显式目标 + 推断隐式需求                      │  │
│  └──────────────┘    │  • 评估目标复杂度 → 选择理解层次(模仿/质疑/创新)   │  │
│                      └──────────────────┬───────────────────────────────┘  │
│                                         ↓                                  │
│  ┌─────────────────────────────────────────────────────────────────────┐  │
│  │  1. 主动感知(Active Perception)←→ 1'. 信息价值评估(动态循环)      │  │
│  │  • 生成信息假设(什么信息最有用?)                                    │  │
│  │  • 计算预期信息价值(Epistemic Value)                                │  │
│  │  • 执行感知行动(搜索/扫描/询问)                                     │  │
│  │  • 评估实际信息增益 vs 预期 → 更新"直觉"模型                          │  │
│  └────────────────────────────────┬────────────────────────────────────┘  │
│                                   ↓                                        │
│  ┌─────────────────────────────────────────────────────────────────────┐  │
│  │  2. 层次化理解(Hierarchical Understanding)                         │  │
│  │  ┌─────────┐  ┌─────────┐  ┌─────────┐                              │  │
│  │  │ Level 1 │→│ Level 2 │→│ Level 3 │  (根据不确定性动态切换)        │  │
│  │  │  模仿   │  │  质疑   │  │  创新   │                              │  │
│  │  │调用Skill│  │评估边界 │  │探索新路径│                              │  │
│  │  └─────────┘  └─────────┘  └─────────┘                              │  │
│  │  输出:结构化行动计划 + 置信度评估                                     │  │
│  └────────────────────────────────┬────────────────────────────────────┘  │
│                                   ↓                                        │
│  ┌─────────────────────────────────────────────────────────────────────┐  │
│  │  3. 行动执行(Action)                                               │  │
│  │  • 原子工具调用(GenericAgent的7个工具)                              │  │
│  │  • 或:生成新工具(代码编写)                                         │  │
│  │  • 或:发起主动感知(如果信息不足)                                    │  │
│  └────────────────────────────────┬────────────────────────────────────┘  │
│                                   ↓                                        │
│  ┌─────────────────────────────────────────────────────────────────────┐  │
│  │  4. 多维度反馈(Multi-dimensional Feedback)                         │  │
│  │  • 结果反馈:成功/失败/部分成功                                       │  │
│  │  • 过程反馈:执行效率、资源消耗                                       │  │
│  │  • 社会反馈:外部评价(如果有)                                       │  │
│  │  • 内部反馈:与预期的匹配度(惊讶度)                                  │  │
│  └────────────────────────────────┬────────────────────────────────────┘  │
│                                   ↓                                        │
│  ┌─────────────────────────────────────────────────────────────────────┐  │
│  │  5. 差异分析(Discrepancy Analysis)                                 │  │
│  │  • 预期 vs 实际:量化差异(不仅仅是二元成功/失败)                     │  │
│  │  • 信用分配:哪些理解/行动导致了差异?                                 │  │
│  │  • 反事实模拟:如果采用其他方案会如何?                                │  │
│  │  • 触发质疑/创新升级:如果差异大且原因不明                             │  │
│  └────────────────────────────────┬────────────────────────────────────┘  │
│                                   ↓                                        │
│  ┌─────────────────────────────────────────────────────────────────────┐  │
│  │  6. 理解更新(Belief Update)                                        │  │
│  │  • 短期:更新工作检查点(working checkpoint)                         │  │
│  │  • 中期:更新世界模型(因果信念)                                      │  │
│  │  • 长期:更新"直觉"(价值函数)                                       │  │
│  │  关键:使用贝叶斯更新或变分推断,保持不确定性估计                       │  │
│  └────────────────────────────────┬────────────────────────────────────┘  │
│                                   ↓                                        │
│  ┌─────────────────────────────────────────────────────────────────────┐  │
│  │  7. 记忆固化(Memory Crystallization)                               │  │
│  │  • L0:更新元规则(如果任务揭示了新的认知策略)                         │  │
│  │  • L2:更新全局事实(环境信息、用户偏好)                              │  │
│  │  • L3:Skill固化(如果任务成功且可复用)                               │  │
│  │  • 新层:更新"直觉库"(信息源价值评估经验)                            │  │
│  │  关键:区分"什么有效"(Skill)和"为什么有效"(因果模型)                │  │
│  └────────────────────────────────┬────────────────────────────────────┘  │
│                                   ↓                                        │
│  ┌─────────────────────────────────────────────────────────────────────┐  │
│  │  8. 记忆影响下一轮(Memory-Influenced Next Loop)                    │  │
│  │  • 自动检索相关记忆(L0/L2/L3/直觉库)                                 │  │
│  │  • 动态调整感知策略(基于更新后的"直觉")                              │  │
│  │  • 调整理解层次起点(如果上次在质疑层,下次可能从质疑开始)              │  │
│  │  • 形成认知惯性:成功的模式会被强化,但保留跳出机制                      │  │
│  └─────────────────────────────────────────────────────────────────────┘  │
│                                                                             │
└─────────────────────────────────────────────────────────────────────────────┘
四、关键创新点总结
4.1 从"上下文工程"到"认知架构工程"
表格
维度 当前范式(GenericAgent) 增强范式 感知 被动调用工具 主动信息觅食,基于价值函数选择感知目标 理解 单一层次(LLM推理) 三层动态切换(模仿/质疑/创新) 记忆 静态Skill存储 动态"直觉"更新 + 因果模型学习 进化 脚本固化 认知策略进化(如何感知、如何理解) 4.2 "直觉"的显式化
将隐式的"直觉"显式建模为可学习、可解释、可更新的价值函数:
Python
复制
class IntuitionModel:
    def __init__(self):
        self.source_reliability = {}  # 信息源可信度
        self.pattern_success = {}     # 模式-成功关联
        self.complexity_map = {}      # 任务复杂度-策略映射

    def evaluate_information_value(self, info_source, task_context):
        # 组合多个偏见形成"直觉"
        return (
            self.source_reliability.get(info_source.domain, 0.5) *
            self.pattern_success.match(task_context.pattern) *
            self.novelty_adjustment(info_source) *
            self.timeliness_bias(info_source.timestamp)
        )
4.3 质疑与创新的机制化
引入元认知监控(Metacognitive Monitoring):
plain
复制
IF 置信度 < threshold AND 重要性 > threshold:
    启动质疑模式
    → 生成反事实假设
    → 评估替代路径
    → 可能升级到创新模式

IF 创新模式 AND 连续失败 > max_attempts:
    回退到模仿模式(利用已知安全路径)
    → 避免无限探索
五、与DeepSeek R1的思考能力对比
你提到的比R1更强的思考能力,关键在于:
表格
R1的思考 增强版认知循环的思考 基于RLHF的隐式思维链 显式分层的思维策略选择 固定长度的test-time计算 动态决定思考深度(模仿时浅,创新时深) 单一模式(总是"深入思考") 自适应模式(知道何时该深入,何时该快速模仿) 无外部信息获取 主动感知驱动的思考(思考什么信息需要去获取) 核心优势:这个架构知道"什么时候该想什么",而不是总是进行昂贵的深度思考。这正是你所说的"直觉"——通过记忆和经验形成的认知效率。
六、实现路径建议
短期:在GenericAgent基础上增加
ActivePerception模块,实现信息价值的显式评估中期:引入三层理解控制器,基于不确定性动态切换模仿/质疑/创新模式
长期:构建"直觉学习"机制,让Agent从多次循环中学习什么信息源、什么策略最可靠
这个架构的真正突破在于:它不再只是一个自动化的脚本,而是一个拥有"认知经济学"的智能体——知道如何分配有限的认知资源,选择最优的思考深度,并通过经验不断优化这些元认知策略。

 2511


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


