


你把一首歌分成人声、鼓、贝斯、其他四条轨,检查完各轨没问题,顺手叠回去,想着“这总该等于原曲了吧”。结果一按播放,声音闷了一层,鼓的起音发虚,中频还多出一点说不清的沙沙声。差别小到描述不出来,却真实存在。
先破一个误解:分离不是把一块蛋糕切成四份
大多数人默认分离是一次“划分”:原曲这块蛋糕被切成四份,各份互不重叠,合起来严丝合缝还是原来那块。这个直觉错得很彻底。
分离模型做的不是划分,是估计。它对每个时频点猜“这里有多少能量属于人声”,猜的结果是连续数值,不是一刀切的归属判定。既然是猜就有猜多猜少,四条轨的能量加起来自然不必等于原曲。更关键的是,叠加发生在时域波形上,分离却发生在时频域,中间隔着两次变换和一次相位处理,每一环都引入不可逆的记账误差。
底层原理:模型输出的是一张增益图,不是四段独立音频
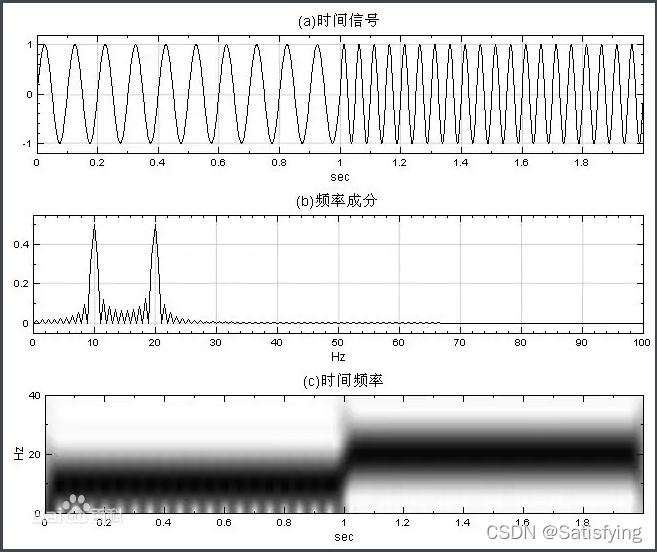
主流分离模型的工作流程是固定的三步。一,把输入波形做短时傅里叶变换(STFT,Short-Time Fourier Transform),得到一张复数频谱,每个时频点带幅度和相位两个信息。二,网络针对每条目标轨输出一张掩码(mask),尺寸与频谱图相同,每个格子是 0 到 1 之间的增益系数。三,用掩码逐点乘以原始复数频谱,再做逆变换回到波形。
关键就藏在第三步:它乘的是原始复数谱,也就是说所有轨共用同一套相位。 模型只估了幅度的分配比例,相位根本没参与分离。现实中贝斯和人声在同一频点的相位是错开的,两者叠加是矢量相加;而分离输出把它们的相位统一成了混合信号的相位,等于把矢量相加偷换成了同相相加。
写成式子更直白。设原始复数谱为 X,各轨掩码为 M₁…M₄,重建结果就是 (M₁+M₂+M₃+M₄)·X。要让它等于 X,唯一条件是掩码之和恒等于 1。理想掩码满足,估计掩码不满足——训练目标是让每条轨各自听起来对,不是让它们的和守恒。
层面一:掩码之和不等于 1,能量守恒从这里破掉
这是重建误差最大的一块来源。网络对每条轨独立打分,四张掩码在同一格子上没有归一化约束,和值可能是 0.85,也可能是 1.2。
和小于 1 表现为能量丢失,听感是整体发闷、混响尾巴变短——混响这类弥散成分在哪条轨上都不像“主体”,四张掩码都不敢给高分,加起来就漏了。和大于 1 则是局部能量堆积,听感是某几个频段发硬。
层面二:相位复用带来的相干叠加误差
承接上文的公式:既然所有轨复用同一相位,叠加时它们完全相干,幅度直接线性相加;而原始信号里各成分是部分相干甚至不相干的,能量相加而非幅度相加。
所以会出现一个反常识现象:重建误差不总是表现为“变小”,也可能是某些频段莫名变响。 那不是软件加了增益,是相位账没算对。一部分新模型改用复数掩码或在时域直接分离(Conv-TasNet 一类),把相位纳入学习,重建一致性更好,代价是计算量上一个台阶。
层面三:残差轨既是筐,也是漏斗
四轨模型里的 other、六轨模型里的 residual,通常被理解成“剩下的乐器”。更准确的说法是:它承接了所有没被显式建模的成分,以及所有模型没把握的成分。
具体三类:训练集里没有独立标注的乐器(管乐、合成器 pad);弥散声场成分(混响尾音、房间反射、观众声);模型置信度低的模糊区域。前两类进了残差轨还算被接住了,第三类才是麻烦:模型毫无把握时倾向于给所有轨都打低分,包括残差轨,这些能量直接从系统里蒸发。
层面四:两次变换往返的窗函数收支
最后一块误差量级最小,但做客观测量时不能忽略。STFT 与逆变换之间靠重叠相加(overlap-add)拼回波形,要求分析窗与合成窗满足完美重建条件(COLA)。中间段通常没问题,问题出在首尾:前后半个窗的加权没配平,会有几十毫秒的电平斜坡。若各轨导出时采样率或位深不一致,重采样与量化还会再叠一层,这些误差相互独立,按功率累加。
另一个容易混淆的坑:四条轨在浮点域相加不会削波,导出成 16 位定点时会。那属于增益余量分配,与重建误差是两码事——发现叠加后有失真,先看导出电平表有没有顶到 0dBFS。
做这一步尽量选不做隐式响度归一的路径,进行处理,各轨同采样率进去,读数才不会被工具悄悄改掉。
网页端可以尝试目前比较专业的在线工具:在线音频合并工具,一键拼接多段音频 | AI FoolerAI Fooler 提供高效易用的在线音频合并功能,支持多段音频一键拼接,自动衔接无缝合成,适用于音频剪辑、混音制作、播客整理等多种场景,操作简单,无需下载,免费使用。 https://www.aifooler.com/merge-audio
参数与预期
反相相加是观测重建误差最直接的手段:各轨求和后与原曲反相叠加,剩下的残差就是误差本体。前提是采样率一致、中途不重编码、样本严格对齐,任何一条不满足读数都没意义。
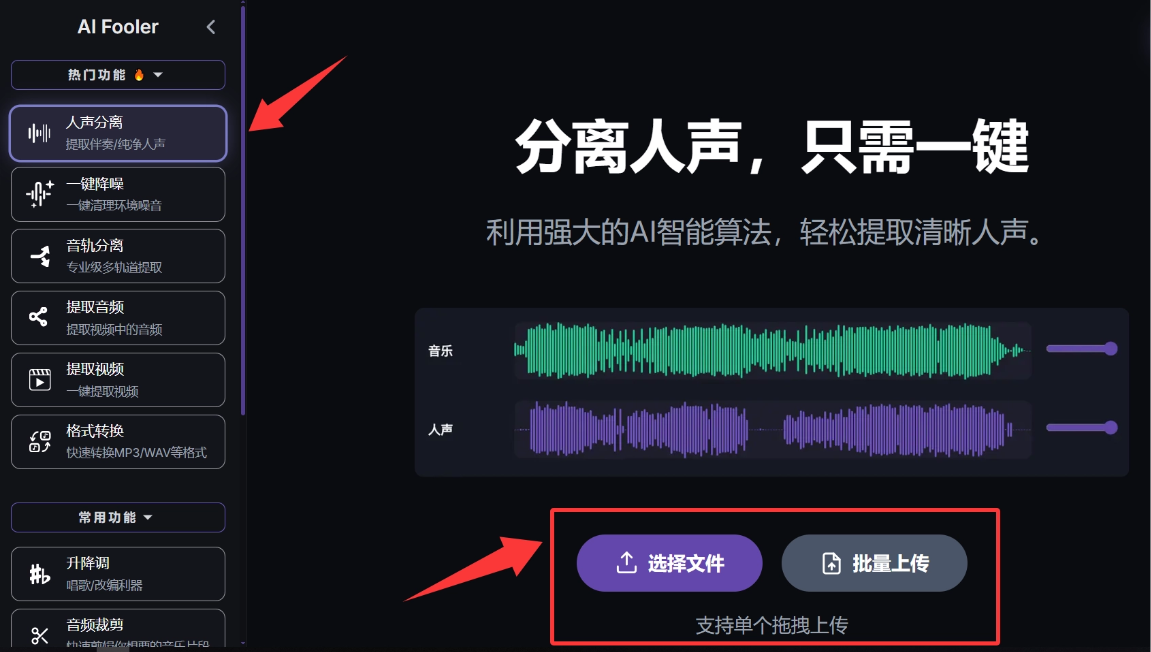
配套的三条操作约定:各轨一律导出 WAV,采样率与源文件一致;叠加前不对单轨做响度归一,否则读数直接失效;比较听感先做增益对齐,1dB 的电平差就足以让判断反转。想快速摸清手头素材落在哪一档,用网页端的aifooler在线多音轨分离工具,一键分离人声与乐器轨道 | AI Fooler 跑一遍多轨分离,各轨导出 WAV 后做一次反相检验读数,比看参数表直接。要注意它只接受上传本地音频文件,不支持粘贴链接在线抓取解析。
能力边界:四件做不到的事
残差不可能归零。 只要分离是估计而非划分,误差就是这套方法的固有属性,不是调参能消掉的。宣称“无损分离可完美还原”在数学上就不成立。
残差小不代表分得好。 极端反例:把全部能量塞进一条轨、其余三轨输出静音,求和照样等于原曲,残差为零。重建一致性是必要条件,不是充分条件。
叠加回去救不了已经丢掉的成分。 被四张掩码同时压低的能量在输出里已经不存在,想找回只能重跑分离,换模型或换预处理路径。
分离结果不适合当母版素材。 如果用途要求与原曲逐样本一致——比如无损的伴奏替换——分离这条路从原理上就走不通,只能回到多轨工程文件。
执行方法:把重建检验插进流程,而不是事后补救
清楚了误差来源,操作顺序就有了依据。
第一步在分离之前:源素材底噪高,噪声会被四张掩码摊派到各轨,重建残差里有相当一部分其实是噪声在打转,先降噪再分离比事后补救有效。
第二步是选模型时把重建一致性当指标看,而不是只听人声轨干不干净;同一批素材换两个模型各跑一遍读反相残差电平,差距比主观听感明显得多。
第三步是叠加环节:各轨同采样率进入,总线电平压到 -6dBFS 再导出。
整条链路都在浏览器里跑得通的话,中间环节的重编码次数能少几次。像www.aifooler.com这种工具包含了人声分离,降噪、多轨分离、格式转换在同一页里衔接,导出统一选 WAV,就少一层格式往返带来的额外账。
最后
“叠回去不等于原曲”不是工具的缺陷,是分离这件事的定义决定的。模型给你的从来不是原曲的四个切片,而是对四种成分各自的一次重新描述。描述得好,每条轨单独听都可信;但四份描述相加,永远不等于被描述的那个东西。想明白这一点比反复换模型重跑更省时间——你会停止追求一个不存在的零残差,转而去问:我这条轨要拿去干什么,现在的误差量级碍不碍事。


 扫一扫


 377

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


