


你把一段录音丢进降噪,听完觉得干净了不少,可心里又冒出一句"是不是把什么东西也磨掉了"。转码更玄:同一首歌从 WAV 转成 MP3 再转回 WAV,文件大小翻了好几倍,播放器里的波形看着一模一样,你说不出哪里变了,也不敢说没变。最后只能反复 A-B 切换,越听越没底——上一遍觉得原始的更厚,下一遍又觉得处理过的更清楚。
四个可量化指标
下面四项都能用 ffmpeg 单独跑出来,不需要专业测量设备。
指标一:高频截止点
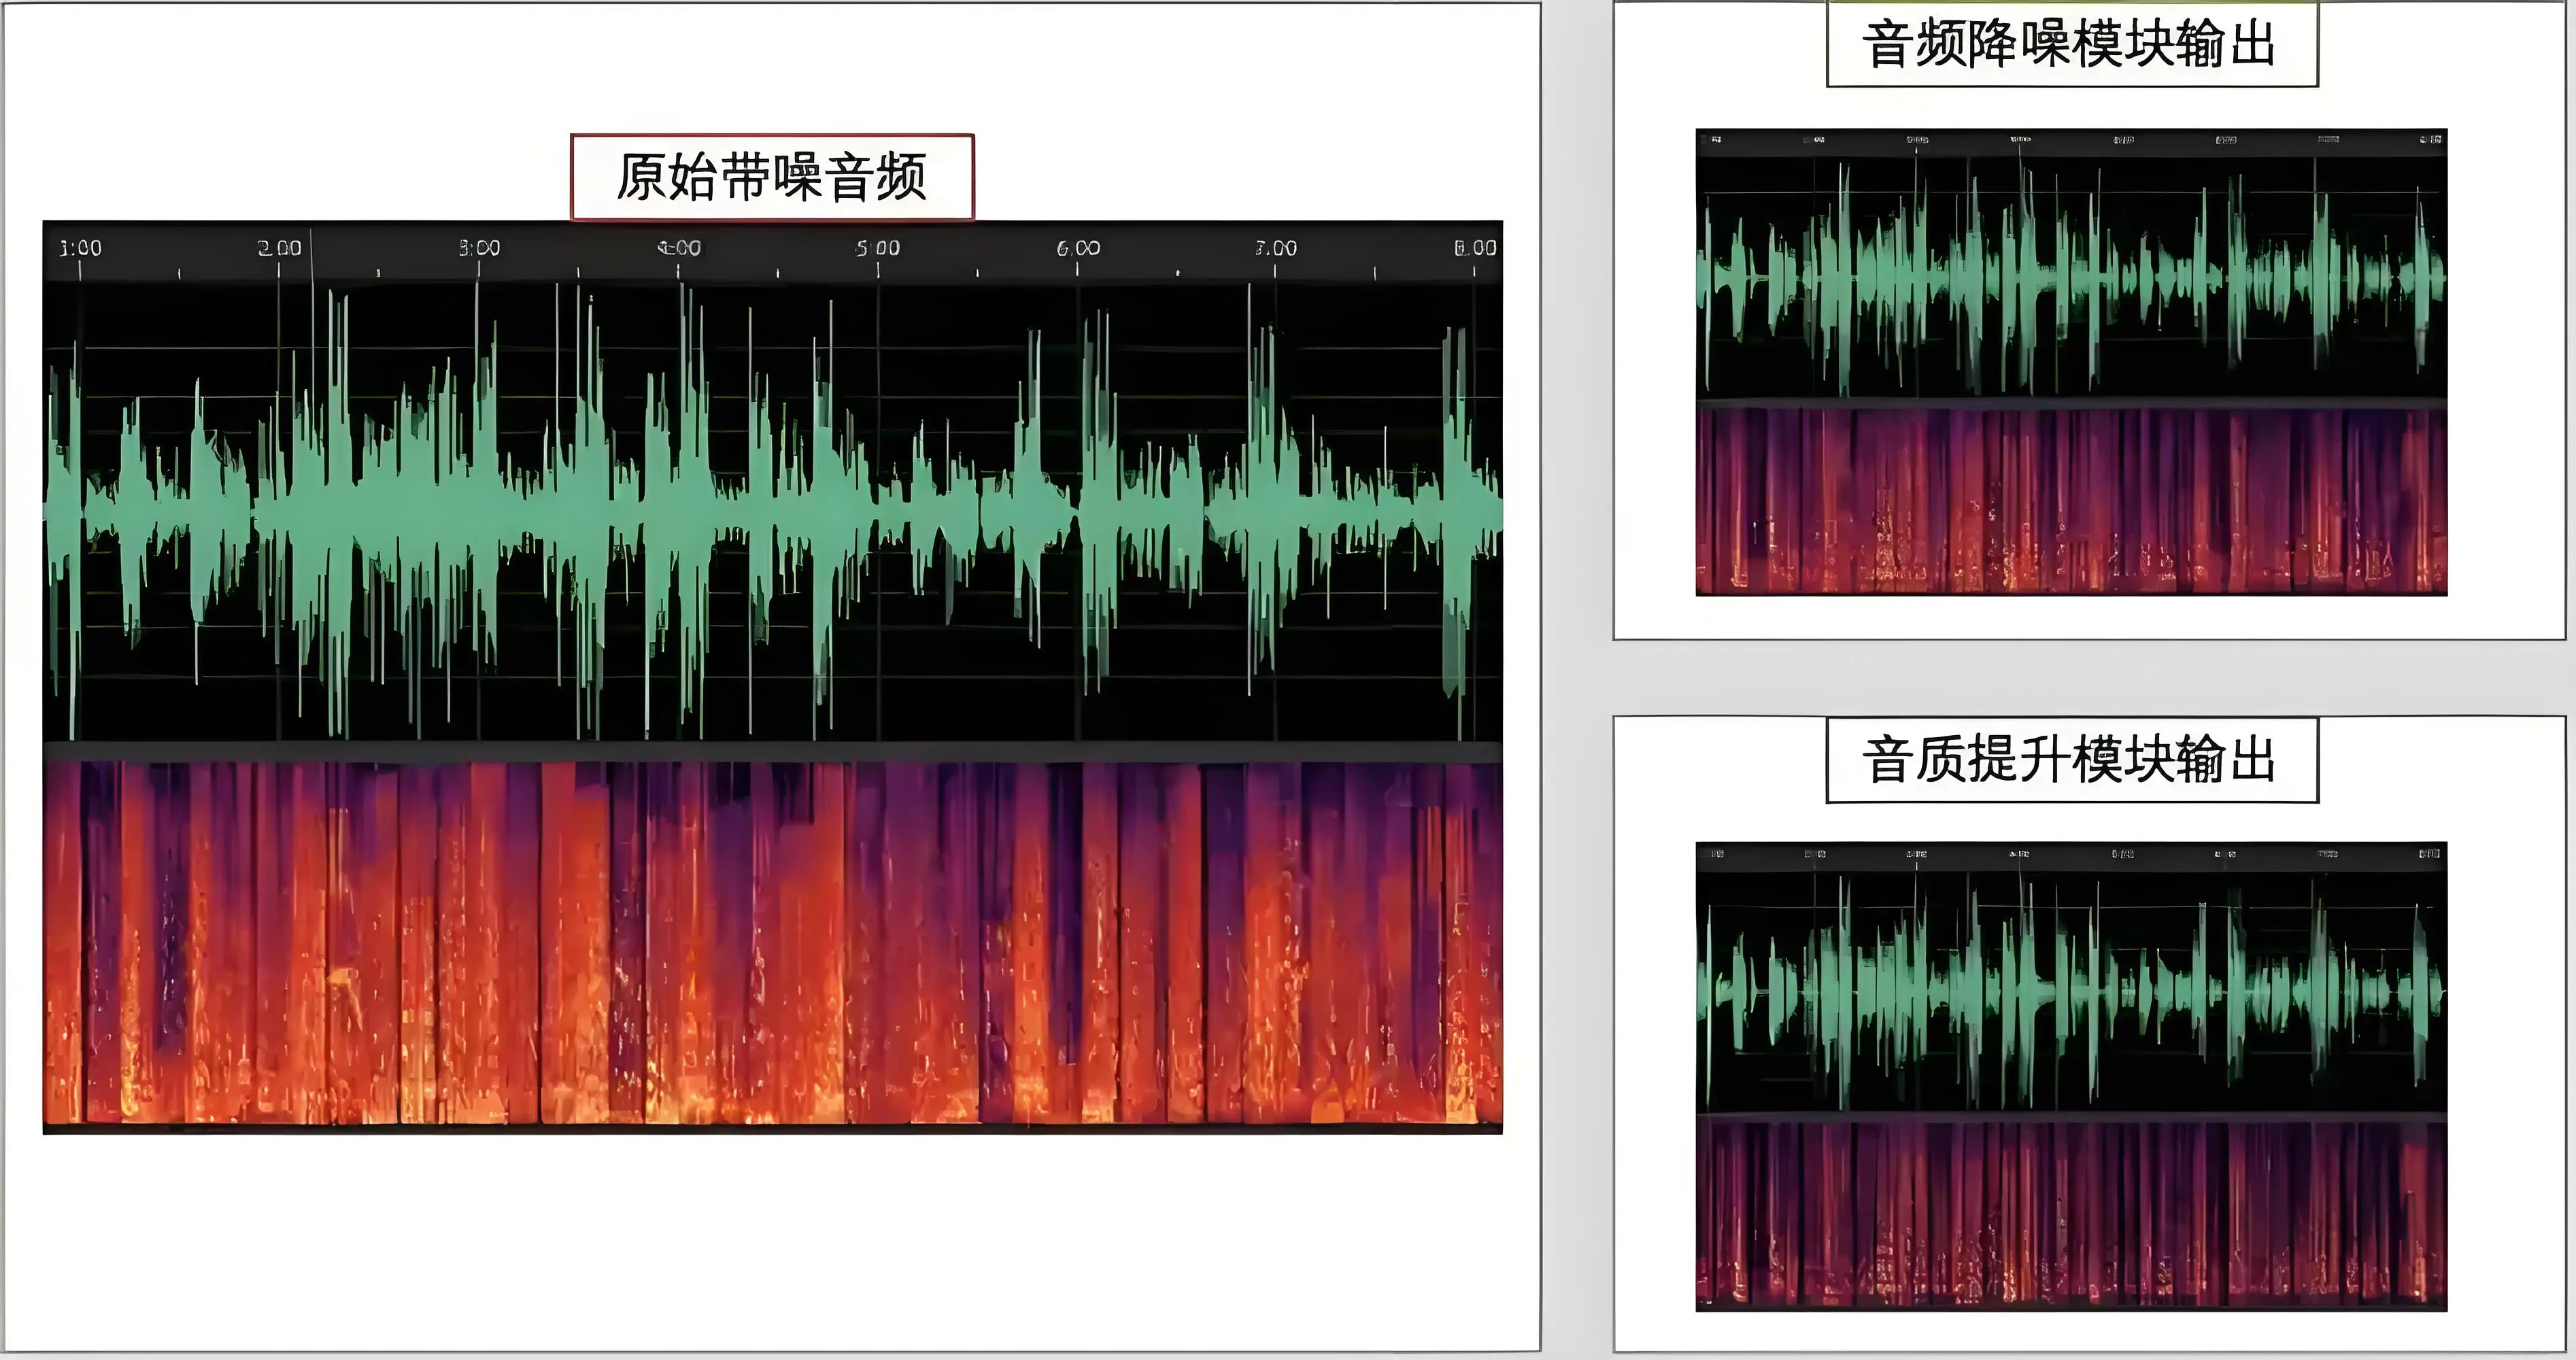
看什么:处理前后的频谱图上,能量在多少赫兹处出现一条横向的"砖墙"。
怎么读:
ffmpeg -i input.wav -lavfi showspectrumpic=s=1200x600:legend=1 spec-before.png
ffmpeg -i output.mp3 -lavfi showspectrumpic=s=1200x600:legend=1 spec-after.png
经验值:128kbps 的 MP3 通常在 16kHz 左右一刀切,192kbps 约 19kHz,320kbps 接近 20kHz。关键是先看处理前那张。 如果源文件本来就在 16kHz 断掉,说明它早就被压过一遍,这条截断线不该记在你这次处理的账上——这是自测里最容易搞错的一笔归属。
指标二:静音段与有效段的 RMS 差值
看什么:降噪到底压掉了多少能量,压的是噪声还是连内容一起压。
怎么读:分别截一段纯静音(或纯背景)和一段人声密集处,各自测电平:
ffmpeg -i input.wav -ss 0 -t 2 -af astats=metadata=1:reset=0 -f null -
读 `RMS_level` 与 `Peak_level`。合格的降噪应该呈现明显的分离感:静音段 RMS 下降 8dB 以上,有效段 RMS 变化控制在 1dB 以内。两段一起掉同样多,说明它做的其实是“整体压低音量”,不是降噪。想拿一个行为可预期的实现做基准对照,可以用音频噪声消除工具跑同一段素材,把两组读数摆在一起比。
指标三:量化底噪与谐波失真
看什么:处理链路自己有没有往信号里加东西。
理想输出只有 1kHz 一根线。出现 2kHz、3kHz 等整数倍的尖峰,是谐波失真(THD,Total Harmonic Distortion);出现和频、差频位置的杂峰,是互调失真。
指标四:增益对齐后的 A-B 一致性
看什么:在排除响度变量之后,你还能不能听出差别。
两者整体响度差压到 0.5 LU 以内再听。 这一步不做,前面三项数据全白测——你的耳朵会被音量牵着走,得出与数据相反的结论,然后你会去怀疑数据。
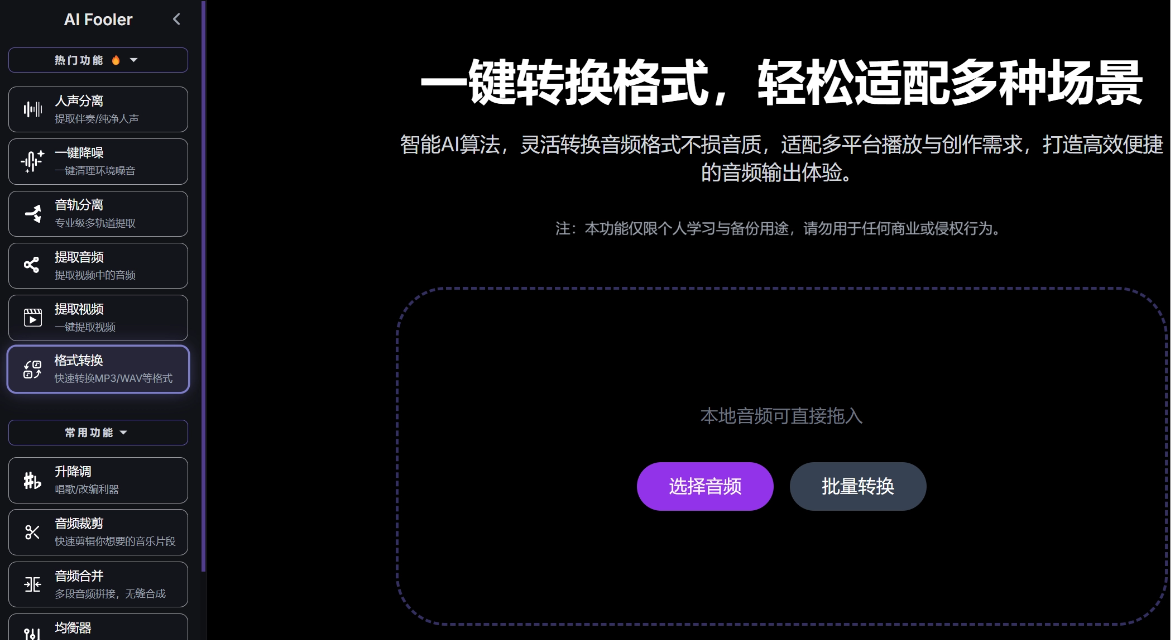
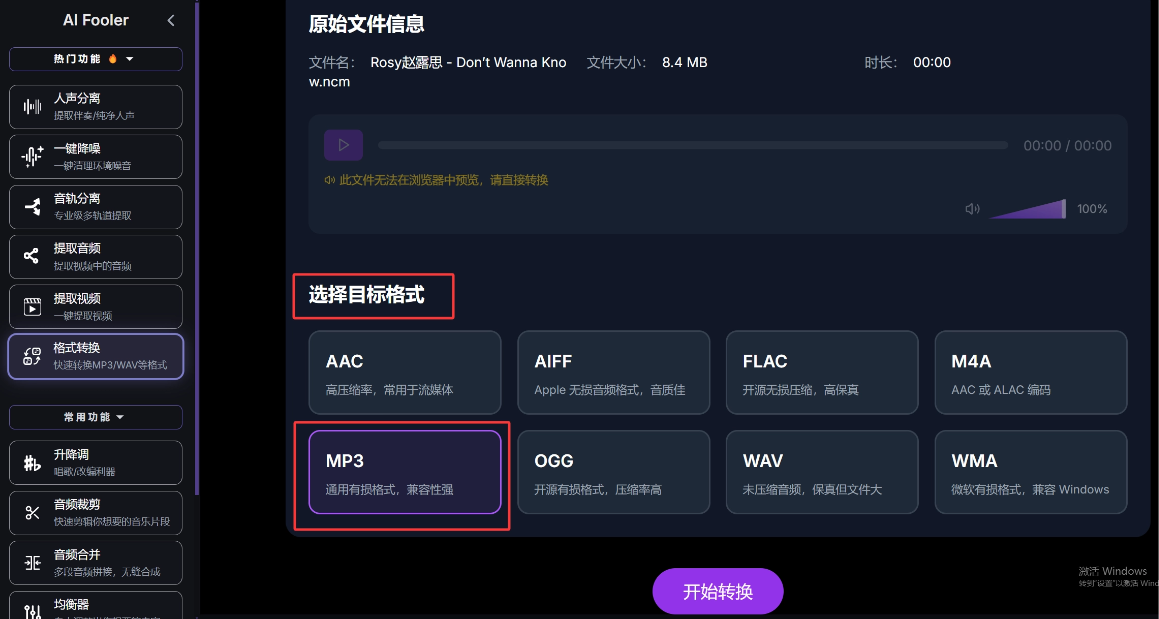
格式环节有一条经验能省掉一半麻烦:中间环节一律走 WAV 或 FLAC,只在最终交付那一步转成有损格式。 需要临时换封装或做一次采样率统一时,用免费音频转码工具这类在线转换过一遍即可,别在多个有损格式之间来回倒——每倒一次都是一次不可逆的重编码。
落地:一条能跑通的自测流程
顺序比工具重要,这条链上每一步都是为了让下一步的读数有意义。
第一步,先给源文件做体检,再动手处理。 看频谱截止点、测静音段本底,把源素材本身的上限记下来。这一步决定后面哪些缺陷不该算在处理头上,跳过它,你会把有损源的高频空白误判成降噪的锅。
第二步,保持一份未处理的原始副本,格式为 WAV。 后面所有对比都以它为基准,它同时也是唯一的回退位。
第三步,处理只做一遍,参数记下来。 底噪偏高的素材先降噪再做其他处理,顺序反了会把已经被后级放大的噪声再压一次,痕迹更重。手边没有本地环境时,AIFooler 这类免费在线音频工具可以覆盖降噪与格式转换这两步:上传本地音频文件,选处理模式,导出时选 WAV。处理完立刻把输出下载下来测,别在网页上凭听感下判断。
需要说明一句:它只接受上传本地文件,不支持粘贴一个链接让它在线抓取解析,素材得先落到本地。
第四步,先读数,后试听。 按上面的速查表把六项过一遍,全部达标再做增益对齐的盲切。数据先行的意义在于,它能挡住"因为期待变好所以听出变好"这类心理偏差。
第五步,把参数和读数写进文件名或一份小记录。 下次遇到同类素材直接复用,这是自测唯一能积累下来的东西。
最后
音质这件事之所以容易吵起来,是因为大家把三个问题混成了一个:变了没有、变了多少、这个变化要不要紧。前两个是可测的,第三个只能由用途来定——做背景音乐可以接受高频砍到 16kHz,做人声素材宁可留一点底噪也不能把气声磨平。
先把可测的部分测掉,剩下的分歧才是真正值得讨论的分歧。


 扫一扫


 694

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


