


任务完成率可以回答“有没有参加”,考试成绩可以回答“是否掌握了部分知识”,但它们仍然无法独立回答三个关键问题:课程是否贴近岗位,讲师是否讲清楚,员工是否把所学应用到了工作中。
如果培训结束后只留下一张平均分报表,低分原因、高频建议和后续改进就会彼此割裂。下一轮培训继续沿用旧内容,运营人员也很难判断一次改版究竟有没有效果。
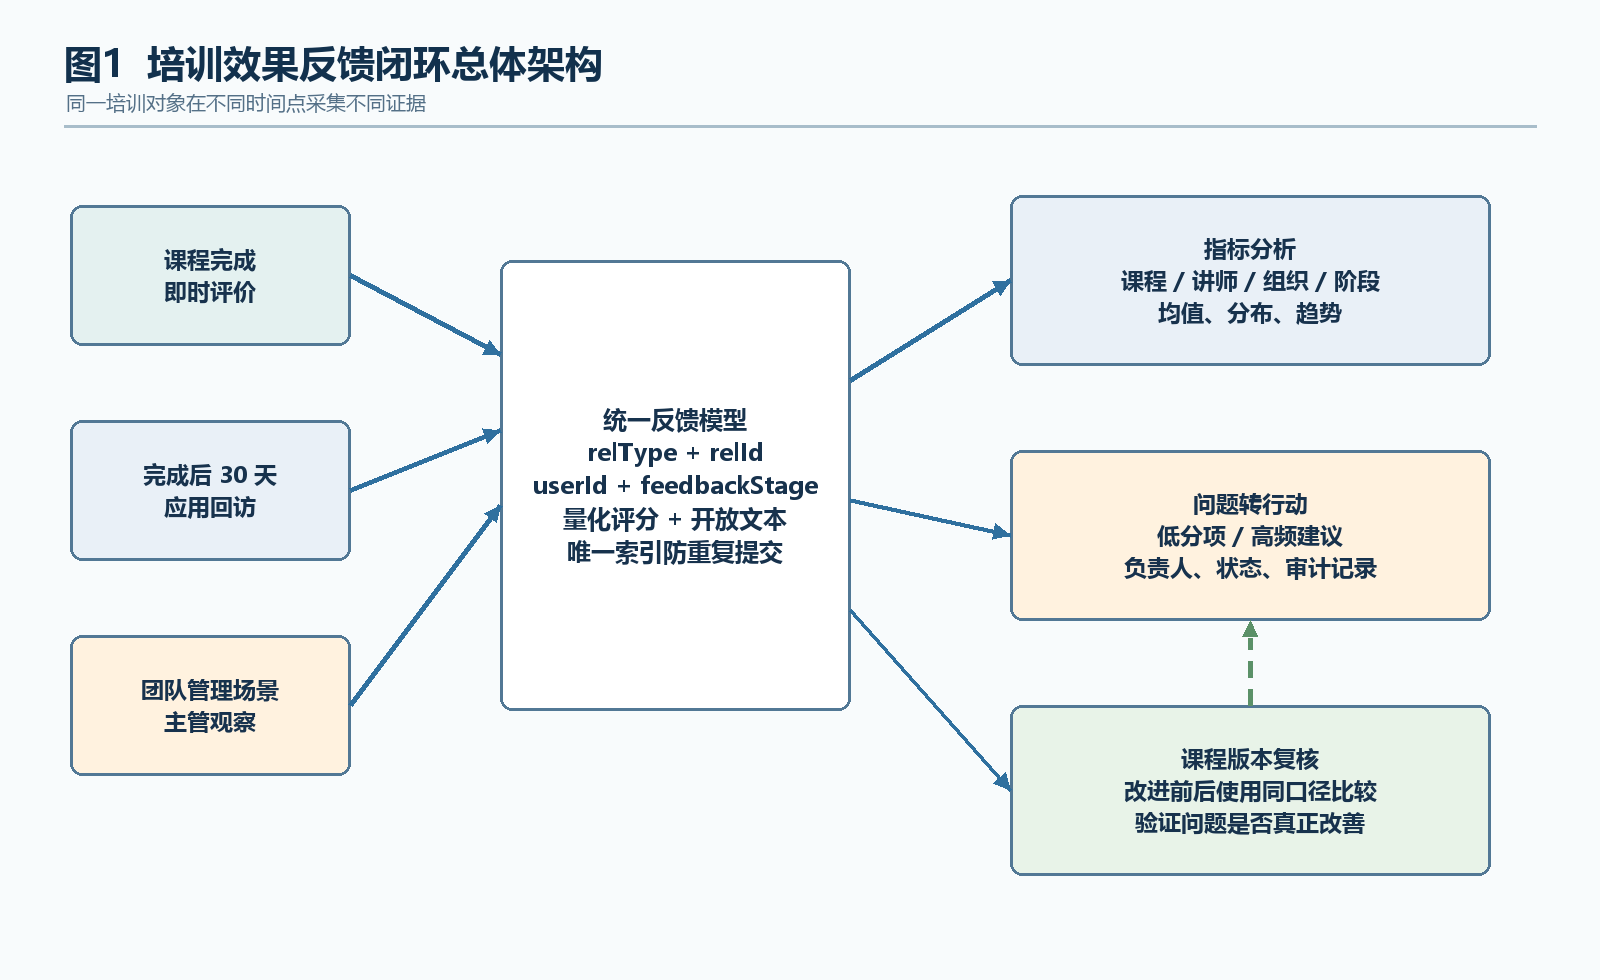
织码在线教育系统将反馈设计为一条可追踪链路:课程完成后采集即时体验,经过一段时间后回访岗位应用情况,再引入主管观察;低分项和高频问题可以转为改进任务,任务完成后关联课程新版本,并通过后续评价验证改进结果。
一、为什么要分阶段评价,而不是只发一份问卷
培训评价存在明显的时间差。课程刚结束时,学员最容易判断内容是否清晰、节奏是否合适、学习体验是否顺畅;但课程能否用于实际岗位,通常需要经过一段工作周期才能判断。主管看到的又是行为变化和工作结果,观察角度与学员不同。
因此,反馈机制可以拆分为三个阶段:
| 反馈阶段 | 触发时点 | 主要评价内容 | 典型回答者 |
|---|---|---|---|
IMMEDIATE | 课程完成后 | 内容质量、讲师表达、学习体验 | 学员 |
FOLLOW_UP | 完成一段时间后 | 岗位应用、应用障碍、补充需求 | 学员 |
MANAGER | 进入观察周期后 | 行为变化、能力改善、业务表现 | 主管 |
不同阶段应使用不同问卷。即时评价控制在 3 至 5 个量化题和一个开放问题,更利于回收;延迟回访重点询问“是否应用”和“为什么没有应用”;主管观察则只保留可观察、可描述的行为指标。把所有问题塞进一份长问卷,既会降低完成率,也会混淆统计口径。
二、统一数据模型:先记录答卷事实,再构建分析维度
原稿中的 training_feedback 以培训对象、用户和反馈阶段作为核心定位信息:
CREATE TABLE `training_feedback` (
  `id` bigint NOT NULL,
  `rel_type` varchar(16) NOT NULL COMMENT 'COURSE/TASK/LIVE',
  `rel_id` bigint NOT NULL,
  `user_id` bigint NOT NULL,
  `feedback_stage` varchar(16) NOT NULL COMMENT 'IMMEDIATE/FOLLOW_UP/MANAGER',
  `score` decimal(3,1) DEFAULT NULL,
  `content` text DEFAULT NULL,
  `gmt_create` datetime NOT NULL,
  PRIMARY KEY (`id`),
  UNIQUE KEY `uk_feedback` (`rel_type`, `rel_id`, `user_id`, `feedback_stage`)
) ENGINE=InnoDB COMMENT='培训反馈答卷';
这张表承担的是答卷事实记录:rel_type + rel_id 关联课程、任务或直播,feedback_stage 区分评价阶段,score 保存量化结果,content 保留开放建议。唯一索引保证同一用户对同一培训对象、同一阶段只有一份有效答卷。
如果问卷后续需要支持多个评分项,工程上宜将“答卷头”和“题目答案”拆分:答卷头负责关联培训对象、用户和阶段,答案明细负责保存题目、选项、分值或文本。这样可以在不反复修改主表字段的情况下扩展题型。这里属于扩展设计,不能仅凭当前原稿认定为已经上线的能力。
三、触发与回收:业务事件负责启动,数据库约束负责兜底
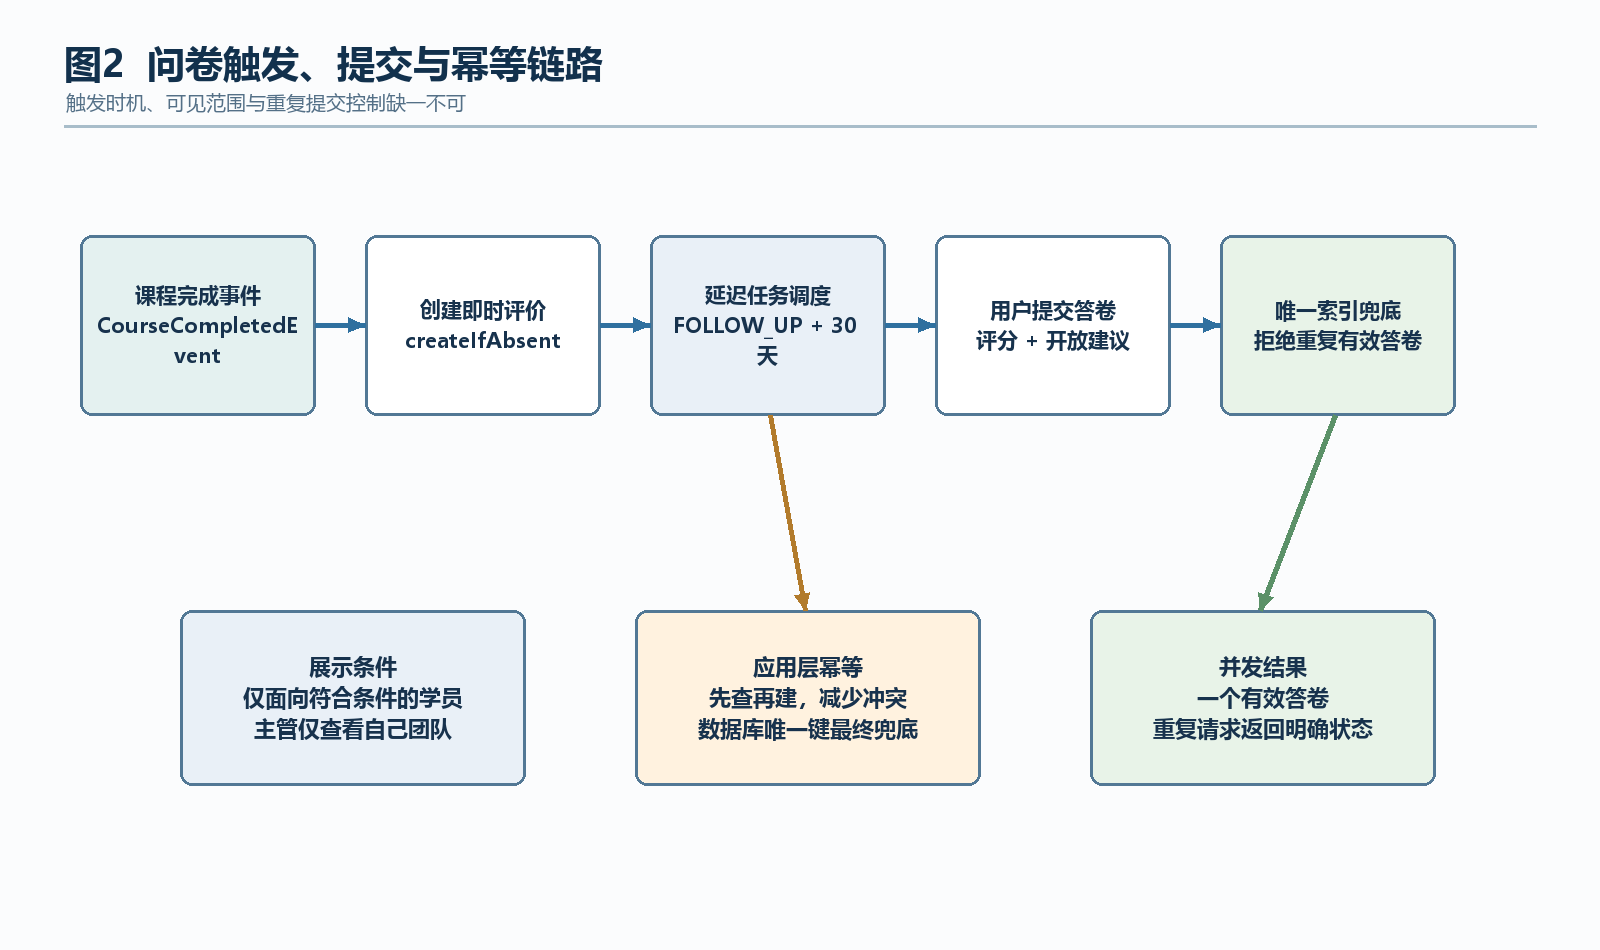
问卷不是越早发送越好,而是要在合适的业务时点创建,并且只对满足条件的人可见。课程完成事件可以创建即时评价任务,同时调度后续回访:
@EventListener
public void onCourseCompleted(CourseCompletedEvent event) {
    feedbackTaskService.createIfAbsent(
        event.getUserId(), event.getCourseId(), "IMMEDIATE"
    );
    delayedJobService.schedule(
        "FOLLOW_UP", event.getOccurredAt().plusDays(30), event
    );
}
createIfAbsent 解决应用层幂等,数据库唯一索引提供最终一致性保护。即使课程完成事件重复投递,或者用户连续点击提交,也不应产生两份有效答卷。并发冲突需要转换为明确的业务结果,而不是把数据库异常直接暴露给前端。
权限范围同样重要:学员只能查看和提交自己的评价任务;主管观察只应覆盖其管理范围内的成员;课程负责人查看汇总时,也应受组织和课程数据权限约束。反馈文本可能包含对讲师、课程或组织的评价,导出、查看和任务流转都需要留下审计记录。
四、统计口径:不要让一个平均分掩盖真实问题
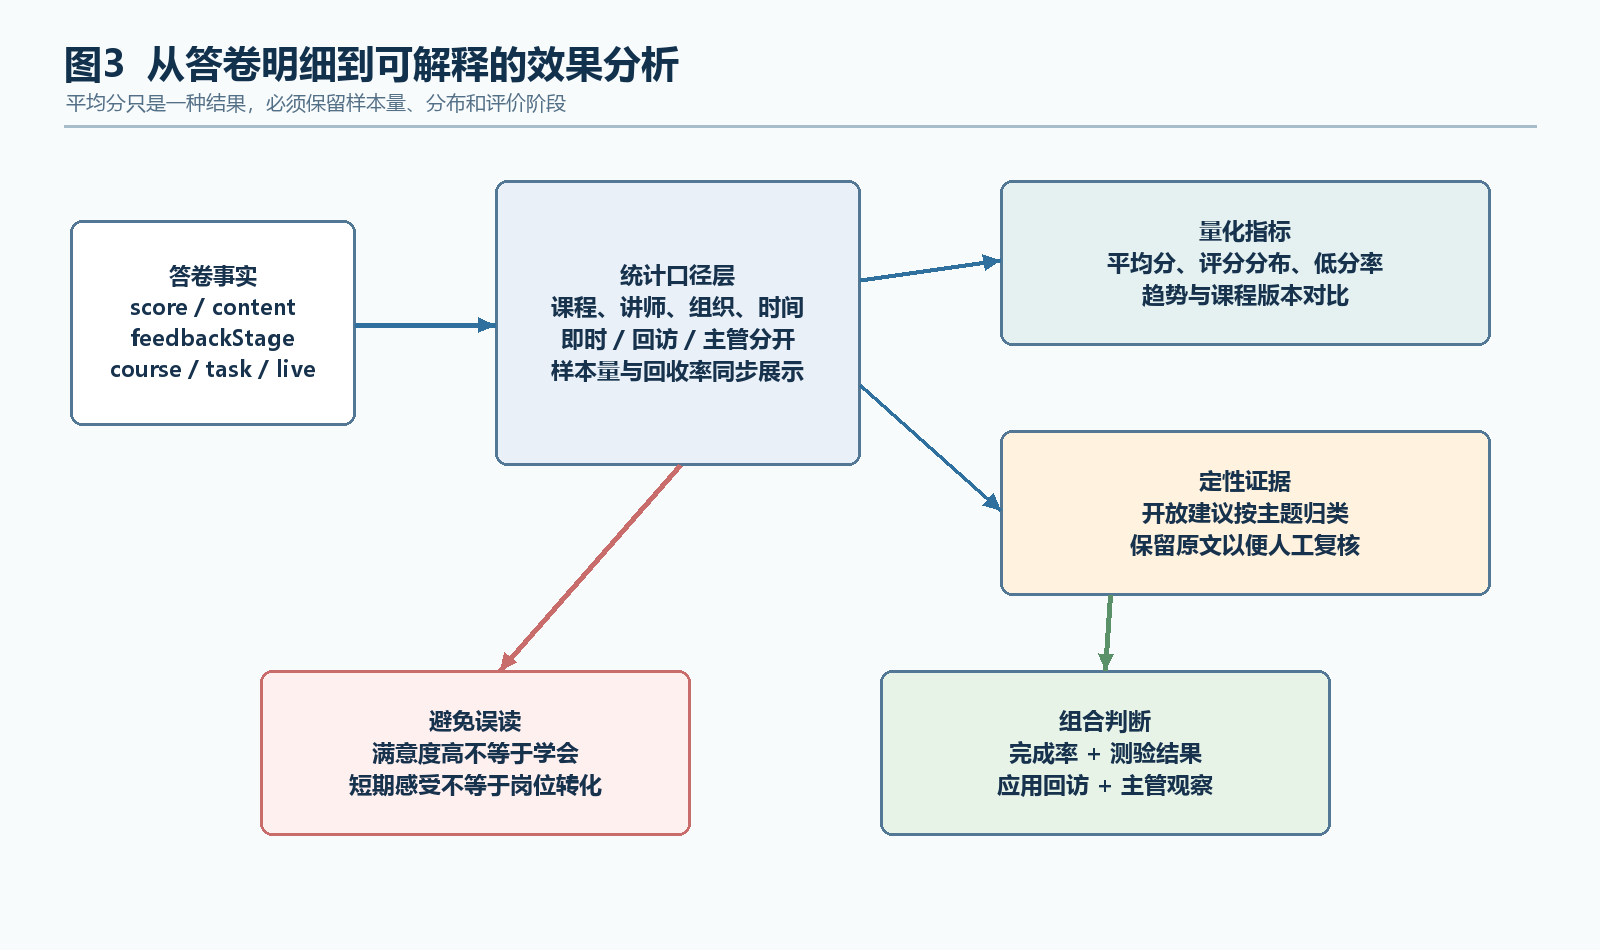
平台可以按课程、讲师、组织、时间和反馈阶段汇总数据,但不同阶段的评分不应直接混为一个总分。即时满意度反映当下感受,延迟回访反映应用情况,主管观察反映外部评价,三者测量的不是同一个对象。
一组可解释的统计结果至少应同时展示:
- 平均分和各评分区间分布,避免均值掩盖两极分化;
- 有效答卷数和符合条件人数,用于计算回收率;
- 低分比例及其对应的开放建议,便于定位具体原因;
- 按组织、课程、讲师和时间拆分的趋势;
- 课程版本号或改进批次,用于比较改进前后的变化。
开放文本适合做主题归类和高频问题汇总,但原始反馈仍应保留,方便运营人员复核上下文。自动归类只能辅助发现线索,不能在缺少人工确认时直接给讲师或课程定性。
五、问题闭环:反馈只有进入任务流才会产生行动
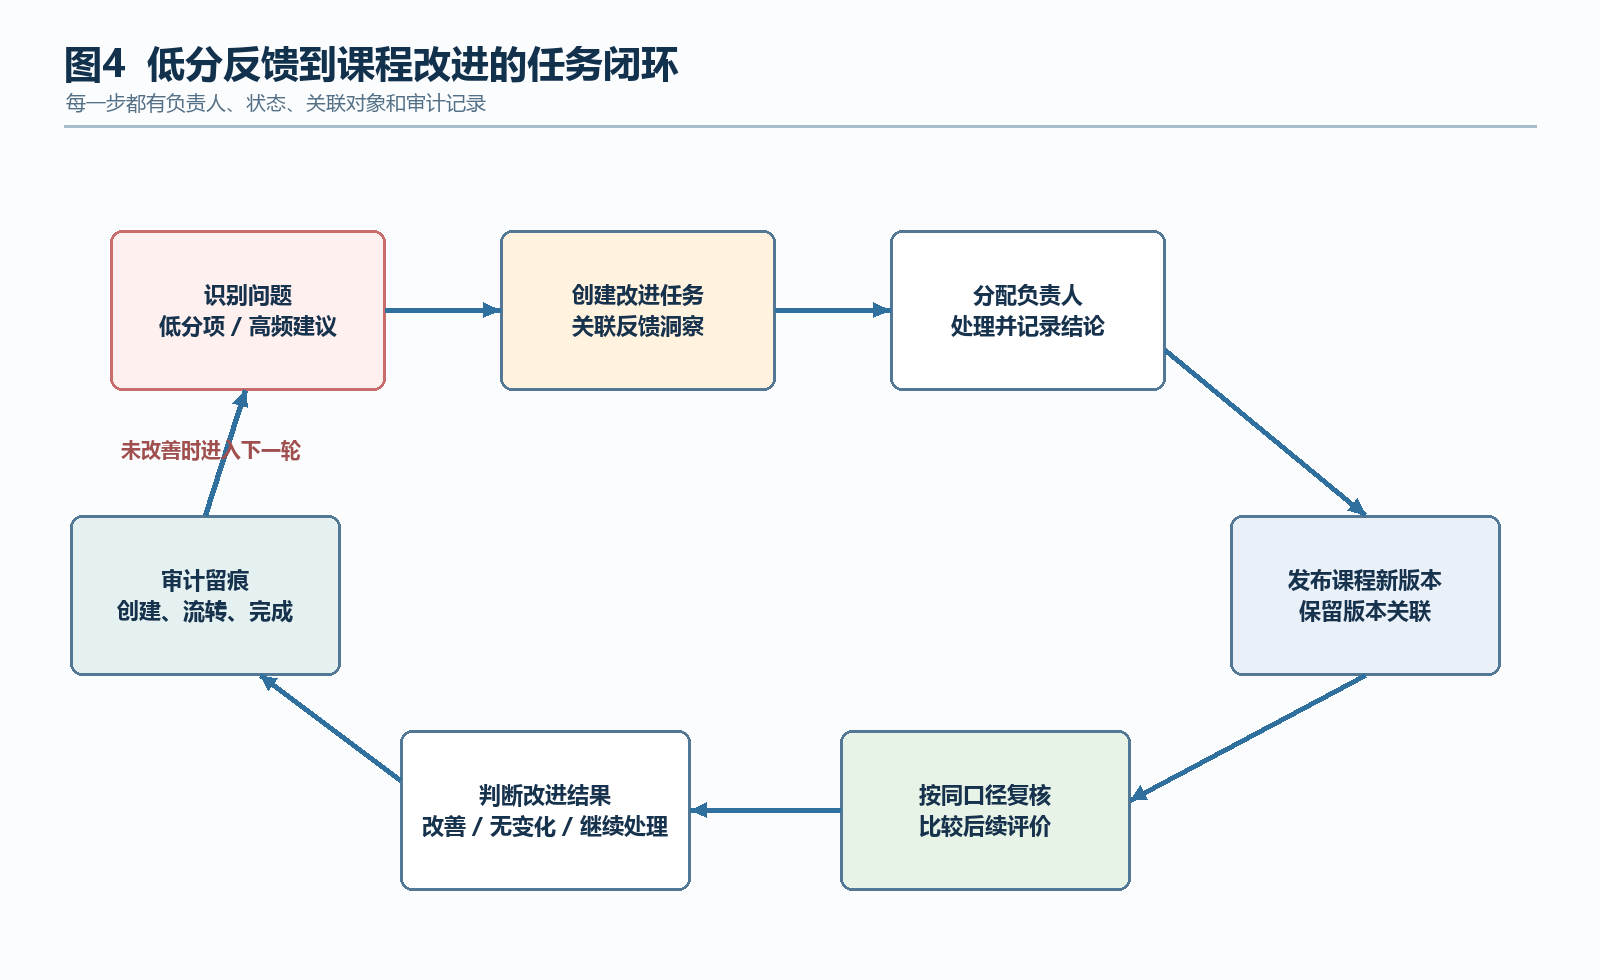
低分项或高频建议被确认后,可以创建改进任务并分配给课程负责人、讲师或运营人员。任务需要关联问题来源、处理负责人和课程对象,创建动作写入审计日志:
@Transactional
public void createImprovement(FeedbackInsight insight, Long ownerId) {
    ImprovementTask task = ImprovementTask.from(insight, ownerId);
    improvementTaskMapper.insert(task);
    auditLogService.record(
        ownerId, "FEEDBACK_IMPROVEMENT_CREATED", task.getId()
    );
}
当任务写入与审计写入使用同一数据源和同一事务时,@Transactional 才能保证两者原子提交;如果审计服务跨库或通过远程调用实现,则需要事件表、可靠消息等额外的一致性机制。任务完成不代表问题已经解决,还要把处理结果关联到新的课程版本,并在后续批次中使用相同统计口径复核。只有“问题识别、任务执行、版本发布、结果验证”都能追踪,反馈才真正形成闭环。
工程实现中还应防止两个常见问题:同一条洞察被重复创建多个任务,以及课程改版后失去原始反馈与旧版本之间的关联。任务创建需要业务幂等键或状态校验,版本关系需要保留,而不是覆盖旧课程数据。
六、满意度不是培训效果的全部
满意度高,可能只是课程表达流畅;考试分数高,也可能是题目难度偏低。评估培训价值时,应根据课程目标组合使用完成率、测验结果、应用回访和主管观察,而不是只追求一个更高的满意度分数。
对于知识传递型课程,测验结果和知识保持度更重要;对于岗位技能课程,延迟回访和主管观察更有解释力;对于合规课程,完成情况和考试达标可能是核心指标。指标选择应服务于培训目标,而不是让所有课程套用同一张评分表。
七、可观测性与数据边界
反馈系统上线后,建议持续观察问卷创建成功率、到期任务数量、答卷回收率、重复提交冲突数、低分任务创建量、任务平均处理时长和改进后评分变化。这些指标能够区分“学员不愿填写”“触发链路失败”和“问题长期无人处理”等不同情况。
同时需要明确当前原稿能够确认的边界:系统描述了分阶段反馈、延迟任务、汇总分析和改进任务,但没有给出匿名问卷、自动文本分析、自动消息通知等实现细节。因此,这些能力不能在对外介绍中直接宣称已经支持;如需上线,应另行补充身份隔离、算法审核、通知重试和数据脱敏设计。
八、总结
织码在线教育系统的培训评估思路,不是把问卷当作培训结束后的附加动作,而是把它连接到课程、讲师、组织、反馈阶段和课程版本:业务事件触发评价任务,唯一索引保证答卷幂等,多维统计定位问题,改进任务承接处理过程,后续评价验证改进结果。
真正有价值的反馈系统,不只告诉管理者“大家打了多少分”,还要说明问题出现在哪里、由谁处理、改了什么,以及下一轮是否变得更好。
如需私有化部署报价、远程产品演示,可访问官网 https://www.weavecodes.com/ ,私信作者领取企业落地案例。
的反馈系统,不只告诉管理者“大家打了多少分”,还要说明问题出现在哪里、由谁处理、改了什么,以及下一轮是否变得更好。
如需私有化部署报价、远程产品演示,可访问官网 https://www.weavecodes.com/ ,私信作者领取企业落地案例。


 扫一扫


 324

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


