HDFS存储与架构

HDFS存储模型

  • 以字节形式存储
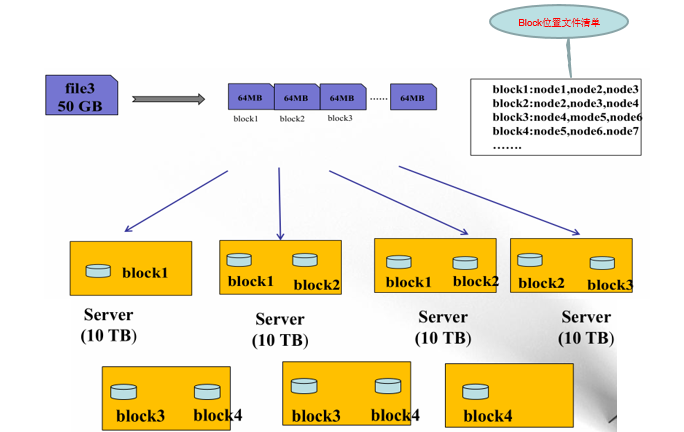
  • 文件线性切割成块(Block):偏移量 offset (byte)
  • Block分散存储在集群节点中
  • 单一文件Block大小一致,文件与文件可以不一致
  • Block可以设置副本数,副本无序分散在不同节点中
  • 副本数不要超过节点数量
  • 文件上传可以设置Block大小和副本数(资源不够开辟的进程)
  • 已上传的文件Block副本数可以调整,大小不变(2.x 128MB 3 blocks)
  • 只支持一次写入多次读取,同一时刻只有一个写入者
  • 可以append追加数据

HDFS架构模型

  • 文件元数据MetaData,文件数据    
    • 元数据
    • 数据本身
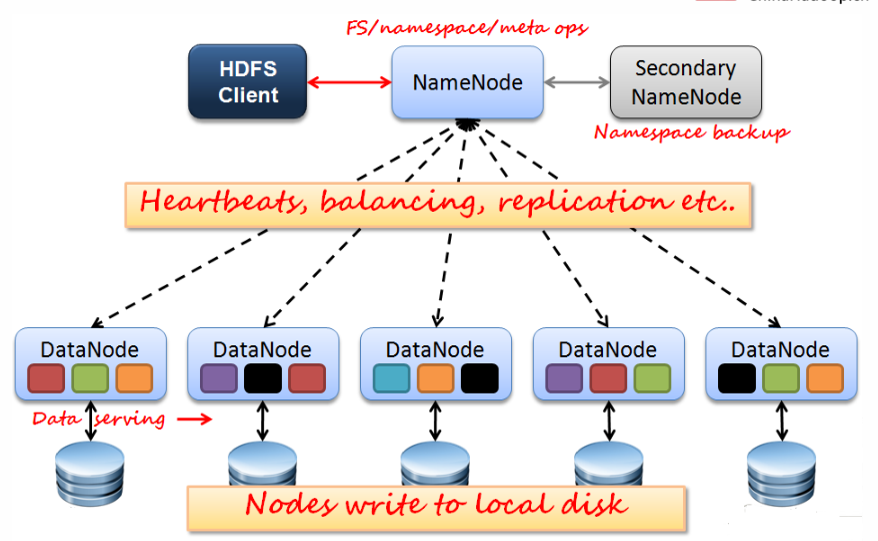
  • NameNode(主)节点保存文件元数据:单节点   posix
  • DataNode(从)节点保存文件Block数据:多节点
  • DataNode与NameNode保持心跳,提交Block列表
  • HdfsClient与NameNode交互元数据信息
  • HdfsClient与DataNode交互文件Block数据(cs)
  • DataNode 利用服务器本地文件系统存储数据块

HDFS架构图

HDFS设计思想

  • 分散均匀存储 dfs.blocksize = 128M
  • 备份冗余存储 dfs.replication = 3


NameNode(NN)

  • 基于内存存储 :不会和磁盘发生交换(双向)
    • 只存在内存中
    • 持久化(单向)
  • NameNode主要功能:
    • 接受客户端的读写服务
    • 收集DataNode汇报的Block列表信息
  • NameNode保存metadata信息包括
    • 文件owership和permissions
    • 文件大小,时间
    • (Block列表:Block偏移量),位置信息(持久化不存)
    • Block每副本位置(由DataNode上报)

NameNode持久化

  • NameNode的metadata信息在启动后会加载到内存
  • metadata存储到磁盘文件名为”fsimage”(时点备份)
  • Block的位置信息不会保存到fsimage
  • edits记录对metadata的操作日志…>Redis
  • 二者的产生时间和过程?(format)

SecondaryNameNode(SNN)

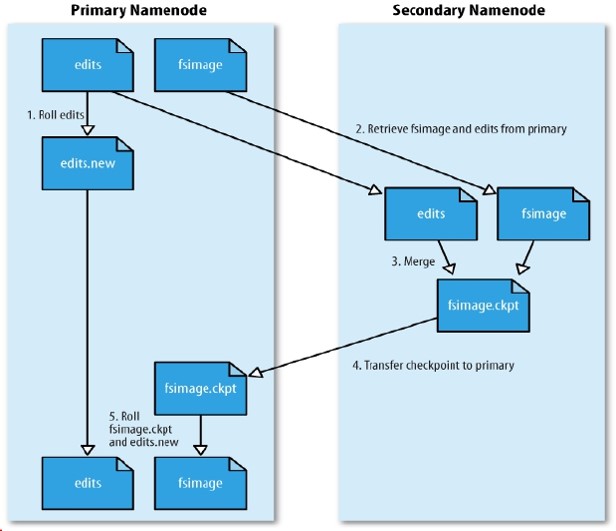
  • 它不是NN的备份(但可以做备份),它的主要工作是帮助NN合并edits log,减少NN启动时间。
  • SNN执行合并时机
    • 根据配置文件设置的时间间隔fs.checkpoint.period  默认3600秒
    • 根据配置文件设置edits log大小 fs.checkpoint.size 规定edits文件的最大值默认是64MB    

SNN合并流程图

DataNode(DN)

  • 本地磁盘目录存储数据(Block),文件形式
  • 同时存储Block的元数据信息文件
  • 启动DN时会向NN汇报block信息
  • 通过向NN发送心跳保持与其联系(3秒一次),如果NN 10分钟没有收到DN的心跳,则认为其已经lost,并copy其上的block到其它DN

HDFS优点

  • 高容错性
    • 数据自动保存多个副本
    •  副本丢失后,自动恢复
  • 适合批处理
    • 移动计算而非数据
    • 数据位置暴露给计算框架(Block偏移量)
  • 适合大数据处理
    • GB 、TB 、甚至PB 级数据
    • 百万规模以上的文件数量
    • 10K+ 节点
  • 可构建在廉价机器上
    • 通过多副本提高可靠性
    • 提供了容错和恢复 机制

HDFS缺点

  • 低延迟数据访问
    • 比如毫秒级
    • 低延迟与高吞吐率
  • 小文件存取
    • 占用NameNode 大量内存
    • 寻道时间超过读取时间
  • 并发写入、文件随机修改
    • 一个文件只能有一个写者
    • 仅支持append

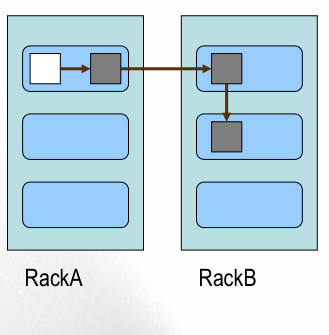
Block的副本放置策略

  • 第一个副本:放置在上传文件的DN;如果是集群外提交,则随机挑选一台磁盘不太满,CPU不太忙的节点。
  • 第二个副本:放置在于第一个副本不同的 机架的节点上。
  • 第三个副本:与第二个副本相同机架的节点。
  • 更多副本:随机节点


转载于:https://www.cnblogs.com/dragon-123/p/11182224.html

大数据领域HDFS存储分层架构设计 HDFS(Hadoop Distributed File System)脱胎于Google File System(GFS)的设计思想,自2006年伴随Hadoop诞生以来,一直是大数据批处理场景的"存储基石"。其核心目标是支持PB级数据的高可靠、高吞吐量存储成本高企:3副本策略导致存储利用率仅33%,全用高性能SSD存储PB级数据的成本难以承受;性能浪费。 阅读详情

相关推荐

HDFS】系统架构存储机制

系统架构存储机制 HDFS系统架构 HDFS是主从架构(Master/Slave),当然这也是大数据产品最常见的架构。主节点为NameNode,从节点为DataNode。其中DataNode用于存储数据,存储的数据会被拆分成Block块(默认按照128M进行切分),然后均匀的存放到各个DataNode节点中,为了保证数据安全性,这些Block块会进行多副本的存储,备份到不同的节点。而NameNode则负责管理整个集群,并且存储数据的元数据信息(记录数据被拆分为哪几块,分别存储到了哪个DataNode中)

pengpengsays 325

Hadoop基础——HDFS基础

Hadoop基础——HDFS HDFS简介: HDFS (Hadoop)分布式文件管理系统:基于Java的分布式文件系统允许文件通过网络在多台机器上分享的文件系统可以让多机器上的多用户分享文件和存储空间,适用于一次写入,多次查询,但是不支持并发写,不适合小文件。 HDFS: ...

BinBin_Jun的博客 505

大数据架构中的存储选择:HDFS vs S3 vs 对象存储

在大数据时代,选择合适的存储解决方案是构建高效数据处理平台的基础。理解HDFS、S3和对象存储的核心架构差异掌握不同存储方案的性能特性和限制根据业务需求选择最合适的存储解决方案了解混合存储架构的设计思路本文讨论范围涵盖存储架构的基本原理、性能基准测试、成本分析以及实际应用案例,但不涉及特定厂商产品的详细配置指南。背景介绍:阐述文章目的和读者定位核心概念联系:详细解析三种存储方案的架构原理技术对比分析:从多个维度进行深入比较性能测试优化:实际性能数据和调优建议。

架构师的AI之路,分享AI应用开发架构的学习与实践。 926

HDFS架构

HDFS概念:Hadoop Distributed File System,是Hadoop项⽬的核⼼⼦项⽬,是分布式计算中数据存储管理的基础。⽀持海量数据的存储,允许⽤户将成百上千的计算机组成存储集群,HDFS 可以运⾏在低成本的硬件上,提供⾼吞吐量、⾼容错性的数据访问,⾮常适合⼤规模数据集上的应⽤。②HDFS优缺点:HDFS优点:高容错性(多个副本且副本丢失可快速恢复);处理大数据;高扩展性(动态扩展集群节点);低成本运行;HDFS缺点:不适合低延时的数据访问;不适合存储大量小文件;

qq_57629191的博客 1904

大数据学习笔记-HDFS(四)——HDFS架构

Hadoop Distribute File System,Hadoop分布式文件系统,HDFS是Hadoop核心组件之一,作为生态圈最底层的分布式服务而存在。HDFS解决的问题就是大数据如何存储架构图:主从架构(master/slave)。通常包含一个主节点和多个从节点。主节点存储和管理namespace,即文件块、位置、权限、大小、其实地址等等,从节点存储文件数据块。

zhang_232的专栏 2267

HDFS组织架构及相关介绍

通过这种机制,Secondary NameNode维护了一个较小的fsimage和edits日志来加速HDFS集群的恢复速度和故障恢复能力,在NameNode崩溃时提供备份数据,同时减少NameNode服务器的压力,在大规模HDFS集群中发挥着重要作用。在非首次启动时,Namenode的工作流程首次启动时类似。为了解决这个问题,Hadoop引入了Secondary NameNode,在内存中定期备份和合并NameNode的元数据,并将其写入本地磁盘中,而不会对NameNode的进程进行任何干扰或负担。

qq_45450889的博客 1724

【分布式存储系统HDFS架构和使用

HDFS是Apache Hadoop项目的一部分,专为大规模数据存储设计。它通过分布式架构,实现了高可靠性、高吞吐量的数据存储和访问,能够处理PB级别的数据量。HDFS采用主从架构,主要由NameNode和DataNode构成。

weixin_39372311的博客 933

Hadoop核心组成部分、HDFS存储模型和架构模型总结

Hadoop核心组成部分 (1)Hadoop Common:用来支撑其他模块的公共工具包 (2)HDFS: 一种分布式文件系统,提供对应用程序数据的高吞吐量访问。 (3)Hadoop Yarn:作业调度和集群资源管理的框架。 (4)Hadoop MapReduce:基于YARN的系统,用于并行处理大型数据集。 HDFS存储模型 存储模型:字节(一个文件就是一个字节数组)  ①block块产生:文件...

SlimShadyKe的博客 2054

HDFS存储架构剖析以及读写流程

HDFS存储架构主要由三部分组成:NameNode,DataNode,Client NameNode Namenode 是一个中心服务器,单一节点(简化系统的设计和实现),负责管理文件系统的名字空间(namespace)以及客户端对文件的访问。 文件操作,NameNode 负责文件元数据的操作,DataNode负责处理文件内容的读写请求,跟文件内容相关的数据流不经过NameN...

TNTZS666的博客 533

浅谈分布式存储架构: IPFS和HDFS

分布式存储架构是一个复杂的系统工程,针对特定应用的数据存储有不同的系统架构解决方案。不同的存储方法会影响存储性能、存储成本、冗余度、工程复杂性等。 分布式存储的历史 分布式存储最早是由谷歌提出的,其目的是通过廉价的服务器来解决大规模,高并发场景下的 Web 访问问题。它采用可扩展的系统结构,利用多台存储服务器分担存储负荷,利用位置服务器定位存储信息,它不但提高了系统的可靠性、可用性和存取效率,还易于后期服务器扩展。 分布式存储的崛起 分布式存储的兴起互联网的发展密不可分,互联网公司由于其大数据

连志安 6870

剖析大数据领域 HDFS 的数据存储架构演进

在大数据时代,数据量呈现爆炸式增长,传统的文件系统难以满足海量数据的存储和管理需求。HDFS 作为 Apache Hadoop 项目的核心组件之一,旨在提供一个高容错、高吞吐量的分布式文件系统,能够在廉价的硬件集群上存储和处理大规模数据。本文的目的是深入剖析 HDFS 数据存储架构的演进过程,涵盖从 HDFS 1.0 到 HDFS 3.0 以及未来可能的发展方向,分析其架构设计的变化、优势和面临的挑战。本文将按照以下结构进行组织:首先介绍 HDFS 的核心概念联系,包括架构原理和流程图;

AI天才研究院 574

hdfs深入:03、hdfs架构以及副本机制和block块存储

HDFS分布式文件系统设计目标 1、 硬件错误 由于集群很多时候由数量众多的廉价机组成,使得硬件错误成为常态 2、 数据流访问 所有应用以流的方式访问数据,设置之初便是为了用于批量的处理数据,而不是低延时的实时交互处理 3、 大数据集 典型的HDFS集群上面的一个文件是以G或者T数量级的,支持一个集群当中的文件数量达到...

weixin_30537451的博客 169

Flink基于HDFS存储架构设计和核心技术实现

胡弦,视频号2023年度优秀创作者,互联网大厂P8技术专家,Spring Cloud Alibaba微服务架构实战派(上下册)和RocketMQ消息中间件实战派(上下册)的作者,资深架构师,技术负责人,极客时间训练营讲师,四维口袋KVP最具价值技术专家,技术领域专家团成员,2021电子工业出版社年度优秀作者,获得2023电子工业出版技术成长领路人称号,荣获2024年电子工业出版社博文视点20周年荣誉专家称号。

huxian1234的专栏 1590

HDFS 架构深度解析:大数据存储的基石

在当今的大数据时代,数据量呈现出爆炸式的增长。传统的文件系统已经无法满足海量数据的存储和管理需求。HDFS 作为一种分布式文件系统,为大数据存储提供了强大的支持。本文的目的就是详细解析 HDFS架构,让大家了解它是如何工作的,适用于哪些场景。我们将涵盖 HDFS 的核心概念、组件关系、算法原理、实际应用等方面的内容。本文将按照以下结构进行阐述:首先介绍 HDFS 的核心概念联系,用故事和生活实例引出主题,并解释核心概念;接着讲解核心算法原理和具体操作步骤,结合源代码进行说明;然后介绍数学模型和公式;

AI智能探索者的博客 649

hdfs的副本数为啥增加了_2.hadoop-hdfs 存储架构模型、角色、持久化

思路概述单节点处理大数据,可以做。磁盘IO的次数决定计算时间的长短。需求:查找重复行,全排序归并排序内部有序,外部无需--->归并排序集群并行:提升速度的关键分布式运行计算数据在一起-计算向数据移动最低要求:快速排序,归并排序hadoop-HDFS存储模型字节-文件线性分割成块(Block)偏移量offset (byte)-Block分散存储在集群节点中-单一文件Block大小一致,文件...

weixin_29333353的博客 167

大数据领域 HDFS 的数据存储系统架构设计

在大数据时代,数据量呈现爆炸式增长,传统的文件系统难以应对大规模数据的存储和管理需求。HDFS 作为 Hadoop 生态系统中的核心组件,旨在为大数据提供高可靠性、高扩展性、高吞吐量的数据存储解决方案。本文的目的是深入探讨 HDFS 数据存储系统的架构设计,涵盖其核心概念、算法原理、数学模型、实际应用等方面,帮助读者全面了解 HDFS 的工作机制和架构特点。范围包括 HDFS 的基本原理、架构设计细节、开发实践以及未来发展趋势等内容。

2502_91592937的博客 1043
上一篇: 租用游艇问题
下一篇: spring cloud微服务之间的调用
weixin_30644369
博客等级 码龄11年 147粉丝 1382原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符  | 博主筛选后可见
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

红包个数最小为10个

红包金额最低5元

当前余额3.43前往充值 >
需支付:10.00
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值