


Jetson Orin arm64架构搭建手写AI tensorRT_Pro项目环境
0 引言
tensorRT是nvidia发布的dnn推理引擎,是针对nvidia系列硬件进行优化加速,实现最大程度的利用GPU资源,提升推理性能。
手写AI:tensorRT_Pro项目是在tensorRT的基础上,提出的一套从onnx( pytorch etc.)到TRT Engine模型推理的解决方案。
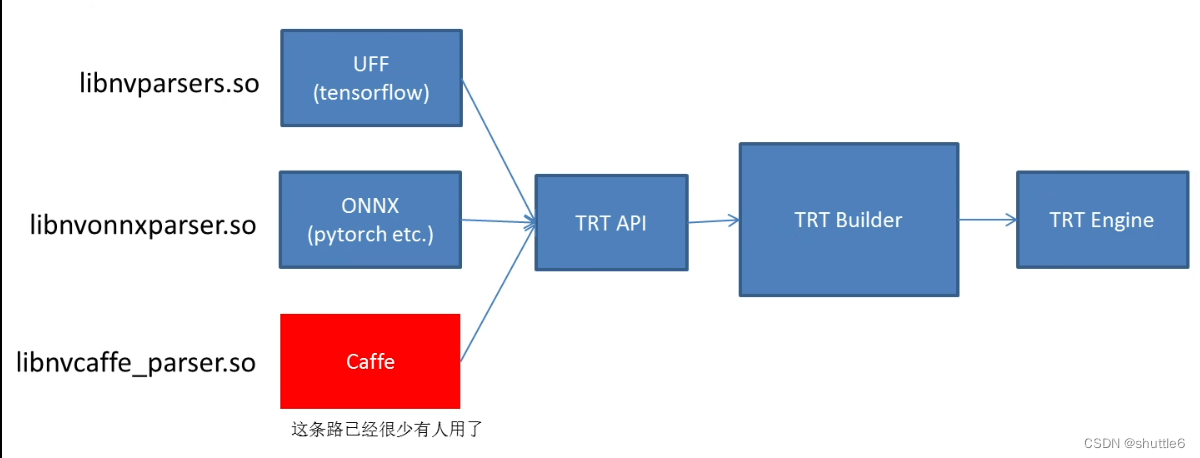
但是该方案目前主要支持的是linux x86_64的系统以及windows的系统,其实也支持jetson nano、orin等arm架构,不过网上相关资料较少,因此,记录一下将该项目部署在nvidia jetson orin边缘设备上。
一、项目下载
github : https://github.com/shouxieai/tensorRT_Pro
git clone https://github.com/shouxieai/tensorRT_Pro.git
bilibili课程:https://www.bilibili.com/video/BV1Xw411f7FW?p=1
或者
使用trtpy进行拉取更多案例
conda activate yourenv
pip install -U trtpy -i https://pypi.tuna.tsinghua.edu.cn/simple
# 最近清华源可能会连接超时,可以使用一下魔法
echo alias trtpy=\"python -m trtpy\">>~/.bashrc && source ~/.bashrc

conda activate yourenv
trtpy set-key [your key]
# your key请添加手写ai微信号:shouxie_ai。获取临时key,有效期大约一周
trtpy get-templ learn-unet-cpp
cd learn-unet-cpp
# 这里以learn-unet-cpp为例子进行环境配置
# 其实tensorRT_Pro也差不多,后面有时间把tensorRT_Pro补上
拉取后文件结构:
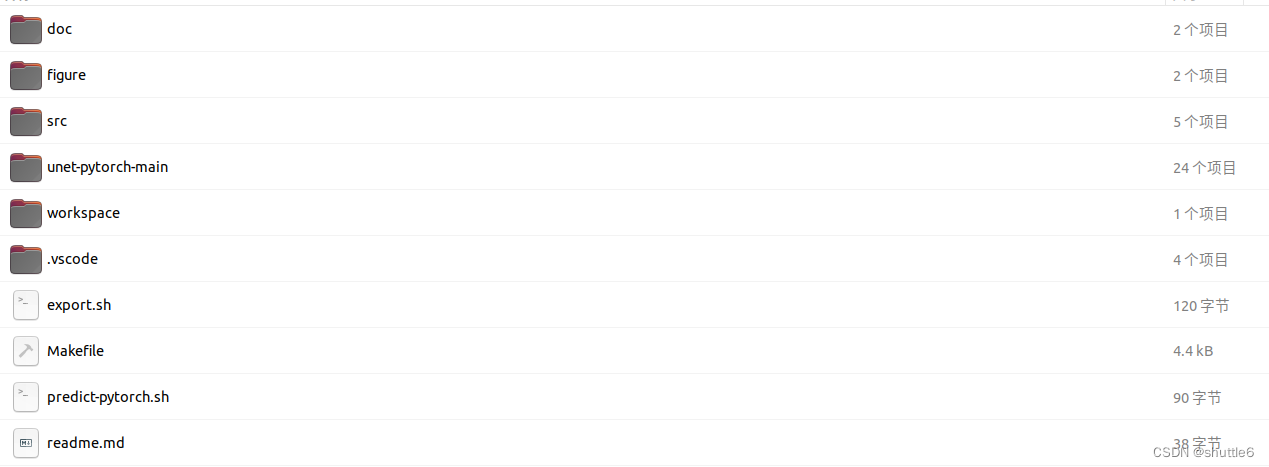 使用learn-unet-cpp测试的话在编译过程还需要将tensorRT_Pro项目中的
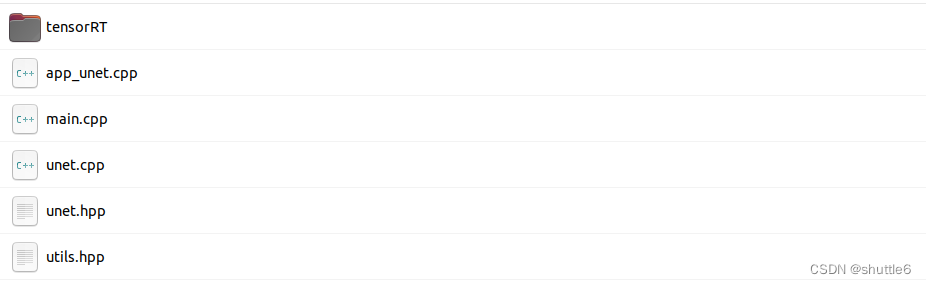
tensorRT_Pro/src/tensorRT/ 下的文件拷贝到learn-unet-cpp/src/tensorRT目录下。或者在编写makefile文件时在include内包含进去。
二、环境依赖安装
配置tensorRT_Pro的项目最核心的就是makefile文件的修改,但是首先得保证你的jetson设备上已经安装了opencv、tensorRT、cuda、cudnn、protobuf, 正常在购买jetson设备后进行刷机会将jetpack刷进去(protobuf除外),自然就会包含这些库,protobuf需要人为手动编译安装。tensorRT_Pro项目需要的依赖版本如下:
CUDA10.1
CUDNN8.2.2.26
OpenCV3.4.6 or 4.x
the above three are modifiable as long as being compatible to TensorRT
Protobuf3.11.4
tensorrt-8.0.1.6
# 其中cuda、cudnn、opencv版本可以修改,适配 TensorRT即可,protobuf版本不建议修改,否则会有可能出现问题
可以使用下面命令判断是否已经进行安装。
1、判断cuda是否安装
nvcc -V
如果出现下列情况证明安装成功
nvcc: NVIDIA (R) Cuda compiler driver
Copyright (c) 2005-2022 NVIDIA Corporation
Built on Sun_Oct_23_22:16:07_PDT_2022
Cuda compilation tools, release 11.4, V11.4.315
Build cuda_11.4.r11.4/compiler.31964100_0
2、判断cudnn是否安装
dpkg -l libcudnn8
如果出现下列情况证明安装成功
期望状态=未知(u)/安装(i)/删除(r)/清除(p)/保持(h)
| 状态=未安装(n)/已安装(i)/仅存配置(c)/仅解压缩(U)/配置失败(F)/不完全安装(H)/触>
|/ 错误?=(无)/须重装(R) (状态,错误:大写=故障)
||/ 名称           版本                 体系结构     描述
+++-==============-====================-============-==========================>
ii  libcudnn8      8.6.0.166-1+cuda11.4 arm64        cuDNN runtime libraries
lines 1-6/6 (END)
3、判断tensorrt是否安装
dpkg -l tensorrt
如果出现下列情况证明安装成功
期望状态=未知(u)/安装(i)/删除(r)/清除(p)/保持(h)
| 状态=未安装(n)/已安装(i)/仅存配置(c)/仅解压缩(U)/配置失败(F)/不完全安装(H)/触>
|/ 错误?=(无)/须重装(R) (状态,错误:大写=故障)
||/ 名称           版本               体系结构     描述
+++-==============-==================-============-============================>
ii  tensorrt       8.5.2.2-1+cuda11.4 arm64        Meta package for TensorRT
lines 1-6/6 (END)
4、判断opencv是否安装
dpkg -l libopencv
如果出现下列情况证明安装成功
期望状态=未知(u)/安装(i)/删除(r)/清除(p)/保持(h)
| 状态=未安装(n)/已安装(i)/仅存配置(c)/仅解压缩(U)/配置失败(F)/不完全安装(H)/触>
|/ 错误?=(无)/须重装(R) (状态,错误:大写=故障)
||/ 名称           版本                体系结构     描述
+++-==============-===================-============-===========================>
ii  libopencv      4.5.4-8-g3e4c170df4 arm64        Open Computer Vision Library
lines 1-6/6 (END)
上面四个步骤如果有疑问请参考这篇博客:
判断jetpack环境是否安装好:https://blog.csdn.net/qq_42178122/article/details/129101682
刷机教程:https://blog.csdn.net/weixin_44921896/article/details/127361741
5、protobuf交叉编译安装
注意正常刷机时protobuf并不会安装,需要进行手动编译安装,一般如果已安装的话可以在/usr/include/google/protobuf路径可以找到。如果没有安装可以参考这篇博客进行安装。
5.1 源码下载
github下载源码 GitHub - protocolbuffers/protobuf: Protocol Buffers - Google’s data interchange format
下载3.11版本
5.2 编译步骤
cd protobuf-3.11.x
 ./autogen.sh
如果出错的话 apt-get install这些(一般不会出错):
autoconf
automake
ibtool
make
g++
unzip
5.3 交叉编译
# 还是protobuf-3.11.x目录
# /PATH 是你交叉编译工具链所在的路径  --prefix为交叉编译后文件的路径.
# 我的路径是:/usr/bin/aarch64-linux-gnu-gcc , /usr/bin/aarch64-linux-gnu-g++
./configure --host=arm-linux CC=/PATH/aarch64-linux-gnu-gcc CXX=/PATH/aarch64-linux-gnu-g++ --prefix=/home/xxx/protobuf/install
make -j
make install
这一步我没遇到什么bug,如果遇到问题建议百度找找。编译后在/home/xxx/protobuf/install路径下会有以下几个文件。

这几个文件路径在后面makefile文件中会用到。
注意上面的关于protobuf的版本一定不要随便更改,如果要更改请参考原项目readme.md。
不然可能会报下列bug:
fatal error: google/protobuf/generated_message_table_driven.h: 没有那个文件或目录
很明显是有部分文件没找到,这个与protobuf版本有关系。
三、核心:makefile文件的修改
接下来就是最主要也是最重要的步骤,最好知道一些makefile基础命令。
从trtpy拉取下来的learn-unet-cpp原始的makefile文件内容如下:
cc        := g++
name      := pro
workdir   := workspace
srcdir    := src
objdir    := objs
stdcpp    := c++11
cuda_home := /home/liu/anaconda3/envs/py/lib/python3.8/site-packages/trtpy/trt8cuda115cudnn8
cpp_pkg   := /home/liu/anaconda3/envs/py/lib/python3.8/site-packages/trtpy/cpp-packages
trtpro_inc := /home/liu/anaconda3/envs/py/lib/python3.8/site-packages/trtpy/include
trtpro_lib := /home/liu/anaconda3/envs/py/lib/python3.8/site-packages/trtpy/trt8cuda115cudnn8/py38
syslib    := /home/liu/anaconda3/envs/py/lib/python3.8/site-packages/trtpy/lib
cuda_arch :=
nvcc      := $(cuda_home)/bin/nvcc -ccbin=$(cc)

# 定义cpp的路径查找和依赖项mk文件
cpp_srcs := $(shell find $(srcdir) -name "*.cpp")
cpp_objs := $(cpp_srcs:.cpp=.cpp.o)
cpp_objs := $(cpp_objs:$(srcdir)/%=$(objdir)/%)
cpp_mk   := $(cpp_objs:.cpp.o=.cpp.mk)

# 定义cu文件的路径查找和依赖项mk文件
cu_srcs := $(shell find $(srcdir) -name "*.cu")
cu_objs := $(cu_srcs:.cu=.cu.o)
cu_objs := $(cu_objs:$(srcdir)/%=$(objdir)/%)
cu_mk   := $(cu_objs:.cu.o=.cu.mk)

# 定义opencv和cuda需要用到的库文件
link_opencv    := opencv_core opencv_imgproc opencv_imgcodecs
link_cuda      := cudart cudnn
link_trtpro    := trtpro protobuf
link_tensorRT  := nvinfer nvparsers nvinfer_plugin
link_sys       := stdc++ dl
link_librarys  := $(link_opencv) $(link_cuda) $(link_tensorRT) $(link_sys) $(link_trtpro)

# 定义头文件路径,请注意斜杠后边不能有空格
# 只需要写路径,不需要写-I
include_paths := src              \
    $(cuda_home)/include/cuda     \
	$(cuda_home)/include/tensorRT \
	$(cuda_home)/include/protobuf \
	$(cpp_pkg)/opencv4.2/include  \
	$(trtpro_inc)

# 定义库文件路径,只需要写路径,不需要写-L
library_paths := $(cuda_home)/lib64 $(trtpro_lib) $(syslib) $(cpp_pkg)/opencv4.2/lib

# 把library path给拼接为一个字符串,例如a b c => a:b:c
# 然后使得LD_LIBRARY_PATH=a:b:c
empty :=
library_path_export := $(subst $(empty) $(empty),:,$(library_paths))

# 把库路径和头文件路径拼接起来成一个,批量自动加-I、-L、-l
run_paths     := $(foreach item,$(library_paths),-Wl,-rpath=$(item))
include_paths := $(foreach item,$(include_paths),-I$(item))
library_paths := $(foreach item,$(library_paths),-L$(item))
link_librarys := $(foreach item,$(link_librarys),-l$(item))

# 如果是其他显卡,请修改-gencode=arch=compute_75,code=sm_75为对应显卡的能力
# 显卡对应的号码参考这里:https://developer.nvidia.com/zh-cn/cuda-gpus#compute
# 如果是 jetson nano,提示找不到-m64指令,请删掉 -m64选项。不影响结果
cpp_compile_flags := -std=$(stdcpp) -w -g -O0 -m64 -fPIC -fopenmp -pthread
cu_compile_flags  := -std=$(stdcpp) -w -g -O0 -m64 $(cuda_arch) -Xcompiler "$(cpp_compile_flags)"
link_flags        := -pthread -fopenmp -Wl,-rpath='$$ORIGIN'
其实文件后面还有一些内容,但是无所谓,那些不需要进行修改。
注意:你拉取这个测试案例的时候可能下面这几个路径都是空的,这个路径是我在x86_64 ubuntu系统下测试的时候,因为使用的是一键安装环境时自动修改的,我直接将这个项目拷贝到jetson orin内。
所以,如果使用的是服务器,还是非常推荐作者提供的一键安装环境功能的,具体可以看这个bilibili教程。
接下来下面这些目录就是我们一会需要进行修改的地方。
cuda_home := /home/liu/anaconda3/envs/py/lib/python3.8/site-packages/trtpy/trt8cuda115cudnn8
cpp_pkg   := /home/liu/anaconda3/envs/py/lib/p这个路径ython3.8/site-packages/trtpy/cpp-packages
trtpro_inc := /home/liu/anaconda3/envs/py/lib/python3.8/site-packages/trtpy/include
trtpro_lib := /home/liu/anaconda3/envs/py/lib/python3.8/site-packages/trtpy/trt8cuda115cudnn8/py38
syslib    := /home/liu/anaconda3/envs/py/lib/python3.8/site-packages/trtpy/lib
首先我们得知道这些目录表示的是什么意思
cuda_home := cuda目录,该目录下包含了cuda、cudnn、tensorrt、protobuf头文件和库文件
cpp_pkg   := opencv目录,该目录包含了opencv头文件和库文件
trtpro_inc := tensorRT_Pro头文件目录
trtpro_lib := tensorRT_Pro库文件目录
syslib    := 系统库文件目录
这里我们由于是在jetson orin arm64系统下,作者没有提供该系统下tensorRT_Pro编译好的链接库,所以需要我们重新编译。
其他目录修改为orin对应下的目录即可。我这里修改的为:
cuda_home := /usr/local/cuda-11.4
cuda_lib   := /usr/local/cuda-11.4/lib64
sys_inc    := /usr/include
protobuf_inc := /home/liu/protobuf/install/include
syslib     := /usr/lib/aarch64-linux-gnu
protobuf_lib := /home/liu/protobuf/install/lib
cuda头文件和库文件目录不需要解释,注意:系统文件sys_inc 目录中会包含opencv头文件目录,其下面的aarch64-linux-gnu会包含tensorrt、cudnn头文件目录。syslib 目录包含所有与sys_inc对应的opencv、tensorrt、cudnn库文件。
protobuf_inc、protobuf_lib路径为2.5节安装的protobuf路径。
其中,tensorRT_Pro目录将会在include_paths包含进去进行编译。
修改后的makefile文件如下所示:
cc        := g++
name      := pro
workdir   := workspace
srcdir    := src
objdir    := objs
stdcpp    := c++11
cuda_home := /usr/local/cuda-11.4
sys_inc    := /usr/include
protobuf_inc := /home/liu/protobuf/install/include
cuda_lib   := /usr/local/cuda-11.4/lib64
syslib     := /usr/lib/aarch64-linux-gnu
protobuf_lib := /home/liu/protobuf/install/lib

cuda_arch :=
nvcc      := $(cuda_home)/bin/nvcc -ccbin=$(cc)

# 定义cpp的路径查找和依赖项mk文件
cpp_srcs := $(shell find $(srcdir) -name "*.cpp")
cpp_objs := $(cpp_srcs:.cpp=.cpp.o)
cpp_objs := $(cpp_objs:$(srcdir)/%=$(objdir)/%)
cpp_mk   := $(cpp_objs:.cpp.o=.cpp.mk)

# 定义cu文件的路径查找和依赖项mk文件
cu_srcs := $(shell find $(srcdir) -name "*.cu")
cu_objs := $(cu_srcs:.cu=.cu.o)
cu_objs := $(cu_objs:$(srcdir)/%=$(objdir)/%)
cu_mk   := $(cu_objs:.cu.o=.cu.mk)

# 定义opencv和cuda需要用到的库文件
link_opencv    := opencv_core opencv_imgproc opencv_imgcodecs opencv_videoio
link_cuda      := cudart cudnn cuda cublas
link_trtpro    := protobuf
link_tensorRT  := nvinfer nvparsers nvinfer_plugin
link_sys       := stdc++ dl
link_librarys  := $(link_opencv) $(link_cuda) $(link_tensorRT) $(link_sys) $(link_trtpro)

# 定义头文件路径,请注意斜杠后边不能有空格
# 只需要写路径,不需要写-I  	$(protobuf_inc)
include_paths := src              \
	src/tensorRT				  \
	src/tensorRT/common 		  \
	$(sys_inc)    				  \
    $(cuda_home)/include	      \
	$(sys_inc)/aarch64-linux-gnu  \
	$(sys_inc)/opencv4			  \
	$(protobuf_inc)


# 定义库文件路径,只需要写路径,不需要写-L
library_paths := $(protobuf_lib) $(cuda_lib) $(syslib)

# 把library path给拼接为一个字符串,例如a b c => a:b:c
# 然后使得LD_LIBRARY_PATH=a:b:c
empty :=
library_path_export := $(subst $(empty) $(empty),:,$(library_paths))

# 把库路径和头文件路径拼接起来成一个,批量自动加-I、-L、-l
run_paths     := $(foreach item,$(library_paths),-Wl,-rpath=$(item))
include_paths := $(foreach item,$(include_paths),-I$(item))
library_paths := $(foreach item,$(library_paths),-L$(item))
link_librarys := $(foreach item,$(link_librarys),-l$(item))

# 如果是其他显卡,请修改-gencode=arch=compute_75,code=sm_75为对应显卡的能力
# 显卡对应的号码参考这里:https://developer.nvidia.com/zh-cn/cuda-gpus#compute
# 如果是 jetson nano,提示找不到-m64指令,请删掉 -m64选项。不影响结果
cpp_compile_flags := -std=$(stdcpp) -w -g -O0 -fPIC -fopenmp -pthread
cu_compile_flags  := -std=$(stdcpp) -w -g -O0 $(cuda_arch) -Xcompiler "$(cpp_compile_flags)"
link_flags        := -pthread -fopenmp -Wl,-rpath='$$ORIGIN'
在最下面原作者注释了# 如果是 jetson nano,提示找不到-m64指令,请删掉 -m64选项。不影响结果,将-m64删掉,我没试过不删会有啥情况,建议直接删掉。
其他需要修改的地方就是include_paths 和library_paths,原则上就是把cuda、opencv、tensorrt、cudnn四个库的头文件和库文件包含进去。
include_paths := src              \
	src/tensorRT				  \
	src/tensorRT/common 		  \
	# 上面三个是代码路径和tensorRT_Pro文件路径
	$(sys_inc)    				  \
    $(cuda_home)/include	      \
	$(sys_inc)/aarch64-linux-gnu  \
	$(sys_inc)/opencv4			  \
	$(protobuf_inc)
最后一个修改就是 link_cuda后需要添加cuda cublas,不然会报下面的错误:
Link workspace/pro
/usr/bin/ld: objs/tensorRT/onnxplugin/plugins/DCNv2.cu.o: undefined reference to symbol 'cublasSgemm_v2@@libcublas.so.11'
/usr/bin/ld: /usr/local/cuda-11.4/targets/aarch64-linux/lib/libcublas.so.11: error adding symbols: DSO missing from command line
collect2: error: ld returned 1 exit status
make: *** [Makefile:89:workspace/pro] 错误 1
提示找不到cublas,如果是在tensorRT_Pro项目中进行配置环境的化不需要修改这部分。
四、测试运行
cd learn-unet-cpp
make clean
make run
最后的运行结果:
偷个懒,下面的编译过程是在我的电脑上编译过程,jetson orin关机了,不想在开机,下次有空改回来。
Compile depends C++ src/app_unet.cpp
Compile depends C++ src/unet.cpp
Compile depends C++ src/main.cpp
Compile CXX src/main.cpp
Compile CXX src/unet.cpp
Compile CXX src/app_unet.cpp
Link workspace/pro
[2023-03-16 19:45:27][info][app_unet.cpp:73]:===================== test FP32 unet ==================================
[2023-03-16 19:45:27][info][trt_builder.cpp:474]:Compile FP32 Onnx Model 'unet.onnx'.
[2023-03-16 19:45:32][info][trt_builder.cpp:558]:Input shape is -1 x 3 x 512 x 512
[2023-03-16 19:45:32][info][trt_builder.cpp:559]:Set max batch size = 1
[2023-03-16 19:45:32][info][trt_builder.cpp:560]:Set max workspace size = 1024.00 MB
[2023-03-16 19:45:32][info][trt_builder.cpp:561]:Base device: [ID 0]<NVIDIA GeForce RTX 3060>[arch 8.6][GMEM 10.93 GB/11.75 GB]
[2023-03-16 19:45:32][info][trt_builder.cpp:564]:Network has 1 inputs:
[2023-03-16 19:45:32][info][trt_builder.cpp:570]:      0.[images] shape is -1 x 3 x 512 x 512
[2023-03-16 19:45:32][info][trt_builder.cpp:576]:Network has 1 outputs:
[2023-03-16 19:45:32][info][trt_builder.cpp:581]:      0.[output] shape is -1 x 512 x 512 x 21
[2023-03-16 19:45:32][info][trt_builder.cpp:585]:Network has 69 layers:
[2023-03-16 19:45:32][info][trt_builder.cpp:652]:Building engine...
[2023-03-16 19:46:31][info][trt_builder.cpp:672]:Build done 58972 ms !
[2023-03-16 19:46:31][info][app_unet.cpp:62]:Done, Save to unet.predict.jpg
在workspace环境下得到结果如下:



 1万+


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


