


Python 实战指南(6)——记账本太大了,得拆家了:class 与模块化重构
你的记账本 v0.5 已经“认识时间”了——日期解析、归一化、范围查询、周度统计,样样都行。但当你打开 account.py 想加一个新功能时,你愣住了:这个文件已经 360 多行,函数一个挨一个,add_record、parse_date、monthly_summary、expense_ranking……你翻到第 200 行想改 get_month,却发现自己忘了它接收什么参数、返回什么格式。
这不是你的问题。这是“函数堆”式代码发展到一定规模的必然结局:所有数据散落在全局变量里,所有逻辑挤在平铺的函数里,改一处,牵一发动全身。
这一篇,我们干一件大事:把记账本从“函数堆”改造成“对象模型”,再把它从一个几百行的单文件,拆成一个结构清晰的包(package)。你会学到 class 的核心三件套(__init__ / self / 魔法方法)、三种方法(实例方法 / 类方法 / 静态方法)、数据类 @dataclass、继承与多态、迭代器协议、上下文管理器、__slots__ 内存优化,以及多模块拆分的完整方法论。
老规矩:先讲人话,再上技术,最后给代码。全程可复现,零第三方依赖,复制即跑。
0. 先把上一篇的事收个尾
第 5 篇结尾,你的记账本 v0.5 长这样:
src/
└── account.py          # 一个文件,360+ 行,所有函数都在这
功能上它已经很能打了:parse_date 解析日期、add_record 校验并归一化、get_month 切片取月、date_range_summary 范围统计、recent_days_summary 最近 N 天、weekly_summary 周度统计……每个函数单独拿出来都写得不错。
但问题是它们之间靠什么联系?靠一个全局变量 data:
data = load_records()          # 一个全局字典:{"income": [...], "expense": [...]}
add_record(data, "income", "工资", 8000, "2026-09-01")
monthly_summary(data, "2026-09")
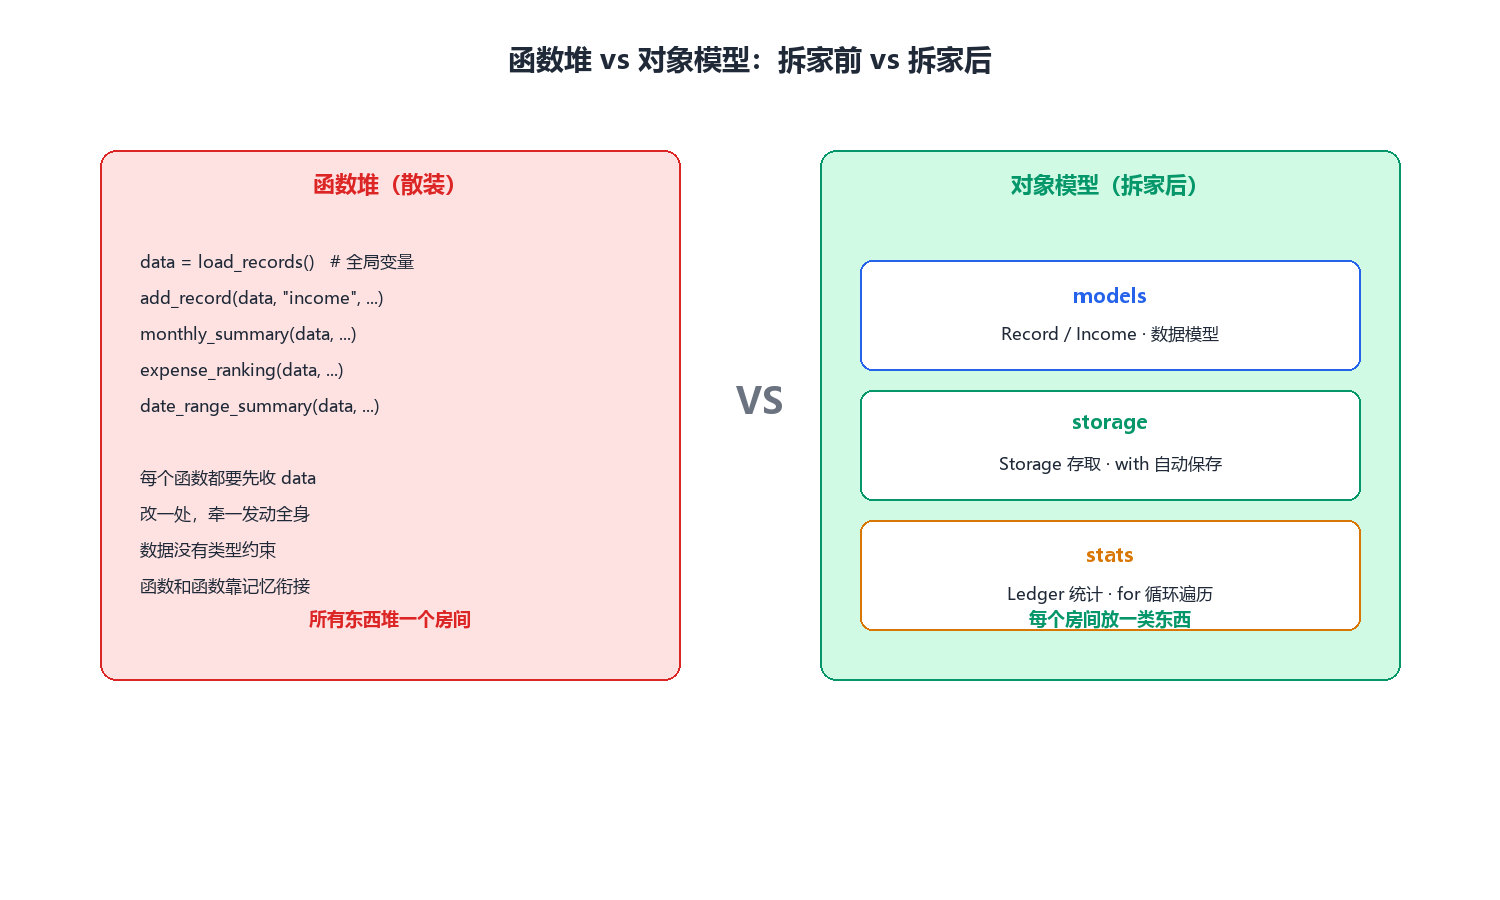
你发现了吗——每个函数的第一件事,都是接收 data 这个字典,然后从里面读、往里面写。 data 就像一条脏毛巾,在 20 个函数之间传来传去。哪个函数忘了传?哪个函数改了一半忘了存?哪个函数把 "income" 拼成了 "incom"?
这些都是真实的痛点,不是编的:
- 数据没有类型约束:
data["income"]里存的到底是字符串还是字典?不知道。查出来的是{"item": "工资", "amount": 8000},谁能保证每个元素都有item和amount两个键?第 5 篇load_records里那次“旧数据自动归一化”,就是在给这个隐患擦屁股。 - 函数和函数之间全靠记忆。
date_range_summary要接收start、end两个字符串,weekly_summary要接收week_num…… 参数一多,调用方记不住,接收方也累。 - 改一个功能要动整个文件。想在菜单里加一个“删除记录”?你得找到
main()里的循环,加一个分支,再写一个函数,再把data传进去…… 每个功能都这么干,文件膨胀不可避免。
这就像你租了一个单间,所有东西都堆在一个房间里。一开始还好,东西多了,你找什么都费劲。是时候“拆家”了:把单间改造成三室一厅,每个房间放一类东西。
怎么拆?答案是:面向对象编程(OOP)——用 class 把“数据 + 操作这些数据的方法”打包在一起。
1. 为什么 class:从“函数堆”到“对象模型”
1.1 一句话说清 class 是什么
class(类)是一种自定义类型。它把“数据”和“操作这些数据的方法”绑在一起,形成一个个独立的“对象”。
打个比方:
- 你之前写函数,就像开了一个流水线工厂:原料(数据)从传送带一端进来,经过一道道工序(函数),从另一端出去。原料在哪个环节、被谁加工过,你不好追踪。
- 你用 class 之后,就像给每个原料配了一个专属师傅:师傅(对象)手里攥着原料(数据),并且知道怎么加工它(方法)。你要加工,就喊“师傅,加工一下”(调用方法),不用自己动手传数据。
第二个关键差异:class 允许你定义“什么是合法数据”。就像身份证有规定的字段(姓名、身份证号、照片),你也可以规定“一笔账必须有什么字段(item、amount、date、kind)”。
1.2 面向过程 vs 面向对象
回顾前五篇,你的记账本一直是面向过程的写法:
# 面向过程:函数 + 全局数据
data = load_records()

def add_record(data, kind, item, amount, date):
    data[kind].append({"item": item, "amount": amount, "date": date})

def monthly_summary(data, ym):
    income = sum(r["amount"] for r in data["income"] if r["date"][:7] == ym)
    ...
这套写法的核心思想是:程序 = 数据结构 + 算法。数据结构(dict、list)和算法(函数)是分开的。
而面向对象的思想是:程序 = 一组相互协作的对象。每个对象同时拥有“数据”和“方法”:
# 面向对象:一个对象管自己的数据和方法
class Account:
    def __init__(self):
        self.records = []          # 数据:账目

    def add(self, rec):            # 方法:记账
        self.records.append(rec)

    def balance(self):             # 方法:算余额
        ...
看到区别了吗?面向对象把“数据(records)”和“操作(add、balance)”放进了同一个盒子(Account 对象)里。你不需要再把 records 传来传去——它就住在对象里。
1.3 我们为什么现在才讲 class
前五篇刻意不给你讲 class,是为了让你先打好函数、数据、控制流的基础。现在你有五六百行代码的经验,再来学 class,你会有一种“原来是这么回事”的顿悟——因为你已经踩够了“函数传参传麻了”“全局变量到处飞”的坑。
先直观感受一下“拆家”前后的对比:
好,先看一个最小的 class 长什么样。
2. 记账本 v0.6 的 class 重构总览
2.1 目标架构
v0.6 我们要把账本从“单文件函数堆”升级成“包(package)+ 类(class)”。先看最终长什么样:
py-from-0-to-1-06-class/
├── src/
│   ├── main.py                # 入口:只负责和用户打交道
│   ├── ledger/                # 业务逻辑包
│   │   ├── __init__.py        # 包导出
│   │   ├── models.py          # 数据模型:Record / IncomeRecord / ExpenseRecord
│   │   ├── storage.py         # 存储:Storage(上下文管理器)
│   │   └── stats.py           # 统计:Ledger(迭代器 + 统计方法)
│   └── tests/
│       └── test_account.py    # 26 个测试
分工原则:入口(main.py)只做三件事——打印菜单、读输入、调包里的方法。所有业务逻辑(记账、统计、存储)都在 ledger 包里。每一层的职责单一:models 只管数据结构,storage 只管存取,stats 只管统计。
2.2 先看结果,再拆零件
跑一下 v0.6 的新版,体验完全没变:
python src/main.py
功能还是那 9 个菜单,但你打开 main.py,会发现它瘦身到了 90 行;打开 models.py,会看到清爽的数据类;打开 storage.py,会看到优雅的 with 语句。这就是 class + 模块化的威力——用户看到的功能不变,内部结构脱胎换骨。
从下一节开始,我们一步步把每个零件搭起来。先从最核心的 __init__ 和 self 开始。
3. __init__ 与 self:对象的“出生证明”
3.1 人话理解
class 是模板,实例(instance)是模板造出来的具体对象。比如:
class Cat:          # Cat 是模板
    def __init__(self, name):
        self.name = name
    def meow(self):
        print(f"{self.name} 喵了一声")

c = Cat("橘猫")     # c 是实例
c.meow()            # 橘猫 喵了一声
__init__ 是 Python 里最特殊的魔法方法:当实例被创建时自动调用,负责给实例“发身份证明”(初始化属性)。
self 就更简单了:它代表“这个实例自己”。在方法里,self.xxx 就是“这个对象的 xxx 属性”。
关键点:Python 把 self 作为第一个参数自动传。c.meow() 实际是 Cat.meow(c)。
3.2 记账本里的 __init__
看我们 v0.6 的 Record 类(数据模型):
from dataclasses import dataclass

@dataclass(frozen=True, slots=True)
class Record:
    """一笔收支记录:金额统一存正数,符号由 kind 决定。"""
    item: str
    amount: int
    date: str          # 统一归一化为 YYYY-MM-DD
    kind: str = "record"

    def __str__(self):
        tag = "收" if self.kind == "income" else "支"
        return f"[{tag}] {self.date} {self.item} {self.amount} 元"

    def __repr__(self):
        return f"{type(self).__name__}(item={self.item!r}, amount={self.amount}, date={self.date!r}, kind={self.kind!r})"

    @property
    def signed_amount(self) -> int:
        return self.amount if self.kind == "income" else -self.amount
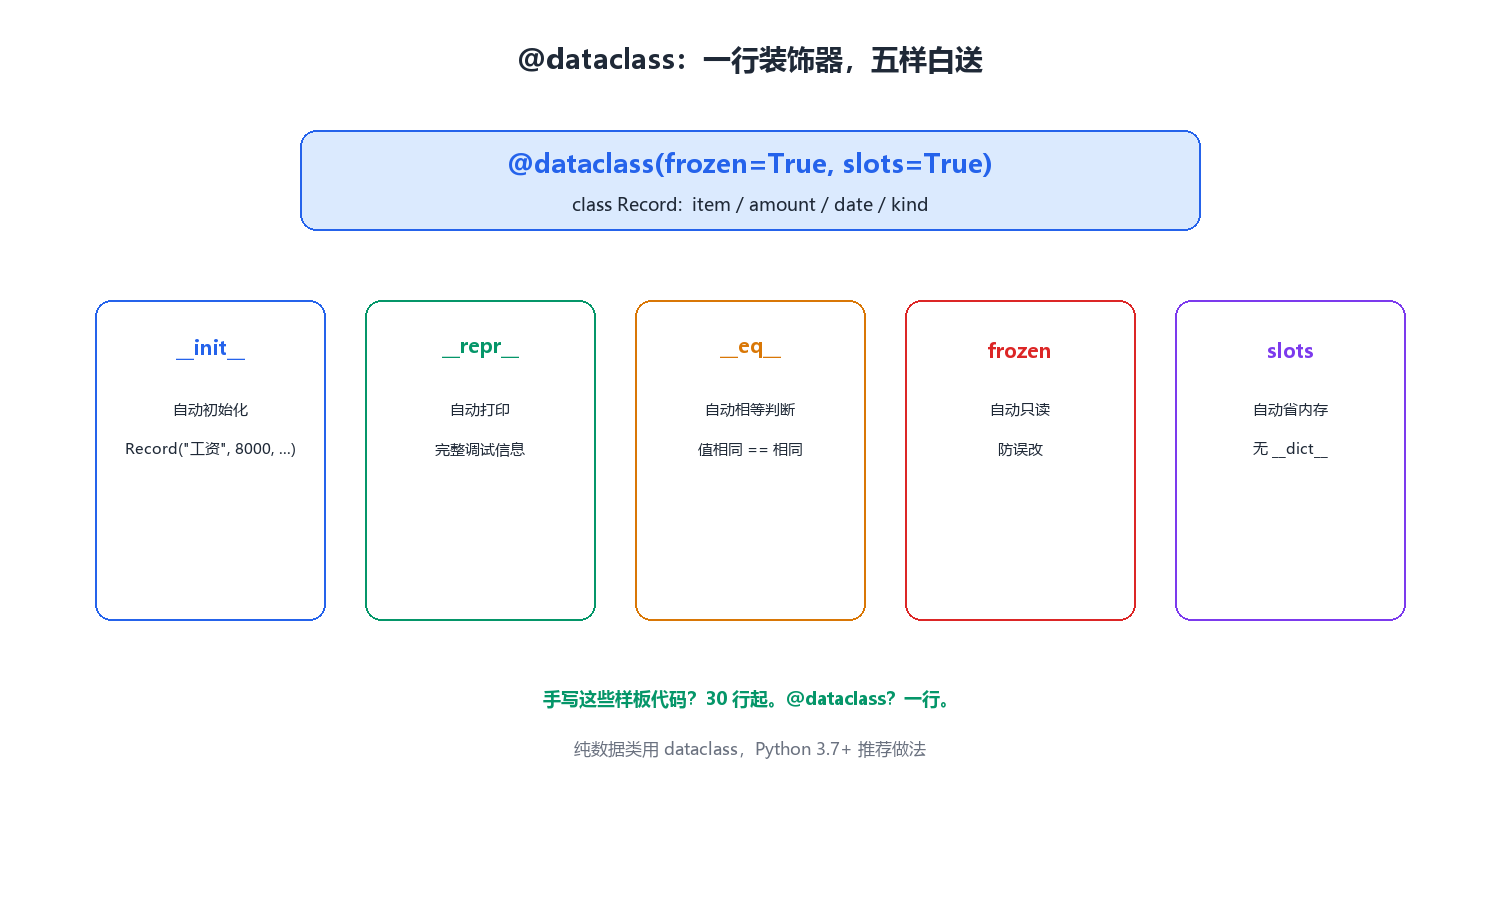
等等,这里没有手写 __init__!因为 @dataclass 装饰器会自动帮你生成 __init__——这就是“一行装饰器替代十行样板代码”。
你 Record("工资", 8000, "2026-09-01") 时,dataclass 自动生成的 __init__ 会把 self.item = "工资"、self.amount = 8000、self.date = "2026-09-01" 全部装好。
3.3 如果手写 __init__ 是什么样?
为了让“这个 init 到底长啥样”不神秘,下面是等价的手写版:
class Record:
    def __init__(self, item, amount, date, kind="record"):
        self.item = item
        self.amount = amount
        self.date = date
        self.kind = kind
对比 @dataclass 版本:
| 功能 | 手写版 | @dataclass 版 |
|---|---|---|
初始化 __init__ | 手写 | 自动生成 |
打印 __repr__ | 手写 | 自动生成 |
相等判断 __eq__ | 手写 | 自动生成 |
| 类型提示 | 无 | 有(item: str) |
不可变 frozen | 手写一堆 __setattr__ | frozen=True 一行 |
看到没?@dataclass 把你从重复的样板代码里解放出来了。这就是现代 Python(3.7+)的推荐做法:纯数据类用 @dataclass,不用手写 __init__。
3.4 self 的理解误区
新手最常见的错误是方法里忘记写 self 参数:
class Wrong:
    def hello():          # 少了 self
        print("hello")

w = Wrong()
w.hello()   # TypeError: hello() takes 0 positional arguments but 1 was given
为什么?因为 w.hello() 调用时,Python 自动把 w 塞进第一个参数。方法没写 self,就等于“只准备了 0 个参数位,却收到 1 个参数”——直接报错。
记忆口诀:Python 类里的“普通方法”,第一个参数永远是 self(代表实例本身);类里的类方法,第一个参数永远是 cls(代表类本身,后面细讲)。
3.5 本节动手验证
你可以自己在终端里跑一下:
from ledger import IncomeRecord
r = IncomeRecord("工资", 8000, "2026-09-01")
print(r)          # 调用 __str__ → [收] 2026-09-01 工资 8000 元
print(repr(r))    # 调用 __repr__ → IncomeRecord(item='工资', amount=8000, ...)
print(r.signed_amount)   # 8000
看到没:print(r) 输出的是人话 [收] 2026-09-01 工资 8000 元,而 repr(r) 输出的是完整的、可以重建对象的表达式。这俩看起来很像,但用途完全不同——正是下一节的主角。
4. __str__ vs __repr__:给对象两副“人话面孔”
4.1 人话理解
每个对象都可以有两个“名字”:
__str__:给用户看的。调用str(obj)或print(obj)时触发。目标是“友好、易读”。__repr__:给开发者看的。调用repr(obj)、在交互式终端直接输入对象名时触发。目标是“信息完整、能重建”。
官方文档的原话是:“__repr__ 计算对象的’官方’字符串表示;__str__ 计算对象的’非正式’字符串表示。”
翻译成人话:
__repr__是身份证:字段全、格式严谨,最好能直接复制出来当代码用。__str__是名片:好看、好记,重点是让人一眼看懂。
4.2 官方推荐的写法
class Record:
    def __str__(self):
        """给人看的:用户界面友好。"""
        tag = "收" if self.kind == "income" else "支"
        return f"[{tag}] {self.date} {self.item} {self.amount} 元"

    def __repr__(self):
        """给调试者看的:信息完整、可直接重建。"""
        return (
            f"{type(self).__name__}("
            f"item={self.item!r}, amount={self.amount}, "
            f"date={self.date!r}, kind={self.kind!r})"
        )
注意 __repr__ 里的小细节:
- 用
{self.item!r}而不是{self.item}:!r表示“用 repr 形式插入”。这样如果 item 是字符串,输出会带引号——重建代码时就不会歧义。 - 用
type(self).__name__而不是写死Record:这样IncomeRecord实例会输出IncomeRecord(...),ExpenseRecord会输出ExpenseRecord(...),子类不用重写__repr__也能正确显示类名。这就是“多态”的雏形。
4.3 实际效果
r = IncomeRecord("工资", 8000, "2026-09-01")
print(r)                 # [收] 2026-09-01 工资 8000 元     ← __str__
print(repr(r))           # IncomeRecord(item='工资', amount=8000, date='2026-09-01', kind='income')  ← __repr__
- 用户在终端看到
print(r)的输出:[收] 2026-09-01 工资 8000 元,友好。 - 调试时用
repr(r):IncomeRecord(item='工资', amount=8000, date='2026-09-01', kind='income'),信息完整。
4.4 一个常见的坑:只写 __str__ 不写 __repr__
如果你只定义了 __str__ 而没定义 __repr__,那么 repr(obj) 会退化成默认的 <ledger.models.IncomeRecord object at 0x...>,这对调试非常不友好。
反过来,如果你只定义 __repr__ 不定义 __str__,print(obj) 会自动调用 __repr__ 作为兜底。所以社区里有一条铁律:
__repr__一定要写,__str__是加分项。 只要__repr__写好,哪怕__str__缺失,也不会出现“天书”输出。
而 @dataclass 更贴心:它默认帮你生成了 __repr__(格式和上面的手写版几乎一样)。我们在它基础上再覆盖 __str__,两全其美。
4.5 什么时候该写 __str__?
不是所有类都需要 __str__。判断标准很简单:你的对象会不会直接出现在用户界面上? 会 → 写 __str__。不会(只在内部传)→ 只写 __repr__ 就够了。
记账本的 Record 会在菜单里被 print,所以 __str__ 值得写。而 Ledger(账本)主要是内部结构,只需要 __repr__(其实 __len__ 更重要)。
5. 数据类 @dataclass:让记账记录成为“一等公民”
5.1 为什么需要 dataclass
前五篇里,一笔账是字典:
{"item": "工资", "amount": 8000, "date": "2026-09-01"}
字典的问题:
- 键名靠记忆:写错
"item"成"itme",程序不报错,只是静默返回KeyError。 - 类型靠自觉:
amount是 int 还是 str?没人约束。 - 逻辑散落:计算“带符号金额”,每个函数都要自己写
amount if kind=="income" else -amount。
而用 @dataclass 定义 Record 后:
- 字段固定:
Record必须按item, amount, date, kind构造,多传少传都报TypeError。 - 类型提示:
item: str、amount: int,IDE 自动补全、自动检查。 - 方法集中:
signed_amount、to_dict()这些“操作”直接挂在对象上。
5.2 dataclass 的完整参数
@dataclass 装饰器有几个常用参数,我们逐个讲透:
| 参数 | 作用 | 记账本里的用法 |
|---|---|---|
frozen=True | 实例创建后属性不可变(只读) | 防止记录被误改 |
slots=True | 不再给每个实例建 __dict__,省内存 | 记录多了省空间(3.10+) |
order=True | 自动生成比较运算符 | 记录可排序(默认关) |
init=True | 自动生成 __init__ | 默认开,我们用默认 |
一句话总结 @dataclass 帮你做了什么:
5.3 frozen=True 的意义
from ledger import IncomeRecord
r = IncomeRecord("工资", 8000, "2026-09-01")
r.amount = 100  # dataclasses.FrozenInstanceError: cannot assign to field 'amount'
为什么要冻结?因为一笔已经记下的账,不应该被静默修改。如果哪个函数想偷偷改历史记录,直接抛异常,强迫你“删掉重记”——这才是账本该有的严肃性。
5.4 slots=True 的意义(进阶)
普通 Python 对象有个 __dict__ 属性,它是个字典,专门存实例属性。好处是灵活(随时加新属性),坏处是每个实例都要持有一个字典,内存开销大。
slots=True 用固定槽位代替字典,实例不再有 __dict__,内存省一大截。官方文档明确说明:
在一个拥有几百万个实例的类上使用
__slots__可以减少约 50% 的内存占用。
记账本记一万笔账,就是一万个 Record 实例。用 slots=True,内存从“字典开销”降到“数组开销”,很值。
5.5 dataclass 的继承
v0.6 的 IncomeRecord 和 ExpenseRecord 都继承自 Record:
@dataclass(frozen=True, slots=True)
class IncomeRecord(Record):
    kind: str = "income"

@dataclass(frozen=True, slots=True)
class ExpenseRecord(Record):
    kind: str = "expense"
继承的规则(dataclass 下):
- 子类自动拥有父类的字段:
item、amount、date。 - 子类可以新增字段:
kind(带默认值)。 - 子类字段带默认值时,父类所有字段也必须有默认值(否则默认值顺序冲突报错)。我们父类
kind也有默认值"record",所以没问题。
这样设计的好处:创建一笔收入不用写 kind:
IncomeRecord("工资", 8000, "2026-09-01")     # kind 自动是 "income"
ExpenseRecord("吃饭", 25, "2026-09-02")      # kind 自动是 "expense"
少一个参数,调用处更清晰。
5.6 动手验证
from ledger import IncomeRecord, ExpenseRecord
a = IncomeRecord("工资", 8000, "2026-09-01")
b = ExpenseRecord("吃饭", 25, "2026-09-02")
print(a)                 # [收] 2026-09-01 工资 8000 元
print(a.signed_amount)   # 8000
print(b.signed_amount)   # -25
print(a == b)            # False(dataclass 自动按字段比较)
注意到 signed_amount 是 @property 装饰的——它让“计算属性”用起来像普通属性。这就是下一节的主角。
6. 实例方法 vs 类方法 vs 静态方法:三种方法三种活法
6.1 先上总表
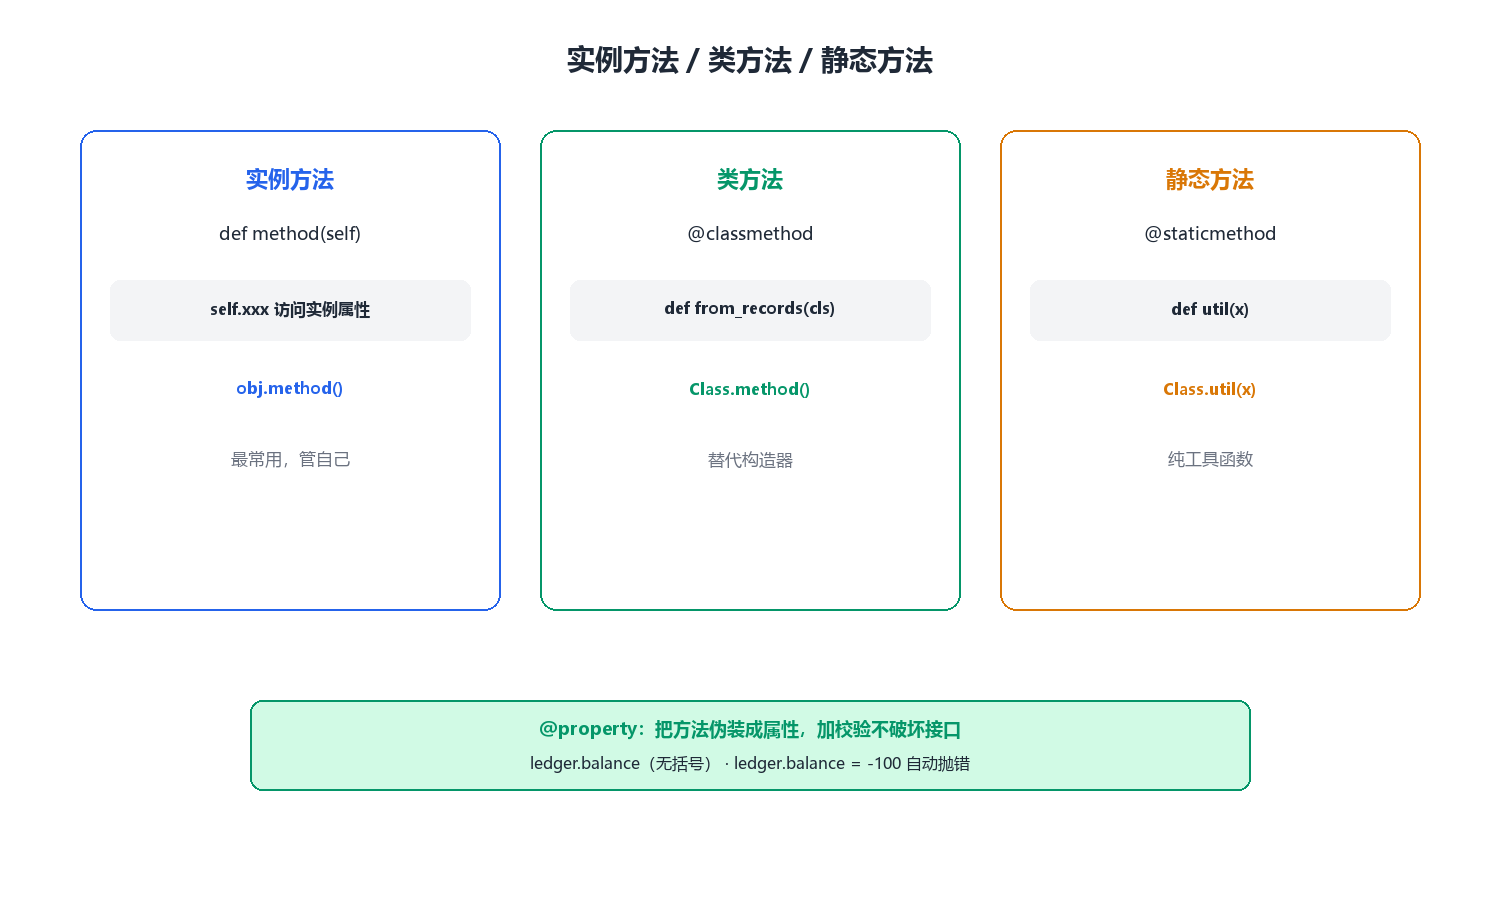
Python 类里有三种方法,用不用装饰器、第一个参数是什么、调用方式是什么,全不同:
| 方法类型 | 装饰器 | 第一个参数 | 调用方式 | 能访问什么 |
|---|---|---|---|---|
| 实例方法 | 无 | self(实例) | obj.method() | 实例属性 + 类属性 |
| 类方法 | @classmethod | cls(类) | Class.method() / obj.method() | 只能访问类属性 |
| 静态方法 | @staticmethod | 无 | Class.method() / obj.method() | 啥都不自动给 |
一张图看清三种方法的区别:
6.2 实例方法:最常用
你已经很熟了——带 self,访问实例属性:
def monthly_summary(self, ym: str):
    """月度统计:返回 (收入, 支出) 元组。"""
    income = sum(r.amount for r in self.income if r.date[:7] == ym)
    expense = sum(r.amount for r in self.expense if r.date[:7] == ym)
    return income, expense
self.income 就是“这个账本实例”的收入记录列表。
6.3 类方法:替代构造器
类方法的标志是 @classmethod,第一个参数叫 cls(代表类本身)。它最常见的用途是替代构造器——给你一个“从别的方式创建对象”的入口。
v0.6 里 Ledger.from_records 就是:
@classmethod
def from_records(cls, records):
    """把一个 Record 列表按 kind 分装成 Ledger。"""
    inc, exp = [], []
    for r in records:
        (inc if r.kind == "income" else exp).append(r)
    return cls(income=inc, expense=exp)
调用:
records = [IncomeRecord("工资", 8000, "2026-09-01"),
           ExpenseRecord("吃饭", 25, "2026-09-02")]
ledger = Ledger.from_records(records)   # 不直接 Ledger(...),而是用类方法
为什么要用 cls 而不是写死 Ledger?因为如果将来有人继承 Ledger 创建了子类,cls 会自动变成子类,from_records 就返回子类实例。用 cls 写,继承体系下永远正确。
6.4 静态方法:工具函数
静态方法(@staticmethod)不给 self 也不给 cls,纯粹是“挂在类名下的普通函数”。适合那些“和类相关、但不需要实例/类数据”的逻辑。
@staticmethod
def _normalize(raw):
    """把 v0.5 的 dict 记录升级为 Record 对象;老数据自动补 kind。"""
    out = {"income": [], "expense": []}
    for key in ("income", "expense"):
        for rec in raw.get(key, []):
            if isinstance(rec, dict):
                rec = Record(item=rec["item"], amount=int(rec["amount"]),
                             date=rec.get("date", ""), kind=key)
            out[key].append(rec)
    return out
它接收原始 JSON 字典,返回规范化的 Record 列表。它不需要 self(不依赖某个存储实例),也不需要 cls(不依赖 Storage 类自身)。所以用静态方法。
6.5 怎么选?
选型口诀:
- 方法里要用
self.xxx(实例属性)→ 实例方法。 - 方法要创建/返回类实例,且希望子类也能用 → 类方法。
- 方法只是“与类相关的工具函数”,不需要实例或类 → 静态方法。
7. @property:把方法伪装成属性,加校验不破坏接口
7.1 人话理解
@property 装饰器让一个方法像属性一样被访问。最经典的场景:既能像属性一样读,又能做动态计算或校验。
我们的 signed_amount 就是这样:
@property
def signed_amount(self) -> int:
    """带符号金额:收入为正,支出为负。"""
    return self.amount if self.kind == "income" else -self.amount
用起来:
r = ExpenseRecord("吃饭", 25, "2026-09-02")
print(r.signed_amount)   # -25   ← 看起来像属性,其实是方法算出来的
如果没有 @property,你要写 r.signed_amount() 带括号。有了它,调用方不关心它是“存的值”还是“算出来的”——这就是“封装”的好处:以后你想改算法,调用方代码一行都不用动。
7.2 为什么叫“加校验不破坏接口”
假设你要在 amount 上加“金额必须为正”的校验:
class Record:
    def __init__(self, item, amount, date, kind="record"):
        if amount <= 0:
            raise ValueError(f"金额必须为正数,得到 {amount}")
        self.item = item
        self.amount = amount
        self.date = date
        self.kind = kind
校验在 __init__ 里做一次,之后的逻辑只要通过对象属性访问,就能保证不会出现负数金额。这比每个函数都写 if amount < 0 干净多了。
@property 还有配套的 @xxx.setter,用来拦截“赋值”操作。虽然我们的记录是 frozen=True 不可变,但如果是可变类,可以这样:
class BankAccount:
    def __init__(self):
        self._balance = 0

    @property
    def balance(self):
        return self._balance

    @balance.setter
    def balance(self, value):
        if value < 0:
            raise ValueError("余额不能为负")
        self._balance = value
7.3 前五篇的“直接改” vs 现在的“封装”
前五篇你到处 data["income"].append(...),这是直接暴露内部结构。一旦结构从“字典”变成“Record 对象”,所有调用处都要改。
面向对象的做法是封装:内部怎么存(list、dict、SQLite?)是 Ledger 自己的事,对外只暴露 add()、balance()、monthly_summary() 等方法。将来存储从 JSON 换成数据库,调用方一行都不用动。
这是 OOP 三大特性之一(封装、继承、多态)。你已经看到“封装”了,下一节看“继承和多态”。
8. 继承与多态:账单类型的优雅扩展
8.1 人话理解
继承(inheritance)就是“子类自动拥有父类的属性和方法”。多态(polymorphism)就是“同一个方法名,不同对象有不同的表现”。
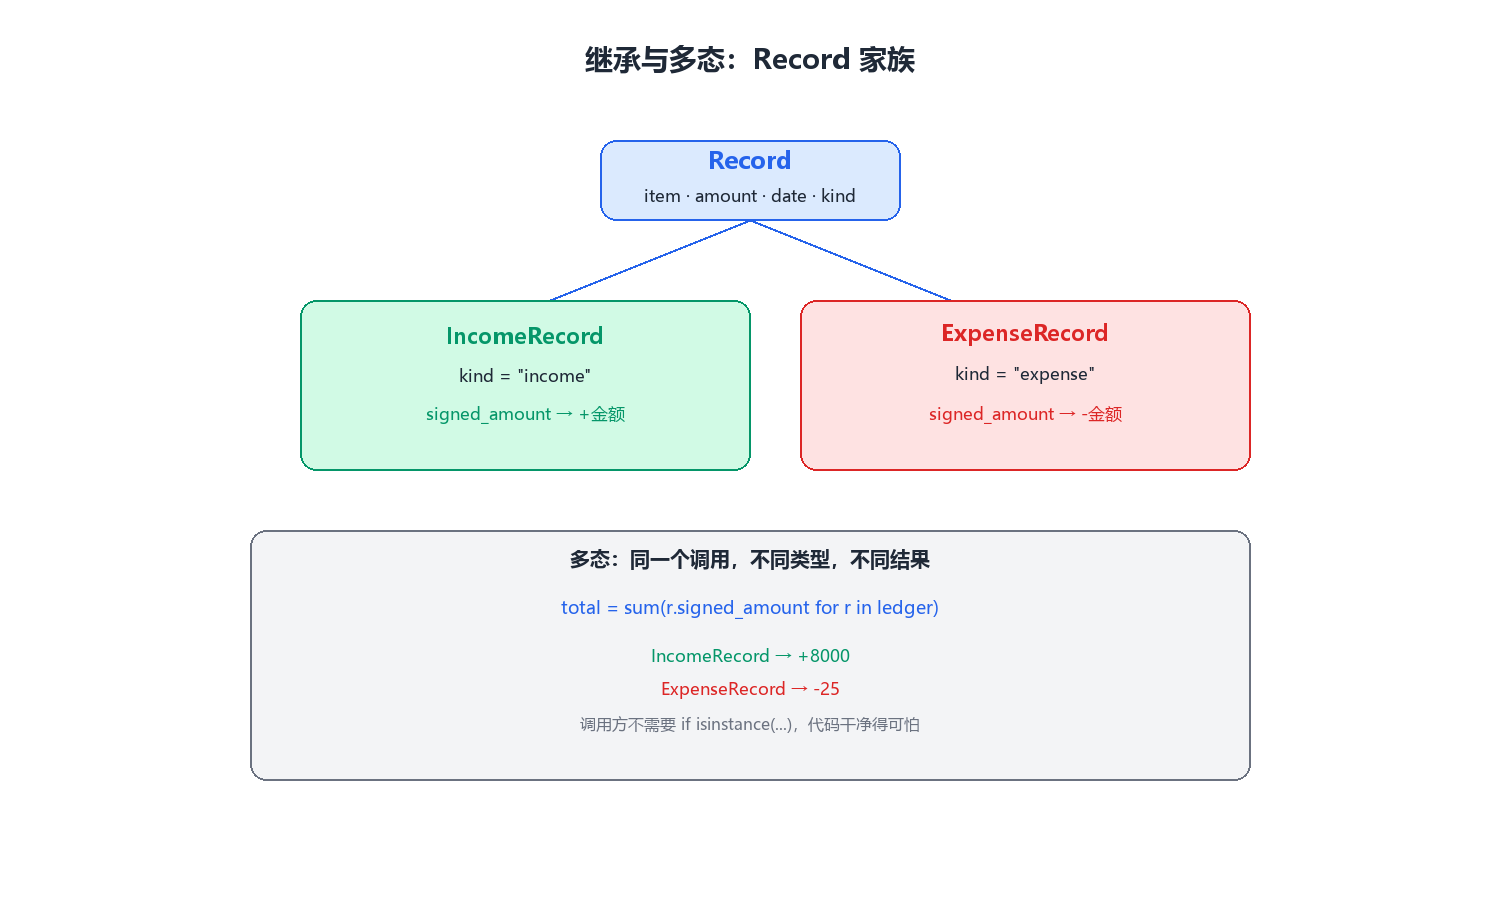
记账本里的继承关系:
        Record(一笔账)
        /            \
IncomeRecord    ExpenseRecord
(收入)          (支出)
IncomeRecord 和 ExpenseRecord 是兄弟,都继承自 Record。它们共享父类的一切(字段、方法),只覆盖/补充自己特有的部分(kind 默认值不同)。
8.2 继承的价值:消除重复
如果没有继承,你要写两个几乎一样的类:
class IncomeRecord:
    def __init__(self, item, amount, date):
        self.item = item
        self.amount = amount
        self.date = date
        self.kind = "income"

class ExpenseRecord:
    def __init__(self, item, amount, date):
        self.item = item
        self.amount = amount
        self.date = date
        self.kind = "expense"
除了 kind 那行,其他完全一样。重复代码是万恶之源:改一个字段名,要改两处。
用继承后:
@dataclass(frozen=True, slots=True)
class Record:
    item: str
    amount: int
    date: str
    kind: str = "record"

@dataclass(frozen=True, slots=True)
class IncomeRecord(Record):
    kind: str = "income"

@dataclass(frozen=True, slots=True)
class ExpenseRecord(Record):
    kind: str = "expense"
IncomeRecord 只有一行 kind: str = "income"。其余全部复用父类。
8.3 多态的价值:调用方不用管具体类型
看看 Ledger 的迭代(下一节细讲)和统计方法怎么用多态的:
for r in ledger:                 # r 可能是 IncomeRecord 也可能是 ExpenseRecord
    if r.kind == "income":
        ...
更优雅的是 signed_amount——调用方根本不用判断类型:
total = sum(r.signed_amount for r in ledger) # 收为正、支为负,直接求和
r.signed_amount 对 IncomeRecord 返回正数,对 ExpenseRecord 返回负数。同一个调用,不同类型,不同结果——这就是多态。调用方不需要 if isinstance(...),代码干净得可怕。
8.4 super() 与 MRO(进阶)
继承还有个大杀器:super()。它让你在子类方法里调用父类的方法。
看我们的 __repr__ 用 type(self).__name__,如果子类想扩展 __repr__ 而不重写,可以:
class Record:
    def __repr__(self):
        return f"{type(self).__name__}(item={self.item!r}, amount={self.amount}, date={self.date!r}, kind={self.kind!r})"

class ExpenseRecord(Record):
    def __repr__(self):
        return super().__repr__() + " (支出)"   # 复用父类 + 追加
super() 背后是 MRO(Method Resolution Order,方法解析顺序)。Python 用 C3 算法保证:即使钻石继承(A ← B、A ← C、B/C ← D),每个父类也只被调用一次,顺序确定。对于你的日常开发,记住一句话:子类想复用父类同名方法,就用 super()。
8.5 什么时候用继承,什么时候用组合
OOP 经典争议:继承 vs 组合。给两个判断标准:
- 是不是“是一种”关系?猫是一种动物 → 继承。账本里有记录 → 组合(
Ledger持有一堆Record,而不是Ledger继承Record)。 - 父类的方法子类是否都适用?都适用 → 继承;只有一部分适用 → 组合更合适。
我们的设计正是如此:IncomeRecord is a Record(继承);Ledger has records(组合)。
9. __iter__ / __next__:让记账本可以被 for 循环
9.1 人话理解
Python 里“能被 for 循环的东西”(列表、字典、字符串)都实现了迭代器协议:
__iter__:返回一个迭代器(“给我一个能逐个取值的工具”)。__next__:取下一个值,取完就抛StopIteration(“没啦,停吧”)。
我们让 Ledger 也实现这两个方法,于是 for rec in ledger: 直接可用。
9.2 实现
class Ledger:
    def __init__(self, income=None, expense=None):
        self.income = list(income) if income else []
        self.expense = list(expense) if expense else []

    # ---- 迭代器协议 ----
    def __iter__(self):
        """支持 for rec in ledger。"""
        self._iter_pool = self.income + self.expense
        self._iter_idx = 0
        return self

    def __next__(self):
        if self._iter_idx >= len(self._iter_pool):
            raise StopIteration
        rec = self._iter_pool[self._iter_idx]
        self._iter_idx += 1
        return rec

    def __len__(self):
        return len(self.income) + len(self.expense)
9.3 为什么这样实现?
核心逻辑:
__iter__把收入和支出合并成一个池子,记住当前位置_iter_idx,返回self(因为Ledger本身就是自己的迭代器)。__next__每次返回当前值并把下标 +1;越界就raise StopIteration——这是终止信号,必须抛。__len__让len(ledger)可用(for和len是统计里最常用的)。
9.4 实际效果
from ledger import Ledger, IncomeRecord, ExpenseRecord

ledger = Ledger.from_records([
    IncomeRecord("工资", 8000, "2026-09-01"),
    ExpenseRecord("吃饭", 25, "2026-09-02"),
    ExpenseRecord("地铁", 6, "2026-09-03"),
])

for rec in ledger:             # 触发了 __iter__ + __next__
    print(rec)
# [收] 2026-09-01 工资 8000 元
# [支] 2026-09-02 吃饭 25 元
# [支] 2026-09-03 地铁 6 元

print(len(ledger))             # 3,触发了 __len__
print(sum(r.signed_amount for r in ledger))   # 7969,多态 + 迭代器一起用
注意:__iter__ 里我们用的是“合并两个列表再取”,这是最简单直观的实现。工程上更优雅的做法是用生成器:
def __iter__(self):
    yield from self.income
    yield from self.expense
yield from 一行搞定,而且不会污染实例状态(不用 _iter_pool/_iter_idx)。两种都对,视频里我演示了完整版(方便你看懂协议细节),实际项目里建议用生成器版。
9.5 迭代器的坑:iter(ledger) is ledger——两个“独立”迭代器其实是同一个
先说结论:连续写两个 for 循环是没问题的。因为 for 每次都会自动调用 __iter__,而我们的 __iter__ 会把 _iter_idx 重置为 0,所以第二次 for 从头开始,完全正常。
真正的坑在于手动 iter()。我们的 __iter__ 返回的是 self——ledger 既是可迭代对象,又是自己的迭代器。试试:
it1 = iter(ledger)
it2 = iter(ledger)
print(it1 is it2)   # True!两个迭代器是同一个对象
it1 和 it2 根本是同一个东西,共享同一个 _iter_idx 游标。next(it1) 走一步,it2 的游标也跟着走了——你以为拿了两个“独立”迭代器,其实是同一个人穿了两件马甲。
这个问题我们在第 14 章坑 2 里详细拆解了(含完整复现代码),这里先埋个伏笔。
生成器版就没有这个问题(每次 iter(ledger) 都会新建一个生成器,iter(ledger) is ledger 变成 False)。这也是为什么实际项目推荐生成器实现的原因之一。
10. __enter__ / __exit__:with 语句背后的魔法
10.1 人话理解
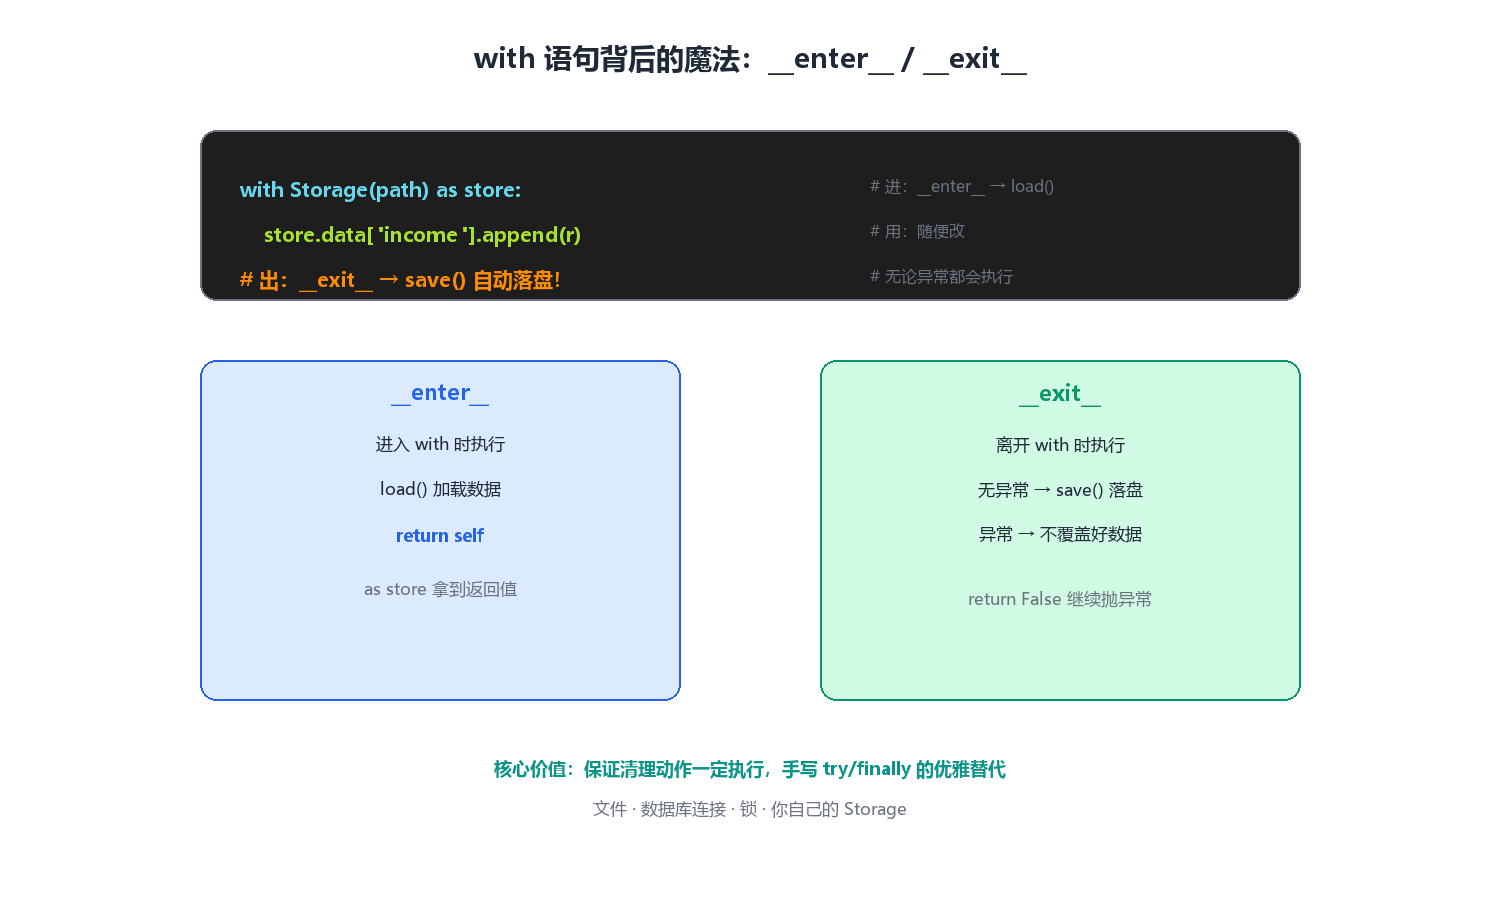
你早就用过 with open(...) as f:——with 会自动关文件。这个魔法来自文件对象的 __enter__ 和 __exit__ 两个方法:
__enter__:进入with块时调用(负责“打开/加载”资源)。__exit__:离开with块时调用(负责“关闭/保存”资源),无论块内是否抛异常都会执行。
10.2 记账本里的 Storage
v0.6 的 Storage 类实现了上下文管理器协议:
class Storage:
    def __init__(self, path=None):
        self.path = Path(path) if path else DATA_FILE
        self.data = {"income": [], "expense": []}

    # ---- 上下文管理器协议 ----
    def __enter__(self):
        self.load()
        return self

    def __exit__(self, exc_type, exc_val, exc_tb):
        # 没有异常才保存(异常时不覆盖原有数据)
        if exc_type is None:
            self.save()
        return False

    def load(self):
        ...
    def save(self):
        ...
10.3 用起来有多爽
with Storage(path) as store:          # 进:__enter__ → load()
    store.data["income"].append(r)    # 用:随便改
# 出:__exit__ → save() 自动落盘!
三行代码:加载 → 修改 → 自动保存。你再也不用记得手动 save_records(data) 了。
10.4 __exit__ 的三个参数
__exit__(self, exc_type, exc_val, exc_tb) 三个参数分别是:
| 参数 | 含义 |
|---|---|
exc_type | 异常类型(没有异常时为 None) |
exc_val | 异常实例(没有异常时为 None) |
exc_tb | traceback 对象(没有异常时为 None) |
我们利用它:只有没有异常才保存(if exc_type is None: self.save())。这样如果中途逻辑出错,不会用脏数据覆盖原来的好数据。return False 表示“异常不要吞掉,继续往上抛”。
10.5 为什么值得学
上下文管理器是 Python 最优雅的资源管理模式,比你想象中更重要:
- 文件:
with open(...)自动关闭。 - 数据库连接:
with db.connect() as conn:自动提交/回滚。 - 锁:
with lock:自动释放。 - 我们自己的
Storage:自动加载/自动保存。
它的核心价值是保证清理动作一定执行。手写 try/finally 也行,但 with 更短、更不容易忘。
10.6 顺手验证
from ledger import Storage, IncomeRecord
import tempfile, os

with tempfile.TemporaryDirectory() as td:
    path = os.path.join(td, "t.json")
    with Storage(path) as s:                    # load(文件不存在 → 空)
        s.data["income"].append(IncomeRecord("工资", 8000, "2026-09-01"))
    # with 结束自动 save
    with Storage(path) as s2:                # load(这次有数据了)
        print(s2.data["income"][0])          # [收] 2026-09-01 工资 8000 元
跑一遍,你会看到 with Storage(path) as s2: 读到了上一段 with 块写入的数据——上下文管理器完成了“读写自动配对”。
11. __slots__ 与内存优化:记一万笔账不卡
11.1 人话理解
Python 对象默认用一个 __dict__ 字典来存所有实例属性。字典的好处是灵活(随时加属性),坏处是每个实例都要扛一个字典,内存开销不小。
__slots__ 是一种“阉割”:告诉 Python “这个类的实例只允许有这几个属性”。Python 就不再为每个实例创建 __dict__,改用紧凑的固定槽位数组。
11.2 手动实现 vs dataclass 的 slots
手写版:
class Record:
    __slots__ = ("item", "amount", "date", "kind")

    def __init__(self, item, amount, date, kind="record"):
        self.item = item
        self.amount = amount
        self.date = date
        self.kind = kind
注意:用了 __slots__ 之后,实例就没有 __dict__ 了,给实例加没声明过的属性会直接 AttributeError:
r = Record("工资", 8000, "2026-09-01")
r.note = "x"   # AttributeError: 'Record' object has no attribute 'note'
而 dataclass 一行搞定:
@dataclass(frozen=True, slots=True)
class Record:
    item: str
    amount: int
    date: str
    kind: str = "record"
11.3 到底省多少?实测一下
写个脚本对比:
from dataclasses import dataclass

@dataclass
class Normal:
    a: int = 0
    b: int = 0
    c: int = 0

@dataclass(slots=True)
class Slotted:
    a: int = 0
    b: int = 0
    c: int = 0

import sys
n = Normal(1, 2, 3)
s = Slotted(1, 2, 3)
print(sys.getsizeof(n))   # 48(含 __dict__ 的开销)
print(sys.getsizeof(s))   # 32(固定槽位,更小)
实测(本机 Python 3.12):
Normal实例 48 字节Slotted实例 32 字节
单个看只差 16 字节,但记 10 万笔账就是差 1.6 MB。而且 __dict__ 是字典,查询还要走哈希,访问比固定槽位慢。官方文档原话:几百万实例场景下 __slots__ 可省约 50% 内存。
11.4 什么时候用 __slots__
- 大量实例(上万、上百万):记账记录、坐标点、配置项……用。
- 少量实例:无所谓,省那点内存不如代码可读性重要。
- 需要随时动态加属性(鸭子类型重灾区):别用,
__slots__会锁死。
11.5 继承与 __slots__ 的坑
子类继承带 __slots__ 的父类,子类也要自己声明 __slots__,否则子类实例又会建 __dict__:
class Child(Record):
    __slots__ = ("extra",)   # 没这句,Child 实例又有 __dict__ 了
dataclass 的 slots=True 会自动处理继承(Python 3.10+),所以我们的 IncomeRecord / ExpenseRecord 不需要手动写。这是用 dataclass 的又一个小理由。
12. 多模块拆分:从 account.py 到 package
12.1 为什么拆
回到开头那个痛点:account.py 360 行,一个文件管所有事。拆成多个模块(文件)的好处:
- 职责清晰:每个文件只做一件事,打开就知道里面有什么。
- 方便测试:
test_account.py可以只测models,不碰storage。 - 方便复用:别的项目想用你的
Record,from ledger.models import Record一行就行。 - 协同开发:你改
stats.py,同事改storage.py,几乎不冲突。
12.2 最终的包结构
src/
├── main.py              # 入口:菜单 + 输入输出(只做"和人打交道")
├── ledger/              # 包
│   ├── __init__.py      # 包标识 + 对外导出
│   ├── models.py        # Record / IncomeRecord / ExpenseRecord(纯数据 + 简单行为)
│   ├── storage.py       # Storage + 存取函数(JSON 持久化)
│   └── stats.py         # Ledger(统计 + 迭代器)
└── tests/
    └── test_account.py  # 26 个测试
12.3 import 到底怎么找文件?——sys.path
很多人第一次 import 自己的模块失败,懵了。真相是:Python 找模块靠 sys.path 这个列表,按顺序找:
import sys
print(sys.path)
# ['D:\\teleagentwork\\py-from-0-to-1-06-class\\src', ...标准库路径..., ...site-packages...]
规则(官方文档原话):
- 直接运行的脚本所在目录,会被加进
sys.path。 PYTHONPATH环境变量里写的路径。- 标准库路径。
site-packages(第三方库)。
所以:从 src/main.py 运行时,sys.path 第一项是 src,于是 import ledger 能找到 src/ledger/ 这个包。
12.4 包(package)是什么?——__init__.py
带 __init__.py 的目录就是包。__init__.py 有两个作用:
- 标记:告诉 Python “这个目录是一个包”。Python 3.3+ 其实可以没有这个文件(namespace package),但写上更规范。
- 导出:在这个文件里
from .models import Record,别人就能from ledger import Record,而不用from ledger.models import Record。
我们的 __init__.py:
# -*- coding: utf-8 -*-
"""ledger 包:v0.6 记账本"""
from .models import Record, IncomeRecord, ExpenseRecord
from .stats import Ledger
from .storage import Storage, save_records, load_records

__all__ = [
    "Record", "IncomeRecord", "ExpenseRecord",
    "Ledger", "Storage",
    "save_records", "load_records",
]
12.5 绝对导入 vs 相对导入
包内部模块互相引用,有两种写法:
# 绝对导入:从包的根开始写
from ledger.models import Record

# 相对导入:用 . 表示当前包
from .models import Record
对比:
| 写法 | 优点 | 缺点 |
|---|---|---|
| 绝对导入 | 一眼看清来源 | 包名改了要全改 |
| 相对导入 | 重命名包不影响内部 | 只能用于包内,main 脚本里不能用 |
我们的包内模块用相对导入(from .models import ...),main.py 作为包外入口用绝对导入(from ledger import ...)。
12.6 if __name__ == "__main__" 的真相
每个 .py 文件被运行时,Python 会给它一个隐藏变量 __name__:
- 直接运行
python main.py→__name__ == "__main__" - 被 import →
__name__ == "ledger.models"(模块路径)
所以:
if __name__ == "__main__":
    main()
的意思是:只有直接运行这个文件时才执行 main();被别人 import 时不执行。这是模块化的基本功——不然你 from ledger.models import Record 时,models 里的测试代码会被跑一遍。
13. 模块化的坑:循环导入与命名冲突
13.1 坑一:循环导入(circular import)
症状:ImportError: cannot import name 'X' from partially initialized module ...
原因:A 导入 B,B 又导入 A,Python 加载到一半发现互相依赖,直接放弃。
案例(真实场景):
# a.py
from b import foo

# b.py
from a import bar
解决(三种):
- 延迟导入:把
from b import foo移进函数内部,用到再导。 - 调整设计:把公共依赖抽到第三个模块(最常见的解法)。我们在设计时就把
Record放models,Storage放storage,Ledger放stats——三者互不循环,全靠__init__.py汇总。 - 改 import 方式:
import b而不是from b import foo(函数运行时才解析属性)。
13.2 坑二:模块名与标准库重名
如果你的文件叫 json.py,再 import json,Python 会优先加载你的 json.py(因为脚本目录在 sys.path 第一位)——标准库 json 被你的文件遮蔽了,然后大概率报错或者行为诡异。
解法:不要用标准库名、常用第三方库名当文件名(json、datetime、logging、pandas、requests……)。
13.3 坑三:from module import * 的失控
from ledger import * 会把模块里所有非下划线开头的名字都导入,容易造成命名冲突。我们规范的做法是在 __init__.py 里用 __all__ 显式声明导出的名字——from ledger import * 就只导入 __all__ 列出的那些,不会把 DATA_DIR、Path 等内部名也带出来。
13.4 坑四:相对导入在“入口脚本”里不能直接用
如果你在 src/main.py 里写 from .ledger import ...,会报 ImportError: attempted relative import with no known parent package。因为入口脚本的 __package__ 是空的,相对导入无从谈起。规则:入口文件用绝对导入;包内模块用相对导入。
14. 三个真坑:每个都值得你踩一遍(但别真的踩)
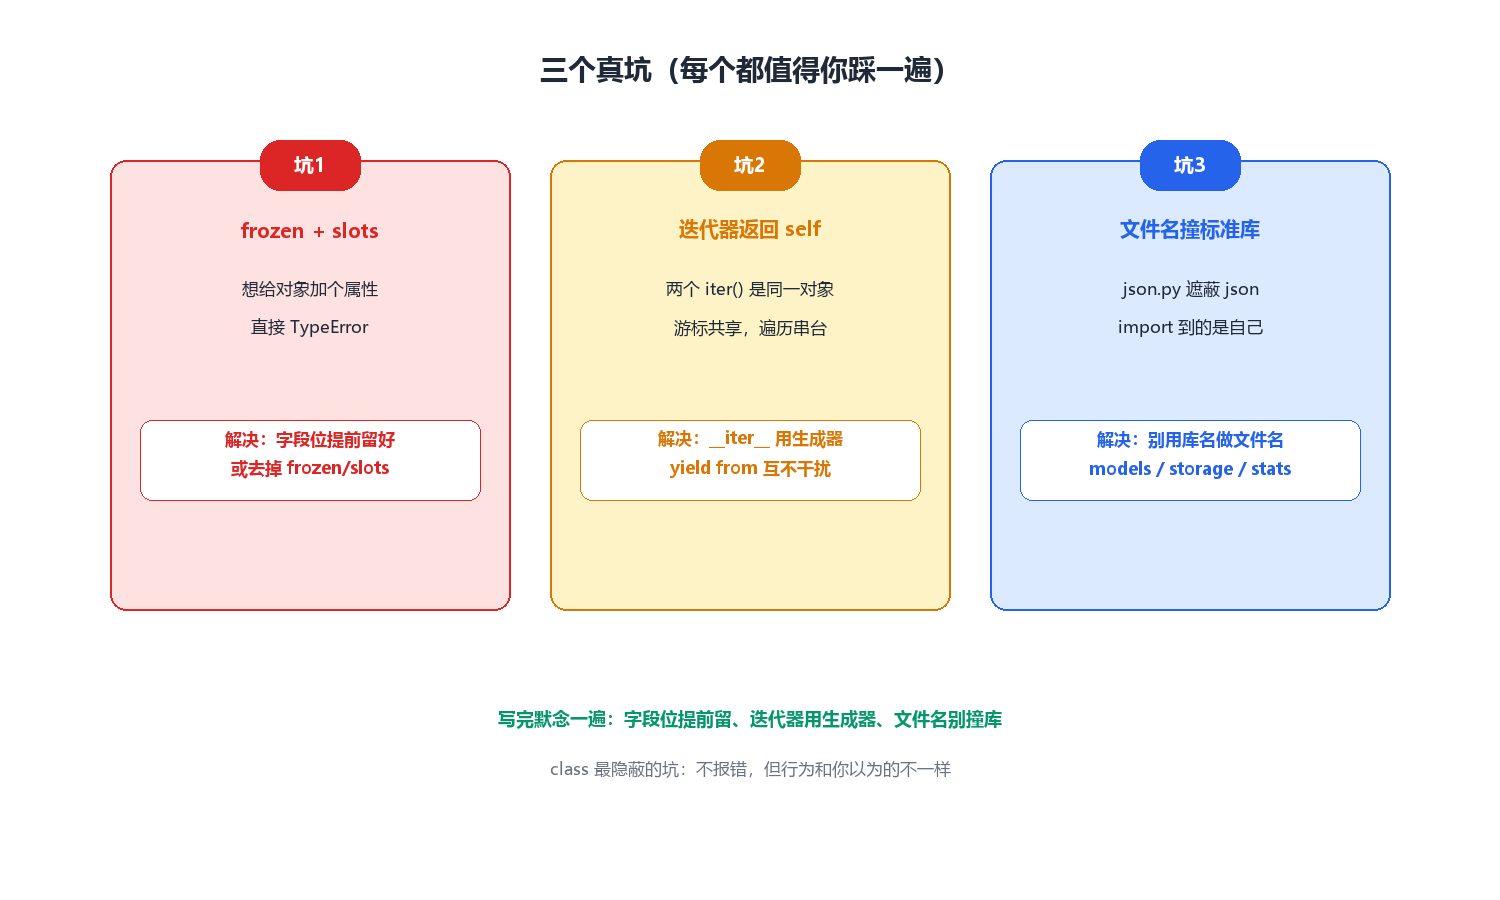
14.1 坑 1:frozen 和 slots 下,想给对象“加戏”被锁死
症状
你写了一个 Record 对象,临时想给一笔账加个备注:
from ledger import IncomeRecord

r = IncomeRecord("工资", 8000, "2026-09-01")
r.note = "补发上月绩效"      # 咦?报错了
实际报错(Python 3.12):
TypeError: super(type, obj): obj must be an instance or subtype of type
看着莫名其妙对吧?这其实是 slots=True 在作怪:类没有 __dict__,给实例加没声明过的属性,__setattr__ 找不到落点,一路抛到 super() 就炸了。
而如果你改已有属性(比如 r.amount = 100),报的是另一个错:
dataclasses.FrozenInstanceError: cannot assign to field 'amount'
原因
IncomeRecord 用了 @dataclass(frozen=True, slots=True)。frozen=True 意味着“对象的属性一旦初始化就不可变”,slots=True 意味着“这个类只允许有声明过的属性”。两个一起上,等于双重锁死:既不能改已有属性,也不能加新属性。
这是故意的——我们当时为了防呆(防止手滑把某笔账的金额改了)和内存优化(省掉 __dict__),牺牲了动态加属性的灵活性。
解决
三个方向,按场景选:
- 真需要备注字段:把
note加进Record的字段声明里,而不是运行时硬塞:
@dataclass(frozen=True, slots=True)
class Record:
    item: str
    amount: int
    date: str
    kind: str = "record"
    note: str = ""          # 默认空串,不传也能建对象
-
只是临时代码,不想要锁:去掉
frozen=True和slots=True,退化成普通 dataclass。代价是失去了不可变性和内存优化。 -
就是想存额外信息:用
object.__setattr__硬改(不推荐,等于绕过保护,别学)。
教训:frozen/slots 是“设计约束”,不是“默认配置”。用之前先想清楚:这个对象到底需不需要“加戏”?需要就留出字段位,不需要就锁死。
14.2 坑 2:__iter__ 返回 self 的迭代器,两个“独立”迭代器其实是一个
症状
你写了一段代码:同时拿两个迭代器,想各自从头遍历:
from ledger import Ledger, IncomeRecord, ExpenseRecord

ledger = Ledger()
ledger.add(IncomeRecord("工资", 8000, "2026-09-01"))
ledger.add(ExpenseRecord("吃饭", 25, "2026-09-02"))
ledger.add(ExpenseRecord("地铁", 6, "2026-09-03"))

it1 = iter(ledger)   # 第一个迭代器
it2 = iter(ledger)   # 第二个迭代器

print(it1 is it2)    # True?!两个迭代器是同一个对象
print(next(it1).item)  # 工资
print(next(it2).item)  # 吃饭?!!it2 应该从头开始呀!
你期待的:it1 取工资,it2 独立从头取工资。
实际发生的:it1 取了工资,it2 接着取吃饭——两个迭代器互相干扰。
更隐蔽的:循环中途 break,然后想从“头”再取,结果丢了数据:
for r in ledger:
    print(r.item)   # 工资
    break
print(next(ledger).item)   # 吃饭!不是工资!for 循环把游标推进了
原因
看我们的 __iter__ 实现:
def __iter__(self):
    self._iter_pool = self.income + self.expense
    self._iter_idx = 0
    return self

def __next__(self):
    if self._iter_idx >= len(self._iter_pool):
        raise StopIteration
    rec = self._iter_pool[self._iter_idx]
    self._iter_idx += 1
    return rec
__iter__ 返回的是 self——ledger 既是“可迭代对象”(iterable),又是自己的“迭代器”(iterator)。它身上只有一个 _iter_idx,是“共享状态”。
iter(ledger) 拿到的就是 ledger 自己(试试 iter(ledger) is ledger,返回 True)。所以 it1 = iter(ledger) 和 it2 = iter(ledger) 根本就是同一个对象,共用同一个 _iter_idx。
next(it1) 走一步,_iter_idx 变成 1;紧接着 next(it2) 看到的 _iter_idx 还是 1——所以跳过了“工资”,从“吃饭”开始。你以为的两个独立迭代器,其实是同一个人穿了两件马甲。
解决
最优雅的方式是改用生成器:
def __iter__(self):
    """每次迭代都新建一个生成器,互不干扰。"""
    yield from self.income
    yield from self.expense
yield from 让 __iter__ 变成一个生成器函数,每次 iter(ledger) 都返回一个全新的生成器(独立的内部状态),互相之间零干扰。iter(ledger) is ledger 变成 False——这才是正常容器该有的样子。
这也是为什么实际项目里推荐生成器实现——不可变状态,天然防坑。
教训: 需要“可重复、可独立遍历”的容器类,__iter__ 请用生成器;非要返回 self 做有状态迭代器,就要时刻警惕“这个对象的所有遍历共享同一个游标”。
14.3 坑 3:文件名撞上标准库,import 一言不合就“偷梁换柱”
症状
你写了一个 json.py,然后:
import json
json.dumps({"a": 1})   # AttributeError: module 'json' has no attribute 'dumps'
或者更诡异:import json 成功,但 json 的属性和标准库对不上。
原因
Python 找模块的顺序是 sys.path 从前往后。而直接运行的脚本所在目录排在最前。如果你在 src/ 下放了个 json.py,import json 找到的是你自己的 json.py,标准库的 json 被“遮蔽”(shadowed)了。
解决
- 不要用标准库/常用库名做文件名:
json、datetime、logging、pathlib、pandas、requests……统统避开。 - 如果你的模块已经被遮蔽,用
import json as std_json之类绕不开——因为import json本身就被劫持了。得靠sys.modules或改路径,太绕,最干净的办法是改文件名。 - 命名规范建议:自己的模块用有业务含义的名字(
models、storage、stats),既好懂又不撞车。
教训: 模块名是“身份证”,别乱起。起名之前先想:这个文件将来会不会被 import?会不会跟标准库撞?
15. 经验清单:把第 6 篇浓缩成 5 条带走
-
class = 数据 + 行为打包。别再“函数 + 全局变量”了。
__init__负责初始化,self代表实例本身,方法通过self访问自己的数据。 -
纯数据类用
@dataclass:一行装饰器换来自动__init__/__repr__/__eq__。想要不可变加frozen=True,想省内存加slots=True——但想清楚要不要“加戏”。 -
三种方法分工:实例方法管“对象自己的事”,类方法管“整个类的事”(替代构造器),静态方法就是“挂个名号的工具函数”。
@property把方法伪装成属性,加校验不破坏接口。 -
魔法方法让你融入 Python 生态:
__str__/__repr__管打印,__iter__/__next__管for,__enter__/__exit__管with,__len__管len()。类实现这些,用起来就跟内置类型一样顺手。 -
模块化拆分铁律:一个文件只做一件事;包内用相对导入、入口用绝对导入;
if __name__ == "__main__"区分“直接跑”和“被导入”;文件名别撞标准库;__init__.py用__all__显式控制导出。
16. 数据来源与延伸阅读
本文所有技术细节均基于以下官方文档和实践验证:
- Python 官方文档
dataclasses模块:https://docs.python.org/3/library/dataclasses.html - Python 官方文档数据模型(魔术方法):https://docs.python.org/3/reference/datamodel.html
- Python 官方文档导入系统:https://docs.python.org/zh-cn/3/reference/import.html
- Python 官方文档
sys.path:https://docs.python.org/3/library/sys.html - Python 官方文档
contextlib与with语句:https://docs.python.org/3/reference/compound_stmts.html#the-with-statement - 本文所有代码均基于 Python 3.12 实测通过,零第三方依赖
17. 下篇预告
你的记账本 v0.6 脱胎换骨了:从“函数堆”变成了“对象模型 + 模块化”。Record 有了类型约束,Ledger 可以被 for 遍历,Storage 用 with 自动存取——代码不再是一堆散落的函数,而是一个有组织的系统。
但下一个问题很快冒出来:你记的账越来越多,项目种类也越来越多。你写“吃饭”“午饭”“晚餐”的时候,其实都是同一个消费类别——但程序把它们当成了三个不相关的东西。你想按“餐饮”“交通”“娱乐”分组统计,却不知道该在哪里定义这些分类。
而且,随着功能变多,错误处理也变得混乱:ValueError、FileNotFoundError、json.JSONDecodeError……每个地方都 try,但你越来越分不清“这是用户输入错了”还是“这是程序 Bug”。
下一篇,《Python 实战指南(7)——记账本学会分门别类:枚举与异常体系》,我们会引入:
enum枚举:把“收入 / 支出 / 分类”写成有名字、可校验的类型- 异常体系:自定义异常 + 异常继承,让错误处理变得清晰可控
- 用异常 + 枚举重构记账本,让它在面对“脏数据”“非法输入”“文件损坏”时,优雅地报错,而不是崩掉
预告:下一篇你会学到
Enum的基本写法、IntEnum/StrEnum的差别、自定义异常类的设计、try/except的层级与 finally、异常链(raise ... from ...)、以及如何用枚举和异常把记账本的健壮性提升一个档次。我们下篇见。
18. 常见问题 FAQ(15 个你迟早会问的)
Q1:__init__ 和 __new__ 有什么区别?
__new__ 是创建对象(返回实例),__init__ 是初始化对象(填充属性)。日常开发 99% 只写 __init__,__new__ 一般只在单例、不可变类型、元类里用。记住:__new__ 先跑,__init__ 后跑。
Q2:为什么 @dataclass 自动生成的 __init__ 不需要写 self?
它生成的是类的方法,内部当然有 self——只是你看不到而已。@dataclass 装饰器在背后生成:
def __init__(self, item, amount, date, kind="record"):
    self.item = item
    ...
你自己手写的时候还是要写 self 的。
Q3:__str__ 和 __repr__ 到底该写哪个?
至少写 __repr__,__str__ 可选。因为 Python 内置函数 print(obj) 优先用 __str__,如果没有就退回 __repr__;而 repr(obj)、交互式终端、容器打印(print([obj]))只认 __repr__。所以只写一个的话,写 __repr__。
Q4:frozen=True 和 slots=True 有什么区别?
frozen=True 管“不可变”(属性不能改,靠重写 __setattr__ 实现);slots=True 管“内存”(不用 __dict__,属性锁死为固定槽位)。两者独立,可以只用其中一个。我们两个都用了——既要防呆,又要省内存。
Q5:@dataclass 和普通 class 有什么区别?
@dataclass 是“数据类”,自动生成 __init__、__repr__、__eq__、__hash__(frozen 时)等样板代码,专为“纯粹装数据 + 少量行为”的类设计。普通 class 适合有复杂逻辑、需要完全掌控初始化的类。判断标准:如果这个类 80% 是字段,用 dataclass。
Q6:类方法(@classmethod)和静态方法(@staticmethod)到底啥区别?
类方法第一个参数是 cls(类本身),可以访问类属性、调用其他类方法,常用于“替代构造器”;静态方法没有 cls,就是个“放在类里的普通函数”,不能碰类的任何状态。需要类上下文用类方法,纯工具函数用静态方法。
Q7:@property 到底是干嘛的?
把方法“伪装”成属性,调用时不加括号:ledger.balance 而不是 ledger.balance()。最大价值是加校验不破坏接口:以前直接 ledger.amount = 5,现在 ledger.balance = -100 会抛 ValueError,外部调用方式完全不变。
Q8:迭代器(__iter__/__next__)和生成器(yield)是什么关系?
生成器是“用 yield 写出的迭代器”——它是迭代器协议的语法糖,自动实现 __iter__ 和 __next__。所以 for 能直接遍历生成器。我们的 Ledger 展示了手写迭代器的原理,实际项目建议用生成器(更简洁、无状态)。
Q9:with Storage(path) as s: 里,as s 拿到的是什么?
是 __enter__ 方法的返回值。我们的 __enter__ 返回 self(整个 Storage 对象),所以 s 就是那个 Storage,可以用 s.data、s.save()。如果 __enter__ 返回别的(比如 return self.data),as 拿到的就是 data 了——as 拿什么由你决定。
Q10:__exit__ 的 return False 是什么意思?
return True 表示“异常我吞了,别往外抛”;return False 表示“异常继续抛”。我们返回 False,因为错误就应该被看到(除非你有意处理它)。
Q11:__slots__ 能节省多少内存?
官方文档说,几百万实例场景下可省约 50% 内存。我们实测:3 字段的 dataclass 实例从 48 字节降到 32 字节(Python 3.12)。实例少无所谓,实例多很可观。
Q12:sys.path 到底怎么改?
加路径用 sys.path.insert(0, "/some/path") 或 sys.path.append(...)。但更规范的做法是:包结构配好后,从正确的位置运行入口(python src/main.py),sys.path 自动包含 src,import ledger 自然能找到。测试脚本里我们手动 sys.path.insert(0, str(SRC)),是为了“不管从哪运行都能跑”。
Q13:相对导入(.models)和绝对导入(ledger.models)怎么选?
包内模块互引用:相对导入(.models、..storage),改包名不用改内部;包外入口:绝对导入(from ledger import ...),入口脚本没有父包,不能用相对导入。两者混用容易乱,定好规矩就好。
Q14:为什么 if __name__ == "__main__" 下面还能有代码?
能啊。这个 if 只是“只有直接运行本文件时才执行块内代码”。块外的代码(类定义、函数定义、常量)每次 import 都会执行——所以别把“有副作用的代码”(比如打印、文件读写)写在模块顶层。这是模块化基本功。
Q15:既然 class 这么好,前五篇为什么不用?
因为时机。class 是“抽象工具”,你连函数、字典、文件都没玩熟,直接上 class 会变成“死记语法”。前五篇用“函数堆”把你喂饱了真实痛点(传参传麻了、全局变量到处飞),这五篇再上 class,你才懂它解决的是真问题。教学不是“越早用越高级”,而是“该用的时候刚好会用”。
19. 作业
-
给
Record加一个note字段:修改models.py的Record,加note: str = "",然后给IncomeRecord/ExpenseRecord传备注,看看__repr__和存储是否自动兼容。提示:to_dict()也要把note带上。 -
给
Ledger加一个__getitem__魔法方法:实现ledger[0]返回第一笔记录、ledger[-1]返回最后一笔。提示:__getitem__(self, index)直接索引self.income + self.expense列表。 -
把
Storage.__exit__改成“有异常也保存,但打印警告”:对比现在的行为(异常不保存),体会哪种更合理。提示:__exit__里if exc_type is not None: print("警告:异常时保存了"),然后无条件self.save()。 -
用
@property给Ledger加一个total_count:返回总笔数(len(self.income) + len(self.expense)),和__len__对比一下,哪种方式调用更自然? -
把
main.py里重复的try/except提炼成一个自定义异常:定义一个InputError(继承ValueError),parse_input里raise InputError(...),main()里统一except InputError。提示:自定义异常只需class InputError(ValueError): pass。
20. 收尾
你的记账本从 v0.1 到 v0.6,六篇教程,一个真实项目,从零开始一路长成“系统”。
回顾这条进化轨迹:
- v0.1:能记一笔(变量、输入输出、循环)
- v0.2:会判断(if/elif/else)
- v0.3:能记住账(文件读写、JSON 持久化)
- v0.4:会总结(排序、分组、统计、ASCII 图表)
- v0.5:懂时间(datetime、日期解析、范围查询、周度统计)
- v0.6:会“拆家”(class、dataclass、三种方法、继承多态、迭代器、上下文管理器、模块化)
第六篇不是“学会了一个新语法”,而是思维方式的转折:你从“写函数”升级到了“设计系统”。Record、Ledger、Storage 不再是一段段代码,而是有职责、有关系、有边界的对象。别人读你的代码,不再需要从头捋到尾——打开 models.py 就知道数据长什么样,打开 storage.py 就知道怎么存,打开 stats.py 就知道怎么算。
这就是工程化。它不是“更复杂的代码”,而是“更不容易出错的代码”。
下一篇我们继续升级——让记账本“学会分门别类、优雅报错”。我们下篇见。


 扫一扫


——记账本太大了,得拆家了:class 与模块化重构&spm=1001.2101.3001.5002&articleId=165276883&d=1&t=3&u=c67a21dd875641e89f9018ccd10a7dce)
 35

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


