数据库常见索引解析(B树,B-树,B+树,B*树,位图索引,Hash索引)

数据库索引 - B树 目录 1. 前言 1.1 B树、B+树出现原因? 1.2 一种新的查找树结构——多路查找树 2. 多路查找树 —— 平衡树—— B树 查询 插入 删除 3、B+树 1. 前言 参考:https://blog.csdn.net/z_ryan/article/details/79685072 二叉查找树的查找时间复杂度为O(log(2,N)),其查找效率已经足够高了,那为什么还有B树和B+树的出现呢?难道它两的时间复杂度比二叉查找树还小吗? IO操作的效率很低,那么,当在大量数据存. 阅读详情

B树

       即二叉搜索树:

       1.所有非叶子结点至多拥有两个儿子(Left和Right);

       2.所有结点存储一个关键字;

       3.非叶子结点的左指针指向小于其关键字的子树,右指针指向大于其关键字的子树;

       如:
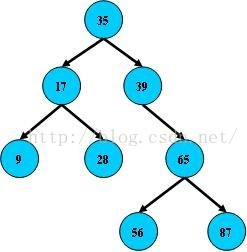
       

       B树的搜索,从根结点开始,如果查询的关键字与结点的关键字相等,那么就命中;否则,如果查询关键字比结点关键字小,就进入左儿子;如果比结点关键字大,就进入右儿子;如果左儿子或右儿子的指针为空,则报告找不到相应的关键字;

       如果B树的所有非叶子结点的左右子树的结点数目均保持差不多(平衡),那么B树的搜索性能逼近二分查找;但它比连续内存空间的二分查找的优点是,改变B树结构(插入与删除结点)不需要移动大段的内存数据,甚至通常是常数开销;

       如:
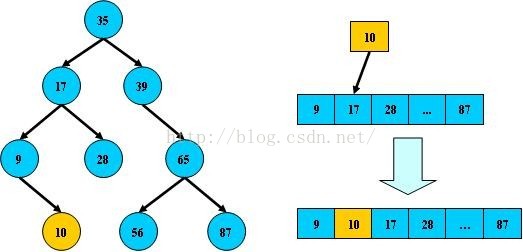
      

   但B树在经过多次插入与删除后,有可能导致不同的结构:
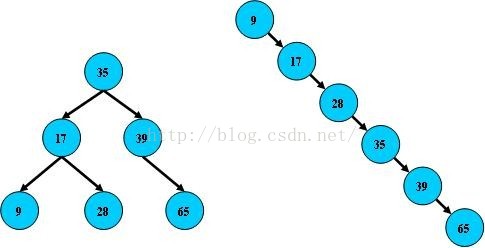
  

   右边也是一个B树,但它的搜索性能已经是线性的了;同样的关键字集合有可能导致不同的树结构索引;所以,使用B树还要考虑尽可能让B树保持左图的结构,和避免右图的结构,也就是所谓的“平衡”问题;      

       实际使用的B树都是在原B树的基础上加上平衡算法,即“平衡二叉树”;如何保持B树结点分布均匀的平衡算法是平衡二叉树的关键;平衡算法是一种在B树中插入和删除结点的策略。常见的平衡二叉树有:AVL,RBT,Treap,Splay Tree。

B-树

是一种多路搜索树(并不是二叉的):

       1.定义任意非叶子结点最多只有M个儿子;且M>2;

       2.根结点的儿子数为[2, M];

       3.除根结点以外的非叶子结点的儿子数为[M/2,M];

       4.每个结点存放至少M/2-1(取上整)和至多M-1个关键字;(至少2个关键字)

       5.非叶子结点的关键字个数=指向儿子的指针个数-1;

       6.非叶子结点的关键字:K[1], K[2], …, K[M-1];且K[i] < K[i+1];

       7.非叶子结点的指针:P[1], P[2], …, P[M];其中P[1]指向关键字小于K[1]的子树,P[M]指向关键字大于K[M-1]的子树,其它P[i]指向关键字属于(K[i-1], K[i])的子树;

       8.所有叶子结点位于同一层;

       如:(M=3)
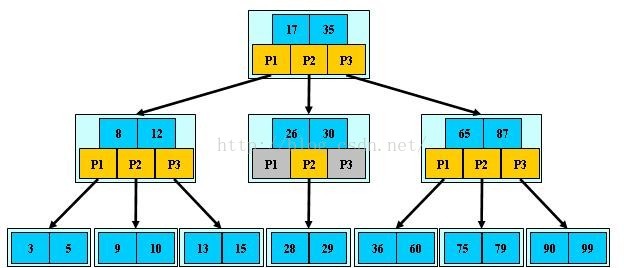

  B-树的搜索,从根结点开始,对结点内的关键字(有序)序列进行二分查找,如果命中则结束,否则进入查询关键字所属范围的儿子结点;重复,直到所对应的儿子指针为空,或已经是叶子结点;

B-树的特性:

       1.关键字集合分布在整颗树中;

       2.任何一个关键字出现且只出现在一个结点中;

       3.搜索有可能在非叶子结点结束;

       4.其搜索性能等价于在关键字全集内做一次二分查找;

       5.自动层次控制;

       由于限制了除根结点以外的非叶子结点,至少含有M/2个儿子,确保了结点的至少利用率,其最底搜索性能为:
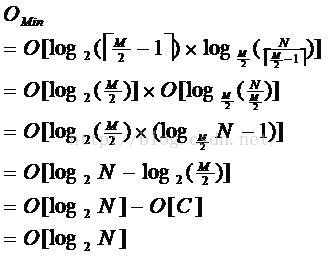

其中,M为设定的非叶子结点最多子树个数,N为关键字总数;

       所以B-树的性能总是等价于二分查找(与M值无关),也就没有B树平衡的问题;

       由于M/2的限制,在插入结点时,如果结点已满,需要将结点分裂为两个各占M/2的结点;删除结点时,需将两个不足M/2的兄弟结点合并;

B+树

  B+树是B-树的变体,也是一种多路搜索树:

       1.其定义基本与B-树同,除了:

       2.非叶子结点的子树指针与关键字个数相同;

       3.非叶子结点的子树指针P[i],指向关键字值属于[K[i], K[i+1])的子树(B-树是开区间);

       5.为所有叶子结点增加一个链指针;

       6.所有关键字都在叶子结点出现;

       如:(M=3)
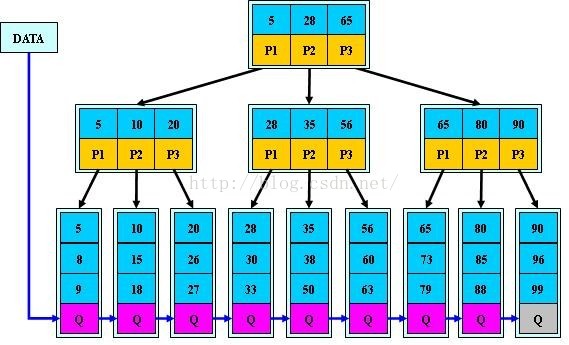

B+的搜索与B-树也基本相同,区别是B+树只有达到叶子结点才命中(B-树可以在非叶子结点命中),其性能也等价于在关键字全集做一次二分查找;

       B+的特性:

       1.所有关键字都出现在叶子结点的链表中(稠密索引),且链表中的关键字恰好是有序的;

       2.不可能在非叶子结点命中;

       3.非叶子结点相当于是叶子结点的索引(稀疏索引),叶子结点相当于是存储(关键字)数据的数据层;

       4.更适合文件索引系统;


B*树

是B+树的变体,在B+树的非根和非叶子结点再增加指向兄弟的指针;
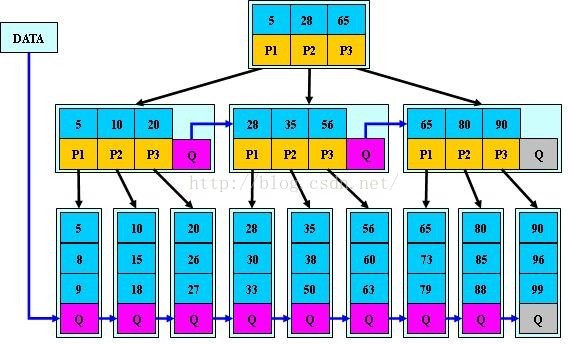

B*树定义了非叶子结点关键字个数至少为(2/3)*M,即块的最低使用率为2/3(代替B+树的1/2);

       B+树的分裂:当一个结点满时,分配一个新的结点,并将原结点中1/2的数据复制到新结点,最后在父结点中增加新结点的指针;B+树的分裂只影响原结点和父结点,而不会影响兄弟结点,所以它不需要指向兄弟的指针;

       B*树的分裂:当一个结点满时,如果它的下一个兄弟结点未满,那么将一部分数据移到兄弟结点中,再在原结点插入关键字,最后修改父结点中兄弟结点的关键字(因为兄弟结点的关键字范围改变了);如果兄弟也满了,则在原结点与兄弟结点之间增加新结点,并各复制1/3的数据到新结点,最后在父结点增加新结点的指针;

       所以,B*树分配新结点的概率比B+树要低,空间使用率更高;

小结

       B树:二叉树,每个结点只存储一个关键字,等于则命中,小于走左结点,大于走右结点;

       B-树:多路搜索树,每个结点存储M/2到M个关键字,非叶子结点存储指向关键字范围的子结点;

       所有关键字在整颗树中出现,且只出现一次,非叶子结点可以命中;

       B+树:在B-树基础上,为叶子结点增加链表指针,所有关键字都在叶子结点中出现,非叶子结点作为叶子结点的索引;B+树总是到叶子结点才命中;

       B*树:在B+树基础上,为非叶子结点也增加链表指针,将结点的最低利用率从1/2提高到2/3


位图索引

1.案例

有张表名为table的表,由三列组成,分别是姓名、性别和婚姻状况,其中性别只有男和女两项,婚姻状况由已婚、未婚、离婚这三项,该表共有100w个记录。现在有这样的查询:     select * from table where Gender=‘男’ and Marital=“未婚”;

姓名(Name)

性别(Gender)

婚姻状况(Marital)

张三

男

已婚

李四

女

已婚

王五

男

未婚

赵六

女

离婚

孙七

女

未婚

...

...

...

1)不使用索引

  不使用索引时,数据库只能一行行扫描所有记录,然后判断该记录是否满足查询条件。

2)B树索引

  对于性别,可取值的范围只有'男','女',并且男和女可能各站该表的50%的数据,这时添加B树索引还是需要取出一半的数据, 因此完全没有必要。相反,如果某个字段的取值范围很广,几乎没有重复,比如身份证号,此时使用B树索引较为合适。事实上,当取出的行数据占用表中大部分的数据时,即使添加了B树索引,数据库如oracle、MySQL也不会使用B树索引,很有可能还是一行行全部扫描。

2.位图索引出马

如果用户查询的列的基数非常的小, 即只有的几个固定值,如性别、婚姻状况、行政区等等。要为这些基数值比较小的列建索引,就需要建立位图索引。

对于性别这个列,位图索引形成两个向量,男向量为10100...,向量的每一位表示该行是否是男,如果是则位1,否为0,同理,女向量位01011。

RowId

1

2

3

4

5

...

男

1

0

1

0

0


女

0

1

0

1

1

 ...

  对于婚姻状况这一列,位图索引生成三个向量,已婚为11000...,未婚为00100...,离婚为00010...。

RowId

1

2

3

4

5

...

已婚

1

1

0

0

0


未婚

0

0

1

0

1


离婚

0

0

0

1

0


   当我们使用查询语句“select * from table where Gender=‘男’ andMarital=“未婚”;”的时候 首先取出男向量10100...,然后取出未婚向量00100...,将两个向量做and操作,这时生成新向量00100...,可以发现第三位为1,表示该表的第三行数据就是我们需要查询的结果。 

RowId

1

2

3

4

5

男

1

0

1

0

0

and


未婚

0

0

1

0

1

结果

0

0

1

0

0

3.位图索引适应场景

上面讲了,位图索引适合只有几个固定值的列,如性别、婚姻状况、行政区等等,而身份证号这种类型不适合用位图索引。

  此外,位图索引适合静态数据,而不适合索引频繁更新的列。举个例子,有这样一个字段busy,记录各个机器的繁忙与否,当机器忙碌时,busy为1,当机器不忙碌时,busy为0。

  这个时候有人会说使用位图索引,因为busy只有两个值。好,我们使用位图索引索引busy字段!假设用户A使用update更新某个机器的busy值,比如update table set table.busy=1 where rowid=100;,但还没有commit,而用户B也使用update更新另一个机器的busy值,update table set table.busy=1 where rowid=12; 这个时候用户B怎么也更新不了,需要等待用户A commit。

  原因:用户A更新了某个机器的busy值为1,会导致所有busy为1的机器的位图向量发生改变,因此数据库会将busy=1的所有行锁定,只有commit之后才解锁。


Hash索引

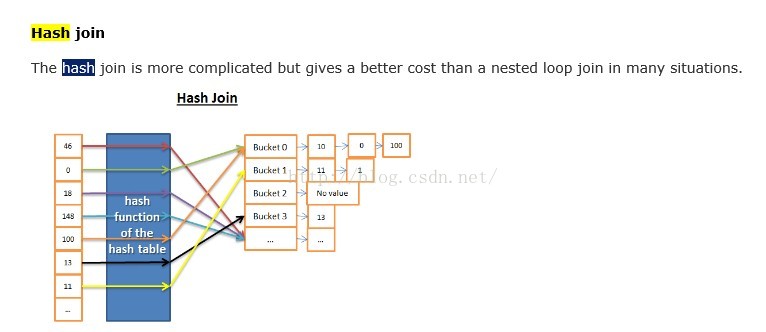
索引列会被存储在匹配到的hash bucket里面的表里,这个表里会有实际的数据行指针,再根据实际的数据行指针查找对应的数据行。
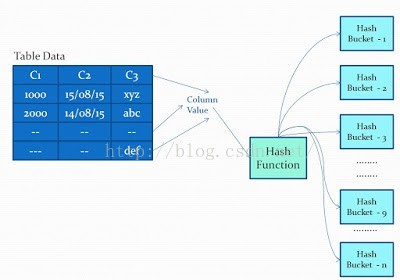

概括来说,要查找一行数据或者处理一个where子句,SQL Server引擎需要做下面几件事

1、根据where条件里面的参数生成合适的哈希函数

2、索引列进行匹配,匹配到对应hash bucket,找到对应hash bucket意味着也找到了对应的数据行指针(row pointer)

3、读取数据

哈希索引比起B树索引简单,因为它不需要遍历B树,所以访问速度会更快

Hash索引的缺点:

1、因为Hash索引比较的是经过Hash计算的值,所以只能进行等式比较,不能用于范围查询

2、由于哈希值是按照顺序排列的,但是哈希值映射的真正数据在哈希表中就不一定按照顺序排列,所以无法利用Hash索引来加速任何排序操作

3、不能用部分索引键来搜索,因为组合索引在计算哈希值的时候是一起计算的。

4、当哈希值大量重复且数据量非常大时,其检索效率并没有Btree索引高的。

MySQL中的B+树索引(聚簇索引/聚集索引、辅助索引/二级索引、联合索引/复合索引、覆盖索引、回表)详解 聚集索引/聚簇索引--主键 所有的数据辅助索引/二级索引--索引列—+主键。查看其他列–>回表(聚集索引/聚簇索引联合索引/复合索引--(多个列+主键)->覆盖索引(不是索引) 阅读详情

相关推荐

4种常见的数据库索引

本文介绍了数据库常见的4种索引和其原理,包括B-Tree索引,哈希索引,位图索引和全文索引,每种索引都有自己的特点,在实际中请根据业务场景选择适合的索引。

2202

B树索引

B-Tree索引是最常见的索引结构,如oracle和mongodb的索引都是B-Tree,而mysql的索引类型是B+Tree 一、B树索引的结构 B-树索引是基于二叉树结构的。B-树索引结构有3个基本组成部分:根节点、分支节点和叶子节点。其中根节点位于索引结构的最顶端,而叶子节点位于索引结构的最底端,中间为分子节点。 叶子节点(Leaf node):包含条目直接指向表里的数据行。 分支节点(Branch node):包含的条目指向索引里其他的分支节点或者是叶子节点。 根...

XiaoGong1688的博客 5789

59、数据库索引:B*Tree与位图索引的深入解析

本文深入解析了数据库索引中的B*Tree索引和位图索引,详细介绍了它们的原理、适用场景以及性能对比。文章还讨论了索引选择对查询效率的影响,包括聚类因子的作用和优化器的决策机制,帮助读者在不同数据特点和查询需求下合理选择索引类型以优化数据库性能。

svm4gardener的博客 72

不得不看的B树索引

索引 一、先导: 要想了解B 树索引,首先要了解树的数据结构,二叉树,平衡二叉树,B-树,B+树。 1、二叉树: 每个结点最多有两个子树的树结构 二叉树的特性: 每个结点都包含一个元素和n个子树,0<=n<=2 左子树和右子树是有顺序的,次序不能颠倒。左子树的值小于父结点的值,父结点的值小于右子树的值 练习:[31 18 73 9 27 37 99] 上面数据经过一系列插入后:变成...

baidu_35160588的博客 923

基于Xilinx Artix7 的FPGA高级应用 (二):千兆以太网通信(实战篇)第一期

本项目是基于Xlinx Artix7 XC7A35T芯片 以太网芯片选用的是RTL8211EG PHY芯片 MAC 和PHY接口标准是GMII 开发工具是vivado 2018.3 我们先来复习一下以太网的基本通信原理: 当我们的计算机需要与局域网中另外的设备进行通信的时候,需要将数据传输到网卡进行编码,然后传输到线上,经过另一个设备的网卡解码成该设备能读取的数据。 关于以太网协议的知识在原理篇中已经讲过,不再重复,下面直接看接收代码: 首先注意我们的MAC和PHY通信选择的是GMII接口标准,发送数据一

工大技术底层人员的博客 4027

【RK3399】Android平台增加一款声卡设备(ES7210+ES8156),进行录音/播放测试。

文章目录前言一、开发环境二、概述三、硬件介绍1、ES72102、ES81563、数字麦克风阵列4、音频示意图四、下载SDK五、编译、烧写1、u-boot2、kernel3、Android SDK4、烧写分区5、烧写固件六、声卡驱动1、添加codec代码2、修改Kconfig3、修改Makefile4、修改rockchip_defconfig5、修改DTS七、声卡调试1、查看声卡注册信息2、使用tinycap/tinyplay录音和放音3、使用示波器观测八、修改HAL层1、修改默认capture/playba

rentong123的博客 2万+

数据库索引的结构

常见的数据库索引的结构有以下几种: 1 B+树索引     B+树是应文件系统所需而出的一种B树的变型树。一棵m阶的B+树和m阶的B-树的差异在于: 1.有n棵子树的结点中含有n个关键字,每个关键字不保存数据,只用来索引,所有数据都保存在叶子节点。 2.所有的叶子结点中包含了全部关键字的信息,及指向含这些关键字记录的指针,且叶子结点本身依关键字的大小自小而大顺序链接。 3.所有的非终

zhoxing 1321

400G光模块测试全攻略:从PCS层到CMIS合规的避坑指南

本文为网络设备测试工程师和光通信研发人员提供了一份详尽的400G光模块测试实战指南。文章深入剖析了从PCS层信号完整性、FEC容限到CMIS管理接口合规性测试的全流程,并分享了ANLT协议分析、SerDes眼图调试以及系统级流量压力测试中的核心技巧与常见避坑点,旨在帮助读者构建一套高效、精准的测试体系,确保高速光模块的可靠性与性能。

weixin_29300931的博客 197

mysql

1、数据库常见索引解析(B树,B-树,B+树,B*树,位图索引,Hash索引) https://www.pianshen.com/article/3795742934/

weixin_42290945的博客 300

Ubuntu22.04+Docker一键部署Autoware Universe避坑指南(附鱼香ROS配置)

本文详细介绍了在Ubuntu22.04系统中使用Docker一键部署Autoware Universe的完整流程,包括鱼香ROS工具链配置、Docker环境优化及VSCode开发环境集成。通过实战指南帮助开发者快速搭建自动驾驶开发环境,解决常见部署问题,提升开发效率。

weixin_29254673的博客 410

科研绘图系列:R语言circos图(circos plot)

科研绘图系列:R语言circos图(circos plot)

专注生信领域 3425

MySQL Hash索引和B-Tree索引的区别

MySQL Hash索引和B-Tree索引的区别究竟在哪里呢?相信很多人都有这样的疑问,下文对两者的区别进行了详细的分析,供您参考。 MySQL Hash索引结构的特殊性,其检索效率非常高,索引的检索可以一次定位,不像B-Tree 索引需要从根节点到枝节点,最后才能访问到页节点这样多次的IO访问,所以 Hash 索引的查询效率要远高于 B-Tree 索引。  可 能很多人又有疑问了,既然

黄江洪的博客 243

创龙 瑞芯微 RK3588 国产2.4GHz八核 工业开发板—ISP图像处理开发案例

创龙科技研发的 TL3588-EVM 评估板具备强大视频处理能力,可满足多场景视频开发需求。为助力开发者快速上手,本文整理 7 个实用视频开发案例,涵盖从采集到显示的全流程,详细说明各案例的硬件连接、参数配置与代码解析,帮助开发者高效实现评估板视频相关功能开发与调试。

创龙,嵌入式一体化解决方案商 199

索引到底有多强?B+树、哈希、位图一文搞懂,含高频面试题解析

类型结构场景B+树多路平衡树范围、排序、前缀哈希哈希表精确查找位图位向量维度小的字段“索引是数据库的加速器,而 B+ 树是它的发动机。项目聚簇索引(Clustered)非聚簇索引(Non-Clustered)数据存储位置索引结构中存储数据行索引结构中存储指向数据行的指针数据顺序数据按索引顺序物理排列数据和索引分开存储每张表支持只有一个(主键)可以有多个访问方式直接查到数据需要“回表”查主键再找数据速度表现快,尤其是范围查询、排序慢一点,适合精确查询。

一键难忘的博客 3642

《用 Python 爬取统计局年鉴:从 API 抓取到结构化分析,实战全流程详解》

在数据分析、经济研究、商业决策中,国家统计局发布的年鉴数据具有权威性和参考价值。本篇博客将带你从零实践:了解目标、设计爬虫、抓取年度数据、解析 JSON、保存结构化数据、并用 Pandas 简要分析可视化,且使用现代 Python 最佳实践(如httpx、pydantic、typer 等),提升代码质量与效率。如何抓取国家统计局年鉴数据;利用 API 方式高效获取;使用现代异步 Python 提升性能;将数据结构化输出;结合 CLI、类型校验和简单分析技术提升实用性。

2201_76125261的博客 1078

MIKE 21 教程 1.2 网格搭建界面介绍之点线面要素的高阶处理 (Mesh Generator 工具)

MIKE 21 教程 手把手教学系列 1.1 网格搭建界面介绍之点线面要素的高阶处理 (Mesh Generator 工具) ​ 上一篇文章讲解了如何创建基本的点、线、面要素 MIKE 21 教程 1.1 网格搭建界面介绍之点线面的创建 本节来讲一下对点线面要素的高阶处理,主要包括要素修改与打断线(break line)的讲解 ​

Hello Word 4129

数据库常见索引

1.什么是索引 数据库索引好比是一本书前面的目录,能加快数据库的查询速度。 2.索引的优缺点 优点: 1.大大加快数据的检索速度 2.创建唯一性索引,保证数据库表中每一行数据的唯一性 3.加速表和表之间的连接 4.在使用分组和排序子句进行数据检索时,可以显著减少查询中分组和排序的时间 缺点 1.索引需要占用数据表以外的物理存储空间 2.创建索引和维护索引要花费一定的时间...

feiyang5260的博客 5702

SAP B1中文培訓教材_SDK

公司内部培训资料,对开发工具 ,DIAPI, UIAPI,Add-ON有详细解说

Hash索引与BitMap索引

Hash索引 概念 hash index是基于哈希表实现的,只有精确匹配索引所有列的查询才会生效。对于每一行数据,存储引擎都会对所有的索引列计算一个hash code,并将的有的hash code存储在索引中,同时在哈希表中保存指向每个数据行的指针。 在MySQL中,只有Memory引擎显示支持哈希索引,也是默认索引类型。 比如 create table test_hash( fname varc...

JustinNeil的博客 903

lwip-2.0.3

lwip是瑞典计算机科学院(SICS)的Adam Dunkels 开发的一个小型开源的TCP/IP协议栈。实现的重点是在保持TCP协议主要功能的基础上减少对RAM 的占用。

华为的C语言编程规范.pdf

华为技术有限公司内部技术规范。本规范制定了编写C语言程序的基本原则、规则和建议。从代码的清晰、简洁、可测试、安全、程序效率、可移植各个方面对C语言编程作出了具体指导。

上一篇: Spark-Sql源码解析之八 Codegen
下一篇: 从 MongoDB 及 Mysql 谈B-/B+树
亮亮-AC米兰
博客等级 码龄17年 233粉丝 46原创
评论 8
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值