从 MongoDB 及 Mysql 谈B-/B+树

为什么 MongoDB 索引选择B树,而 Mysql 选择B+树 前言 之前有人看了我的博客提出了这个问题,我懒省事让他自行百度,今天发现网上的答案很多,但是很啰嗦或者让人看不懂,所以就写下了这篇文章 一、B树和B+树的区别 很明显,我们要想弄清楚原因就要知道B树和B+树的区别。为了不长篇大论。我们直接给出他们的形式总结他们的特点。 1、B树 B树是一种自平衡的搜索树,形式很简单: 这就是一颗B树。针对我们这个问题的最核心的特点如下: (1)多路,非二叉树 (... 阅读详情

装载自:http://blog.csdn.net/wwh578867817/article/details/50493940

前两天有位朋友邀请我回答个问题,为什么 MongoDB (索引)使用B-树而 MySQL 使用 B+树?我觉得这个问题非常好,从实际应用的角度来学习数据结构,没有比这更好的方法了。因为像 Mysql 和 MongoDB 这种经久考验的大型软件在设计上都是精益求精的,它们为什么选择这些数据结构?:)

本文从实际应用的角度来介绍以及分析B-树和B+树。


B-树由来

定义:B-树是一类树,包括B-树、B+树、B*树等,是一棵自平衡的搜索树,它类似普通的平衡二叉树,不同的一点是B-树允许每个节点有更多的子节点。B-树是专门为外部存储器设计的,如磁盘,它对于读取和写入大块数据有良好的性能,所以一般被用在文件系统及数据库中。

定义只需要知道B-树允许每个节点有更多的子节点即可。子节点数量一般在上千,具体数量依赖外部存储器的特性。

先来看看为什么会出现B-树这类数据结构。

传统用来搜索的平衡二叉树有很多,如 AVL 树,红黑树等。这些树在一般情况下查询性能非常好,但当数据非常大的时候它们就无能为力了。原因当数据量非常大时,内存不够用,大部分数据只能存放在磁盘上,只有需要的数据才加载到内存中。一般而言内存访问的时间约为 50 ns,而磁盘在 10 ms 左右。速度相差了近 5 个数量级,磁盘读取时间远远超过了数据在内存中比较的时间。这说明程序大部分时间会阻塞在磁盘 IO 上。那么我们如何提高程序性能?减少磁盘 IO 次数,像 AVL 树,红黑树这类平衡二叉树从设计上无法“迎合”磁盘。 
关于磁盘可参考 浅谈计算机中的存储模型(四)磁盘
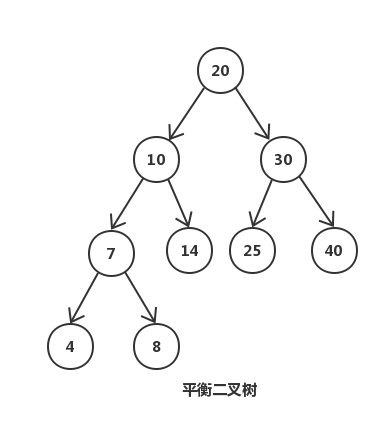
平衡二叉树

上图是一颗简单的平衡二叉树,平衡二叉树是通过旋转来保持平衡的,而旋转是对整棵树的操作,若部分加载到内存中则无法完成旋转操作。其次平衡二叉树的高度相对较大为 log n(底数为2),这样逻辑上很近的节点实际可能非常远,无法很好的利用磁盘预读(局部性原理),所以这类平衡二叉树在数据库和文件系统上的选择就被 pass 了。

空间局部性原理:如果一个存储器的某个位置被访问,那么将它附近的位置也会被访问。

我们从“迎合”磁盘的角度来看看B-树的设计。

索引的效率依赖与磁盘 IO 的次数,快速索引需要有效的减少磁盘 IO 次数,如何快速索引呢?索引的原理其实是不断的缩小查找范围,就如我们平时用字典查单词一样,先找首字母缩小范围,再第二个字母等等。平衡二叉树是每次将范围分割为两个区间。为了更快,B-树每次将范围分割为多个区间,区间越多,定位数据越快越精确。那么如果节点为区间范围,每个节点就较大了。所以新建节点时,直接申请页大小的空间(磁盘是按 block 分的,一般为 512 Byte。磁盘 IO 一次读取若干个 block,我们称为一页,具体大小和操作系统有关,一般为 4 k,8 k或 16 k),计算机内存分配是按页对齐的,这样就实现了一个节点只需要一次 IO。
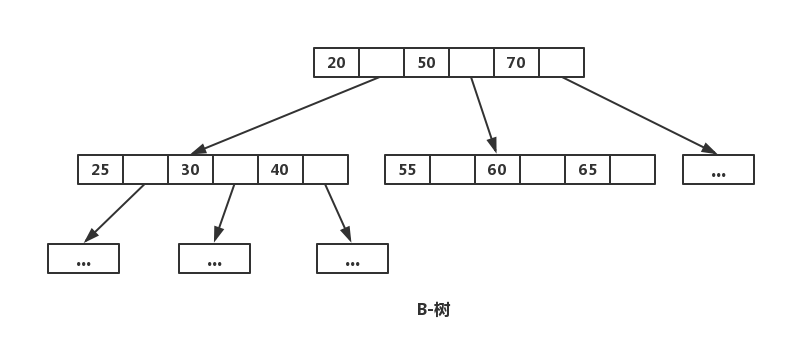
B-树

上图是一棵简化的B-树,多叉的好处非常明显,有效的降低了B-树的高度,为底数很大的 log n,底数大小与节点的子节点数目有关,一般一棵B-树的高度在 3 层左右。层数低,每个节点区确定的范围更精确,范围缩小的速度越快。上面说了一个节点需要进行一次 IO,那么总 IO 的次数就缩减为了 log n 次。B-树的每个节点是 n 个有序的序列(a1,a2,a3…an),并将该节点的子节点分割成 n+1 个区间来进行索引(X1< a1, a2 < X2 < a3, … , an+1 < Xn < anXn+1 > an)。


B-树
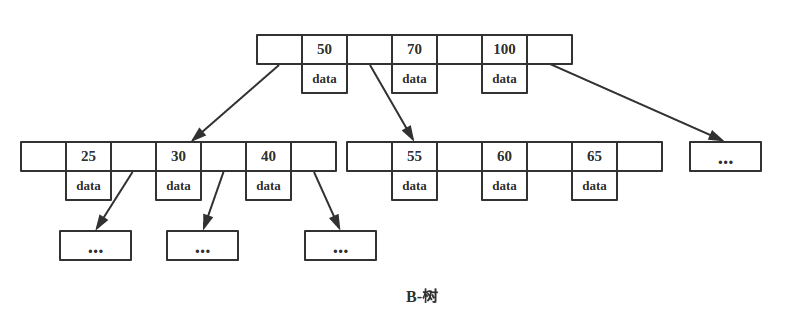
B-树

上图是一颗B-树,B-树的每个节点有 d~2d 个 key,2 这个因子指明了树的分裂及合并的规则,这个规则维持了B-树的平衡。

B-树的插入和删除就不具体介绍了,很多资料都描述了这一过程。在普通平衡二叉树中,插入删除后若不满足平衡条件则进行 旋转 操作,而在B-树中,插入删除后不满足条件则进行分裂及合并操作。

简单叙述下分裂及合并操作。

分裂:如果有一个节点有 2d 个 key,增加一个后为 2d+1 个 key,不符合上述规则 B-树的每个节点有 d~2d 个 key,大于 2d,则将该节点进行分裂,分裂为两个 d 个 key 的节点并将中值 key 归还给父节点。 
合并:如果有一个节点有 d 个 key,删除一个后为 d-1 个 key,不符合上述规则 B-树的每个节点有 d~2d 个 key,小于 d,则将该节点进行合并,合并后若满足条件则合并完成,不满足则均分为两个节点。

B-树的查找

我们来看看B-树的查找,假设每个节点有 n 个 key值,被分割为 n+1 个区间,注意,每个 key 值紧跟着 data 域,这说明B-树的 key 和 data 是聚合在一起的。一般而言,根节点都在内存中,B-树以每个节点为一次磁盘 IO,比如上图中,若搜索 key 为 25 节点的 data,首先在根节点进行二分查找(因为 keys 有序,二分最快),判断 key 25 小于 key 50,所以定位到最左侧的节点,此时进行一次磁盘 IO,将该节点从磁盘读入内存,接着继续进行上述过程,直到找到该 key 为止。

查找伪代码

Data* BTreeSearch(Root *node, Key key)
{
    Data* data;

    if(root == NULL)
        return NULL;
    data = BinarySearch(node);
    if(data->key == key)
    {
        return data;
    }else{
        node = ReadDisk(data->next);
        BTreeSearch(node, key);
    }
}
 
  • 1
  • 2
  • 3
  • 4
  • 5
  • 6
  • 7
  • 8
  • 9
  • 10
  • 11
  • 12
  • 13
  • 14
  • 15
  • 1
  • 2
  • 3
  • 4
  • 5
  • 6
  • 7
  • 8
  • 9
  • 10
  • 11
  • 12
  • 13
  • 14
  • 15

B+树

B+树是B-树的变种,它与B-树的不同之处在于:

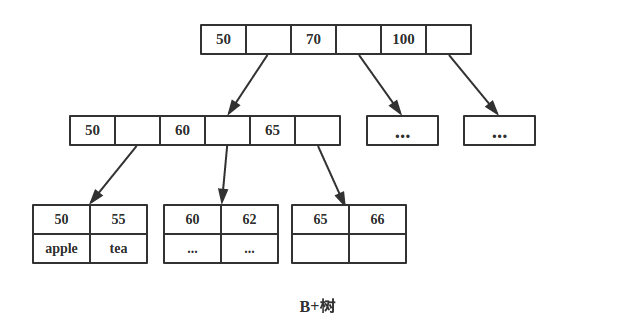
  • 在B+树中,key 的副本存储在内部节点,真正的 key 和 data 存储在叶子节点上 。
  • n 个 key 值的节点指针域为 n 而不是 n+1。

如下图为一颗B+树:
B+树

因为内节点并不存储 data,所以一般B+树的叶节点和内节点大小不同,而B-树的每个节点大小一般是相同的,为一页。

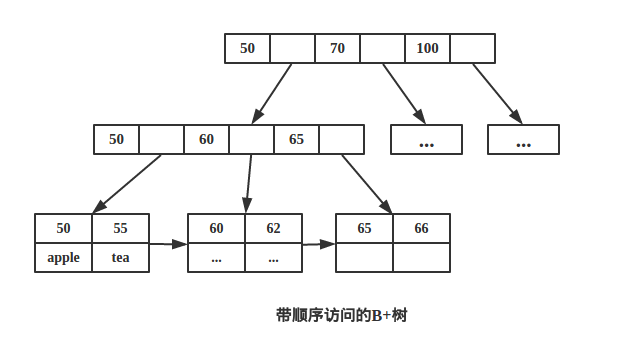
为了增加 区间访问性,一般会对B+树做一些优化。 
如下图带顺序访问的B+树。
带顺序访问的B+树


B-树和B+树的区别

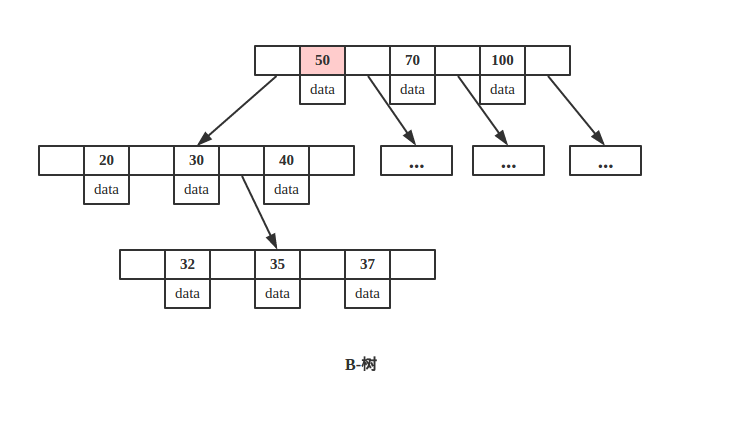
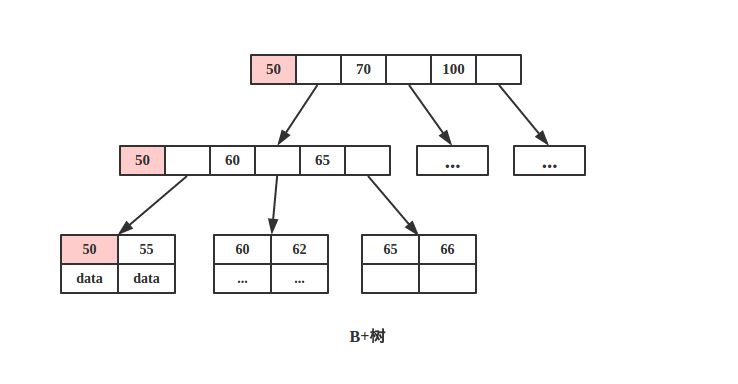
1.B+树内节点不存储数据,所有 data 存储在叶节点导致查询时间复杂度固定为 log n。而B-树查询时间复杂度不固定,与 key 在树中的位置有关,最好为O(1)。

如下所示B-树/B+树查询节点 key 为 50 的 data。

B-树
B-树

从上图可以看出,key 为 50 的节点就在第一层,B-树只需要一次磁盘 IO 即可完成查找。所以说B-树的查询最好时间复杂度是 O(1)。


B+树
B+树

由于B+树所有的 data 域都在根节点,所以查询 key 为 50的节点必须从根节点索引到叶节点,时间复杂度固定为 O(log n)。


2.B+树叶节点两两相连可大大增加区间访问性,可使用在范围查询等,而B-树每个节点 key 和 data 在一起,则无法区间查找。
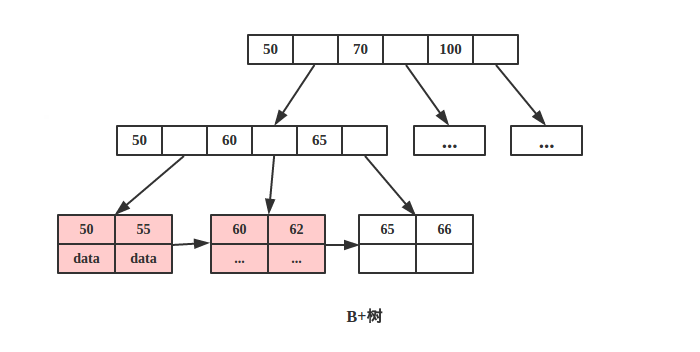
B+树

根据空间局部性原理:如果一个存储器的某个位置被访问,那么将它附近的位置也会被访问。

B+树可以很好的利用局部性原理,若我们访问节点 key为 50,则 key 为 55、60、62 的节点将来也可能被访问,我们可以利用磁盘预读原理提前将这些数据读入内存,减少了磁盘 IO 的次数。 
当然B+树也能够很好的完成范围查询。比如查询 key 值在 50-70 之间的节点。


3.B+树更适合外部存储。由于内节点无 data 域,每个节点能索引的范围更大更精确

这个很好理解,由于B-树节点内部每个 key 都带着 data 域,而B+树节点只存储 key 的副本,真实的 key 和 data 域都在叶子节点存储。前面说过磁盘是分 block 的,一次磁盘 IO 会读取若干个 block,具体和操作系统有关,那么由于磁盘 IO 数据大小是固定的,在一次 IO 中,单个元素越小,量就越大。这就意味着B+树单次磁盘 IO 的信息量大于B-树,从这点来看B+树相对B-树磁盘 IO 次数少。
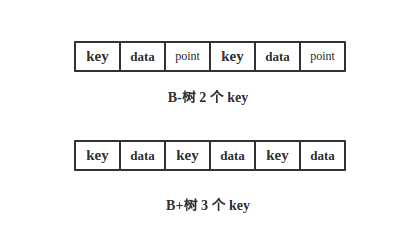
B/B+树

从上图可以看出相同大小的区域,B-树仅有 2 个 key,而B+树有 3 个 key。


为什么 MongoDB 索引选择B-树,而 Mysql 索引选择B+树

这些内容了解后,我们来看为什么 MongoDB 索引选择B-树,而 Mysql (InooDB 引擎)索引选择B+树。

Mysql 大家应该比较熟悉,传统的关系型数据库,下面介绍下 MongoDB。

来看下 wiki 百科上 MongoDB 的定义:

MongoDB (from humongous) is a cross-platform document-oriented database. Classified as a NoSQL database, MongoDB eschews the traditional table-based relational database structure in favor of JSON-like documents with dynamic schemas (MongoDB calls the format BSON)

这段话的大致意思是 MongoDB 是文档型的数据库,是一种 nosql,它使用类 Json 格式保存数据。

文档型数据库和我们常见的关系型数据库不同,一般使用 XML 或 Json 格式来保存数据,归属于聚合型数据库。

键值数据库也属于聚合型数据库,熟悉 Redis 的同学应该很好理解。

举个例子:

加入我们要建立一个电子商务网站,类似淘宝这种将商品销售给用户,那么必须存储用户信息、商品目录、订单、收货地址、账单地址、付款方式等。

看下传统的关系型数据库是如何存储的:
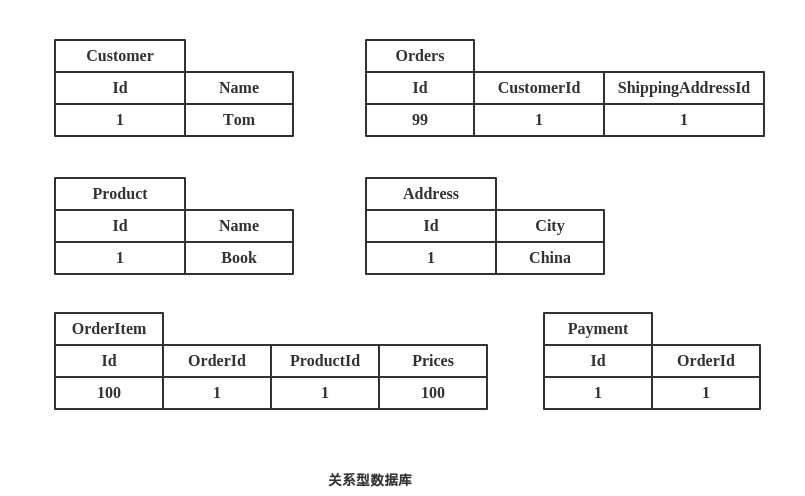
关系型数据库

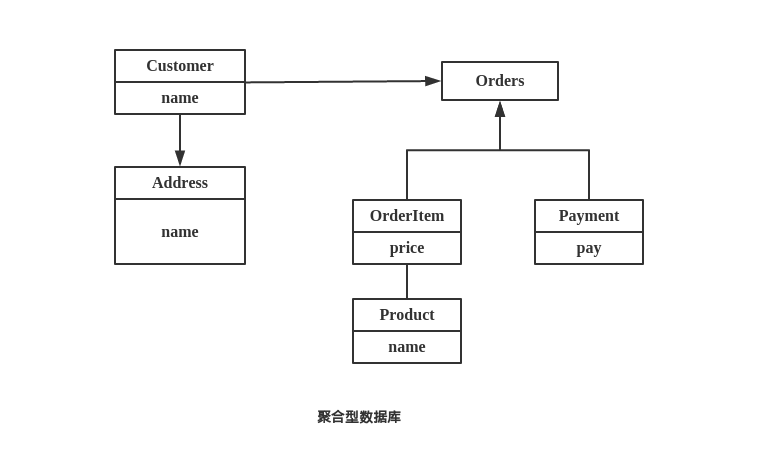
聚合型数据库存储模型:

聚合型数据库

用类似 Json 的格式表示如下:

//Customer
{
        "id":1,
        "name":Tom,
        "billingAddress":[{"city":"China"}]
}

//Orders
{
        "id":99,
        "orderItem":[
                "productId"27,
                "price":100,
                "productName":book
         ],
         "shippingAddress":[{"city":"china"}],
         "orderPayment":[
            ...
        ]   
}
 
  • 1
  • 2
  • 3
  • 4
  • 5
  • 6
  • 7
  • 8
  • 9
  • 10
  • 11
  • 12
  • 13
  • 14
  • 15
  • 16
  • 17
  • 18
  • 19
  • 20
  • 1
  • 2
  • 3
  • 4
  • 5
  • 6
  • 7
  • 8
  • 9
  • 10
  • 11
  • 12
  • 13
  • 14
  • 15
  • 16
  • 17
  • 18
  • 19
  • 20

相对于 Mysql 关系型数据库,MongoDB 这类 nosql 适用于数据模型简单,性能要求高的场合


为什么 MongoDB 使用B-树

MongoDB 是一种 nosql,也存储在磁盘上,被设计用在 数据模型简单,性能要求高的场合。性能要求高,看看B/B+树的区别第一点:

B+树内节点不存储数据,所有 data 存储在叶节点导致查询时间复杂度固定为 log n。而B-树查询时间复杂度不固定,与 key 在树中的位置有关,最好为O(1)

我们说过,尽可能少的磁盘 IO 是提高性能的有效手段。MongoDB 是聚合型数据库,而 B-树恰好 key 和 data 域聚合在一起。


为什么 Mysql 使用B+树

Mysql 是一种关系型数据库,区间访问是常见的一种情况,而 B-树并不支持区间访问(可参见上图),而B+树由于数据全部存储在叶子节点,并且通过指针串在一起,这样就很容易的进行区间遍历甚至全部遍历。见B/B+树的区别第二点:

B+树叶节点两两相连可大大增加区间访问性,可使用在范围查询等,而B-树每个节点 key 和 data 在一起,则无法区间查找。

其次B+树的查询效率更加稳定,数据全部存储在叶子节点,查询时间复杂度固定为 O(log n)。

最后第三点:

B+树更适合外部存储。由于内节点无 data 域,每个节点能索引的范围更大更精确

B-树和 B+树的区别 特性B-树B+树数据存储数据存储在内部节点和叶子节点数据只存储在叶子节点叶子节点链接不链接叶子节点按链表顺序链接查询效率查询时可能需要遍历多个节点查询效率较高,叶子节点按顺序存储范围查询不如B+树高效高效,通过叶子节点链表实现插入与删除操作较为复杂,可能涉及多个节点插入和删除操作较简单,只影响叶子节点内存使用节点存储数据,内存占用较大内部节点不存储数据,内存利用率更高。 阅读详情

相关推荐

B, B-, B+树的定义,特性,联系与区别(红黑树)

B树的不同定义,有时B树即是B-树 为什么会有B树: 因为二叉树的查找平均时间是logN,是与二叉树的深度有关,所以为了减少二叉树的深度,增加查找速度,势必要增加树的叉树。如果该树是M叉的,M&gt;2的话,logm(N)势必要小于log2(N),所以当数据量非常大的时候,B树的平均查找时间要少于二叉树。 红黑树:带有平衡性的二叉搜索树增强版 红黑树是每个节点都带有颜色属性的二叉查找树,颜色...

l1394049664的博客 7522

从 MongoDB 及 Mysql 谈B/B+树

前两天有位朋友邀请我回答个问题,为什么 MongoDB (索引)使用B-树而 Mysql 使用 B+树?我觉得这个问题非常好,从实际应用的角度来学习数据结构,没有比这更好的方法了。因为像 Mysql 和 MongoDB 这种经久考验的大型软件在设计上都是精益求精的,它们为什么选择这些数据结构?:) 本文从实际应用的角度来介绍以及分析B-树和B+树。 B-树由来 定义:B-树是一类树

IT小小鸟~~ 1万+

为什么MongoDB索引用B树,而Mysql用B+树?

引言 如果面试官问的是,为什么Mysql中Innodb的索引结构采取B+树?这个问题时,给自己留一条后路,不要把B树喷的一文不值。因为网上有些答案是说,B树不适合做文件存储系统的索引结构。如果按照那种答法,自己就给自己挖了一个坑,很难收场。因此,就有了这篇文章的诞生~ 正文 这里的Mysql指的是Innodb的存储引擎下的索引结构,其他存储引擎我们暂时不讨论。 B树和B+树 开头,我们先...

2117

B树与B+树

一、B树(B-树) 特点: (1)多路,非二叉树 (2)每个节点既保存索引,又保存数据 (3)搜索时相当于二分查找 二、B+树 特点: (1)多路非二叉 (2)只有叶子节点保存数据 (3)搜索时相当于二分查找 (4)增加了相邻接点的指向指针。 三、B树与B+树的区别 1,关键字的数量不同;B+树中分支结点有m个关键字,其叶子结点也有m个,其关键字只是起到了一个索引的作用,但是B树虽然也有m个子结点,但是其只拥有m-1个关键字。 2,存储的位置不同;B+树中的数据都存储在叶子

光何 869

Linux系统下SAPGUI安装包选择与避坑指南

本文详细介绍了在Linux系统下选择和安装SAPGUI安装包的策略与避坑指南。重点解析了不同版本安装包的关键区别,特别是Linux版必须包含linux-lib.jar和linux64-lib.jar文件,避免误用Mac或Windows版导致的兼容性问题。文章还提供了针对Ubuntu、RHEL等不同Linux发行版的安装实战指南,以及常见报错的解决方案,帮助用户顺利完成SAPGUI的安装与配置。

weixin_28366353的博客 659

电机控制实战:SVPWM五段式与七段式算法在STM32上的实现对比

本文深入对比了SVPWM五段式与七段式算法在STM32上的实现效果,详细分析了两种算法在占空比控制、开关损耗和波形质量等方面的差异。通过实测数据,为工程师提供了针对不同应用场景的选型建议,包括电池供电设备和高精度伺服控制系统的优化方案。

h6i7j8的博客 578

从MongoDB及mysql 谈B/B+树

一 B树的由来 B树指的是一类树,包括B-树,B+树,B*树等,是一种自平衡的搜索树,它类似普通的平衡二叉树,不同的一点是B树允许每个节点有更多的子节点。B树是专门为外部存储器设计的,如磁盘,它对于读取和写入大块数据有良好的性能,所以一般用在文件系统及数据库中。 1. 为什么不用二叉平衡树 传统用来搜索的平衡二叉树有很多,AVL树,红黑树等。这些树在一般情况下的查询性能非常好,但当数...

weixin_30666401的博客 115

EC20模块实战:5步搞定MQTT连接阿里云IoT(附常见错误排查)

本文详细介绍了使用EC20 4G模块通过AT指令连接阿里云IoT平台的完整实战流程。文章以智能农业项目为背景,从硬件接线、网络注册、PDP激活,到MQTT连接配置、一型一密动态注册及数据收发,提供了清晰的5步操作指南,并重点附上了常见错误排查方法,帮助开发者快速实现稳定可靠的物联网设备上云。

weixin_29209801的博客 190

从 MongoDB 及 Mysql 谈B/B+树(转载)

本文从实际应用的角度来介绍以及分析B-树和B+树。介绍为什么mongodb使用B-树建立索引,而mysql使用B+树建立索引

cjf_wei的博客 429

哈密顿-雅可比不等式:连接最优控制与优化算法的自然物理原理

在控制理论与优化算法之间,存在一个深刻而实用的桥梁。最优控制理论旨在通过设计控制输入,使动态系统在时间维度上达到性能最优,其核心数学工具如庞特里亚金极大值原理和哈密顿-雅可比-贝尔曼方程,为解决连续时间系统的优化问题提供了优雅框架。然而,这些方法在高维非凸问题中面临求解难题。哈密顿-雅可比不等式作为一种松弛方法,通过构造李雅普诺夫函数并验证一个不等式条件,转而寻求性能有保障且易于实现的次优解,其本质是保证系统能量衰减和性能上界。这一原理与耗散性理论紧密相连,体现了自然物理系统(如阻尼振动)中能量耗散的普遍规

weixin_30582943的博客 309

Docker(八):Docker Compose(容器编排) 管理多容器应用—实战案例演示

🟢 Docker(八):Docker Compose(容器编排) 管理多容器应用—实战案例演示

✨ 欢迎来到【Seal ^_^ 的CSDN博客】!✨ 6万+

为什么Mongodb索引用B树,而Mysql用B+树?

引言好久没写文章了,今天回来重操旧业。今天讲的这个主题,是《面试官:谈谈你对mysql索引的认识》,里头提到的一个坑。也就是说,如果面试官问的是,为什么Mysql中Innodb的索引结构...

孤独烟 3988

物联网设备数据是如何流转的:基于EMQX与TDengine的前后端分离项目实践

背景 在我写了TDengine极简实战:从采集到入库,从前端到后端,体验物联网设备数据流转这篇文章后,不少读者朋友评论、私信说可不可以提供代码参考学习下,那必须是可以的。那篇文章主要介绍了数据采集、数据传输、数据转发、数据解析、数据存储、数据查询、数据呈现、数据导出、消息推送的物联网设备数据流程过程,作为体验 TDengine 的极简实战项目,没引入过多的业务设计(复杂功能)以及异步解耦设计(消息中间件)。 在整理代码的过程中,我发现虽然整个项目并不复杂,但是涉及到的技术点较多,有必要对关键的组件进行说明

Heartsuit的博客 9399

MongoDb(七)为什么MongoDB使用B树

   我们在这一系列前面的文章曾经分析过 为什么 MySQL 使用 B+ 树,有读者在文章下面留言,希望能出一个为什么 MongoDB 使用 B 树的对比文章,这是一个比较好的问题,MySQL 和 MongoDB 两种不同类型的数据库使用了相似却不同的数据结构,为什么 MySQL 选择使用 B+ 树而 MongoDB 使用 B 树呢? (一)概述  &nbs...

weixin_41987908的博客 4110

无线通信技术及其在机器人中的应用

本文系统阐述了无线通信技术在机器人领域的应用框架与技术选型。首先构建了无线通信的三层理论架构:物理层解决信号传输问题,链路层处理接入控制,网络层实现组网管理。随后详细分析了主流无线技术的特性与适用场景:BLE适用于低功耗传感器节点,Wi-Fi适合高带宽视频传输,5G专网满足工业AGV的广域覆盖需求,星闪技术凭借20μs超低时延和4096台并发连接能力,为高端机器人应用提供突破性解决方案。通过鄂尔多斯隆基5G专网等典型案例,验证了5G在工业AGV规模化部署中的优势,并展望了通感算智融合、星闪+5G协同等未来发

weiyvyy的博客 1107

245. 项目195:简易文字冒险游戏——《跟老吕学Python·新手》

如果您在学习本专栏教程时遇到任何问题,或有任何技术交流的意愿,欢迎在文章评论区留言,或通过CSDN私信与老吕取得联系。老吕将及时回复您的留言,并与您共同探讨,以期为大家提供更为精准和有效的帮助。老吕珍视每一位读者的反馈和支持,期待与您共同学习、共同进步,共同创造美好的未来!我们的目标是不仅教会您Python语言,更是培养您解决问题的思维方式。请随意翻阅,按照自己的节奏学习,让这本专栏成为您编程旅程中的可靠伙伴。开发一个简易的文字冒险游戏,通过文本描述场景和事件,让玩家通过选择不同的选项来推动故事发展。

Python老吕的博客 702

为什么 MongoDB 索引选择B-树,而 Mysql 索引选择B+树(精干总结)

本文献给准备面试或者是还在面试的你。常见面试题,送分题目,不拿白不拿。 本文收录在个人博客《愚公要移山》中,地址 www.javachat.cc 这篇是修改版,针对知乎上很多人提出的问题,进行了一次修复 一、B树和B+树的区别 很明显,我们想向弄清楚原因就要知道B树和B+树的区别。为了不长篇大论。我们直接给出他们的形式总结他们的特点。 1、B树 B树是一种自平衡的搜索树,形式很简单: 这就是一颗B-树。针对我们这个问题的最核心的特点如下: (1)多路,非二叉树 (2)每个节点既保存索引,又保存数据

冯冬冬的博客 1万+

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

为什么 MongoDB 使用 B 树?

点击上方“五分钟学算法”,选择“星标”公众号重磅干货,第一时间送达我们在这一系列前面的文章曾经分析过 为什么 MySQL 使用 B+ 树,有读者在文章下面留言,希望能出一个为什么 Mon...

程序员吴师兄的博客 1721

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

为什么有关MongoDB采用B树索引,以及Mysql B+树做索引?

MySQL 中的许多概念在 MongoDB 中具有相近的类比。下表是一些常见概念: MySQL MongoDB 库 Database 库 Database 表 Table 集合 Collection 行 Row 文档 Document 列 Column 字段 Field joins 嵌入文档或者链接 1、B-树 ...

ProMonkey_chen的博客 1111

蓝牙模块HM-10手册

蓝牙模块HM-10手册,该手册对蓝牙模块HM-10进行了详细的介绍和使用方法以及一些AT指令。

oracle是b树 MySQL是B 树_Mongodb索引用B树,而Mysql用B+树

引言好久没写文章了,今天回来重操旧业。毕竟现在对后端开发的要求越来越高,大家要做好各种准备。因此,大家有可能遇到如下问题为什么Mysql中Innodb的索引结构采取B+树?回答这个问题时,给自己留一条后路,不要把B树喷的一文不值。因为网上有些答案是说,B树不适合做文件存储系统的索引结构。如果按照那种答法,自己就给自己挖了一个坑,很难收场。因此,就有了这篇文章的诞生~文末附面试指南!正文这里的Mys...

weixin_30479433的博客 776

mysql mongodb b树_【转载】为什么Mongodb索引用B树,而Mysql用B+树?

文章转载自孤独烟的微信公众号,可关注他的公众号阅读原文正文这里的Mysql指的是Innodb的存储引擎下的索引结构,其他存储引擎我们暂时不讨论。B树和B+树开头,我们先回忆一下,B树和B+树的结构以及特点,如下所示:B树注意一下B树的两个明显特点树内的每个节点都存储数据叶子节点之间无指针相邻B+树注意一下B+树的两个明显特点数据只出现在叶子节点所有叶子节点增加了一个链指针针对上面的B+树和B树的特...

weixin_28766939的博客 970

为什么 MongoDB 索引选择B-树,而 Mysql 选择B+树(精干总结)

这个问题是我在看视频的时候老师提到的,虽然之前知道他们各自的索引结构但是还没有研究过原因。在网上一搜答案特别多。但是都特别的啰嗦。于是总结了这篇文章。 一、B-树和B+树的区别 很明显,我们要向弄清楚原因就要知道B-树和B+树的区别。为了不长篇大论。我们直接给出他们的形式总结他们的特点。 1、B-树 B-树是一种自平衡的搜索树,形式很简单: 这就是一颗B-树。针对我们这个问题的最核心的特点如下:...

冯冬冬的博客 1万+

为什么MySQL 使用 B+树、MongoDB 使用 B 树?

MySQL使用B+树以支持高效的范围查询和全表扫描,其叶子节点有序链表结构适合关系型数据库的整行数据访问。而MongoDB采用B树,因其节点可存储文档部分数据,更匹配文档型数据库的灵活查询特性,能快速加载局部数据,减少IO次数。两者数据结构选择差异源于不同的数据模型和查询需求:MySQL强调整体数据扫描,MongoDB侧重随机读取和部分数据获取。

weixin_42449750的博客 869
上一篇: 数据库常见索引解析(B树,B-树,B+树,B*树,位图索引,Hash索引)
下一篇: 详解LSM Tree
亮亮-AC米兰
博客等级 码龄17年 233粉丝 46原创
评论 3
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值