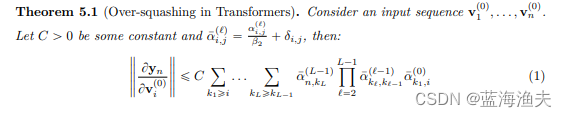论文阅读:Transformer的表示坍塌和过度压缩问题,Transformers need glasses!Information over-squashing in language tasks

从注意力到坍缩:Transformer模型的深层秘密 Transformer模型的成功离不开注意力机制的创新,但注意力坍缩现象提醒我们,模型的规模化并非万能的解决方案。通过深入理解Transformer的数学本质,我们不仅可以更好地优化现有模型,还能为未来的模型设计提供新的思路。在未来,随着研究的深入,我们有望解决注意力坍缩问题,使Transformer模型在生成任务中表现得更加多样化和稳定。毕竟,只有真正理解了模型的内在机制,我们才能让人工智能更好地服务于人类。 阅读详情

本文是6月4号新鲜出炉的arxiv文章,探索了decoder-only Transformer的表示坍塌和过度压缩问题,感觉其思考很有意思。

论文:《Transformers need glasses!Information over-squashing in language tasks》

1,作者研究了decoder-only Transformers中信息的传播方式,

尤其是最后一层中最后一个token的表示,发现了表示坍塌的现象。

所谓表示坍塌指的是在Transformer模型中,不同的输入序列可能导致最终标记的表示非常接近,甚至在某些情况下无法区分。这种现象在长序列中尤为明显。这种效应在现代LLMs中经常使用的低精度浮点格式下会加剧。

而表示坍塌也是目前众多大模型在涉及计数或复制序列元素等简单任务中出现错误的原因。

2,首先回顾现有工作在“Transformer表示能力”方面的研究。

1)有研究指出Transformer不是图灵完备的,但可以在某些假设下通过修改使其变得图灵完备【1】。还有工作表明,使用“硬注意力”的Transformer通过将softmax替换为一热向量并使用无限精度,可以使Transformer变得图灵完备【2】。这与作者的研究形成了对比,他们的工作关注于使用软注意力和有限精度的更标准的(更一般的)Transformer设置。

2)Peng等人【3】表明,具有有限精度的Transformer块在表示组合函数和解决需要它的简单问题方面的能力从根本上受到限制。

3)注意力机制的衰减问题:在Transformer模型中,自注意力机制可能达到一种限制其学习能力的病理状态。这种衰减可能导致训练不稳定,甚至在训练后期也会显著降低模型的性能。此外,特定的标记可能会过分集中注意力,使得Transformer无法学习处理简单的语言任务。

4)过度压缩现象:是在图神经网络(GNNs)和基于注意力的Transformer模型中观察到的一个问题。它描述了在具有“瓶颈”的图形上传播信息时,信息可能会被“压缩”或丢失。这种信息的丢失通过节点间的通勤时间(即随机游走从一个节点到另一个节点再返回的预期步数)来衡量。对于高通勤时间的节点,其信息传播将受到更大的压缩。
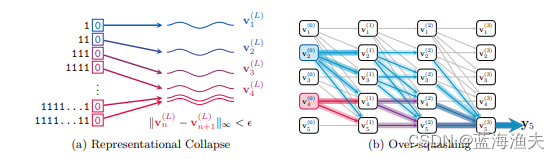
表现坍塌和过渡压缩的图示

3,失败案例

如之前段落所说,本文观察到的基于Transformer的大模型在计数和复制这样的简单任务中也会出错。以大模型Gimini为例

1)提示Gemini复制序列“1...10”的最后一个元素或序列“01...1”的第一个元素。两者的答案都是0,但我们逐渐增加了1的数量。我们观察到,当要求返回第一个元素而不是最后一个元素时,任务似乎要容易得多。令人惊讶的是,在序列长度仅为300个元素时,Gemini在尝试复制最后一个元素时已经开始错误地输出“1”。

2)考虑了四种不同的任务:(i)累加1 ¨ ¨ ¨ 1,(ii)计算由“1”组成的序列中“1”的数量,(iii)计算由“1”和“0”组成的序列中“1”的数量,其中“1”以70%的概率被采样,以及(iv)计算句子中特定单词出现的次数。

实验结果表明,随着序列长度的增加,性能迅速下降。例如,在任务(i)中,一旦序列大小达到或超过100,大型语言模型(LLM)很可能预测“100”的值。这一观察为这样的论点提供了激励性的证据:Transformer模型可能并不是真正地进行机械计数,而是执行一种粗略的子化(subitizing)类型。这解释了为什么像100这样的“常见”数字更有可能被LLM输出。

其他错误实验结果可以自己查看原论文,不在这里详述了。

4,表示坍塌

1)表示塌陷现象:作者指出,在Transformer模型中,尤其是当使用有限精度浮点数时,不同的输入序列在模型的最终层的最后一个标记上可能产生非常接近的表示。这意味着模型难以区分这些序列,导致在某些任务上出现错误。

2)理论分析:通过理论分析,作者证明了随着序列长度的增加,某些特定序列的表示会趋于一致,这种现象称为表示塌陷。这在数学上通过分析softmax分布的L1距离(或总变差)来证明。

3)低精度浮点数的影响:论文强调了现代大型语言模型(LLMs)常用的低精度浮点数格式(如bfloat16)可能加剧表示塌陷的问题,因为这些格式的表示能力有限。

4)解决方案:作者提出的一种解决方案是在序列中引入额外的标记或分隔符,以保持不同序列的表示之间的距离。

5,过渡压缩

1)过度压缩现象:作者指出,由于decoder-only Transformer的计算图结构,特别是其单向因果掩码,模型可能会在处理输入序列时丢失对特定标记的敏感性。

2)理论分析:论文量化了输入序列中每个标记对最终层最后一个标记表示的影响。分析表明,序列中较早的标记由于通过更多的路径影响最终表示,因此其信息更容易被“压缩”。

量化的方式是:(I)定义敏感度度量(II)作者计算了最终层最后一个标记 yn​ 相对于 v0i​ 的偏导数 。这个偏导数衡量了输入标记 v0i​ 对输出 yn​ 的影响程度。(III)作者最终导出了一个数学表达式来量化这种敏感度:

这里只简单介绍量化分析过程,有兴趣的自己去原文理解这个公式。

3)信息传播:作者研究了信息如何在Transformer模型中传播,特别是如何从输入序列的早期标记传播到最终用于预测下一个标记的表示。他们发现,由于注意力机制的拓扑结构,早期标记的信息更容易在模型中保留。

4)U形效应:论文解释了为什么大型语言模型(LLMs)在检索任务中,当所需检索的信息位于序列的开始或结束时,表现得更好。这种现象被称为U形效应,与过度压缩的理论分析相一致。

5)由于softmax层的归一化特性,模型难以在计数时考虑到序列的长度,这导致模型在执行计数任务时面临困难。

5)解决方案:可惜的是,作者没有提出针对性的解决方案,作者认为大概率要从改进模型结构入手

本文的价值在于对decoder only Transformer存在的固有缺陷的分析,虽然本文没有提出太多有价值的解决方案,但是我们在这些分析的基础之上可以进一步改进Transformer模型。

【1】Mostafa Dehghani, Stephan Gouws, Oriol Vinyals, Jakob Uszkoreit, and Łukasz Kaiser. Universal transformers, 2019.

【2】Jorge Pérez, Pablo Barceló, and Javier Marinkovic. Attention is turing-complete. Journal of Machine Learning Research, 22(75):1–35, 2021.

【3】Binghui Peng, Srini Narayanan, and Christos Papadimitriou. On limitations of the transformer architecture, 2024.


UCOS-III 系统移植 UCOSIII系统移植到GD32F303详细过程 工程代码:https://github.com/jslaobing/techIot_ucosiii_porting 阅读详情

相关推荐

从零实现高精度手势检测:OpenCV+MediaPipe模型移植实战(2)(附c++完整代码)

上篇已经介绍了手掌检测的方法。本章将在手掌检测的基础上,完成手指关节的检测。

qq_37160641的博客 2659

深入Vector Quantization:揭秘表征坍塌原因&解法

导读新加坡国立大学在论文《Representation Collapsing Problems in Vector Quantization》系统性地探讨了生成模型中矢量量化 (VQ) 中的表征坍塌问题,确定了两种类型坍塌:1)Token 坍塌:过多tokens 集中于少数Embedding;2)Embedding 坍塌:Embedding 空间坍塌到有限的表征集,并通过实验揭示了随机初始化和有限的编码器容量是导致这些坍塌的原因,提出了相应解决方案。核心内容总结。

Java癫疯的博客 1564

Procedural modeling

What is procedural modeling? One content generation option is modeling buildings, plants, clouds, cities, and worlds using an underlying system of rules. 1 Procedural Modeling: Grammars A rule-based generative system loosely organized as: ...

qq_24505417的博客 707

论文精读(1)

论文大致介绍了表征坍缩(representation collapse),即模型输出一个持续的输入不变的特征表示。所采用的方法是不在高维重构信号,而是预测嵌入(embedding)层;并对时间序列的统计值的泛函做预测。

ldy_lzy的博客 2176

基于GIS的生态安全网络格局构建(附练习数据下载)

基于GIS的生态安全网络格局构建(附练习数据下载)

qq_43173805的博客 3112

SQL Server 2025在Windows 11上的安装避坑指南

SQL Server 是微软主流关系型数据库管理系统,其安装与Windows操作系统深度耦合;Windows 11作为新一代桌面平台,强化了基于虚拟化的安全(HVCI)、驱动签名强制策略(WDAC)及内核隔离机制,导致传统数据库部署流程失效。理解二者底层交互原理,是解决服务启动失败、配置管理器无法打开、远程连接被拒等高频问题的技术前提。本文聚焦SQL Server 2025与Windows 11的兼容性挑战,覆盖系统预配置、安装节点诊断、防火墙与服务权限调优等工程实践环节,适用于高校教学、电赛备赛、中小企业

weixin_28741413的博客 309

神经崩塌Neural Collapse

关于神经网络可以叫上名字的现象不多,Neural Collapse可以算得上一个,Double/Triple descent等现象也算得上,这里基于文献1讨论一下这个现象及其可能的影响因素,毕竟提出来才两年,可能理论上并不是很清楚。...

weixin_43991828的博客 7405

《机器学习》周志华_自学记录

第一章绪论## 1.1引言机器学习所研究的主要内容,是关于在计算机上从数据中产生"模型"(model)的算法,即"学习算法"(learning algorithm).在面对新的情况时(例如看到一个没剖开的西瓜),模型会给我们提供相应的判断(例如好瓜).如果说计算机科学是研究关于"算法"的学问,那么类似的,可以说机器学习是研究关于"学习算法"的学问.## 1.2基本术语:用于预测离散值,例如将样本分为“好瓜”或“坏瓜”。:用于预测连续值,例如西瓜的成熟度(如0.95、0.37)。

2201_75296678的博客 2520

Transformer,浅析归纳偏置对模型缩放的影响

还是搬运工啊 小白求学之路谷歌的研究者试图了解归纳偏置(体系架构)对语言模型标度律的影响。他们预训练和微调了 100 多种不同体系架构和大小的模型,并提出了在缩放这十种不同体系架构方面的见解和挑战。Transformer 模型的缩放近年来引发了众多学者的研究兴趣。然而,对于模型架构所施加的不同归纳偏置的缩放性质,人们了解得并不多。通常假设,在特定标度(计算、大小等)的改进可以迁移到不同的规模和计算区域。不过,理解架构和标度律之间的相互作用至关重要,设计在不同标度上表现良好的模型具有重要的研究意义。

whaosoft143ai的博客 1049

南京邮电大学电工电子基础B实验六(组合逻辑电路)

南京邮电大学电工电子基础B实验五(组合逻辑电路);电工电子;南京邮电大学;计算机学院;实验报告;电路图;

亦是远方的小地方 1万+

计算机网络实验报告实验七可靠传输TCP协议分析

计算机网络实验报告实验七可靠传输TCP协议分析

m0_56638814的博客 956

[CNN-grad]1. 梯度爆炸实操|梯度消失|模型坍塌初识

1. 神经网络梯度爆炸实操 在深度学习中,网络常见的问题有两种,一个是梯度消失(也称梯度弥散),另一个是梯度爆炸,其实还有一个就是模型坍塌(这个模型坍塌在网络设计的较为合理的前提下,会在生成模型GAN系列中出现)。 一、梯度消失 在损失下降的时候,我们希望损失下降到0,但是,神经网络实际上损失下降到0是有问题的, 其一:就是损失到0是一种过拟合的现象; 其二:在训练时,如果损失到0,然后突然出现NAN,那么就意味着,梯度不能更新了,有一种很大的可能就是梯度消失。 解决梯度消失,我们通常会加入BN,加

呼啦圈 2693

工业激光器核心参数详解与选型实战:从理论到产线落地(五)

本文深入解析了脉冲激光加工的三大核心参数——脉宽、重复频率和脉冲能量的协同作用机制。通过公式推导和产线案例,揭示了参数设置对加工良率的关键影响:1. 脉宽决定热影响区大小,缩短脉宽可显著提升加工精度;2. 重复频率影响加工速度和热积累效应,需平衡效率与质量;3. 脉冲能量决定材料去除量,过大易导致加工缺陷。文中以ABS塑料打标、模具清洗和微孔钻孔为例,展示了参数优化如何将良率从65%提升至99%,并提供了不同应用场景的参数选型表和调试技巧,强调峰值功率比平均功率更具决定性作用。

weixin_44520581的博客 2417

【论文阅读】未配准多对比度 MRI:让网络先对齐,再共享解剖信息

本文提出一种联合配准与重建的深度学习框架,用于欠采样多对比度MRI图像重建。通过引入可微空间变换模块(ST),自动校正参考图像(如T1w)与目标图像(如T2w)间的非对齐问题,实现解剖结构信息的可靠共享。模型在BraTS和MRBrainS数据集上验证,显著优于不使用参考或直接拼接未配准参考的方法,在8×至16×加速下提升PSNR达2.36 dB,证明了配准对跨对比度信息融合的关键作用。

银尘博客 365

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

【论文阅读】Agent记忆机制(109):MemComposer——用强化学习学会选哪些记忆、选多少以及怎样排序

MemComposer提出将记忆检索重构为查询相关的序列级记忆编排问题,摒弃传统按相似度排序取Top-k的做法。它通过经验策略优化(ExPO)训练一个可学习的“记忆编排层”,联合决策记忆内容、数量与顺序,基于完整任务执行结果(如成功与否)进行端到端优化。实验表明,记忆选择并非越相似越好,数量也非越多越优,顺序更显著影响性能。该方法在不改变记忆库与执行器的前提下,显著提升Agent对历史经验的利用效率,为记忆使用提供了新范式。

weixin_45642847的博客 256

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

【论文阅读】Agent记忆机制(111):FEB-30——别再只用问答准确率评估 Agent Memory

应该保存原始对话、原子事实,还是高层摘要;应该使用向量库、图结构,还是离散语义索引;新信息到来时,应该创建、强化、更新,还是淘汰旧记忆;面对长时间跨度和多会话历史,如何控制延迟、token 与存储成本。我们怎么知道一个 Agent 的记忆系统真的记对了?目前最常见的答案是做问答。把一段长历史交给记忆系统,之后向 Agent 提问;回答正确,就认为记忆有效,回答错误,就认为记忆失败。最终回答记忆状态检索结果生成模型行为。

weixin_45642847的博客 218

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

rppg相关论文阅读笔记10.22

RhythmGaussian首次将可泛化高斯模型引入rPPG,通过4D高斯表征显式解耦几何与色度变化,提出“4D虚拟相机”实现无真实参数下的高效建模,并设计显式运动与色度建模(EMM/ECM)在无监督下分离生理信号、运动噪声与镜面反射,显著提升复杂场景下的远程生理测量精度。

m0_74900369的博客 376

office-academic-skill:论文阅读报告和组会PPT怎么生成

•两份文件都能在 Word 和 PowerPoint 里正常打开、能直接编辑;•PPT 每页只有一个核心观点,标题是判断,不是话题标签;•每一条定量结论都能在 PDF 里指到具体位置——第几页、哪个图或哪张表;•所有来源标签都指向真实存在的条目;•局限性那一节里,作者声明的和推断出来的分开写;•单位、坐标轴、图例跟原文一致。最省事的做法是先做阅读报告:把 PDF 和上面那段提示词发过去,删掉 PPT 那两行,拿到 docx 之后先按核对项的六条过一遍。

AcademicIdeas的博客 263

意识障碍--论文阅读5

传统 DBS 主要依据解剖靶点及固定刺激参数进行治疗,未充分考虑患者个体症状差异和动态状态变化,可能是治疗效果不稳定的原因之一。本文研究不同刺激靶点的症状特异性,以及初始状态对刺激响应的影响。

qq_42829312的博客 151

【论文阅读】Agent记忆机制(110):MemCode——用离散语义码突破长期 Agent 记忆的向量检索边界

摘要(148字): MemCode 提出一种双路径记忆访问机制,将长期记忆写入自包含的原子单元(AMU),并为每条记忆生成离散语义指纹。通过结合连续向量近邻与离散码本共现关系,突破传统向量检索在语义关联上的局限。该方法在不依赖显式图结构的前提下,实现跨事件、跨时间的事实连接,显著提升多跳推理性能。异步演化机制保障系统可扩展性,核心创新在于将写入、索引与检索对齐,推动记忆系统从“存得久”迈向“找得准”。

weixin_45642847的博客 366

【多论文阅读笔记】下一阶段,Agent记忆关注什么能力?

本文聚焦于下一代Agent记忆系统的核心目标——维持运行态“心流”,即实现信息的无损、无缝调用。基于此,作者评析了近期三项代表性测评基准:LoCoMo-Plus(测认知记忆)、TriggerBench(测前瞻记忆)与EvalMem。其中,LoCoMo-Plus通过隐含状态与跨场景触发,检验模型对用户价值观、目标等深层记忆的运用能力;TriggerBench则模拟真实提醒场景,测试模型在恰当时机激活记忆的能力。二者均超越传统事实记忆,但前者忽略幻觉与认知错配风险,后者尚待扩展。整体而言,这些工作推动记忆测评向

xian_ren008的博客 191

【论文阅读】Agent 记忆机制(113):Agentic Memory Management——从“检索相关信息”走向“管理 Agent 内部记忆”

本文提出将代理记忆(Agent Memory)重新定义为面向智能体的内部信息检索问题,命名为Agentic Memory Management (AMM)。作者 Qingyao Ai 指出,传统信息检索以“服务人”为核心,而 AMM 转向“服务代理”,并强调记忆系统需从对象表示、检索策略到反馈利用形成闭环。论文创新性地提出“常量—函数—算子”三类记忆对象,分别对应事实、技能与偏好,并引入“可观测性反转”概念,构建四层评价体系(状态质量、利用质量、任务结果、成本),推动记忆研究从工程实现迈向系统化理论框架。

weixin_45642847的博客 91

【论文阅读】Agent记忆机制(108):系统级剖析长期记忆的构建、检索与部署成本

本文首次将Agent Memory视为具有构建、检索、生成与维护成本的状态化系统工作负载,而非仅以准确率衡量的算法模块。通过对10种代表性系统进行阶段级性能剖析,揭示不同记忆范式在写路径与读路径间对延迟、能耗、一致性与扩展性的权衡。研究提出统一框架,涵盖七阶段执行流程,并提炼出10条部署建议,强调“系统账单”对实际落地的关键意义。

weixin_45642847的博客 321

【论文阅读】MoDL:把共轭梯度与参数共享引入模型驱动重建

本文提出MoDL,一种模型驱动的深度学习框架,用于解决多线圈MRI逆问题。通过交替执行共享参数的CNN去噪与共轭梯度求解的数据一致性更新,实现端到端训练。该方法在保持物理模型准确性的基础上,利用CNN学习图像先验,显著提升重建质量,并有效控制参数量,适用于高加速成像。

银尘博客 397

【论文阅读】Agent记忆机制(112):MemFit——保留对话原文,用多路检索降低长期记忆成本

MemFit 提出一种高效长期代理记忆框架,核心创新在于将记忆写入从“由LLM决定保留什么”转变为“无损追加原始对话,摘要仅作可回溯索引”,并将复杂检索任务推迟至查询阶段。通过 append-only episode store 保留完整对话,结合混合检索(BM25、dense retrieval、伪相关反馈、cross-encoder)实现精准召回,最终仅需一次LLM调用生成答案。该设计显著降低写入成本与不可逆风险,兼顾检索精度与系统可扩展性。

weixin_45642847的博客 195

【论文阅读】Deep Image Prior:随机初始化的网络为什么也能重建图像?

摘要(≤150字): 《Deep Image Prior》提出无需预训练的单图像恢复方法,通过优化随机初始化的生成网络实现去噪、超分辨率与修复。网络结构本身蕴含归纳偏置,作为隐式先验,引导恢复结果符合自然图像统计特性。仅依赖当前图像与数据项,结合提前停止机制,即可获得媲美传统方法的结果。该工作揭示了网络架构在图像重建中的核心作用,推动了对“先验来源”的深层思考。

银尘博客 993
上一篇: 论文阅读:Polyp-PVT: Polyp Segmentation with PyramidVision Transformers
下一篇: 论文阅读KAN: Kolmogorov–Arnold Networks
蓝海渔夫
博客等级 码龄14年 6133粉丝 52原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

蓝海渔夫

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值