


目录:
Spring AI 框架介绍
Spring AI 框架介绍 - Advisor
Spring AI 框架介绍 - 上下文记忆
SpringAI 框架介绍 - 工具调用
Spring AI 对话模型
Spring AI 图像模型
LLM 工具与 RAG 原理
AI Code Review 工具
Spring AI 项目的目标是简化集成人工智能功能的应用开发过程,避免不必要的复杂性。
该项目从一些知名的 Python 项目(如 LangChain 和 LlamaIndex)中获得灵感,但 Spring AI 并不是这些项目的直接移植版本。该项目的创立基于这样一种理念:下一波生成式 AI 应用将不仅仅属于 Python 开发者,而是会在多种编程语言中广泛普及。
概述
Spring AI 提供了一组抽象层,作为开发 AI 应用的基础。这些抽象具有多种实现方式,使得在只需极少代码改动的情况下即可轻松替换组件。
Spring AI 提供以下功能:
- 支持目前市面上大部分主流模型提供商,如 Anthropic、OpenAI、Microsoft、Amazon、Google、Ollama 等。
- 支持不同类型的模型,如对话、嵌入、文本转图像、音频转录、文本转语音等。
- 结构化输出,将 AI 模型的输出结果映射成 POJOs。
- 支持大部分嵌入模型,如 Apache Cassandra、Azure Cosmos DB、Azure Vector Search、Chroma、Elasticsearch、GemFire、MariaDB、Milvus、MongoDB Atlas、Neo4j、OpenSearch、Oracle、PostgreSQL/PGVector、Pinecone、Qdrant、Redis、SAP Hana、Typesense 和 Weaviate。
- 工具/函数调用,允许模型调用客户端工具和函数,以此来获取所需的实时信息并采取下一步行动。
- 可观测性,提供了 AI 相关的操作视图。
- 文本 ETL 采集框架。
- AI 模型评估,对模型的输出结果进行评估。
- ChatClient API、Advisors API。
- 支持对话记录和检索增强生成RAG。
术语介绍
提示词
提示词 Prompt 是基于语言的输入的基础,指导人工智能模型产生特定的输出。
制定高效的提示词既是一门艺术,也是一门科学。ChatGPT 设计出来是为了与人类对话的。这与使用SQL之类的东西来“问问题”有很大的不同。人们必须像与人交流一样来与 AI 模型交流。由于这种交互是如此的重要,现在已经出现了“提示词工程”这种术语,专门描述在提示词方面的研究。高效的提示词可以极大提高输出结果的准确性。
分享提示已经变成了公共实践,当前学术界正在积极地研究这个问题。很多提示词是反直觉的,比如最近的一篇研究论文显示,一个非常高效的提示词短语是:“深呼吸,循序渐进地来解决这个问题”。到目前为止,我们还不完全了解如何最有效地利用该技术的前几次迭代,例如ChatGPT 3.5,更不用说最新的版本了。
提示词模版
创建有效的提示词涉及建立请求上下文,并用特定于用户输入的值替换请求的部分内容。
下面是一个提示词模板示例:
给我讲一个关于 {content} 的笑话。
这是一个字符串模板,其中 {content} 是需要替换的内容,最终输入到大模型的是渲染后的结果。
发送给模型的提示词的数据格式有很大的变化。提示词最初是简单的字符串,现在已经发展到包括多个消息,不同的消息可能代表不同的角色输入。
嵌入
嵌入(Embedding)是一种将文本(如单词、短语、句子或文档)转换为数字向量表示的方法。这种向量化表示捕捉了文本的语义信息,使得模型能够以数学形式理解和操作自然语言。
嵌入的工作原理是将文本、图像和视频转换为称为向量的浮点数数组。嵌入后的向量通常是实数值(如 [0.1, -0.3, 0.7]),这些向量能够反映文本在语义空间中的相对位置。
嵌入的核心目的是捕捉文本的语义关系和上下文信息,从而支持各种 NLP任务,例如:
- 语义相似度:两个语义上相近的单词或句子,其嵌入向量在空间中的距离较小。
- 分类和聚类:嵌入向量可以作为特征,用于分类或聚类任务。
- 搜索和推荐:通过计算嵌入之间的距离或相似度,找到相关内容。
在 ChatGPT 中,嵌入用于以下方面:
- 语言理解:模型将用户输入转化为嵌入,理解语义信息以生成相关回答。
- 知识存储:嵌入帮助模型在回答时调用相关的上下文或知识点。
- 搜索增强:通过嵌入匹配用户输入和知识库中的相关内容,提高生成回答的准确性。
举个例子, 假设模型生成了以下嵌入:
- “猫”:[0.21, -0.19, 0.37, …]
- “狗”:[0.20, -0.18, 0.36, …]
- “桌子”:[0.05, 0.33, -0.15, …]
通过计算余弦相似度或欧几里得距离,可以发现"猫"和"狗"的向量更加相似,而与"桌子"差异较大。
作为探索 AI 的 Java 开发人员,没有必要理解这些向量表示背后复杂的数学理论或特定的实现。对它们在AI系统中的角色和功能的基本了解就足够了,特别是当您将 AI 功能集成到应用程序中时。
Tokens
Tokens 是 AI 模型工作的基石。在输入时,模型将单词转换为 tokens,然后在输出时又将 tokens 转换成单词。
在英语中,一个 token 大约相当于一个单词的 75%。作为参考,莎士比亚全集约 90 万字,可以翻译成约 120 万个 tokens。
也许更为重要的是,Tokens = Money。在受托管的 AI 模型的上下文中,你的花费取决于使用的 tokens 的数量。不管是输入还是输出,都计入 token 的数量。
另外,模型也有 token 限制,具体来说就是一次 API 调用会限制处理的文本的数量。这就是所谓的上下文窗口。如果文本超过这个限制,将不会被模型处理。
举例来说,ChatGPT3 的 token 限制为 4K,GPT4 则有多个选择,可以是 8K,16K 或 32K。Anthropic 的Claude AI 模型具有 100K token 限制,而 Meta 最近的研究创建了一个 1M token 限制的模型。
一次请求占用的 tokens 数量是输入 + 输出。
结构化输出
通常情况下,即使你要求 AI 模型输出JSON格式,但实际上它还是字符串。另外,要求“输出JSON”本身也不是一个准确的提示词。
这种复杂性导致了一个专门领域的出现,包括创建提示以产生预期的输出,然后将生成的简单字符串转换为用于应用程序集成的可用数据结构,如下图所示:

结构化输出转换采用精心设计的提示,通常需要与模型进行多次交互才能实现所需的格式。
训练你的 AI 模型
如何让 AI 模型拥有它没有被培训过的知识呢?
GPT3.5/4.0 知识库更新到 2021 年 9 月。改进版本的 GPT4 知识库更新到 23 年 10 月。某些特定版本还具备联网功能,可以获取实时信息。
定制AI模型主要有三种技术手段。
- 微调(Fine Tuning)
在现有大模型的基础上,使用特定领域的数据进行二次训练,以调整模型的权重,提升其在特定任务上的表现。如构建医疗、法律行业的问答系统,但这种方式不适用于 GPT 这种规模太大的模型。当然,也有一些模型是不提供微调选项的。
- 提示填充(Prompt Stuffing)
另外一种比较实际的方案是在提示词中填充你的数据。具体来说,就是将额外信息嵌入到提示中,以改进模型的回答或引导其生成目标输出,比如扩展上下文范围、提供更多相关背景,甚至注入具体的任务指令。
Spring AI 中的提示填充即所谓的 RAG(Retrieval Augmented Generation,检索增强生成)
- 工具调用
工具调用或者说函数调用允许注册工具(用户定义好的服务或函数),将大型语言模型连接到外部系统的 api。
检索增强生成
Spring AI 中使用了 Retrieval Augmented Generation 来实现提示填充。RAG主要包括两个阶段,一是检索阶段,在用户提出问题时,系统会通过搜索引擎、数据库查询或向量检索等技术,从外部知识库(如文档集合、数据库、网页等)中提取相关信息。二是生成阶段,使用生成式AI模型接收用户输入和检索到的信息,并根据二者生成答案。如下图所示:

其中offline部分是离线生成外部知识库的过程,runtime 部分就是将用户问题与检索到的信息传入模型并返回生成结果的过程。
工具调用
大型语言模型在训练后是冻结的,这会导致知识陈旧,并且无法访问或修改外部数据。
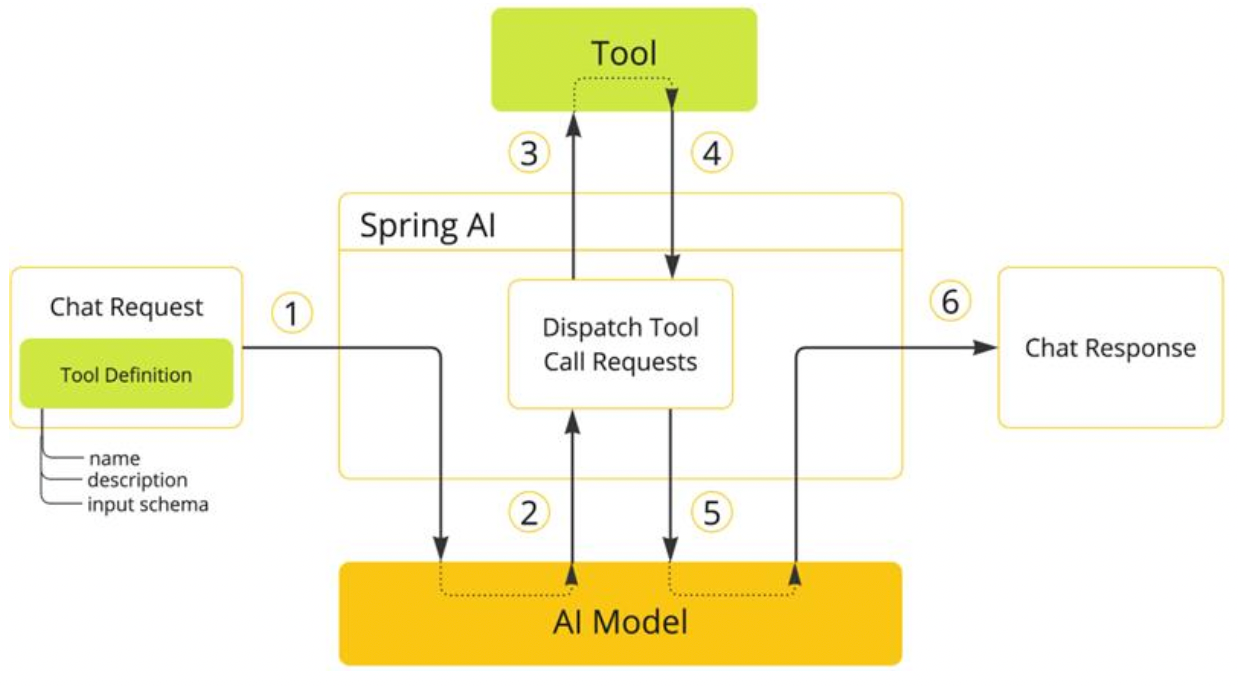
工具调用机制可以解决这些缺点。它允许你将自己的服务注册成工具,以将大型语言模型连接到外部系统的 api。这些系统可以为 llm 提供实时数据并代表它们执行数据处理操作。
Spring AI 极大简化了为支持工具调用而需要编写的代码。它为你处理工具调用的对话,你可以通过 @Tool的形式提供方法,然后在提示词中使用它。此外,你也可以在单个提示词中定义和引用多个工具。如下所示:
结果评估
高效评价 AI 模型的输出结果对问题的准确性和有效性是非常重要的。这个评估过程包括分析生成的响应是否与用户的意图和查询的上下文一致。可以用来衡量响应质量的指标包括:相关性、连贯性和事实正确性。
其中一种方法是同时呈现用户的请求和 AI 模型的响应,查询该响应是否与提供的数据一致。进一步地,引入向量数据库存储的补充信息,提供额外上下文来支持评估过程。
Spring AI 提供了一个名为Evaluator API 的工具,用于自动化模型响应的评估过程。当然,目前只提供了一些基础评估策略。
开启你的 Spring AI 之旅
你可以通过 Spring Initializr 来创建你的 Spring AI 项目,也可以手动创建。
或者直接从github上下载demo:
- OpenAI:github.com/rd-1-2022/ai-openai-helloworld
- Azure OpenAI:github.com/rd-1-2022/ai-azure-openai-helloworld 或者 github.com/Azure-Samples/spring-ai-azure-workshop
下面以ai-azure-openai-helloworld为例,下载到本地后,配置好的你的api-key和endpoint。有的模型还需要额外设置一下temperature: 1。
temperature是一个用来控制生成式AI模型输出内容随机性的重要参数。数值越小,随机性越低。数值越大,随机性越高。
运行项目,访问curl localhost:8080/ai/simple即可。
其他资源:awesome-spring-ai
Chat Client
ChatClient为与AI模型通信提供了流畅的API,它同时支持同步和流式编程模型。
创建ChatClient
下面是一个例子:
@RestController
class MyController {

    private final ChatClient chatClient;

    public MyController(ChatClient.Builder chatClientBuilder) {
        this.chatClient = chatClientBuilder.build();
    }

    @GetMapping("/ai")
    String generation(String userInput) {
        return this.chatClient.prompt()
            .user(userInput)
            .call()
            .content();
    }
}
ChatClient.Builder是自动装配的bean,直接注入使用即可。
也可以禁用ChatClient.Builder 的自动装配:spring.ai.chat.client.enabled=false。这在联合使用多种对话模型时是很有用的。
单个模型,多个 ChatClients
假如在某个场景中,需要有多个 ChatClients,使用方式如下:
// Create ChatClient instances programmatically
ChatModel myChatModel = ... // already autoconfigured by Spring Boot
ChatClient chatClient = ChatClient.create(myChatModel);

// Or use the builder for more control
ChatClient.Builder builder = ChatClient.builder(myChatModel);
ChatClient customChatClient = builder
    .defaultSystemPrompt("You are a helpful assistant.")
    .build();
多模型
如果需要联合使用多种不同的模型,则使用方式如下:
import org.springframework.ai.chat.ChatClient;
import org.springframework.context.annotation.Bean;
import org.springframework.context.annotation.Configuration;

@Configuration
public class ChatClientConfig {

    @Bean
    public ChatClient openAiChatClient(OpenAiChatModel chatModel) {
        return ChatClient.create(chatModel);
    }

    @Bean
    public ChatClient anthropicChatClient(AnthropicChatModel chatModel) {
        return ChatClient.create(chatModel);
    }
}
多 OpenAI 兼容的 API 终端
OpenAI 定义的一套调用大模型的接口规范,现已成为行业通用标准,很多平台都会兼容它以降低用户接入成本。
在 SpringAI 中,OpenAiApi 和 OpenAiChatModel 类提供了 mutate() 方法,实现了对 OpenAI 兼容的模型的热插拔,如下所示:
@Service
public class MultiModelService {

    private static final Logger logger = LoggerFactory.getLogger(MultiModelService.class);

    @Autowired
    private OpenAiChatModel baseChatModel;

    @Autowired
    private OpenAiApi baseOpenAiApi;

    public void multiClientFlow() {
        try {
            // Derive a new OpenAiApi for Groq (Llama3)
            OpenAiApi groqApi = baseOpenAiApi.mutate()
                .baseUrl("https://api.groq.com/openai")
                .apiKey(System.getenv("GROQ_API_KEY"))
                .build();

            // Derive a new OpenAiApi for OpenAI GPT-4
            OpenAiApi gpt4Api = baseOpenAiApi.mutate()
                .baseUrl("https://api.openai.com")
                .apiKey(System.getenv("OPENAI_API_KEY"))
                .build();

            // Derive a new OpenAiChatModel for Groq
            OpenAiChatModel groqModel = baseChatModel.mutate()
                .openAiApi(groqApi)
                .defaultOptions(OpenAiChatOptions.builder().model("llama3-70b-8192").temperature(0.5).build())
                .build();

            // Derive a new OpenAiChatModel for GPT-4
            OpenAiChatModel gpt4Model = baseChatModel.mutate()
                .openAiApi(gpt4Api)
                .defaultOptions(OpenAiChatOptions.builder().model("gpt-4").temperature(0.7).build())
                .build();

            // Simple prompt for both models
            String prompt = "What is the capital of France?";

            String groqResponse = ChatClient.builder(groqModel).build().prompt(prompt).call().content();
            String gpt4Response = ChatClient.builder(gpt4Model).build().prompt(prompt).call().content();

            logger.info("Groq (Llama3) response: {}", groqResponse);
            logger.info("OpenAI GPT-4 response: {}", gpt4Response);
        }
        catch (Exception e) {
            logger.error("Error in multi-client flow", e);
        }
    }
}
ChatClient Response
你可以通过三种方式来创建链式API:prompt(),prompt(Prompt prompt) 和 prompt(String content)。
ChatClient 提供了多种方式对返回结果进行格式化。
返回 ChatResponse
AI 模型的返回类型是ChatResponse定义的,其中包括 response 的元数据,如该 response 所使用的tokens 数量:
ChatResponse chatResponse = chatClient.prompt()
    .user("Tell me a joke")
    .call()
    .chatResponse();
返回Entity
可以通过 entity方法将返回的内容映射成对象实体,如下所示:
record ActorFilms(String actor, List<String> movies) {}

ActorFilms actorFilms = chatClient.prompt()
    .user("Generate the filmography for a random actor.")
    .call()  // send request to AI model
    .entity(ActorFilms.class);
流式响应
stream() 方法可以让结果异步返回:
Flux<String> output = chatClient.prompt()
    .user("Tell me a joke")
    .stream()
    .content();  // string content response
当然,也可以直接通过异步的Flux<ChatResponse> chatResponse()来获得异步返回。
根据以上介绍可知,对 AI 模型的调用分为同步和异步两种方式,前者使用call方法,后者使用stream方法。原始的返回内容应该是ChatResponse类型,其中包括了各种元数据。可以通过content方法仅仅只返回字符串类型,也可以通过entity方法来返回对象实体。
call() 返回值
call() 后可以调用不同方法来同步获取不同类型的返回结果:
- String content(): 响应结果的字符串内容。
- ChatResponse chatResponse(): ChatResponse 对象,包含响应的元数据等信息。
- ChatClientResponse chatClientResponse():ChatClientResponse 对象,包含 ChatResponse 对象和 ChatClient 的执行上下文。
- entity(): Java 对象,支持多种参数,最基本的就是 Class。
- responseEntity(): ChatResponse 对象和 Java 对象,同样支持多种参数。
stream() 返回值
stream() 后可以调用不同方法来异步获取不同类型的返回结果:
- Flux content(): 字符串格式的 Flux 对象。
- Flux chatResponse():ChatResponse 格式的 Flux 对象。
- Flux chatClientResponse(): ChatClientResponse 格式的 Flux 对象。
使用默认值
在与 AI 模型进行交互时,请求一般包含三类消息:
- system,定义模型行为,例如确定其回答的风格、角色或语气
- user,用户输入
- asistent,模型历史回复
下面是一个示例:
"messages": [
    {
      "role": "system",
      "content": "你是一个资深Java架构师,擅长Spring生态。回答必须简洁、结构化,并提供可执行建议。避免泛泛而谈。"
    },
    {
      "role": "user",
      "content": "在Spring AI中如何实现多模型切换(OpenAI 和 Groq),并保证代码最小改动?"
    }
  ]
如果在与 AI 模型交互时没有指定系统级别的 prompt,大多数模型服务商会在后台自动加一段默认的 system 指令,但这种内置的 system 提示一般只包含安全性、合法性等要求。在实际开发中,最好是显式地设置 system prompt。
默认系统提示
创建 ChatClient 时可以指定系统提示,这样就可以在使用 ChatClient 时默认使用 system prompt 了:
@Configuration
class Config {

    @Bean
    ChatClient chatClient(ChatClient.Builder builder) {
        return builder.defaultSystem("You are a friendly chat bot that answers question in the voice of a Pirate")
                .build();
    }

}
然后调用这个chatClient:
@RestController
class AIController {

	private final ChatClient chatClient;

	AIController(ChatClient chatClient) {
		this.chatClient = chatClient;
	}

	@GetMapping("/ai/simple")
	public Map<String, String> completion(@RequestParam(value = "message", defaultValue = "Tell me a joke") String message) {
		return Map.of("completion", this.chatClient.prompt().user(message).call().content());
	}
}
带参数的默认系统提示
修改默认的系统提示如下:
@Configuration
class Config {

    @Bean
    ChatClient chatClient(ChatClient.Builder builder) {
        return builder.defaultSystem("You are a friendly chat bot that answers question in the voice of a {voice}")
                .build();
    }

}
调用:
@RestController
class AIController {
	private final ChatClient chatClient;

	AIController(ChatClient chatClient) {
		this.chatClient = chatClient;
	}

	@GetMapping("/ai")
	Map<String, String> completion(@RequestParam(value = "message", defaultValue = "Tell me a joke") String message, String voice) {
		return Map.of("completion",
				this.chatClient.prompt()
						.system(sp -> sp.param("voice", voice))
						.user(message)
						.call()
						.content());
	}

}
其他默认配置项
其他默认配置项
在 ChatClient.Builder 级别,你可以指定默认的提示词配置,如
defaultOptions(ChatOptions chatOptions): 可以传入ChatOptions属性配置,也可以传入特定模型配置,如实现了ChatOptions接口的OpenAiChatOptions。defaultFunction(String name, String description, java.util.function.Function<I, O> function):三个参数分别表示函数名,函数描述和模型要调用的函数本身。defaultFunctions(String… functionNames):在应用上下文中定义的函数 bean 的名称。defaultUser(String text),defaultUser(Resource text),defaultUser(Consumer<UserSpec> userSpecConsumer): 用于定义用户文本。Consumer<UserSpec>允许你用lambda表达式来指定用户文本和其他默认参数。defaultAdvisors(Advisor… advisor):在与 AI 模型交互的过程中拦截请求或响应,修改相应的数据。QuestionAnswerAdvisor实现通过在提示词里附加与用户文本相关的上下文信息来支持检索增强生成(RAG)模式。defaultAdvisors(Consumer<AdvisorSpec> advisorsSpecConsumer):允许定义一个Consumer通过AdvisorSpec来配置多个 advisors。
这些方法去掉 default 前缀,就是相应的自定义方法了,可以用来覆盖默认值。
Advisors
在 Spring AI 中,Advisors 是用于拦截和增强 AI 操作行为的组件。可以将其看作是一种中间件机制,允许开发者在 AI 请求的处理流程中插入自定义逻辑,以调整默认行为或实现特定需求。
ChatClient的流式API提供了 AdvisorSpec 接口用来配置 advisors。如下所示:
interface AdvisorSpec {
    AdvisorSpec param(String k, Object v);
    AdvisorSpec params(Map<String, Object> p);
    AdvisorSpec advisors(Advisor... advisors);
    AdvisorSpec advisors(List<Advisor> advisors);
}
advisors 根据添加的先后顺序按顺序执行,下面是一个示例:
ChatClient.builder(chatModel).build().prompt().advisors(
	MessageChatMemoryAdvisor.builder(chatMemory).build(),
	QuestionAnswerAdvisor.builder(vectorStore).build()
).user(userText).call().content();
这个例子中,MessageChatMemoryAdvisor 将会先执行,将对话历史记录添加到 prompt 中,然后 QuestionAnswerAdvisor 会根据 prompt 来查询向量库,获取用户请求的上下文信息,生成最终的 prompt 发送给 AI 模型。
日志
SimpleLoggerAdvisor 是一个记录 request 和 response 的日志 advisor,开启如下:
ChatResponse response = ChatClient.create(chatModel).prompt()
        .advisors(new SimpleLoggerAdvisor())
        .user("Tell me a joke?")
        .call()
        .chatResponse();

// set up the log level
loggging.level.org.springframework.ai.chat.client.advisor=DEBUG
你可以定制日志格式:
SimpleLoggerAdvisor(
    Function<AdvisedRequest, String> requestToString,
    Function<ChatResponse, String> responseToString,
    int order
)

// example usage
SimpleLoggerAdvisor customLogger = new SimpleLoggerAdvisor(
	request -> "Custom request: " + request.userText,
	response -> "Custom response: " + response.getResult(),
	0
);
参考资料
[1]. https://docs.spring.io/spring-ai/reference/concepts.html


 扫一扫


 4931

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


