英伟达Orin芯片平台使用TensorRT加速部署YOLO

[orin] nvidia orin 上配置tensorrt | 解决虚拟环境中路径无法import的问题 到系统本身的python目录下,把`tensorrt-8.4.1.5.dist-info`和`tensorrt`两个文件夹拷贝到虚拟环境(我这里的名字叫做`mmdeploy`)中。 阅读详情

前言

自动驾驶行业想要在开发板上部署一套算法还是需要花费很大功夫的,因为计算资源的限制以及实时性要求高。并不像在服务器端部署算法那样粗犷。接下来就记录一下YOLO系列部署的过程,后期会把开发板上的问题都记录在此。


一、部署环境

计算平台:orin
算力:254 TOPS
系统环境:Ubuntu 20.04
Cuda:11.4
cudnn:8.3.2
TensorRT:
ros:noetic

二、拉取代码

1.克隆YOLOv5源码

git clone https://github.com/ultralytics/yolov5.git

自定义数据的训练可以参考博客:yolov5训练过程

2.克隆下载tensorrtx

git clone -b yolov5-v7.0 https://github.com/wang-xinyu/tensorrtx.git

三、模型转化

1.生成yolov5s.wts文件

将tensorrt/yolov5下的gen_wts.py 复制yolov5项目目录下,执行如下命令就会生成yolov5s.wts模型

python gen_wts.py --weights weights/yolov5s.pt

2.编译

接下来在tensorrt目录下进行编译,

mkdir build && cd build
cmake .. && make

编译通过后会生成yolov5_cls,yolov5_det,yolov5_seg 可执行文件
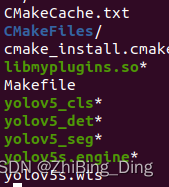
在这里插入图片描述

3.生成TensorRT加速engine

通过编译后,使用可执行文件进行加速模型的转化

sudo ./yolov5_det -s yolov5s.wts yolov5s.engine s

此时,生成了上图的yolov5_engin模型,接下来就可以进行模型推理了

 ./yolov5_seg -d yolov5s.engine ../samples

四、问题

1.yolov5分割暂时还没有跑通;

./yolov5_seg -d yolov5s.engine ../samples

报如下错误:
[12/30/2022-16:03:31] [W] [TRT] TensorRT was linked against cuBLAS/cuBLAS LT 11.8.0 but loaded cuBLAS/cuBLAS LT 11.6.5
[12/30/2022-16:03:32] [W] [TRT] TensorRT was linked against cuBLAS/cuBLAS LT 11.8.0 but loaded cuBLAS/cuBLAS LT 11.6.5
yolov5_seg: /home/maxsense/yolov5_trt/tensorrtx/yolov5/yolov5_seg.cpp:341: int main(int, char**): Assertion `engine->getNbBindings() == 3’ failed.
Aborted (core dumped)
2.计划把yolov7 部署到Orin 嵌入式平台上;
3.rostopic 发送和回调参考rostopic

五、小技巧

查看cudnn版本
ldconfig -v | grep cudnn


Jetson AGX Orin上部署YOLOv5_v5.0+TensorRT8 阅读详情

相关推荐

jetson agx orin 的pytorch、torchvision、tensorrt安装最全教程

jetson agx orin 的pytorch、torchvision、tensorrt安装最全教程

qq_58728069的博客 1万+

Jetson Nano部署YOLOv5与Tensorrtx加速——(自己走一遍全过程记录)

Jetson Nano部署YOLOv5与Tensorrtx加速

Mr_LanGX的博客 3万+

英伟达 Jetson Orin Nano Super 开发套件实测:从烧录到部署避坑指南

边缘AI与嵌入式视觉的快速发展,让开发者对低功耗高算力平台的需求日益增长。Jetson Orin Nano Super 作为英伟达推出的开发套件,凭借67 TOPS算力与102GB/s内存带宽,成为目标检测、语义分割等推理任务的理想选择。它基于Ampere架构GPU,通过JetPack 6.2软件解锁性能,无需更换硬件即可获得Super模式体验。本文从实际工程角度出发,详解系统烧录流程、驱动版本选择、TensorRT引擎部署及现场测试方法,并针对常见问题如USB识别失败、GPU利用率低等提供排查思路。无论是

weixin_34159110的博客 551

Jetson Orin arm64架构搭建手写AI tensorRT_Pro项目环境

Jetson Orin arm64架构搭建手写AI tensorRT_Pro项目环境

weixin_42855362的博客 3461

英伟达Jetson Orin Nano Super开发套件实战:从烧录到边缘AI部署

边缘计算正成为AI落地的重要阵地,而如何在低功耗设备上高效完成深度学习推理,是开发者普遍关注的难题。以GPU为核心的嵌入式平台提供了新的解决思路,它将CUDA生态带到设备端,让智能相机、机器人、工业视觉等场景能够在靠近数据源的位置实时处理信息。实际部署过程中,硬件选型、系统烧录、模型优化与环境配置环环相扣,任何一个环节失误都可能导致性能不及预期。TensorRT加速、模型量化、功耗与温控管理,都是决定边缘AI项目能否稳定运行的关键因素。本文基于一套真实测试记录,从开发套件开箱、JetPack环境搭建、Sup

weixin_34380948的博客 256

终端侧AI芯片怎么选?RK3588、旭日X5、Orin Nano实战对比与部署指南

边缘计算正成为AI落地的核心形态,其价值在于将实时推理、数据隐私和长期成本三者统一到本地设备上。理解终端侧AI芯片的算力分层与工具链差异,是选型的第一步:从MCU级轻量推理到边缘服务器级重负载,不同场景对应不同TOPS区间。部署实践中,模型转换与量化精度是常见难点,而芯片的NPU架构、软件生态和散热设计则决定了项目能否稳定量产。针对当前最热门的中高端边缘盒子需求,本文深度拆解RK3588的全能型集成方案、地平线旭日X5的专用视觉优化思路,以及Jetson Orin Nano的CUDA生态优势,结合模型转换、

weixin_33843409的博客 301

英伟达DRIVE平台解析:从芯片到软件栈的自动驾驶开发生态

在自动驾驶技术领域,异构计算架构与高性能AI推理是支撑系统实时决策的核心基础。异构计算通过协同CPU、GPU及专用加速器(如DLA),实现对感知、融合、规划等任务的高效并行处理,其关键在于软硬件协同优化。这一技术价值在于显著提升算力利用效率,满足车载环境对低延迟、高可靠性的严苛要求。在实际应用中,开发者需借助TensorRT等工具将训练好的深度学习模型进行量化与编译优化,以部署至车规级芯片。本文以英伟达DRIVE平台为例,深入剖析其从Orin芯片到DriveWorks框架的完整工具链,探讨如何通过Tenso

weixin_30514745的博客 344

自研YOLO训练平台:20张图快速实现AI视觉硬件部署

目标检测作为计算机视觉的核心任务,通过深度学习模型在图像中定位和识别物体,其原理基于卷积神经网络提取特征并预测边界框与类别。这项技术的价值在于将视觉感知能力赋予机器,广泛应用于工业质检、智能安防、自动驾驶等领域。传统YOLO模型开发面临数据收集难、训练复杂、端侧部署门槛高等挑战,尤其涉及瑞芯微、英伟达Jetson等硬件适配时,流程繁琐。本文介绍的一体化训练平台,集成了数据标注、智能扩增和小样本学习能力,通过自动化流水线简化从模型训练到端侧部署的全过程,让开发者能快速验证视觉想法并落地到嵌入式设备,显著降低A

weixin_30493401的博客 402

一站式YOLO训练平台:20张图启动,跨瑞芯微/英伟达硬件部署

目标检测作为计算机视觉的核心任务,其原理是通过深度学习模型在图像中定位和识别目标物体。YOLO系列算法因其速度快、精度高而成为工业界首选,其技术价值在于实现了实时检测与高精度的平衡。在实际工程应用中,模型训练与硬件部署常面临环境配置复杂、跨平台适配困难等挑战,尤其在小样本场景和嵌入式设备部署中更为突出。针对这些痛点,一站式YOLO训练平台应运而生,它封装了从数据标注、模型训练到端侧部署的全流程,显著降低了技术门槛。该平台支持小样本训练,仅需20张图片即可启动,并内置数据扩增功能提升模型鲁棒性。同时,它打通了

weixin_30394981的博客 399

Jetson Orin Nano 2深度解析:AI算力翻倍至100 TOPS,边缘部署如何受益

边缘计算已成为AI落地的重要方向,在摄像头、机器人和工业设备上实现本地推理,需要兼顾算力、功耗与成本的嵌入式平台。英伟达Jetson系列长期是开发者首选,而新发布的Jetson Orin Nano 2开发套件,将AI性能提升至100 TOPS级别,内存与带宽同步升级。其背后依赖TensorRT对INT8稀疏计算的优化,以及16GB内存对量化大模型的支持,让过去只能在桌面端完成的任务开始向边缘迁移。无论是智能机器人、质检还是多路视频分析,Nano 2都提供了更充裕的算力预算。本文将围绕该开发板的硬件变化、实际

weixin_33770878的博客 303

Jetson Orin Nano Super性能翻倍实测:从装系统到大模型部署全攻略

边缘AI是近年嵌入式开发的热点,它要求设备在有限功耗下完成实时推理。其核心瓶颈常不在芯片算力,而在显存带宽与功耗策略。英伟达通过软件解锁,将Jetson Orin Nano Super的INT8算力从40 TOPS提升至67 TOPS,显存带宽翻倍到102GB/s,价格仍为249美元。这一软硬结合思路,大幅降低了本地运行大模型的门槛,使得7B量化LLM、YOLOv8s等视觉模型能在25W功耗下流畅运行。从系统烧录到Super模式切换,再到TensorRT加速,本文将完整梳理实际部署中的关键步骤与常见坑点,为

weixin_34176694的博客 408

实时手机检测-通用模型部署案例:Jetson Orin Nano边缘设备适配实录

本文介绍了如何在星图GPU平台上自动化部署“实时手机检测-通用”镜像,实现高效的边缘AI应用。该平台简化了部署流程,用户可快速搭建基于DAMO-YOLO模型的手机检测系统。该镜像的典型应用场景包括智能工厂生产线上的手机组装实时监控,或会议中心对参会人员手机使用情况的统计分析,满足边缘端实时、精准的视觉检测需求。

weixin_42577243的博客 401

英伟达Jetson Orin Nano深度评测:40TOPS算力边缘AI部署实战

边缘计算与本地AI推理正成为嵌入式开发的热点,其核心在于如何在低功耗下实现高效能计算。英伟达Jetson Orin Nano凭借40TOPS稀疏算力和Ampere架构GPU,为这一需求提供了硬件基础。通过TensorRT优化和DeepStream流水线,开发者能在7W-25W功耗窗口内运行YOLO、ResNet等模型,甚至部署Qwen量化大语言模型。从智能视觉到多路视频分析,该主板展现了CUDA生态在边缘侧的成熟度。本文基于实测数据,详解系统烧录、算力基准及典型场景部署,助你快速上手这块边缘推理利器。

weixin_42520573的博客 276

Jetson Orin Nano Super部署实战:从环境搭建到TensorRT性能调优

边缘计算正成为AI落地的重要阵地,在摄像头、机器人等资源受限设备上高效运行深度学习模型,是工程实践中的核心挑战。NVIDIA Jetson系列凭借专用GPU与统一软件生态,为边缘推理提供了理想平台。本文围绕Jetson Orin Nano Super开发套件,系统讲解硬件性能指标、JetPack系统烧录、PyTorch与TensorRT推理路径选择,并实测YOLOv8目标检测的帧率与显存占用。TensorRT作为性能优化利器,通过层融合与精度校准实现成倍提速,是边缘设备发挥算力的关键。文中还涵盖DeepSt

weixin_30399155的博客 344

Jetson Orin Nano 2深度解析:性能翻倍背后的技术逻辑与实操部署

边缘AI设备正成为机器人、工业视觉和端侧大模型落地的关键载体,而嵌入式平台的真实性能往往由算力、内存带宽与功耗策略共同决定。英伟达Jetson家族的新一代入门级产品Orin Nano 2,通过提升INT8算力、扩展内存带宽并放开功耗档位,让TOPS数字从40翻倍至80级别,但实际帧率收益还需结合TensorRT优化与散热管理。对于开发者而言,理解统一内存架构下的瓶颈转移,掌握nvpmodel功耗切换、YOLOv8模型导出为engine格式、llama.cpp量化部署等工程技能,远比单纯对比峰值性能更重要。在

weixin_33911824的博客 367

Jetson Orin Nano Super深度解析:67TOPS边缘AI性能翻倍实战指南

边缘计算正在改变AI落地的形态,从智能安防到机器人视觉,端侧推理的实时性和隐私优势愈发突出。在众多嵌入式AI平台中,NVIDIA Jetson系列凭借成熟的JetPack开发套件和TensorRT加速库,成为开发者最常用的选择之一。新一代Jetson Orin Nano Super将AI算力从40TOPS提升至67TOPS,内存带宽同步升级,使得原本只能在桌面级显卡上运行的YOLOv8、TinyBERT乃至量化大语言模型,如今可以在7至25瓦的功耗下流畅部署。本文将围绕硬件升级、JetPack版本迁移、模型

weixin_34185512的博客 341

Jetson Orin Nano Super 实测:67 TOPS 边缘 AI 部署与性能优化指南

边缘计算正在成为 AI 落地的关键战场,而算力与功耗的平衡始终是开发者面临的核心难题。Jetson 系列作为嵌入式 AI 的标杆平台,通过软硬件协同设计,在有限功耗内释放出可观的计算能力。以 Orin Nano Super 为例,其 67 TOPS 的 INT8 算力并非依赖新芯片,而是通过解锁功耗档位和频率策略实现的性能跃升。在深度学习模型部署中,TensorRT 加速与量化技术能进一步挖掘硬件潜力,使目标检测、大语言模型推理等任务在边缘侧高效运行。本文从硬件构成、系统烧录、性能实测到问题排查,完整展示了

weixin_34357887的博客 313

Xcelium XRUN实用指南:从入门到高效仿真

本文是Xcelium XRUN仿真工具的实用指南,从基础入门到高效应用全面解析。XRUN作为Cadence Xcelium的统一命令行入口,能自动化编译、精细和仿真流程,大幅提升数字芯片与FPGA验证效率。文章详细介绍了最简命令、波形调试、增量编译、多核并行仿真等核心功能,并提供了管理复杂项目、性能调优与深度调试的进阶技巧,帮助工程师快速上手并精通这一高效仿真工具。

weixin_29238147的博客 719

英伟达Jetson Orin Nano Super开发套件实战:部署、评测与选型指南

边缘计算正成为AI落地的重要方向,在算力与功耗受限的设备上高效部署深度学习模型,是许多开发者和研究人员关注的焦点。其中,模型加速引擎(如TensorRT)和硬件平台的选择,直接影响推理性能与开发效率。Jetson系列作为嵌入式AI计算的代表,凭借统一的CUDA生态,为从原型验证到产品落地提供了平滑迁移路径。本文围绕最新的Jetson Orin Nano Super开发套件,介绍其硬件架构、算力升级与功耗设计,分享基于TensorRT的YOLOv8模型实测数据,并梳理系统烧录、环境配置与现场测试的完整流程。无

weixin_30399155的博客 164

LiveReload:释放你的F5,实时预览HTML效果

一、liveReload插件开发背景Web前端开发人员在写页面时,如果修改了HTML or CSS,要想看效果通常的做法就是保存代码就得 Alt+Tab,切换到浏览器(当然,我知道很多开发人员是双屏操作不一定需要切换到浏览器),但是一定要F5刷新才能看自己刚写的代码有没有效果,没有效果就再切换到编辑器下修改,然后再切换到浏览器F5刷新看效果,还没有效果,就再继续修改,如此反复。时间久了,前端自动化...

Char_n的博客 2499

SAP WMS开发实战:用BAPI_L_TO_CREATE_MULTIPLE搞定LT01转储单(附完整代码)

本文详细解析了SAP WMS开发中如何利用BAPI_L_TO_CREATE_MULTIPLE函数模块批量创建LT01转储单。文章深入剖析了核心参数、常见错误及实战代码框架,重点强调了源/目标存储类型等关键字段的获取方法,为系统集成与自动化流程开发提供了可靠的解决方案。

view3的博客 559
上一篇: git 使用
下一篇: fatal error: ***.h: No such file or directory
ZhiBing_Ding
博客等级 码龄9年 8147粉丝 55原创
评论 5
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

ZhiBing_Ding

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值