


本期学习活动我们一起来看一下数学建模导论的后半部分,使用语言为Python,本教程开源地址:
https://github.com/datawhalechina/intro-mathmodel
在线学习网站:Datawhale-学用 AI,从此开始
以下是本人参与Datawhale组队学习的笔记
目录
这一章主要是用以解决对于一个目标不同方案之间比较或不同影响因素之间比较的问题。
7.1.1 层次分析法的原理
在一些问题当中,明确了需要做一个评价类问题,通过查找以往文献得到了一些指标。在层次分析法中一个非常重要的操作就是构造层次模型图。从结构上看,层次分析法将模型大致分为目标层、准则层和方案层。目标层是你的评价目标,准则层是你的评价指标体系,方案层是多个对比方案。注意,方案层是一定要有多个对象进行比较的,因为层次分析法是基于比较的方法。指标按照一定的层级结构组织起来就构成了一个指标体系。
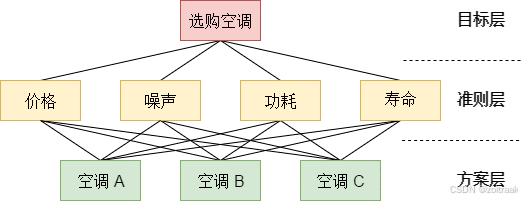
两个相邻的层次之间是需要构建成对比较矩阵的。
成对比较矩阵:
成对比较矩阵是一个方阵,用于表示不同因素之间的相对重要性。它的构造方法如下
-
-
假设在某一层有 n 个因素(或准则),那么成对比较矩阵的大小为 n×n。
-
-
矩阵的元素:
-
矩阵的每个元素 aij 表示因素 i 相对于因素 j 的重要性。通常,aij 是一个正数,表示因素 i 比因素 j 更重要(或更不重要)的程度。
-
如果 aij>1,则因素 i 比因素 j 更重要;
-
如果 aij<1,则因素 i 比因素 j 不重要;
-
如果 aij=1,则因素 i 和因素 j 同样重要。
-
-
对角线元素:
-
对角线上的元素 aii 表示因素 i 与自身比较,因此总是等于1。
-
-
互反性:
-
成对比较矩阵具有互反)(也称正互反矩阵)即 aij=aji1。这意味着,如果因素 i 比因素 j 更重要,那么因素 j 相对于因素 i 的重要性就是 aij 的倒数。
-
成对比较矩阵是层次分析法的核心工具之一,用于计算各因素的权重。通过求解矩阵的最大特征值对应的特征向量(归一化后),可以得到各因素的相对权重,从而为决策提供依据。
成对比较矩阵是一种用于量化因素相对重要性的工具,广泛应用于层次分析法中。它通过专家的主观判断,将复杂的决策问题转化为可量化的形式,帮助决策者做出更科学的决策。
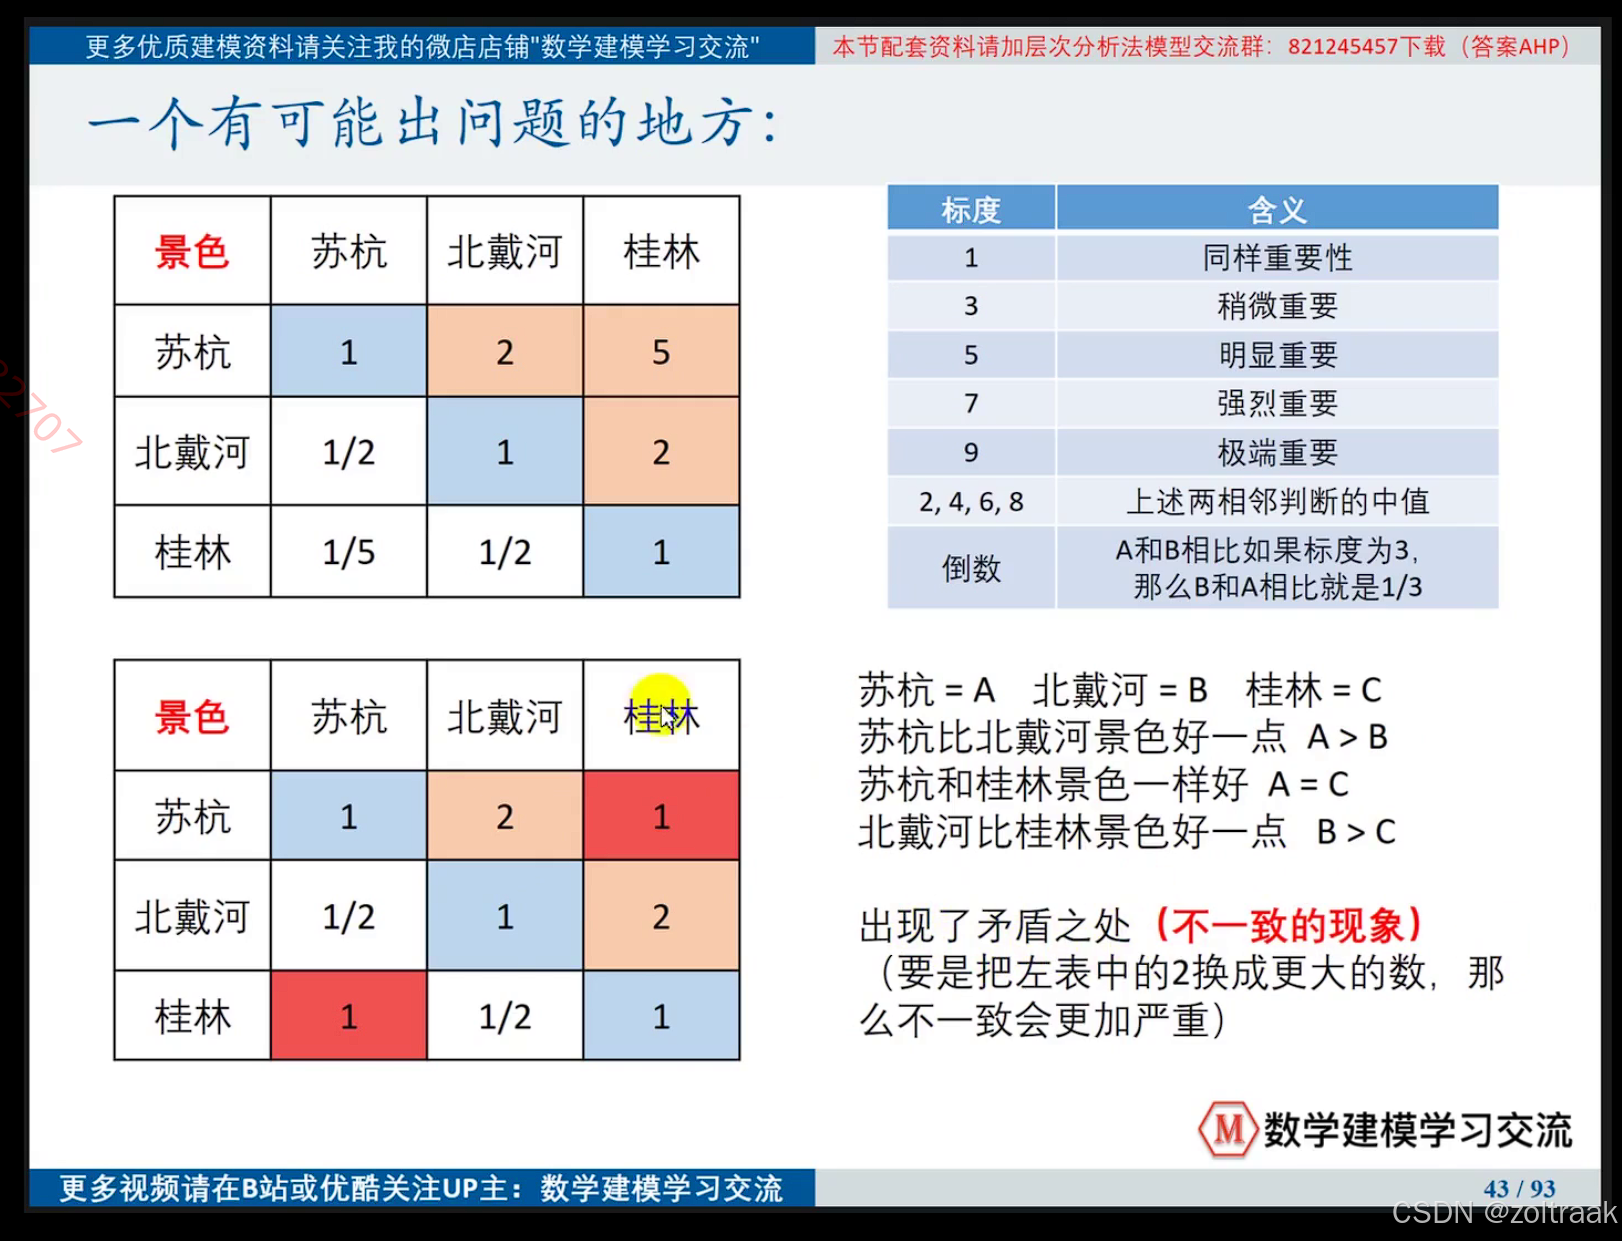
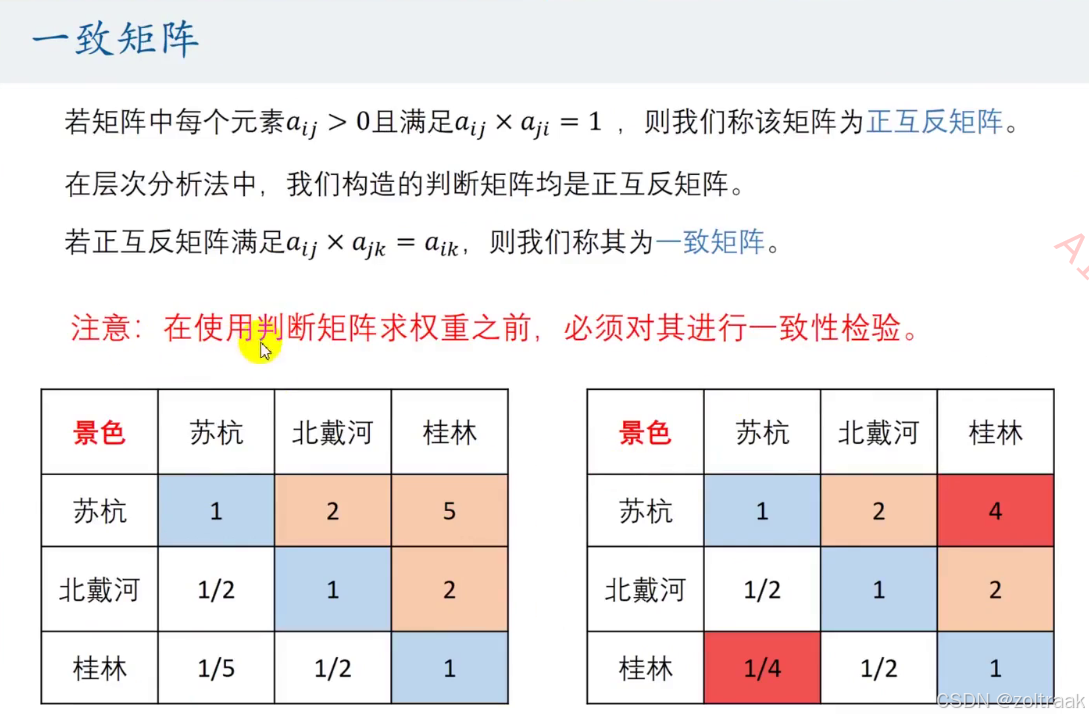
不一致现象:
 j
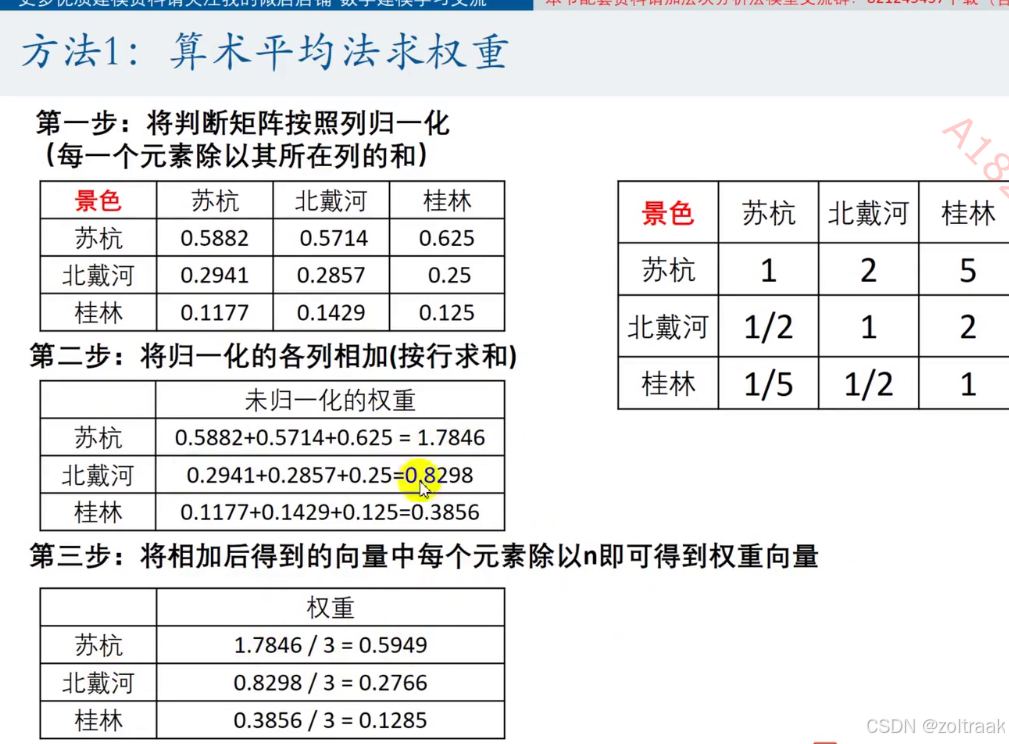
如果矩阵不一致,要用每一列的数据将权重求出再求平均值
几何平均法求权重:
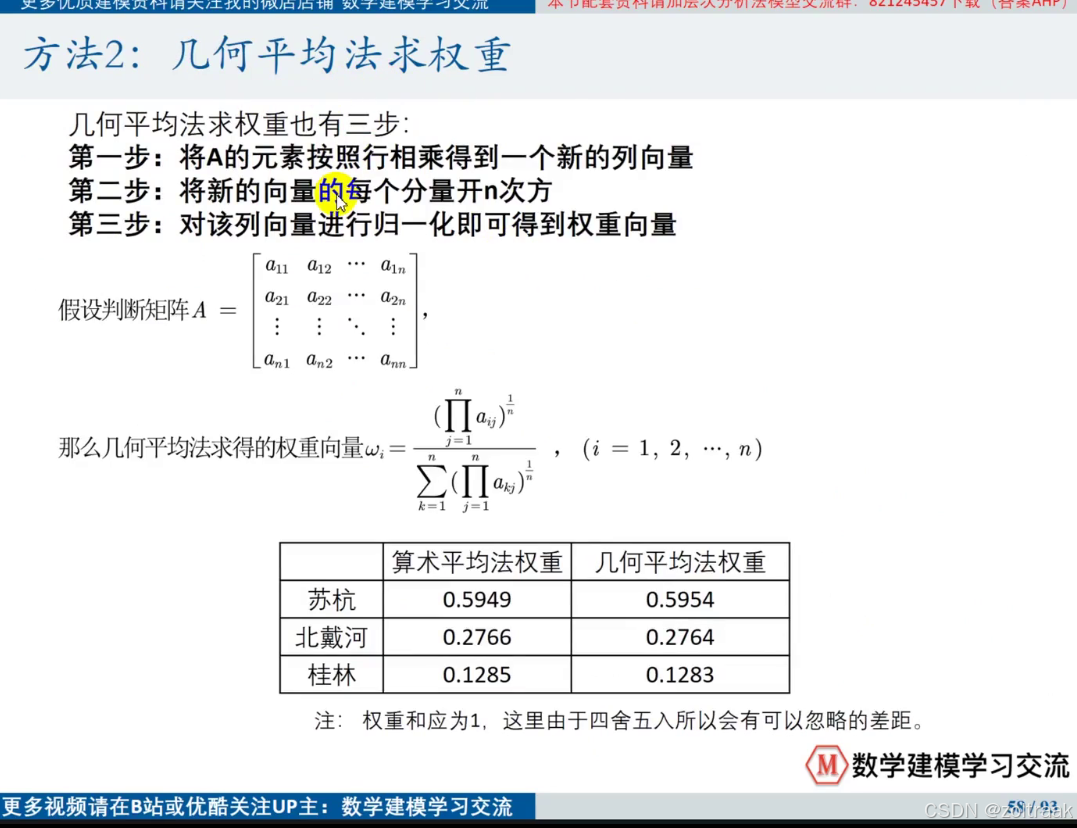
第三种方法:
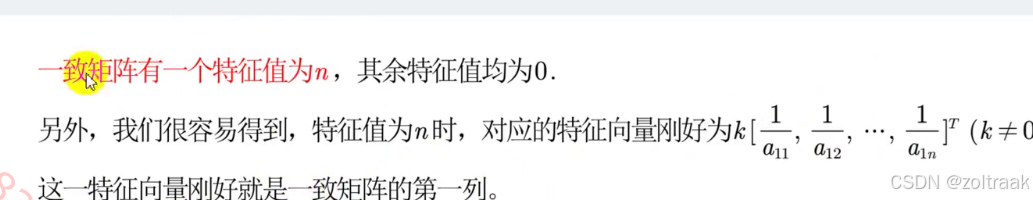
特征值法求权重
假设我们判断矩阵一致性可以接受,那么我们按照一致矩阵的权重求法
第一步,求出矩阵的最大特征值及其特征向量
第二步 :对求出的特征向量进行归一化记得到我们的权重
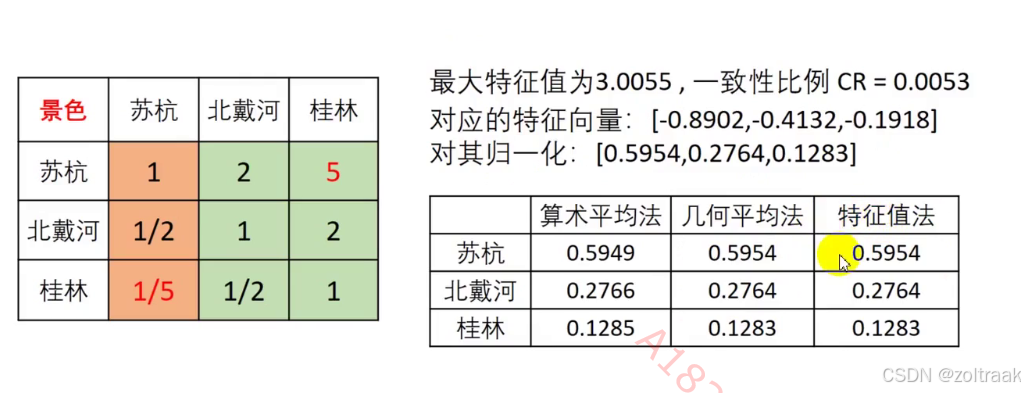
将计算结果填入特征表中,特征值法在获奖论文中使用最多
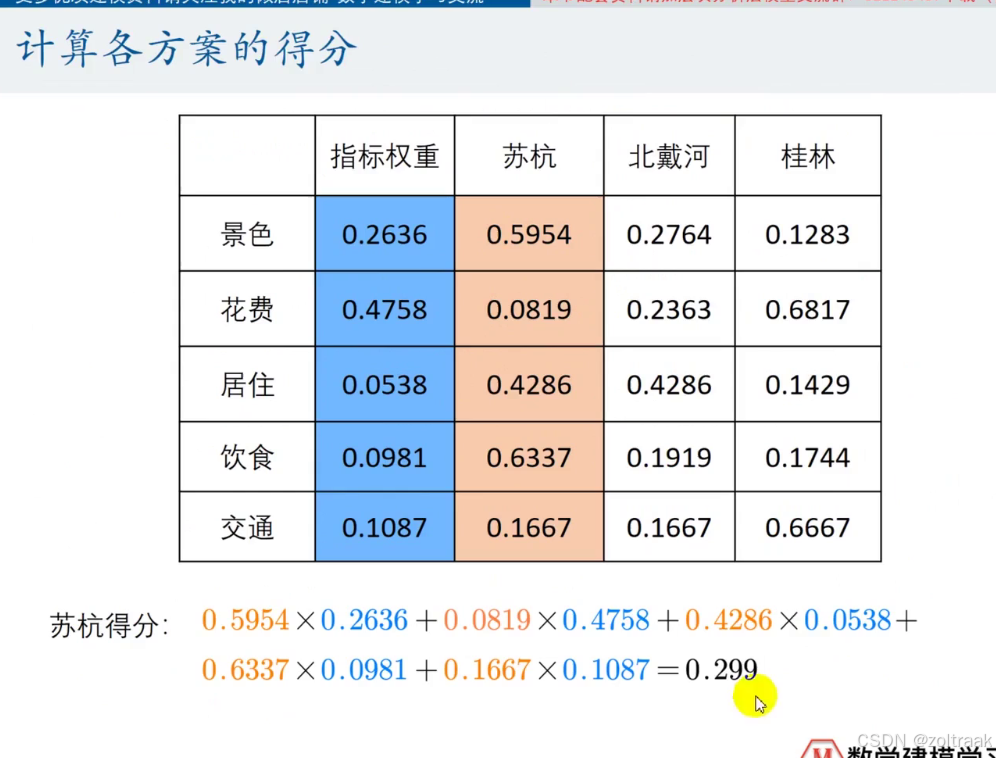
对于这样一个给定的表格,用excel快速计算其得分
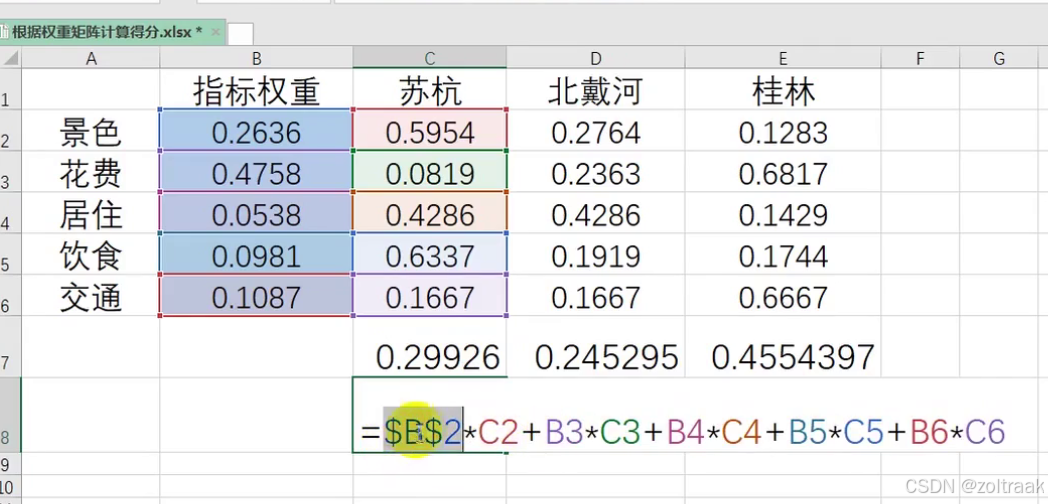
用f4锁定单元格,看见美元符号即可
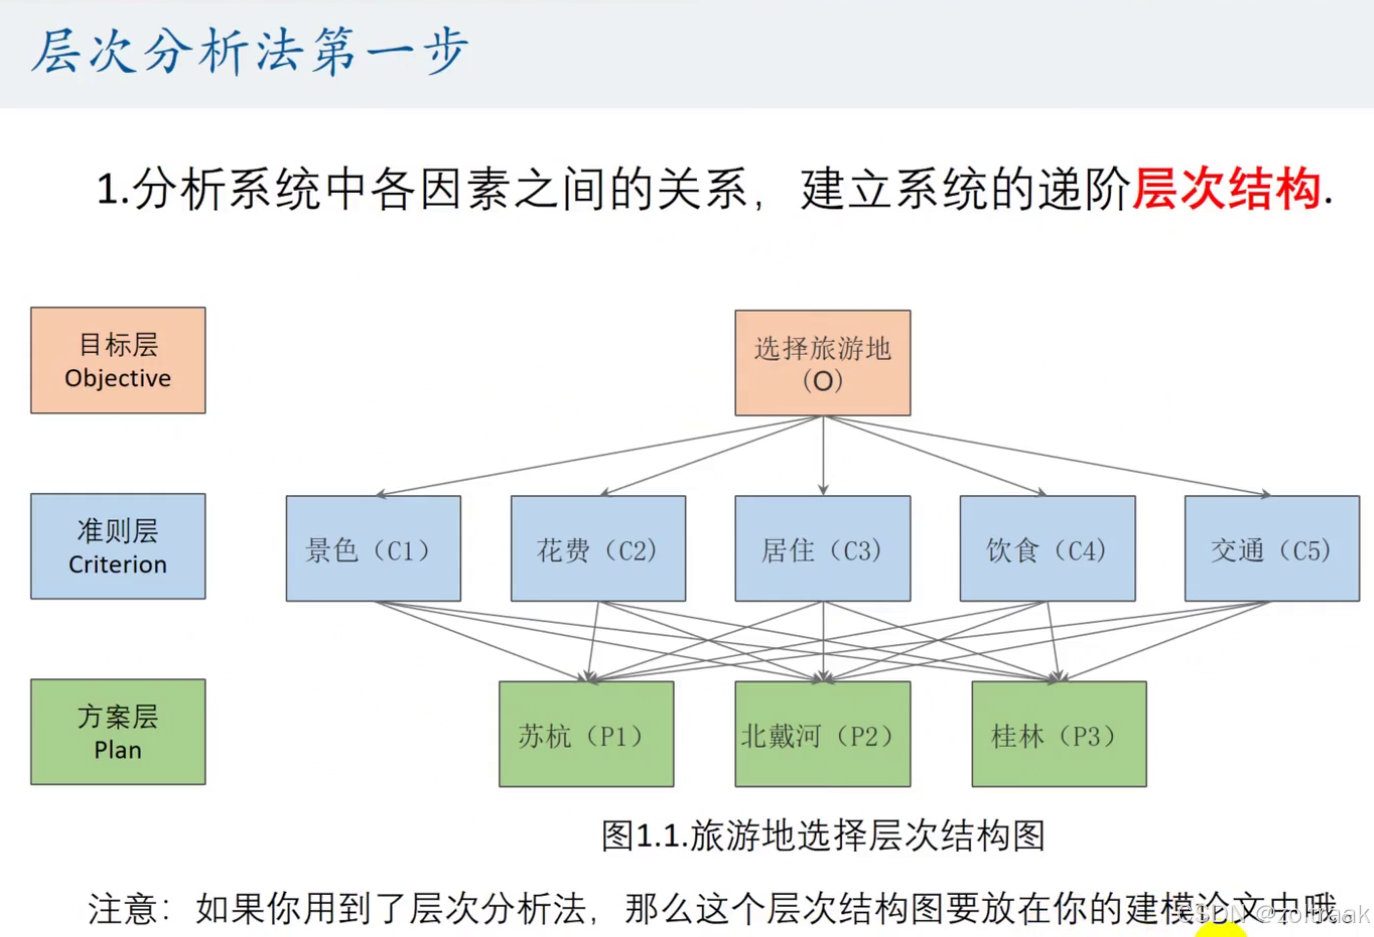
只要运用了层次分析法,就要将层次结构图放在论文中。
层次结构图的使用,使用PPT中的Smartart或者专业软件亿图图示
三种方法在计算权重时,为了保证结果的稳健性,本文采用了三种方法求权重。
往一致矩阵上调整
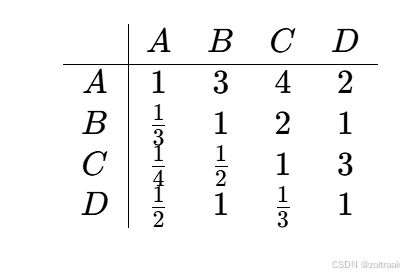
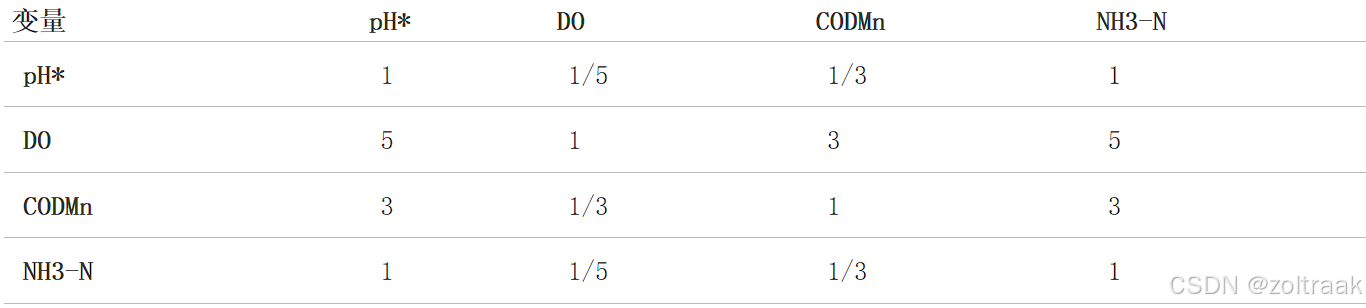
比方说在上图,我们在目标层和准则层之间就需要构建第一层比较矩阵,这个矩阵的大小是行列均为4。矩阵的每一项表示因素i和因素j的相对重要程度。由于对角线上元素都是自己和自己做比较,所以对角线上元素为1。
成对比较矩阵是一种用于量化因素相对重要性的工具,广泛应用于层次分析法中。它通过专家的主观判断,将复杂的决策问题转化为可量化的形式,帮助决策者做出更科学的决策。
对重要性的取值都是取奇数,也就是1、3、5、7、9,偶数是当你不太确定,也就是认为介于两个奇数程度之间时再取偶数。
这里的数学基础,矩阵的特征值分解我暂时不会。
具体来说,对于一个 n×n 的方阵 A,如果存在一个非零向量 v 和一个标量 λ,使得:
Av=λv
那么 λ 被称为矩阵 A 的特征值,而 v 被称为对应于特
征值 λ 的特征向量。
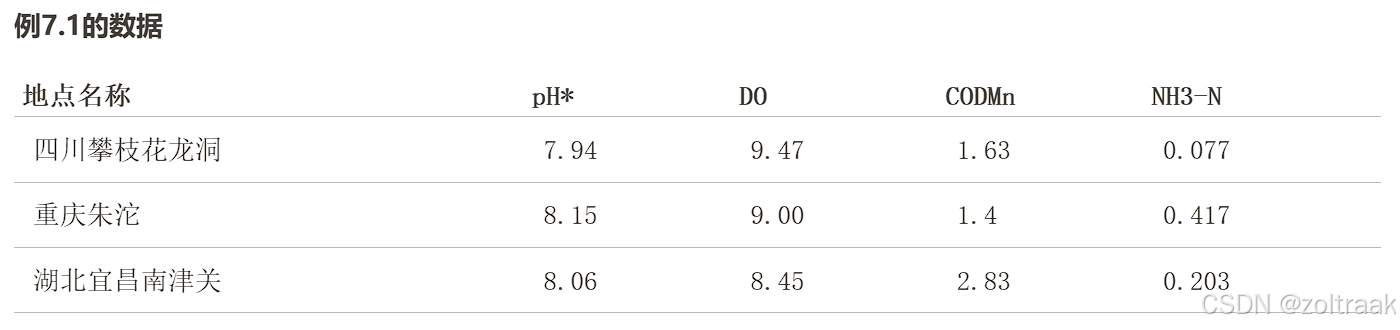
例如:某日从三条河流的基站处抽检水样,得到了水质的四项检测指标如表5.1所示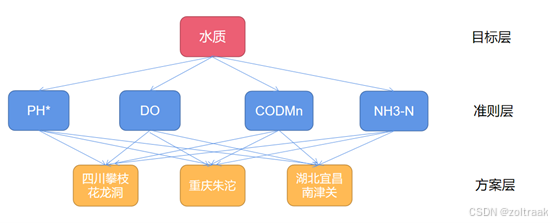
假设准则层有n个元素,从目标蹭到准则层构建一个大小为n的方阵,方案层有m个元素,从准则层到方案层构建n个大小为m的方阵
import numpy as np

# 构建矩阵
A = np.array([[1, 1/5, 1/3, 1],
              [5, 1, 3, 5],
              [3, 1/3, 1, 3],
              [1, 1/5, 1/3, 1]])

# 获得矩阵的维度
m, n = A.shape  # 获取矩阵的行数和列数

# 随机一致性指数(RI)表
RI = [0, 0, 0.58, 0.90, 1.12, 1.24, 1.32, 1.41, 1.45, 1.49, 1.51]

# 求判断矩阵的特征值和特征向量
# V为特征值,D为特征向量矩阵
V, D = np.linalg.eig(A)

# 将特征值转换为列表
list1 = list(V)

# 求矩阵的最大特征值
B = np.max(list1)  # 最大特征值
index = list1.index(B)  # 最大特征值的索引

# 提取最大特征值对应的特征向量
C = D[:, index]  # 注意:这里D是特征向量矩阵,D[:, index]表示第index列

# 打印结果
print("最大特征值:", B)
print("最大特征值对应的特征向量:", C)
最大特征值: (4.043493461607898+0j)
最大特征值对应的特征向量: [-0.15216224+0.j -0.89193997+0.j -0.39766367+0.j -0.15216224+0.j]
进而我们计算CI和CR,通过CTR的值判断矩阵是否通过一致性检验。
import numpy as np

# 构建矩阵
A = np.array([[1, 1/5, 1/3, 1],
              [5, 1, 3, 5],
              [3, 1/3, 1, 3],
              [1, 1/5, 1/3, 1]])

# 获得矩阵的维度
m, n = A.shape  # 获取矩阵的行数和列数

# 随机一致性指数(RI)表
RI = [0, 0, 0.58, 0.90, 1.12, 1.24, 1.32, 1.41, 1.45, 1.49, 1.51]

# 求判断矩阵的特征值和特征向量
# V为特征值,D为特征向量矩阵
V, D = np.linalg.eig(A)

# 将特征值转换为列表
list1 = list(V)

# 求矩阵的最大特征值
B = np.max(list1)  # 最大特征值
index = list1.index(B)  # 最大特征值的索引

# 提取最大特征值对应的特征向量
C = D[:, index]  # 注意:这里D是特征向量矩阵,D[:, index]表示第index列

# 打印结果
print("最大特征值:", B)
print("最大特征值对应的特征向量:", C)
import numpy as np

# 构建矩阵
A = np.array([[1, 1/5, 1/3, 1],
              [5, 1, 3, 5],
              [3, 1/3, 1, 3],
              [1, 1/5, 1/3, 1]])

# 获得矩阵的维度
m, n = A.shape

# 随机一致性指数(RI)表
RI = [0, 0, 0.58, 0.90, 1.12, 1.24, 1.32, 1.41, 1.45, 1.49, 1.51]

# 求判断矩阵的特征值和特征向量
V, D = np.linalg.eig(A)

# 将特征值转换为列表
list1 = list(V)

# 求矩阵的最大特征值
B = np.max(list1)
index = list1.index(B)

# 提取最大特征值对应的特征向量
C = D[:, index]

# 计算一致性指数(CI)
CI = (B - n) / (n - 1)

# 计算一致性比率(CR)
CR = CI / RI[n]

# 判断一致性
if CR < 0.10:
    print("CI=", CI)
    print("CR=", CR)
    print("对比矩阵A通过一致性检验,各向量权重向量Q为:")
    C_sum = np.sum(C)
    Q = C / C_sum
    print(Q)
else:
    print("对比矩阵A未通过一致性检验,需对对比矩阵A重新构造")
CI= (0.014497820535966117+0j)
CR= (0.012944482621398318+0j)
对比矩阵A通过一致性检验,各向量权重向量Q为:
[0.09546368-0.j 0.55958606-0.j 0.24948658-0.j 0.09546368-0.j]
Python在矩阵分析时是在复数域内进行分解,得到的向量也是一个附属向量矩阵的每一列代表评价准则。将这一方案权重矩阵与目标层到准则层的权重向量进行数量积,得到的分数就是最终的评分。将一个成对比较矩阵的AHP过程封装为函数,完整函数如下:
import numpy as np

def AHP(A):
    # 获取指标个数,即矩阵的阶数
    n = len(A)

    # 随机一致性指数(RI)表
    RI = [0, 0, 0.58, 0.90, 1.12, 1.24, 1.32, 1.41, 1.45, 1.49, 1.51]

    # 求判断矩阵的特征值和特征向量,V为特征值数组,D为特征向量矩阵
    V, D = np.linalg.eig(A)

    # 将特征值转换为列表,并求矩阵的最大特征值
    list1 = list(V)
    B = np.max(list1)

    # 获取最大特征值的索引,并提取对应的特征向量
    index = list1.index(B)
    C = D[:, index]

    # 计算一致性检验指标CI
    CI = (B - n) / (n - 1)

    # 计算一致性比率CR
    CR = CI / RI[n]

    # 判断一致性
    if CR < 0.10:
        print("CI=", CI)
        print("CR=", CR)
        print('对比矩阵A通过一致性检验,各向量权重向量Q为:')

        # 特征向量标准化
        C_sum = np.sum(C)
        Q = C / C_sum

        # 输出权重向量
        print(Q)
        return Q
    else:
        print("对比矩阵A未通过一致性检验,需对对比矩阵A重新构造")
        return None

# 示例使用
A = np.array([[1, 1/5, 1/3, 1],
              [5, 1, 3, 5],
              [3, 1/3, 1, 3],
              [1, 1/5, 1/3, 1]])
weight_vector = AHP(A)
if weight_vector is not None:
    print("权重向量:", weight_vector)
例7.2 第二个例子是有关于物种入侵的。
import numpy as np


def AHP(A):
    # 获取指标个数,即矩阵的阶数
    n = len(A)

    # 随机一致性指数(RI)表
    RI = [0, 0, 0.58, 0.90, 1.12, 1.24, 1.32, 1.41, 1.45, 1.49, 1.51]

    # 求判断矩阵的特征值和特征向量,V为特征值数组,D为特征向量矩阵
    V, D = np.linalg.eig(A)

    # 将特征值转换为列表,并求矩阵的最大特征值
    list1 = list(V)
    B = np.max(list1)

    # 获取最大特征值的索引,并提取对应的特征向量
    index = list1.index(B)
    C = D[:, index]

    # 计算一致性检验指标CI
    CI = (B - n) / (n - 1)

    # 计算一致性比率CR
    CR = CI / RI[n]

    # 判断一致性
    if CR < 0.10:
        print("CI=", CI)
        print("CR=", CR)
        print('对比矩阵A通过一致性检验,各向量权重向量Q为:')

        # 特征向量标准化
        C_sum = np.sum(C)
        Q = C / C_sum

        # 输出权重向量
        print(Q)
        return Q
    else:
        print("对比矩阵A未通过一致性检验,需对对比矩阵A重新构造")
        return None


# 目标层到第一准则层
A0 = np.array([[1, 3, 5],
               [1 / 3, 1, 3],
               [1 / 5, 1 / 3, 1]])

print('目标到第一准则层')
v0 = AHP(A0)

# 第一准则层到第二准则层
A11 = np.array([[1, 5, 3, 4, 2],
                [1 / 5, 1, 1 / 2, 1, 1 / 3],
                [1 / 3, 2, 1, 2, 1 / 2],
                [1 /



 扫一扫


 333

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


