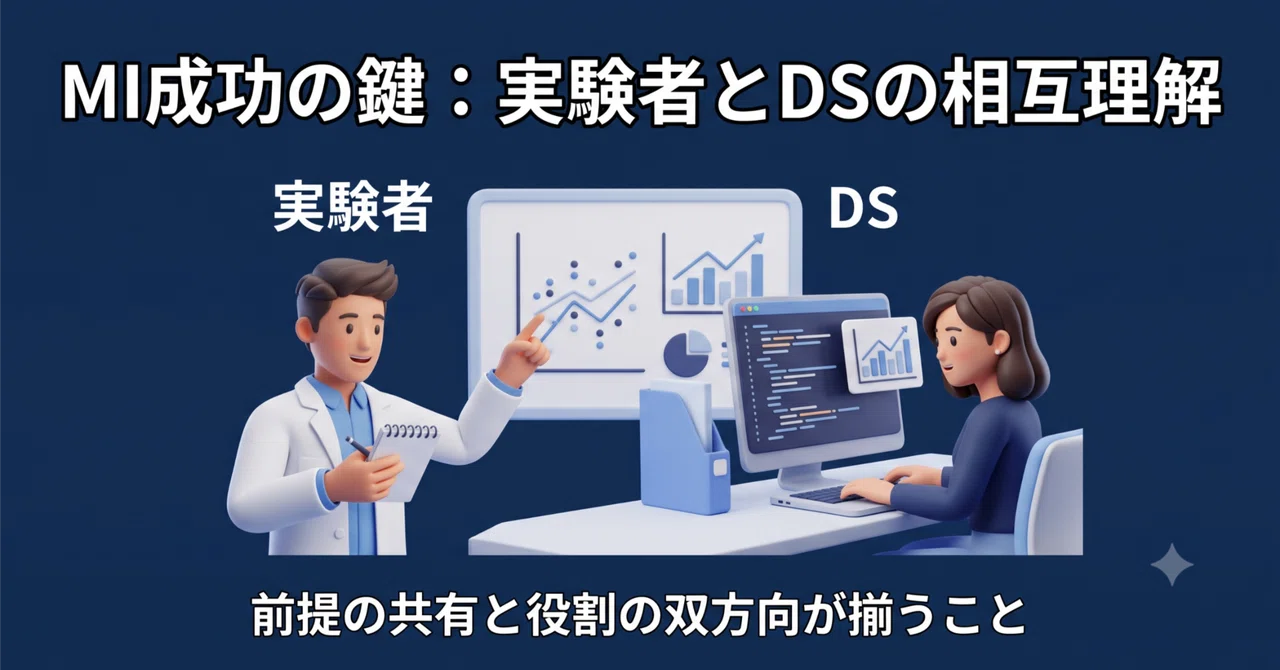
マテリアルズインフォマティクスに必要なのは、実験者とデータサイエンティストの相互理解

「データはあるのに精度が悪い」
「相関が強い変数があるのに、モデルが全然学習しない」
「せっかく作ったモデルが、現場では全く使えない」
そんなすれ違いを、マテリアルズインフォマティクス(MI)の現場では本当に多く見てきました。仕様が悪いわけではありません。前提が共有されていないことが、ほとんどの原因です。
以前、『データサイエンスだけではMIはできない——科学の知識が果たす役割』という記事で、データサイエンティストが科学の文脈を学びにいく必要があると書きました。今回はその続きで、それだけでは足りないという話です。実験者が何を渡すか、データサイエンティストが実験のどこに入るか——役割同士の双方向が揃わないと、MIは回りにくいと思っています。
実験者が渡すと、モデルに意味が出る
数値の表は出てきます。でも表だけ渡されても、データサイエンティストは「何を操作して何を見たいのか」「何が揺れ要因として残るのか」が読み取れないことがあります。
渡すと良いのは、完璧なレポートではなく、次のような文脈だと感じています。
何を仮定して、何を変えたか(今回の実験の意図)
それに至る経緯(プロジェクトの流れ、ここまでで何が分かっていて何がまだか)
何を優先するかという勘所(コスト、スピード、再現性、安全)
測定値が何を表しているか(中間の量なのか、最終品質なのか)
失敗・異常の判定基準(捨てたサンプルがあれば、なぜ捨てたか)
条件の再現性(同じ「条件」が、装置やロットでどう揺れるか)
意図に加えて経緯や勘所まで伝わっていると、データサイエンティストも「こう試したら」と提案しやすくなります。実験者が「それは通常やらない」「別ルートで見ている」と返せば無駄な往復が減ります。経緯がないと、データサイエンティストの提案が実験者の常識から外れて見えるやり取りになりがちです。
データサイエンティストが実験計画に入ると、手戻りが減る
実験が終わったあとに「そこは測っていないから特徴量に入れられない」となるのは、誰の非難というより設計のズレであることが多いです。
データサイエンティストが早い段階で入ると、次のような点を一緒に詰められます。
予測したいもの(目的変数)と、説明に使いたい物理量の対応
実験の分解能(どの因子を独立に動かせるか)
ラベルや単位の揃え方(後で結合できるか)
評価の仕方(再現性をどう見るか、リークを避けるには)
測定量の選び方ごと変わることもあります。実験者が「この値は変数に使えそうだから測っておこう」と判断した量が、実はモデルに乗せにくい形だったり、別の測り方をした方が学習しやすかったりすることがあります。DSが科学的な背景を持ったうえで計画に入っていると、そこも含めて事前に詰められます。
「アルゴリズムを選ぶ」より前の話ですが、ここがずれると精度の議論にすら進めません。
ただ、データサイエンティストの発想は、実験現場の知見が浅いとズレます。実験者にも「いつもそうしている」というバイアスはあります。どちらの声も大事で、提案を試すかどうかを一緒に決められる関係が、相互理解の実態に近いと思っています。
実験者の歩み寄り
実験者がPythonを書いたり統計を学び直したりする必要はありません。「この測定値が何を意味しているのか」「なぜこの条件を優先しているのか」——そこを言語化する場に乗ってもらうだけで、モデルの質は大きく変わります。用語は後から揃えればよくて、観察と判断の背景を共有することが、一番コストが低く、一番効きます。
MIはツールの話だけでは終わりません。実験者とデータサイエンティストのあいだで前提を更新し続ける作業だと捉えています。
理想を言えば、実験の文脈を知ったままデータを扱える人が増えるのがいちばんだと思います。全員がそこに至れなければ、両者のことばを通訳できる人を育てていくことも、同じくらい意味があります。自分は前者の立場に近いところにいるので、今の現場を起点に考えを更新していきたいと思っています。
材料研究×データ活用の実務的な話は、「データ活用の実務」マガジンにまとめています。
いいなと思ったら応援しよう!
 よろしければ応援をお願いいたします!
頂いたチップを励みにこれからも記事を書かせていただきます。
