
AI音声合成とは?仕組み・活用シーン・始め方を解説!

この記事はこんな方に向けた内容です。
・AI 音声合成に興味はあるけど、仕組みがよくわからない方
・「ロボット声」のイメージがあって、実際どこまで自然なのか気になる方
・YouTube・ポッドキャスト・動画制作で AI ナレーションを活用したい方
・AivisSpeech を使い始めたばかりの方
・Web サービスやアプリに音声合成機能を組み込みたい開発者の方
・AI 音声合成の技術的な仕組みを理解したい方
なお、本記事の内容は 2026年4月時点のものです。
皆さんこんにちは!
感情豊かな音声合成技術を誰もがかんたんに活用できる未来を目指す Aivis Project です。
「AI 音声合成って最近よく聞くけど、実際どういう仕組みなの?」
「自分でも使えるの?難しくないの?」
「開発に組み込むとしたら、何を使えばいいの?」
このような疑問を持っている方は多いのではないでしょうか。
AI 音声合成は、テキスト(文章)を入力するだけで、人間のような自然な音声を自動生成できる技術です。
ほんの数年前まで「いかにも機械」だった合成音声は、今では「本当に人間が話しているの?」と思うほどのクオリティに進化しています。
この記事では、AI 音声合成の基本的な仕組みから種類・進化の歴史、具体的な活用シーン、よくある疑問への回答、ツール比較、そして実際に始める方法まで、初めての方にもわかりやすく、かつ技術的視点も含めて解説します!
ぜひ最後までご覧ください💫
1. AI音声合成とは?
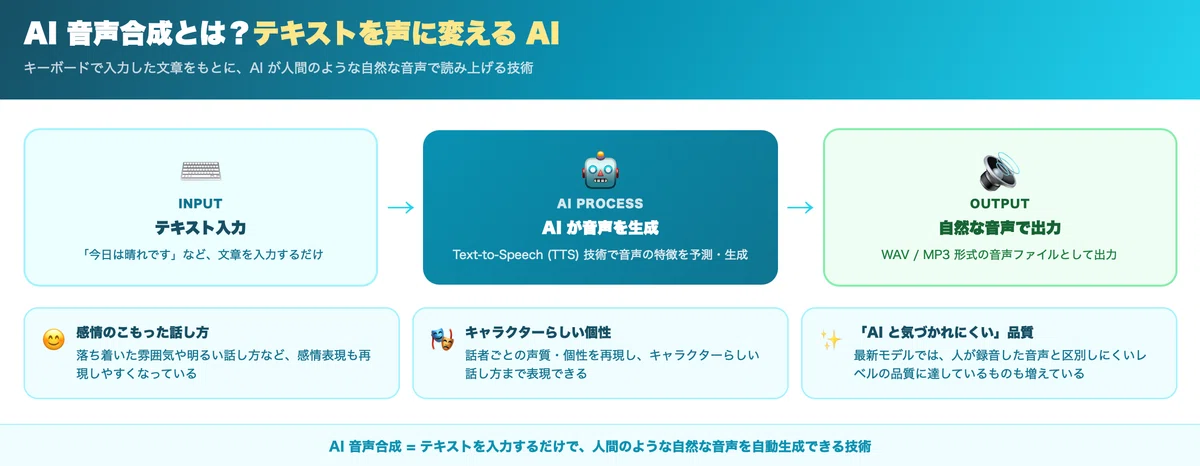
AI 音声合成を一言で表すと、「テキストを声に変える AI」です。
キーボードで入力した文章をもとに、AI が人間のような自然な音声で読み上げてくれる技術を指します。
身近な例でいうと、スマートフォンの音声アシスタントが話しかけてくれる声や、カーナビが「200 メートル先を右折です」と案内してくれる声も、広い意味では音声合成技術の一種です。
ただし、最近の AI 音声合成は、こうした従来の音声案内とは比べものにならないほど進化しています。
たとえば、単に文章を読むだけでなく、感情のこもった話し方や自然なイントネーション、さらにはキャラクターらしさのある声まで表現できるようになってきました。
そのため、用途によっては「機械が読んでいる」と気づかれにくいレベルに達しているサービスも増えています。
技術的には、AI 音声合成は Text-to-Speech (TTS) と呼ばれることもあります。
これは、入力されたテキストをもとに音声の特徴を予測し、最終的に人が聞ける音の波形として出力する仕組みです。
以前は複数の処理を段階的に組み合わせる形が一般的でしたが、近年ではより自然で高品質な音声をまとめて生成できるモデルも増えており、音質や表現力は大きく向上しています。
その結果、AI 音声合成は現在、ナレーション、動画制作、ゲーム、配信、音声アシスタント、業務システムへの組み込みなど、さまざまな場面で活用されるようになっています。
2. AI 音声合成の仕組みを3ステップで解説!
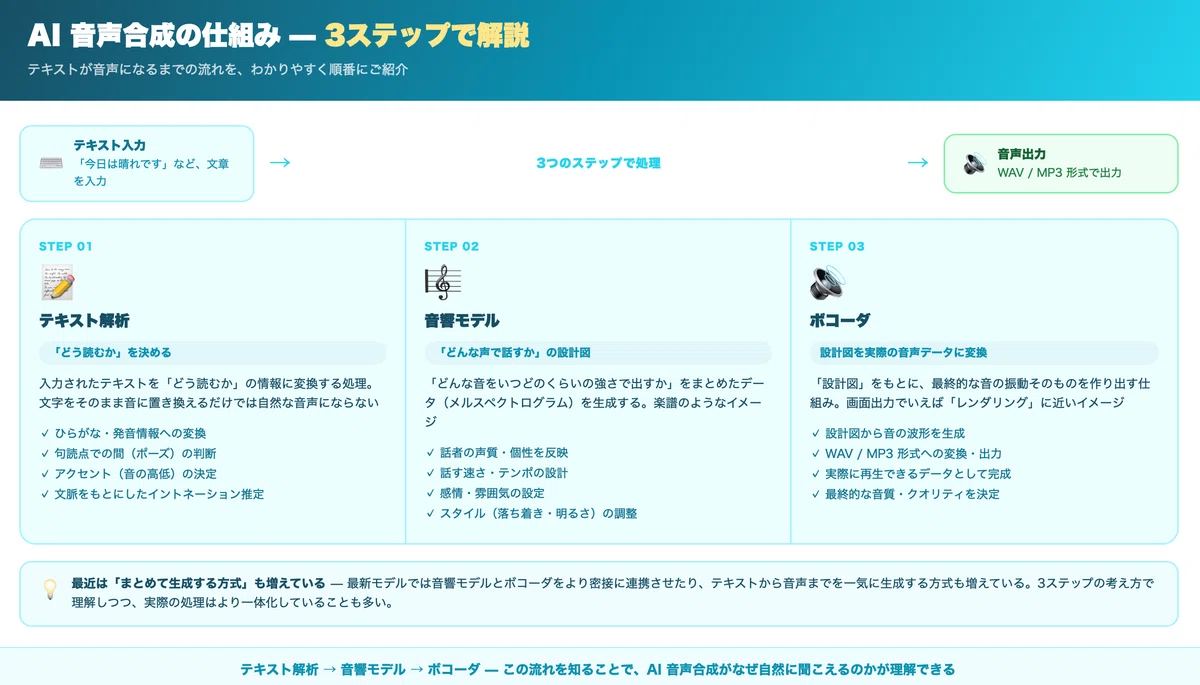
ここでは、AI 音声合成がどのようにテキストを音声へ変えているのかを、できるだけわかりやすく順番にご紹介します✨
Step1:テキスト解析(テキストを「どう読むか」の情報に変換する)
入力されたテキストは、そのままでは自然な音声にできません。
まず最初に行うのが、テキストを「どう読むか」の情報に変換する処理です。
たとえば、「東京都」という文字列は通常「とうきょうと」と読みます。
また、「今日は晴れです」という文では、文字としては「は」と書かれていても、実際の発音は「わ」になります。
このように、文章を自然に読み上げるためには、文字をそのまま音に置き換えるだけでは足りません。
どのように読むのか、どこで区切るのか、どこにアクセントを置くのかといった情報を、あらかじめ整理する必要があります。
このステップでは、主に以下のような処理が行われます。
・テキストをひらがなや発音の情報に変換する
・句読点や文の区切りをもとに、どこで間を置くかを判断する
・アクセント(音の高低の変化)を決める
・文脈をもとに、より自然なイントネーションを推定する
つまりこの段階では、「この文章を、どのように読ませるのが自然か」を整理しているイメージです。
特に日本語は、同じ漢字でも読み方が複数あったり、助詞の読み方が表記と異なったり、アクセントの扱いが複雑だったりするため、このステップの精度が音声の自然さに大きく影響します。
Step2:音響モデル("どんな声で話すか"の設計図を作る)
テキスト解析によって読み方の情報が整理できたら、次は AI モデルが 「どんな音を出すか」の設計図を作ります。
この設計図にあたるものとして、よく メルスペクトログラムという言葉が使われます。
少し専門的な名前ですが、イメージとしては、「どのタイミングで、どのような音を、どのくらいの強さで出すか」をまとめたデータです。
たとえば楽譜にたとえるなら、
「どの音を、どのタイミングで、どのくらいの長さ・強さで鳴らすか」
を細かく決めている段階に近い、と考えるとわかりやすいかもしれません。
このステップでは、単に文字を音にするだけではなく、以下のような情報も反映されます。
・どの話者の声として話すか
・どのくらいの速さで話すか
・落ち着いた雰囲気か、明るい雰囲気か
・感情やスタイルをどの程度持たせるか
つまり、ここでは 「何を読むか」ではなく、「どんな声で、どんな話し方で読むか」 が形になっていきます。
最近の AI 音声合成では、この部分の進化が特に大きく、以前よりも自然な抑揚や感情表現、キャラクターらしさを出しやすくなっています。
その結果、ただ文章を読み上げるだけではない、より表現力の高い音声が作れるようになってきました。
Step3:ボコーダ(設計図を実際の音声データに変換する)
「どんな声で話すか」の設計図ができたら、最後にそれを実際に再生できる音声データに変換します。
この役割を担うのがボコーダです。
ボコーダは、設計図を見ながら、最終的な音の振動そのものを作り出す仕組みです。
たとえば、画面表示にたとえるなら、設計図や指示をもとに、最終的な映像として表示できる形に仕上げるレンダリング処理に近いイメージです。
このステップを経ることで、最終的に WAV や MP3 といった、実際に再生できる音声データとして出力されます。
最近は「まとめて生成する方式」も増えている
ここまで3ステップでご紹介しましたが、最近の AI 音声合成では、これらをきれいに完全分離しているとは限りません。
特に最近のモデルでは、音響モデルとボコーダの役割をより密接に連携させたり、テキストから音声までを一気に生成したりする方式も増えています。
こうした仕組みによって、より自然で高品質な音声や、より高速な生成が実現しやすくなっています。
そのため、仕組みの考え方としては3ステップで理解するとわかりやすい一方で、実際の最新モデルでは、それらをより一体化した形で処理していることも多いと考えるとイメージしやすいと思います。
AI 音声合成の仕組み まとめ
AI 音声合成は、単に文字を音に置き換えているわけではありません。
まずどう読むかを決め、その次にどんな声で話すかを設計し、最後に実際の音声データとして出力することで、自然な音声が作られています。
この流れを知っておくと、AI 音声合成がなぜここまで自然に聞こえるのか、また、読み方・感情表現・声質の調整がなぜ重要なのかも理解しやすくなるはずです。
3. AI 音声合成の種類と進化の歴史
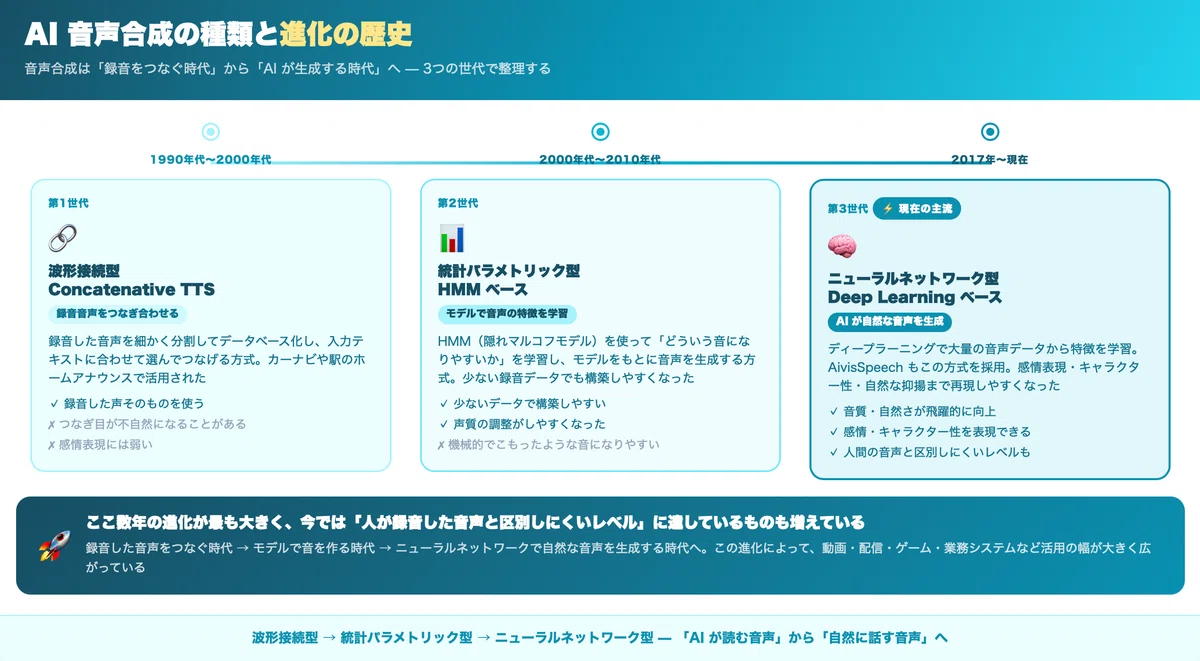
AI 音声合成は、これまでずっと同じ仕組みで進化してきたわけではありません。
時代ごとに使われる方式が大きく変わってきており、その変化を見ていくと、なぜ今の AI 音声合成がこれほど自然になったのかが見えてきます。
ここでは、代表的な 3 つの世代に分けてご紹介します。
第1世代:波形接続型(Concatenative TTS)
最初に広く普及したのが、あらかじめ録音しておいた音声をつなぎ合わせる方式です。
これは、話者の音声を細かい単位で大量に録音してデータベース化しておき、入力されたテキストに合わせて、その中から適切な音声断片を選び、順番につなげて読み上げる仕組みです。
1990 年代から 2000 年代にかけて広く使われており、カーナビの音声案内や駅のホームアナウンスなど、身近な場面でも長く活用されてきました。
この方式のよいところは、実際に録音した人の声そのものを使うため、聞き慣れた自然な音質を出しやすい ことです。
一方で、録音されていない言い回しや感情表現には弱く、音声のつなぎ目が不自然になることがある という課題もありました。
また、新しい話者を追加したい場合は、その人の声を大量に録音し直す必要があり、運用面でも手間がかかりやすい方式でした。
第2世代:統計パラメトリック型
次に主流となったのが、音声の特徴を統計モデルで学習し、そのパラメータをもとに音声を生成する方式です。
代表的なものとしては、HMM(隠れマルコフモデル)を使った手法があり、2000 年代から 2010 年代にかけて研究・実用の中心となりました。
この方式では、音声をそのままつなぎ合わせるのではなく、「どういう音になりやすいか」をモデルとして学習し、それをもとに新しい音声を作る という考え方になります。
メリットとしては、波形接続型と比べて少ない録音データでも構築しやすく、声質や話し方をある程度柔軟に調整しやすい点が挙げられます。
一方で、当時の技術ではどうしても機械的で少しこもったような音になりやすく、自然さの面では限界がありました。
それでも、この世代は音声合成における大きな前進であり、「録音した音を並べる」から、「モデルで音声を作る」へと考え方が変わっていく重要な時代でした。
その後は深層学習の発展によって、この流れがさらに加速していくことになります。
第3世代:ニューラルネットワーク型(現在の主流)
現在の主流になっているのが、ニューラルネットワーク型の音声合成です。
これは、ディープラーニングを使って大量の音声データから音声の特徴を学習し、より自然で表現力の高い音声を生成する方式です。
2017 年ごろから急速に発展し、今では AI 音声合成の中心的な方式になっています。
AivisSpeech が採用している音声合成の仕組みも、このニューラルネットワーク型に分類されます。
この世代の大きな特長は、音声の自然さが大きく向上したことです。
従来のような「機械っぽさ」がかなり抑えられ、
・自然な抑揚
・感情の表現
・キャラクターらしい話し方
・話者ごとの個性
まで再現しやすくなりました。
さらに最近では、少量の録音サンプルから話者の特徴を反映した音声を生成する技術も進んでおり、より柔軟で高品質な音声合成が実現しつつあります。
もちろん、こうした高品質さを支えているぶん、学習には大きな計算リソースやデータが必要になる傾向があります。
ただし、学習済みモデルを使った音声生成そのものは高速で、用途によってはリアルタイムに近い形で動かすことも可能です。
音声合成はここ数年で一気に自然になった
AI 音声合成の進化を振り返ると、
録音した音声をつなぐ時代から、
統計モデルで音を作る時代を経て、
現在はニューラルネットワークで自然な音声を生成する時代に入っている
ということがわかります。
特にここ数年の進化は大きく、今では用途によっては人が録音した音声と区別しにくいレベルの品質に達しているものも増えてきました。
その結果、動画、配信、ゲーム、ナレーション、アプリ、業務システムなど、活用の幅も大きく広がっています。
Aivis Project でも、こうした最新の AI 音声合成技術を活用した高品質な音声合成モデルを扱うことができ、AivisHub ではさまざまな音声合成モデルが公開・配布されています。
そのため、以前よりもずっと身近に、そして実用的に AI 音声合成を活用しやすい環境が整ってきています。
AI 音声合成の種類と進化の歴史 まとめ
AI 音声合成は、
波形接続型 → 統計パラメトリック型 → ニューラルネットワーク型
という流れで進化してきました。
現在主流のニューラルネットワーク型では、音質・自然さ・感情表現・キャラクター性のいずれも大きく向上しており、「AI が読む音声」から、「自然に話す音声」へ と大きく変わってきています。
この進化の流れを知っておくと、今の AI 音声合成がなぜここまで注目されているのか、そして なぜ実用の場面で使いやすくなってきたのか も理解しやすくなるはずです。
4. AI 音声合成の活用シーン
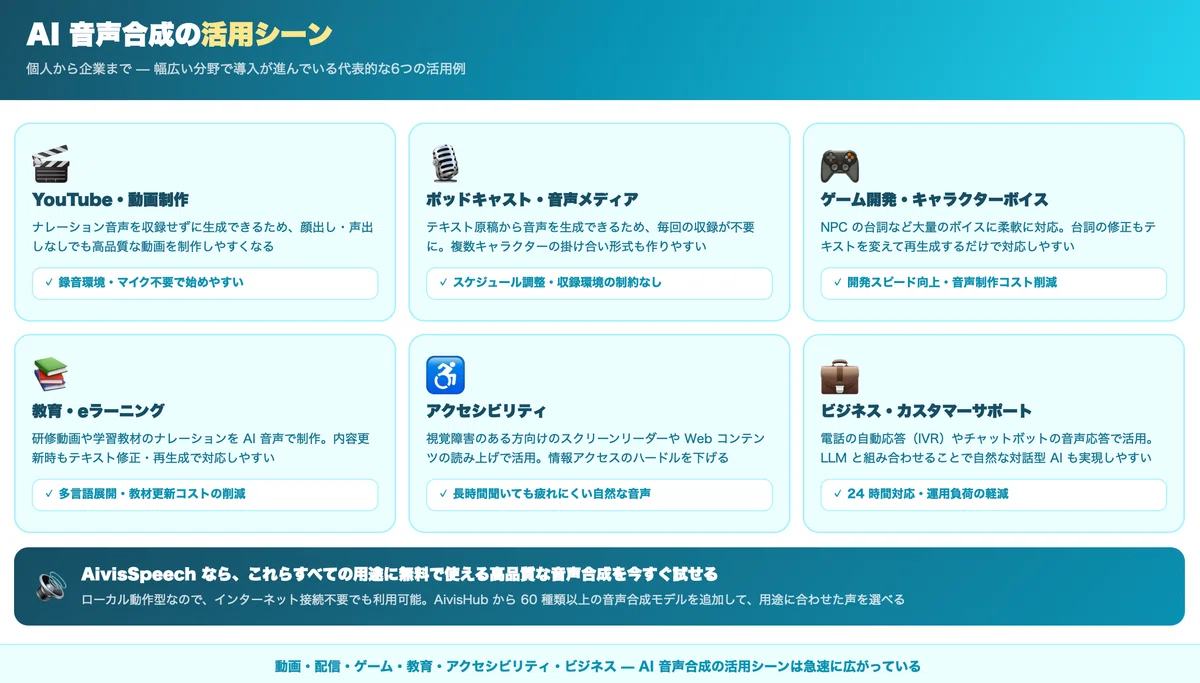
AI 音声合成は、さまざまな分野で活用されており、個人から企業まで幅広い用途で導入が進んでいます。ここでは、代表的な活用シーンを紹介します。
YouTube・動画制作
AI 音声合成を使えば、ナレーション音声を収録せずに生成できるため、顔出しや声出しをしなくても高品質な動画を制作しやすくなります。
実際に、解説動画、ニュース系チャンネル、商品レビュー動画など、幅広いジャンルで活用が進んでいます。
従来の動画制作では、
台本作成 → 録音 → 編集
という流れが一般的でした。
一方で、AI 音声合成を活用すると、
台本作成 → 音声生成 → 編集
という形に整理しやすくなります。
その結果、収録にかかる時間やコストを抑えやすくなるだけでなく、録音環境やマイクなどの機材がなくても始めやすいのが大きなメリットです。
「まずは動画制作を始めてみたい」という方にとっても、取り入れやすい活用方法のひとつです。
ポッドキャスト・音声メディア
AI 音声合成は、ポッドキャストや音声メディアの制作にも活用できます。
テキスト原稿からそのまま音声を生成できるため、毎回の収録が不要になり、番組制作を継続しやすくなります。
特に、話す人のスケジュール調整や、静かな収録環境の確保が難しい場合でも、テキストさえ用意できれば制作を進めやすいのが特長です。
また、複数のキャラクターボイスや話者を使い分けることで、対談形式のコンテンツや掛け合い形式の番組も作りやすくなります。
1 人で企画・台本制作・音声制作まで進めたい場合にも相性の良い使い方です。
ゲーム開発・キャラクターボイス
ゲーム開発では、NPC(ノンプレイヤーキャラクター)の台詞やイベントシーンの音声など、非常に多くのボイスが必要になることがあります。
AI 音声合成を活用すれば、こうした大量のセリフにも柔軟に対応しやすくなります。
たとえば、開発途中で台詞を調整したい場合でも、収録をやり直すことなく、テキストを修正して再生成するだけで対応しやすくなります。
そのため、開発スピードの向上や音声制作コストの削減にもつながります。
さらに、オリジナルの音声合成モデルを活用すれば、作品の世界観に合わせた独自のキャラクターボイスを作れるのも大きな魅力です。
教育・eラーニング
AI 音声合成は、教育コンテンツや eラーニング教材とも非常に相性が良い技術です。
研修動画や学習教材のナレーションを AI 音声で制作することで、教材の更新コストを抑えやすくなります。
特に、ルール変更や内容更新が多い教材では、音声を録り直すのではなく、テキストを修正して再生成するだけで対応しやすいため、運用負荷を下げやすいのが特長です。
また、翻訳と音声合成を組み合わせることで、多言語対応の教材制作にも活用しやすくなります。
同じ内容を複数の言語で展開したい場合にも、効率よく音声コンテンツを作りやすくなります。
アクセシビリティ
AI 音声合成は、アクセシビリティ向上の面でも重要な役割を持っています。
たとえば、視覚障害のある方に向けたスクリーンリーダーや、Web コンテンツの読み上げ機能などで活用されています。
音声が自然で聞き取りやすくなることで、長時間聞いていても疲れにくくなり、より多くの方が情報へアクセスしやすくなります。
そのため、AI 音声合成は単なる便利な技術ではなく、情報取得のハードルを下げるための大切な技術としても注目されています。
ビジネス・カスタマーサポート
ビジネス領域では、電話の自動応答(IVR)やチャットボットの音声応答などで活用が進んでいます。
24 時間いつでも対応できる仕組みを作りやすくなるため、顧客満足度の向上と運用負荷の軽減を両立しやすくなります。
特に、よくあるお問い合わせへの一次対応や、予約確認、案内業務などでは、AI 音声合成との相性が良いケースが多くあります。
さらに、近年では LLM(大規模言語モデル) と AI 音声合成を組み合わせることで、より自然な対話型の音声 AI も作りやすくなっています。
たとえば、LLM が生成したテキストを少しずつ取り出しながら音声合成へ渡す構成にすることで、最初の返答までの待ち時間を短くしやすくなります。
このようなリアルタイム性が求められる用途では、Aivis Cloud API のようにストリーミングを活用しやすい仕組みとの相性も良く、より自然な音声応答体験を設計しやすくなります。
5. よくある質問
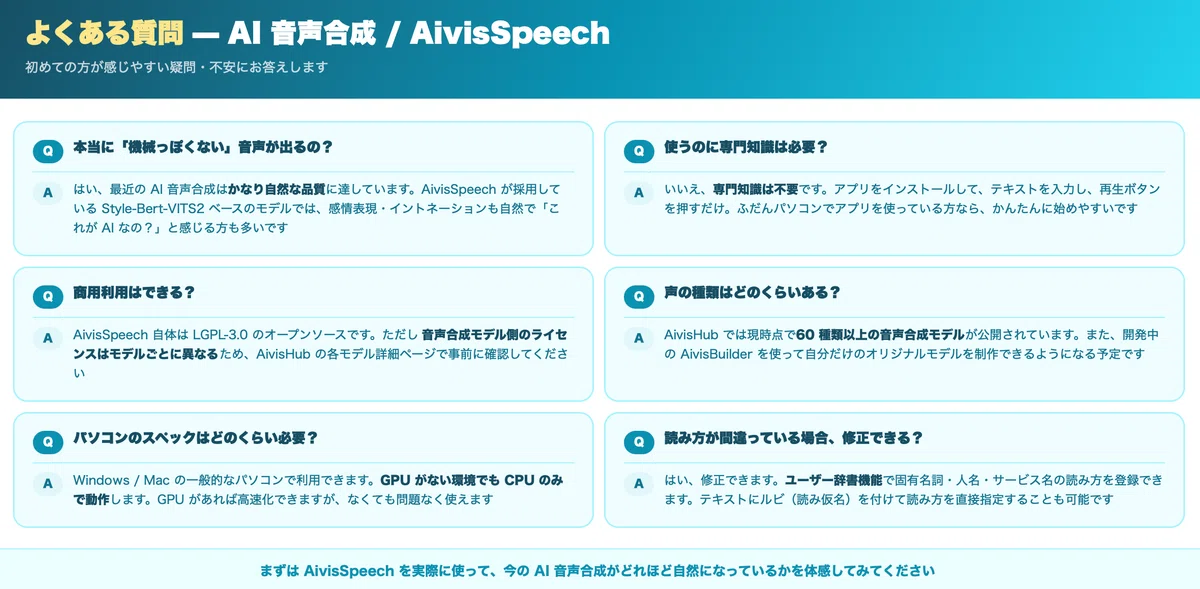
ここでは、AI 音声合成を初めて知った方が感じやすい疑問や不安 について、ひとつずつわかりやすくお答えします。
Q. 本当に「機械っぽくない」音声が出るの?
A. はい、最近の AI 音声合成はかなり自然な品質 に達しています。
特に、AivisSpeech が採用している Style-Bert-VITS2 ベースの音声合成モデル では、感情表現やイントネーションも自然で、実際に聞いてみると 「これが AI なの?」 と感じる方も少なくありません。
文章をただ読み上げるだけではなく、落ち着いた雰囲気や感情のこもった話し方まで表現しやすくなっているため、従来の「機械音声」のイメージとはかなり異なります。
まずは、AivisSpeech を実際に使って聞いてみる のがいちばんわかりやすいと思います。
Q. 使うのに専門知識は必要?
A. いいえ、AivisSpeech を使い始めるだけであれば、専門知識は必要ありません。
アプリをインストールして、テキストを入力し、再生ボタンを押すだけで音声を生成できます。
そのため、プログラミングや機械学習の知識がなくても、ふだんパソコンでアプリをインストールしたことがある方なら、比較的かんたんに始めやすい と思います。
一方で、API 連携や音声合成モデルの制作など、より発展的な使い方をしたい場合は、用途に応じて少しずつ知識を広げていく必要があります。
まずは 「使ってみる」 ところから始めていきましょう!
Q. 商用利用はできる?
A. 商用利用が可能かどうかは、音声合成ソフトウェア本体と使用する音声合成モデルのライセンスを分けて確認する必要があります。
AivisSpeech 自体は、LGPL-3.0 ライセンス のオープンソースソフトウェアです。
ただし、実際に音声を生成する際に使用する音声合成モデル側のライセンス条件はモデルごとに異なる場合があります。
そのため、商用利用を検討されている場合は、AivisHub の各モデル詳細ページでライセンス表記を確認するのがおすすめです。
特に、公開動画、商用コンテンツ、サービス組み込みなどに利用する場合は、事前に確認しておくと安心です。
Q. 声の種類はどのくらいある?
A. AivisHub では、現時点で60種類以上の音声合成モデル が公開されており、さまざまな声のキャラクターから選べます。
落ち着いた声、明るい声、個性的なキャラクターボイスなど、用途に応じて選びやすいのが特長です。
また、将来的には現在開発中の AivisBuilder を使って、自分の声やオリジナルキャラクターの音声合成モデル を制作できるようになる予定です。
そのため、今後は「公開されているモデルを使う」だけでなく、自分だけの音声合成モデルを活用する方向にも広がっていく予定です。
Q. パソコンのスペックはどのくらい必要?
A. AivisSpeech は、Windows / Mac の一般的なパソコン で利用できます。
また、GPU(グラフィックボード)がない環境でも、CPU のみで動作させることができます。
一方で、GPU が利用できる環境では、より高速に音声を生成しやすくなる ため、生成速度を重視したい場合には GPU 搭載環境が有利です。
どの程度の快適さで使えるかは、パソコンの性能や利用する音声合成モデルによっても変わるため、詳細については公式サイトの動作環境案内を確認するのがおすすめです。
Q. 読み方が間違っている場合、修正できる?
A. はい。修正できます。
AivisSpeech にはユーザー辞書機能が用意されており、固有名詞、サービス名、人名などの読み方を登録・調整できます。
また、テキストにルビ(読み仮名)を付けることで、読み方を直接指定することも可能です。
そのため、標準の読み方ではうまく読まれない単語があっても、後から調整しやすくなっています。
特に、ブランド名や専門用語、人名などは読み間違いが起きやすいため、こうした機能を活用することで、より意図に近い読み上げを行いやすくなります。
6. 主要な AI 音声合成ツール比較
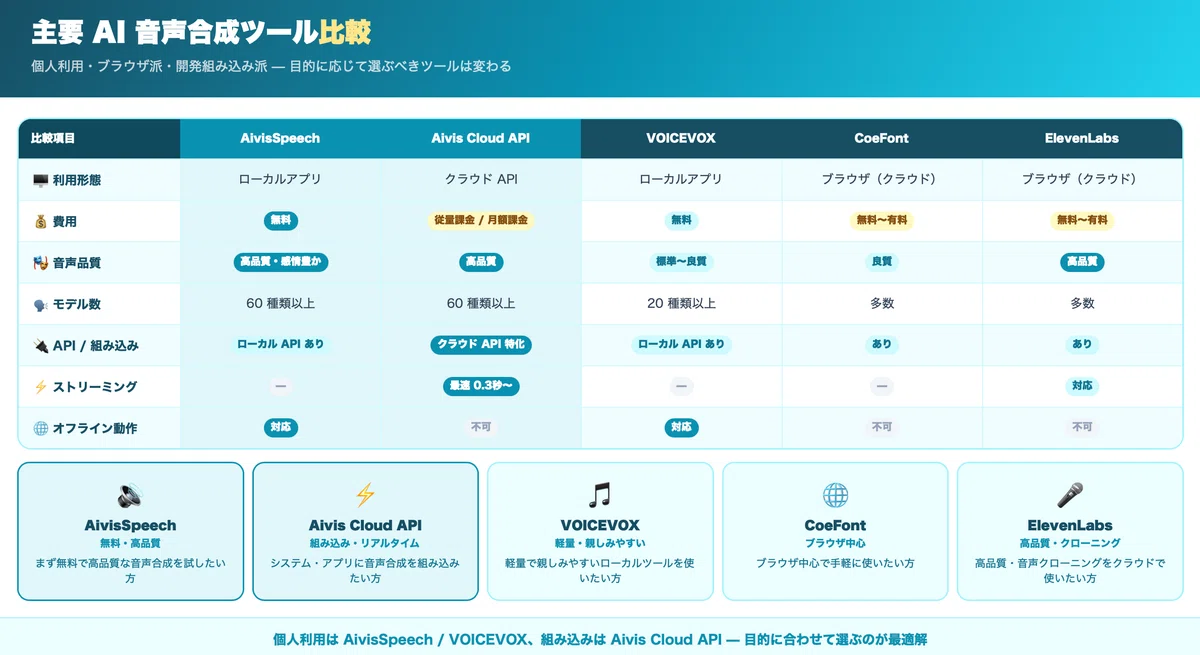
現在、日本にはさまざまな AI 音声合成ツールが存在しています。
それぞれに得意分野があり、用途によって、向いているツールは変わってきます。
ここでは、代表的なツールをわかりやすく整理してご紹介します。
ローカルで無料ではじめたいなら AivisSpeech や VOICEVOX
まず、パソコンにインストールして使うローカル型のツール としては、AivisSpeech や VOICEVOX が代表的です。
AivisSpeechは、高品質な音声 と 感情表現の豊かさ が大きな特長です。
さらに、AivisHub で公開されている 60 種類以上の音声合成モデル を利用できるため、用途に合わせて幅広い声を選びやすくなっています。
一方、VOICEVOX は、軽量で扱いやすく、コミュニティも活発なため、まずは無料で音声合成を試してみたい方にとって親しみやすい選択肢です。
豊富なキャラクター音声が用意されている点も魅力です。
ブラウザ中心で使いたいなら CoeFont や ElevenLabs
インストール不要で使いやすいのが、クラウド型の音声合成ツール です。
その代表例として、CoeFont や ElevenLabs があります。
CoeFont は、ブラウザから使いやすく、多数のボイスが用意されているのが特長です。
ローカル環境のセットアップなしで利用したい方に向いています。
ElevenLabs は、高品質な音声生成や音声クローニング機能で知られているクラウド型ツールです。
用途によっては非常に強力な選択肢ですが、利用目的や求める言語・運用方法によって向き不向きがあります。
システムやアプリに組み込みたいなら Aivis Cloud API
Aivis Cloud API は、Aivis Project が提供する クラウド API 型の音声合成サービスです。
単に音声を作るだけでなく、アプリや Web サービス、業務システムへ組み込みやすいことを前提に設計されています。
特に、最速 0.3 秒で生成開始 できる点や、ストリーミング対応、LLM との連携に適した構成が特長です。
そのため、リアルタイム性が求められる音声対話システムや、生成 AI と組み合わせたサービス開発とも相性が良くなっています。
どれを選べばよいのか
どのツールがよいかは、何をしたいかによって変わります。
・まずは無料で高品質な音声合成を試したい → AivisSpeech
・軽量で親しみやすいローカルツールを使いたい → VOICEVOX
・ブラウザ中心で手軽に使いたい → CoeFont
・クラウドで高品質な音声生成や音声クローニングを使いたい → ElevenLabs
・システムやアプリに音声合成を組み込みたい → Aivis Cloud API
このように、個人利用向けのツールと 開発・組み込み向けのツール では、選ぶべきものが変わってきます。
7. AivisSpeech を今すぐ始めよう
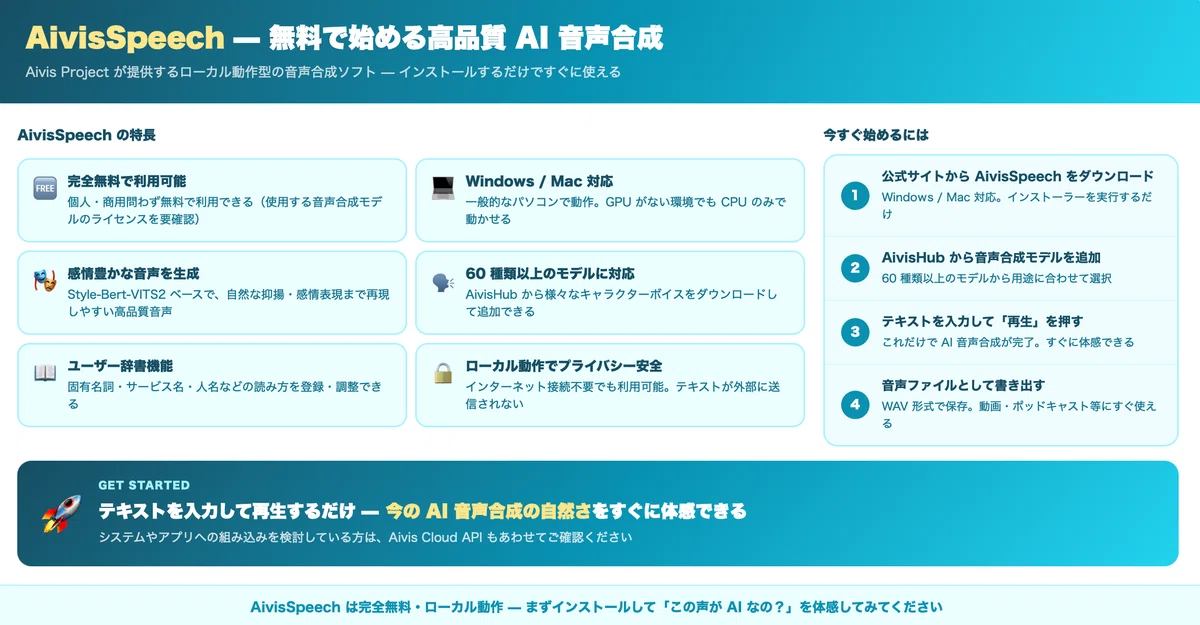
ここまで読んで、「実際に AI 音声合成を試してみたい!」 と感じた方におすすめなのが、無料で使える音声合成ソフト AivisSpeech です。
AivisSpeech は、Aivis Project が提供する ローカル動作型の音声合成ソフト です。
お使いのパソコンにインストールするだけで、テキストを入力してすぐに音声合成を試せます。
AivisSpeech には、次のような特長があります。
・完全無料で利用可能
・Windows / Mac に対応
・AivisHub から 60 種類以上の音声合成モデルを追加できる
・感情豊かな音声を生成できる
また、AivisSpeech では、テキストを入力して音声を生成する基本的な使い方だけでなく、AivisHub からの音声合成モデル追加や、ユーザー辞書による読み方・アクセントの調整なども行えます。
こうした AivisSpeech の具体的な使い方 については、以下の記事で画面付きで詳しく解説しています。
インストール方法から基本操作まで順番に知りたい方は、ぜひあわせてご覧ください。
AivisSpeech の使い方解説記事はこちら
8. まとめ
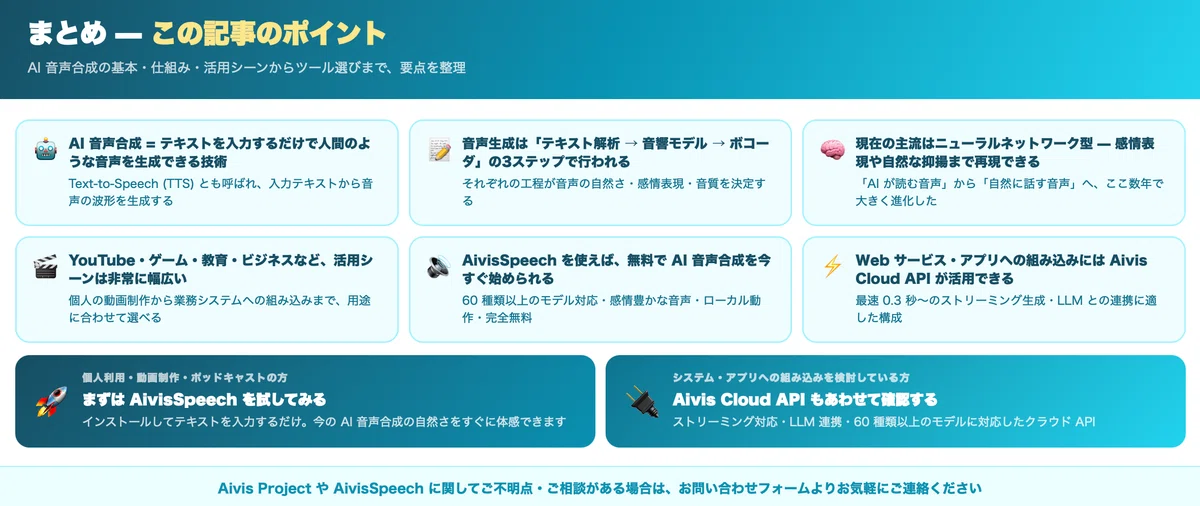
この記事では、AI 音声合成とは何か という基本から、仕組み、種類と進化の歴史、活用シーン、初心者の方が感じやすい疑問、主要ツールの比較、そして実際に始める方法まで、順番にご紹介してきました。
最後に、この記事のポイントをあらためて整理すると、以下のようになります。
・AI 音声合成は、テキストを入力するだけで人間のような音声を生成できる技術
・音声は、テキスト解析 → 音響モデル → ボコーダ という流れを通して生成される
・現在主流の ニューラルネットワーク型 では、感情表現や自然なイントネーションまで再現しやすくなっている
・YouTube、ポッドキャスト、ゲーム、教育、アクセシビリティ、ビジネスなど、活用シーンは非常に幅広い
・AivisSpeech を使えば、無料で AI 音声合成を始められる
・Web サービスやアプリ、ゲームなどへ組み込みたい場合は、Aivis Cloud API も活用できる
AI 音声合成は、ここ数年で一気に実用的な技術へと進化してきました。
以前は一部の専門領域に限られていたものが、今では 個人の動画制作 から 業務システムへの組み込み まで、幅広い場面で活用できるようになっています。
まずは、AivisSpeech を実際に使ってみること から始めてみるのがおすすめです。
テキストを入力して再生するだけでも、今の AI 音声合成がどれほど自然になっているかを体感していただけるはずです。
また、
「もっといろいろな声を試してみたい」
「自分のサービスやアプリに組み込みたい」
「読み方やアクセントまで細かく調整したい」
といった場合には、AivisHub や Aivis Cloud API もあわせて活用してみてください。
Aivis Project や AivisSpeech に関してご不明点やご相談がある場合は、お問い合わせフォーム よりお気軽にご連絡ください。
